20. Kruskal–Wallis H Testi
Analiz kimliği: kruskal · Menü adı: Kruskal-Wallis · Panel: gui/panels/analyses/kruskal_wallis.py · Motor: stats/hypothesis.py, HypothesisTests.kruskal_wallis (satır 4554–4676), ek çıktılar _kw_q1_extras (1478–1610), Dunn _dunn_posthoc (765–799), kesin p _kesin_p_blogu (1458–1475) ve stats/kesin_sayim.py, kw_kesin_p (87–182)
20.1 Ne işe yarar
Kruskal–Wallis testi, birbirinden bağımsız üç ya da daha çok grubun değerlerinin aynı dağılımdan gelip gelmediğini, ham değerler yerine birleşik sıralamadaki sıraları kullanarak sınar. Cevapladığı soru şudur: "Grupların ortalama sıraları arasındaki fark, yalnız rastgele atamayla açıklanabilir mi?"
- F_i: i. grubun (evrendeki) dağılım fonksiyonu; k: grup sayısı.
- Dağılımların biçimi aynı, yalnız konumu farklıysa H_0 "medyanlar eşittir" biçimine indirgenir. Biçimler farklıysa test medyan testi değildir (Mann–Whitney için 18.1'deki uyarının aynısı).
Test, Mann–Whitney U testinin k gruba genellemesidir: k=2 iken H, Mann–Whitney'in süreklilik düzeltmesiz z^2'sine eşittir. Aynı zamanda tek yönlü ANOVA'nın sıralar üzerinde kurulmuş biçimidir: değerleri sıralarıyla değiştirip ANOVA kurmak, büyük örneklemde aynı kararı verir.
Ne zaman kullanılır? Bağımlı değişken sıralı ya da sürekli ama çarpık veya aykırı değerliyse; gruplar farklı kişilerden oluşuyorsa; soru "gruplardan biri daha yüksek değer alma eğiliminde mi?" ise.
Ne zaman kullanılmaz?
- Yalnız iki grup varsa: Mann-Whitney U (Bölüm 18). Kruskal–Wallis iki grupla da çalışır (MerQur en az 2 grup ister,
hypothesis.py:4580–4581), ama ek çıktılar (HL kestirimi, rank-biserial) yalnız orada vardır. - Aynı kişiler her koşulda ölçüldüyse: gözlemler bağımlıdır, Friedman (Bölüm 21).
- Dağılımlar kabaca normal ve varyanslar benzerse: Tek Yönlü ANOVA (Bölüm 7) daha güçlüdür ve farkı özgün birimde verir; varyanslar farklıysa Welch ANOVA.
- Gruplar sıralıysa ve soru "değer grup sırasıyla artıyor mu?" ise: bu modüldeki Jonckheere–Terpstra ek çıktısı tek serbestlik dereceli bir eğilim testi olarak daha güçlüdür.
- Sonuç ikili ya da sayımsa: oranlar için ki-kare (Bölüm 25), sayımlar için Poisson modeli.
Sık karıştırılan analizler. "Mood medyan testi" (bu modülde ek çıktı) yalnız her gözlemin genel medyanın üstünde mi altında mı olduğunu sayar; Kruskal–Wallis tüm sıra bilgisini kullanır ve çoğu durumda daha güçlüdür. "Dunn testi" Kruskal–Wallis'in yerine geçmez; anlamlı bir H'den sonra hangi çiftlerin farklı olduğunu araştıran ikili karşılaştırmadır.
20.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsızlık | Gözlemler grup içinde ve gruplar arasında bağımsızdır. | Tasarımla sağlanır; denetlenmez. |
| En az sıralı ölçek | Değerler sıralanabilir; eşit aralık gerekmez. | Değer sütunu pd.to_numeric(..., errors="coerce") ile sayıya çevrilir; çevrilemeyen hücre eksik sayılır (hypothesis.py:4573). |
| Aynı biçim (yalnız medyan yorumu için) | Dağılımlar yalnız konumca farklıdır. | Denetlenmez. "Ölçek testleri" ek çıktısı yayılım farkını görmeyi sağlar. |
| En az 2 grup, değişkenlik | Grup sütununda ≥ 2 düzey; değerlerin hepsi aynı değil. | Değilse çevrilmiş hata (hypothesis.py:4580–4595). |
Normallik ve varyans eşitliği gerekmez. Bağlar (eşit değerler) testi geçersiz kılmaz: MerQur her yolda orta sıra kullanır ve H'yi bağ düzeltmesiyle hesaplar.
Eksik değer. Grup değeri eksik satır hiçbir gruba girmez (df[group_col].dropna().unique(), hypothesis.py:4574). Değer sütunu eksik satır kendi grubundan atılır (grup bazında silme, 4326). Künyedeki n df[[grup, değer]].dropna() satır sayısıdır (stats_panel.py:5183).
Uç durumlar.
- Grup sayısı < 2 ya da tüm değerler eşitse çevrilmiş hata verilir (
res_hyp_err_kruskal_groups,res_hyp_err_kruskal_const). - Grup başına tek gözlem kabul edilir. Conover–Iman post-hoc'u N-k\le0 ise atlanır ve not yazılır (
hypothesis.py:1509–1511). - Bir grup düzeyinin bütün değerleri eksikse o düzey analizden çıkarılır ve adıyla bir not yazılır; H, sd, asimptotik, kesin ve Monte Carlo p ve karar aynı (kalan) grup kümesiyle hesaplanır. R
kruskal.testde kullanılmayan düzeyi düşürür. - Kesin p hesap sınırını aşarsa sonuç yerine uyarı yazılır ve "İstenen ve uygulanan ayarlar" kaydına not düşülür (
hypothesis.py:1465–1472; 20.5.6).
20.3 Parametreler
Varsayılanlar kruskal_wallis.py:38–99 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Grup Sütunu | veriye bağlı | Bağımsız grupları tanımlayan değişken. | — |
| Değer Sütunu | veriye bağlı | Karşılaştırılan sayısal/sıralı değişken; çoklu seçilebilir. | Her sütun ayrı test edilir; çoklu karşılaştırma düzeltmesi yoktur. |
| Post-hoc testi | Yok | Dunn (Bonferroni, Holm, BH, Hochberg, Šidák), Conover–Iman, Nemenyi, Dwass–Steel–Critchlow–Fligner. | Ek bölüm; ana H değişmez. |
| Dunn p tek yönlü | kapalı | Dunn p=P(Z\ge\lvert z\rvert); karar p_{\text{düz}}\le\alpha/2. | Yalnız Dunn satırları. |
| Ek çıktı: ε², Betimsel | kapalı | \varepsilon^2 etki büyüklüğü; grup başına n, M, SS, medyan, Ç1/Ç3. | Ek satır/bölüm. |
| Güven Düzeyi | %95 | \alpha=1-\text{düzey}. | H₀ kararı, yıldız ve post-hoc işaretleri; p değişmez. |
| Ek çıktılar: Ayrıntılı ikili tablo (+ r) | kapalı | Dunn tablosu: \Delta\bar R, SH, z, ham ve düzeltilmiş p, r=\lvert z\rvert/\sqrt N. | Ek bölüm. |
| Ek çıktılar: Jonckheere-Terpstra | kapalı | Sıralı gruplar için eğilim testi. | Ek satır. |
| Ek çıktılar: Monte Carlo p | kapalı | B=10000 rastgele atamayla permütasyon p'si. | Ek satır; ana p değişmez. |
| Ek çıktılar: Kesin p (tam sayım) | kapalı | Bütün eşit olasılıklı grup atamaları sayılarak kesin p | Ek satır; sınır aşılırsa uyarı. |
| Ek çıktılar: Medyan testi | kapalı | k örneklem Mood medyan testi. | Ek satır. |
| Puan / ölçek testleri | kapalı | Van der Waerden + Savage; Siegel–Tukey, Ansari–Bradley, Mood, Klotz, Fligner–Killeen. | Ek bölümler. |
| Tohum | 12345 | Monte Carlo üreteci. | Yalnız Monte Carlo p. |
Güven düzeyi neden p'yi değiştirmez?
Kruskal–Wallis bir güven aralığı üretmez; güven düzeyi yalnız karar eşiğini (\alpha) ve post-hoc satırlarındaki "*" işaretini belirler. Monte Carlo satırındaki aralık her zaman %99'dur (Clopper–Pearson, hypothesis.py:1590), güven düzeyinden bağımsızdır. Varsayılan dışı bir düzey seçildiğinde MerQur kararın hangi eşikle verildiğini bir notla yazar (kruskal_wallis.py:117–118).
20.4 Tıp örneği
Dosya: english/datasets/Tip/16_kruskal_antibiotic_duration.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/16_kruskal_antibiotik_sure.xlsx).
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
antibiotic |
Grup Sütunu | nominal, 3 düzey | Amoksisilin, Sefuroksim, Levofloksasin (verideki ilk görülme sırası); her grupta 15 hasta. |
treatment_day |
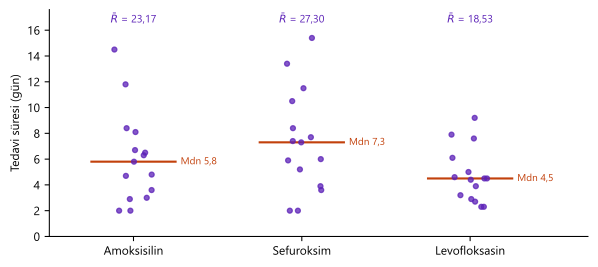
Değer Sütunu | sürekli (gün, bir ondalık) | Tedavi süresi; 2,0–15,4 gün, sağa çarpık. |
patient_id |
kullanılmaz |
n ve eksik değer: 45 hasta, eksik değer yok. Veride 7 bağ grubu vardır: 2,0 gün dört kez; 2,3, 2,9, 3,6, 3,9, 4,5 ve 8,4 gün ikişer kez.
Klinik soru: Üç antibiyotikle tedavi süresi dağılımları farklı mı? (VIDEO_SCRIPT_TR.txt, #16.)
Seçilen ayarlar: Arayüz varsayılanları. Sayısal yürüyüş için tüm ek çıktı kutuları açık ve post-hoc Dunn (Bonferroni) olarak ikinci bir çalıştırma; ayrıca Holm, tek yönlü Dunn, Conover–Iman, Nemenyi ve DSCF çalıştırmaları yapılmıştır. Kesin p bu verinin tamamında hesap sınırını aştığından (20.5.6), her antibiyotiğin son 5 hastasından oluşan alt kümede (N=15) ayrıca çalıştırılmıştır.
Şekil 20.1. Üç antibiyotikte tedavi süreleri. Turuncu çizgiler grup medyanları; üstteki sayılar birleşik sıralamada ortalama sıralar (\bar R).
20.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) grup düzeylerini MerQur'un ortak düzey sırasıyla al (Veri sekmesinde tanımlı sıra ya da sıralı kategorik, yoksa sayısal/doğal sıra, o da yoksa verideki ilk görülme sırası), her grupta değeri sayıya çevir ve eksikleri at, (2) H ve p'yi scipy.stats.kruskal ile hesapla (bağ düzeltmeli H, \chi^2_{k-1} yaklaşımı), (3) \eta^2_H'yi kur, (4) birleşik sıralamadan grup başına ortalama sırayı yaz, (5) istenen post-hoc ve ek çıktıları, grupları aynı düzey sırasıyla dizerek ekle.
20.5.1 Birleşik sıralama ve H istatistiği
Tüm grupların N=\sum n_i gözlemi birlikte küçükten büyüğe sıralanır; bağlı değerler kapladıkları sıraların ortalamasını (orta sıra) alır. Her grubun sıra toplamı R_i ve ortalama sırası \bar R_i=R_i/n_i'dir.
- R_i: i. grubun birleşik sıralamadaki sıra toplamı; n_i: grup büyüklüğü.
- H_0^{*}: bağ düzeltmesiz istatistik (yıldız, H_0 hipoteziyle karışmasın diye).
- Eşdeğer biçim: H_0^{*}=\dfrac{12}{N(N+1)}\sum n_i\big(\bar R_i-\tfrac{N+1}{2}\big)^2; yani ortalama sıraların genel ortalama sıradan (N+1)/2 ağırlıklı kare sapması.
Neden 12/(N(N+1))?
H_0 altında 1,\dots,N sıralarının varyansı (N^2-1)/12'dir. \bar R_i'nin varyansı, sonlu evren düzeltmesiyle \frac{(N+1)(N-n_i)}{12\,n_i} olur. Kare sapmaları bu varyansla ölçeklemek, ANOVA'daki F'nin payını hata varyansına bölmeye karşılık gelir; ölçek sabiti 12/(N(N+1)), H'yi büyük örneklemde \chi^2_{k-1} dağılımına yaklaştıracak biçimde seçilmiştir (Kruskal ve Wallis 1952). Sabit 3(N+1), \sum R_i^2/n_i'nin H_0 altındaki beklenen kısmını çıkarır.
20.5.2 Bağ düzeltmesi ve p değeri
- t_j: j. bağ grubundaki gözlem sayısı; bağsız değerde t_j^3-t_j=0, dolayısıyla C=1.
- C\le1 olduğundan bağ düzeltmesi H'yi büyütür.
- k-1: serbestlik derecesi; MerQur boş grup dahil düzey sayısından hesaplar (
hypothesis.py:4597).
Bağ düzeltmesi neden H'yi büyütür?
Bağlı gözlemler aynı orta sırayı alınca sıraların toplam yayılımı küçülür: \sum(r-\bar r)^2=\frac{N^3-N}{12}\,C. H_0^{*} ise bağsız sıra varyansını (paydadaki N(N+1)) varsayar ve gerçek varyansı abartır. C'ye bölmek, H'yi gerçek sıra varyansıyla ölçeklenmiş hâle getirir: H=(N-1)\sum n_i(\bar R_i-\bar r)^2/\sum(r-\bar r)^2. Bu biçim, doğrusal sıra puan testlerinin k örneklem ki-kare formülünün Wilcoxon puanlarıyla yazılmış hâlidir (20.5.5).
Koddaki tercih
Ana H ve p doğrudan scipy.stats.kruskal'dan gelir (hypothesis.py:4596); bağ düzeltmesi her zaman uygulanır, kapatılamaz (R kruskal.test de böyledir). Ek çıktılarda aynı H ayrıca elle de kurulur (_kw_q1_extras, 1377–1378); iki değer 10^{-15} düzeyinde aynıdır. Gruplar ana tabloda verideki ilk görülme sırasıyla, ek çıktılarda doğal sırayla (_natural_cat_order, hypothesis.py:512–517) yazılır. H sıradan bağımsızdır; Dunn z'sinin işareti ve JT'nin yönü değildir.
20.5.3 Etki büyüklükleri
- \eta^2_H: Kruskal–Wallis'in eta-karesi; H'nin H_0 altındaki beklenen değeri k-1 çıkarılıp en büyük olası değere bölünür. Negatif değer 0'a kırpılır (
hypothesis.py:4602–4603). Ana satırda ve APA satırında yazılır. - \varepsilon^2: Tomczak ve Tomczak'ın sıra epsilon-karesi; "ε²" kutusu açıksa yazılır, [0{,}1] aralığına kırpılır (
4350–4351). Reffectsize::rank_epsilon_squaredile aynıdır.
İki etki büyüklüğü farklı ölçekte
\eta^2_H "beklenen değeri çıkarılmış", \varepsilon^2 çıkarılmamış bir orandır; aynı veride \varepsilon^2>\eta^2_H olur (Tıp örneğinde 0,076 ve 0,032). Raporda hangisinin verildiği yazılmalıdır. MerQur'un APA satırı simgeyi yalnız "η²" diye yazar (hypothesis.py:4652); kastedilen \eta^2_H'dir.
20.5.4 İkili karşılaştırmalar
Dunn (bağ düzeltmeli z). Birleşik sıralamanın ortalama sıraları karşılaştırılır (_dunn_posthoc, hypothesis.py:765–799):
- \sigma^2: bağ düzeltmeli sıra varyansı (=\sum(r-\bar r)^2/(N-1)).
- p_{ij} seçilen yöntemle düzeltilir (
_padjust,hypothesis.py:734–762; Rp.adjusttanımları). Holm ve Hochberg tekdüze (kümülatif en büyük/en küçük) biçimdedir. - "Dunn p tek yönlü" açıksa p_{ij}=1-\Phi(\lvert z_{ij}\rvert) ve karar p_{\text{düz}}\le\alpha/2 ile verilir (R
dunn.test(altp = FALSE)). - Ayrıntılı tabloda etki büyüklüğü r=\lvert z_{ij}\rvert/\sqrt N (N toplam örneklem, çiftin değil).
Conover–Iman (tek adım). Aynı ortalama sıra farkı, H'den türetilen bir payda ve studentize aralık dağılımıyla değerlendirilir (hypothesis.py:1504–1516):
Nemenyi bağ düzeltmesiz sıra varyansıyla, sonsuz serbestlik dereceli studentize aralıkla: q_{ij}=\sqrt2\,\lvert\bar R_i-\bar R_j\rvert\big/\sqrt{\tfrac{N(N+1)}{12}(\tfrac1{n_i}+\tfrac1{n_j})}, p=P(Q_{k,\infty}>q_{ij}). Dwass–Steel–Critchlow–Fligner (DSCF) her çifti kendi ikili sıralamasında değerlendirir: W_{ij}, i. grubun çift içi sıra toplamı; q_{ij}=\sqrt2\,\big(W_{ij}-n_i(m+1)/2\big)/\sqrt{V_{ij}}, V_{ij} çift içi bağ düzeltmeli Mann–Whitney varyansı, m=n_i+n_j; p=P(Q_{k,\infty}>\lvert q_{ij}\rvert).
Neden dört ayrı post-hoc?
Dunn, z dağılımı ve ayrı bir çoklu karşılaştırma düzeltmesiyle çalışır; düzeltme seçimi kullanıcıdadır. Conover–Iman, H'nin açıkladığı kısmı paydadan çıkardığı (D<1) için Dunn'dan daha güçlüdür, ama anlamlı bir H sonrası kullanılmak üzere tasarlanmıştır. Nemenyi, Tukey HSD'nin sıra karşılığıdır ve aileyi kendisi korur. DSCF çift içi yeniden sıraladığından üçüncü bir grubun değerlerinden etkilenmez; bu yüzden "ikili Mann–Whitney'lerin aile korumalı biçimi" sayılır. Tıp örneğinde dördü de aynı kararı verir (20.6, Adım 5).
Koddaki tercih
Tanımlar PMCMRplus ile aynıdır: kwAllPairsConoverTest(p.adjust.method = "single-step"), kwAllPairsNemenyiTest(dist = "Tukey"), dscfAllPairsTest (hypothesis.py:1479–1481 belge dizisi). PMCMRplus'ın Conover varsayılanı Holm düzeltmesidir; MerQur tek adımlı studentize aralığı kullanır. Nemenyi bağ düzeltmesi yapmaz (PMCMRplus da "Ties are present, p-values are not corrected" uyarısı verir).
20.5.5 Ek testler
Jonckheere–Terpstra. Gruplar doğal sırada dizildiğinde, sıraya göre artan bir eğilimi sınar (hypothesis.py:1559–1577):
- U_{ij}: i. grubun bir gözleminin j. grubun bir gözleminden küçük olduğu çiftlerin sayısı (bağlar yarım).
- z=(J-E(J))/\sqrt{\operatorname{Var}(J)}, iki yönlü normal p. Varyans bağ düzeltmelidir (Hollander, Wolfe ve Chicken 2014); PMCMRplus
jonckheereTestile aynı. - Sıra, MerQur'un ortak düzey sırasıdır ve çıktıda "Sıra (öngörülen artış)" satırında yazılır. Kullanıcı sırayı sıralı kategorik sütunla ya da Veri sekmesinde tanımlayarak belirler; sıra tanımlanmamışsa verideki ilk görülme sırası kullanılır ve "sıra tanımlanmadı" uyarısı verilir. Eğilim testinin sonucu sıraya bağlı olduğu için alfabetik sıra kullanılmaz.
Medyan testi. Genel medyan M hesaplanır; her grupta M'den büyük ve M'ye eşit ya da küçük gözlemler sayılır; 2\times k tabloda süreklilik düzeltmesiz Pearson \chi^2_{k-1} (scipy.stats.median_test(ties="below", correction=False), hypothesis.py:1603).
Doğrusal sıra puan testleri. Bölüm 18'deki puanlar (Van der Waerden, Savage, Siegel–Tukey, Ansari–Bradley, Mood, Klotz; 18.5.6) k grupta ki-kare biçimine getirilir (_np1way_score_tests, hypothesis.py:1294–1329):
- a_j: j. gözlemin puanı (bağda bağ grubundaki konum puanlarının ortalaması); \bar a: tüm puanların ortalaması.
- S_i: i. grubun puan toplamı. Wilcoxon puanı a_j= orta sıra seçilirse bu formül tam olarak bağ düzeltmeli H'yi verir.
- Fligner–Killeen k grupta
scipy.stats.fligner(center="median"); Rfligner.testile aynıdır.
20.5.6 Kesin p (tam sayım)
\chi^2_{k-1} yaklaşımı küçük gruplarda kaba olabilir. "Kesin p (tam sayım)" kutusu, gözlenen orta sıraları sabit tutup bütün grup atamalarını sayarak p'yi kesin olarak hesaplar. H_0 altında N gözlemin gruplara her ataması eşit olasılıklıdır; atama sayısı çok terimli katsayıdır:
- M: eşit olasılıklı atama sayısı; çıktıda "… eşit olasılıklı grup ataması" diye yazılır.
- Dağılım koşulludur: bağlı değerler orta sıralarını korur; bağ düzeltme çarpanı C her atamada aynı olduğundan H\ge H_{\text{göz}} ile \sum R_i^2/n_i\ge(\cdot)_{\text{göz}} aynı olaydır.
- Karşılaştırma tam sayılarla yapılır: orta sıralar gerekiyorsa 2 ile çarpılır, \sum R_i^2/n_i ise L=\operatorname{ekok}(n_1,\dots,n_k) ile çarpılarak Q=\sum (L/n_i)\,R_i^2 tam sayısına çevrilir (
kesin_sayim.py:101–107). Kayan nokta eşitlik sorunu yoktur.
Algoritma (kw_kesin_p, kesin_sayim.py:87–182). Atamalar tek tek sayılmaz; dinamik programlama kullanılır:
- Farklı değerler (bağ sınıfları) küçükten büyüğe işlenir.
- Durum, ilk k-1 grubun o ana kadar aldığı eleman sayıları (c_1,\dots,c_{k-1}) ile tanımlanır; her durumda ilk k-1 grubun sıra toplamları üzerinde bir sayım dizisi tutulur. Son grubun eleman sayısı ve sıra toplamı ötekilerden türetilir.
- t gözlemli bir bağ sınıfı k gruba (a_1,\dots,a_k) biçiminde dağıtılır; ağırlık çok terimli katsayı t!/\prod a_i!'dir (
_cokterimli_dagilimlar,68–82). Sıra toplamları a_i\cdot v kadar kayar (v: sınıfın ölçekli orta sırası). - Sonunda (n_1,\dots,n_{k-1}) durumundaki dizide her hücrenin Q'su hesaplanır; Q\ge Q_{\text{göz}} hücrelerinin toplamı M'ye bölünür.
Hesap sınırı. İş, verinin büyüklüğüne göre hızla büyür. Hesaba başlamadan iki tahmin yapılır (kesin_sayim.py:120–133); biri aşılırsa kesin p verilmez:
- s_{\min}(c), s_{\max}(c): ölçekli sıraların en küçük ve en büyük c tanesinin toplamı; parantez, c elemanlı bir grubun sıra toplamının alabileceği değer sayısının üst sınırıdır.
- \binom{t+k-1}{k-1}: t bağlı gözlemin k gruba dağıtılma biçimi sayısı.
- Ayrıca hesap 60 saniyeyi geçerse durdurulur (
MAKS_SURE,kesin_sayim.py:40,172–173). - Sınır aşılırsa çıktıda "⚠ Kesin p hesaplanmadı: tam sayım için gereken dizi hücresi sayısı (…) sınırı (…) aşıyor. Bu veri için Monte Carlo p seçeneğini kullanın." yazılır.
Neden hücre sayısına sınır?
Bellek, hücre sayısıyla doğru orantılıdır: 2\times10^7 hücre, 8 baytlık kayan nokta sayımla yaklaşık 160 MB eder. Çarpımın her terimi kabaca n_i^2N/2 gibi büyür: bağsız üç grupta 3\times5 için 30976, 3\times10 için 1628176, 3\times15 için 17438976 hücre gerekir. Tek bir yarım sıra bile ölçeği 2 yapar ve hücre sayısını yaklaşık 4 kat artırır. Tıp verisi bağsız olsaydı 1{,}74\times10^7 hücreyle sınırın altında kalırdı; bağlar yüzünden tahmin 6{,}92\times10^7 hücredir ve sınırı aşar. Aynı verinin 3\times5'lik alt kümesinde hesap anında biter.
Koddaki tercih
Boş gruplar ana H'de de, kesin p'de de atılır (20.2, uç durumlar). Sınır aşıldığında ileti hangi sınırın (hücre sayısı, iş ya da süre) aşıldığını ayrı ayrı yazar. Kesin p satırı 8 ondalıkla yazılır; p<10^{-6}'da 4 anlamlı basamağa geçer, değer additional["exact_p"]'de tamdır. R'de coin::kruskal_test(distribution = "exact") yalnız iki grupta çalışır; k\ge3'te "not a two-sample problem" hatası verir. MerQur'un tam sayımı, iki örneklemdeki koşullu kesin testin (Bölüm 18.5.3) k örneklem genellemesidir; doğrulamada R'de kaba sayımla denetlenmiştir (20.6.1).
20.5.7 Monte Carlo p
"Monte Carlo p" kutusu, orta sıraları B=10000 kez rastgele karıştırır (numpy.random.default_rng(tohum).permutation), her karışımda \sum n_i\bar R_i^{*2}'yi gözlenenle karşılaştırır (hypothesis.py:1578–1592):
- +1'ler, gözlenen düzenin de bir permütasyon olduğunu hesaba katar; \hat p hiçbir zaman 0 olmaz (Phipson ve Smyth 2010).
- Çıktıdaki %99 GA, b/B oranının Clopper–Pearson aralığıdır (
scipy.stats.binomtest), (b+1)/(B+1)'in değil; fark 1/B düzeyindedir. - Satır kullanılan tohumu (formdaki değer) yazar.
20.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/kruskal/elle_hesap.py ile, MerQur kodu çağrılmadan hesaplanmıştır.
Adım 1 — Sıralar ve bağlar. 45 değer birlikte sıralanır. 2,0 gün dört kez geçer ve 1.–4. sıraları paylaşır: orta sıra 2,5. Altı değer ikişer kez geçer. Bağ toplamı:
Adım 2 — Sıra toplamları.
| Grup | n_i | Medyan | R_i | \bar R_i |
|---|---|---|---|---|
| Amoksisilin | 15 | 5,8 | 347,5 | 23,1667 |
| Sefuroksim | 15 | 7,3 | 409,5 | 27,3000 |
| Levofloksasin | 15 | 4,5 | 278,0 | 18,5333 |
Denetim: 347{,}5+409{,}5+278=1035=45\cdot46/2.
Adım 3 — H ve p.
(\chi^2_2 kuyruğu e^{-x/2} olduğundan bu değer elle de bulunur.) Bağ düzeltmesi H'yi yalnız %0,1 büyütür; az bağ vardır.
Adım 4 — Etki büyüklükleri.
Adım 5 — İkili karşılaştırmalar. Bağ düzeltmeli sıra varyansı \sigma^2=45\cdot46/12-96/(12\cdot44)=172{,}5-0{,}181818=172{,}318182; eşit grup büyüklüğünde her çiftin SH'si \sqrt{172{,}318182\cdot2/15}=4{,}793303. Conover'ın S^2'si bu veride aynı sayıdır, D=(44-3{,}348650)/42=0{,}967889.
| Çift | \Delta\bar R | Dunn z | ham p | Bonferroni | Holm | Conover p | Nemenyi p | DSCF p |
|---|---|---|---|---|---|---|---|---|
| Amoks.–Sefur. | −4,133 | −0,8623 | 0,3885 | 1,0000 | 0,6675 | 0,6579 | 0,6644 | 0,6184 |
| Amoks.–Levof. | 4,633 | 0,9666 | 0,3337 | 1,0000 | 0,6675 | 0,5918 | 0,5983 | 0,5532 |
| Sefur.–Levof. | 8,767 | 1,8289 | 0,0674 | 0,2022 | 0,2022 | 0,1633 | 0,1604 | 0,1893 |
Örnek: Sefur.–Levof. için z=(27{,}3-18{,}5333)/4{,}793303=1{,}8289; r=1{,}8289/\sqrt{45}=0{,}273. Hiçbir çift anlamlı değildir; H de anlamlı olmadığından bu beklenen sonuçtur.
Adım 6 — Ek testler.
| Test | İstatistik | p |
|---|---|---|
| Jonckheere–Terpstra (Amoks. < Sefur. < Levof.) | J=293; E(J)=337{,}5; SS =47{,}9959; z=-0{,}9272 | 0,353842 |
| Medyan testi (genel medyan 5,2; üstte 8, 10, 4 hasta) | \chi^2(2)=4{,}9802 | 0,082900 |
| Van der Waerden | \chi^2(2)=2{,}7509 | 0,252727 |
| Savage | \chi^2(2)=4{,}2580 | 0,118954 |
| Siegel–Tukey / Ansari–Bradley | \chi^2(2)=0{,}9291 / 0{,}8776 | 0,628403 / 0,644799 |
| Mood / Klotz | \chi^2(2)=1{,}7208 / 2{,}8594 | 0,423002 / 0,239381 |
| Fligner–Killeen | \chi^2(2)=3{,}8087 | 0,148916 |
| Monte Carlo (B=10000, tohum 12345; b=1894) | (1894+1)/10001 | 0,189481 |
JT'nin sırası bu veride tanımlanmamıştır (ilk görülme sırası) ve klinik bir anlam taşımaz; yalnız hesap örneği olarak verilmiştir. Monte Carlo p asimptotik p'ye (0,1874) yakındır (%99 GA [0,1794; 0,1997] onu içerir): 3\times15 gözlemde \chi^2 yaklaşımı iyidir.
Adım 7 — Kesin p. Tam veride hesap sınırı aşılır: hücre tahmini
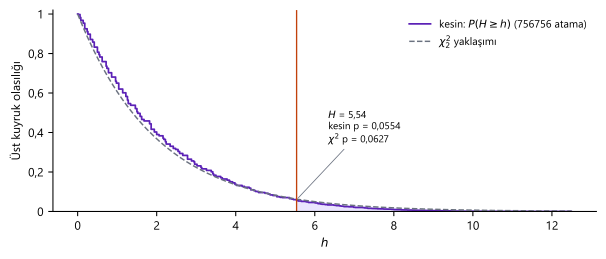
(s: 2 ile çarpılmış orta sıralar). Bu nedenle her antibiyotiğin son 5 hastası alınmıştır (N=15, bağ yok):
| Grup | Değerler (gün) | Sıralar | R_i | \bar R_i |
|---|---|---|---|---|
| Amoksisilin | 6,3 6,7 8,4 6,5 11,8 | 7 9 13 8 15 | 52 | 10,4 |
| Sefuroksim | 7,7 11,5 7,4 5,9 6,0 | 12 14 10 5 6 | 47 | 9,4 |
| Levofloksasin | 3,9 4,5 7,6 3,2 2,3 | 3 4 11 2 1 | 21 | 4,2 |
Atama sayısı M=15!/(5!)^3=756756. Bunların 41916'sında H\ge5{,}54 olur:
Monte Carlo (tohum 12345) 0{,}058894 verir. Kesin p, \chi^2 yaklaşımından %12 küçüktür; ikisi de 0,05'in üstündedir, ama 0,05 sınırına yakın bir veride yaklaşımın yönü önemlidir. \eta^2_H=(5{,}54-2)/12=0{,}295.
Şekil 20.2. Alt kümede (3\times5) H'nin kesin üst kuyruk olasılığı (basamaklı mor) ve \chi^2_2 yaklaşımı (kesikli). Kesin dağılım 162 farklı H değerinde yoğunlaşan kesikli bir dağılımdır.
20.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan, round() ve p_yuvarla bellekte etkisizleştirilerek alınmıştır (dogrulama/kruskal/merqur_calistir.py). Python, kesin p'yi MerQur'dan farklı bir algoritmayla kurar: gözlemler tek tek gruplara dağıtılır ve her (eleman sayıları, sıra toplamları) durumuna ulaşan atama sayısı Python tam sayılarıyla tutulur. R: 4.5.3, kruskal.test, effectsize::rank_epsilon_squared, dunn.test (Holm satırında p.adjust ile; 20.8 S5), PMCMRplus (kwAllPairsConoverTest(p.adjust.method = "single-step"), kwAllPairsNemenyiTest, dscfAllPairsTest, jonckheereTest), coin (normal_test, savage_test, ansari_test, mood_test, klotz_test, ties.method = "average-scores"), fligner.test. Siegel–Tukey puanları R'de formülle kurulmuştur. Kesin p R'de alt kümedeki 756756 atamanın kaba sayımıyla (combn) bulunmuştur. Monte Carlo satırlarında Python, MerQur'un üreteç adımlarını aynı tohumla yeniden üretir.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Ortalama sıra (Amoksisilin) | 23,166667 | 23,166667 | — | 0,0e+00 | ✓ |
| Ortalama sıra (Levofloksasin) | 18,533333 | 18,533333 | — | 0,0e+00 | ✓ |
| Ortalama sıra (Sefuroksim) | 27,300000 | 27,300000 | — | 0,0e+00 | ✓ |
| H (bağ düzeltmeli) | 3,348650 | 3,348650 | 3,348650 | 4,9e−15 | ✓ |
| p (\chi^2_2) | 0,187435 | 0,187435 | 0,187435 | 3,9e−16 | ✓ |
| \eta^2_H | 0,032111 | 0,032111 | 0,032111 | 3,5e−17 | ✓ |
| \varepsilon^2 | 0,0761 | 0,076106 | 0,076106 | 2,8e−17 | ✓ (4 ondalık) |
| Dunn z (Amoks.–Sefur.) | −0,862314 | −0,862314 | −0,862314 | 2,2e−16 | ✓ |
| Dunn z (Amoks.–Levof.) | 0,966626 | 0,966626 | 0,966626 | 2,2e−16 | ✓ |
| Dunn z (Sefur.–Levof.) | 1,828940 | 1,828940 | 1,828940 | 1,6e−15 | ✓ |
| Dunn Bonferroni p (Amoks.–Sefur.) | 1 | 1 | 1 | 0,0e+00 | ✓ |
| Dunn Bonferroni p (Amoks.–Levof.) | 1 | 1 | 1 | 0,0e+00 | ✓ |
| Dunn Bonferroni p (Sefur.–Levof.) | 0,202226 | 0,202226 | 0,202226 | 2,2e−16 | ✓ |
| Dunn Holm p (Amoks.–Sefur.) | 0,667462 | 0,667462 | 0,667462 | 4,4e−16 | ✓ |
| Dunn Holm p (Amoks.–Levof.) | 0,667462 | 0,667462 | 0,667462 | 4,4e−16 | ✓ |
| Dunn Holm p (Sefur.–Levof.) | 0,202226 | 0,202226 | 0,202226 | 2,2e−16 | ✓ |
| Dunn tek yönlü Bonferroni p (Amoks.–Sefur.) | 0,582772 | 0,582772 | 0,582772 | 4,4e−16 | ✓ |
| Dunn tek yönlü Bonferroni p (Amoks.–Levof.) | 0,500596 | 0,500596 | 0,500596 | 4,4e−16 | ✓ |
| Dunn tek yönlü Bonferroni p (Sefur.–Levof.) | 0,101113 | 0,101113 | 0,101113 | 3,9e−16 | ✓ |
| Conover–Iman p (Amoks.–Sefur.) | 0,657927 | 0,657927 | 0,657927 | 6,9e−14 | ✓ |
| Conover–Iman p (Amoks.–Levof.) | 0,591832 | 0,591832 | 0,591832 | 7,4e−14 | ✓ |
| Conover–Iman p (Sefur.–Levof.) | 0,163307 | 0,163307 | 0,163307 | 6,3e−13 | ✓ |
| Nemenyi p (Amoks.–Sefur.) | 0,664386 | 0,664386 | 0,664386 | 4,5e−14 | ✓ |
| Nemenyi p (Amoks.–Levof.) | 0,598339 | 0,598339 | 0,598339 | 3,3e−14 | ✓ |
| Nemenyi p (Sefur.–Levof.) | 0,160445 | 0,160445 | 0,160445 | 1,2e−15 | ✓ |
| DSCF p (Amoks.–Sefur.) | 0,618415 | 0,618415 | 0,618415 | 3,7e−14 | ✓ |
| DSCF p (Amoks.–Levof.) | 0,553207 | 0,553207 | 0,553207 | 2,5e−14 | ✓ |
| DSCF p (Sefur.–Levof.) | 0,189314 | 0,189314 | 0,189314 | 1,8e−15 | ✓ |
| Jonckheere–Terpstra J | 293 | 293 | 293 | 0,0e+00 | ✓ |
| Jonckheere–Terpstra z | −0,927163 | −0,927163 | −0,927163 | 4,4e−16 | ✓ |
| Jonckheere–Terpstra p | 0,353842 | 0,353842 | 0,353842 | 5,6e−17 | ✓ |
| Medyan testi \chi^2 | 4,980237 | 4,980237 | 4,980237 | 1,8e−15 | ✓ |
| Medyan testi p | 0,082900 | 0,082900 | 0,082900 | 8,3e−17 | ✓ |
| Van der Waerden \chi^2 | 2,750893 | 2,750893 | 2,750893 | 8,9e−16 | ✓ |
| Savage \chi^2 | 4,258034 | 4,258034 | 4,258034 | 1,8e−15 | ✓ |
| Siegel–Tukey \chi^2 | 0,929148 | 0,929148 | 0,929148 | 1,1e−16 | ✓ |
| Ansari–Bradley \chi^2 | 0,877633 | 0,877633 | 0,877633 | 1,1e−16 | ✓ |
| Mood \chi^2 | 1,720757 | 1,720757 | 1,720757 | 1,8e−15 | ✓ |
| Klotz \chi^2 | 2,859399 | 2,859399 | 2,859399 | 2,2e−15 | ✓ |
| Fligner–Killeen \chi^2 | 3,808743 | 3,808743 | 3,808743 | 2,2e−15 | ✓ |
| Monte Carlo p (tohum 12345, B = 10000) | 0,189481 | 0,189481 | — | 0,0e+00 | ✓ |
| Alt küme (N=15): H | 5,540000 | 5,540000 | 5,540000 | 8,9e−15 | ✓ |
| Alt küme: asimptotik p | 0,062662 | 0,062662 | 0,062662 | 2,2e−16 | ✓ |
| Alt küme: kesin p (tam sayım) | 0,055389 | 0,055389 | 0,055389 | 6,9e−18 | ✓ |
| Alt küme: eşit olasılıklı atama sayısı | 756756 | 756756 | 756756 | 0,0e+00 | ✓ |
| Alt küme: Monte Carlo p | 0,058894 | 0,058894 | — | 0,0e+00 | ✓ |
Sonuç: 46 büyüklüğün tamamı ölçütü karşılar. Kesin p üç bağımsız yoldan (MerQur dinamik programlama, Python durum sayımı, R kaba sayım) aynı orana (41916/756756) ulaşır.
20.7 Çıktıyı okuma
Varsayılan ayarlarla Sonuçlar sekmesinin üst bloğu (stats_panel.py:9885–9923) ve yorum satırı:
TEST: Kruskal-Wallis H Testi
──────────────────────────────────────────────────
İstatistik : 3.3487
p-değeri   : 0.187435  ns
df         : 2.0
Etki Büy.  : 0.0321  (η²_H = 0.0321)

GRUP İSTATİSTİKLERİ:
  Amoksisilin: n = 15, medyan = 5.8, ort. = 6.0733, ort. sıra = 23.17
  Sefuroksim: n = 15, medyan = 7.3, ort. = 7.3467, ort. sıra = 27.3
  Levofloksasin: n = 15, medyan = 4.5, ort. = 4.74, ort. sıra = 18.53

H(2) = 3.3487, p = 0.1874 ns, η²_H = 0.0321. H₀ REDDEDİLEMEZ.
APA: H(2) = 3.35, p = .187, η² = .03
Tüm seçeneklerle eklenen bölümlerden (kısaltılmış):
── ETKİ BÜYÜKLÜKLERİ ──
    η²_H = 0.0321   ε² = 0.0761
── Dunn ikili karşılaştırmaları (düzeltme: bonferroni) ──
                                       ΔR̄        SE        z         p     p adj       r
    Amoksisilin − Sefuroksim        -4.133     4.793   -0.862    0.3885    1.0000   0.129
    Amoksisilin − Levofloksasin      4.633     4.793    0.967    0.3337    1.0000   0.144
    Sefuroksim − Levofloksasin       8.767     4.793    1.829    0.0674    0.2022   0.273
── Jonckheere-Terpstra ──
    Sıra (öngörülen artış): Amoksisilin < Sefuroksim < Levofloksasin
    J = 293.0, E(J) = 337.5, SD = 47.9959, z = -0.9272, p = 0.3538
── Monte Carlo p ──
    Monte Carlo permütasyon p (B = 10000, tohum 12345) = 0.189481  [%99 GA 0.1794, 0.1997]
── Kesin p (tam sayım) ──
    ⚠ Kesin p hesaplanmadı: tam sayım için gereken dizi hücresi sayısı (6.92e+07)
      sınırı (2e+07) aşıyor. Bu veri için Monte Carlo p seçeneğini kullanın.
⚠ Düzey sırası tanımlanmadı (antibiotic): eğilim testi verideki ilk görülme sırasını
  (Amoksisilin, Sefuroksim, Levofloksasin) skor olarak kullandı. ...
Alt kümede (3\times5) kesin p satırı:
── Kesin p (tam sayım) ──
    Kesin permütasyon p = P(H ≥ H_gözlenen) = 0.05538906  (756756 eşit olasılıklı
    grup ataması; bağlar orta sıralarla)
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İlk satır | H (sd), p, yıldız, \eta^2_H, karar | H bağ düzeltmelidir; p \chi^2_{k-1} yaklaşımıdır. |
| Grup tablosu | n, medyan, ortalama, ortalama sıra | Gruplar düzey sırasıyla dizilir. Testin karşılaştırdığı büyüklük ortalama sıradır. |
| Dunn tablosu | \Delta\bar R, SH, z, p, düzeltilmiş p, r | Gruplar düzey sırasıyla; z'nin işareti çiftte önce gelen grubun ortalama sırası büyükse pozitiftir. |
| Jonckheere–Terpstra | J, E(J), SS, z, p | Yalnız düzey sırası anlamlı bir sıra ise yorumlanır; "sıra tanımlanmadı" uyarısı varsa yorumlanmaz. |
| Monte Carlo / Kesin p | Permütasyon p'leri | Küçük gruplarda ve p\approx\alpha iken asimptotik p yerine raporlanır. |
| Kesin p uyarısı | Hesap sınırı aşıldı | Monte Carlo p'yi açın; ana sonuç geçerlidir. |
APA biçiminde rapor cümlesi:
Tedavi süresi üç antibiyotik arasında anlamlı farklılık göstermedi, Kruskal–Wallis H(2) = 3{,}35, p = 0{,}187, \eta^2_H = 0{,}03. Ortalama sıralar Levofloksasin'de 18,5 (Mdn = 4,5 gün), Amoksisilin'de 23,2 (Mdn = 5,8 gün) ve Sefuroksim'de 27,3 (Mdn = 7,3 gün) idi; Bonferroni düzeltmeli Dunn karşılaştırmalarının hiçbiri anlamlı değildi (en küçük düzeltilmiş p = 0{,}202).
20.8 Uzman soruları
S1. MerQur'un H'si bağ düzeltmeli mi; kapatılabilir mi?
Her zaman bağ düzeltmelidir (scipy.stats.kruskal, hypothesis.py:4596) ve kapatılamaz. R kruskal.test de düzeltmeli değeri verir. Bu veride düzeltmesiz H_0^{*}=3{,}3451, düzeltmeli H=3{,}3487; fark %0,1'dir. Yoğun bağlı Likert verisinde fark büyür ve düzeltme H'yi her zaman büyütür.
S2. Kesin p nasıl hesaplanıyor, Monte Carlo'dan farkı ne?
Gözlenen orta sıralar sabit tutularak N!/\prod n_i! eşit olasılıklı atamanın tamamı, dinamik programlamayla sayılır (kesin_sayim.py:87–182); p, H\ge H_{\text{göz}} olan atamaların oranıdır. Monte Carlo aynı dağılımdan B=10000 örnek çeker; sonuç örnekleme hatası taşır (%99 GA verilir). Kesin p tekrar üretilebilirdir ve tohuma bağlı değildir; bedeli hesap sınırıdır (2\times10^7 hücre, 3\times10^9 iş, 60 s).
S3. Kesin p hangi veride hesaplanamaz, ne yapılmalı?
Hücre sayısı kabaca grup büyüklüklerinin ve N'nin çarpımı gibi büyür. Bağsız veride 3\times12 yarım saniyede biter, 4\times6 ise sınırı aşar (7{,}41\times10^7 hücre). Bağlı (yarım sıralı) veride ölçek 2 olduğundan sınır daha erken gelir: Tıp örneğindeki 3\times15 veri 6{,}92\times10^7 hücreyle aşar. Bu durumda MerQur sonucu atlar, nedenini yazar ve Monte Carlo p'yi önerir. Büyük örneklemde zaten \chi^2 yaklaşımı iyidir (bu veride Monte Carlo 0,1865, asimptotik 0,1874).
S4. Bağlı veride kesin p koşullu mu, koşulsuz mu?
Koşulludur: bağlar orta sıralarını korur ve yalnız grup etiketleri permüte edilir. Bu, R coin paketinin kesin testlerinin tanımıdır. Koşulsuz (bağsız tablolardan) kesin dağılım bağlı veride yanlış sonuç verir.
S5. Dunn'ın Holm p'si R'deki dunn.test'ten neden farklı?
dunn.test(method = "holm") "durdurma kuralı" gösterimini kullanır: her basamağın ham çarpımını yazar ve tekdüzeliği zorlamaz. Bu veride ikinci çift için 0,3885 yazar. MerQur R p.adjust("holm") tanımını kullanır: düzeltilmiş p'ler kümülatif en büyükle tekdüze yapılır (0,6675). Ret kararı iki tanımda aynıdır; sayılar farklıdır.
S6. Neden Dunn, Conover, Nemenyi ve DSCF farklı p veriyor?
Payda ve referans dağılımı farklıdır. Conover paydadan H'nin açıkladığını çıkarır (D<1) ve Q_{k,N-k} kullanır: anlamlı H sonrası en güçlüsüdür. Nemenyi bağ düzeltmesiz varyansla Q_{k,\infty} kullanır. DSCF her çifti yeniden sıralar. Dunn ise z ve ayrı düzeltmedir. Tıp örneğinde Sefur.–Levof. çifti için p: Dunn-Bonferroni 0,202, Conover 0,163, Nemenyi 0,160, DSCF 0,189.
S7. η²_H ile ε² arasında hangisi raporlanmalı?
İkisi farklı tanımlardır: \eta^2_H=(H-k+1)/(N-k), H_0 altındaki beklenen değeri çıkarır ve küçük etkide 0'a kırpılır; \varepsilon^2=H/(N-1) çıkarmaz. R rstatix::kruskal_effsize \eta^2_H, effectsize::rank_epsilon_squared \varepsilon^2 verir. Hangisi raporlanırsa adıyla yazılmalıdır.
S8. Grup sırası sonucu değiştirir mi?
H, p ve kesin p değişmez; Monte Carlo p'nin dağılımı da değişmez, ancak aynı tohumla çekilen atamalar farklı gruplara düştüğü için tek bir Monte Carlo değeri Monte Carlo hatası kadar oynar. Dunn z'sinin ve DSCF q'sunun işareti, ayrıntılı tablodaki "A − B" yönü ve JT'nin öngörülen artış sırası değişir. MerQur ana tabloda ve ek çıktılarda grupları ortak düzey sırasıyla dizer: tanımlı sıra ya da sıralı kategorik, yoksa sayısal/doğal sıra, o da yoksa verideki ilk görülme sırası. Alfabetik sıra kullanılmaz; etiketin diline göre değişen bir sıra JT'nin sonucunu keyfi kılardı. JT'yi anlamlı bir sırayla kullanmak için sırayı Veri sekmesinde tanımlayın ya da grupları 1, 2, 3 gibi sayısal kodlayın.
S9. Çok küçük gruplarda ne olur?
Grup başına tek gözlem bile kabul edilir; \chi^2 yaklaşımı ise anlamını yitirir. Örneğin 3\times2 bağsız veride en büyük H=4{,}57'dir ve \chi^2_2 ile p=0{,}102 çıkar, oysa kesin p=1/15=0{,}067'dir: asimptotik p bu kez tutucudur. Küçük gruplarda kesin p kutusu açılmalıdır; bu boyutta hesap anlıktır.
20.9 Sık hatalar ve tuzaklar
- "Medyanlar farklı" diye raporlamak. Test, dağılımların biçimi aynı değilse medyan testi değildir. Ölçek testleri yayılım farkını gösterir.
- Anlamlı olmayan H'den sonra ikili karşılaştırma aramak. Post-hoc kutusu H'den bağımsız çalışır; anlamsız H'den sonra tek bir anlamlı çift bulmak çoklu sınama sorunudur.
- Dunn z'sinin işaretini çift etiketine bakmadan okumak. z'nin işareti çiftte önce gelen gruba göredir.
- JT'yi sırası tanımlanmamış metin etiketlerle kullanmak. Öngörülen sıra verideki ilk görülme sırasıdır ve "sıra tanımlanmadı" uyarısı çıkar; sırayı Veri sekmesinde tanımlayın.
- Kesin p uyarısını hata sanmak. Sınır aşıldığında ana test geçerlidir; yalnız kesin satır atlanır. Monte Carlo p'yi kullanın.
- Çıkarılan boş düzeyi gözden kaçırmak. Bütün değerleri eksik bir grup düzeyi analizden çıkarılır ve notla yazılır; raporda grup sayısı buna göre verilmelidir.
- Çoklu değer sütununda düzeltme beklemek. Her sütun ayrı test edilir; düzeltme yoktur.
20.10 Kaynaklar
- Ansari, A. R., & Bradley, R. A. (1960). Rank-sum tests for dispersions. The Annals of Mathematical Statistics, 31(4), 1174–1189. https://doi.org/10.1214/aoms/1177705688
- Conover, W. J. (1999). Practical nonparametric statistics (3rd ed.). Wiley.
- Critchlow, D. E., & Fligner, M. A. (1991). On distribution-free multiple comparisons in the one-way analysis of variance. Communications in Statistics – Theory and Methods, 20(1), 127–139. https://doi.org/10.1080/03610929108830487
- Dunn, O. J. (1964). Multiple comparisons using rank sums. Technometrics, 6(3), 241–252. https://doi.org/10.1080/00401706.1964.10490181
- Fligner, M. A., & Killeen, T. J. (1976). Distribution-free two-sample tests for scale. Journal of the American Statistical Association, 71(353), 210–213. https://doi.org/10.1080/01621459.1976.10481517
- Fritz, C. O., Morris, P. E., & Richler, J. J. (2012). Effect size estimates: Current use, calculations, and interpretation. Journal of Experimental Psychology: General, 141(1), 2–18. https://doi.org/10.1037/a0024338
- Hollander, M., Wolfe, D. A., & Chicken, E. (2014). Nonparametric statistical methods (3rd ed.). Wiley.
- Jonckheere, A. R. (1954). A distribution-free k-sample test against ordered alternatives. Biometrika, 41(1–2), 133–145. https://doi.org/10.1093/biomet/41.1-2.133
- Klotz, J. (1962). Nonparametric tests for scale. The Annals of Mathematical Statistics, 33(2), 498–512. https://doi.org/10.1214/aoms/1177704576
- Kruskal, W. H., & Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association, 47(260), 583–621. https://doi.org/10.1080/01621459.1952.10483441
- Mood, A. M. (1954). On the asymptotic efficiency of certain nonparametric two-sample tests. The Annals of Mathematical Statistics, 25(3), 514–522. https://doi.org/10.1214/aoms/1177728719
- Phipson, B., & Smyth, G. K. (2010). Permutation p-values should never be zero: Calculating exact p-values when permutations are randomly drawn. Statistical Applications in Genetics and Molecular Biology, 9(1), Article 39. https://doi.org/10.2202/1544-6115.1585
- Savage, I. R. (1956). Contributions to the theory of rank order statistics—the two-sample case. The Annals of Mathematical Statistics, 27(3), 590–615. https://doi.org/10.1214/aoms/1177728170
- Siegel, S., & Tukey, J. W. (1960). A nonparametric sum of ranks procedure for relative spread in unpaired samples. Journal of the American Statistical Association, 55(291), 429–445. https://doi.org/10.1080/01621459.1960.10482073