46. İkili Lojistik Regresyon
Analiz kimliği: logistic_regression · Menü adı: İkili Lojistik Regresyon · Panel: gui/panels/analyses/logistic_regression.py · Motor: stats/regression.py, Regression.logistic (satır 1127–1455) ve stats/linlogit_extras.py
46.1 Ne işe yarar
İkili lojistik regresyon, iki kategorili bir sonucun (hasta/sağlıklı, olay var/yok) olasılığını bir ya da daha çok açıklayıcı değişkenle modeller. Cevapladığı sorular şunlardır: "Yaş bir yıl arttığında kalp krizi geçirme odds'u kaç kat değişir?", "Diğer risk etkenleri sabitken sigara içmek odds'u değiştiriyor mu?", "Bu hastanın olay olasılığı nedir?"
Model, olasılığın kendisini değil, logitini (log-odds) doğrusal yazar:
- \pi_i=P(Y_i=1\mid\mathbf x_i): i. kişide olayın olasılığı.
- \pi_i/(1-\pi_i): odds (olasılığın olmama olasılığına oranı); 0,5 olasılık odds = 1 demektir.
- \mathbf x_i=(1,x_{i1},\dots,x_{ip})^{\top}: başına 1 eklenmiş açıklayıcı vektörü (1, sabit terim içindir).
- \boldsymbol\beta: log-odds ölçeğinde katsayılar; e^{\beta_j} odds oranıdır (OR).
- \eta_i=\mathbf x_i^{\top}\boldsymbol\beta: doğrusal yordayıcı.
Neden doğrudan olasılık değil de logit?
Olasılık 0 ile 1 arasında sınırlıdır; doğrusal bir fonksiyon bu aralığın dışına taşar. Logit dönüşümü (0{,}1) aralığını (-\infty,\infty)'a açar; doğrusal model bu ölçekte sınırsız değer alabilir. Ayrıca logit, Bernoulli dağılımının kanonik bağlantısıdır: yeterli istatistik \mathbf X^{\top}\mathbf y olur ve en çok olabilirlik denklemleri yalın bir biçim alır: \mathbf X^{\top}(\mathbf y-\boldsymbol\pi)=\mathbf 0.
Ne zaman kullanılır? Sonuç tam iki kategorili ise; açıklayıcılar sayısal ya da kategorik olabilir; amaç etkilerin OR olarak kestirimi ya da olasılık tahminidir.
Ne zaman kullanılmaz?
- Sonuçta üç ya da daha çok sırasız kategori varsa: Multinomial Lojistik Regresyon; sıralı kategoriler varsa Sıralı Lojistik Regresyon (MerQur bu modülde iki sınıf dışında hata verir).
- Olay zamanı önemliyse ve izlem süreleri farklıysa: Cox regresyonu.
- Gözlemler kümeli ya da tekrarlıysa: GEE ya da karma etkili lojistik model (bu modülde yalnız küme-sağlam SH vardır).
- Karmaşık örneklem ağırlıkları varsa: Ağırlıklı Lojistik Regresyon (Survey Logistic).
- Olay çok nadir ve örneklem küçükse: Firth düzeltmesi açılmalıdır.
Sık karıştırılan analizler. Probit regresyon aynı soruyu normal birikimli bağlantıyla yanıtlar; katsayılar yaklaşık 1,6–1,8 kat küçüktür ve OR yorumu yoktur. Doğrusal olasılık modeli (0/1 sonuçla OLS) olasılığı doğrudan modeller ama sınır dışı tahmin üretebilir. Ayırma analizi (LDA) açıklayıcıların çok değişkenli normalliğini varsayar.
46.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| İkili sonuç | Bağımlı değişkende tam iki farklı değer. | İki değilse hata (regression.py:1179–1188). |
| Bağımsız gözlemler | Her satır ayrı kişi; kümelenme yok. | Tasarım; gerekirse Küme değişkeni ile küme-sağlam SH. |
| Logitte doğrusallık | Sürekli x ile logit arasında doğrusal ilişki (olasılıkla değil). | İsteğe bağlı Box–Tidwell (x\ln x terimleri). |
| Çoklu doğrusal bağıntı yok | Açıklayıcılar birbirinin doğrusal birleşimi değil. | İsteğe bağlı VIF; tam bağımlılıkta açıklayıcı hata. |
| Ayrışma yok | Bir açıklayıcı birleşimi sonucu kusursuz ayırmamalı. | Her çalıştırmada doğrusal programlama ile otomatik denetim (linlogit_extras.py:619–640). |
| Yeterli olay sayısı | Kabaca açıklayıcı başına en az 10 olay (EPV). | Denetlenmez; kullanıcı hesaplamalıdır. |
Normallik ve varyans eşitliği varsayımı yoktur: Bernoulli dağılımında varyans ortalamanın fonksiyonudur, \operatorname{Var}(Y_i)=\pi_i(1-\pi_i).
Eksik değer. Hedef ve seçilen açıklayıcıların (varsa etkileşimde geçen değişkenlerin) herhangi birinde eksik olan satır tümüyle çıkarılır (liste bazında silme, regression.py:1162).
Sabit açıklayıcı. Tek değerli bir açıklayıcı modelden çıkarılır ve uyarılır; R'nin NA katsayı davranışına karşılık gelir (regression.py:1168–1174).
46.3 Parametreler
Varsayılanlar logistic_regression.py:36–204 ve motorun options okumasından alınmıştır. Panelde onay kutularının varsayılanı ile motorun varsayılanı farklı olabilir; tabloda arayüz varsayılanı verilmiştir.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken | veriye bağlı | İki sınıflı hedef. | Olay kategorisi aşağıdaki kuralla seçilir. |
| Bağımsız değişkenler | en az 1 | Sayısal ya da kategorik açıklayıcılar. | Metin sütunları ve Veri sekmesinde "kategorik" işaretli sütunlar kukla kodlanır. |
| Güven Düzeyi | %95 | Katsayı/OR GA'sı ve AME GA'sı için; \alpha=1-\text{düzey}. | GA genişliği; Hosmer–Lemeshow etiketinde de bu \alpha kullanılır. |
| Güven aralığı yöntemi | Wald (varsayılan) | Wald: b\pm z\cdot\SH. Profil olabilirlik: LR testinin tersine çevrilmesi. | Yalnız GA sınırları değişir; b, SH, z, p aynı kalır. |
| Ek çıktı: Pseudo-R² (CS/Nagelkerke) | açık | McFadden, Cox–Snell, Nagelkerke R^2. | Ek satır. |
| Ek çıktı: Sınıflandırma + AUC | açık | Doğruluk, duyarlılık, özgüllük, AUC, 2×2 tablo, PPV, NPV. | Ek bölüm. |
| Ek çıktı: Hosmer-Lemeshow | kapalı | Ondalık gruplarıyla uyum iyiliği. | Ek satır. |
| Ek çıktı: VIF | kapalı | Açıklayıcı başına VIF. | Ek bölüm. |
| Sınıflama kesme değeri | 0,5 | \hat\pi\ge kesme değeri ise olay. | Sınıflama tablosu ve oranlar; AUC değişmez. |
| Olay kategorisi | boş | Y = 1 sayılacak kategori. | Boşsa ortak olay kuralı: 0/1 ya da 1/2'de büyük değer; tanınan olumlu etiket; aksi hâlde düzey sırasındaki ikinci sınıf ve uyarı. Değiştirmek tüm katsayıların işaretini çevirir. |
| Referans kategori (faktörler) | İlk düzey | Kukla kodlamada referans: ilk ya da son düzey. | Kategorik açıklayıcıların OR'leri hangi düzeye göre yazılır. |
| Değişken seçim yöntemi | Enter (tümü) | İleri/geri adımsal (LR ya da Wald). | Modele giren değişkenler. |
| PIN / POUT | 0,05 / 0,10 | Adımsal giriş/çıkış eşikleri. | Yalnız adımsal yöntemde kullanılır. |
| Hiyerarşik bloklar | boş | "a, b | c" biçiminde bloklar. | Blok χ², model χ² ve −2LL tablosu. |
| Kategorik (faktör) değişkenler | boş | Sayısal kodlu sütunları kukla kodlatır. | Tasarım matrisi. |
| Etkileşim terimleri | boş | x1*x2 ya da x1:x2. |
Tasarım matrisi; AME hesaplanmaz. |
| Standart hata türü | Klasik (ML bilgi matrisi) | HC0 ya da HC1 sandviç SH. | SH, z, p, GA. |
| Küme değişkeni | (yok) | Küme-sağlam sandviç SH. | SH, z, p, GA. |
| Aşırı yayılım ölçeği | Yok (ölçek = 1) | Pearson ya da sapma \varphi ile SH ölçeklenir. | SH, z, p, GA. |
| Ek çıktılar (2): Omnibus + Tip III (LR/Wald) | kapalı | Model χ², −2LL, terim başına LR ve Wald χ²; katsayı tablosuna Wald χ² sütunu. | Ek bölüm. |
| Ek çıktılar (2): Etkili gözlem tanıları | kapalı | Kaldıraç, Cook D, Pearson ve sapma artıkları, DFBETA. | Ek bölüm ve tablo. |
| Ek çıktılar (2): Ortalama marjinal etkiler | kapalı | Olasılık ölçeğinde AME (delta yöntemi SH). | Ek bölüm. |
| Box-Tidwell | kapalı | Pozitif sürekli x'ler için x\ln x testi. | Ek bölüm. |
| Firth düzeltmesi | kapalı | Cezalı en çok olabilirlik. | Tüm katsayılar değişir. |
| Veri setine kaydet | kapalı | PRE, PGR, COO, LEV, ZRE, DEV sütunları. | Veri setine yeni sütunlar. |
| Frekans ağırlığı | Yok (ağırlıksız) | Her satır ağırlığı kadar çoğaltılır. | n ve tüm kestirimler. |
| Özel kontrast (L) | boş | L\boldsymbol\beta için Wald testi ve OR. | Ek satırlar. |
| Grafik | Tahmin olasılığı histogramı | Histogram ya da 3B olasılık yüzeyi. | Yalnız Grafik sekmesi. |
Olay kategorisi kuralı (koddan)
Sınıflar MerQur'un ortak düzey sırası kuralıyla dizilir (natural_cat_order, regression.py:1194–1216): kullanıcının sıralı kategorik sütunu; sayısal etiketlerde sayısal sıra; aksi hâlde verideki ilk görülme sırası. Alfabetik sıra kullanılmaz. Olay kategorisi, bütün ikili sonuç analizlerinin ortak kuralıyla seçilir (core/binary_event.py, regression.py:1256–1264): 0/1 ya da 1/2 sayısal kodda büyük değer; iki düzeyden yalnız biri tanınan olumlu etiketse (evet, yes, var, present, pozitif, event, case, died …) o düzey; aksi hâlde düzey sırasındaki ikinci sınıf ve "olay kategorisi seçilmedi" uyarısı. 0/1 kodlamada olay 1'dir; 9/10 gibi başka sayısal kodlarda sıradaki ikinci değer (10) olay alınır ve uyarı yazılır. Sonuç metninin ilk satırı olay ve referans kategoriyi açıkça yazar: Olay (Y = 1): 1 · referans (Y = 0): 0.
46.4 Tıp örneği
Dosya: english/datasets/Tip/40_logistic_KAH.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/40_lojistik_KAH.xlsx: kalp_atagi, yas, kolesterol, sigara, sistolik_KB).
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
heart_attack |
Bağımlı | 0/1 | 144 olay (%48), 156 olay yok |
age |
Açıklayıcı | sürekli (yıl) | ort. 60,7; SS 11,7; 40–79 |
cholesterol |
Açıklayıcı | sürekli (mg/dL) | ort. 233,9; SS 48,3; 150–319 |
smoking |
Açıklayıcı | 0/1 (sayısal) | 96 sigara içen (%32) |
systolic_bp |
Açıklayıcı | sürekli (mmHg) | ort. 145,5; SS 20,2; 110–179 |
n ve eksik değer: 300 hasta, hiçbir sütunda eksik değer yok; modelde 300 gözlem kullanılır. Açıklayıcı başına olay sayısı 144/4=36'dır; EPV ≥ 10 ölçütü rahatça karşılanır.
smoking sayısal 0/1 olduğu için kukla kodlanmaz, olduğu gibi girer; katsayısı "sigara içen ile içmeyen arasındaki log-odds farkı" anlamını yine taşır.
Klinik soru: Yaş, kolesterol, sigara ve sistolik kan basıncı, birbirlerinin etkisi denetlendiğinde kalp krizi riskiyle ilişkili mi? Her etkenin OR'si nedir?
Seçilen ayarlar: Arayüz varsayılanları (Enter, Wald GA, %95, kesim 0,5, Pseudo-R² ve Sınıflandırma açık). Hesap yürüyüşü için Hosmer–Lemeshow, VIF ve Omnibus + Tip III kutuları da açılarak ikinci bir çalıştırma yapılmıştır.
46.5 Formüller ve hesap adımları
46.5.1 Olabilirlik
Y_i\sim\text{Bernoulli}(\pi_i) ve gözlemler bağımsız olduğundan log-olabilirlik
- y_i\in\{0{,}1\}: gözlenen sonuç.
- \eta_i=\mathbf x_i^{\top}\boldsymbol\beta; ikinci biçim birinciye \pi_i=e^{\eta_i}/(1+e^{\eta_i}) konarak bulunur ve sayısal olarak daha kararlıdır.
- \ell her zaman negatiftir; 0'a ne kadar yakınsa uyum o kadar iyidir. Çıktılarda -2\ell ("−2LL") kullanılır.
Türevler:
- \mathbf U: skor vektörü; en çok olabilirlik kestiriminde \mathbf U(\hat{\boldsymbol\beta})=\mathbf 0.
- \mathbf X: n\times(p+1) tasarım matrisi (ilk sütun 1'ler).
- \mathbf I: Fisher bilgi matrisi. Logit kanonik bağlantı olduğundan gözlenen ve beklenen bilgi aynıdır.
- \mathbf W: Bernoulli varyanslarından oluşan köşegen ağırlık matrisi.
46.5.2 Kestirim: Newton–Raphson = IRLS
\mathbf U(\boldsymbol\beta)=\mathbf 0 denkleminin kapalı çözümü yoktur; yinelemeli çözülür. Newton–Raphson adımı
cebirsel olarak yinelemeli yeniden ağırlıklandırılmış en küçük kareler (IRLS) adımıyla aynıdır:
- \mathbf z^{(t)}: "çalışma yanıtı"; logit ölçeğine birinci dereceden Taylor açılımıyla taşınmış gözlem.
- Her adım, \mathbf z'nin \mathbf X üzerine \mathbf W ağırlıklı en küçük kareler regresyonudur.
Neden IRLS?
Lojistik modelde Hessian -\mathbf X^{\top}\mathbf W\mathbf X her zaman negatif yarı tanımlıdır; log-olabilirlik içbükeydir ve (ayrışma yoksa) tek bir en büyük noktası vardır. Newton–Raphson bu durumda karesel hızla yakınsar; genellikle 4–6 yineleme yeter. Her adımın ağırlıklı en küçük kareler olması, hesabı doğrusal regresyon altyapısıyla yapmayı sağlar (Nelder ve Wedderburn 1972; McCullagh ve Nelder 1989).
Koddaki tercih: statsmodels Logit, Newton, başlangıç β = 0
MerQur sm.Logit(y, X).fit(disp=False) çağırır (regression.py:1010). statsmodels 0.14.6 varsayılanları: method="newton", maxiter=35, başlangıç değeri sıfır vektörü, durma ölçütü \max_j|\beta_j^{(t+1)}-\beta_j^{(t)}|<10^{-8}. statsmodels ortalama log-olabilirlikle (\ell/n) çalışır ve sayısal kararlılık için bu ölçekli Hessian'ın köşegenine 10^{-10} ekler; bu, ilk yinelemede 7. anlamlı basamakta küçük bir fark yaratır (aşağıda), yakınsama noktasını değiştirmez, çünkü durma noktasında skor sıfırdır. R glm ise başlangıçta \hat\mu_i=(y_i+0{,}5)/2 alır ve sapmanın göreli değişimiyle durur; iki yazılım farklı yollardan aynı kestirime ulaşır.
Newton yöntemi en çok yineleme sayısında yakınsamazsa yineleme sayısıyla birlikte çevrilmiş bir yakınsama uyarısı yazılır (regression.py:1024–1026). Yakınsamamanın tipik nedeni olan ayrışma ise doğrusal programlamayla ayrıca denetlenir (46.5.9).
Başlangıç β = 0'da ilk adımın kapalı biçimi. \boldsymbol\beta^{(0)}=\mathbf 0 iken her gözlemde \pi_i=0{,}5, w_i=0{,}25 ve z_i=(y_i-0{,}5)/0{,}25=4y_i-2\in\{-2,\,2\} olur. \mathbf W=0{,}25\,\mathbf I sabit olduğu için
yani ilk IRLS adımı, 4y-2'nin açıklayıcılar üzerine sıradan en küçük kareler regresyonudur. Bu, doğrusal olasılık modelinin katsayılarının 4 katıdır (sabit terimde ayrıca −2 kayması).
46.5.3 Standart hata, Wald testi ve odds oranı
- \hat{\mathbf W}: \pi_i'ler kestirimdeki değerleriyle hesaplanmış ağırlık matrisi.
- z_j: standart normal dağılıma göre değerlendirilir (t değil): ML kestiricileri asimptotik olarak normaldir ve kestirilecek ayrı bir ölçek parametresi yoktur.
- \text{OR}_j: x_j bir birim arttığında, diğer açıklayıcılar sabitken odds'un çarpıldığı katsayı.
- GA önce log-odds ölçeğinde kurulur, sonra üstel alınır; bu yüzden OR GA'sı OR çevresinde simetrik değildir.
Neden GA log-odds ölçeğinde kurulup dönüştürülüyor?
\hat\beta_j'nin örnekleme dağılımı normale yakındır; e^{\hat\beta_j}'ninki sağa çarpıktır. Normal yaklaşımı yaklaşımın iyi işlediği ölçekte uygulayıp sınırları dönüştürmek, OR'nin pozitifliğini korur ve kapsama olasılığını iyileştirir (regression.py:1269–1289).
46.5.4 Olabilirlik oranı testi ve −2LL
- \ell_0: yalnız sabit terimli modelin log-olabilirliği; bu modelde her kişiye aynı olasılık \bar y=n_1/n verilir.
- n_1, n_0: olay ve olay olmayan sayıları.
- p: sabit dışındaki parametre sayısı (burada 4).
Wald ile olabilirlik oranı (LR) arasındaki fark
Wald testi yalnız tam modelin tepe noktasındaki eğriliği kullanır; parametre sınıra uzaksa ya da katsayı büyükse SH şişer ve Wald istatistiği azalır (Hauck–Donner etkisi; Hauck ve Donner 1977). LR testi iki modeli gerçekten kestirip karşılaştırır; yeniden parametrelemeye karşı değişmezdir ve küçük örneklemde daha güvenilirdir. MerQur katsayı tablosunda Wald z ve p verir; "Omnibus + Tip III" kutusu her terim için LR χ²'yi de ekler. Profil olabilirlik GA'sı, LR testinin tersine çevrilmiş hâlidir.
Koddaki tercih: \ell_0 sayısal olarak kestirilir
MerQur model.llnull ve model.llr değerlerini kullanır (regression.py:1319–1323, 1056–1058). statsmodels \ell_0'ı kapalı biçimden değil, yalnız sabitli modeli yeniden yinelemeli kestirerek bulur. Bu veride kapalı biçimle fark 1{,}5\times10^{-8}'dir (-2\ell_0'da 2{,}9\times10^{-8}); raporlanan dört ondalıkta görünmez.
46.5.5 Sözde R² ölçüleri ve bilgi ölçütleri
- R^2_{\text{McF}} (McFadden 1974): log-olabilirlikteki göreli iyileşme.
- R^2_{\text{CS}} (Cox–Snell): doğrusal regresyondaki R^2'nin olabilirlik oranı biçimindeki genellemesi. İkili sonuçta en büyük değeri 1-e^{2\ell_0/n}<1'dir.
- R^2_{\text{N}} (Nagelkerke 1991): Cox–Snell'i bu üst sınıra bölerek 0–1 aralığına taşır.
- k: sabit dahil parametre sayısı.
Neden üç ayrı ölçü?
İkili sonuçta doğrusal regresyondaki R^2'nin tüm özelliklerini (açıklanan varyans oranı, 0–1 aralığı, olabilirlikle ilişki) aynı anda taşıyan tek bir ölçü yoktur. McFadden olabilirlik temellidir ve doğrudan yorumlanır; Cox–Snell doğrusal modeldeki R^2 ile aynı formülden gelir ama 1'e ulaşamaz; Nagelkerke bu kusuru giderir. MerQur'un künyede ve APA satırında kullandığı ölçü McFadden'dır.
46.5.6 Sınıflama tablosu ve AUC
\hat\pi_i\ge c ise "olay" tahmini yapılır (MerQur'da eşitlik olay tarafındadır; regression_extras.py:540–552). c varsayılan 0,5'tir.
- DP: doğru pozitif (olay, olay tahmin edildi); DN: doğru negatif; YP: yanlış pozitif; YN: yanlış negatif.
AUC (ROC eğrisi altındaki alan), kesme değerinden bağımsızdır ve Mann–Whitney istatistiğine eşittir (Hanley ve McNeil 1982):
- R_1: tüm \hat\pi'ler birlikte sıralandığında olay grubundaki sıraların toplamı.
- MerQur
sklearn.metrics.roc_auc_scorekullanır; bağlara yarım puan verir.
46.5.7 Hosmer–Lemeshow uyum iyiliği testi
Gözlemler \hat\pi'ye göre sıralanır ve ondalık dilimlere (g=10) bölünür. Her grupta gözlenen ve beklenen olay ve olay-olmayan sayıları karşılaştırılır:
- O_{1k}, O_{0k}: k. grupta gözlenen olay ve olay-olmayan sayısı.
- E_{1k}: gruptaki tahmin olasılıklarının toplamı (beklenen olay sayısı).
- g-2: Hosmer ve Lemeshow'un (1980) benzetimle bulduğu yaklaşık serbestlik derecesi.
Koddaki tercih: gruplama
Gruplar pandas.qcut(p, q=10, duplicates="drop") ile kurulur (regression.py:1362–1383): kesim noktaları \hat\pi'nin %0, %10, …, %100 yüzdelikleridir (R quantile tür 7 ile aynı doğrusal ara değer), aralıklar sağdan kapalıdır ve en alt sınır dahildir. Bu tanım R ResourceSelection::hoslem.test ile aynıdır. Yinelenen kesim noktaları birleştirilir; o zaman grup sayısı ve sd azalır (\text{sd}=\max(g'-2{,}1)). Aynı olasılıklı gözlemleri bölmeyen, yaklaşık eşit büyüklükte gruplar kuran kurallar da kullanılır; bağlı tahminlerin çok olduğu veride (ör. yalnız kategorik açıklayıcılar) bu kurallarla χ², sd ve p değerleri farklı olabilir. MerQur bu uyarıyı sonuç metninde yazar.
46.5.8 VIF
R_j^2, x_j'nin diğer açıklayıcılar (ve sabit) üzerine ağırlıksız OLS regresyonundan gelir (statsmodels variance_inflation_factor, regression.py:1384–1395). R car::vif(lm(...)) ile aynıdır; car::vif(glm(...)) ise \hat{\mathbf W} ağırlıklı genelleştirilmiş VIF verir ve farklı sayılar üretebilir.
46.5.9 Ayrışma ve Firth düzeltmesi
Tam ayrışma, bir doğrusal birleşimin olayları olay olmayanlardan kusursuz ayırmasıdır; yarı ayrışma eşitliklere izin verir. Bu durumda \ell(\boldsymbol\beta) bir yönde sürekli artar, ML kestirimi sonlu değildir (Albert ve Anderson 1984). MerQur her çalıştırmada şu doğrusal programı çözer (Konis 2007; detect_separation, linlogit_extras.py:619–640):
Amaç değeri sıfırdan büyükse ayrışma vardır; sonuç metnine "Tam/yarı ayrışma (separation) saptandı…" uyarısı eklenir ve OR'si taşan satırlar "—" ile gösterilir (regression.py:1412–1417).
Firth düzeltmesi cezalı log-olabilirliği en büyükler:
Neden Firth?
Ceza terimi Jeffreys önsel dağılımına karşılık gelir; ML kestiricisinin O(n^{-1}) yanlılığını giderir (Firth 1993) ve ayrışmada bile sonlu kestirim verir (Heinze ve Schemper 2002). MerQur'da Firth kestirimi FirthFit sınıfıyla yapılır; nokta kestirimi ve Wald SH'si R logistf(pl = FALSE) ile aynıdır. Firth seçildiğinde Cox–Snell ve Nagelkerke R^2 cezalı log-olabilirliklerden, McFadden, AIC ve BIC cezasız log-olabilirlikten hesaplanır; omnibus ve Tip III LR testleri cezalı log-olabilirlikle yapılır. Sandviç ve küme-sağlam SH Firth ile birlikte uygulanmaz; seçilmişse uyarı verilir.
46.5.10 Profil olabilirlik güven aralığı
\beta_j için profil log-olabilirlik \ell_p(b)=\max_{\boldsymbol\beta_{-j}}\ell(b,\boldsymbol\beta_{-j})'dir. GA sınırları
denkleminin \hat\beta_j'nin iki yanındaki kökleridir (Venzon ve Moolgavkar 1988). MerQur kökleri doğrudan bulur (stats/profile_ci.py, regression.py:219–248). Firth, sandviç SH ya da aşırı yayılım ölçeği seçiliyse profil GA tanımsız sayılır; Wald GA verilir ve bu durum ayar bloğuna yazılır.
46.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/elle_hesap.py ile, MerQur çağrılmadan numpy ile hesaplanmıştır.
Adım 1 — Başlangıç (\boldsymbol\beta^{(0)}=\mathbf 0). Her hastada \pi_i=0{,}5, w_i=0{,}25, z_i=\pm2. Başlangıç log-olabilirliği \ell(\mathbf 0)=300\ln0{,}5, yani -2\ell=415{,}888308. Skor vektörü:
İlk bileşen \sum(y_i-0{,}5)=144-150=-6'dır: olay oranı 0,48 olduğu için sabit terim aşağı çekilecektir.
Bilgi matrisi \mathbf X^{\top}\mathbf W\mathbf X=0{,}25\,\mathbf X^{\top}\mathbf X:
Adım 2 — Birinci IRLS adımı. \boldsymbol\beta^{(1)}=(\mathbf X^{\top}\mathbf X)^{-1}\mathbf X^{\top}(4\mathbf y-2):
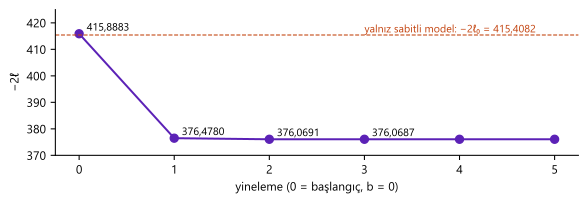
Tek adımda -2\ell, 415,89'dan 376,48'e iner; kalan yinelemeler yalnız 0,41 puanlık iyileşme sağlar. (statsmodels ilk adımda sabit terimi -6{,}683222 bulur; fark, 46.5.2'deki 10^{-10}'luk Hessian düzenlemesindendir.)
Adım 3 — Yakınsama.
| Yineleme | b_0 | b_{\text{age}} | b_{\text{chol}} | b_{\text{smok}} | b_{\text{sbp}} | -2\ell | \max\lvert\Delta b\rvert |
|---|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 | 0 | 415,888308 | |
| 1 | −6,683221 | 0,037022 | 0,007384 | 0,296747 | 0,017403 | 376,478016 | 6,68 |
| 2 | −7,479614 | 0,041176 | 0,008219 | 0,344979 | 0,019631 | 376,069060 | 0,796 |
| 3 | −7,504791 | 0,041305 | 0,008244 | 0,346739 | 0,019703 | 376,068680 | 0,0252 |
| 4 | −7,504817 | 0,041305 | 0,008245 | 0,346740 | 0,019703 | 376,068680 | 2,5·10⁻⁵ |
| 5 | −7,504817 | 0,041305 | 0,008245 | 0,346740 | 0,019703 | 376,068680 | 2,6·10⁻¹¹ |
Beşinci yinelemede en büyük değişim 10^{-8}'in altına iner ve algoritma durur. Değişimin her adımda kabaca karesinin alınması (0,796 → 0,025 → 2,5·10⁻⁵ → 2,6·10⁻¹¹) Newton yönteminin karesel yakınsamasını gösterir. R glm varsayılan ölçütle (sapmanın göreli değişimi <10^{-8}) 4 yinelemede durur; farklı başlangıç ve durma ölçütüne karşın aynı kestirime ulaşır (doğrulamada R ölçütü 10^{-14}'e sıkılaştırılmıştır).
Şekil 46.1. IRLS yinelemelerinde −2ℓ. Kesikli çizgi yalnız sabitli modelin değeri; aradaki fark LR χ²'dir.
Adım 4 — Katsayı tablosu. \hat{\mathbf W} ile (\mathbf X^{\top}\hat{\mathbf W}\mathbf X)^{-1}'in köşegeninden SH; z_{0{,}975}=1{,}959964.
| Terim | b | SH | z | Wald χ² | p | OR | %95 GA (Wald) |
|---|---|---|---|---|---|---|---|
| Sabit | −7,504817 | 1,348458 | −5,565 | 30,975 | 2,61·10⁻⁸ | 0,000550 | [0,000039; 0,007736] |
| age | 0,041305 | 0,010838 | 3,811 | 14,524 | 0,000138 | 1,042170 | [1,020265; 1,064546] |
| cholesterol | 0,008245 | 0,002605 | 3,165 | 10,018 | 0,001551 | 1,008279 | [1,003144; 1,013439] |
| smoking | 0,346740 | 0,267434 | 1,297 | 1,681 | 0,194788 | 1,414450 | [0,837427; 2,389064] |
| systolic_bp | 0,019703 | 0,006240 | 3,158 | 9,970 | 0,001591 | 1,019899 | [1,007501; 1,032449] |
Örnek, age satırı: z=0{,}041305/0{,}010838=3{,}8110; \text{Wald}=3{,}8110^2=14{,}5239; p=2\,[1-\Phi(3{,}8110)]=0{,}000138; \text{OR}=e^{0{,}041305}=1{,}042170; GA: e^{0{,}041305\pm1{,}959964\times0{,}010838}=e^{[0{,}020063;\ 0{,}062548]}=[1{,}020265;\ 1{,}064546].
Adım 5 — Tek bir hastanın olasılığı. 1 numaralı hasta: yaş 62, kolesterol 253, sigara 0, SKB 118.
\hat\pi<0{,}5 olduğundan "olay yok" diye sınıflanır; gerçek değer de 0'dır (doğru negatif).
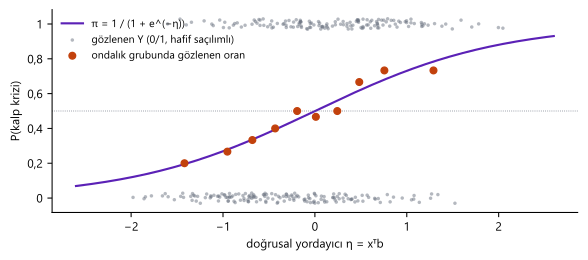
Şekil 46.2. Kestirilen lojistik eğri. Gri noktalar 0/1 sonuçları, turuncu noktalar ondalık gruplarında gözlenen olay oranlarıdır; eğriye yakın olmaları iyi kalibrasyonu gösterir.
Adım 6 — Model testi ve −2LL. n_1=144, n_0=156, \bar y=0{,}48:
Adım 7 — Sözde R² ve bilgi ölçütleri.
Adım 8 — Sınıflama tablosu (kesim 0,5).
| Gözlenen \ Tahmin | 0 | 1 | % doğru |
|---|---|---|---|
| 0 (olay yok, 156) | DN = 108 | YP = 48 | özgüllük = 108/156 = %69,2 |
| 1 (olay, 144) | YN = 58 | DP = 86 | duyarlılık = 86/144 = %59,7 |
| Genel | doğruluk = 194/300 = %64,7 |
PPV = 86/134 = 0,641791; NPV = 108/166 = 0,650602; AUC = 0,703748.
Olay oranı %48 olduğu için "herkese en sık sınıfı ata" kuralı %52 doğruluk verir; model bunu 12,7 puan aşar.
Adım 9 — Hosmer–Lemeshow (10 grup, her grupta 30 hasta).
| Grup | \hat\pi aralığı | O_1 | E_1 | O_0 | E_0 | Katkı |
|---|---|---|---|---|---|---|
| 1 | 0,121–0,246 | 6 | 5,919 | 24 | 24,081 | 0,0014 |
| 2 | 0,249–0,308 | 8 | 8,360 | 22 | 21,640 | 0,0215 |
| 3 | 0,310–0,364 | 10 | 10,089 | 20 | 19,911 | 0,0012 |
| 4 | 0,365–0,423 | 12 | 11,813 | 18 | 18,187 | 0,0049 |
| 5 | 0,423–0,479 | 15 | 13,558 | 15 | 16,442 | 0,2800 |
| 6 | 0,480–0,527 | 14 | 15,079 | 16 | 14,921 | 0,1553 |
| 7 | 0,527–0,590 | 15 | 16,816 | 15 | 13,184 | 0,4464 |
| 8 | 0,595–0,646 | 20 | 18,550 | 10 | 11,450 | 0,2970 |
| 9 | 0,647–0,721 | 22 | 20,405 | 8 | 9,595 | 0,3900 |
| 10 | 0,728–0,886 | 22 | 23,412 | 8 | 6,588 | 0,3877 |
| Toplam | \hat C=1{,}985258 |
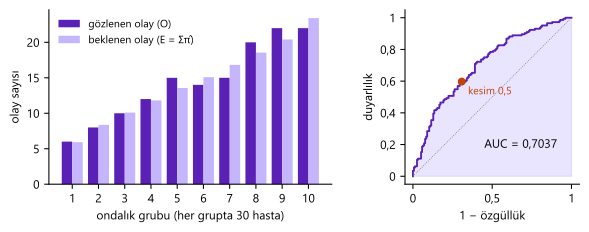
\text{sd}=10-2=8, p=P(\chi^2_8\ge1{,}985258)=0{,}981460. Gözlenen ve beklenen sayılar her grupta yakındır; uyumsuzluk kanıtı yoktur.
Şekil 46.3. Sol: ondalık gruplarında gözlenen ve beklenen olay sayısı (Hosmer–Lemeshow). Sağ: ROC eğrisi ve 0,5 kesim noktası.
Adım 10 — Tip III testleri ve VIF.
| Terim | LR χ² (terim çıkarılınca −2LL artışı) | Wald χ² | VIF |
|---|---|---|---|
| age | 15,2599 | 14,5239 | 1,0147 |
| cholesterol | 10,3444 | 10,0176 | 1,0150 |
| smoking | 1,6888 | 1,6810 | 1,0031 |
| systolic_bp | 10,3373 | 9,9704 | 1,0029 |
Her terimde Wald χ² LR χ²'den biraz küçüktür; Hauck–Donner yönündeki bu fark büyük değildir ve hiçbir kararı değiştirmez. VIF'ler 1'e çok yakındır: açıklayıcılar neredeyse ilişkisizdir.
Adım 11 — Profil olabilirlik ve Firth (karşılaştırma). Profil GA'lar Wald GA'lardan biraz geniştir ve sağa kayıktır; örneğin smoking için OR GA'sı Wald [0,8374; 2,3891], profil [0,8386; 2,3981]. Firth kestirimleri ML'ye yakındır (b_{\text{age}}=0{,}040475; b_{\text{smok}}=0{,}340155), çünkü n=300 ve ayrışma yoktur; Firth'in katsayıları sıfıra doğru çekmesi küçük örneklemde belirginleşir.
46.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundaki katsayı tablosundan ve extras sözlüğünden (sınıflama, omnibus, Tip III) tam hassasiyetle alınmıştır; McFadden ve LR'deki gösterim yuvarlaması doğrulama sırasında devre dışı bırakılmıştır. Yalnız metinde yazılan Cox–Snell, Nagelkerke ve Hosmer–Lemeshow değerleri MerQur'un yazdığı ondalık sayısında karşılaştırılmıştır. R: 4.5.3, glm(family = binomial), confint.default, logLik, DescTools::PseudoR2, pROC::auc, car::Anova(type = 3, test = "LR"), car::vif(lm(...)); Hosmer–Lemeshow, ResourceSelection::hoslem.test tanımı R'de elle yazılarak hesaplanmıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b (sabit) | −7,50481652 | −7,50481652 | −7,50481652 | 1,5e−13 | ✓ |
| SH (sabit) | 1,34845781 | 1,34845781 | 1,34845781 | 2,2e−13 | ✓ |
| Wald z (sabit) | −5,565481 | −5,565481 | −5,565481 | 9,6e−13 | ✓ |
| p (sabit) | 2,6143·10−8 | 2,6143·10−8 | 2,6143·10−8 | 1,4e−19 | ✓ |
| OR (sabit) | 0,00055043 | 0,00055043 | 0,00055043 | 8,2e−17 | ✓ |
| OR %95 GA alt, Wald (sabit) | 3,9164·10−5 | 3,9164·10−5 | 3,9164·10−5 | 1,6e−17 | ✓ |
| OR %95 GA üst, Wald (sabit) | 0,00773587 | 0,00773587 | 0,00773587 | 4,3e−15 | ✓ |
| b (age) | 0,04130548 | 0,04130548 | 0,04130548 | 8,7e−16 | ✓ |
| SH (age) | 0,01083842 | 0,01083842 | 0,01083842 | 9,4e−16 | ✓ |
| Wald z (age) | 3,811022 | 3,811022 | 3,811022 | 3,8e−13 | ✓ |
| p (age) | 0,000138 | 0,000138 | 0,000138 | 2,2e−16 | ✓ |
| OR (age) | 1,04217042 | 1,04217042 | 1,04217042 | 1,8e−15 | ✓ |
| OR %95 GA alt, Wald (age) | 1,02026516 | 1,02026516 | 1,02026516 | 2,7e−15 | ✓ |
| OR %95 GA üst, Wald (age) | 1,06454598 | 1,06454598 | 1,06454598 | 2,0e−15 | ✓ |
| b (cholesterol) | 0,00824452 | 0,00824452 | 0,00824452 | 1,1e−16 | ✓ |
| SH (cholesterol) | 0,00260486 | 0,00260486 | 0,00260486 | 2,1e−16 | ✓ |
| Wald z (cholesterol) | 3,165052 | 3,165052 | 3,165052 | 2,7e−13 | ✓ |
| p (cholesterol) | 0,001551 | 0,001551 | 0,001551 | 1,5e−15 | ✓ |
| OR (cholesterol) | 1,00827860 | 1,00827860 | 1,00827860 | 3,3e−15 | ✓ |
| OR %95 GA alt, Wald (cholesterol) | 1,00314402 | 1,00314402 | 1,00314402 | 2,4e−15 | ✓ |
| OR %95 GA üst, Wald (cholesterol) | 1,01343946 | 1,01343946 | 1,01343946 | 3,1e−15 | ✓ |
| b (smoking) | 0,34674046 | 0,34674046 | 0,34674046 | 2,7e−15 | ✓ |
| SH (smoking) | 0,26743406 | 0,26743406 | 0,26743406 | 1,9e−14 | ✓ |
| Wald z (smoking) | 1,296546 | 1,296546 | 1,296546 | 9,6e−14 | ✓ |
| p (smoking) | 0,194788 | 0,194788 | 0,194788 | 3,3e−14 | ✓ |
| OR (smoking) | 1,41444958 | 1,41444958 | 1,41444958 | 5,8e−15 | ✓ |
| OR %95 GA alt, Wald (smoking) | 0,83742744 | 0,83742744 | 0,83742744 | 3,3e−14 | ✓ |
| OR %95 GA üst, Wald (smoking) | 2,38906383 | 2,38906383 | 2,38906383 | 8,6e−14 | ✓ |
| b (systolic_bp) | 0,01970331 | 0,01970331 | 0,01970331 | 4,7e−16 | ✓ |
| SH (systolic_bp) | 0,00623997 | 0,00623997 | 0,00623997 | 5,6e−16 | ✓ |
| Wald z (systolic_bp) | 3,157596 | 3,157596 | 3,157596 | 3,5e−13 | ✓ |
| p (systolic_bp) | 0,001591 | 0,001591 | 0,001591 | 1,9e−15 | ✓ |
| OR (systolic_bp) | 1,01989870 | 1,01989870 | 1,01989870 | 1,8e−15 | ✓ |
| OR %95 GA alt, Wald (systolic_bp) | 1,00750118 | 1,00750118 | 1,00750118 | 6,7e−16 | ✓ |
| OR %95 GA üst, Wald (systolic_bp) | 1,03244877 | 1,03244877 | 1,03244877 | 4,4e−15 | ✓ |
| -2\ell (model) | 376,068680 | 376,068680 | 376,068680 | 2,8e−13 | ✓ |
| -2\ell_0 (yalnız sabit) | 415,408180 | 415,408180 | 415,408180 | 2,9e−08 | ✓ |
| LR \chi^2 (sd = 4) | 39,339500 | 39,339500 | 39,339500 | 2,9e−08 | ✓ |
| LR p | 5,9275·10−8 | 5,9275·10−8 | 5,9275·10−8 | 3,4e−14 | ✓ |
| McFadden R^2 | 0,094701 | 0,094701 | 0,094701 | 6,4e−11 | ✓ |
| Cox–Snell R^2 | 0,1229 | 0,122898 | 0,122898 | 3,1e−16 | ✓ (4 ondalık) |
| Nagelkerke R^2 | 0,1640 | 0,163951 | 0,163951 | 5,6e−17 | ✓ (4 ondalık) |
| AIC | 386,068680 | 386,068680 | 386,068680 | 2,8e−13 | ✓ |
| BIC | 404,587593 | 404,587593 | 404,587593 | 2,8e−13 | ✓ |
| Doğruluk (kesim 0,5) | 0,646667 | 0,646667 | 0,646667 | 3,3e−16 | ✓ |
| Duyarlılık | 0,597222 | 0,597222 | 0,597222 | 2,2e−16 | ✓ |
| Özgüllük | 0,692308 | 0,692308 | 0,692308 | 3,3e−16 | ✓ |
| AUC | 0,703748 | 0,703748 | 0,703748 | 4,4e−16 | ✓ |
| Hosmer–Lemeshow \chi^2 | 1,985 | 1,985258 | 1,985258 | 1,1e−14 | ✓ (3 ondalık) |
| Hosmer–Lemeshow p | 0,9815 | 0,981460 | 0,981460 | 0,0e+00 | ✓ (4 ondalık) |
| Tip III LR \chi^2 (age) | 15,259919 | 15,259919 | 15,259919 | 4,4e−14 | ✓ |
| Tip III LR \chi^2 (cholesterol) | 10,344379 | 10,344379 | 10,344379 | 5,7e−14 | ✓ |
| Tip III LR \chi^2 (smoking) | 1,688825 | 1,688825 | 1,688825 | 5,8e−14 | ✓ |
| Tip III LR \chi^2 (systolic_bp) | 10,337341 | 10,337341 | 10,337341 | 7,1e−14 | ✓ |
Profil olabilirlik GA'sı için üç kaynak:
| Büyüklük | MerQur | Python (doğrudan kök) | R confint() |
Fark M–P / M–R | Durum |
|---|---|---|---|---|---|
| OR profil GA alt (age) | 1,02057884 | 1,02057884 | 1,02057919 | 2,0e−15 / 3,5e−07 | ✓ |
| OR profil GA üst (age) | 1,06497570 | 1,06497570 | 1,06497643 | 2,2e−16 / 7,4e−07 | ✓ |
| OR profil GA alt (cholesterol) | 1,00320118 | 1,00320118 | 1,00320123 | 4,4e−16 / 5,6e−08 | ✓ |
| OR profil GA üst (cholesterol) | 1,01352091 | 1,01352091 | 1,01352106 | 0,0e+00 / 1,5e−07 | ✓ |
| OR profil GA alt (smoking) | 0,83862818 | 0,83862818 | 0,83862698 | 5,4e−15 / 1,2e−06 | ✓ |
| OR profil GA üst (smoking) | 2,39814723 | 2,39814723 | 2,39817033 | 1,3e−14 / 2,3e−05 | ✓ |
| OR profil GA alt (systolic_bp) | 1,00765360 | 1,00765360 | 1,00765376 | 1,3e−15 / 1,6e−07 | ✓ |
| OR profil GA üst (systolic_bp) | 1,03266305 | 1,03266305 | 1,03266344 | 0,0e+00 / 3,9e−07 | ✓ |
MerQur ile Python'un doğrudan kök bulması 10^{-14} düzeyinde aynıdır. R confint() profili bir ızgarada hesaplayıp ara değer bulduğu için 10^{-7}–10^{-5} düzeyinde farklıdır; en büyük fark smoking üst sınırındadır (2{,}3\times10^{-5}). Burada başvuru değeri R değil, doğrudan köktür. Firth kestirimleri R logistf(pl = FALSE) ile 10^{-9} düzeyinde eşleşir.
46.7 Çıktıyı okuma
Sonuç metni (varsayılan ayarlar, kısaltılmış):
MODEL: İkili Lojistik Regresyon
──────────────────────────────────────────────────
n = 300  |  Hedef: heart_attack
R² (McFadden) = 0.094701
LR χ² = 39.3395  p < 0.0001
AIC = 386.0687  BIC = 404.5876
Olay (Y = 1): 1  ·  referans (Y = 0): 0
── ETKİ BÜYÜKLÜKLERİ ──
    McFadden R² = 0.0947   Cox-Snell R² = 0.1229   Nagelkerke R² = 0.1640
── SINIFLANDIRMA METRİKLERİ (kesim 0.5) ──
Doğruluk = 0.6467  ·  Duyarlılık = 0.5972  ·  Özgüllük = 0.6923  ·  AUC = 0.7037
    Sınıflama tablosu (kesme = 0.5): ...
    PPV = 0.6418  ·  NPV = 0.6506
Tablo sekmesi: Katsayı, Std.Hata, z, (Omnibus açıksa Wald χ²), p, Sig, OR, OR %95 GA alt, OR %95 GA üst.
| Öğe | Nasıl yorumlanır |
|---|---|
| Olay / referans satırı | Katsayıların hangi kategorinin log-odds'unu modellediğini söyler; önce buna bakın. |
| LR χ² ve p | Tüm açıklayıcıların birlikte katkısı. p<\alpha: model, yalnız sabitli modelden anlamlı biçimde iyi. |
| McFadden R^2 | 0,095. OLS R^2 gibi "açıklanan varyans" değildir; 0,2–0,4 aralığı çok iyi uyum sayılır (McFadden 1979). Klinik risk modellerinde 0,1 civarı olağandır. |
| Katsayı (B) | Log-odds değişimi; işaret yönü verir. |
| OR | age 1,042: diğerleri sabitken her ek yaş yılı odds'u %4,2 artırır. 10 yıl için e^{10\times0{,}041305}=1{,}511 (%95 GA [1,222; 1,869]). Kolesterolde 20 mg/dL için 1,179; SKB'de 10 mmHg için 1,218. |
| OR GA'sı | 1'i içermiyorsa etki anlamlıdır. smoking [0,84; 2,39] 1'i içerir: bu veride sigaranın bağımsız etkisi gösterilemedi. |
| Sabitin OR'si | Tüm açıklayıcılar 0 iken odds (yaş 0, kolesterol 0…); klinik anlamı yoktur. |
| Sınıflama | Kesim noktasına bağlıdır; model karşılaştırmasında AUC'yi tercih edin. AUC 0,70: kabul edilebilir ayırt edicilik (Hosmer, Lemeshow ve Sturdivant 2013, 0,7–0,8 aralığı). |
| Hosmer–Lemeshow | p>\alpha ise "karşılanıyor": kalibrasyon bozukluğu kanıtı yok. Uyumun kanıtı değildir. |
| "—" görünen OR | Katsayı taşmış (ayrışma); Firth düzeltmesi önerilir. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Kalp krizi olasılığını yordamak için yaş, total kolesterol, sigara içme ve sistolik kan basıncını içeren ikili lojistik regresyon modeli kuruldu (n = 300; 144 olay). Model, yalnız sabitli modelden anlamlı biçimde daha iyi uyum gösterdi, \chi^2(4, N = 300) = 39{,}34, p < 0{,}001, McFadden R^2 = 0{,}09, Nagelkerke R^2 = 0{,}16. Diğer değişkenler denetlendiğinde yaş (OR = 1,04; %95 GA [1,02; 1,06]; p < 0{,}001), kolesterol (OR = 1,008; %95 GA [1,003; 1,013]; p = 0{,}002) ve sistolik kan basıncı (OR = 1,02; %95 GA [1,01; 1,03]; p = 0{,}002) kalp krizi odds'unu anlamlı biçimde artırırken sigara içmenin etkisi anlamlı değildi (OR = 1,41; %95 GA [0,84; 2,39]; p = 0{,}195). Modelin ayırt ediciliği kabul edilebilir düzeydeydi (AUC = 0,70) ve Hosmer–Lemeshow testi uyumsuzluk göstermedi, \chi^2(8) = 1{,}99, p = 0{,}98.
46.8 Uzman soruları
S1. Hangi algoritmayla kestiriliyor ve neden IRLS ile aynı?
statsmodels Logit.fit() Newton–Raphson kullanır; başlangıç \boldsymbol\beta=\mathbf 0, durma ölçütü \max|\Delta\beta|<10^{-8}, en çok 35 yineleme. Logit kanonik bağlantı olduğu için gözlenen bilgi beklenen bilgiye eşittir; dolayısıyla Newton–Raphson, Fisher skorlaması ve IRLS aynı yinelemeleri üretir. R glm IRLS ile ve farklı bir başlangıçla (\mu=(y+0{,}5)/2) çalışır; içbükey olabilirlikte aynı noktaya varır.
S2. Katsayı tablosu Wald testi veriyor. Neden LR değil?
Wald testi tek modelle hesaplanır ve yazılımlar arası gelenektir. Ancak büyük katsayılarda Hauck–Donner etkisiyle gücünü yitirir. MerQur "Omnibus + Tip III" kutusuyla her terim için LR χ²'yi verir ve profil olabilirlik GA'sı sunar. Bu veride iki test aynı kararı verir (ör. age: Wald 14,52, LR 15,26).
S3. Ayrışma olursa ne olur?
ML kestirimi sonlu değildir; Newton adımları katsayıyı büyütmeye devam eder ve SH çok büyür. MerQur her çalıştırmada Konis'in doğrusal programını çözer; ayrışma varsa uyarı yazar, taşan OR'leri "—" gösterir ve Firth düzeltmesini önerir. Firth seçiliyse aynı denetim "Firth düzeltmeli kestirim kullanıldı" notunu yazar. ML yakınsamaması için ayrı bir uyarı yoktur; bu yüzden ayrışma denetimi önemlidir.
S4. Hosmer–Lemeshow'da grup sayısı neden 10? Sonuç gruplamaya bağlı mı?
Ondalık dilimler, Hosmer ve Lemeshow'un (1980) önerdiği ve benzetimle sd \approx g-2 bulduğu varsayılan tasarımdır. Test gruplamaya duyarlıdır: farklı g ya da bağların farklı işlenmesi farklı p verebilir (Hosmer vd. 1997). MerQur R hoslem.test tanımını kullanır; başka gruplama kuralları farklı p verebilir. Ayrıca test büyük n'de önemsiz sapmaları anlamlı bulur, küçük n'de gücü düşüktür. Kalibrasyon grafiğiyle birlikte okunmalıdır.
S5. McFadden R² 0,095 düşük değil mi?
Doğrusal regresyondaki R^2 ile karşılaştırılmamalıdır. İkili sonuçta bireysel olasılıklar 0 ya da 1'e yaklaşmadıkça log-olabilirlik iyileşmesi sınırlıdır. McFadden'ın kendisi 0,2–0,4 aralığını "çok iyi uyum" saymıştır. Kalp krizi gibi çok etkenli bir sonuçta dört klasik risk etkeniyle 0,1 düzeyi olağandır. Ayırt edicilik için AUC (0,70), kalibrasyon için Hosmer–Lemeshow daha bilgilendiricidir.
S6. Cox–Snell neden 1'e ulaşamıyor?
R^2_{\text{CS}}=1-(L_0/L)^{2/n}'dir; ikili veride kusursuz modelin olabilirliği L=1 olur ve en büyük değer 1-L_0^{2/n}=1-e^{2\ell_0/n} çıkar. Bu veride bu üst sınır 0,7496'dır. Nagelkerke bu sınıra bölerek ölçeği 0–1'e çeker. Firth modelinde MerQur pay ve paydayı aynı (cezalı) tanımla hesaplar.
S7. Olay kategorisini kim belirliyor? 0/1 yerine "Evet/Hayır" olsaydı?
Alan boşsa olay, ikili sonuçların ortak kuralıyla seçilir. 0/1 ya da 1/2 sayısal kodda büyük değer olaydır. "Evet/Hayır", "var/yok", "present/absent" gibi etiketlerde tanınan olumlu düzey (Evet, var, present) olaydır; verinin hangi satırla başladığı ya da dil sonucu değiştirmez. Etiketler tanınmazsa (ör. "A/B") olay, düzey sırasındaki ikinci sınıftır ve "olay kategorisi seçilmedi" uyarısı yazılır; bu durumda katsayıların işareti veri sırasına bağlı kalır. Alfabetik sıra kullanılmaz. Metin kodlu hedeflerde "Olay kategorisi" alanı doldurulmalı ve sonuç metnindeki olay satırı denetlenmelidir.
S8. 0,5 kesim noktası neden? Sınıflama doğruluğu iyi bir ölçüt mü?
0,5, olay oranı %50'ye yakınken doğal seçimdir; bu veride oran %48'dir. Olay nadirse 0,5 duyarlılığı çok düşürür; olay oranına yakın bir kesim seçilebilir. Ancak doğruluk "uygun olmayan" bir puanlama kuralıdır: kesim noktasına bağlıdır ve olasılıkların kalitesini ölçmez. Model karşılaştırmasında AUC, Brier puanı ya da log-olabilirlik tercih edilmelidir.
S9. Profil GA'larında MerQur ile R neden 5. ondalıkta ayrılıyor?
R confint.glm profili bir ızgarada hesaplayıp ara değer bulur; sonuç yaklaşıktır. MerQur profil denkleminin kökünü doğrudan bulur. Python'da bağımsız kök bulma MerQur ile 10^{-14} düzeyinde aynıdır; R'den sapma en çok 2{,}3\times10^{-5}'tir (smoking üst sınırı). Test dosyası: tests/test_v232_profil_ga.py.
S10. VIF neden ağırlıksız tasarım matrisinden? GLM'de VIF böyle mi hesaplanır?
MerQur VIF'i açıklayıcılar arası OLS regresyonundan hesaplar; R car::vif(lm(...)) ile aynıdır. Lojistik modelin bilgi matrisi \mathbf W ile ağırlıklıdır; bu nedenle car::vif(glm(...)) ağırlıklı genelleştirilmiş VIF verir ve sayılar farklı olabilir. Çoklu doğrusal bağıntının teşhisi için iki tanım genellikle aynı sonuca götürür; raporda hangisinin kullanıldığı belirtilmelidir.
46.9 Sık hatalar ve tuzaklar
- OR'yi risk oranı (RR) gibi okumak. OR odds'u karşılaştırır. Olay sık olduğunda (burada %48) OR, RR'den belirgin biçimde büyüktür; "sigara riski %41 artırır" demek yanlıştır.
- Birimi unutmak.
cholesterolOR'si 1,008 küçük görünür; 1 mg/dL içindir. Klinik birimle (20 ya da 40 mg/dL) yeniden ölçeklenmelidir: e^{c\,b}. - Olay kategorisini denetlememek. Tanınmayan metin etiketlerinde olay, düzey sırasındaki ikinci sınıftır ve uyarı yazılır; işaretler beklenenin tersi çıkabilir.
- Logitte doğrusallığı varsaymak. Sürekli bir açıklayıcının etkisi U biçimliyse doğrusal terim etkiyi gizler; Box–Tidwell ya da spline ile denetlenmelidir.
- Az olayla çok değişken. EPV < 10 olduğunda katsayılar yanlı ve GA'lar güvenilmez olur (Peduzzi vd. 1996).
- Hosmer–Lemeshow anlamsızlığını "model doğru" diye okumak. Test düşük güçlüdür ve gruplamaya bağlıdır.
- Adımsal seçimden sonra p değerlerini olduğu gibi raporlamak. Seçim süreci hesaba katılmaz; p'ler iyimserdir.
- Sabit terimin OR'sini yorumlamak. Açıklayıcılar 0'da anlamsızsa sabit de anlamsızdır; yorum gerekiyorsa açıklayıcılar merkezlenmelidir.
46.10 Kaynaklar
- Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1–10. https://doi.org/10.1093/biomet/71.1.1
- Box, G. E. P., & Tidwell, P. W. (1962). Transformation of the independent variables. Technometrics, 4(4), 531–550. https://doi.org/10.1080/00401706.1962.10490038
- Cox, D. R., & Snell, E. J. (1989). Analysis of binary data (2. baskı). Chapman and Hall.
- Firth, D. (1993). Bias reduction of maximum likelihood estimates. Biometrika, 80(1), 27–38. https://doi.org/10.1093/biomet/80.1.27
- Hanley, J. A., & McNeil, B. J. (1982). The meaning and use of the area under a receiver operating characteristic (ROC) curve. Radiology, 143(1), 29–36. https://doi.org/10.1148/radiology.143.1.7063747
- Hauck, W. W., & Donner, A. (1977). Wald's test as applied to hypotheses in logit analysis. Journal of the American Statistical Association, 72(360a), 851–853. https://doi.org/10.1080/01621459.1977.10479969
- Heinze, G., & Schemper, M. (2002). A solution to the problem of separation in logistic regression. Statistics in Medicine, 21(16), 2409–2419. https://doi.org/10.1002/sim.1047
- Hosmer, D. W., Hosmer, T., le Cessie, S., & Lemeshow, S. (1997). A comparison of goodness-of-fit tests for the logistic regression model. Statistics in Medicine, 16(9), 965–980. https://doi.org/10.1002/(SICI)1097-0258(19970515)16:9<965::AID-SIM509>3.0.CO;2-O
- Hosmer, D. W., & Lemeshow, S. (1980). Goodness of fit tests for the multiple logistic regression model. Communications in Statistics – Theory and Methods, 9(10), 1043–1069. https://doi.org/10.1080/03610928008827941
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3. baskı). Wiley. https://doi.org/10.1002/9781118548387
- Konis, K. (2007). Linear programming algorithms for detecting separated data in binary logistic regression models (Doktora tezi). University of Oxford.
- McCullagh, P., & Nelder, J. A. (1989). Generalized linear models (2. baskı). Chapman and Hall. https://doi.org/10.1007/978-1-4899-3242-6
- McFadden, D. (1974). Conditional logit analysis of qualitative choice behavior. P. Zarembka (Ed.), Frontiers in econometrics içinde (ss. 105–142). Academic Press.
- McFadden, D. (1979). Quantitative methods for analysing travel behaviour of individuals: Some recent developments. D. A. Hensher & P. R. Stopher (Ed.), Behavioural travel modelling içinde (ss. 279–318). Croom Helm.
- Nagelkerke, N. J. D. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691–692. https://doi.org/10.1093/biomet/78.3.691
- Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society. Series A (General), 135(3), 370–384. https://doi.org/10.2307/2344614
- Peduzzi, P., Concato, J., Kemper, E., Holford, T. R., & Feinstein, A. R. (1996). A simulation study of the number of events per variable in logistic regression analysis. Journal of Clinical Epidemiology, 49(12), 1373–1379. https://doi.org/10.1016/S0895-4356(96)00236-3
- Venzon, D. J., & Moolgavkar, S. H. (1988). A method for computing profile-likelihood-based confidence intervals. Applied Statistics, 37(1), 87–94. https://doi.org/10.2307/2347496