98. Karmaşık Örneklem Sıralı Lojistik Regresyon
Analiz kimliği: survey_ordinal · Menü adı: Karmaşık Örneklem Sıralı Lojistik Regresyon · Panel: gui/panels/analyses/survey_ordinal.py (ortak form _survey_polytomous_ui.py) · Motor: stats/survey_polytomous.py, run_survey_ordinal (satır 702–778), _fit_ordinal (221–260), _po_test (781–857); tasarım altyapısı stats/survey_design.py
98.1 Ne işe yarar
Bu analiz, karmaşık örneklem tasarımıyla toplanmış veride sıralı bir sonucu (hipertansiyon evresi, Likert maddesi, öz-bildirilen sağlık: kötü < orta < iyi) açıklayıcılarla modeller. Model, Bölüm 51'deki orantılı odds (kümülatif bağlantı) modelidir; kestirim ağırlıklı sözde olabilirlikle, SH Taylor doğrusallaştırmasıyla yapılır. Cevapladığı soru: "Evrende yaşı bir yıl büyük olanların daha yüksek bir evrede olma odds'u kaç kat fazladır?"
- Y_i\in\{1,\dots,J\}: sıralı sonuç (J\ge3); Tıp örneğinde J=4 evre.
- \zeta_k: k. eşik (kesim noktası); ayrı sabit terim yoktur.
- \boldsymbol\beta: tüm eşiklerde ortak eğimler; \mathbf x_i sabit sütunu içermez.
- F: bağlantının ters fonksiyonu; lojistik (varsayılan) F(u)=1/(1+e^{-u}), probit \Phi(u), cloglog 1-e^{-e^u}, loglog e^{-e^{-u}}.
- Lojistikte e^{\beta_j}, her k için P(Y>k) odds'unun oranıdır (orantılı odds).
Neden eksi işaret ve neden R svyolr tanımı?
\zeta_k-\mathbf x^{\top}\boldsymbol\beta yazımında \beta_j>0, x_j arttıkça P(Y\le k)'nın azalması, yani yanıtın üst kategorilere kayması demektir. Sezgiye uygun yön budur ve R MASS::polr / survey::svyolr ile Bölüm 51'in tanımıdır. Bazı yazılımlar modeli P(Y\le k)=F(\alpha_k+\mathbf x^{\top}\boldsymbol\gamma) biçiminde yazar: eşikler aynı, eğimler ters işaretlidir (\boldsymbol\gamma=-\boldsymbol\beta). MerQur bu dönüşümü sonuç notlarında yazar (v240b_note_ord_sas).
Ne zaman kullanılır? Sonuç üç ya da daha çok sıralı kategoriden oluşuyor, veri ağırlıklı, tabakalı ya da kümeli bir örneklemden geliyor ve amaç evren düzeyinde tek bir "yukarı kayma" etkisidir.
Ne zaman kullanılmaz?
- Basit rastgele örneklem: Sıralı Lojistik Regresyon (Bölüm 51); LR tabanlı paralel çizgiler testi ve kısmi orantılı odds modeli orada.
- İki kategori: Ağırlıklı Lojistik Regresyon (Karmaşık Örneklem) (Bölüm 97). Bu modül J<3'te hata verir.
- Kategoriler sırasızsa ya da orantılı odds testi açıkça reddediyorsa: Karmaşık Örneklem Çok Terimli Lojistik Regresyon (Bölüm 99).
- Sonuç sürekli ve aralık ölçekliyse: Ağırlıklı Doğrusal Regresyon (Bölüm 96).
Sık karıştırılan analizler. Sıralı sonucu sayısal kodlayıp Bölüm 96 ile modellemek, kategoriler arası uzaklıkları eşit varsayar. Bölüm 51'in frekans ağırlığı örnekleme ağırlığı değildir. Çok terimli model sırayı kullanmaz ve J-1 katsayı vektörü kestirir.
98.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Sıralı sonuç, en az 3 düzey | Düzeylerin anlamlı bir sırası var. | J<3 ya da J>25 hata (survey_polytomous.py:640–653); sıra kullanıcıdan alınabilir. |
| Orantılı odds | Eğimler tüm kesimlerde aynı. | Tasarım tabanlı Brant türü Wald testi (varsayılan açık). |
| Tasarım bilgisi doğru | Ağırlık, tabaka, PSU, FPC. | Negatif ağırlık hata; tek PSU'lu tabakada uyarı. |
| Ayrışma yok | Bir kategori bir açıklayıcıyla kusursuz ayrılmamalı. | Sezgisel ölçüt: |\theta|>15 ya da SH >10^3 (98.5.6; bu ölçütün sorunu 98.8 S6). |
| Yeterli PSU | t(\nu-p) yaklaşımının geçerliliği. | Denetlenmez; sd çıktıda yazılır. |
Eksik değer. Varsayılan kural Tasarımda tut (sıfır katkı)'dır (R svyolr'in design[-na, ] davranışı); "Tasarımdan çıkar" da seçilebilir (survey_polytomous.py:450–465). Lojistik panelin varsayılanı tersidir (Bölüm 97.2). Tasarım sütunlarında (ağırlık, tabaka, küme, FPC) eksik olan satır her iki kuralda çıkar ve not yazılır.
Uç durumlar. Pozitif ağırlıklı gözlemi olmayan bir Y düzeyi hata verir (_check_y, :640–653). Etkin gözlemlerde sabit ya da doğrusal bağımlı açıklayıcı sütunu R gibi "NA" katsayıyla düşürülür (:531–547). Kullanıcı sırasında olmayan bir veri düzeyi hata, veride olmayan bir sıra düzeyi "İstenen ve uygulanan ayarlar"a not verir (:362–409). Yakınsama olmazsa uyarı yazılır.
98.3 Parametreler
Tasarım satırları (Ağırlık, Tabaka, Küme / PSU, FPC), Güven Düzeyi, Referans düzeyleri, Etkileşim terimleri, Alt-popülasyon ve Tek PSU'lu tabaka Bölüm 96.3'teki gibidir. Bu panelde replikasyon varyansı ve tabaka sabit etkisi yoktur. Kalan satırlar (survey_ordinal.py:49–112, _survey_polytomous_ui.py:71–140):
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken (Y, sıralı) | ilk sütun | Sıralı sonuç. | — |
| Düzey sırası (düşükten yükseğe) | boş | düşük < orta < yüksek (<, ; ya da , ile). |
Boşsa sıralı yanıt kuralı: Veri sekmesinde tanımlı sıra, sayısal ya da sayı içeren etiketlerde sayısal sıra, tanınan sıralı sözcük dizileri (düşük < orta < yüksek, mild < moderate < severe, Likert katılım dizileri …); hiçbiri yoksa analiz yapılmaz; kullanılan sıra ve kaynağı raporda yazılır. Ters sıra tüm işaretleri çevirir. |
| Bağlantı fonksiyonu | Lojistik (logit) | logit, probit, cloglog, loglog. | Tüm katsayılar; OR yalnız logitte. |
| Bilgi matrisi | Gözlenen (Hessian) | Sandviçteki ekmek: gözlenen ya da beklenen (Fisher). | Yalnız SH (logitte farklı; nokta kestirimi aynı). |
| Orantılı odds testi | açık | Tasarım tabanlı Brant türü Wald testi. | Ek bölüm. |
| Eksik değerli gözlemler | Tasarımda tut (sıfır katkı) | 98.2. | Yalnız SH (eksik varsa). |
| Test dağılımı | t (tasarım df) | t(\nu-p) ya da normal (z). | p ve GA; z'de Wald p değeri \chi^2_q'dan. |
Bilgi matrisi seçimi neden SH'yi değiştiriyor?
Sıralı modelde logit kanonik bağlantı değildir: kümülatif olasılıkların farkı modellendiği için gözlenen Hessian ile beklenen bilgi kestirim noktasında bile eşit değildir. R svyolr gözlenen (sayısal) Hessian'ı kullanır; Fisher puanlaması ise beklenen bilgiyi kullanır. İkisi de tutarlıdır; sonlu örneklemde SH'ler biraz ayrışır. Tıp örneğinde BMI SH'si 0,033351 (gözlenen) ve 0,033719 (beklenen), fark %1,1'dir.
98.4 Tıp örneği
Tıp setinde karmaşık örneklemli sıralı sonuç içeren bir dosya yoktur. Bu nedenle Tıp #81'in tasarımı kullanılmış ve sıralı yanıt sistolik kan basıncından türetilmiştir.
Dosya: english/datasets/Tip/81_survey_reg_bp.xlsx (Bölüm 96.4). Türetilen değişken, ESC/ESH 2018 kılavuzunun sistolik evre sınırlarıyla (Williams vd. 2018):
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
ht_grade |
Bağımlı | sıralı 0–3 | 49 / 139 / 115 / 17 kişi; ağırlıklı 51,15 / 143,70 / 119,50 / 18,15 |
age |
Açıklayıcı | sürekli (yıl) | ort. 49,48; 20–79 |
BMI |
Açıklayıcı | sürekli (kg/m²) | ort. 27,33; 18,00–37,61 |
weight |
Ağırlık | sayısal | Marmara 1,20; rural 0,85; urban 1,10 |
region |
Tabaka | metin | 3 tabaka; küme yok |
n ve eksik değer: 320 hasta, eksik yok; \nu=317, eğim sayısı p=2, test sd'si \nu-p=315.
Klinik soru: Evrende yaş ve BMI hipertansiyon evresiyle nasıl ilişkilidir; bu ilişki evre sınırlarına göre değişiyor mu (orantılı odds)?
Seçilen ayarlar: Arayüz varsayılanları (logit, gözlenen bilgi, t, PO testi açık). Karşılaştırma: beklenen bilgi, probit, z, %99 GA ve merkezlenmiş açıklayıcılar (age − 49,475, BMI − 27,3283).
98.5 Formüller ve hesap adımları
Hesap sırası: veri ve tasarım hazırlığı (_prepare, Bölüm 96 ile aynı kurallar) → Y düzeyleri ve sıra → ağırlıklı Newton ile (\boldsymbol\beta,\boldsymbol\zeta) → birim skorlar ve Hessian → Taylor sandviç → t(\nu-p) testleri → Wald F ve ayarlı F → sözde R^2 → orantılı odds testi.
98.5.1 Ağırlıklı sözde olabilirlik
- \boldsymbol\theta=(\boldsymbol\beta,\boldsymbol\zeta): p eğim ve q=J-1 eşik.
- \pi_i: i. kişinin gözlenen kategorisinin olasılığı; \zeta_0=-\infty, \zeta_J=+\infty.
- a_i, b_i: kategorinin üst ve alt sınırının doğrusal yordayıcıdan uzaklığı.
Koddaki tercih: üst kuyrukta 1-F farkı
pr = np.where(a + b > 0, S(b) - S(a), F(a) - F(b)) (survey_polytomous.py:164); S=1-F her bağlantı için kapalı biçimde (expit(−x), ndtr(−x), expm1) yazılmıştır. a ve b büyük pozitifken F(a)-F(b) iki sayının 1'e yakın farkıdır ve double'da sıfıra çöker; S(b)-S(a) ise küçük sayılar arasında hesaplanır.
98.5.2 Skor ve gözlenen Hessian
- f=F', f'=F'': bağlantının yoğunluğu ve türevi.
- \mathbf d_{a,i}=\partial a_i/\partial\boldsymbol\theta: eğim kısmında -\mathbf x_i, \zeta_{y_i} konumunda 1 (üst kategoride yok). \mathbf d_{b,i} benzer biçimde \zeta_{y_i-1} konumunda 1.
- -\mathbf H: gözlenen bilgi (
_ord_eval,:187–194). Beklenen bilgi \mathbf Q=\sum_iw_i\sum_j(\partial\pi_{ij}/\partial\boldsymbol\theta)(\partial\pi_{ij}/\partial\boldsymbol\theta)^{\top}/\pi_{ij} (_ord_expected_info,:197–218).
98.5.3 Kararlı logit türevi
Lojistik bağlantıda f'(x)=e(1-e)(1-2e), e=\operatorname{expit}(x). Bu ifade doğrudan yazılırsa x\gtrsim37 olduğunda double'da e=1 olur, (1-e)=0 çıkar ve f'(x) tam sıfır hesaplanır. Doğrusu -e^{-x} düzeyinde küçük ama sıfırdan farklı bir sayıdır. Kod bu yüzden (1-e) yerine \operatorname{expit}(-x) kullanır (survey_polytomous.py:101–108):
- \operatorname{expit}(-x)=1/(1+e^{x}): 1-e'nin kayıpsız yazımı; x=38'de 3{,}14\cdot10^{-17} verir, 1-e ise 0.
- Ilımlı x'te iki biçim 10^{-9} içinde aynıdır; fark yalnız uç doğrusal yordayıcılarda sonucu değiştirir.
Bu küçük sayı neden SH'yi beş kat değiştirebilir?
Hessian'da f' tek başına değil, f'(b)/\pi oranı olarak geçer. Üst kategorideki bir gözlemde a=+\infty ve b büyük pozitifken \pi=S(b)\approx e^{-b}, f(b)\approx e^{-b}, f'(b)\approx-e^{-b} olur. Doğru değerler g_b=-1, g_{bb}=-f'(b)/\pi-g_b^2=1-1=0'dır. Kararsız formülde f'(b)=0 hesaplanınca g_{bb}=-1 çıkar: her böyle gözlem Hessian'a sahte bir -w_i\,\mathbf d_b\mathbf d_b^{\top} katkısı ekler, bilgi şişer, \mathbf H^{-1} ve sandviç SH'si küçülür. Bir örnek müşteri verisinde (n=194, Usage 986'ya kadar, |b| en çok 42,6) Usage SH'si kararsız formülle 0,0034687, kararlı formülle 0,0190786'dır; bağımsız Python ikisini de yeniden üretir (98.6.1). Bu veride R svyolr "infinite or missing values in 'x'" hatasıyla durur.
98.5.4 Kestirim: Newton ve adım yarılama
- Başlangıç: \boldsymbol\beta^{(0)}=\mathbf 0, \zeta_k^{(0)}=F^{-1}\!\big(\sum_{y_i\le k}w_i/\sum w_i\big): ağırlıklı kümülatif oranların bağlantı ölçeğindeki değeri (
:224–227). - \lambda: adım, eşik sırası korunuyor ve \ell_w azalmıyorsa kabul edilir; en çok 60 yarılama.
- Durma: \max_j|\Delta\theta_j|/(1+|\theta_j|)<10^{-10}; en çok 200 yineleme. Yakınsamazsa uyarı.
- Beklenen bilgi seçilse de kestirim gözlenen Hessian'la yapılır; yalnız sandviçin ekmeği değişir (
:258–260).
98.5.5 Taylor sandviç, testler ve sd
- \mathbf G: skor katkılarının tabakalı PSU toplamlarından et matrisi (Bölüm 93.5.3, 96.5.2);
_sandwich,:563–568; \mathbf B^{-1} içinpinv. - \nu-p: p yalnız eğim sayısıdır; eşikler sayılmaz (R
svyolrdf.residual). İkili lojistikteki \nu+1-k ile aynı mantık: k=p+1 alınırsa \nu+1-k=\nu-p. - "Normal (z)" seçilirse p değerleri ve GA standart normalden, Wald p değerleri \chi^2_q'dan hesaplanır; ayarlı F yine \nu ile.
- Eşikler için de t, p ve GA verilir; OR verilmez.
Koddaki tercih: z seçeneğinde Wald p
scipy.stats.f.sf(x, q, inf) NaN döndürür; bu yüzden payda sd'si sonsuzsa p=P(\chi^2_q\ge W) kullanılır (_wald_from_W, :585–604). Tıp örneğinde model geneli p=1{,}34\cdot10^{-31} (z) ve 3{,}31\cdot10^{-26} (t(315)).
98.5.6 Sözde R^2 ve ayrışma ölçütü
- \ell_{w,0}: yalnız eşikli modelin log-olabilirliği; kapalı biçimdedir (
_null_loglik,:630–637). - Log-olabilirlik ham ağırlıkla hesaplanır; R
svyolrağırlıkları ortalama 1'e ölçekler ve \ell'yi ortalama ağırlığa bölünmüş verir.
Ayrışma, ikili lojistikteki Konis doğrusal programının (Bölüm 46.5.9) yığılmış biçimiyle denetlenir (_ordinal_separation). Her gözlem i ve kesim k için z_{ik}=1(y_i>k) yazılır; sonlu ML çözümü yoktur ancak ve ancak
- Ölçüt açıklayıcıların konumuna ve ölçeğine bağlı değildir: büyük eşikler (merkezlenmemiş yaş ve BMI'da \hat\zeta_3=17{,}63) ayrışma sayılmaz.
- Ayrışma varsa uyarı, ayrışmayı taşıyan eğim sütunlarını adlandırır.
98.5.7 Orantılı odds testi (tasarım tabanlı Brant türü)
Her kesim k=1,\dots,q için ayrı ikili model kurulur ve eğimlerin eşitliği sınanır (Brant 1990'ın tasarım tabanlı Wald biçimi):
- \hat{\mathbf b}=(\hat{\boldsymbol\beta}_1,\dots,\hat{\boldsymbol\beta}_q): yığılmış eğimler; \widehat{\mathbf V}_b yığın kovaryansın eğim bloğu.
- \mathbf G_{\text{yığın}}: q modelin skorları yan yana konarak tek bir Taylor et matrisi; böylece modeller arası kovaryans (aynı kişiler) hesaba girer.
- \mathbf C: \boldsymbol\beta_k-\boldsymbol\beta_1 (k=2,\dots,q) farklarını seçen matris; genel test sd'si (q-1)p, terim testi (q-1)\times terimin sütun sayısı.
- F=W/\text{sd}_1\sim F(\text{sd}_1,\ \nu-p) ve ayarlı F (98.5.5).
Koddaki tercih: kesim modelinde ayrışma ölçütü
Kesim modellerinden biri ayrışırsa sonlu ML çözümü yoktur ve Wald istatistiği anlamsız sayılar verebilir (W<0 ya da \approx10^8). Kararlı logit türeviyle (98.5.3) Newton ayrışan modelde de "yakınsadı" bayrağıyla dönebildiği için yakınsama denetimi yetmez. Bu yüzden her ikili kesim modeline (sabit + eğimler) Konis doğrusal programı uygulanır; ayrışma varsa ya da W sonlu ve negatif olmayan bir sayı değilse test verilmez: "Test uygulanamadı: kesim noktası ikili modellerinden birinde ayrışma var" (_po_test). Ölçüt konumdan bağımsız olduğundan kesim modelinin sabitinin büyüklüğü testi engellemez.
Neden LR değil Wald tabanlı test?
Bölüm 51 paralel çizgiler testini iki modelin olabilirlik oranıyla yapar. Sözde olabilirlikte LR istatistiği \chi^2 dağılmaz (Bölüm 97.8 S1). Wald testi yalnız kesim modellerinin eğimlerini ve bunların tasarım tabanlı ortak kovaryansını gerektirir.
98.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/survey_ordinal/elle_hesap.py ile, MerQur çağrılmadan numpy ile hesaplanmıştır (gradyan ve Hessian bağımsız olarak yeniden türetilmiştir).
Adım 1 — Başlangıç değerleri. Ağırlıklı kümülatif oranlar 51{,}15/332{,}5=0{,}153835; 194{,}85/332{,}5=0{,}586015; 314{,}35/332{,}5=0{,}945414. Logit ölçeğinde \boldsymbol\zeta^{(0)}=(-1{,}704837;\ 0{,}347516;\ 2{,}851836); \boldsymbol\beta^{(0)}=\mathbf 0. Bu noktada \ell_w=\ell_{w,0}=-391{,}364991.
Adım 2 — Newton yinelemeleri (hepsinde \lambda=1):
| Yineleme | \beta_{\text{age}} | \beta_{\text{BMI}} | \zeta_{0\mid1} | \zeta_{1\mid2} | \zeta_{2\mid3} | \ell_w |
|---|---|---|---|---|---|---|
| 0 | 0 | 0 | −1,704837 | 0,347516 | 2,851836 | −391,364991 |
| 1 | 0,067217 | 0,279961 | 8,862425 | 11,420812 | 14,375805 | −286,751022 |
| 2 | 0,078890 | 0,314966 | 9,878933 | 13,062457 | 16,595783 | −278,168165 |
| 3 | 0,083565 | 0,332376 | 10,410270 | 13,813269 | 17,540456 | −277,610956 |
| 4 | 0,083994 | 0,334073 | 10,462213 | 13,884967 | 17,628787 | −277,607384 |
| 5 | 0,083997 | 0,334085 | 10,462591 | 13,885487 | 17,629419 | −277,607384 |
Göreli değişim 5. yinelemede 3{,}5\cdot10^{-5}, 6.'da 1{,}7\cdot10^{-9}, 7.'de 6\cdot10^{-16}'dır; Newton'un karesel yakınsaması görülür.
Adım 3 — Tek bir hastanın olasılıkları. 1 numaralı hasta: age 67, BMI 26,17, SKB 182 (evre 3).
Kategori olasılıkları farklardır: 0,019681 / 0,361312 / 0,581988 / 0,037019. Gözlenen kategori 3 olduğu için \pi_1=1-0{,}962981=0{,}037019 ve \ln\pi_1=-3{,}296; katkısı w_1\ln\pi_1=1{,}1\times(-3{,}296).
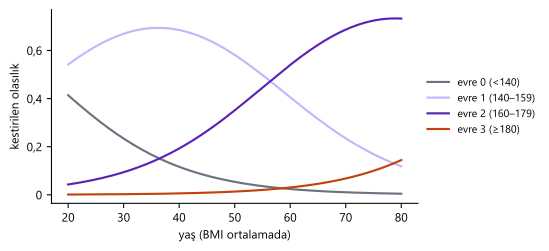
Şekil 98.1. Ortalama BMI'de (27,33) yaşa göre kestirilen evre olasılıkları.
Adım 4 — Ekmek ve et (eğim bloğu). Gözlenen bilgi ve Taylor et matrisinin (\beta_{\text{age}},\beta_{\text{BMI}}) bloğu:
\mathbf G'nin -\mathbf H'den büyük olması, Bernoulli/kategorik model varyansının veriye göre biraz dar kaldığını gösterir; sandviç SH model SH'sinden büyüktür.
Adım 5 — Katsayı tablosu. t_{0{,}975;\,315}=1{,}967524.
| Terim | Kestirim | SH | t | p | %95 GA | OR [%95 GA] |
|---|---|---|---|---|---|---|
| age | 0,083997 | 0,008266 | 10,162 | 3,61·10⁻²¹ | [0,067734; 0,100260] | 1,087626 [1,070081; 1,105459] |
| BMI | 0,334085 | 0,033351 | 10,017 | 1,10·10⁻²⁰ | [0,268467; 0,399703] | 1,396662 [1,307957; 1,491382] |
| \zeta_{0\mid1} | 10,462591 | 1,030706 | 10,151 | 3,93·10⁻²¹ | [8,434654; 12,490529] | — |
| \zeta_{1\mid2} | 13,885487 | 1,187492 | 11,693 | 1,78·10⁻²⁶ | [11,549068; 16,221906] | — |
| \zeta_{2\mid3} | 17,629419 | 1,330999 | 13,245 | 3,89·10⁻³² | [15,010648; 20,248190] | — |
Adım 6 — Wald testleri ve R^2. Model geneli W=142{,}1824; F=71{,}0912 (F(2,\,315), p=3{,}31\cdot10^{-26}); ayarlı F=\frac{316}{634}\times142{,}1824=70{,}8669 (F(2,\,316)). R^2_{\text{McF}}=1-(-277{,}6074)/(-391{,}3650)=0{,}290669.
Adım 7 — Seçeneklerin etkisi.
| Çalıştırma | \beta_{\text{age}} | SH | \beta_{\text{BMI}} | SH |
|---|---|---|---|---|
| Logit, gözlenen bilgi (varsayılan) | 0,083997 | 0,008266 | 0,334085 | 0,033351 |
| Logit, beklenen bilgi | 0,083997 | 0,008243 | 0,334085 | 0,033719 |
| Probit | 0,047210 | 0,004588 | 0,186649 | 0,018572 |
| Logit, merkezlenmiş açıklayıcılar | 0,083997 | 0,008266 | 0,334085 | 0,033351 |
Probit katsayılarının logit katsayılarına oranı yaklaşık 0,56'dır (lojistik dağılımın SS'si \pi/\sqrt3=1{,}81 olduğundan beklenen oran 1/1{,}81\approx0{,}55); probit \ell_w=-277{,}8022, logitten biraz düşük. Merkezlenmiş modelde eşikler -2{,}8232, 0{,}5997, 4{,}3437 olur; eğimler ve SH'leri değişmez.
Adım 8 — Orantılı odds testi ve ayrışma ölçütü. Merkezlenmemiş veride üç kesim modelinin ikili lojistik kestirimleri (sabit, age, BMI; P(Y>k) yönünde):
| Kesim | sabit | \beta_{\text{age}} | \beta_{\text{BMI}} |
|---|---|---|---|
| Y>0 | −9,5620 | 0,068685 | 0,321267 |
| Y>1 | −14,2517 | 0,087860 | 0,338621 |
| Y>2 | −20,0612 | 0,113693 | 0,348950 |
Üçüncü kesim modelinin sabiti büyüktür (−20,06), ama ayrışma yoktur: doğrusal program ayrışma yönü bulmaz, kesim modellerinin model tabanlı SH'leri 0,01–3,8 aralığındadır ve R svyglm aynı sonlu kestirimleri bulur. Test merkezlenmemiş ve merkezlenmiş açıklayıcılarla aynı sonucu verir; bağımsız Python ve R de aynı sayıları bulur:
| Test | W | sd | F | p | Ayarlı F | p |
|---|---|---|---|---|---|---|
| Genel | 3,3738 | 4 | 0,8434 | 0,4985 | 0,8355 | 0,5034 |
| age | 3,2801 | 2 | 1,6400 | 0,1956 | 1,6349 | 0,1966 |
| BMI | 0,1077 | 2 | 0,0538 | 0,9476 | 0,0537 | 0,9477 |
Yaş eğimi kesimlere göre 0,069'dan 0,114'e artıyor gibi görünse de fark anlamlı değildir; orantılı odds varsayımı bu veride reddedilmez.
98.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan (rows, wald_model, po_test, loglik) tam hassasiyetle alınmıştır. R: 4.5.3, survey 4.5; svyolr(control = list(reltol = 1e-16, ndeps = 1e-5)), regTermTest; PO testi R'de her kesim için svyglm(quasibinomial, influence = TRUE) etki fonksiyonları ve svyrecvar ile kurulmuştur. R svyolr Hessian'ı sayısal türevle hesapladığı için SH'ler 10^{-8} düzeyinde göreli farkla eşleşir; bu fark t\approx10–13 olan p değerlerinde t^2 katına büyür. Bu yüzden ✱ işaretli üç çok küçük p değerinde R için göreli 10^{-5} tolerans kullanılmıştır; MerQur ile Python bu satırlarda da 10^{-6} ölçütüyle aynıdır. Beklenen bilgi ve z seçeneklerinin R karşılığı yoktur; yalnız Python ile karşılaştırılmıştır. R log-olabilirliği ortalama ağırlıkla (1,0390625) çarpılarak ham ölçeğe getirilmiştir.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Kestirim age | 0,083997 | 0,083997 | 0,083997 | 2,2e−10 | ✓ |
| SH age | 0,008266 | 0,008266 | 0,008266 | 1,4e−10 | ✓ |
| p age ✱ | 3,6060·10−21 | 3,6060·10−21 | 3,6060·10−21 | 4,0e−27 | ✓ |
| GA alt age | 0,067734 | 0,067734 | 0,067734 | 5,3e−11 | ✓ |
| GA üst age | 0,100260 | 0,100260 | 0,100260 | 4,9e−10 | ✓ |
| Kestirim BMI | 0,334085 | 0,334085 | 0,334085 | 4,0e−10 | ✓ |
| SH BMI | 0,033351 | 0,033351 | 0,033351 | 1,8e−10 | ✓ |
| p BMI | 1,0988·10−20 | 1,0988·10−20 | 1,0988·10−20 | 3,4e−27 | ✓ |
| GA alt BMI | 0,268467 | 0,268467 | 0,268467 | 5,0e−11 | ✓ |
| GA üst BMI | 0,399703 | 0,399703 | 0,399703 | 7,4e−10 | ✓ |
| Kestirim \zeta_{0\mid 1} | 10,462591 | 10,462591 | 10,462591 | 8,4e−09 | ✓ |
| SH \zeta_{0\mid 1} | 1,030706 | 1,030706 | 1,030706 | 6,3e−09 | ✓ |
| p \zeta_{0\mid 1} | 3,9303·10−21 | 3,9303·10−21 | 3,9303·10−21 | 1,6e−27 | ✓ |
| GA alt \zeta_{0\mid 1} | 8,434654 | 8,434654 | 8,434654 | 3,9e−09 | ✓ |
| GA üst \zeta_{0\mid 1} | 12,490529 | 12,490529 | 12,490529 | 2,1e−08 | ✓ |
| Kestirim \zeta_{1\mid 2} | 13,885487 | 13,885487 | 13,885487 | 9,5e−09 | ✓ |
| SH \zeta_{1\mid 2} | 1,187492 | 1,187492 | 1,187492 | 7,3e−09 | ✓ |
| p \zeta_{1\mid 2} | 1,7762·10−26 | 1,7762·10−26 | 1,7762·10−26 | 9,3e−33 | ✓ |
| GA alt \zeta_{1\mid 2} | 11,549068 | 11,549068 | 11,549068 | 4,9e−09 | ✓ |
| GA üst \zeta_{1\mid 2} | 16,221906 | 16,221906 | 16,221906 | 2,4e−08 | ✓ |
| Kestirim \zeta_{2\mid 3} | 17,629419 | 17,629419 | 17,629419 | 1,0e−08 | ✓ |
| SH \zeta_{2\mid 3} | 1,330999 | 1,330999 | 1,330999 | 1,5e−08 | ✓ |
| p \zeta_{2\mid 3} ✱ | 3,8933·10−32 | 3,8933·10−32 | 3,8934·10−32 | 4,6e−38 | ✓ |
| GA alt \zeta_{2\mid 3} | 15,010648 | 15,010648 | 15,010648 | 1,9e−08 | ✓ |
| GA üst \zeta_{2\mid 3} | 20,248190 | 20,248190 | 20,248190 | 3,9e−08 | ✓ |
| OR age | 1,087626 | 1,087626 | — | 0,0e+00 | ✓ |
| OR GA alt age | 1,070081 | 1,070081 | — | 2,2e−16 | ✓ |
| OR GA üst age | 1,105459 | 1,105459 | — | 2,2e−16 | ✓ |
| OR BMI | 1,396662 | 1,396662 | — | 0,0e+00 | ✓ |
| OR GA alt BMI | 1,307957 | 1,307957 | — | 0,0e+00 | ✓ |
| OR GA üst BMI | 1,491382 | 1,491382 | — | 0,0e+00 | ✓ |
| Model Wald F | 71,091206 | 71,091206 | 71,091204 | 1,6e−06 | ✓ |
| Model Wald p ✱ | 3,3099·10−26 | 3,3099·10−26 | 3,3099·10−26 | 3,6e−32 | ✓ |
| Model ayarlı F | 70,866943 | 70,866943 | — | 3,2e−12 | ✓ |
| \ell (ham ağırlık) | −277,607384 | −277,607384 | −277,607384 | 4,5e−13 | ✓ |
| \ell_0 | −391,364991 | −391,364991 | — | 0,0e+00 | ✓ |
| McFadden R^2 | 0,290669 | 0,290669 | — | 0,0e+00 | ✓ |
| Test sd \nu-p | 315 | 315 | 315 | 0,0e+00 | ✓ |
Ek çalıştırmalar ve kararlı logit türevinin müşteri verisinde sınanması:
Beklenen (Fisher) bilgi (R karşılığı yok; Python)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Kestirim age | 0,083997 | 0,083997 | — | 0,0e+00 | ✓ |
| SH age | 0,008243 | 0,008243 | — | 1,3e−16 | ✓ |
| Kestirim BMI | 0,334085 | 0,334085 | — | 0,0e+00 | ✓ |
| SH BMI | 0,033719 | 0,033719 | — | 1,0e−15 | ✓ |
| Kestirim \zeta_{0\mid 1} | 10,462591 | 10,462591 | — | 0,0e+00 | ✓ |
| SH \zeta_{0\mid 1} | 1,028357 | 1,028357 | — | 3,1e−14 | ✓ |
| Kestirim \zeta_{1\mid 2} | 13,885487 | 13,885487 | — | 0,0e+00 | ✓ |
| SH \zeta_{1\mid 2} | 1,188364 | 1,188364 | — | 3,4e−14 | ✓ |
| Kestirim \zeta_{2\mid 3} | 17,629419 | 17,629419 | — | 3,6e−15 | ✓ |
| SH \zeta_{2\mid 3} | 1,323525 | 1,323525 | — | 5,0e−14 | ✓ |
Probit bağlantı
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Kestirim age | 0,047210 | 0,047210 | 0,047210 | 1,1e−10 | ✓ |
| SH age | 0,004588 | 0,004588 | 0,004588 | 6,1e−11 | ✓ |
| Kestirim BMI | 0,186649 | 0,186649 | 0,186649 | 7,0e−11 | ✓ |
| SH BMI | 0,018572 | 0,018572 | 0,018572 | 1,3e−10 | ✓ |
| Kestirim \zeta_{0\mid 1} | 5,862735 | 5,862735 | 5,862735 | 5,1e−12 | ✓ |
| SH \zeta_{0\mid 1} | 0,574645 | 0,574645 | 0,574645 | 3,4e−09 | ✓ |
| Kestirim \zeta_{1\mid 2} | 7,780207 | 7,780207 | 7,780207 | 1,4e−12 | ✓ |
| SH \zeta_{1\mid 2} | 0,654245 | 0,654245 | 0,654245 | 6,5e−09 | ✓ |
| Kestirim \zeta_{2\mid 3} | 9,900822 | 9,900822 | 9,900822 | 3,6e−12 | ✓ |
| SH \zeta_{2\mid 3} | 0,729420 | 0,729420 | 0,729420 | 5,6e−09 | ✓ |
Normal (z) test dağılımı
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| p (z) age | 2,9285·10−24 | 2,9285·10−24 | — | 4,1e−36 | ✓ |
| p (z) BMI | 1,2793·10−23 | 1,2793·10−23 | — | 2,8e−37 | ✓ |
| p (z) \zeta_{0\mid 1} | 3,2832·10−24 | 3,2832·10−24 | — | 6,6e−36 | ✓ |
| p (z) \zeta_{1\mid 2} | 1,3822·10−31 | 1,3822·10−31 | — | 2,9e−43 | ✓ |
| p (z) \zeta_{2\mid 3} | 4,8064·10−40 | 4,8064·10−40 | — | 1,8e−51 | ✓ |
| Model p (\chi^2_2) | 1,3350·10−31 | 1,3350·10−31 | — | 4,3e−43 | ✓ |
%99 GA
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| %99 GA alt age | 0,062576 | 0,062576 | 0,062576 | 1,4e−10 | ✓ |
| %99 GA üst age | 0,105418 | 0,105418 | 0,105418 | 5,8e−10 | ✓ |
| %99 GA alt BMI | 0,247656 | 0,247656 | 0,247656 | 5,9e−11 | ✓ |
| %99 GA üst BMI | 0,420514 | 0,420514 | 0,420514 | 8,5e−10 | ✓ |
| %99 GA alt \zeta_{0\mid 1} | 7,791490 | 7,791490 | 7,791490 | 7,9e−09 | ✓ |
| %99 GA üst \zeta_{0\mid 1} | 13,133693 | 13,133693 | 13,133693 | 2,5e−08 | ✓ |
| %99 GA alt \zeta_{1\mid 2} | 10,808068 | 10,808068 | 10,808068 | 9,5e−09 | ✓ |
| %99 GA üst \zeta_{1\mid 2} | 16,962905 | 16,962905 | 16,962905 | 2,8e−08 | ✓ |
| %99 GA alt \zeta_{2\mid 3} | 14,180100 | 14,180100 | 14,180100 | 2,8e−08 | ✓ |
| %99 GA üst \zeta_{2\mid 3} | 21,078737 | 21,078737 | 21,078737 | 4,8e−08 | ✓ |
Merkezlenmiş açıklayıcılar ve orantılı odds testi
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Kestirim age | 0,083997 | 0,083997 | 0,083997 | 5,5e−10 | ✓ |
| SH age | 0,008266 | 0,008266 | 0,008266 | 5,0e−11 | ✓ |
| Kestirim BMI | 0,334085 | 0,334085 | 0,334085 | 3,5e−11 | ✓ |
| SH BMI | 0,033351 | 0,033351 | 0,033351 | 6,1e−11 | ✓ |
| Kestirim \zeta_{0\mid 1} | −2,823152 | −2,823152 | −2,823152 | 6,1e−11 | ✓ |
| SH \zeta_{0\mid 1} | 0,242857 | 0,242857 | 0,242857 | 7,4e−10 | ✓ |
| Kestirim \zeta_{1\mid 2} | 0,599743 | 0,599743 | 0,599743 | 8,4e−10 | ✓ |
| SH \zeta_{1\mid 2} | 0,150723 | 0,150723 | 0,150723 | 4,7e−10 | ✓ |
| Kestirim \zeta_{2\mid 3} | 4,343675 | 4,343675 | 4,343675 | 8,3e−10 | ✓ |
| SH \zeta_{2\mid 3} | 0,316924 | 0,316924 | 0,316924 | 4,2e−10 | ✓ |
| PO Wald W genel | 3,373757 | 3,373757 | 3,373757 | 9,2e−12 | ✓ |
| PO F p genel | 0,498474 | 0,498474 | 0,498474 | 1,4e−12 | ✓ |
| PO ayarlı F genel | 0,835457 | 0,835457 | 0,835457 | 2,3e−12 | ✓ |
| PO Wald W age | 3,280083 | 3,280083 | 3,280083 | 1,8e−11 | ✓ |
| PO F p age | 0,195624 | 0,195624 | 0,195624 | 1,7e−12 | ✓ |
| PO ayarlı F age | 1,634868 | 1,634868 | 1,634868 | 8,9e−12 | ✓ |
| PO Wald W BMI | 0,107693 | 0,107693 | 0,107693 | 1,4e−12 | ✓ |
| PO F p BMI | 0,947586 | 0,947586 | 0,947586 | 6,7e−13 | ✓ |
| PO ayarlı F BMI | 0,053677 | 0,053677 | 0,053677 | 7,0e−13 | ✓ |
Logit türevinin kararlı ve kararsız biçimi: müşteri verisi (R svyolr bu veride hata verdi)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| SH (kararlı f') Usage | 0,019079 | 0,019079 | — | 8,0e−17 | ✓ |
| SH (kararlı f') ζ 1–2 | 0,371327 | 0,371327 | — | 2,8e−16 | ✓ |
| SH (kararlı f') ζ 2–3 | 0,370986 | 0,370986 | — | 1,3e−15 | ✓ |
| SH (kararlı f') ζ 3–4 | 0,373653 | 0,373653 | — | 1,3e−15 | ✓ |
| SH (kararlı f') ζ 4–5 | 0,516180 | 0,516180 | — | 4,4e−16 | ✓ |
| SH (kararsız f') Usage | 0,003469 | 0,003469 | — | 5,6e−11 | ✓ |
| SH (kararsız f') ζ 1–2 | 0,299560 | 0,299560 | — | 1,7e−10 | ✓ |
100 değerin tamamı eşleşir. Müşteri verisinde kararsız formül satırları, MerQur'un logit türevi bellekte kararsız biçime döndürülerek çalıştırılmasıyla ve bağımsız Python'da aynı formülle elde edilmiştir; iki kaynak kararsız formülün sonucunu da aynı sayıyla üretir.
98.7 Çıktıyı okuma
Sonuç metni (varsayılan ayarlar, kısaltılmış):
Karmaşık Örneklem — Sıralı Lojistik Regresyon (kümülatif bağlantı)
  Bağlantı                       = Lojistik (logit)
  Y düzeyleri                    = 0 < 1 < 2 < 3  (sayısal sıra)
  N (gözlem)                     = 320
  PSU sayısı                     = 320 (küme yok: her gözlem bir PSU)
  Tabaka sayısı                  = 3
  Tasarım df (ν)                 = 317
  Test df (ν − p)                = 315
  Log-olabilirlik                = -277.6074
  McFadden R²                    = 0.2907
Eğim katsayıları (β; P(Y ≤ k) = F(ζ_k − x'β))
  age        0.0840    0.0083   10.162   <0.0001   [0.0677, 0.1003]    1.0876   [1.0701, 1.1055]
  BMI        0.3341    0.0334   10.017   <0.0001   [0.2685, 0.3997]    1.3967   [1.3080, 1.4914]
Eşikler (ζ_k; kesim noktaları)
  0|1       10.4626    1.0307   10.151   <0.0001   [8.4347, 12.4905]        —        —
  1|2       13.8855    1.1875   11.693   <0.0001  [11.5491, 16.2219]        —        —
  2|3       17.6294    1.3310   13.245   <0.0001  [15.0106, 20.2482]        —        —
── APA 7 ÖZET ──
  Model geneli (ayarlı Wald): F(2, 316) = 70.87, p < .001
Orantılı odds testi (tasarım tabanlı Brant türü Wald; H0: eğimler tüm kesimlerde eşit)
  Terim                       df1  Wald χ²       F  df2       p  Ayarlı F  df2       p
  Model geneli (sabit hariç)    4   3.3738  0.8434  315  0.4985    0.8355  314  0.5034
  age                           2   3.2801  1.6400  315  0.1956    1.6349  316  0.1966
  BMI                           2   0.1077  0.0538  315  0.9476    0.0537  316  0.9477
| Öğe | Nasıl yorumlanır |
|---|---|
| Y düzeyleri ve kaynak | Sıranın doğru olduğunu ilk iş denetleyin: "(sayısal sıra)", "(otomatik düzey sırası …)", "(sıralı kategori tanımındaki sıra)" ya da "(kullanıcının verdiği sıra)". |
| Tasarım df (ν), Test df | \nu = PSU − tabaka; test sd'si \nu-p. |
| Eğim ve OR | age OR 1,088: diğerleri sabitken yaşı 10 yıl büyük olanların daha yüksek bir evrede olma odds'u e^{0{,}84}=2{,}32 kat (%95 GA [1,97; 2,73]). BMI 5 kg/m² için e^{5\times0{,}3341}=5{,}31. |
| Eşikler | Açıklayıcılar 0'dayken kesim noktaları; merkezlenmemiş veride tek başına yorumlanmaz. |
| Ayarlı Wald F | Model geneli testi; APA satırı. |
| PO testi | p\ge\alpha: orantılı odds varsayımı reddedilmez. "Uygulanamadı" notu kesim modellerinden birinde ayrışma olduğunu gösterir; varsayım sınanmamıştır (98.5.7). |
| Ayrışma uyarısı | Uyarının adlandırdığı açıklayıcılar kategorileri tam ayırıyordur; seyrek kategorileri birleştirmeyi ya da modeli sadeleştirmeyi düşünün. |
| Notlar | Tanım, öteki parametreleştirmeyle işaret dönüşümü, ölçek notu, eksik değer ve tek PSU uyarıları. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Bölgeye göre tabakalanmış ve ağırlıklandırılmış örneklemde (n = 320; tasarım sd = 317) sistolik kan basıncından türetilen hipertansiyon evresi (4 düzey), yaş ve BMI ile tasarım tabanlı orantılı odds modeliyle incelendi; standart hatalar Taylor doğrusallaştırmasıyla hesaplandı. Model anlamlıydı, ayarlı Wald F(2,\ 316) = 70{,}87, p < 0{,}001, McFadden R^2 = 0{,}29. Diğer değişken sabitken yaştaki her 10 yıllık artış daha yüksek evrede olma odds'unu 2,32 kat (%95 GA [1,97; 2,73]), BMI'daki her 1 kg/m²'lik artış 1,40 kat (%95 GA [1,31; 1,49]) artırdı (her ikisi t(315) > 10, p < 0{,}001). Tasarım tabanlı Brant testi orantılı odds varsayımını reddetmedi, ayarlı F(4,\ 314) = 0{,}84, p = 0{,}50.
98.8 Uzman soruları
S1. Eğimlerin işareti başka bir çıktıdakinin tersi; hangisi doğru?
İkisi de doğrudur; parametreleştirme farklıdır. MerQur ve R svyolr F(\zeta_k-\mathbf x^{\top}\boldsymbol\beta) yazar; öteki yazım F(\alpha_k+\mathbf x^{\top}\boldsymbol\gamma)'dır: \boldsymbol\gamma=-\boldsymbol\beta, eşikler aynı. Notlar bölümü bunu her çalıştırmada yazar.
S2. Gözlenen ve beklenen bilgi neyle eşleşir?
Gözlenen bilgi R svyolr ile; beklenen bilgi Fisher puanlamasının verdiği kovaryansla eşleşir. MerQur (n-1)/(n-p) sd düzeltmesini uygulamaz. Testler (tests/test_v240_b_survey_ordinal.py) apiclus1 ve NHANES verilerinde R ile 10^{-6} düzeyinde karşılaştırır.
S3. Logit türevinin kararlı yazımı hangi sonuçları etkiler?
Yalnız logit bağlantı, gözlenen bilgi ve |a| ya da |b|\gtrsim37 olan gözlemler içeren veride SH, t, p, GA ve PO testi bu yazıma duyarlıdır; katsayılar değildir (kestirim gradyanla durur, gradyan f içerir, f' içermez). Müşteri verisinde Usage SH'si kararlı yazımla 0,0191, kararsız yazımla 0,0035 çıkar. Ilımlı veride iki formül 10^{-9} içinde aynıdır (tests/test_v251_dv2_svy_logit_turev.py).
S4. Eşikler için neden p değeri veriliyor?
H_0:\zeta_k=0, açıklayıcılar sıfırken P(Y\le k)=0{,}5 demektir; çoğu zaman anlamsız bir hipotezdir. MerQur tablo bütünlüğü için verir (R summary.svyolr t değerlerini verir). Yorum eğimler ve OR'ler üzerinden yapılmalıdır.
S5. Brant testi neden ayrı ikili modellerle kuruluyor?
Genel (kesime özgü eğimli) kümülatif model olasılık sırasını bozabilir (Bölüm 51.5.5 uyarısı) ve sözde olabilirlikte LR testi geçersizdir. Brant (1990) ayrı ikili modellerin eğimlerini ve ortak kovaryanslarını kullanan bir Wald testi önerir; tasarım tabanlı biçimde ortak kovaryans, tüm kesim modellerinin skorları yan yana konarak tek Taylor et matrisinden gelir.
S6. Ayrışma neden katsayı büyüklüğüyle değil doğrusal programla denetleniyor?
Büyüklüğe dayalı bir sezgi (ör. \max|\hat\theta_j|>15 ya da SH >10^3) eşikleri ve kesim modellerinin sabitlerini de sayar; eşikler ise açıklayıcıların konumuna bağlıdır. Tıp örneğinde merkezlenmemiş yaş ve BMI ile \hat\zeta_{2\mid3}=17{,}63, üçüncü kesim modelinin sabiti −20,06'dır; böyle bir sezgi ayrışma yokken uyarı verir ve PO testini engellerdi. Albert ve Anderson (1984) ayrışmayı, olabilirliği sınırsız artıran bir parametre yönünün varlığı olarak tanımlar; Konis doğrusal programı (Bölüm 46.5.9) bu tanımı doğrudan sınar ve sonucu konum ve ölçekten bağımsızdır. İkili, sıralı ve çok terimli modeller aynı ölçütü kullanır.
S7. "Tasarımda tut" eksik değer kuralı neden bu panelde varsayılan, lojistikte değil?
Sıralı ve çok terimli modeller R svyolr/svy_vglm ile birebir eşleşecek biçimde kurulmuştur; R bu modellerde eksik satırı tasarımda bırakır. İkili lojistik ve doğrusal panelde varsayılan "tasarımdan çıkar"dır; iki panelde de "tasarımda tut" seçilebilir. Eksik değer yoksa iki kural aynıdır.
S8. Neden test sd'si \nu-p ve eşikler sayılmıyor?
R svyolr df.residual değerini \text{degf}-p olarak verir; eşikler sabit terimin karşılığıdır ve ikili lojistikte sabit de \nu+1-k formülünde bir serbestlik "geri verir". İki formül aynı kurala indirgenir: eğim başına bir serbestlik.
98.9 Sık hatalar ve tuzaklar
- Düzey sırasını denetlememek. Metin kodlu Y'de sıra tanımlanmamış ve etiketler tanınan bir sıralı diziye uymuyorsa analiz yapılmaz; sıra satır sırasından tahmin edilmez. "Düzey sırası" alanını doldurun; çıktının ikinci satırı kullanılan sırayı ve kaynağını yazar.
- PO testinin verilmemesini "varsayım sağlandı" diye okumak. "Uygulanamadı" notu varsayımın sınanamadığını gösterir (98.5.7).
- Öteki parametreleştirmeyle yazılmış çıktıyla işaretleri karşılaştırmak. Eğimler ters işaretlidir (98.8 S1).
- Bilgi matrisini raporlamamak. Gözlenen ve beklenen bilgi farklı SH verir.
- Log-olabilirliği R ile karşılaştırmak. R ağırlıkları ortalama 1'e ölçekler.
- Probit/cloglog/loglog'da OR aramak. OR yalnız logitte vardır; MerQur diğer bağlantılarda OR sütununu basmaz.
- cloglog adını R ile karıştırmak. R
svyolr(method = "cloglog")aslında Gumbel-maksimum (MerQur'da "loglog") dağılımını kullanır; MerQur'un "cloglog"u gerçek tamamlayıcı log-log'dur ve R'de ters sıralı yanıtla elde edilir (notlarda yazılır). - Kategorileri seyrek bırakmak. Ağırlıklı frekansı çok küçük bir uç kategori (burada evre 3: 17 kişi) eşiği büyütür; kategori çok seyrekse gerçek (yarı-tam) ayrışma oluşabilir.
98.10 Kaynaklar
- Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1–10. https://doi.org/10.1093/biomet/71.1.1
- Binder, D. A. (1983). On the variances of asymptotically normal estimators from complex surveys. International Statistical Review, 51(3), 279–292. https://doi.org/10.2307/1402588
- Brant, R. (1990). Assessing proportionality in the proportional odds model for ordinal logistic regression. Biometrics, 46(4), 1171–1178. https://doi.org/10.2307/2532457
- Fellegi, I. P. (1980). Approximate tests of independence and goodness of fit based on stratified multistage samples. Journal of the American Statistical Association, 75(370), 261–268. https://doi.org/10.1080/01621459.1980.10477462
- Lumley, T. (2010). Complex surveys: A guide to analysis using R. Wiley. https://doi.org/10.1002/9780470580066
- Lumley, T., & Scott, A. (2017). Fitting regression models to survey data. Statistical Science, 32(2), 265–278. https://doi.org/10.1214/16-STS605
- McCullagh, P. (1980). Regression models for ordinal data. Journal of the Royal Statistical Society: Series B (Methodological), 42(2), 109–127. https://doi.org/10.1111/j.2517-6161.1980.tb01109.x
- Williams, B., Mancia, G., Spiering, W., Agabiti Rosei, E., Azizi, M., Burnier, M., … Desormais, I. (2018). 2018 ESC/ESH Guidelines for the management of arterial hypertension. European Heart Journal, 39(33), 3021–3104. https://doi.org/10.1093/eurheartj/ehy339