86. Açıklayıcı Faktör Analizi (AFA)
Analiz kimliği: factor_analysis · Menü adı: Açıklayıcı Faktör Analizi (EFA) · Panel: gui/panels/analyses/factor_analysis.py; form add_form_rows (130–205) ve add_extra_rows (211–253), execute (283–577), ek çıktılar _efa_extras (580–627), metin build_body_text (775–899) · Motor: stats/efa_engine.py (çıkarım 150–208, döndürme 322–383, paralel analiz 409–449, MAP 452–476, uyum 557–631, puanlar 640–662), stats/rotation.py (varimax, promax), stats/sampling_adequacy.py (KMO, Bartlett)
86.1 Ne işe yarar
Açıklayıcı faktör analizi (AFA), çok sayıda madde arasındaki korelasyonların az sayıda gizil (örtük) faktörle açıklanıp açıklanamayacağını araştırır. Cevapladığı sorular şunlardır: "18 maddelik ölçek kaç boyut ölçüyor?", "Hangi madde hangi boyuta ait?", "Bir madde hiçbir boyuta yüklenmiyor ya da iki boyuta birden mi yükleniyor?"
Model, standartlaştırılmış madde vektörünü ortak faktörlerin doğrusal birleşimi ve maddeye özgü bir artık olarak yazar; buradan korelasyon matrisinin yapısı çıkar:
- \mathbf z: p maddenin standartlaştırılmış değerleri (p=18 örnekte).
- \mathbf f: m ortak faktör (m<p); \operatorname{Var}(\mathbf f)=\boldsymbol\Phi (köşegeni 1). Dik çözümde \boldsymbol\Phi=\mathbf I.
- \boldsymbol\Lambda: p\times m yük matrisi (eğik çözümde örüntü matrisi \mathbf P).
- \mathbf u: maddeye özgü artık (özgül varyans + ölçme hatası); \boldsymbol\Psi=\operatorname{diag}(\psi_1,\dots,\psi_p) teklik (uniqueness) matrisi.
- \mathbf R: madde korelasyon matrisi. Köşegende 1=h_i^2+\psi_i; h_i^2 ortak varyanstır (communality).
Modelin özü köşegen dışındadır: iki maddenin korelasyonu yalnız ortak faktörlerden gelir, r_{ij}=\sum_{k,l}\lambda_{ik}\phi_{kl}\lambda_{jl}. Temel bileşenler analizinden (TBA) ayrıldığı nokta budur: TBA toplam varyansı (\mathbf R'nin köşegeni 1) açıklar, AFA yalnız ortak varyansı.
Ne zaman kullanılır?
- Yeni geliştirilen bir ölçeğin boyut yapısını keşfetmek; madde ayıklamak.
- Kuramın faktör sayısını kesin söylemediği, maddelerin hangi faktöre ait olduğunun veriden öğrenileceği durumlar.
- Doğrulayıcı analizden önce bağımsız bir alt örneklemde yapı önerisi üretmek.
Ne zaman kullanılmaz?
- Yapı önceden belliyse ve sınanacaksa: Doğrulayıcı Faktör Analizi (Bölüm 88). Aynı veride AFA ile yapı bulup DFA ile "doğrulamak" döngüseldir.
- Amaç ortak varyans değil, değişkenleri az sayıda bileşende özetlemekse (veri indirgeme, regresyonda çoklu doğrusallık): PCA (Bölüm 80). MerQur'un AFA panelinde de "Temel bileşenler" çıkarımı vardır; ancak PCA panelinin çıktıları (bileşen puanları, biplot) bu amaca daha uygundur.
- Maddeler ikili (doğru/yanlış) ve amaç madde güçlüğü ile ayırt ediciliğiyse: Madde Tepki Kuramı (Bölüm 91). Az kategorili Likert maddelerde AFA yapılacaksa korelasyon türü "Polikorik" seçilmelidir.
- Gizil değişkenin sürekli değil, kategorik (sınıflar) olduğu düşünülüyorsa: Gizil Sınıf Analizi (Bölüm 78) ya da Gizil Profil Analizi (Bölüm 79).
- Yalnız iç tutarlılık soruluyorsa: Cronbach Alfa (Bölüm 84).
Sık karıştırılan analizler. PCA ile AFA'nın yükleri büyük örneklemde ve yüksek ortak varyanslarda birbirine yaklaşır; küçük ortak varyanslarda PCA yükleri sistematik olarak büyüktür (örnekte PC ile açıklanan %72,9, ML ile %67,5). DFA her maddenin yalnız belirlenen faktöre yüklendiğini varsayar ve uyumu sınar; AFA her maddeye her faktörde yük verir ve döndürmeyle basit yapı arar.
86.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Ortak faktör modeli | Korelasyonları birkaç gizil faktör üretir; artıklar ilişkisiz | Uyum ek çıktısı: χ², RMSEA, artık RMSR |
| Faktörleştirilebilirlik | Maddeler arasında yeterli kısmi olmayan ortak varyans var | KMO ve madde MSA (eşikler 0,60 / 0,50); Bartlett küresellik testi |
| Ölçek düzeyi | Pearson için aralık ölçeği; az kategorili sıralı maddelerde polikorik | Denetlenmez; "Korelasyon türü" seçimi kullanıcıdadır |
| Çok değişkenli normallik | Yalnız ML'nin χ² testi ve GA'sı için gerekir; yükler için şart değil | Denetlenmez; uyum notu "χ² testi ML varsayar" der |
| Yeterli örneklem | n\ge100 (tercihen \ge200, n/p\ge5) | n<30 hata, n<100 uyarı (factor_analysis.py:338–341, 487–490) |
| Tekillik yok | \mathbf R ters çevrilebilir olmalı (KMO, SMC, ML) | Determinant <10^{-5} uyarısı (tanı ek çıktısında); pozitif tanımlı değilse KMO tanımsız |
Eksik değer. Varsayılan liste bazında silmedir: seçili maddelerden birinde eksik olan satır tümüyle atılır (factor_analysis.py:329–333) ve atılan satır sayısı uyarıya yazılır. "Çift bazında" seçilirse yalnız tüm maddeleri boş olan satırlar atılır, her korelasyon iki değeri de bulunan çiftlerden hesaplanır (sub.corr(), satır 367–368); bu matris pozitif tanımlı olmayabilir ve MerQur onu düzleştirmez, yalnız uyarır (satır 488–493). Çift bazında yolda Bartlett'in n'i "en az bir değeri olan satır sayısı"dır. Faktör puanları her iki durumda da yalnız tam satırlardan hesaplanır (satır 616).
Uç durumlar (kodun hata verdiği ya da davranış değiştirdiği koşullar):
- 3'ten az madde:
ValueError(satır 316–319). Arayüz de en az 3 değişken ister. - Silmeden sonra n<30:
ValueError(satır 338–341). - Sıfır varyanslı (sabit) madde:
ValueError, sütun adlarıyla (satır 345–349). - Faktör sayısı her durumda 1\le m\le p-1 aralığına kırpılır (satır 434). Tek faktörde (m=1) döndürme atlanır.
- Polikorik + çift bazında yolda iki değeri birlikte gözlenmiş satırı olmayan bir madde çifti varsa hata (satır 364–365).
- Ters matrisin köşegeninde sıfır ya da negatif terim varsa (pozitif tanımlı olmayan matris) KMO ve tüm MSA'lar NaN olur, metinde "—" yazılır (
sampling_adequacy.py:33–35). - ML, minres ve GLS'de teklik alt sınıra (\psi_i=0{,}005) dayanırsa, PA'da 1-h_i^2\le0 olursa Heywood uyarısı çıkar (
efa_engine.py:180–181, 206;factor_analysis.py:519–520). - Paralel analiz ya da MAP hesaplanamazsa faktör sayısı Kaiser kuralına düşer ve bu, ayar bloğuna "hesaplanamadı" gerekçesiyle yazılır (satır 413–429). Faktör tabanlı paralel analiz başarısız olursa önce bileşen tabanlıya düşülür (satır 397–407).
86.3 Parametreler
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Maddeler | — | Sayısal sütunlar (en az 3) | Analize giren p değişken |
| Faktör sayısı | Otomatik (Kaiser k>1) | Otomatik, Sabit 1…10, Paralel analiz (Horn), MAP (Velicer) | m; tüm yükleri, ortak varyansları ve uyumu değiştirir |
| Çıkarım yöntemi | En çok olabilirlik (ML) | ML, Temel eksen (PAF), Minres/ULS, GLS, Temel bileşenler (PC) | Yükler ve h^2 (86.5.7); uyum χ² testi yalnız ML'de kuramsal olarak geçerli |
| Rotasyon | Varimax (varsayılan) | Varimax, Rotasyonsuz, Quartimax, Equamax (dik); Oblimin, Promax, Geomin (eğik) | Yüklerin dağılımı, eğikte \boldsymbol\Phi ve yapı matrisi; h^2 ve uyum değişmez |
| Kaiser normalizasyonu (döndürmede) | Açık | Döndürmeden önce satırları h_i'ye böler | Döndürülmüş yükleri değiştirir (86.5.8) |
| Eksik veri | Liste bazında | Liste / Çift bazında | n ve \mathbf R |
| Korelasyon türü | Pearson | Pearson / Polikorik (sıralı Likert) | \mathbf R; tüm sonuçlar |
| Paralel analiz türü | Bileşen tabanlı (köşegende 1) | Bileşen / Faktör tabanlı (köşegende SMC) | Paralel analiz tablosu ve "Paralel analiz" seçiliyse m |
| Ek çıktılar: korelasyon matrisi, anlamlılık, determinant, anti-imaj | Kapalı | Tanı tabloları | Yalnız ek metin |
| Ek çıktılar: başlangıç/çıkarım ortak varyansları + Toplam Açıklanan Varyans | Kapalı | SMC, h^2, üç bloklu varyans tablosu | Yalnız ek metin |
| Ek çıktılar: uyum testi ve indeksleri | Kapalı | χ², TLI, CFI, RMSEA (%90 GA), BIC, RMSR | Yalnız ek metin |
| Ek çıktılar: yükleri sırala, küçükleri gizle, çapraz yük uyarısı | Kapalı | Sıralı tablo + çapraz yük uyarısı | Ek metin ve uyarı |
| Yük gizleme eşiği | 0,30 | Sıralı tabloda gizlenecek \lvert\lambda\rvert sınırı | Yalnız "sırala" açıkken etkili |
| Faktör puanları | Hesaplama | Regresyon (Thurstone), Bartlett, Anderson-Rubin, ten Berge | Puan ağırlıkları (86.5.11) |
| Faktör puanlarını veri setine kaydet | Kapalı | FAC1_REG … sütunları | Veri setine yazar |
| Grafik | Scree + yük ısı haritası | 3B yük / 3B skor / 3B biplot | Yalnız grafik |
Paralel analizin yineleme sayısı (100) ve tohum (seed) değeri (42) formda yoktur; execute imzasındaki varsayılanlarla sabittir (factor_analysis.py:291–293). Aynı veri her çalıştırmada aynı paralel analiz tablosunu verir.
Neden "Otomatik" Kaiser kuralıdır, paralel analiz değil?
Kaiser kuralı (\lambda>1) en eski ve en yaygın ölçüttür; MerQur geriye dönük uyumluluk için onu varsayılan tutar. Ancak bu kural p büyüdükçe faktör sayısını abartır (rastgele veride bile ilk özdeğerler 1'i aşar; örnekte rastgele verinin ilk özdeğer ortalaması 1,50'dir). Bu yüzden MerQur hangi kural seçilirse seçilsin paralel analiz ve MAP sonuçlarını her zaman basar; kullanıcı üç ölçütü yan yana görür. Örnekte üçü de 3 der; bu uyuşma bulgunun sağlamlığını gösterir.
Koddaki tercih: dağıtıcıdaki eski varsayılan
stats_panel.py:7132–7135 çıkarım kutusu bulunamazsa "ml_sklearn" gönderir; execute bunu "ml"ye çevirir (factor_analysis.py:442–443). sklearn'ün FactorAnalysis ML'i bazı verilerde optimuma ulaşmadan durduğu için kullanılmaz; bu değerle gelen istek de efa_engine ML'ine gider.
86.4 Tıp örneği
Dosya: english/datasets/Tip/75_efa_18_item_3faktor.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/75_efa_18_madde_3faktor.xlsx). VIDEO_SCRIPT_TR.txt #75'e göre değişkenler q01…q18'dir.
| Değişken | Rol | Tür | Açıklama / özet |
|---|---|---|---|
| patient_id | — | Kimlik | Analize girmez |
| q01–q06 | Madde | 1–5 Likert | Ortalamalar 3,00–3,14; SS 1,06–1,16 |
| q07–q12 | Madde | 1–5 Likert | Ortalamalar 3,03–3,09; SS 1,08–1,14 |
| q13–q18 | Madde | 1–5 Likert | Ortalamalar 2,97–3,04; SS 1,07–1,24 |
n ve eksik değer: 250 hasta, eksik değer yok; liste bazında silmede atılan satır 0.
Klinik soru: On sekiz maddelik hasta ölçeği kaç bağımsız boyutu ölçüyor ve her madde hangi boyuta ait?
Seçilen ayarlar: Arayüz varsayılanları (Otomatik/Kaiser, ML, Varimax, Kaiser normalizasyonu açık, Pearson, liste bazında, bileşen tabanlı paralel analiz). Hesap yürüyüşü için ek çıktıların dördü de açılmış, faktör puanı olarak Regresyon seçilmiştir. Karşılaştırma için ayrıca: faktör tabanlı paralel analiz, PA + Promax, Minres + Oblimin ve polikorik korelasyon çalıştırılmıştır.
86.5 Formüller ve hesap adımları
MerQur'un hesap sırası şudur: maddeler sayıya çevrilir ve eksikler silinir → korelasyon matrisi \mathbf R → KMO/MSA ve Bartlett → \mathbf R'nin özdeğerleri (Kaiser sayısı) → paralel analiz ve MAP (her zaman) → faktör sayısı kuralı → seçilen yöntemle m faktörlü döndürülmemiş çözüm → (gerekirse Kaiser normalizasyonlu) döndürme, işaret ve sıra düzeltmesi → ortak varyans ve açıklanan varyans → uyarılar → isteğe bağlı tanılar, uyum ölçütleri ve faktör puanları. Tüm hesaplar korelasyon matrisi üzerindedir; ham veri yalnız korelasyonu ve faktör puanlarını hesaplamak için kullanılır.
86.5.1 Korelasyon matrisi
Pearson ve liste bazında yolda \mathbf R=\texttt{np.corrcoef}(\mathbf X^{\top})'dir (factor_analysis.py:370):
- x_{ti}: t. hastanın i. maddeye cevabı; \bar x_i: madde ortalaması.
- Payda ve paydaki 1/(n-1) çarpanları sadeleştiği için korelasyon bölenden bağımsızdır.
Polikorik seçilirse \mathbf R, stats/reliability_extras.polychoric_matrix ile iki adımlı ML polikorik korelasyonlardan kurulur: her maddenin eşikleri kendi marjinal dağılımından, her çiftin \rho'su o çiftin iki boyutlu çapraz tablosundan (psych polychoric(global = TRUE) tanımı; factor_analysis.py:353–366). Sonraki tüm adımlar bu matrisle aynı biçimde ilerler.
86.5.2 KMO ve madde MSA
Kaiser–Meyer–Olkin ölçüsü, korelasyonların kısmi korelasyonlara göre büyüklüğüdür (sampling_adequacy.py:18–51):
- q_{ij}: i ve j maddelerinin, öteki p-2 madde sabitken kısmi korelasyonu.
- (\mathbf R^{-1})_{ij}: ters korelasyon matrisinin öğesi; kodda
np.linalg.pinv(sözde ters) kullanılır. - Toplamlar köşegen dışıdır; her çift iki kez sayılır, oran değişmez.
Neden kısmi korelasyon?
Ortak faktör modeli doğruysa, iki madde arasındaki korelasyonun tamamına yakını öteki maddelerin de paylaştığı faktörlerden gelir; öteki maddeler kontrol edilince kalan (kısmi) korelasyon küçüktür. KMO 1'e yaklaştıkça korelasyonlar "ortak" kaynaklıdır; 0,5'in altındaysa korelasyonlar madde çiftlerine özgüdür ve faktör analizi anlamsızdır. Kaiser'in (1974) ölçeği MerQur'da birebir kullanılır (factor_analysis.py:746–752): \ge0{,}90 mükemmel, \ge0{,}80 çok iyi, \ge0{,}70 iyi, \ge0{,}60 orta, \ge0{,}50 zayıf, altı kabul edilemez.
Madde MSA'sı 0,50'nin altında olan maddeler uyarıda listelenir (factor_analysis.py:512–518); genel KMO <0{,}60 ise "zayıf", 0{,}60–0{,}70 ise "orta" uyarısı çıkar.
Anti-imaj matrisleri (tanı ek çıktısı; efa_engine.py:536–553): anti-imaj kovaryansı \mathbf Q=\mathbf S\mathbf R^{-1}\mathbf S, \mathbf S=[\operatorname{diag}(\mathbf R^{-1})]^{-1}; anti-imaj korelasyonunun köşegen dışı öğesi (\mathbf R^{-1})_{ij}/\sqrt{(\mathbf R^{-1})_{ii}(\mathbf R^{-1})_{jj}}=-q_{ij}, köşegeni madde MSA'sıdır.
86.5.3 Bartlett küresellik testi
H_0:\ \mathbf R=\mathbf I (maddeler ilişkisiz). Test istatistiği (sampling_adequacy.py:54–73):
- \lvert\mathbf R\rvert: korelasyon matrisinin determinantı; maddeler ilişkisizse 1, \ln\lvert\mathbf R\rvert=0.
- n-1-(2p+5)/6: Bartlett'in (1950) χ² yaklaşımını iyileştiren çarpan.
- p değeri: P(\chi^2_{\text{sd}}\ge\chi^2).
Neden -(n-1-(2p+5)/6) çarpanı?
-n\ln\lvert\mathbf R\rvert olabilirlik oranı istatistiğidir; büyük örneklemde \chi^2 dağılır. Bartlett, küçük örneklemde dağılımın beklenen değerini \chi^2'ninkine eşitleyen düzeltmeyi türetmiştir: n yerine n-1-(2p+5)/6. Örnekte 250-1-41/6=242{,}1667.
Koddaki tercih
Bartlett, Pearson + liste bazında yolda veriden yeniden hesaplanan korelasyonla, p değeri 1-F_{\chi^2}(\chi^2) olarak (sampling_adequacy.py:71); polikorik ya da çift bazında yolda kullanılan \mathbf R ile ve p değeri chi2.sf ile hesaplanır (factor_analysis.py:380–385). İki yol aynı sayıyı verir, ancak 1-F biçimi çok büyük \chi^2'de 0'a yuvarlanır; metinde "p = 0{,}000000" ve APA'da "p<{,}001" yazar. \ln\lvert\mathbf R\rvert hesabında determinant 10^{-300}'den küçükse bu sınıra kırpılır.
86.5.4 Özdeğerler ve Kaiser kuralı
\mathbf R=\mathbf V\operatorname{diag}(\lambda_1,\dots,\lambda_p)\mathbf V^{\top}, \lambda_1\ge\dots\ge\lambda_p (np.linalg.eigvalsh, satır 388). Kaiser sayısı m_K=\#\{k:\lambda_k>1\}'dir. \sum_k\lambda_k=\operatorname{tr}\mathbf R=p olduğundan \lambda_k/p, k. bileşenin açıkladığı toplam varyans oranıdır. Yamaç (scree) grafiği bu özdeğerleri çizer ve \lambda=1 çizgisini gösterir.
86.5.5 Paralel analiz: bileşen ve faktör tabanlı
Horn'un (1965) fikri: aynı n ve p ile üretilen ilişkisiz rastgele verinin özdeğerleri, örnekleme gürültüsünün ürettiği "boş" özdeğerlerdir. Gözlenen özdeğer bunları aştığı sürece faktör sayılır. MerQur'un tanımı (efa_engine.py:416–449):
- \mathbf Y^{(b)}: n\times p bağımsız standart normal sayılar;
np.random.default_rng(42)ile, 100 tekrar. - Bileşen tabanlı (
kind="pc", varsayılan): \lambda_k, \mathbf R'nin ve \mathbf C^{(b)}'nin (köşegeni 1) özdeğerleridir. - Faktör tabanlı (
kind="fa"): hem gözlenen hem rastgele matrislerin köşegenine SMC konur, \mathbf R_{\text{ind}}=\mathbf R-\mathbf I+\operatorname{diag}(\text{SMC}), özdeğerler bu indirgenmiş matristen alınır (_reduced_eig, satır 398–402). - \text{SMC}_i=1-1/(\mathbf R^{-1})_{ii}: i. maddenin öteki maddelerle çoklu korelasyon karesi (
smc, satır 43–54). - Yüzdelik
np.quantileile (doğrusal ara değerleme, R'deki tip 7). - Sayım ardışıktır: ilk kez \lambda^{\text{göz}}_k\le ölçüt olduğunda durur; sonraki özdeğerlere bakılmaz.
- "Paralel analiz (Horn)" kuralı seçilirse m=m_{\text{ort}} kullanılır (
factor_analysis.py:417); %95 yüzdelik ölçütüne göre sayı (m_{0{,}95}, Glorfeld 1995) yalnız bilgi olarak basılır.
Neden faktör tabanlı paralel analiz eklendi?
Bileşen tabanlı paralel analiz, toplam varyansı (köşegen 1) ölçer; oysa AFA'nın çıkardığı şey ortak varyanstır. Ortak faktör modeline uygun karşılaştırma, köşegene ortak varyans kestirimi (SMC) konmuş indirgenmiş matrisin özdeğerleridir (psych fa.parallel(fa = "fa", SMC = TRUE)). İndirgenmiş matriste özdeğerler küçülür ve rastgele verinin özdeğerleri sıfıra yakın, hatta negatif olur; bu nedenle faktör tabanlı yöntem zayıf faktörleri daha kolay "görür" ve genellikle daha çok faktör önerir (araç ipucu da bunu söyler). Bileşen tabanlı yöntem ise çok güçlü bir ilk faktör varken sonraki faktörleri gözden kaçırabilir. İki yöntemin uyuşması yapının sağlamlığını gösterir; ayrışması, aradaki faktörlerin zayıf olduğuna işarettir.
psych ile tanım farkları
(1) psych fa.parallel kararını varsayılan olarak %95 yüzdeliğe göre verir (quant = .95); MerQur'un kuralı ortalamadır (Horn'un özgün ölçütü). İki sayı MerQur çıktısında yan yana yazılır. (2) psych SMC = FALSE (varsayılan) ile gözlenen faktör özdeğerlerini fa() çözümünün ortak varyanslarından alır; MerQur'un faktör tabanlı tanımı SMC = TRUE ile aynıdır. (3) psych rastgele veriye ek olarak yeniden örneklenmiş veri de kullanır ve kendi rastgele sayı üretecini kullanır; benzetim ortalamaları R ile birebir aynı olamaz. Gözlenen özdeğerler (iki türde de) R ile 10^{-14} düzeyinde aynıdır (86.6.1).
86.5.6 Velicer MAP
Velicer'in (1976) en küçük ortalama kısmi korelasyon ölçütü, temel bileşenler sırayla kısmileştirildikçe kalan korelasyonların ne kadar küçüldüğüne bakar (efa_engine.py:460–476):
- \mathbf A: tüm temel bileşen yükleri; \mathbf A_{[:,1:m]} ilk m sütun.
- \mathbf C_m: ilk m bileşen çıkarıldıktan sonra kalan kovaryans; \mathbf D_m=\operatorname{diag}(\mathbf C_m).
- \mathbf P_m: kısmi korelasyon matrisi; m=0'da \mathbf R'nin kendisi.
-
- kuvvet ölçütü (O'Connor 2000 revizyonu) aynı ortalamayı (\mathbf P_m)_{ij}^4 ile alır; bilgi olarak basılır.
- Bir \mathbf C_m'nin köşegeni 10^{-12}'nin altına inerse döngü durur.
Neden en küçük?
Gerçek ortak faktörlere karşılık gelen bileşenler çıkarıldıkça kısmi korelasyonlar küçülür; artık yalnız maddeye özgü varyansı temsil eden bileşenler çıkarılmaya başlayınca kalan korelasyon matrisi "bozulur" ve ortalama kare kısmi korelasyon yeniden büyür. Dönüm noktası faktör sayısıdır. Örnekte \text{MAP}_3=0{,}0158, \text{MAP}_4=0{,}0209.
Koddaki tercih: m=0 dahil
MerQur, m=0 (hiç bileşen çıkarılmamış) değerini de aday sayar; en küçük \text{MAP}_0 ise önerilen sayı 0 olur ve execute bunu m=1'e kırpar (satır 434). psych VSS()$map yalnız m=1,\dots,n değerlerini verir. m\ge1 için iki tanım aynıdır (86.6.1, 10^{-16}).
86.5.7 Çıkarım yöntemleri
Beş yöntemin hepsi m faktörlü döndürülmemiş yük matrisi \mathbf A (p\times m) ve teklikler \boldsymbol\psi üretir (efa_engine.extract, satır 140–197). Hepsinde sonunda her sütunun yük toplamı pozitif olacak biçimde işaret düzeltilir (_fix_signs, satır 63–68).
Temel bileşenler (PC). \mathbf A=\mathbf V_m\operatorname{diag}(\sqrt{\lambda_m}), \psi_i=1-\sum_k a_{ik}^2. Ortak/özgül varyans ayrımı yapmaz; yükler bu yüzden en büyüktür.
Temel eksen (PA, iteratif). Köşegene ortak varyans kestirimi konarak özayrışım tekrarlanır (satır 153–171):
- Durma: \max_i\lvert h_i^{(t+1)}-h_i^{(t)}\rvert<10^{-8} ya da 1000 yineleme.
- Heywood: 1-h_i^2\le0 olan madde (ortak varyans 1'i aşmış).
- \mathbf R_r^{(0)}'ın özdeğerleri, faktör tabanlı paralel analizin "gözlenen" özdeğerleriyle aynıdır.
Minres (ULS). Verili \boldsymbol\Psi için yükler \mathbf R-\boldsymbol\Psi'nin ilk m özvektöründen alınır; \boldsymbol\Psi ise kalan özdeğerlerin karelerini en küçükler (Harman ve Jones 1966; satır 83–93):
Bu, \operatorname{tr}[(\mathbf R-\mathbf A\mathbf A^{\top}-\boldsymbol\Psi)^2]'nin, yani artık korelasyonların kareler toplamının en küçüklenmesine denktir.
En çok olabilirlik (ML, varsayılan). Jöreskog'un (1967) yoğunlaştırılmış (concentrated) ölçütü (satır 96–117):
- \gamma_1\ge\dots\ge\gamma_p: ölçeklenmiş matris \mathbf R^{*}'ın özdeğerleri; \boldsymbol\Omega_m ilk m özvektör.
- F_{\text{ML}}, \boldsymbol\Sigma=\mathbf A\mathbf A^{\top}+\boldsymbol\Psi için \ln\lvert\boldsymbol\Sigma\rvert+\operatorname{tr}(\boldsymbol\Sigma^{-1}\mathbf R)-\ln\lvert\mathbf R\rvert-p ile aynı değerdir.
- En iyileme: L-BFGS-B, \psi_i\in[0{,}005;\ 1], başlangıç 1-\text{SMC},
ftol10^{-14},gtol10^{-10}, en çok 1000 yineleme.
GLS. Jöreskog ve Goldberger (1972) ölçütü F_{\text{GLS}}=\tfrac12\operatorname{tr}[(\mathbf I-\mathbf R^{-1}\boldsymbol\Sigma)^2]; verili \boldsymbol\Psi için yükler \boldsymbol\Psi^{1/2}\mathbf R^{-1}\boldsymbol\Psi^{1/2}'nin en küçük m özdeğerinden: \mathbf A=\boldsymbol\Psi^{1/2}\boldsymbol\Omega_m(\boldsymbol\Gamma_m^{-1}-\mathbf I)^{1/2} (satır 120–137). Gradyan analitik değildir; L-BFGS-B sayısal türev kullanır.
Neden ML varsayılan?
ML, örneklem korelasyon matrisinin çok değişkenli normal dağılımdan geldiği varsayımı altında olabilirliği en büyükler; tutarlı ve asimptotik olarak etkin kestirim verir ve tek yöntem olarak uyum için kuramsal χ² testi sunar. Normallik bozulduğunda bile yükler genellikle sağlamdır, yalnız χ² ve GA'lar güvenilmez olur. PA ve minres dağılım varsayımı yapmaz ve küçük örneklemde ya da Heywood eğiliminde daha kararlıdır; Likert ölçek geliştirmede sık seçilirler (araç ipucu efa_tt_extraction).
Koddaki tercih: yakınsama denetimi
Extraction nesnesi converged ve iterations alanlarını taşır (efa_engine.py:73–80); panel bunları okur (factor_analysis.py:444–446). PA 1000 yinelemede ya da L-BFGS-B en çok yinelemede yakınsamadan durursa "Faktör çıkarımı yakınsamadı (… yineleme); yükler ve uyum ölçütleri güvenilir olmayabilir" uyarısı çıkar. Bu veride PA 15, ML 11, minres 6, GLS 11 yinelemede yakınsar; sorun ancak zayıf tanımlı, Heywood'a yakın çözümlerde ortaya çıkar.
Koddaki tercih: ML çıkarım sütunlarının sırası
Döndürülmemiş sütunlar bütün çıkarım yöntemlerinde (ML, PAF, minres, GLS, PC), R factanal ve psych fa gibi kareler toplamına (KT) göre büyükten küçüğe sıralanır (efa_engine.py, extract). Özdeğer (\gamma_k) sırası KT sırasıyla aynı olmayabilir: örnekte \gamma sırasındaki KT'ler 4,263 / 4,723 / 3,167'dir, sıralanmış sütunlar 4,723 / 4,263 / 3,167 verir. Değerler kümesi aynıdır; döndürme sonrası sütunlar da KT'ye göre sıralıdır. Kodun ML ölçütü F'ye eklediği sabit, standart biçimden (-(p-m)) farklıdır (_ml_obj, satır 107); sabit en iyilemeyi etkilemez, uyum χ²'si ise ayrıca standart formülle hesaplanır (86.5.10).
86.5.8 Döndürme
Döndürme, \mathbf A'yı bir \mathbf T matrisiyle çarparak yükleri "basit yapıya" (her madde tek faktörde büyük, ötekilerde küçük yük) yaklaştırır. Dik döndürmede \mathbf T^{\top}\mathbf T=\mathbf I, \mathbf L=\mathbf A\mathbf T; eğik döndürmede \mathbf P=\mathbf A(\mathbf T^{\top})^{-1}, \boldsymbol\Phi=\mathbf T^{\top}\mathbf T. Her iki durumda model korelasyonu \mathbf P\boldsymbol\Phi\mathbf P^{\top}=\mathbf A\mathbf A^{\top} değişmez; bu yüzden h^2, \boldsymbol\Psi ve uyum ölçütleri döndürmeden bağımsızdır.
Kaiser normalizasyonu (varsayılan açık; efa_engine.py:346–350, 371–372):
Neden satırları normalleştirmek?
Varimax ölçütü yük karelerinin varyansıdır; ortak varyansı büyük maddeler ölçüte orantısız katkı yapar ve döndürmeyi kendi yönlerine çeker. Satırlar birim uzunluğa getirilince her madde döndürmeye eşit ağırlıkla katılır (Kaiser 1958). R psych varsayılanı budur; MerQur'da da varsayılandır. Kapatılırsa sonuç değişir: örnekte q04'ün yükleri normalizasyonla (0{,}0115;\ 0{,}8382;\ -0{,}1429), normalizasyonsuz (0{,}0102;\ 0{,}8387;\ -0{,}1402)'dir.
Varimax (stats/rotation.py:31–53). Normalleştirilmiş yükler \mathbf X için ölçüt, sütun başına yük karelerinin varyansının toplamıdır:
Kod R stats::varimax'ın SVD yinelemesini kullanır:
- \mathbf Z^{\circ3}: öğe öğe küp.
- Durma: d=\operatorname{tr}\mathbf S için d_{\text{yeni}}<d_{\text{eski}}(1+\varepsilon), \varepsilon=10^{-14} (R'de 10^{-5}); en çok 100000 yineleme.
Neden \varepsilon=10^{-14}?
R'nin varsayılan 10^{-5}'i yükleri dördüncü ondalıkta durdurabilir. Doğrulamada R tarafında da varimax(eps = 1e-14) kullanılmıştır.
GPA ölçütleri (Bernaards ve Jennrich 2005; efa_engine.py:213–301). Quartimax, equamax, oblimin ve geomin gradyan izdüşüm algoritmasıyla (tolerans 10^{-8}, en çok 10000 yineleme) çözülür. Ölçütler (en küçüklenen):
- \lambda_{ik}: döndürülmüş (eğikte örüntü) yük.
- Oblimin'de \gamma arayüzde sabit 0'dır (etiket "δ = 0"); bu, quartimin'dir.
- Equamax, Crawford–Ferguson (CF) ailesinin \kappa=m/(2p) üyesidir; örnekte 3/36.
- Geomin'in \varepsilon'u GPArotation
geominQ(delta = .01)ile aynıdır.
Promax (Hendrickson ve White 1964; stats/rotation.py:56–82):
- \mathbf Q: hedef matris; varimax yüklerinin satırı birim uzunluğa normalleştirilmiş hâlinin 4. kuvveti (işaret korunarak).
- \mathbf U: hedefe en küçük kareler yaklaşımı; sütun ölçeklemesi faktör varyanslarını 1 yapar.
- \mathbf T_m=\mathbf T_v\mathbf U: döndürülmemiş yüklerden örüntüye toplam dönüşüm.
R `stats::promax` ile fark
R'nin stats::promax'ı hedefi normalleştirilmemiş varimax yüklerinden kurar; bu, normalleştirilmiş hedeften farklı \boldsymbol\Phi verir. MerQur normalleştirilmiş hedefi izler. Doğrulamada R tarafı aynı tanımla elle yazılmıştır.
İşaret ve sıra (efa_engine.py:373–383). Döndürmeden sonra her sütunun toplamı pozitif yapılır (\boldsymbol\Phi buna göre işaretlenir); sütunlar \operatorname{diag}(\boldsymbol\Phi\mathbf P^{\top}\mathbf P)'ye göre büyükten küçüğe dizilir. Yapı matrisi \mathbf S=\mathbf P\boldsymbol\Phi'dir.
86.5.9 Ortak varyans ve açıklanan varyans
- h_i^2: i. maddenin ortak varyansı; h_i^2<0{,}30 ise "düşük communality" uyarısı (satır 518–524).
- \text{SS}_k: k. faktörün açıkladığı varyans; dikte yük karelerinin sütun toplamı. Eğikte \sum_i p_{ik}s_{ik} (örüntü × yapı); paylaşılan katkıyı faktörlere eşit böler, toplamı \sum_ih_i^2'dir.
- Eğik çözümde ayrıca \Sigma S^2_k=\sum_i s_{ik}^2 basılır; toplanamaz.
- Toplam ortak varyans yüzdesi 100\sum_ih_i^2/p.
Neden eğik çözümde iki ayrı "açıklanan varyans"?
Faktörler ilişkiliyse, bir maddenin iki faktörle paylaştığı varyans iki faktöre birden atfedilebilir. \Sigma S^2 her faktörü ötekileri yok sayarak değerlendirir ve paylaşılan kısmı iki kez sayar; \operatorname{diag}(\boldsymbol\Phi\mathbf P^{\top}\mathbf P) bu kısmı ikiye böler ve toplam ortak varyansı korur. Hangisinin raporlandığı açıkça yazılmalıdır; MerQur ikisini yan yana verir.
86.5.10 Uyum ölçütleri
Uyum ek çıktısı psych fa.stats tanımlarını izler (efa_engine.py:581–631). Model korelasyonu \mathbf M=\mathbf P\boldsymbol\Phi\mathbf P^{\top}, artıklar \mathbf E=\mathbf R-\mathbf M:
- \text{sd}: serbestlik derecesi = korelasyon sayısı − serbest yük + döndürme belirsizliği (m(m-1)/2). Örnekte 153-54+3=102.
- c_m=(n-1)-(2p+5)/6-2m/3: Bartlett düzeltmeli çarpan; örnekte 240,1667.
- \chi_0^2, \text{sd}_0=p(p-1)/2: bağımsızlık (boş) modeli; \chi_0^2 Bartlett küresellik χ²'siyle aynıdır.
- RMSEA %90 GA: merkezî olmayan χ² ters çevrilerek \lambda bulunur ve \sqrt{\lambda/((n-1)\,\text{sd})} yazılır.
- PA, minres, GLS ve PC çözümlerinde de aynı F (ML ölçütü) çözüm yüklerinde hesaplanır; χ² testi yalnız ML'de kuramsal dayanaklıdır, ötekilerde betimseldir (notu
efa2_fit_note).
Neden -2m/3 düzeltmesi?
Bartlett (1950), ML faktör analizinde olabilirlik oranı istatistiğinin \chi^2 yaklaşımını düzelten çarpanı (n-1)-(2p+5)/6-2m/3 olarak türetmiştir; faktör sayısı arttıkça kestirilen parametre sayısı arttığından çarpan küçülür. R factanal ve psych bu çarpanı kullanır.
RMSR: Harman tanımı, psych'ten √2 kat büyük
Kod \text{RMSR}=\sqrt{2\,r^*/(p(p-1))} yazar, r^*=\sum_{i<j}e_{ij}^2 (efa_engine.py:592–593); bu, köşegen dışı artıkların gerçek karekök ortalamasıdır (Harman 1976). Tanım çıktıda formülüyle yazılır. psych fa.stats paydayı p(p-1) alır; değeri \sqrt2 kat küçüktür. sd-düzeltmeli RMSR için de aynı \sqrt2 farkı vardır (psych crms =\sqrt{r^*/(2\,\text{sd})}). Doğrulamada R değeri \sqrt2 ile çarpılarak karşılaştırılmıştır.
86.5.11 Faktör puanları
Ağırlıklar \mathbf W (p\times m) korelasyon matrisinden, puanlar standartlaştırılmış tam satırlardan hesaplanır: \hat{\mathbf F}=\mathbf Z\mathbf W, z_{ti}=(x_{ti}-\bar x_i)/s_i, s_i n-1 bölenli (factor_analysis.py:619–626; efa_engine.py:640–662):
- \mathbf U^2=\operatorname{diag}(1-h_i^2): teklikler.
- Regresyon (Thurstone): \operatorname{E}(\mathbf f\mid\mathbf z)'nin en küçük kareler kestirimi; puanların korelasyonu \boldsymbol\Phi'den farklı olabilir.
- Bartlett: koşullu yansız (puanın beklenen değeri gerçek faktöre eşit).
- Anderson–Rubin: puanlar ilişkisiz ve birim varyanslı (dik çözüm için).
- ten Berge: \mathbf L=\mathbf P\boldsymbol\Phi^{1/2}, \mathbf C=\mathbf R^{-1/2}\mathbf L(\mathbf L^{\top}\mathbf R^{-1}\mathbf L)^{-1/2}, \mathbf W=\mathbf R^{-1/2}\mathbf C\boldsymbol\Phi^{1/2}; puan korelasyonu \boldsymbol\Phi'yi korur.
86.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/factor_analysis/elle_hesap.py ile, MerQur çağrılmadan numpy/scipy ile hesaplanmıştır. ML için MerQur'un L-BFGS-B yolundan farklı bir algoritma (Rubin ve Thayer 1982 EM algoritması), varimax için Kaiser'in ikili düzlem döndürmeleri kullanılmıştır.
Adım 1 — Korelasyon matrisi. 18 madde, n=250. Örnek: r_{\text{q01,q02}}=0{,}684458. Bloklar içinde korelasyonlar 0,62–0,78; bloklar arasında -0{,}24 ile 0{,}10 arasıdır. \lvert\mathbf R\rvert=2{,}2377\times10^{-6}, \ln\lvert\mathbf R\rvert=-13{,}010052.
Adım 2 — KMO ve MSA. Köşegen dışı toplamlar (her çift iki kez):
q01 için \sum_jr^2=2{,}227082, \sum_jq^2=0{,}238154, \text{MSA}_{\text{q01}}=2{,}227082/2{,}465236=0{,}903395. q01–q02 kısmi korelasyonu q_{12}=0{,}275155 (anti-imaj korelasyonu -0{,}275155): iki madde öteki 16 madde sabitken de bir miktar ilişkilidir; ama bu, ham korelasyonun (0,684) yarısından azdır. KMO Kaiser ölçeğinde "mükemmel"dir.
Adım 3 — Bartlett. c=249-41/6=242{,}166667:
Adım 4 — Özdeğerler. \lambda=5{,}0647;\ 4{,}5534;\ 3{,}5060;\ 0{,}4950;\ 0{,}4240;\dots Toplam 18'dir. Üç özdeğer 1'i aşar: Kaiser sayısı 3. İlk üç bileşen toplam varyansın %72,91'ini açıklar. Üçüncü ile dördüncü özdeğer arasında belirgin bir kırılma vardır (3,51 → 0,50).
Adım 5 — Paralel analiz. 100 rastgele 250\times18 standart normal veri (tohum 42):
| k | Gözlenen \lambda_k | Rastgele ort. | Rastgele %95 | Gözlenen (SMC) | Rastgele ort. (SMC) | Rastgele %95 (SMC) |
|---|---|---|---|---|---|---|
| 1 | 5,0647 | 1,5014 | 1,5961 | 4,6812 | 0,5817 | 0,6810 |
| 2 | 4,5534 | 1,3970 | 1,4789 | 4,2363 | 0,4719 | 0,5614 |
| 3 | 3,5060 | 1,3256 | 1,3875 | 3,1228 | 0,3969 | 0,4639 |
| 4 | 0,4950 | 1,2524 | 1,2994 | 0,1243 | 0,3210 | 0,3776 |
| 5 | 0,4240 | 1,1994 | 1,2413 | 0,0640 | 0,2659 | — |
Bileşen tabanlı yöntemde dördüncü gözlenen özdeğer (0,4950) rastgele ortalamanın (1,2524) altına düşer: m_{\text{ort}}=m_{0{,}95}=3. Faktör tabanlı yöntemde de dördüncü indirgenmiş özdeğer (0,1243) rastgele ortalamanın (0,3210) altındadır: yine 3. Bu veride iki yöntem uyuşur. Rastgele verinin indirgenmiş özdeğerleri bileşen tabanlıdakilerden çok küçüktür (0,58'e karşı 1,50): indirgenmiş matriste örnekleme gürültüsü SMC'ler kadar küçülür.
Şekil 86.1. Yamaç grafiği ve iki tür paralel analiz. Sol: korelasyon matrisinin özdeğerleri (köşegende 1); sağ: köşegenine SMC konmuş indirgenmiş matrisin özdeğerleri. Gözlenen çizginin rastgele veri çizgisini kestiği yer faktör sayısını verir.
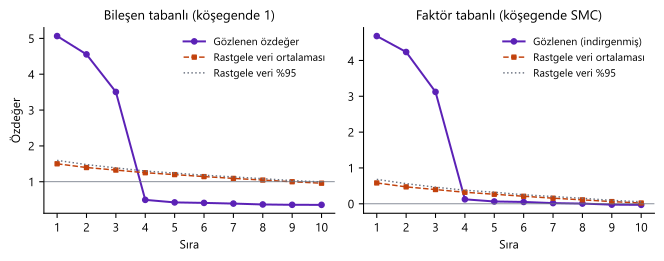
Adım 6 — MAP. Kısmileştirilen bileşen sayısına göre ortalama kare kısmi korelasyon:
| m | 0 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|---|
| \text{MAP}_m (kare) | 0,138460 | 0,142745 | 0,102392 | 0,015802 | 0,020940 |
| 4. kuvvet | 0,061030 | 0,046253 | 0,021304 | 0,000844 | 0,001511 |
İlk bileşen çıkarılınca ortalama artar (0,1385 → 0,1427): ilk bileşen üç bloktan yalnız birini temsil eder, öteki iki bloğun içindeki korelasyonları kısmileştirmez ama bloklar arası küçük korelasyonları büyütür. Üç bileşenden sonra en küçük değere iner: m_{\text{MAP}}=3.
Adım 7 — ML çıkarımı. m=3. Yakınsamış çözümde ölçeklenmiş matrisin ilk üç özdeğeri \gamma=16{,}1010;\ 15{,}0262;\ 10{,}3827; \sqrt{\gamma_k-1}=3{,}8860;\ 3{,}7452;\ 3{,}0631. Sütunlar kareler toplamına göre dizilir. q01 için teklik \psi_1=0{,}357054 ve döndürülmemiş yükler
Amaç fonksiyonu F=0{,}430686. Döndürülmemiş sütunların kareler toplamı 4,7226 / 4,2628 / 3,1670'dir; birinci ve üçüncü sütunda q01–q06 ile q07–q12 aynı anda büyük yük alır (Şekil 86.2 sol): döndürülmemiş çözüm yorumlanamaz.
Adım 8 — Varimax (Kaiser normalizasyonlu). Satırlar h_i'ye bölünür, döndürülür, geri çarpılır. Ham varimax ölçütü V, 0,3349'dan 0,6460'a çıkar. q01'in döndürülmüş yükleri (-0{,}0433;\ 0{,}7985;\ -0{,}0595); h^2 değişmez: 0{,}0019+0{,}6375+0{,}0035=0{,}642946.
Şekil 86.2. Döndürmenin etkisi. Sol: döndürülmemiş ML yüklerinin 1. ve 3. sütunu; iki madde bloğu eksenler arasında yer alır. Sağ: varimax sonrası F2 ve F3; her blok kendi eksenine oturur.
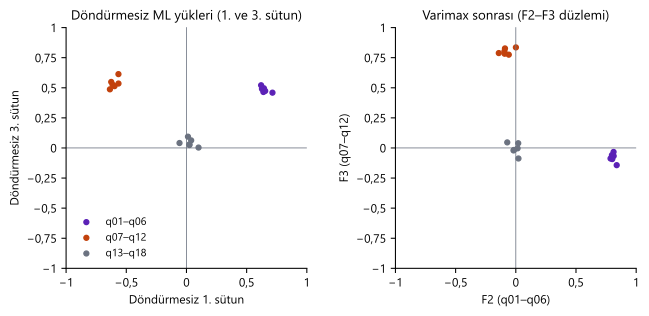
Adım 9 — Açıklanan varyans.
| Faktör | Döndürme KT | % | Birikimli % | Maddeler (\lvert\lambda\rvert\ge0{,}40) |
|---|---|---|---|---|
| F1 | 4,253156 | 23,63 | 23,63 | q13–q18 (0,813–0,875) |
| F2 | 3,978412 | 22,10 | 45,73 | q01–q06 (0,787–0,838) |
| F3 | 3,920799 | 21,78 | 67,51 | q07–q12 (0,775–0,836) |
\sum_ih_i^2=12{,}152367; 12{,}152367/18=\%67{,}51. Çapraz yük yoktur: en büyük ikincil yük q04'ün F3'teki -0{,}143'üdür.
Adım 10 — Uyum. c_m=249-41/6-2=240{,}166667:
Artıklar: \sum_{i<j}e_{ij}^2=0{,}042919; \text{RMSR}=\sqrt{0{,}042919/153}=0{,}016749, \chi^2_{\text{amp}}=250\times0{,}042919=10{,}7297. Üç faktörlü model korelasyonları neredeyse tam üretir.
Adım 11 — Faktör puanı (hasta 1). \mathbf W_{\text{reg}}=\mathbf R^{-1}\mathbf L; hasta 1'in standartlaştırılmış cevaplarıyla \hat{\mathbf f}=(-0{,}3917;\ -1{,}2270;\ 0{,}9500). Bartlett yöntemiyle \hat f_1=-0{,}4182: Bartlett puanları regresyon puanlarından daha geniş yayılır (koşullu yansızlığın bedeli).
Adım 12 — PA + Promax (karşılaştırma). PA 15 yinelemede yakınsar (ilk dört yinelemede en büyük h^2 değişimi 0,0429 → 0,0092 → 0,0023 → 0,0006). Promax sonrası faktör korelasyonları \phi_{12}=-0{,}0191, \phi_{13}=-0{,}0190, \phi_{23}=-0{,}1968. q01'in örüntü yükü F2'de 0,8039, yapı yükü 0,8006. F1'in iki "açıklanan varyans" tanımı \operatorname{diag}(\boldsymbol\Phi\mathbf P^{\top}\mathbf P)=4{,}2545 ve \Sigma S^2=4{,}2572'dir; faktörler neredeyse ilişkisiz olduğundan ikisi yakındır. Faktör korelasyonları bu kadar küçükken eğik döndürme dik döndürmeyle hemen aynı yükleri verir.
86.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan, factor_analysis modülünde round ve p_yuvarla ad alanında etkisizleştirilerek tam hassasiyetle alınmıştır (dogrulama/factor_analysis/merqur_calistir.py). R 4.5.3: psych 2.6.9 (KMO, cortest.bartlett, fa.stats(alpha = .1), VSS()$map, fa(fm = "pa", min.err = 1e-14), fa(fm = "minres"), polychoric), stats::factanal (ML, factr = 1) ve stats::varimax(eps = 1e-14), GPArotation 2026.8.2 oblimin; promax normalleştirilmiş hedef tanımıyla R'de elle. Paralel analizin rastgele kısmı R'de üretilemez; Python aynı tohum ve aynı üreteçle yeniden üretmiştir (fark 0). RMSR satırlarında R değeri \sqrt2 ile çarpılmıştır (86.5.10). Polikorik satırlarında R polychoric'in kendi en iyileme toleransı nedeniyle ayrı mutlak tolerans kullanılmıştır (KMO 3\times10^{-6}, Bartlett χ² göreli 1{,}1\times10^{-6}).
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| KMO (genel) | 0,908606 | 0,908606 | 0,908606 | 4,4e−16 | ✓ |
| MSA q01 | 0,903395 | 0,903395 | 0,903395 | 4,4e−16 | ✓ |
| MSA q18 | 0,873524 | 0,873524 | 0,873524 | 1,7e−15 | ✓ |
| Bartlett χ² | 3150,600820 | 3150,600820 | 3150,600820 | 9,5e−12 | ✓ |
| Determinant det(R) | 2,2377·10−6 | 2,2377·10−6 | — | 8,8e−20 | ✓ |
| Özdeğer λ1 | 5,064677 | 5,064677 | 5,064677 | 8,9e−15 | ✓ |
| Özdeğer λ2 | 4,553402 | 4,553402 | 4,553402 | 3,6e−15 | ✓ |
| Özdeğer λ3 | 3,505970 | 3,505970 | 3,505970 | 8,9e−16 | ✓ |
| Özdeğer λ4 | 0,495006 | 0,495006 | 0,495006 | 2,2e−15 | ✓ |
| SMC q01 (başlangıç ortak varyansı) | 0,612980 | 0,612980 | — | 2,4e−15 | ✓ |
| λ q01, F2 (ML, varimax) | 0,798456 | 0,798456 | 0,798456 | 1,3e−09 | ✓ |
| λ q04, F3 (ML, varimax) | −0,142877 | −0,142877 | −0,142877 | 8,9e−09 | ✓ |
| λ q10, F3 (ML, varimax) | 0,835549 | 0,835549 | 0,835549 | 5,6e−10 | ✓ |
| λ q14, F1 (ML, varimax) | 0,867042 | 0,867042 | 0,867042 | 1,0e−09 | ✓ |
| λ q18, F1 (ML, varimax) | 0,875273 | 0,875273 | 0,875273 | 1,9e−10 | ✓ |
| h² q01 | 0,642946 | 0,642946 | 0,642946 | 5,9e−11 | ✓ |
| h² q18 | 0,766331 | 0,766331 | 0,766331 | 2,8e−10 | ✓ |
| Döndürme KT F1 | 4,253156 | 4,253156 | 4,253156 | 1,6e−09 | ✓ |
| Döndürme KT F2 | 3,978412 | 3,978412 | 3,978412 | 1,9e−08 | ✓ |
| Döndürme KT F3 | 3,920799 | 3,920799 | 3,920799 | 1,8e−08 | ✓ |
| Kümülatif % (3 faktör) | 67,513152 | 67,513152 | — | 6,1e−10 | ✓ |
| Çıkarım KT (sıralı) 1 | 4,722644 | 4,722644 | 4,722644 | 8,9e−10 | ✓ |
| Çıkarım KT (sıralı) 2 | 4,262762 | 4,262762 | 4,262762 | 2,7e−10 | ✓ |
| Çıkarım KT (sıralı) 3 | 3,166961 | 3,166961 | 3,166961 | 1,0e−09 | ✓ |
| ML amaç fonksiyonu | 0,430686 | 0,430686 | 0,430686 | 7,1e−15 | ✓ |
| Uyum χ² (Bartlett düzeltmeli) | 103,436431 | 103,436431 | 103,436431 | 1,7e−12 | ✓ |
| Uyum χ² p | 0,441666 | 0,441666 | 0,441666 | 4,7e−14 | ✓ |
| Boş model χ² | 3150,600820 | 3150,600820 | 3150,600820 | 8,2e−12 | ✓ |
| TLI | 0,999275 | 0,999275 | 0,999275 | 8,9e−16 | ✓ |
| CFI | 0,999521 | 0,999521 | 0,999521 | 7,8e−16 | ✓ |
| RMSEA | 0,006346 | 0,006346 | 0,006346 | 5,3e−15 | ✓ |
| RMSEA %90 GA üst | 0,034114 | 0,034114 | 0,034114 | 2,0e−09 | ✓ |
| BIC | −459,752583 | −459,752583 | −459,752583 | 1,7e−12 | ✓ |
| RMSR (R: psych rms × √2) | 0,016749 | 0,016749 | 0,016749 | 1,9e−12 | ✓ |
| sd-düzeltmeli RMSR (R: crms × √2) | 0,020513 | 0,020513 | 0,020513 | 2,3e−12 | ✓ |
| Ampirik χ² | 10,729691 | 10,729691 | 10,729691 | 2,4e−09 | ✓ |
| Regresyon puanı, hasta 1, F1 | −0,391680 | −0,391680 | −0,391680 | 2,1e−08 | ✓ |
| Regresyon puanı, hasta 1, F2 | −1,227031 | −1,227031 | −1,227031 | 6,3e−09 | ✓ |
| Regresyon puanı, hasta 1, F3 | 0,949953 | 0,949953 | 0,949953 | 1,7e−08 | ✓ |
| Bartlett puanı, hasta 1, F1 | −0,418236 | −0,418236 | −0,418236 | 2,4e−08 | ✓ |
| MAP ort. kısmi r², m = 0 | 0,138460 | 0,138460 | — | 2,5e−16 | ✓ |
| MAP ort. kısmi r², m = 1 | 0,142745 | 0,142745 | 0,142745 | 6,4e−16 | ✓ |
| MAP ort. kısmi r², m = 2 | 0,102392 | 0,102392 | 0,102392 | 5,4e−16 | ✓ |
| MAP ort. kısmi r², m = 3 | 0,015802 | 0,015802 | 0,015802 | 3,6e−16 | ✓ |
| MAP ort. kısmi r², m = 4 | 0,020940 | 0,020940 | 0,020940 | 4,5e−16 | ✓ |
| MAP 4. kuvvet, m = 3 | 0,000844 | 0,000844 | — | 2,0e−17 | ✓ |
| Paralel (bileşen) benzetim ort. 1 | 1,501436 | 1,501436 | — | 0,0e+00 | ✓ |
| Paralel (bileşen) benzetim ort. 2 | 1,397008 | 1,397008 | — | 0,0e+00 | ✓ |
| Paralel (bileşen) benzetim ort. 3 | 1,325595 | 1,325595 | — | 0,0e+00 | ✓ |
| Paralel (bileşen) benzetim ort. 4 | 1,252378 | 1,252378 | — | 0,0e+00 | ✓ |
| Paralel (bileşen) %95 yüzdelik 4 | 1,299401 | 1,299401 | — | 0,0e+00 | ✓ |
| Paralel (faktör) gözlenen 1 | 4,681229 | 4,681229 | 4,681229 | 5,3e−15 | ✓ |
| Paralel (faktör) gözlenen 2 | 4,236345 | 4,236345 | 4,236345 | 5,3e−15 | ✓ |
| Paralel (faktör) gözlenen 3 | 3,122796 | 3,122796 | 3,122796 | 4,9e−15 | ✓ |
| Paralel (faktör) gözlenen 4 | 0,124324 | 0,124324 | 0,124324 | 2,2e−15 | ✓ |
| Paralel (faktör) benzetim ort. 1 | 0,581691 | 0,581691 | — | 0,0e+00 | ✓ |
| Paralel (faktör) benzetim ort. 2 | 0,471926 | 0,471926 | — | 0,0e+00 | ✓ |
| Paralel (faktör) benzetim ort. 3 | 0,396916 | 0,396916 | — | 0,0e+00 | ✓ |
| Paralel (faktör) benzetim ort. 4 | 0,320996 | 0,320996 | — | 0,0e+00 | ✓ |
| Paralel (faktör) %95 yüzdelik 4 | 0,377650 | 0,377650 | — | 0,0e+00 | ✓ |
| Paralel (faktör) önerilen sayı | 3 | 3 | 3 | 0,0e+00 | ✓ |
| PA çıkarım KT F1 (sıralı) | 4,724051 | 4,724051 | 4,724051 | 2,4e−10 | ✓ |
| PA + promax: desen λ q01, F2 | 0,803939 | 0,803939 | 0,803939 | 5,4e−10 | ✓ |
| PA + promax: Φ₁₂ | −0,019098 | −0,019098 | −0,019098 | 8,5e−11 | ✓ |
| PA + promax: Φ₂₃ | −0,196798 | −0,196798 | −0,196798 | 3,9e−11 | ✓ |
| PA + promax: h² q01 | 0,642343 | 0,642343 | — | 8,4e−10 | ✓ |
| PA + promax: yapı λ q01, F2 | 0,800558 | 0,800558 | — | 5,2e−10 | ✓ |
| PA + promax: diag(ΦP′P) F1 | 4,254526 | 4,254526 | — | 4,6e−11 | ✓ |
| PA + promax: ΣS² F1 | 4,257233 | 4,257233 | — | 4,6e−11 | ✓ |
| PA + promax: uyum χ² | 103,700416 | 103,700416 | — | 3,3e−08 | ✓ |
| Minres: teklik q01 (1 − h²) | 0,357657 | — | 0,357657 | 1,2e−09 | ✓ |
| Minres + oblimin: Φ₂₃ | −0,191639 | — | −0,191639 | 4,7e−11 | ✓ |
| Minres + oblimin: desen λ q01, F2 | 0,803457 | — | 0,803457 | 8,1e−10 | ✓ |
| Polikorik KMO | 0,898874 | — | 0,898871 | 3,0e−06 | ✓ (R: 10−5) |
| Polikorik Bartlett χ² | 3881,725162 | — | 3881,729576 | 4,4e−03 | ✓ (R: 10−2) |
Toplam 75 satırın tamamı ölçütü sağlar.
86.7 Çıktıyı okuma
Varsayılan çalıştırmanın gerçek çıktısından (kısaltılmış):
── ÖRNEKLEM YETERLİLİĞİ ──
KMO (genel)          : 0.9086 (Mükemmel)
Bartlett χ²(153) = 3150.60, p < 0.0001
── ÖZDEĞERLER ──
  Faktör 1: 5.0647  ✓ (>1)
  Faktör 2: 4.5534  ✓ (>1)
  Faktör 3: 3.5060  ✓ (>1)
  Faktör 4: 0.4950
Kaiser kuralı: 3 faktör (özdeğer > 1)
Paralel analiz (Horn; bileşen tabanlı: korelasyon matrisi özdeğerleri, köşegende 1;
  100 rastgele veri seti): ortalama ölçütüne göre 3, %95 yüzdeliğine göre 3 faktör
Velicer MAP: 3 faktör (kare ölçüt, en küçük ort. kısmi r² = 0.0158); 4. kuvvet ölçütü: 3
Kullanılan: 3 faktör (rotasyon: varimax)
Çıkarım: En çok olabilirlik (ML) · Döndürme: Varimax (Kaiser normalizasyonlu)
── AÇIKLANAN VARYANS ──
  Faktör 1: %23.6  (kümülatif %23.6)
  Faktör 2: %22.1  (kümülatif %45.7)
  Faktör 3: %21.8  (kümülatif %67.5)
── FAKTÖR YÜKLERİ (rotasyon sonrası) ──
Madde                     F1       F2       F3           h²
q01                       -0.043   +0.798★  -0.059   0.643
q04                       +0.011   +0.838★  -0.143   0.723
q14                       +0.867★  -0.071   +0.046   0.759
── Uyum İyiliği (ML amaç fonksiyonu) ──
  χ²(102) = 103.436, p = 0.442   (amaç fonksiyonu = 0.4307)
  TLI = 0.999   CFI = 1.000   RMSEA = 0.006 [%90 GA 0.000, 0.034]   BIC = -459.75
  RMSR = 0.0167   sd-düzeltmeli RMSR = 0.021   ampirik χ² = 10.73
  RMSR = √(Σ_{j<k} r²_jk / [p(p−1)/2]): köşegen dışı artıkların karekök ortalaması (Harman 1976); sd-düzeltmeli RMSR = √(Σ_{j<k} r²_jk / sd).
── APA 7 ÖZET ──
KMO = .91, χ²(153, N = 250) = 3150.60, p < .001; 3 faktör kümülatif olarak %67.5 varyans açıklar.
| Satır / öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| KMO (genel) | Genel KMO ve Kaiser sınıfı | \ge0{,}60 ise ✓; MSA <0{,}50 maddeler uyarıda |
| Bartlett χ² | Küresellik testi | p<0{,}05 ise korelasyonlar sıfırdan farklı; büyük n'de neredeyse her zaman anlamlıdır, tek başına yeterlilik göstermez |
| Özdeğerler | İlk 10 özdeğer, >1 olanlar işaretli | Yamaç grafiğiyle birlikte okunur |
| Paralel analiz / MAP | İki ölçütün önerdiği sayılar ve tablo | Kaiser ile çelişirse paralel analiz ve MAP'e öncelik verin |
| Kullanılan | Uygulanan m ve döndürme; kural paralel/MAP/sabitse bunu belirten satır | Hangi kuralın kullanıldığını raporlayın |
| Faktör yükleri | Döndürülmüş (eğikte örüntü) yükler; ★ \lvert\lambda\rvert\ge0{,}40; h^2 | Her madde tek faktörde ★ almalı |
| Yapı / Φ (eğik) | \mathbf S=\mathbf P\boldsymbol\Phi ve faktör korelasyonları | \lvert\phi\rvert>0{,}30 ise eğik çözüm raporlanmalı |
| Uyum İyiliği | ML χ², TLI, CFI, RMSEA (GA), BIC, RMSR | RMSEA \le0{,}05 ve RMSR \le0{,}05 iyi; m'yi bir artırıp azaltarak BIC karşılaştırılabilir |
| Uyarılar | n<100, KMO, Bartlett, düşük MSA, Heywood, düşük h^2, çapraz yük, pozitif tanımlı olmayan matris | Her uyarının koşulu 86.2'de |
Determinant uyarısı ("determinant < 0.00001: çoklu doğrusallık / tekillik şüphesi") bu veride de çıkar (tanı ek çıktısı): 18 maddelik, blok içi korelasyonları 0,7 civarında bir ölçekte determinant doğal olarak küçüktür. Uyarı tek başına çoklu doğrusallık kanıtı değildir; madde çiftlerinde \lvert r\rvert>0{,}90 olup olmadığına bakılmalıdır.
APA biçiminde rapor:
On sekiz maddenin faktör yapısı en çok olabilirlik çıkarımı ve Kaiser normalizasyonlu varimax döndürmesiyle incelendi (N = 250). Örneklem yeterliliği mükemmeldi, KMO = ,91; Bartlett küresellik testi anlamlıydı, χ²(153) = 3150,60, p < ,001. Kaiser ölçütü, paralel analiz (100 rastgele veri seti, ortalama ve %95 yüzdelik ölçütleri) ve Velicer MAP ölçütü üç faktörde uyuştu. Üç faktör toplam varyansın %67,5'ini açıkladı (sırasıyla %23,6, %22,1 ve %21,8). Her madde yalnız bir faktöre ,40'ın üzerinde yüklendi (yük aralığı ,78–,88; ortak varyanslar ,61–,77). ML uyum testi üç faktörlü modelin korelasyonları yeterince ürettiğini gösterdi, χ²(102) = 103,44, p = ,442, RMSEA = ,006, %90 GA [,000, ,034], TLI = ,999.
86.8 Uzman soruları
S1. Döndürme yöntemi değişince ortak varyanslar ve uyum χ²'si neden aynı kalıyor?
Her döndürme \mathbf A\mathbf A^{\top}=\mathbf P\boldsymbol\Phi\mathbf P^{\top}'yi korur; model korelasyon matrisi ve teklikler aynıdır. h^2, F ve tüm uyum ölçütleri bu matristen hesaplanır (fit_stats desen ve \boldsymbol\Phi'yi alır ama \mathbf M=\mathbf P\boldsymbol\Phi\mathbf P^{\top} değişmez). Örnekte ML + varimax ve ML + rotasyonsuz χ²'si 103,436'dır. Değişen yalnız yüklerin faktörler arasında dağılımıdır. PA + promax'ta χ² 103,700 olur, çünkü çıkarım yöntemi değişmiştir.
S2. Paralel analiz neden "ortalama" ölçütüyle karar veriyor; psych neden farklı sayı verebilir?
MerQur Horn'un özgün kuralını uygular: gözlenen özdeğer rastgele ortalamayı aştığı sürece say (factor_analysis.py:417). psych fa.parallel varsayılanı %95 yüzdeliktir (Glorfeld'in daha tutucu ölçütü) ve kararını o verir. Ayrıca psych hem benzetilmiş hem yeniden örneklenmiş veri kullanır. MerQur iki sayıyı da yazar; sınırda bir faktörde ortalama ölçütü 1 fazla faktör önerebilir.
S3. Faktör tabanlı paralel analiz neden daha çok faktör önerme eğiliminde?
İndirgenmiş matriste rastgele verinin özdeğerleri çok küçüktür (örnekte ilk ortalama 0,58); gözlenen indirgenmiş özdeğerler de küçülür ama zayıf bir ortak faktörün katkısı daha görünür kalır. Bileşen tabanlı yöntemde her özdeğere 1'e yakın bir "özgül varyans tabanı" eklenir ve zayıf faktörler bu tabanın altında kalabilir. Simülasyon çalışmaları faktör tabanlı yöntemin aşırı faktör önerebildiğini, bileşen tabanlının ise eksik önerebildiğini gösterir; ikisinin uyuşması güçlü bir kanıttır.
S4. Heywood durumunda MerQur ne yapar?
ML, minres ve GLS'de teklikler [0{,}005;\ 1] ile sınırlıdır (PSI_LOWER, efa_engine.py:38); bir \psi_i alt sınırda kalırsa çözüm sınırdadır ve madde adıyla "Heywood durumu" uyarısı çıkar. PA'da sınır yoktur; 1-h_i^2\le0 olursa aynı uyarı verilir. Yükler yine basılır. Heywood genellikle fazla faktör, çok küçük örneklem ya da neredeyse aynı iki maddeye işaret eder; faktör sayısını azaltmak ya da maddeyi gözden geçirmek gerekir. psych de alt sınırı 0,005 alır; sonuçlar aynıdır.
S5. Promax'taki \boldsymbol\Phi R `promax` ile neden farklı çıkar?
MerQur promax hedefini satırı normalleştirilmiş varimax yüklerinden kurar (stats/rotation.py:56–75); yaygın istatistik yazılımlarındaki tanım budur. R stats::promax hedefi normalleştirilmemiş yüklerden kurar. Faktör korelasyonları belirgin olduğunda fark ikinci ondalığa kadar çıkabilir. Hangi yazılımla karşılaştırıldığı raporda yazılmalıdır.
S6. Çift bazında eksik veri seçilirse ML gerçekten "ML" midir?
Hayır, tam anlamıyla değildir. Kestirim yine korelasyon matrisi üzerinde ML ölçütünü en küçükler, ama çift bazında matris tek bir veri setinin örneklem korelasyonu değildir ve χ²'nin dağılımsal dayanağı kalmaz; Bartlett n'i de yaklaşıktır. Matris pozitif tanımlı değilse MerQur düzleştirme yapmaz (psych cor.smooth yapar), yalnız uyarır. Eksik veri oranı yüksekse çoklu atama ya da FIML tabanlı DFA tercih edilmelidir.
S7. Neden KMO "NaN" olabiliyor ve ne zaman?
KMO kısmi korelasyonlar için \mathbf R^{-1}'in köşegenini kullanır. Pozitif tanımlı olmayan matriste (çift bazında Pearson, kimi polikorik matrisler) köşegende sıfır ya da negatif terim çıkabilir; kısmi korelasyon tanımsızdır. MerQur bu durumda KMO ve MSA'ları NaN yapar ve "—" yazar (psych KMO ile aynı); köşegeni kırpıp bir sayı basmak anlamsız bir 0,000 üretirdi.
S8. Uyum ek çıktısındaki RMSR neden psych'in `rms` değerinden büyük?
MerQur köşegen dışı artıkların gerçek karekök ortalamasını verir: \sqrt{\sum_{i<j}e^2/(p(p-1)/2)}. psych fa.stats paydayı p(p-1) alır; değeri \sqrt2 kat küçüktür. Örnekte MerQur 0,0167, psych 0,0118. MerQur birincil kaynağın (Harman 1976) tanımını izler ve tanımı çıktıda yazar; raporlarken hangi tanımın kullanıldığı belirtilmelidir.
S9. Varimax ve Kaiser normalizasyonu R ile birebir aynı mı?
Evet: satır normalizasyonu, varimax ölçütü ve tam yakınsama (\varepsilon=10^{-14}) R stats::varimax(eps = 1e-14) ile aynı döndürülmüş yükleri verir. Fark yalnız işaret ve sütun sırasındadır: MerQur her sütunun toplamını pozitif yapar ve sütunları açıklanan varyansa göre sıralar. Başka yazılımlarda bir faktörün tüm yükleri negatif görünebilir; anlamı aynıdır.
86.9 Sık hatalar ve tuzaklar
- Kaiser kuralına körü körüne güvenmek. p büyüdükçe rastgele verinin bile ilk özdeğerleri 1'i aşar (örnekte 1,50). Paralel analiz ve MAP her zaman basılır; ikisine birlikte bakın.
- Bartlett testini yeterlilik kanıtı saymak. n=250, p=18'de küçük korelasyonlar bile testi anlamlı yapar. Yeterlilik için KMO ve madde MSA'ları okunmalıdır.
- Determinant uyarısını yanlış okumak. \lvert\mathbf R\rvert<10^{-5} uyarısı çok maddeli, iyi ölçeklerde de çıkar. Çoklu doğrusallık için çift korelasyonlarına (\lvert r\rvert>0{,}90) ve madde MSA'larına bakın.
- Eğik çözümde örüntü ile yapıyı karıştırmak. Örüntü yükü maddenin faktöre özgün katkısıdır; yapı yükü korelasyondur. Faktörler ilişkiliyken madde, yüklenmediği faktörle de yüksek yapı katsayısı gösterebilir. Yorum örüntü matrisinden yapılır.
- Eğik çözümde açıklanan varyansları toplamak. \Sigma S^2 değerleri toplanamaz; toplam ortak varyans "Toplam ortak varyans (Σh²/p)" satırındadır.
- Kaiser normalizasyonunu bilmeden kapatmak. Kutunun formdaki varsayılanı açıktır; kapatmak yükleri değiştirir ve R ile karşılaştırmayı bozar.
- Gizleme eşiğini değiştirip etkisini beklemek. "Yük gizleme eşiği" yalnız "sırala/gizle" ek çıktısı açıkken çalışır; kapalıyken değiştirilirse ayar bloğu "gerekli seçenek kapalı" diye not düşer (
factor_analysis.py:587–591). - Yakınsama uyarısını görmezden gelmek. PA ya da ML yakınsamazsa uyarı çıkar (86.5.7); yükler o çözümde güvenilir değildir. Heywood uyarısı, garip derecede büyük ya da 1'e yakın h^2'ler, ya da yöntemden yönteme çok farklı yükler görülürse faktör sayısını ve maddeleri gözden geçirin.
- Likert maddeleri her zaman Pearson'la çözmek. 5'ten az kategorili ya da çarpık maddelerde Pearson korelasyonları küçülür ve yapay "güçlük faktörleri" çıkabilir. Polikorik seçin; örnekte polikorik matrisle açıklanan ortak varyans %67,5'ten %73,0'a çıkar.
- Aynı veride AFA ve DFA yapmak. AFA'nın bulduğu yapıyı aynı veride DFA ile sınamak uyumu yapay olarak iyi gösterir; örneklemi bölün ya da yeni veri toplayın.
86.10 Kaynaklar
- Bartlett, M. S. (1950). Tests of significance in factor analysis. British Journal of Statistical Psychology, 3(2), 77–85. https://doi.org/10.1111/j.2044-8317.1950.tb00285.x
- Bernaards, C. A., & Jennrich, R. I. (2005). Gradient projection algorithms and software for arbitrary rotation criteria in factor analysis. Educational and Psychological Measurement, 65(5), 676–696. https://doi.org/10.1177/0013164404272507
- Crawford, C. B., & Ferguson, G. A. (1970). A general rotation criterion and its use in orthogonal rotation. Psychometrika, 35(3), 321–332. https://doi.org/10.1007/BF02310792
- Fabrigar, L. R., Wegener, D. T., MacCallum, R. C., & Strahan, E. J. (1999). Evaluating the use of exploratory factor analysis in psychological research. Psychological Methods, 4(3), 272–299. https://doi.org/10.1037/1082-989X.4.3.272
- Glorfeld, L. W. (1995). An improvement on Horn's parallel analysis methodology for selecting the correct number of factors to retain. Educational and Psychological Measurement, 55(3), 377–393. https://doi.org/10.1177/0013164495055003002
- Harman, H. H. (1976). Modern factor analysis (3. baskı). University of Chicago Press.
- Harman, H. H., & Jones, W. H. (1966). Factor analysis by minimizing residuals (minres). Psychometrika, 31(3), 351–368. https://doi.org/10.1007/BF02289468
- Hendrickson, A. E., & White, P. O. (1964). Promax: A quick method for rotation to oblique simple structure. British Journal of Statistical Psychology, 17(1), 65–70. https://doi.org/10.1111/j.2044-8317.1964.tb00244.x
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Jennrich, R. I. (2002). A simple general method for oblique rotation. Psychometrika, 67(1), 7–19. https://doi.org/10.1007/BF02294706
- Jöreskog, K. G. (1967). Some contributions to maximum likelihood factor analysis. Psychometrika, 32(4), 443–482. https://doi.org/10.1007/BF02289658
- Jöreskog, K. G., & Goldberger, A. S. (1972). Factor analysis by generalized least squares. Psychometrika, 37(3), 243–260. https://doi.org/10.1007/BF02306782
- Kaiser, H. F. (1958). The varimax criterion for analytic rotation in factor analysis. Psychometrika, 23(3), 187–200. https://doi.org/10.1007/BF02289233
- Kaiser, H. F. (1974). An index of factorial simplicity. Psychometrika, 39(1), 31–36. https://doi.org/10.1007/BF02291575
- O'Connor, B. P. (2000). SPSS and SAS programs for determining the number of components using parallel analysis and Velicer's MAP test. Behavior Research Methods, Instruments, & Computers, 32(3), 396–402. https://doi.org/10.3758/BF03200807
- Rubin, D. B., & Thayer, D. T. (1982). EM algorithms for ML factor analysis. Psychometrika, 47(1), 69–76. https://doi.org/10.1007/BF02293851
- ten Berge, J. M. F., Krijnen, W. P., Wansbeek, T., & Shapiro, A. (1999). Some new results on correlation-preserving factor scores prediction methods. Linear Algebra and its Applications, 289(1–3), 311–318. https://doi.org/10.1016/S0024-3795(97)10007-6
- Timmerman, M. E., & Lorenzo-Seva, U. (2011). Dimensionality assessment of ordered polytomous items with parallel analysis. Psychological Methods, 16(2), 209–220. https://doi.org/10.1037/a0023353
- Tucker, L. R., & Lewis, C. (1973). A reliability coefficient for maximum likelihood factor analysis. Psychometrika, 38(1), 1–10. https://doi.org/10.1007/BF02291170
- Velicer, W. F. (1976). Determining the number of components from the matrix of partial correlations. Psychometrika, 41(3), 321–327. https://doi.org/10.1007/BF02293557