33. Çapraz Tablo
Analiz kimliği: crosstab · Menü adı: Çapraz Tablo · Panel: gui/panels/analyses/crosstab.py (ek istatistikler de panel modülündedir: crosstab_extra satır 329–407, association_measures 192–302, column_proportion_tests 600–664, layer_tables 410–444) · Motor: stats/crosstab.py, CrossTabEngine.build (satır 56–144), chi_square_test (146–211); kesin p: stats/kesin_sayim.py
33.1 Ne işe yarar
Çapraz Tablo, iki kategorik değişkenin ortak dağılımını betimler ve bütün hücre istatistiklerini, ki-kare testlerini ve ilişki ölçülerini tek çıktıda toplar. Cevapladığı sorular şunlardır: "Her hücrede kaç kişi var, satırın ve sütunun yüzde kaçı?", "Dağılım bağımsızlıktan sapıyor mu, sapma hangi hücrelerde?", "İlişki ne kadar güçlü?".
Bağımsızlık hipotezi Bölüm 25'tekiyle aynıdır:
- \pi_{ij}: ortak olasılık; \pi_{i\cdot}, \pi_{\cdot j}: marjinal olasılıklar (Bölüm 25.1).
Ne zaman kullanılır? Kategorik iki değişkenin dağılımı yüzdelerle raporlanacaksa; artıklarla hangi hücrenin sapma yarattığı gösterilecekse; sıralı ve nominal ilişki ölçüleri ASE ve GA ile isteniyorsa; üçüncü bir değişkenin her düzeyinde ayrı tablo (katman) gerekiyorsa; 2×2'de satır oranlarının Wilson GA'sı ve iki yönlü kohort riskleri gerekiyorsa.
Ne zaman kullanılmaz?
- Yalnız bağımsızlık testi ve Yates/G seçenekleri isteniyorsa: Ki-Kare Bağımsızlık (2×2'de varsayılanı Yates'tir).
- Tek yönlü kesin test, koşullu ML OR, Barnard/Boschloo gerekiyorsa: Fisher Kesin Testi.
- Katmanlar üzerinden birleşik test (ortak OR) gerekiyorsa: Cochran–Mantel–Haenszel; bu modül katmanları ayrı ayrı test eder.
- Çok yanıtlı (birden çok seçenek işaretlenebilen) sorular: MR × Kategorik Çapraz Tablo.
- Eşleşik veri: McNemar; uyum: Cohen's Kappa.
Sık karıştırılan analizler. Ki-Kare Bağımsızlık ile aynı Pearson \chi^2'yi verir, ama ana satır her zaman düzeltmesiz Pearson'dur; Yates 2×2'de ek satırdır. Nominal ölçüler burada ASE ve GA ile verilir, Ki-Kare panelinde verilmez. Monte Carlo varsayılan tohumu ve üreteç akışı iki modülde farklıdır (42 ve 12345), bu yüzden aynı veride Monte Carlo p'leri birebir aynı çıkmaz.
33.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsız gözlemler, dışlayıcı kategoriler | Her kişi tek hücrede. | Denetlenmez. |
| Yeterli beklenen frekans (\chi^2 için) | Cochran kuralı (Bölüm 25.2). | En küçük beklenen ve E<5 hücre oranı sonuç nesnesinde saklanır (stats/crosstab.py:168–170); bu modül metinde ayrıca uyarı yazmaz. |
| Sıralı ölçüler için doğru düzey sırası | \gamma, \tau, Somers d ve doğrusal-doğrusal test sıralı değişken ister. | Doğrusal-doğrusal satırıyla birlikte her çalıştırmada kullanılan düzey sırası ve kaynağı yazılır; sıra tanımlanmamışsa (verideki ilk görülme sırası) uyarı verilir (crosstab.py:802–816). |
| En az iki düzey | Testler için her iki değişkende ≥ 2 düzey. | Tek düzeyde testler ve ölçüler atlanır, frekans tablosu ve not verilir (stats/crosstab.py:103–108, crosstab.py:146–151). |
Eksik değer. Tablo pd.crosstab ile kurulur (hypothesis.py:408–424); iki değişkenden biri eksikse satır dışarıda kalır. Künyedeki n, df[[c1, c2]].dropna() satır sayısı ya da (ağırlıkta) toplam ağırlıktır (stats_panel.py:5897–5900).
Uç durumlar. Ağırlık sütununda eksik ya da negatif değer hata verir; 0 ağırlıklı düzeyler atılır ve listelenir (stats/crosstab.py:83–86). Beklenen frekansı 0 olan hücrede artıklar "—" yazılır (crosstab.py:737–739). Katman değişkeni satır, sütun ya da ağırlık değişkeniyle aynıysa katman yapılmaz, not yazılır (crosstab.py:160–162). Kesin p ağırlıklı kesirli sayımlarda hesaplanmaz (crosstab.py:395–397).
33.3 Parametreler
Varsayılanlar crosstab.py:42–122 ve stats_panel.py:5875–5887 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Sütun 1 / Sütun 2 | veriye bağlı | Satır ve sütun değişkeni. | Yüzdeler, yönlü ölçüler (\lambda, U, Somers d) ve RR rol değişince değişir. |
| Sütun oranlarını karşılaştır (z testi, Bonferroni) | kapalı | Her satırda sütun yüzdelerinin ikili z testi, harfler. | Ek bölüm; Frekans sekmesine ikili test tablosu. |
| Güven Düzeyi | %95 | \alpha=1-\text{düzey}. | OR, Wilson, RR, RD, ölçü GA'ları; harf ve artık eşiği metinde 1,96 olarak kalır. |
| Katman (kontrol) | Yok | Üçüncü değişkenin her düzeyi için ayrı tablo ve testler. | Ek bölüm; birleşik test yok. |
| Ek çıktılar: İlişki ölçüleri | kapalı | \gamma, \tau_b, \tau_c, iki Somers d; \lambda (iki yön), U (üç biçim), C; ASE, T, p, GA. | Ek bölüm. Düzey sırası satırları ve sıra uyarısı doğrusal-doğrusal satırıyla birlikte her zaman yazılır. |
| Ek çıktılar: Risk (2×2) | kapalı | İki sütun için kohort RR ve 1. sütun için RD. | Yalnız 2×2; R×C'de not. |
| Ek çıktılar: Monte Carlo p | kapalı | Pearson \chi^2 ve Fisher için B=10000 Monte Carlo p. | Ek satır; ana p değişmez. |
| Ek çıktılar: Kesin p (tam sayım) | kapalı | Fisher–Freeman–Halton kesin p (Bölüm 27.5.6). | Ek satır; sınır aşılırsa not, ana p değişmez. |
| Ağırlık (frekans) sütunu | Yok | Özet (sayım) tablosu girişi. | n = toplam ağırlık; sonuçlar ham veriyle aynı. |
| Sütun 1 / Sütun 2 düzey sırası | boş | Virgülle ayrılmış sıra. | Sıralı ölçüler, doğrusal-doğrusal test, tablo düzeni. |
| Tohum | 42 | Monte Carlo tohumu (seed). | Yalnız Monte Carlo p'leri. |
Neden Monte Carlo ve kesin p burada ana p'yi değiştirmiyor?
Çapraz Tablo bir betimleme modülüdür: ana satır her zaman asimptotik Pearson \chi^2'dir ve öbür testler ayrı satırlarda yan yana durur (build_extra_text, crosstab.py:480–499). Ki-Kare Bağımsızlık modülü ise bir test modülüdür ve kesin/Monte Carlo seçildiğinde kararı o p'ye bağlar (Bölüm 25.3). Aynı veride iki modülün ana p'si bu yüzden farklı olabilir; ikisi de doğrudur ama farklı soruya cevap verir.
33.4 Tıp örneği
Ana dosya: english/datasets/Tip/28_cross_age_symptom.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/28_capraz_yas_semptom.xlsx).
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
age_group |
Sütun 1 (satır) | metin, 3 düzey (sıralı) | 18-40 107, 41-65 141, 66+ 102 |
symptom |
Sütun 2 (sütun) | metin, 4 düzey (nominal) | abdomen pain 80, chest pain 111, fever 89, head pain 70 |
patient_id |
kullanılmaz |
n ve eksik değer: 350 hasta, eksik değer yok. Yaş etiketleri aralık etiketi olarak tanınır ve sayısal sınırlarına göre sıralanır (18-40 < 41-65 < 66+). Semptomlar nominaldir; sıra tanımlanmadığı için verideki ilk görülme sırası kullanılır (abdomen pain, head pain, fever, chest pain) ve çıktı bunu uyarıyla bildirir. Tablolar bu sırayla verilmiştir.
| abdomen pain | head pain | fever | chest pain | Toplam | |
|---|---|---|---|---|---|
| 18-40 | 21 | 23 | 41 | 22 | 107 |
| 41-65 | 30 | 34 | 33 | 44 | 141 |
| 66+ | 29 | 13 | 15 | 45 | 102 |
| Toplam | 80 | 70 | 89 | 111 | 350 |
Klinik soru: Başvuru semptomu yaş grubuna göre değişiyor mu? Gençlerde ateş, yaşlılarda göğüs ağrısı mı öne çıkıyor?
Ek veriler. 2×2 çıktıları (Wilson, kohort RR, Fisher) için Tıp #23 (test × sonuc; İngilizce kopya ağaçta yok, Türkçe kopya kullanıldı, bkz. Bölüm 27.4). Kesin p ve katman için Tıp #26 (26_cmh_treatment_stroke_age.xlsx): age_group × stroke ve katman age_group ile treatment × stroke. Ağırlık yolu için Tıp #28'den 12 satırlık özet tablo (age_group, symptom, frekans) üretilmiştir.
Seçilen ayarlar: Önce varsayılanlar; sonra sütun oranları, ilişki ölçüleri, risk, Monte Carlo ve kesin p kutuları açık.
33.5 Formüller ve hesap adımları
Sıra şudur (crosstab.py:127–166): (1) CrossTabEngine.build tabloyu kurar (ağırlık, sıfır düzey, düzey sırası; Bölüm 25.5.1 ile aynı kural), yüzdeleri, beklenen değerleri, artıkları ve düzeltmesiz Pearson \chi^2'yi hesaplar; 2×2'de Woolf OR ve Wilson GA'larını ekler; (2) istenirse sütun oranı testleri; (3) crosstab_extra her zaman G^2, doğrusal-doğrusal testi ve 2×2'de Fisher p'lerini, isteğe bağlı olarak ölçüleri, riski, Monte Carlo ve kesin p'yi hesaplar; (4) katman tabloları.
33.5.1 Hücre istatistikleri
- Satır yüzdesi, satır değişkeni bağımsız (açıklayıcı) değişken olduğunda karşılaştırılır; sütun yüzdesi tersinde.
- Standart artık r_{ij} ve düzeltilmiş artık d_{ij} Bölüm 25.5.6'daki tanımlardır. |d_{ij}|>1{,}96 hücreler "Beklenenden anlamlı sapan hücreler" satırında listelenir (
crosstab.py:734–742).
Koddaki tercih
Yüzdeler ve beklenen değer pandas.round(2) ile saklanır (stats/crosstab.py:121–124); artıklar yuvarlanmadan saklanır ve gösterimde bir kez yuvarlanır (satır 125–128). Tablo sekmesinin düzeni şöyledir: her satır kategorisi için gözlenen, beklenen, satır %, sütun %, toplam %, iki artık ve "Toplam" satırı (get_table_df, crosstab.py:848–894).
33.5.2 Ki-kare testleri bloğu
Pearson X^2 (düzeltmesiz; R chisq.test(correct = FALSE)), 2×2'de Yates satırı, G^2 ve doğrusal-doğrusal M^2=(n-1)r_{uv}^2 Bölüm 25.5.2–25.5.7'deki formüllerdir. Kodda G^2 ve M^2 ayrıca yazılmıştır (crosstab.py:341–356); puanlar sayısal düzeylerde düzey değeri, değilse 1,\dots,k'dır (_scores, satır 171–176). 2×2 ve tam sayı tabloda Fisher iki yönlü p ve parantezde \min(p_<,p_>) "tek yönlü" p yazılır (crosstab.py:358–363, 493–495).
Doğrusal-doğrusal satırı her zaman basılır, düzey sırası onunla birlikte yazılır
M^2 satırı "Ki-kare testleri" bloğunda her çalıştırmada yer alır; her iki değişkenin kullanılan düzey sırası ve sıranın kaynağı da her zaman onunla birlikte yazılır (crosstab.py:802–816). Sıra şu öncelikle alınır: formdaki düzey sırası alanı, sıralı kategorik sütun, sayısal ya da aralık etiketleri (<55 < 55-70 < >70), tanınan sıralı sözcükler, en son verideki ilk görülme sırası. Alfabetik sıra kullanılmaz. Sıra tanımlanamayan üç ve daha çok düzeyli değişken için "sıra tanımlanmadı" uyarısı basılır. Ki-Kare Bağımsızlık modülü aynı satırı yalnız "Tüm testler" açıkken ve sıra satırıyla birlikte verir.
33.5.3 Sıralı ilişki ölçüleri
\gamma, \tau_b, \tau_c, Somers d(C\mid R) ve d(R\mid C); ASE₁ ve ASE₀ Bölüm 25.5.7'deki formüllerle (Brown ve Benedetti 1977) hesaplanır (association_measures, crosstab.py:229–257). Çıktıdaki T sütunu \text{değer}/\mathrm{ASE}_0, p=2\Phi(-|T|); GA \text{değer}\pm z_{1-\alpha/2}\mathrm{ASE}_1, [-1{,}1]'e kırpılmış.
33.5.4 Nominal ilişki ölçüleri ve ASE'leri
Lambda (Goodman ve Kruskal 1954). r_i=\max_j n_{ij}, r=\max_j n_{\cdot j}, l en büyük sütun toplamının sütunu, l_i satır i'nin en büyük hücresinin sütunu:
- \sum_{i:\,l_i=l}r_i: en büyük hücresi, en kalabalık sütuna düşen satırların en büyük hücreleri toplamı (
crosstab.py:259–270). - \lambda_{R\mid C} aynı formülün devrik tabloya uygulanmasıdır. GA [0{,}1]'e kırpılır; ASE₀ verilmediği için T ve p yoktur.
- Simetrik \lambda bu modülde verilmez (Ki-Kare panelinde verilir).
Belirsizlik katsayısı (doğal log), H_R, H_C, H_{RC} Bölüm 25.5.8'deki entropiler:
- U_{R\mid C} satır/sütun rolleri değiştirilerek, simetrik U=2(H_R+H_C-H_{RC})/(H_R+H_C) kendi ASE'siyle verilir (
crosstab.py:271–297). - Üç U'nun p'si aynıdır: olabilirlik oranı G^2'nin p'si. C'nin p'si Pearson \chi^2'ninkidir (
crosstab.py:298–301).
33.5.5 Sütun oranlarının karşılaştırılması ve harfler
z ve Bonferroni Bölüm 25.5.9'daki gibidir (column_proportion_tests, crosstab.py:600–641); havuzlanmış oran 0 ya da 1 ise test yapılmaz ("test edilemez"). Harfler Piepho (2004) ekle-emme algoritmasıyla verilir (crosstab.py:636–656): bütün sütunlar tek grupta başlar; anlamlı her (j,k) çifti için ikisini birden içeren grup, j'siz ve k'sız iki gruba bölünür; başka bir grubun alt kümesi olan gruplar atılır. Aynı harfi paylaşan iki sütunun oranı düzeltilmiş \alpha düzeyinde farklı değildir.
Neden Bonferroni satır içinde?
MerQur her satırı ayrı bir karşılaştırma ailesi sayar; c sütunda m=c(c-1)/2 çift vardır. Satırlar arasında düzeltme yapılmaz; 3×4 tabloda toplam 18 test yapılır ama her satırda çarpan 6'dır. Daha tutucu bir aile tanımı gerekiyorsa p'ler elle 18 ile çarpılmalıdır.
33.5.6 2×2'ye özgü çıktılar
Wilson GA (her satır için 1. sütun oranı, stats/crosstab.py:236–264):
- x: satırın 1. sütundaki sayısı; m: satır toplamı; z=z_{1-\alpha/2}.
- Wilson (1927) skor aralığı; Wald aralığından farklı olarak [0{,}1] dışına taşmaz ve küçük m'de kapsaması nominale yakındır.
Kohort RR (Risk kutusu, crosstab.py:366–385): her iki sütun için \widehat{\text{RR}}_j=(n_{1j}/n_{1\cdot})/(n_{2j}/n_{2\cdot}), log-Wald GA. Hücre 0 olan sütun atlanır. RD yalnız 1. sütun için, Wald GA [-1{,}1]'e kırpılır. OR Woolf aralığıyla, sıfır hücrede Haldane–Anscombe (Bölüm 25.5.10).
33.5.7 Monte Carlo ve kesin p
_mc_pvalues (crosstab.py:305–326), Patefield üreteciyle B=10000 tablo üretir ve aynı tablolar üzerinden iki p verir:
- p_F: Fisher–Freeman–Halton Monte Carlo p'si; p_{\chi^2}: Pearson Monte Carlo p'si.
- Üreteç
random_table(…, seed = tohum).rvs(size = B)biçimindedir; Ki-Kare ve Fisher panellerindekidefault_rng(tohum)+ 10000'lik parça akışından farklıdır. GA verilmez.
Kesin p (crosstab.py:391–405): ffh_kesin_p ile Fisher–Freeman–Halton kesin p'si (algoritma Bölüm 27.5.6). 2×2'de iki yönlü Fisher p'sine eşittir. Hesap sınırı aşılırsa kesin p satırı yerine "Monte Carlo p seçeneğini kullanın" notu ve ayar bloğu kaydı yazılır; Fisher panelinden farklı olarak Monte Carlo'ya kendiliğinden geçilmez.
33.5.8 Katman tabloları
Katman değişkeninin her düzeyi için (sıralama MerQur düzey sırasıyla: kullanıcının tanımladığı sıra, yoksa sayısal/doğal sıra, o da yoksa verideki ilk görülme sırası) aynı kurallarla ayrı bir tablo kurulur ve Pearson \chi^2, G^2 p'si, V ve 2×2'de Fisher p raporlanır (layer_tables, crosstab.py:410–444). Katmanlar arası birleşik test ya da homojenlik testi yoktur; ortak OR için CMH paneli kullanılmalıdır.
33.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/crosstab/elle_hesap.py ile (ki-kare ve sıralı ölçü işlevleri dogrulama/chisquare/elle_hesap.py'den), MerQur kodu çağrılmadan hesaplanmıştır.
Adım 1 — Yüzdeler ve beklenen değerler. 18-40 × fever: satır %'si 41/107=38{,}32, sütun %'si 41/89=46{,}07, toplam %'si 41/350=11{,}71. E_{13}=107\times89/350=27{,}208571. En küçük beklenen E_{32}=102\times70/350=20{,}4; bütün hücreler 5'in üstündedir.
Adım 2 — Pearson χ² ve G². Hücre katkıları:
| abdomen pain | head pain | fever | chest pain | |
|---|---|---|---|---|
| 18-40 | 0,488685 | 0,119626 | 6,990573 | 4,197147 |
| 41-65 | 0,154103 | 1,192908 | 0,227224 | 0,011501 |
| 66+ | 1,386590 | 2,684314 | 4,611961 | 4,947935 |
k=2 için Cohen eşikleri 0{,}071/0{,}212/0{,}354; V=0{,}196 "Küçük".
Adım 3 — Düzeltilmiş artıklar. 18-40 × fever:
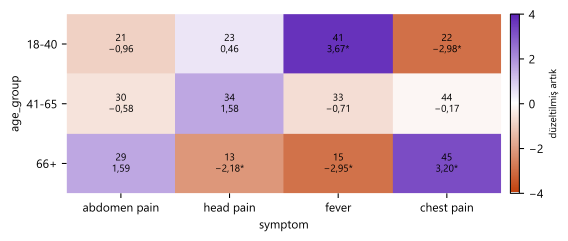
|d|>1{,}96 olan beş hücre: 18-40 × fever (+3,67), 18-40 × chest pain (−2,98), 66+ × head pain (−2,18), 66+ × fever (−2,95), 66+ × chest pain (+3,20). Klinik okuma: ateş gençlerde, göğüs ağrısı yaşlılarda beklenenden sıktır.
Şekil 33.1. Tıp #28'de hücre sayıları ve düzeltilmiş artıklar; mor beklenenden fazla, turuncu beklenenden az; yıldız |d|>1{,}96.
Adım 4 — Doğrusal-doğrusal test. Puanlar yaş 1, 2, 3; semptom ilk görülme sırasıyla 1–4 (abdomen pain, head pain, fever, chest pain). \bar u=1{,}985714, \bar v=2{,}66; çapraz çarpım 15{,}3, kareler toplamları 208,928571 ve 460,54:
Sağ kuyruk olasılığı p=P(\chi^2_1\ge0{,}849)=0{,}3568'dir. Semptomlar alfabetik sırayla puanlansaydı M^2=11{,}66 (p=0{,}0006) çıkardı.
Semptom nominal olduğundan bu "eğilim" yalnız keyfî bir düzey sırasından doğar; yorumlanmamalıdır.
Adım 5 — Sıralı ölçüler (aynı uyarıyla). P=32758 (16379 uyumlu çift), Q=27942 (13971 uyumsuz çift); \gamma=(32758-27942)/60700=0{,}079341, \mathrm{ASE}_1=0{,}066953, T=1{,}185. \tau_b=0{,}056189 (\mathrm{ASE}_1=0{,}047445), \tau_c=0{,}058971, d(C\mid R)=0{,}059629, d(R\mid C)=0{,}052948. Bu değerler matematiksel olarak doğru ama semptom sırası keyfî olduğundan anlamsızdır; MerQur uyarıyı ölçüler açıkken yazar.
Adım 6 — Lambda ve belirsizlik katsayısı. Satır en büyükleri 41+44+45=130, en büyük sütun toplamı 111 (chest pain):
En büyük hücresi chest pain sütununda olan satırlar 41-65 (44) ve 66+'dır (45): \sum_{l_i=l}r_i=89.
Yaşı bilmek semptom tahmin hatasını %7,9 azaltır. Entropiler H_R=1{,}087890, H_C=1{,}371638, H_{RC}=2{,}420652; U_{C\mid R}=(1{,}087890+1{,}371638-2{,}420652)/1{,}371638=0{,}028343, \mathrm{ASE}_1=0{,}010650, GA [0{,}007469;\ 0{,}049217]; p, G^2'ninkidir (0,000132).
Adım 7 — Sütun oranları z testi. 18-40 satırında fever (41/89=0{,}460674) ile chest pain (22/111=0{,}198198): \bar p=63/200=0{,}315,
18-40 satırının harfleri: abdomen pain a, head pain ab, fever b, chest pain a.
Adım 8 — Monte Carlo ve kesin p. Tohum 42, B=10000: Pearson Monte Carlo p'si b=0 ile 1/10001=0{,}0001, Fisher Monte Carlo p'si b=1 ile 2/10001=0{,}0002. Üretilen tablolar sütun sırasına bağlı olduğundan bu sayılar düzey sırası değişince Monte Carlo hatası kadar oynar. Kesin p bu tabloda iş sınırını aşar (Bölüm 27.6, Adım 8); MerQur not yazar.
Adım 9 — 2×2 (Tıp #23). Ana satır düzeltmesiz Pearson X^2=1{,}4479, p=0{,}2289; Yates ek satırı 0{,}6731, p=0{,}4120; Fisher iki yönlü 0{,}2761, tek yönlü \min(0{,}9446;\ 0{,}2066)=0{,}2066; kesin FFH p = Fisher iki yönlü. Sütunlar verideki ilk görülme sırasıyla Pozitif, Negatif'tir; OR =(7\times4)/(8\times9)=0{,}3889. Wilson, Hızlı Test (x=7 Pozitif, m=15, \hat p=0{,}4667): payda 1+1{,}959964^2/15=1{,}256097, merkez 0{,}473463, yarı genişlik 0{,}225367 → [0{,}248095;\ 0{,}698830]. Kohort RR: Pozitif (7/15)/(9/13)=0{,}6741 [0{,}3515;\ 1{,}2927], Negatif 1{,}7333 [0{,}6752;\ 4{,}4499].
Adım 10 — Katmanlar (Tıp #26, treatment × stroke). Birleşik tabloda ilaç grubunda inme 9/180, plaseboda 30/180; X^2=12{,}68, Fisher p=0{,}0005. Katmanlarda (yaş aralıkları sayısal sırayla) Fisher p: <55: 0,0434; 55-70: 0,3223; >70: 0,0246. İlaç grubundaki 3 inme her katmanda aynıdır; etki yaş arttıkça belirginleşir. Katmanlar ayrı ayrı test edildiği için ortak OR ve homojenlik sorusu CMH panelinde sorulmalıdır.
33.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan, stats.crosstab modülünde round ve p_yuvarla bellekte etkisizleştirilerek alınmıştır (dogrulama/crosstab/merqur_calistir.py). Motorun pandas.round(2) ile sakladığı beklenen değer ve yüzdeler 2 ondalıkta karşılaştırılmıştır. R 4.5.3: chisq.test, DescTools (GTest, CramerV, ContCoef, GoodmanKruskalGamma, StuartTauC, SomersDelta, Lambda, UncertCoef, BinomCI(method = "wilson"), OddsRatio), epitools::riskratio.wald, prop.test(correct = FALSE), fisher.test. \tau_b ASE₁ R'de Brown–Benedetti formülüyle doğrudan; Somers d(R\mid C) devrik tablodan (Bölüm 25.5.7). DescTools::UncertCoef GA'yı 0'da kırpmaz; 2×2'de yalnız üst sınır karşılaştırılmıştır. Monte Carlo satırlarında Python aynı üreteç akışını yeniden üretir.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Tıp #28 (3×4) | |||||
| Pearson \chi^2 | 27,012567 | 27,012567 | 27,012567 | 3,6e−14 | ✓ |
| p | 0,000144 | 0,000144 | 0,000144 | 4,9e−19 | ✓ |
| Beklenen E_{11} | 24,46 | 24,457143 | 24,457143 | 4,6e−14 | ✓ (2 ondalık) |
| Satır % (18-40, fever) | 38,32 | 38,317757 | — | 0,0e+00 | ✓ (2 ondalık) |
| Standart artık r_{13} | 2,643969 | 2,643969 | 2,643969 | 4,4e−16 | ✓ |
| Düzeltilmiş artık d_{13} | 3,674524 | 3,674524 | 3,674524 | 8,9e−16 | ✓ |
| Düzeltilmiş artık d_{34} (66+, chest pain) | 3,197829 | 3,197829 | 3,197829 | 3,6e−15 | ✓ |
| Cramér V | 0,196442 | 0,196442 | 0,196442 | 3,6e−16 | ✓ |
| G^2 | 27,213491 | 27,213491 | 27,213491 | 1,8e−14 | ✓ |
| G^2 için p | 0,000132 | 0,000132 | 0,000132 | 5,3e−17 | ✓ |
| Doğrusal-doğrusal M^2 | 0,849069 | 0,849069 | 0,849069 | 1,6e−14 | ✓ |
| M^2 için p | 0,356816 | 0,356816 | 0,356816 | 4,4e−15 | ✓ |
| \gamma | 0,079341 | 0,079341 | 0,079341 | 5,6e−17 | ✓ |
| \gamma GA alt | −0,051885 | −0,051885 | −0,051885 | 6,9e−18 | ✓ |
| \gamma için T (ASE₀) | 1,185183 | 1,185183 | — | 0,0e+00 | ✓ |
| \tau_b ASE₁ | 0,047445 | 0,047445 | 0,047445 | 4,2e−17 | ✓ |
| \tau_c GA üst | 0,156494 | 0,156494 | 0,156494 | 3,9e−16 | ✓ |
| Somers d(C\mid R) GA alt | −0,038950 | −0,038950 | −0,038950 | 2,1e−17 | ✓ |
| Somers d(R\mid C) GA üst | 0,140670 | 0,140670 | 0,140670 | 3,1e−16 | ✓ |
| \lambda(C\mid R) | 0,079498 | 0,079498 | 0,079498 | 0,0e+00 | ✓ |
| \lambda(C\mid R) GA alt | 0,017048 | 0,017048 | 0,017048 | 2,4e−17 | ✓ |
| \lambda(R\mid C) GA üst | 0,160184 | 0,160184 | 0,160184 | 1,4e−16 | ✓ |
| U(C\mid R) | 0,028343 | 0,028343 | 0,028343 | 3,1e−16 | ✓ |
| U(C\mid R) GA alt | 0,007469 | 0,007469 | 0,007469 | 3,3e−16 | ✓ |
| U(R\mid C) GA üst | 0,061990 | 0,061990 | 0,061990 | 3,8e−16 | ✓ |
| U simetrik GA üst | 0,054868 | 0,054868 | 0,054868 | 4,2e−16 | ✓ |
| Olumsallık katsayısı C | 0,267673 | 0,267673 | 0,267673 | 2,8e−16 | ✓ |
| Sütun oranı z (18-40: fever–chest pain) | 3,971280 | 3,971280 | — | 0,0e+00 | ✓ |
| Bonferroni p (18-40: fever–chest pain) | 0,000429 | 0,000429 | 0,000429 | 1,1e−18 | ✓ |
| Bonferroni p (66+: head pain–chest pain) | 0,012230 | 0,012230 | 0,012230 | 2,4e−17 | ✓ |
| Monte Carlo Pearson p (B = 10000, tohum 42) | 9,9990·10−5 | 9,9990·10−5 | — | 0,0e+00 | ✓ |
| Monte Carlo Fisher p | 0,000200 | 0,000200 | — | 0,0e+00 | ✓ |
| Ağırlık sütunuyla \chi^2 (özet veri) | 27,012567 | 27,012567 | 27,012567 | 3,6e−14 | ✓ |
| Tıp #23 (2×2) | |||||
| Pearson \chi^2 (düzeltmesiz, ana satır) | 1,447863 | 1,447863 | 1,447863 | 2,4e−15 | ✓ |
| Yates \chi^2 (ek satır) | 0,673077 | 0,673077 | 0,673077 | 2,2e−16 | ✓ |
| Fisher p iki yönlü | 0,276058 | 0,276058 | 0,276058 | 3,9e−16 | ✓ |
| Fisher tek yönlü \min(p_<, p_>) | 0,206592 | 0,206592 | 0,206592 | 5,0e−16 | ✓ |
| FFH kesin p (= Fisher iki yönlü) | 0,276058 | 0,276058 | 0,276058 | 3,7e−15 | ✓ |
| OR (Woolf) | 0,388889 | 0,388889 | 0,388889 | 1,1e−16 | ✓ |
| Wilson GA alt (Hızlı Test) | 0,248095 | 0,248095 | 0,248095 | 1,4e−16 | ✓ |
| Wilson GA üst (PCR) | 0,873193 | 0,873193 | 0,873193 | 2,2e−16 | ✓ |
| Kohort RR (Pozitif) | 0,674074 | 0,674074 | 0,674074 | 0,0e+00 | ✓ |
| Kohort RR (Pozitif) GA üst | 1,292720 | 1,292720 | 1,292720 | 3,6e−15 | ✓ |
| \lambda(C\mid R) GA üst | 0,688978 | 0,688978 | 0,688978 | 3,3e−16 | ✓ |
| U(C\mid R) GA üst | 0,160479 | 0,160479 | 0,160479 | 3,1e−16 | ✓ |
| Monte Carlo Pearson p | 0,265873 | 0,265873 | — | 0,0e+00 | ✓ |
| Tıp #26 | |||||
| age_group × stroke (3×2) FFH kesin p | 0,558804 | 0,558804 | 0,558804 | 1,4e−12 | ✓ |
| Katman <55: Fisher p | 0,043415 | — | 0,043415 | 1,4e−17 | ✓ |
| Katman <55: \chi^2 | 5,175202 | — | 5,175202 | 1,8e−15 | ✓ |
| Katman 55-70: Fisher p | 0,322347 | — | 0,322347 | 6,1e−16 | ✓ |
| Katman 55-70: \chi^2 | 1,745455 | — | 1,745455 | 4,4e−15 | ✓ |
| Katman >70: Fisher p | 0,024575 | — | 0,024575 | 4,5e−17 | ✓ |
| Katman >70: \chi^2 | 6,171429 | — | 6,171429 | 1,8e−15 | ✓ |
Sonuç: 53 büyüklüğün tamamı ölçütü karşılar; en büyük fark kesin FFH p'sinde 1{,}4\times10^{-12}'dir.
33.7 Çıktıyı okuma
Varsayılan ayarlarla Tıp #28 (kısaltılmış):
Pearson χ²(6)=27.0126, p=0.0001. Cramer's V=0.1964 (Küçük). H₀ REDDEDİLİR.

── Hücre istatistikleri ──
  Hücre                         Gözl.  Beklenen  Satır%  Sütun% Toplam%  St.artık Düz.artık
  18-40 × abdomen pain             21     24.46   19.63   26.25    6.00   -0.699   -0.955
  18-40 × fever                    41     27.21   38.32   46.07   11.71    2.644    3.675
  ...
  66+ × chest pain                 45     32.35   44.12   40.54   12.86    2.224    3.198
  Beklenenden anlamlı sapan hücreler: 18-40 × fever (+3.67), 18-40 × chest pain (-2.98), 66+ × head pain (-2.18), 66+ × fever (-2.95), 66+ × chest pain (+3.20)

── Ki-kare testleri ──
  Pearson χ²                         27.0126     6    0.0001
  Olabilirlik oranı (G²)             27.2135     6    0.0001
  Doğrusal-doğrusal ilişki            0.8491     1    0.3568
  ...
Düzey sırası — age_group: 18-40, 41-65, 66+  [sayısal kodlar, sayısal sıra]
Düzey sırası — symptom: abdomen pain, head pain, fever, chest pain  [verideki ilk görülme sırası — sıra tanımlanmadı]
⚠ Sıralı ölçüler / doğrusal-doğrusal test düzey sırasına bağlıdır; şu değişken(ler)de sıra tanımlanmadı ve verideki ilk görülme sırası kullanıldı: symptom. ...
APA: χ²(6, N = 350) = 27.01, p < .001, V = .20
Ölçüler açıkken (kısaltılmış):
── İlişki ölçüleri ──
                                   Değer      ASE        T         p                %95 GA
  Sıralı × sıralı
    Gamma                         0.0793   0.0670    1.185    0.2359     [-0.0519, 0.2106]
  Nominal × nominal
    Lambda (C|R)                  0.0795   0.0319                  —      [0.0170, 0.1419]
    Belirsizlik kats. (C|R)       0.0283   0.0107             0.0001      [0.0075, 0.0492]
    Olumsallık katsayısı C        0.2677                      0.0001
⚠ Sıralı ölçüler / doğrusal-doğrusal test düzey sırasına bağlıdır; şu değişken(ler)de sıra tanımlanmadı ve verideki ilk görülme sırası kullanıldı: symptom. ...
ℹ Kesin p hesaplanmadı: tam sayım hesap sınırını aşıyor (tahmini iş 4e+06, sınır 4e+06). Bu veri için Monte Carlo p seçeneğini kullanın.
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| İlk satır | Düzeltmesiz Pearson \chi^2, p (4 ondalık; <10^{-4} ise "p<0.0001"), V ve etiket | 2×2'de bile düzeltmesizdir; Yates ayrı satırda. |
| Hücre istatistikleri | Gözlenen, beklenen, üç yüzde, iki artık | Karşılaştırmada bağımsız değişkenin yönündeki yüzde kullanılır. |
| Anlamlı sapan hücreler | |d|>1{,}96 hücreler | Hücre başına \alpha=0{,}05; çoklu karşılaştırma düzeltmesi yok. |
| Ki-kare testleri | Pearson, G^2, doğrusal-doğrusal; 2×2'de Fisher (ve tek yönlü); Monte Carlo ve kesin p satırları | Doğrusal-doğrusal satırı yalnız iki değişken de sıralı ve sıra doğruysa anlamlıdır. |
| İlişki ölçüleri | Değer, ASE₁, T (ASE₀ ile), p, GA | \lambda için T ve p yok; U'nun p'si G^2'den. |
| Risk kestirimleri | İki sütun için kohort RR, 1. sütun için RD | Olay olarak hangi sütunu istediğinize göre satır seçin. |
| ⚠ / ℹ satırları | Sıra tanımlanmadı uyarısı, uygulanamayan seçenek notları | ℹ satırı seçeneğin uygulanmadığını söyler. |
| APA | χ²(6, N = 350) = 27.01, p < .001, V = .20 |
Ondalık noktalı; Türkçe metinde virgüle çevrilmeli. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Başvuru semptomu yaş grubuna göre farklılaştı, \chi^2(6, N = 350) = 27{,}01, p < 0{,}001, Cramér V = 0{,}20. Düzeltilmiş artıklara göre ateş 18–40 yaş grubunda (%38,3; d = 3{,}67), göğüs ağrısı 66 yaş ve üstünde (%44,1; d = 3{,}20) beklenenden sıktı; ateş 66 yaş ve üstünde beklenenden seyrekti (d = -2{,}95).
33.8 Uzman soruları
S1. Aynı 2×2 tabloda Ki-Kare Bağımsızlık 0,412, Çapraz Tablo 0,229 veriyor. Hangisi doğru?
İkisi de doğru hesaplanmıştır, tanımlar farklıdır. Ki-Kare panelinin varsayılanı Yates düzeltmeli \chi^2'dir (R chisq.test varsayılanı); Çapraz Tablo ana satırda düzeltmesiz Pearson'u, Yates'i ek satırda verir (stats/crosstab.py:146–152).
S2. Doğrusal-doğrusal test her zaman çıkıyor; nominal bir değişkende ne anlama gelir?
Hiçbir anlama gelmez. M^2, satır ve sütun puanları arasındaki doğrusal korelasyonu sınar; nominal değişkende puanlar keyfî bir sıradan (verideki ilk görülme sırası) gelir. Tıp #28'de verideki ilk görülme sırasıyla M^2=0{,}85 (p=0{,}357) çıkar; aynı tablo alfabetik semptom sırasıyla M^2=11{,}66 (p=0{,}0006) verirdi. Sonuç tamamen keyfî sıraya bağlıdır. MerQur bu satırı her zaman basar; kullanılan sırayı ve "sıra tanımlanmadı" uyarısını da onunla birlikte yazar.
S3. Lambda neden bu kadar küçük çıkıyor, ilişki yok mu?
\lambda yalnız en sık kategoriyi tahmin etme hatasındaki azalmayı ölçer. Satırların en sık kategorisi genel en sık kategoriyle aynıysa ilişki güçlü olsa bile \lambda sıfıra yakın çıkar. Tıp #28'de 41-65 ve 66+ satırlarında en sık semptom zaten genel en sık olan chest pain'dir; yalnız 18-40 (fever) katkı verir: \lambda_{C\mid R}=0{,}079. V=0{,}196 ve U=0{,}028 başka ölçeklerdir; birbirine çevrilemez.
S4. Bir satırda bütün gözlemler tek sütundaysa ya da tablo tek düzeye inerse ne olur?
Tek düzeyde (r=1 ya da c=1) sd = 0'dır; R chisq.test hata verir. MerQur \chi^2, ölçüler ve testleri atlar, frekans tablosunu ve bir uyarı satırını verir (stats/crosstab.py:99–108, crosstab.py:146–151). Beklenen frekansı 0 olan hücrede artıklar "—" yazılır ve dipnot eklenir. Havuzlanmış oranı 0 ya da 1 olan sütun çifti için z testi "test edilemez" yazılır.
S5. Kesin p seçeneği Fisher panelindekiyle aynı mı? Neden Monte Carlo'ya geçmiyor?
Algoritma ve p tanımı aynıdır (ffh_kesin_p); Tıp #26'da iki panel de 0,558804 verir. Sınır aşıldığında Fisher paneli Monte Carlo'ya geçip test adını değiştirir; Çapraz Tablo kesin satırını yazmaz, Monte Carlo kutusunu öneren bir not yazar. Çapraz Tablo'da Monte Carlo ayrı bir kutudur ve iki p'yi (Pearson ve Fisher) birlikte verir.
S6. Kendall τ_b'nin ASE'si R ile aynı mı?
MerQur Brown ve Benedetti (1977) formülünü kullanır; bu, \tau_b'nin çok terimli model altındaki delta yöntemi varyansıyla aynıdır (sayısal türevle doğrulandı, dogrulama/chisquare/delta_ase.py). DescTools::KendallTauB farklı bir ifade kullanır ve Tıp #21'de ASE'yi %0,2 büyük verir. Görülen yaklaşık 2e-4 göreli fark bu DescTools farkıdır. DescTools::SomersDelta(direction = "row") ise R×C tablolarda hizalama hatası nedeniyle yanlış ASE verir; devrik tabloyla "column" yönü doğrudur.
S7. Sütun oranları z testinde süreklilik düzeltmesi var mı? R'de nasıl tekrar edilir?
Yok. Her çift için prop.test(c(x_j, x_k), c(n_j, n_k), correct = FALSE)$p.value hesaplanır ve satırdaki çift sayısıyla çarpılır (1'de kesilir). Tıp #28 18-40 satırında fever–chest pain çifti için R 0,000429 verir; MerQur aynıdır.
S8. Katman tablolarında her katmanda farklı sonuç çıktı. Tedavi etkisi yaşa göre değişiyor mu?
Bu modül bunu sınamaz; katmanları ayrı ayrı test eder. Tıp #26'da Fisher p <55, 55-70 ve >70 katmanlarında 0,043, 0,32 ve 0,025'tir; küçük katmanlarda (her biri n=120) güç sınırlıdır. Ortak OR ve katmanlar arası OR homojenliği (Breslow–Day) için Cochran–Mantel–Haenszel paneli kullanılmalıdır.
33.9 Sık hatalar ve tuzaklar
- Yanlış yüzdeyi karşılaştırmak. Bağımsız değişken satırdaysa satır yüzdeleri karşılaştırılır; çıktı üç yüzdeyi birlikte verir, seçim kullanıcıya kalır.
- Doğrusal-doğrusal satırını sorgusuz raporlamak. Her çalıştırmada basılır; nominal değişkende ya da sırası tanımlanmamış ("sıra tanımlanmadı" uyarılı) değişkende anlamsızdır.
- Sıralı ölçüleri nominal değişkende yorumlamak. Tıp #28'de \gamma=0{,}08 çıkar (alfabetik sırayla -0{,}23 olurdu); semptomun sırası yoktur.
- Monte Carlo p'yi Ki-Kare panelininkiyle karşılaştırmak. Tohum (42 ve 12345) ve üreteç akışı farklıdır; sonuçlar Monte Carlo hatası kadar farklıdır.
- Katman sonuçlarını birleşik test sanmak. Katmanlar ayrı ayrı test edilir; ortak etki için CMH gerekir.
- Beklenen frekans dipnotunu atlamak. Ki-kare testleri bloğu beklenen frekansı 5'ten küçük hücre sayısını, oranını ve en küçük beklenen frekansı yazar (Ki-Kare modülüyle aynı dipnot); oran yüksekse Fisher ya da Monte Carlo p kullanılmalıdır.
- 2×2'de ana satırın düzeltmesiz olduğunu unutmak. Yates gerekiyorsa ek satırdan okunmalıdır.
33.10 Kaynaklar
- Agresti, A. (2013). Categorical data analysis (3. baskı). Wiley.
- Brown, M. B., & Benedetti, J. K. (1977). Sampling behavior of tests for correlation in two-way contingency tables. Journal of the American Statistical Association, 72(358), 309–315. https://doi.org/10.1080/01621459.1977.10480995
- Freeman, G. H., & Halton, J. H. (1951). Note on an exact treatment of contingency, goodness of fit and other problems of significance. Biometrika, 38(1–2), 141–149. https://doi.org/10.1093/biomet/38.1-2.141
- Goodman, L. A., & Kruskal, W. H. (1954). Measures of association for cross classifications. Journal of the American Statistical Association, 49(268), 732–764. https://doi.org/10.1080/01621459.1954.10501231
- Haberman, S. J. (1973). The analysis of residuals in cross-classified tables. Biometrics, 29(1), 205–220. https://doi.org/10.2307/2529686
- Kendall, M. G. (1945). The treatment of ties in ranking problems. Biometrika, 33(3), 239–251. https://doi.org/10.1093/biomet/33.3.239
- Mantel, N. (1963). Chi-square tests with one degree of freedom; extensions of the Mantel–Haenszel procedure. Journal of the American Statistical Association, 58(303), 690–700. https://doi.org/10.1080/01621459.1963.10500879
- Mehta, C. R., & Patel, N. R. (1983). A network algorithm for performing Fisher's exact test in r × c contingency tables. Journal of the American Statistical Association, 78(382), 427–434. https://doi.org/10.1080/01621459.1983.10477989
- Patefield, W. M. (1981). Algorithm AS 159: An efficient method of generating random R × C tables with given row and column totals. Applied Statistics, 30(1), 91–97. https://doi.org/10.2307/2346669
- Piepho, H.-P. (2004). An algorithm for a letter-based representation of all-pairwise comparisons. Journal of Computational and Graphical Statistics, 13(2), 456–466. https://doi.org/10.1198/1061860043515
- Somers, R. H. (1962). A new asymmetric measure of association for ordinal variables. American Sociological Review, 27(6), 799–811. https://doi.org/10.2307/2090408
- Stuart, A. (1953). The estimation and comparison of strengths of association in contingency tables. Biometrika, 40(1–2), 105–110. https://doi.org/10.2307/2333101
- Wilson, E. B. (1927). Probable inference, the law of succession, and statistical inference. Journal of the American Statistical Association, 22(158), 209–212. https://doi.org/10.1080/01621459.1927.10502953