94. Ağırlıklı Frekans (Karmaşık Örneklem)
Analiz kimliği: survey_freq · Menü adı: Ağırlıklı Frekans (Karmaşık Örneklem) · Panel: gui/panels/analyses/survey_freq.py (form 44–134, execute 137–179) · Ortak seçenekler: gui/panels/analyses/_survey_extras_ui.py (oran GA yöntemi 30–39, apply_svy_extras 292–372) · Motor: stats/survey_design.py, run_survey_freq (1059–1224), run_survey_crosstab (1227–1419), survey_2x2_measures (1433–1477), metin format_freq_text (2401–2452); GA stats/survey_extras.py, prop_ci (212–232) · Çağıran: stats_panel.py:8051–8099
Bu bölüm, Bölüm 93'te anlatılan karmaşık örneklem kuramını (ağırlık, tabaka, küme, Taylor doğrusallaştırması, tasarım sd'si, DEFF) bilindiği varsayarak yalnız oranlara özgü adımları anlatır.
94.1 Ne işe yarar
Ağırlıklı Frekans, karmaşık örneklem tasarımıyla toplanmış verilerde kategorik bir değişkenin her kategorisi için evren oranını, tasarıma dayalı SH'yi ve güven aralığını verir. İsteğe bağlı ikinci bir kategorik değişkenle iki yönlü ağırlıklı çapraz tablo kurar ve bağımsızlığı Rao–Scott ile Wald testleriyle sınar.
Kestirilen büyüklük, k kategorisinin evrendeki payıdır:
- x_i: i. birimin kategorik yanıtı (ör. sigara durumu).
- \mathbb 1\{x_i=k\}: gösterge; yanıt k ise 1, değilse 0.
- P_k: evrende k kategorisindekilerin oranı.
Çapraz tabloda sıfır hipotez satır ve sütun değişkenlerinin evrende bağımsız olmasıdır:
Ne zaman kullanılır? Anket sorusu kategorikse (sigara içme durumu, eğitim düzeyi, Likert yanıtı) ve evren yüzdelerini tasarımı hesaba katarak raporlamak gerekiyorsa. İki kategorik değişkenin ilişkisini karmaşık örneklemde sınamak için.
Ne zaman kullanılmaz?
- Veri BRÖ ve ağırlıksızsa: Frekans Tablosu ya da Çapraz Tablo; bağımsızlık için Ki-Kare Bağımsızlık Testi.
- Hedef sayısalsa ve ortalaması isteniyorsa: Ağırlıklı Ortalama (Karmaşık Örneklem) (Bölüm 93).
- Kategori sayıları (evrende kaç kişi) isteniyorsa: bu analizdeki "Ağırlıklı frekanslar" ek çıktısı ya da Ağırlıklı Toplam (Karmaşık Örneklem) (Bölüm 95).
- İkili sonuç birden çok açıklayıcıyla açıklanacaksa: Ağırlıklı Lojistik Regresyon (Survey Logistic).
Sık karıştırılan analizler. Klasik Pearson \chi^2 testi gözlemlerin bağımsız ve eşit olasılıkla seçildiğini varsayar. Kümeli ya da ağırlıklı veride bu varsayım bozulur ve test çok sık reddeder. Rao–Scott düzeltmesi aynı X^2'yi tasarım etkileriyle ölçekler. Ağırlıklı frekans tablosunu sıradan ki-kare testine "sıklık ağırlığı" olarak vermek ise n'yi yapay olarak değiştirir; her iki yol da yanlıştır.
94.2 Varsayımlar ve veri türü
Tasarıma ilişkin varsayımlar (doğru tanımlı tasarım, iç içe kümeler, iadeli PSU seçimi, tabaka başına en az 2 PSU) Bölüm 93.2 ile aynıdır.
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Hedef kategorik | Kategoriler sayı ya da metin olabilir. | Hedef listesi kategorik, ikili, metin ve tam sayı kodlu sütunları içerir (survey_freq.py:55–68). Ondalıklı kodlar listeye girmez. |
| Kategoriler ayrık | Her gözlem tek kategoridedir. | Değerler metne çevrilir ve her farklı değer bir kategori sayılır (survey_design.py:1130). |
| Yeterli PSU | Oranlar ve testler büyük PSU sayısı yaklaşımına dayanır. | Denetlenmez; tasarım sd'si raporda yazılır. |
| Çapraz tabloda en az 2×2 | Bağımsızlık testi için iki değişkende de en az iki düzey. | Değilse hata (survey_design.py:1274–1275). |
Eksik değer. Tasarım sütununda eksik olan satır atılır (Bölüm 93.2). Hedefte eksik olan satır domain dışı sayılır; oranlar yalnız yanıt verenler arasında hesaplanır, tasarım tüm örneklemden korunur (survey_design.py:1131–1156). Çapraz tabloda ise satır, sütun ya da ağırlığı eksik olan ve ağırlığı 0 olan satırlar tablodan çıkarılır (survey_design.py:1262–1264). Varyans bu alt kümenin tasarım yapısından hesaplanır.
Uç durumlar.
- Bir kategorinin SH'si NaN ya da 10^{-7}'den küçük çıkarsa, SH tam tasarımla yeniden hesaplanır. Yapısal sıfırsa SH = 0, GA [\hat p,\hat p], DEFF = DEFT = 0 yazılır (
survey_design.py:1176–1187). - Logit GA \hat p=0 ya da 1'de tanımsızdır. SH > 0 ise "—" yazılır; SH = 0 ise [\hat p,\hat p] yazılır (
prop_ci, 214–217). - Çapraz tablo sütunu hedefle aynıysa yok sayılır (
survey_design.py:1081–1082). - 2×2 ölçüleri istenip tablo 2×2 değilse ölçüler hesaplanmaz; ayar bloğuna gerekçesi yazılır (
survey_freq.py:171–178).
94.3 Parametreler
Form survey_freq.py:44–134 ve add_svy_extra_rows(..., "freq") ile kurulur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Ağırlık: | (yok) | Örnekleme ağırlığı; isteğe bağlı, (yok) = tüm ağırlıklar 1. | Oranları, SH'yi ve DEFF'i değiştirir. |
| Tabaka: · Küme / PSU: · FPC (popülasyon): | (yok) | Bölüm 93.3 ile aynı. | SH ve sd. |
| Bağımlı değişken: | ilk kategorik sütun | Oranı kestirilecek kategorik değişken (tek sütun). | Her kategori bir satır. |
| Alt grup (by): | (yok) | Her düzeyde ayrı oran dağılımı (domain). | Ek satırlar. |
| Çapraz tablo sütunu: | (yok) | İkinci kategorik değişken; hedef × sütun çapraz tablo ve bağımsızlık testleri. | Ek blok; tüm örneklemden. |
| 2x2 tabloda odds oranı / risk oranı | kapalı | 2×2 tabloda OR ve iki risk oranı, log ölçeğinde GA. | Ek blok; yalnız 2×2'de. |
| DEFF paydası: | Otomatik | Bölüm 93.5.5. | Yalnız DEFF/DEFT. |
| Güven Düzeyi | %95 | GA düzeyi. | GA. |
| Oran GA yöntemi | Logit dönüşümlü | Logit, Wald (simetrik) ya da Korn-Graubard (beta). | Yalnız GA. |
| Ek çıktılar: Ağırlıklı frekanslar (popülasyon sayıları) + SE, ağırlıksız hücre n | kapalı | Kategori (× domain) başına \sum w\,\mathbb 1\{x=k\} ve Taylor SH'si. | Ek tablo. |
| Ek çıktılar: Ağırlıksız n ve ağırlık toplamı (N̂) · Domainler arası farklar (kontrast) | kapalı | Bölüm 93.3. Kontrast her kategori göstergesi için ayrı kurulur. | Ek tablolar. |
| Tek PSU'lu tabaka · Varyans yöntemi: | certainty · Taylor | Bölüm 93.3. |
Neden varsayılan GA logit?
Oranın örnekleme dağılımı, \hat p 0'a ya da 1'e yakınken simetrik değildir. Simetrik Wald aralığı bu durumda 0'ın altına taşabilir ve küçük oranlarda kapsama olasılığı düşüktür. Logit dönüşümü aralığı (0{,}1) içinde tutar ve küçük oranlarda daha iyi kapsama verir. R svyciprop() varsayılanı da logittir. Bu tercih kodda kayıtlıdır (_survey_extras_ui.py:31–32).
Koddaki tercih: GA her zaman yeniden kurulur
Ortalama ve toplamda GA yalnız güven düzeyi %95 değilse yeniden kurulur. Frekansta ise apply_svy_extras koşulu kind == "freq" olduğunda her zaman doğrudur (_survey_extras_ui.py:304). svy kütüphanesinin döndürdüğü lci/uci hiç kullanılmaz; her satırın GA'sı seçilen yönteme göre prop_ci ile (survey_extras.py:212–232) yeniden hesaplanır. Sonuç metninin sonunda "Güven aralıkları: %95, Logit dönüşümlü (t, tasarım df)." notu bu yüzden her zaman görünür.
Ağırlıksız tasarım. Ağırlık "(yok)" seçilirse her gözlem 1 ağırlık alır (survey_freq.py:155–157, with_unit_weight). Oranlar örneklem yüzdeleridir, SH ise tabaka ve küme yapısından hesaplanır. Ayrıntı Bölüm 93.3'tedir.
94.4 Tıp örneği
Dosya: english/datasets/Tip/79_survey_freq_smoking.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/79_survey_freq_sigara.xlsx). Değişkenler VIDEO_SCRIPT_TR.txt #79 ve SUNUMLAR_TR/79_survey_freq_smoking_TR.pptx ile aynıdır.
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
smoking |
Hedef | 4 kategori | active high, active low, none, old |
weight |
Ağırlık | sürekli | Tabaka içinde sabit: rural 0,85; urban 1,10 |
region |
Tabaka | 2 düzey | rural (n=152), urban (n=248) |
patient_id |
kullanılmaz |
Ağırlıksız hücre sayıları:
| smoking | rural | urban | Toplam |
|---|---|---|---|
| active high | 8 | 9 | 17 |
| active low | 11 | 59 | 70 |
| none | 87 | 96 | 183 |
| old | 46 | 84 | 130 |
| Toplam | 152 | 248 | 400 |
n ve eksik değer: 400 kişi, eksik değer yok. Küme yok. \sum w=402, \sum w/n=1{,}005; ağırlıklar göreli ağırlıktır ve kentsel kesimin evrendeki payını yükseltir.
Klinik soru: Evrende sigara durumunun dağılımı nedir? Sigara durumu yerleşim yeriyle (kır/kent) ilişkili mi?
Seçilen ayarlar: Ağırlık weight, tabaka region, DEFF paydası Otomatik, oran GA yöntemi Logit, %95. Ek çalıştırmalar: Wald ve Korn-Graubard GA; iadesiz DEFF paydası; ağırlıksız; çapraz tablo smoking × region (tabaka belirtilmeden, aşağıya bakın).
Kümeli ikinci örnek. Tıp setindeki 79_anket_sigara_frekans.xlsx gerçek bir kümeli tasarım içerir: 4 bölge (tabaka) × 5 PSU, her PSU'da 25 kişi, toplam 500; hedef smoking (Evet/Hayir), ağırlık weight (\sum w=577{,}368, \sum w/n=1{,}155).
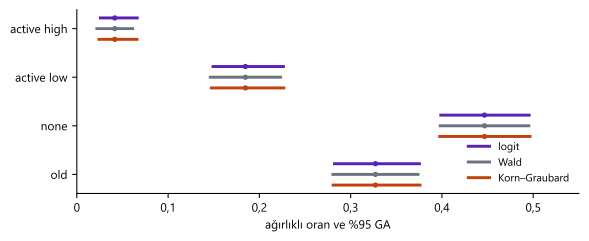
Şekil 94.1. Dört sigara kategorisinin ağırlıklı oranı ve üç yöntemle %95 GA (logit, Wald, Korn–Graubard). Küçük oranda (active high) Wald aralığı simetriktir ve alt sınırı belirgin biçimde aşağıdadır.
94.5 Formüller ve hesap adımları
MerQur'un sırası şudur:
- Tasarımı hazırlar (Bölüm 93.5).
- Hedefte eksik yoksa
svykütüphanesininprop()işleviyle her kategori için oran ve Taylor SH'si alır. Eksik varsa ya da tek PSU kuralı "adjust" ise her kategori göstergesinin domain ortalamasını_domain_taylorile hesaplar. - DEFF'i ekler.
- GA'yı seçilen yönteme göre yeniden kurar.
- İstenirse çapraz tabloyu ve testleri hesaplar.
94.5.1 Oran: göstergenin ağırlıklı ortalaması
Bir kategorinin oranı, gösterge değişkeninin Bölüm 93.5.1'deki ağırlıklı ortalamasıdır:
- \hat p_k: k kategorisinin ağırlıklı oranı; çıktıda
p̂. - z_i^{(k)}: doğrusallaştırılmış değişken; varyans Bölüm 93.5.3'teki formülle hesaplanır.
- Kategorilerin oranları toplamı 1'dir; bu yüzden SH'ler bağımsız değildir.
Küme yoksa ve ağırlık tabaka içinde sabitse varyans sadeleşir:
- \hat p_{hk}: h tabakasında k kategorisinin ağırlıksız oranı.
- n_h-1: tabaka içi örneklem varyansının paydası; s_h^2/n_h=\hat p_{hk}(1-\hat p_{hk})/(n_h-1).
94.5.2 Oran güven aralıkları
Logit (varsayılan). Oran logit ölçeğine taşınır, SH delta yöntemiyle çevrilir, aralık orada kurulur ve geri dönüştürülür (prop_ci, 213–221):
- \eta: oranın logiti; \operatorname{expit}(u)=1/(1+e^{-u}).
- \SH_\eta: logit ölçeğinde SH; d\eta/dp=1/[p(1-p)] türevinden.
- t=t_{1-\alpha/2,\ \sd_{\text{tasarım}}}.
Wald (simetrik). \hat p\pm t\cdot\SH(\hat p) (prop_ci, 230). R svyciprop(method = "mean") ile aynıdır.
Korn–Graubard (beta). Önce tasarım etkisine göre ayarlanmış etkin örneklem büyüklüğü bulunur, sonra Clopper–Pearson tipi beta aralığı kurulur (prop_ci, 222–229):
- n^{*}: tasarım etkisiyle küçültülmüş (ya da büyütülmüş) etkin örneklem; \hat p(1-\hat p)/\SH^2=n/\text{DEFF} yaklaşık eşitliğinden.
- Parantezdeki kare, t dağılımlarının sd farkını düzelten Korn–Graubard çarpanıdır; n, tasarım temizliğinden sonraki gözlem sayısıdır.
- B^{-1}_q(a,b): Beta(a,b) dağılımının q kantili.
- \hat p=0 ise alt sınır 0, \hat p=1 ise üst sınır 1 alınır.
Neden Korn–Graubard?
Çok küçük oranlarda (beklenen olay sayısı az) logit aralığı da yetersiz kalabilir. Korn ve Graubard (1998), BRÖ'de iyi çalışan kesin Clopper–Pearson aralığını tasarıma uyarlamak için gözlem sayısı yerine etkin örneklem büyüklüğünü koymayı önerdi. Aralık tutucudur; nominal kapsamanın altına nadiren düşer. R svyciprop(method = "beta") aynı formülü kullanır; MerQur ile R'nin değerleri 10^{-16} düzeyinde eşleşir.
94.5.3 Oranlarda tasarım etkisi
DEFF Bölüm 93.5.5'teki formülle hesaplanır; gösterge için ağırlıklı varyans s_w^2=\hat p(1-\hat p)\cdot n/(n-1) olur. Otomatik payda FPC verilmemişse iadeli BRÖ'dür (Bölüm 93.5.5). Tıp #79'da FPC yoktur; iadeli payda kullanılır ve DEFF'ler 1 civarındadır. İadesiz payda elle seçilirse 1-400/402=0{,}005 çarpanı paydayı ezer ve DEFF 200'ün üstüne çıkar (94.6, Adım 5).
94.5.4 Çapraz tablo: hücre oranları ve kovaryans
Çapraz tablo sütunu seçilirse r\times c tablo için her hücrenin göstergesi kurulur ve tüm hücre oranları birlikte kestirilir (run_survey_crosstab, 1171–1349):
- \mathbf I_i: rc uzunluğunda gösterge vektörü; gözlemin düştüğü hücrede 1.
- \hat{\mathbf p}: hücre oranları vektörü; \widehat{\mathbf V} onun rc\times rc Taylor kovaryans matrisi (FPC varsa her tabaka 1-f_h ile çarpılır).
- Çıktıda hücre başına \hat p_{ab}, SH ve satır yüzdesi \hat p_{ab}/\hat p_{a\cdot} yazılır.
94.5.5 Pearson X² ve Rao–Scott düzeltmesi
- n: tabloya giren ağırlıksız gözlem sayısı; oranlar ağırlıklıdır.
- \hat p_{a\cdot},\ \hat p_{\cdot b}: satır ve sütun marjinal oranları.
BRÖ'de X^2\sim\chi^2_{(r-1)(c-1)} olur. Karmaşık tasarımda ise X^2, ağırlıkları "genelleştirilmiş tasarım etkileri" olan \chi^2_1'lerin ağırlıklı toplamı gibi dağılır (Rao ve Scott 1981, 1984). Bu ağırlıklar şu matrisin özdeğerleridir:
- \mathbf C: rc\times(r-1)(c-1) boyutlu etkileşim kontrastları; satır ve sütun ana etkilerine dik kalıntı olarak kurulur (
survey_design.py:1341–1351). - Pay: kontrastların tasarım kovaryansı. Payda: aynı kontrastların BRÖ (multinom) kovaryansı.
- \boldsymbol\Delta'nın özdeğerleri \delta_1,\dots,\delta_d: bağımsızlık yönlerindeki tasarım etkileri; d=(r-1)(c-1).
MerQur iki düzeltme verir (R svychisq ile aynı):
Neden iki düzeltme, hangisi raporlanmalı?
Birinci derece düzeltme X^2'yi ortalama tasarım etkisine böler; beklenen değeri doğru yapar ama özdeğerler birbirinden çok farklıysa varyansı yanlış kalır. İkinci derece düzeltme (Satterthwaite tipi) hem ortalamayı hem varyansı eşler: d_0 sd'si, özdeğerlerin yayılımı arttıkça küçülür. Payda sd'si d_0\nu, varyans kestiriminin kendi belirsizliğini F dağılımına taşır. MerQur notu "Önerilen test: Rao-Scott F" der ve APA satırında bu testi yazar; R svychisq() varsayılanı da budur.
R çıktısıyla karşılaştırırken dikkat
R svychisq(statistic = "Chisq") sonucunda istatistik olarak düzeltilmemiş X^2'yi yazar; p değerini ise X^2/\bar\delta'dan hesaplar. MerQur "Rao-Scott χ² (1. derece)" satırında düzeltilmiş değeri (X^2/\bar\delta) yazar. p değerleri aynıdır. Tıp örneğinde R X-squared = 20.555 gösterirken MerQur 22,2839 yazar. Ayrıca X^2_{RS1}=d\cdot F_{RS2} özdeşliği vardır: 3\times7{,}427967=22{,}283900.
94.5.6 Wald ve ayarlı Wald testleri
Wald testi (Koch, Freeman ve Freeman 1975) toplam ölçeğinde kurulur (survey_design.py:1365–1394). İlk r-1 satır ve c-1 sütundaki her hücre için bağımsızlıktan sapma:
- \hat T_{ab}=\sum_i w_iI_{i,ab}: hücre toplamı; \widehat{\mathbf V}_T hücre toplamlarının Taylor kovaryansı.
- \mathbf J: \mathbf Y'nin hücre toplamlarına göre türev matrisi (delta yöntemi).
- \nu=\#\text{PSU}-H: tasarım sd'si.
- Ayarlı F: Fellegi (1980) düzeltmesi; \nu küçükken Wald testinin aşırı reddetmesini azaltır. \nu-d+1\le0 ise hesaplanmaz.
94.5.7 2×2 tabloda odds oranı ve risk oranları
İstenirse ve tablo 2×2 ise (survey_2x2_measures, 1363–1409), şu tanımlarla:
\SH_{\ln\theta}=\sqrt{\mathbf g^{\top}\widehat{\mathbf V}\mathbf g} hücre oranlarının kovaryansından delta yöntemiyle hesaplanır. Satır ve sütun düzeyleri MerQur düzey sırasındadır (Veri sekmesinde tanımlı sıra; yoksa sayısal ya da doğal sıra; o da yoksa verideki ilk görülme sırası); referans grup notta yazılır. Tıp #79 tablosu 4×2 olduğundan bu bölümde sayısal örneği yoktur ve doğrulama tablosunda yer almaz.
94.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Değerler dogrulama/survey_means/elle_hesap.py (ortak betik, freq() işlevi) ile numpy'da hesaplanmıştır; çıktı dogrulama/survey_freq/elle_survey_freq.json.
Adım 1 — Ağırlıklı oranlar. Tabaka ağırlık toplamları \hat N_{\text{rural}}=0{,}85\times152=129{,}2, \hat N_{\text{urban}}=1{,}10\times248=272{,}8, \hat N=402. active low için:
Dört kategori, verideki ilk görülme sırasıyla: old 0,327114; active low 0,184701; none 0,446642; active high 0,041542. Ağırlıksız oranlar 0,3250; 0,1750; 0,4575; 0,0425'tir; kentte daha sık görülen active low ağırlıkla yükselir.
Adım 2 — Taylor varyansı (active low). Tabaka içi oranlar \hat p_{\text{rural}}=11/152=0{,}072368, \hat p_{\text{urban}}=59/248=0{,}237903:
Adım 3 — Logit GA (active low).
Wald aralığı 0{,}184701\pm0{,}038522=[0{,}146180;\ 0{,}223223]'tür. Logit aralığı sağa kaymıştır, çünkü oran 0'a daha yakındır.
Adım 4 — Korn–Graubard (active low). \hat p(1-\hat p)/\SH^2=0{,}150586/0{,}00038395=392{,}20. t_{0{,}025;\,399}/t_{0{,}025;\,398} oranı 1'e çok yakındır, bu yüzden n^{*}=392{,}20 olur. Beta kantilleri [0{,}147526;\ 0{,}226714] verir. En küçük kategoride (active high, \hat p=0{,}041542, \SH=0{,}009966, n^{*}=400{,}91) üç yöntem belirgin biçimde ayrılır:
| Yöntem | Alt | Üst | Genişlik |
|---|---|---|---|
| Logit | 0,025815 | 0,066201 | 0,040387 |
| Wald | 0,021951 | 0,061134 | 0,039183 |
| Korn–Graubard | 0,024230 | 0,065984 | 0,041754 |
Adım 5 — DEFF (active low). s_w^2=0{,}150964; \widehat V_{\text{BRÖ}}^{\text{iadeli}}=0{,}150964/400=0{,}00037741; \text{DEFF}=0{,}00038395/0{,}00037741=1{,}017322. FPC verilmediği için Otomatik payda iadelidir. İadesiz payda elle seçilirse çarpan (402-400)/402=0{,}004975 olur ve DEFF 204{,}48'e çıkar. Bu değerin tasarımla ilgisi yoktur.
Adım 6 — Ağırlıksız tasarım. Ağırlık "(yok)" ve tabaka region ile oranlar örneklem yüzdeleridir: none için \hat p=0{,}4575, \SH=0{,}024562, logit GA [0{,}409758;\ 0{,}506036]. Ağırlıklı kestirimle (0,446642) fark 1,1 yüzde puanıdır.
Adım 7 — Çapraz tablo smoking × region. Region bu tasarımda tabakadır. Bağımsızlık testi "evrende sigara dağılımı kır ve kentte aynı mı?" sorusunu sınar ve MerQur bu testi tabaka bilgisiyle de kurabilir. Bu örnekte çalıştırma tabaka belirtilmeden yapılmıştır: tek tabaka, her gözlem bir PSU, \nu=399. Hücre oranları ve satır yüzdeleri:
| smoking | rural \hat p | urban \hat p | satır % (rural / urban) |
|---|---|---|---|
| old | 0,097264 | 0,229851 | 29,73 / 70,27 |
| active low | 0,023259 | 0,161443 | 12,59 / 87,41 |
| none | 0,183955 | 0,262687 | 41,19 / 58,81 |
| active high | 0,016915 | 0,024627 | 40,72 / 59,28 |
Özdeğerler 1'in biraz altındadır. Ağırlıklar yalnız iki değer aldığı ve küme olmadığı için tasarım etkisi küçüktür; düzeltilmiş istatistik X^2'den biraz büyüktür. Dört test de bağımsızlığı güçlü biçimde reddeder. Fark esas olarak active low hücresinden gelir: aktif hafif içicilerin %87'si kenttedir, kentin evren payı ise yaklaşık %68'dir.
Adım 8 — Kümeli örnek (Tıp #79, ikinci dosya). 20 PSU, 4 tabaka, \sd=16, t_{0{,}975;\,16}=2{,}119905:
Kümeler yok sayılırsa SH 0,020767 ve sd 496 olur. Kümeleme varyansı 0{,}024272^2/0{,}020767^2=1{,}366 kat artırır; sd'nin 16'ya düşmesi t'yi 1,965'ten 2,120'ye çıkarır. İadeli DEFF 1,421402'dir ve FPC olmadığı için Otomatik payda bunu verir. İadesiz payda elle seçilseydi \sum w/n=1{,}155 ile DEFF 10,6074 çıkardı (Bölüm 93.5.5'teki uyarı).
94.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonuç nesnesinden (dogrulama/survey_means/merqur_calistir.py, freq(); çıktı dogrulama/survey_freq/merqur_survey_freq.json) alınmıştır. R tarafında (r_dogrulama.R) survey 4.5'in svymean(~factor(), deff = TRUE / "replace"), svyciprop(method = "logit" / "mean" / "beta"), svytable + chisq.test (X^2) ve svychisq(statistic = "F" / "Chisq" / "Wald" / "adjWald") işlevleri kullanılmıştır. Ölçüt 10^{-6}'dır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 (survey 4.5) | En büyük fark | Durum |
|---|---|---|---|---|---|
| active high: \hat p | 0,041542 | 0,041542 | 0,041542 | 2,7e−16 | ✓ |
| active high: SH | 0,009966 | 0,009966 | 0,009966 | 6,4e−17 | ✓ |
| active high: logit GA alt | 0,025815 | 0,025815 | 0,025815 | 1,8e−16 | ✓ |
| active high: logit GA üst | 0,066201 | 0,066201 | 0,066201 | 1,7e−15 | ✓ |
| active high: DEFF (wr, otomatik) | 0,995210 | 0,995210 | 0,995210 | 1,3e−14 | ✓ |
| active low: \hat p | 0,184701 | 0,184701 | 0,184701 | 1,1e−15 | ✓ |
| active low: SH | 0,019595 | 0,019595 | 0,019595 | 7,6e−17 | ✓ |
| active low: logit GA alt | 0,149234 | 0,149234 | 0,149234 | 5,7e−15 | ✓ |
| active low: logit GA üst | 0,226356 | 0,226356 | 0,226356 | 8,6e−15 | ✓ |
| active low: DEFF (wr, otomatik) | 1,017322 | 1,017322 | 1,017322 | 7,8e−15 | ✓ |
| none: \hat p | 0,446642 | 0,446642 | 0,446642 | 4,2e−15 | ✓ |
| none: SH | 0,024693 | 0,024693 | 0,024693 | 1,4e−16 | ✓ |
| none: logit GA alt | 0,398752 | 0,398752 | 0,398752 | 1,0e−10 | ✓ |
| none: logit GA üst | 0,495543 | 0,495543 | 0,495543 | 1,0e−10 | ✓ |
| none: DEFF (wr, otomatik) | 0,984400 | 0,984400 | 0,984400 | 1,4e−14 | ✓ |
| old: \hat p | 0,327114 | 0,327114 | 0,327114 | 3,1e−15 | ✓ |
| old: SH | 0,023706 | 0,023706 | 0,023706 | 1,5e−16 | ✓ |
| old: logit GA alt | 0,282317 | 0,282317 | 0,282317 | 7,9e−14 | ✓ |
| old: logit GA üst | 0,375303 | 0,375303 | 0,375303 | 8,3e−14 | ✓ |
| old: DEFF (wr, otomatik) | 1,018693 | 1,018693 | 1,018693 | 1,0e−14 | ✓ |
| active high: Wald GA alt | 0,021951 | 0,021951 | 0,021951 | 7,5e−16 | ✓ |
| active high: Wald GA üst | 0,061134 | 0,061134 | 0,061134 | 1,1e−15 | ✓ |
| active high: Korn–Graubard GA alt | 0,024230 | 0,024230 | 0,024230 | 1,7e−16 | ✓ |
| active high: Korn–Graubard GA üst | 0,065984 | 0,065984 | 0,065984 | 4,0e−16 | ✓ |
| active high: DEFF (iadesiz) | 200,037152 | 200,037152 | 200,037152 | 1,2e−11 | ✓ |
| Ağırlıksız: none \hat p | 0,457500 | 0,457500 | 0,457500 | 0,0e+00 | ✓ |
| Ağırlıksız: none SH | 0,024562 | 0,024562 | 0,024562 | 5,2e−17 | ✓ |
| Hücre active low × rural: \hat p | 0,023259 | 0,023259 | 0,023259 | 1,0e−17 | ✓ |
| Hücre active low × rural: SH | 0,006956 | 0,006956 | 0,006956 | 1,0e−17 | ✓ |
| Hücre none × urban: \hat p | 0,262687 | 0,262687 | 0,262687 | 2,2e−16 | ✓ |
| Hücre none × urban: SH | 0,022748 | 0,022748 | 0,022748 | 1,0e−17 | ✓ |
| Pearson X^2 | 20,555173 | 20,555173 | 20,555173 | 6,0e−14 | ✓ |
| Rao–Scott F (2. derece) | 7,427967 | 7,427967 | 7,427967 | 3,4e−14 | ✓ |
| Rao–Scott d_0 | 2,997354 | 2,997354 | 2,997354 | 1,3e−15 | ✓ |
| Rao–Scott payda sd | 1195,944187 | 1195,944187 | 1195,944187 | 2,5e−12 | ✓ |
| Rao–Scott p | 6,2914·10−5 | 6,2914·10−5 | 6,2914·10−5 | 5,0e−17 | ✓ |
| Rao–Scott \chi^2 (1. derece) | 22,283900 | 22,283900 | 22,283900 | 9,9e−14 | ✓ ¹ |
| Rao–Scott 1. derece p | 5,6934·10−5 | 5,6934·10−5 | 5,6934·10−5 | 2,2e−18 | ✓ |
| Wald F | 9,176731 | 9,176731 | 9,176731 | 9,6e−14 | ✓ |
| Wald p | 6,9536·10−6 | 6,9536·10−6 | 6,9536·10−6 | 8,0e−19 | ✓ |
| Ayarlı Wald F | 9,130733 | 9,130733 | 9,130733 | 9,9e−14 | ✓ |
| Ayarlı Wald p | 7,4160·10−6 | 7,4160·10−6 | 7,4160·10−6 | 1,1e−18 | ✓ |
| Eksik değerli çapraz: Rao–Scott F | 7,745451 | — | 7,745451 | 3,6e−14 | ✓ ² |
| Eksik değerli çapraz: payda sd | 1195,897035 | — | 1195,897035 | 3,9e−12 | ✓ ² |
| Eksik değerli çapraz: Rao–Scott p | 4,0205·10−5 | — | 4,0205·10−5 | 1,0e−17 | ✓ ² |
| Eksik değerli çapraz: Wald F | 9,513107 | — | 9,513107 | 4,6e−13 | ✓ ² |
| Eksik değerli çapraz: tasarım sd | 399 | — | 399 | 0,0e+00 | ✓ ² |
| Kümeli (Tıp #79b): Evet \hat p | 0,292211 | 0,292211 | 0,292211 | 5,6e−16 | ✓ |
| Kümeli: Evet SH | 0,024272 | 0,024272 | 0,024272 | 4,5e−17 | ✓ |
| Kümeli: Evet logit GA alt | 0,243524 | 0,243524 | 0,243524 | 5,6e−13 | ✓ |
| Kümeli: Evet logit GA üst | 0,346177 | 0,346177 | 0,346177 | 5,7e−13 | ✓ |
| Kümeli: tasarım sd | 16 | 16 | 16 | 0,0e+00 | ✓ |
| Kümeli: DEFF (iadeli, otomatik) | 1,421402 | 1,421402 | 1,421402 | 5,1e−15 | ✓ |
| Kümeli: DEFF (iadeli, elle seçim) | 1,421402 | 1,421402 | 1,421402 | 5,1e−15 | ✓ |
¹ R svychisq(statistic = "Chisq") istatistik olarak düzeltilmemiş X^2'yi yazar (94.5.5). Bu satırdaki R değeri, R'nin 2. derece F değerinden d\cdot F ile elde edilmiştir; p değeri doğrudan R'den alınmıştır.
² Eksik değerli çapraz tablo denetimi: Tıp #79'da smokingin 8 değeri (satır 2, 11, 25, 26, 90, 140, 141, 300) silinmiş, MerQur R svychisq(na.rm = TRUE) ile karşılaştırılmıştır. R bu seçenekle eksik gözlemleri domain dışı sayar ve tasarımı korur (\nu=399). Bağımsız Python hesabı bu denetimi kapsamaz.
Sonuç: 54 büyüklüğün tamamı ölçütü karşılar. En büyük fark logit GA sınırlarında 10^{-10} düzeyindedir: R svyciprop(method = "logit") aralığı svyglm(quasibinomial) uydurmasından kurar ve IRLS yakınsama toleransı bu farkı doğurur. 2×2 ölçüleri ve ek çıktılar tabloda yer almaz.
94.7 Çıktıyı okuma
Varsayılan ayarlarla sonuç metni (künye kısaltılmış):
Karmaşık Anket — Ağırlıklı Frekans (Taylor SE)
  N (gözlem)     = 400
  PSU sayısı     = 400 (küme yok: her gözlem bir PSU)
  Tabaka sayısı  = 2
  Tasarım df     = 398

  old              p̂ =  0.3271   SE =  0.0237   %95 GA = [ 0.2823,  0.3753]
  active low       p̂ =  0.1847   SE =  0.0196   %95 GA = [ 0.1492,  0.2264]
  none             p̂ =  0.4466   SE =  0.0247   %95 GA = [ 0.3988,  0.4955]
  active high      p̂ =  0.0415   SE =  0.0100   %95 GA = [ 0.0258,  0.0662]

Tasarım etkisi (DEFF = tasarım varyansı / BRÖ varyansı, DEFT = √DEFF)
  BRÖ paydası: iadeli, FPC'siz
  (Payda otomatik seçildi: sonlu evren düzeltmesi verilmediği için referans iadeli basit rastgele örneklemdir.)
  old              DEFF =   1.0187   DEFT =   1.0093
  ...
── APA 7 ÖZET ──
  old: p̂ = .327, SE = .024, %95 GA [.282, .375], DEFF = 1.02
  ...
N = 400

Güven aralıkları: %95, Logit dönüşümlü (t, tasarım df).
Çapraz tablo istendiğinde ek blok:
Tasarım-tabanlı bağımsızlık testleri
  Pearson X²                         = 20.5552   df = 3
  Rao-Scott χ² (1. derece)           = 22.2839   df = 3   p = 5.693e-05
  Rao-Scott F (2. derece)            = 7.4280   df = (2.997, 1195.94)   p = 6.291e-05
  Wald F                             = 9.1767   df = (3, 399)   p = 6.954e-06
  Ayarlı Wald F                      = 9.1307   df = (3, 397)   p = 7.416e-06
  Not: çapraz tablo tüm örneklemden hesaplanır (alt grup 'by' uygulanmaz); ν = PSU − tabaka. Önerilen test: Rao-Scott F.
  ...
  smoking × region bağımsızlığı (Rao-Scott): F(3, 1195.94) = 7.43, p < .001
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
p̂, SE, %95 GA |
Kategori oranı, Taylor SH, seçilen yöntemle GA | Logit GA asimetriktir; bu bir hata değildir. |
| DEFF bloğu | Paydanın türü ve kategori başına DEFF/DEFT | Paydayı kontrol edin; göreli ağırlıkta iadesiz DEFF anlamsız büyük olur. |
APA satırı p̂ = .042 |
Oran, SH ve GA | Buradaki p̂ orandır, p değeri değil. Türkçe raporda "oran" ya da "%" kullanın. |
| Pearson X² | Düzeltilmemiş istatistik | p değeri verilmez; tasarımda geçersizdir. |
| Rao-Scott F | Önerilen test; kesirli sd | APA satırına bu test yazılır; sd'ler iki ondalığa yuvarlanır. |
| Wald / Ayarlı Wald | Toplam ölçeğinde test | Az PSU'lu tasarımda ayarlı Wald, Wald'dan daha güvenilirdir. |
| Uyarı satırları | Eksik değer, tek PSU, FPC notları | Bölüm 93.7. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Bölgeye göre tabakalanmış ve ağırlıklandırılmış örneklemde (n=400; tasarım sd = 398), evrendeki aktif içici oranı %22,6 olarak kestirildi (aktif yoğun %4,2, %95 GA [2,6; 6,6]; aktif hafif %18,5, %95 GA [14,9; 22,6]; logit dönüşümlü GA). Hiç içmeyenlerin oranı %44,7 (%95 GA [39,9; 49,6]), bırakmışların oranı %32,7 (%95 GA [28,2; 37,5]) idi. Sigara durumu yerleşim yeriyle ilişkiliydi; Rao–Scott düzeltmeli test F(3{,}00;\ 1195{,}94)=7{,}43, p<0{,}001.
94.8 Uzman soruları
S1. GA neden logit? Wald seçersem ne değişir?
Logit aralığı (0{,}1) içinde kalır ve küçük oranlarda daha iyi kapsama verir; R svyciprop varsayılanıdır. Wald aralığı simetriktir ve küçük oranlarda alt sınırı fazla aşağı çeker; active high için logit [0{,}0258;\,0{,}0662], Wald [0{,}0220;\,0{,}0611] verir. Orta oranlarda (0,3–0,7) yöntemler pratikte aynıdır. Çok küçük beklenen sayılarda Korn–Graubard en tutucu seçenektir.
S2. Rao–Scott F'nin sd'si neden 2,997 gibi kesirli?
İkinci derece düzeltmede F'nin pay sd'si d_0=(\operatorname{tr}\boldsymbol\Delta)^2/\operatorname{tr}(\boldsymbol\Delta^2)'dir. Tüm özdeğerler eşitse d_0=d=3 olur; yayıldıkça küçülür. Payda sd'si d_0\nu'dur ve varyans kestiriminin belirsizliğini taşır (survey_design.py:1282–1293). R svychisq aynı formülü kullanır; değerler 10^{-15} düzeyinde eşleşir.
S3. R'de Rao–Scott χ² 20,56 çıkıyor, MerQur 22,28 yazıyor. Hangisi doğru?
İkisi aynı testtir. R svychisq(statistic = "Chisq") istatistik olarak düzeltilmemiş X^2'yi gösterir, ama p'yi X^2/\bar\delta'dan hesaplar. MerQur düzeltilmiş istatistiği yazar. p değerleri (5{,}69\times10^{-5}) aynıdır.
S4. Pearson X²'de neden ağırlıksız n kullanılıyor?
X^2 tanımında ölçek n'dir; ağırlıklı oranlar ağırlıksız n ile çarpılır (survey_design.py:1334–1338). Ağırlık toplamı kullanılsaydı, evren genişletme ağırlıklarında istatistik milyonlarla ölçeklenirdi. Rao–Scott düzeltmesi \boldsymbol\Delta'nın paydasında da aynı n'yi kullanır (\mathbf C^{\top}\mathbf D^{-1}\mathbf C/n); böylece n seçimi düzeltilmiş istatistikte birbirini götürür. R svytable(Ntotal = n) ile aynıdır.
S5. Bir kategoride hiç gözlem yoksa ya da bir kategori tüm örneklemse?
Bir kategori verilen domainde hiç görülmüyorsa ya da hep görülüyorsa SH yapısal olarak sıfırdır. MerQur SH'yi tam tasarımla yeniden hesaplar ve sıfırsa SH = 0, GA [\hat p,\hat p], DEFF = 0 yazar (survey_design.py:1176–1187). R de SH = 0 verir. Logit ve Korn–Graubard aralıkları \hat p\in\{0{,}1\}'de anlamlı bir aralık üretmez; gerekirse kategori birleştirilmelidir.
S6. Çapraz tablo eksik değerleri nasıl ele alıyor? Tek yönlü oranlarla aynı mı?
Evet, aynı ilkeyle. Satır ya da sütun değişkeni eksik olan gözlem domain dışı sayılır; tablodan çıkar ama tabaka ve PSU yapısı tüm örneklemden korunur (run_survey_crosstab, alan yaklaşımı). Böylece bir PSU'nun bütün gözlemleri eksik olsa da PSU sayısı ve \nu değişmez; R svychisq ile aynı sonuç alınır. Alt kümeye süzüp tasarımı yeniden kurmak \nu'yu küçültür ve varyansı yanlış hesaplar. Tıp örneğinde eksik değer yoktur; smokingin 8 değeri silinerek yapılan denetimde Rao–Scott F = 7,7455, payda sd 1195,90 ve \nu=399 bulunur, R svychisq(na.rm = TRUE) ile aynıdır (94.6.1, dipnot ²).
S7. Alt grup (by) seçtim. Çapraz tablo testi alt grupta mı yapılıyor?
Hayır. Not satırının dediği gibi çapraz tablo her zaman tüm örneklemden kurulur ve by uygulanmaz (survey_freq.py:165–168; run_survey_crosstab by_col almaz). Bir alt gruptaki bağımsızlık sınanmak isteniyorsa veri o alt gruba süzülüp analiz yeniden çalıştırılmalıdır. Süzülmüş veriyle yapılan test domain ilkesini bozar; sonuç dikkatle yorumlanmalıdır.
S8. Hedef olarak 1–5 kodlu bir Likert sorusu seçebilir miyim?
Evet. Hedef listesi kategorik, ikili ve metin sütunlarının yanı sıra tam sayı kodlu sayısal sütunları da içerir (survey_freq.py:55–68). Ondalıklı değer içeren sütunlar listeye girmez; ağırlık sütunları bu yüzden hedef adayı olmaz. Her farklı kod bir kategori sayılır.
94.9 Sık hatalar ve tuzaklar
- APA satırındaki
p̂'yi p değeri sanmak.p̂ = .042oranı gösterir; Türkçe raporda "%4,2" yazın. - Pearson X²'yi raporlamak. Pearson satırı yalnız bilgi içindir; tasarımda geçerli test Rao–Scott F'dir.
- Ağırlıklı tabloyu sıradan ki-kare testine vermek. Sıklık ağırlığı olarak verilen anket ağırlıkları n'yi değiştirir; tasarım etkisini ise hiç hesaba katmaz.
- Göreli ağırlıkta "İadesiz" paydayı seçmek. Tıp #79'da FPC olmadan iadesiz payda DEFF'i 200'e çıkarır (kümeli dosyada 10,6). Otomatik ya da "İadeli (WR)" kullanın.
- Ağırlıksız çalıştırmayı evren yüzdesi sanmak. Ağırlık "(yok)" seçilirse yüzdeler örnekleme aittir.
- Tabakayı sütun değişkeni yapıp tabaka olarak da girmek. Mümkündür ve geçerlidir; ama tabaka içi örneklem büyüklükleri tasarımla sabitlendiyse marjinal dağılım rastlantısal değildir. Sorunun "evren düzeyinde fark" mı yoksa "tasarım içinde ilişki" mi olduğu yazılmalıdır.
- 2×2 ölçülerinde düzey sırasını gözden kaçırmak. OR ve RR MerQur düzey sırasındaki ilk satır ve sütuna göre kurulur; sırayı Veri sekmesinde tanımlayabilirsiniz, referans grup notta yazılır.
94.10 Kaynaklar
- Fellegi, I. P. (1980). Approximate tests of independence and goodness of fit based on stratified multistage samples. Journal of the American Statistical Association, 75(370), 261–268. https://doi.org/10.1080/01621459.1980.10477462
- Koch, G. G., Freeman, D. H., & Freeman, J. L. (1975). Strategies in the multivariate analysis of data from complex surveys. International Statistical Review, 43(1), 59–78. https://doi.org/10.2307/1402660
- Korn, E. L., & Graubard, B. I. (1998). Confidence intervals for proportions with small expected number of positive counts estimated from survey data. Survey Methodology, 24(2), 193–201.
- Lumley, T. (2010). Complex surveys: A guide to analysis using R. Wiley. https://doi.org/10.1002/9780470580066
- Rao, J. N. K., & Scott, A. J. (1981). The analysis of categorical data from complex sample surveys: Chi-squared tests for goodness of fit and independence in two-way tables. Journal of the American Statistical Association, 76(374), 221–230. https://doi.org/10.1080/01621459.1981.10477633
- Rao, J. N. K., & Scott, A. J. (1984). On chi-squared tests for multiway contingency tables with cell proportions estimated from survey data. The Annals of Statistics, 12(1), 46–60. https://doi.org/10.1214/aos/1176346391