38. Korelasyon Analizi
Analiz kimliği: correlation · Menü adı: Korelasyon Analizi · Panel: gui/panels/analyses/correlation.py (form 42–103, execute 134–169, kısmi korelasyon 172–238, ek çıktılar corr_extras 306–415) · Motor: stats/regression.py, Regression.correlation (satır 1677–1765), p düzeltmesi _corr_padjust (251–269) · Çağrı: stats_panel.py:4854–4878
38.1 Ne işe yarar
Korelasyon analizi, seçilen sayısal değişkenlerin her çifti için ilişkinin yönünü ve gücünü tek bir katsayıyla özetler ve "evrende ilişki yoktur" hipotezini sınar. Cevapladığı soru şudur: "İki değişken birlikte artıp azalıyor mu ve bu birliktelik rastlantıyla açıklanabilir mi?"
- \rho: seçilen yönteme göre evren katsayısı: Pearson'da doğrusal korelasyon, Spearman'da sıraların korelasyonu, Kendall'da uyumlu ve uyumsuz çift olasılıklarının farkı (\tau).
- Test her çift için ayrı yapılır; m=p(p-1)/2 çift için isteğe bağlı çoklu düzeltme uygulanır.
Aynı modül isteğe bağlı olarak kontrol değişkenleriyle kısmi ve yarı-kısmi korelasyon, sıra korelasyonları için Bonett–Wright/Fieller aralıkları, bootstrap GA, betimleyiciler, Shapiro–Wilk ve Mardia testleri, polikorik/tetrakorik/biserial katsayılar verir.
Ne zaman kullanılır? İki ya da daha çok sürekli (ya da sıralı) değişken arasındaki birlikteliği betimlemek, bir modele girecek açıklayıcılar arasında çoklu doğrusallığı taramak, bir ölçümün başka bir ölçümle ilişkisini raporlamak.
Ne zaman kullanılmaz?
- Bir değişkenin ötekinden kestirimi ya da ortak değişken etkisinin ayrılması isteniyorsa: Çoklu Doğrusal Regresyon.
- İki ölçüm yönteminin uyumu soruluyorsa: korelasyon uyumu ölçmez; Bland–Altman ya da ICC.
- İki değişken kümesi arasındaki ilişki soruluyorsa: Kanonik Korelasyon.
- İki kategorik değişken için: Ki-Kare Testi ya da Çapraz Tablo (Cramér V, φ).
- Kanıtın H_0 lehine de ölçülmesi isteniyorsa: Bayesçi Korelasyon (Bölüm 113).
Sık karıştırılan analizler. Korelasyon bir nedensellik ölçüsü değildir. Kısmi korelasyon kontrol değişkenini iki değişkenden de çıkarır; yarı-kısmi (part) korelasyon yalnız ikinci değişkenden çıkarır ve regresyondaki "benzersiz katkı" ile ilişkilidir. ICC aynı niceliğin ölçümleri arasındaki uyumdur; Pearson r sistematik farkı görmez.
38.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsız gözlemler | Satırlar bağımsız birimlerdir. | Denetlenmez. |
| Doğrusallık (Pearson) | İlişki yaklaşık doğrusaldır; eğrisel ama tekdüze ilişkide Spearman/Kendall uygundur. | "Varsayım kontrolleri" işaretlenince Grafik sekmesinde saçılım matrisi. |
| İki değişkenli normallik (Pearson testi ve GA) | t testi ve Fisher z aralığı ortak normal dağılım altında geçerlidir. | Değişken başına Shapiro–Wilk ve Mardia çok değişkenli çarpıklık/basıklık (aynı kutu). |
| Aykırı değerler | Pearson r tek bir uç noktadan güçlü etkilenir. | Denetlenmez; saçılım grafiği ve bootstrap GA ile görülür. |
| Sayısal veri | Sayıya çevrilemeyen değerler eksik sayılır. | pd.to_numeric(..., errors="coerce") (regression.py:1694). |
Eksik değer. "Eksik veri" seçeneği:
- Çiftli silme (varsayılan): her çift, yalnız o iki değişkende dolu olan satırlarla hesaplanır (
regression.py:1714–1717; matrisDataFrame.corrile, o da çiftlidir). Çift başına n farklı olabilir; künye bu durumda "Gözlem (n, çiftli silme): en küçük–en büyük" satırı yazar (pair_n_range,correlation.py:512–521). - Liste bazında silme: seçili değişkenlerin ve kontrol değişkenlerinin tümünde dolu satırlar kullanılır (
correlation.py:152–156). - Kısmi korelasyonda her çift + kontroller kendi içinde liste bazında silinir (
correlation.py:195).
Uç durumlar:
- Bir çiftte n<3: r matristen gelir; test tanımsız olduğundan p ve GA "—" yazılır (
regression.py:1738–1741). Testin sayısal hata verdiği çiftte de p "—" olur. - Fisher GA n\le3'te, Fieller GA n\le4'te tanımsızdır (—); kırpılarak ±1 yazılmaz (
regression.py:1737–1745). - |r| hesaptan önce 0,999999'a kırpılır (\operatorname{artanh} sonsuz olmasın diye,
1670). - Kısmi korelasyonda n-2-g<1 ise o çift "hesaplanamadı" olur; korelasyon matrisi tekilse sözde ters (pinv) kullanılır ve ayar bloğuna yazılır (
correlation.py:199–210). - Sabit sütun:
pearsonrNaN ve uyarı döndürür; r "—" görünür.
38.3 Parametreler
Varsayılanlar correlation.py:42–120 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Değişkenler: | veriye bağlı | En az 2 sayısal değişken. | Tüm çiftler hesaplanır. |
| Yöntem: | Pearson (parametrik) | Pearson, Spearman (sıralı), Kendall τ. | Katsayı, test ve GA tanımı. |
| Güven Düzeyi: | %95 | \alpha=1-\text{düzey}. | GA genişliği ve yıldız eşiği: p\ge\alpha "ns", p<\alpha ise 0,01 ve 0,001 eşikleriyle "", "", "". |
| Hipotez yönü | Çift yönlü (≠) | Sağ (\rho>0) ya da sol (\rho<0) yönlü. | p tek kuyruklu; GA da tek yönlü olur (bir sınır ±1). |
| p-düzeltmesi (çoklu) | Yok | Bonferroni, Holm, FDR (BH); m = çift sayısı. | Tablodaki p ve yıldızlar düzeltilmiş p'dir; GA düzeltilmez. |
| r için güven aralığı | açık | Fisher z (Pearson ve Spearman), Fieller (Kendall). | GA sütunu. |
| Kontrol değişkenleri (kısmi r): | boş | Seçilirse her çift için kısmi ve yarı-kısmi korelasyon tablosu eklenir. | Kontrol, seçili değişkenlerle çakışıyorsa listeden düşürülür (146). |
| Eksik veri | Çiftli silme | Çiftli ya da liste bazında. | n, r, p. |
| Sıra korelasyonu GA'sı | Fisher z (varsayılan) | Bonett–Wright / Fieller seçilirse ek bir GA tablosu yazılır; Pearson'da devre dışı. | Ana tablodaki GA değişmez. |
| Ek çıktılar: Betimleyiciler ve N | kapalı | Değişken başına N, ortalama, SS; çift başına N. | Ek bölüm. |
| Ek çıktılar: Bootstrap GA | kapalı | Her çift için B=2000 yüzdelik ve BCa GA. | Ek bölüm; Tohum ile tekrarlanabilir. |
| Ek çıktılar: Varsayım kontrolleri | kapalı | Shapiro–Wilk, Mardia; Grafik'te saçılım matrisi. | Ek bölüm; Grafik sekmesi değişir. |
| Ek çıktılar: Polikorik / biserial | kapalı | Sıralı/ikili çiftler için gizil korelasyon. | Ek bölüm. |
| Tohum: | 42 | Bootstrap rastgele sayı üretecinin tohumu (seed). | Yalnız bootstrap GA. |
Neden Spearman GA'sı varsayılanda 1/√(n − 3)?
Fisher'in z=\operatorname{artanh}(r) dönüşümü Pearson r için normal altında varyansı 1/(n-3) olan yaklaşık normal bir değişken verir. Spearman r_s için bu varyans biraz büyüktür; Bonett ve Wright (2000) (1+r_s^2/2)/(n-3)'ü önerir. MerQur ana tabloda basit Fisher SH'sini kullanır, Bonett–Wright'ı ek tablo olarak verir. Aynı veride Bayesçi Korelasyon modülü Spearman için doğrudan Bonett–Wright kullanır (Bölüm 113); iki modülün Spearman GA'ları bu yüzden farklıdır.
38.4 Tıp örneği
Dosya: english/datasets/Tip/33_correlation_5klinik.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/33_korelasyon_5klinik.xlsx).
| Değişken | Rol | Tür | Özet (n = 180) |
|---|---|---|---|
age |
Değişken | sürekli (tam sayı) | O = 57,41; SS = 12,66 |
BMI |
Değişken | sürekli | O = 27,15; SS = 4,22 |
systolic_bp |
Değişken | sürekli (tam sayı) | O = 133,09; SS = 12,11 |
glucose_mg_dL |
Değişken | sürekli (tam sayı) | O = 93,36; SS = 12,88 |
cholesterol_mg_dL |
Değişken | sürekli (tam sayı) | O = 194,91; SS = 23,23 |
patient_id |
kullanılmaz |
n ve eksik değer: 180 hasta, eksik değer yok; bütün çiftlerde n=180.
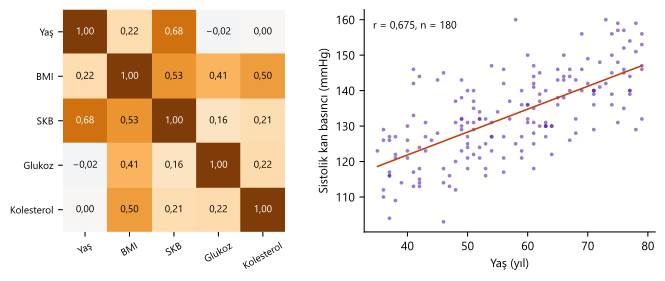
Klinik soru: Beş klinik ölçüm arasında hangi ikili ilişkiler var? Yaşın etkisi çıkarıldığında BMI ile kan basıncı arasındaki ilişki sürer mi? (VIDEO_SCRIPT_TR.txt, #33.)
Seçilen ayarlar: Pearson, %95, çift yönlü, GA açık (varsayılan). Ek çalıştırmalar: Spearman ve Kendall; sağ yönlü; %99; Bonferroni/Holm/BH; Bonett–Wright/Fieller; kontrol age (üç yöntem) ve age + BMI (Holm); betimleyiciler, bootstrap ve varsayım kontrolleri.
Türetilmiş veriler (yalnız bu bölümün doğrulaması için). Tıp setinde eksik değer ve sıralı değişken olmadığından iki kopya üretilmiştir (dogrulama/correlation/merqur_calistir.py): (i) glucose_mg_dL'de patient_id 9'un katı olan, BMI'de 13'ün katı olan satırlar boşaltılmıştır (çiftli n 148–180); (ii) BMI_kat (WHO: <18,5 / 18,5–25 / 25–30 / ≥30 → 1–4; sıklıklar 3, 51, 78, 48), sbp_kat (<120 / 120–140 / ≥140 → 1–3), glukoz_yuksek (glukoz ≥ 100), kolesterol_yuksek (≥ 200) değişkenleri.
Şekil 38.1. Sol: beş değişkenin Pearson korelasyon matrisi. Sağ: en güçlü çift olan yaş ve sistolik kan basıncının saçılımı ve en küçük kareler doğrusu.
38.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) liste bazında silme seçildiyse satırları ayıkla, (2) korelasyon matrisini DataFrame.corr(method) ile hesapla, (3) her çift için scipy testiyle r ve p'yi, ardından GA'yı hesapla, (4) istenirse üst üçgendeki p'lere düzeltme uygula, (5) ek çıktıları (corr_extras) ve kısmi korelasyonları ekle.
38.5.1 Pearson r ve t testi
- S_{xx}, S_{yy}: kareler toplamları; S_{xy}: çapraz çarpımlar toplamı.
- n: çiftteki tam gözlem sayısı.
- p,
scipy.stats.pearsonr(x, y, alternative=...)ile hesaplanır (regression.py:1697,1723); bu fonksiyon H_0 altında r'nin beta dağılımını kullanır, t_{n-2} testiyle sayısal olarak aynıdır.
Neden n − 2?
r, iki ortalamanın kestirildiği bir regresyonun eğimiyle eşdeğerdir; kalıntı varyansında iki serbestlik derecesi harcanır. İki değişkenli normallik ve \rho=0 altında t tam olarak t_{n-2} dağılımına uyar (Fisher 1915).
38.5.2 Spearman ve Kendall
Spearman r_s: değerler ortalama sıralara çevrilir (bağlara ortalama sıra), sıralar üzerinde Pearson r hesaplanır. p, aynı t_{n-2} yaklaşımıyla (spearmanr).
Kendall \tau_b (pandas ve scipy varsayılanı):
- n_1, n_2: x'te ve y'de bağlı olmayan çift sayıları; bağ yoksa ikisi de n(n-1)/2'dir ve \tau_b=\tau_a.
- t, u: x'teki ve y'deki bağ gruplarının büyüklükleri.
- scipy
kendalltau(method="auto") bağ varsa ya da n büyükse bu normal yaklaşımı, küçük ve bağsız örneklemde kesin dağılımı kullanır.
R ile p farkı (Spearman)
scipy spearmanr p'yi her zaman t_{n-2} yaklaşımıyla verir. R cor.test(method = "spearman") bağsız ve n<1290 veride varsayılan olarak kesin p (AS 89) hesaplar; küçük örneklemde iki p farklı olabilir. Bu bölümün doğrulamasında R exact = FALSE ile çalıştırılmıştır (veride bağ vardır, R zaten yaklaşıma geçerdi).
38.5.3 Güven aralığı
| Yöntem | \SH | Kaynak |
|---|---|---|
| Pearson, Spearman (ana tablo) | 1/\sqrt{n-3} | Fisher (1915) |
| Kendall (ana tablo ve ek tablo) | \sqrt{0{,}437/(n-4)} | Fieller, Hartley ve Pearson (1957) |
| Spearman (ek tablo, "Bonett-Wright / Fieller") | \sqrt{(1+r_s^2/2)/(n-3)} | Bonett ve Wright (2000) |
- Yönlü hipotezde z_{1-\alpha/2} yerine z_{1-\alpha} kullanılır ve sağ yönlüde U=1, sol yönlüde L=-1 yazılır (
regression.py:1706,1741–1744). Rcor.test(alternative = "greater")$conf.intile aynı tanım. - Kodda r önce \pm0{,}999999'a kırpılır.
Koddaki tercih: Kendall GA'sı
Kendall \tau için GA, "\tau\pm z\cdot\SH_0" doğrusal aralığı değil, Fieller'in z-dönüşümlü aralığıdır (regression.py:1733–1737). Doğrusal aralık sınırda \pm1'i aşabilir ve kırpılması gerekir; dönüşümlü aralıkta bu sorun yoktur. Kendall seçiliyken "Bonett-Wright / Fieller" seçeneği aynı Fieller aralığını ek tabloda tekrarlar.
38.5.4 Çoklu karşılaştırma düzeltmesi
m üst üçgen p'si için (_corr_padjust, regression.py:251–269):
- p_{(i)}: küçükten büyüğe sıralı i. p.
- Holm aile bazında hata oranını Bonferroni gibi korur ama her zaman ondan güçlüdür; BH yanlış bulgu oranını (FDR) denetler.
- Düzeltilmiş p matrisin iki yarısına da yazılır; GA'lar düzeltilmez.
38.5.5 Kısmi ve yarı-kısmi korelasyon
g kontrol değişkeni Z için, [x,y,Z]'nin korelasyon matrisinin (seçilen yöntemle) tersi P=R^{-1} olmak üzere (partial_correlations, correlation.py:172–238):
- r_{xy\cdot Z}: Z hem x'ten hem y'den çıkarıldıktan sonra kalıntıların korelasyonu.
- r_{x(y\cdot Z)}: yarı-kısmi; Z yalnız y'den çıkarılır: \operatorname{cor}(x,\ y-\hat y_Z). Tek kontrolde \dfrac{r_{xy}-r_{xz}r_{yz}}{\sqrt{1-r_{yz}^2}}.
- Pearson/Spearman testi: t=r\sqrt{(n-2-g)/(1-r^2)}, sd n-2-g. Kendall: z=r\big/\sqrt{2(2(n-g)+5)/(9(n-g)(n-1-g))}.
Koddaki tercih
Bu tanımlar R ppcor::pcor.test ve spcor.test (Kim 2015) ile birebir aynıdır; yarı-kısmi katsayı ppcor'daki gibi kontrolü ikinci değişkenden çıkarır. Kendall kısmi korelasyonu (\tau matrisinin tersi) bir kestirim formülüdür; z testi ppcor'un yaklaşımıdır ve dağılım kuramı zayıftır. Yarı-kısmi katsayı için test verilmez.
38.5.6 Bootstrap GA
Her çift için B=2000 kez n satır yerine koyarak çekilir (correlation.py:345–381; tek bir default_rng(tohum) akışı çiftler boyunca sırayla kullanılır). Yüzdelik GA: bootstrap dağılımının \alpha/2 ve 1-\alpha/2 yüzdelikleri (numpy.percentile, doğrusal ara değerleme). BCa (Efron 1987):
- r_{(i)}: i. gözlem çıkarılarak hesaplanan jackknife katsayısı; \bar r_{(\cdot)} ortalaması.
- BCa sınırları bootstrap dağılımının \alpha_1 ve \alpha_2 yüzdelikleridir. Bütün bootstrap değerleri \hat r'nin bir yanındaysa (\hat z_0 sonsuz) BCa yazılmaz.
38.5.7 Mardia testi
\mathbf X (n\times p) merkezlenmiş, \mathbf S=\mathbf X_c^\top\mathbf X_c/n (n paydalı), d_{ij}=(\mathbf x_i-\bar{\mathbf x})^\top\mathbf S^{-1}(\mathbf x_j-\bar{\mathbf x}) (mardia, correlation.py:284–303):
n<20 iken çarpıklığa küçük örneklem düzeltmesi uygulanır (R MVN ile aynı). Mardia yalnız liste bazında tam vakalarla ve n>p+1 iken hesaplanır.
38.5.8 Polikorik, tetrakorik ve biserial
Her iki değişkende en çok 10 farklı değer varsa polikorik (2×2'de tetrakorik) hesaplanır; biri ikili, öteki 10'dan fazla düzeyliyse biserial (correlation.py:394–414). Polikorik iki aşamalıdır (Olsson 1979): eşikler marjinal birikimli oranlardan a_i=\Phi^{-1}(F_i); sonra \rho, tablonun çok terimli olabilirliğini iki değişkenli normal hücre olasılıklarıyla en büyükler:
Biserial: ikili değişkenin üst düzeyi oranı p, nokta-çift serili korelasyon r_{pb} (ikili değişkenin 0/1 kodlu Pearson r'si) ile
Koddaki tercih
Uç eşikler \pm\infty yerine \pm8 alınır (\Phi(-8)\approx6\times10^{-16}, etkisiz); \rho minimize_scalar(..., bounds=(-0,999, 0,999), xatol=1e-7) ile aranır (correlation.py:269–280). Bu, R polycor::polychor(ML = FALSE) ve psych::polychoric iki aşamalı kestirimidir; SH ve test verilmez. polycor::polychor'un iç eniyileyicisi R optimize() varsayılan toleransıyla (\approx1{,}2\times10^{-4}) durduğundan R çıktısı 4.–5. ondalıkta ayrılabilir; doğrulamada aynı olabilirlik R'de sıkı toleransla yeniden çözülmüştür. Biserial polycor::polyserial(ML = FALSE) ile birebir aynıdır.
38.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/correlation/elle_hesap.py ile, MerQur kodu çağrılmadan hesaplanmıştır (Pearson toplamlardan; Kendall O(n^2) çift sayımıyla; kısmi korelasyon OLS kalıntılarıyla).
Adım 1 — Yaş ve sistolik KB için Pearson r.
Adım 2 — t ve p.
Adım 3 — Fisher z GA. z_r=\operatorname{artanh}(0{,}675415)=0{,}820634, \SH=1/\sqrt{177}=0{,}075165, z_{0{,}975}=1{,}959964:
Sağ yönlü %95 GA: z_{0{,}95}=1{,}644854 ile alt sınır 0{,}602460, üst sınır 1; %99 GA [0{,}555999;\ 0{,}767512].
Adım 4 — Spearman ve Kendall. r_s=0{,}668968, p=1{,}03\times10^{-24}; Fisher GA [0{,}579396;\ 0{,}742574], Bonett–Wright SH \sqrt{(1+0{,}668968^2/2)/177}=0{,}083150 ile [0{,}568905;\ 0{,}749514].
Kendall: n(n-1)/2=16110 çiftten S=7733; yaşta bağsız çift sayısı n_1=15769, sistolik KB'de n_2=15723:
Fieller SH \sqrt{0{,}437/176}=0{,}049829; GA [0{,}413527;\ 0{,}561612].
Adım 5 — Bütün çiftler ve çoklu düzeltme.
| Çift | r | p | Bonferroni | Holm | BH |
|---|---|---|---|---|---|
| Yaş – BMI | 0,2177 | 0,003329 | 0,033291 | 0,016645 | 0,005548 |
| Yaş – SKB | 0,6754 | 2{,}5\times10^{-25} | 2{,}5\times10^{-24} | 2{,}5\times10^{-24} | 2{,}5\times10^{-24} |
| Yaş – glukoz | −0,0173 | 0,817489 | 1 | 1 | 0,908322 |
| Yaş – kolesterol | 0,0035 | 0,962354 | 1 | 1 | 0,962354 |
| BMI – SKB | 0,5292 | 2{,}2\times10^{-14} | 2{,}2\times10^{-13} | 2{,}0\times10^{-13} | 1{,}1\times10^{-13} |
| BMI – glukoz | 0,4100 | 1{,}1\times10^{-8} | 1{,}1\times10^{-7} | 7{,}7\times10^{-8} | 2{,}7\times10^{-8} |
| BMI – kolesterol | 0,4957 | 1{,}5\times10^{-12} | 1{,}5\times10^{-11} | 1{,}2\times10^{-11} | 5{,}0\times10^{-12} |
| SKB – glukoz | 0,1623 | 0,029465 | 0,294645 | 0,088394 | 0,036831 |
| SKB – kolesterol | 0,2103 | 0,004598 | 0,045980 | 0,018392 | 0,006569 |
| Glukoz – kolesterol | 0,2239 | 0,002515 | 0,025147 | 0,015088 | 0,005029 |
SKB–glukoz çifti düzeltmesiz ve BH'de anlamlı, Bonferroni ve Holm'da anlamsızdır.
Adım 6 — Yaş sabitken BMI ve sistolik KB. r_{xy}=0{,}529199 (BMI–SKB), r_{xz}=0{,}217693 (BMI–yaş), r_{yz}=0{,}675415 (SKB–yaş):
Yaş, BMI–SKB ilişkisini neredeyse hiç değiştirmez (0,529 → 0,531). Yaş ve BMI birlikte sabitlenince SKB–glukoz kısmi korelasyonu 0,014'e iner: ham ilişki büyük ölçüde BMI üzerinden gelmektedir.
Adım 7 — Varsayım kontrolleri. Shapiro–Wilk yalnız yaşta anlamlıdır (W=0{,}958602, p=3{,}8\times10^{-5}; yaş dağılımı normalden sapar). Mardia: b_{1{,}5}=1{,}146099, b_{2{,}5}=32{,}988437; çarpıklık 180\times1{,}146099/6=34{,}382962, sd 35, p=0{,}497719; basıklık (32{,}988437-35)/\sqrt{8\cdot35/180}=-1{,}612838, p=0{,}106780. Çok değişkenli normallikten anlamlı sapma yoktur.
Adım 8 — Bootstrap (tohum 42, B = 2000). Yaş–SKB: yüzdelik [0{,}594295;\ 0{,}749462]; \hat z_0=-0{,}036354, \hat a=-0{,}013711 ile BCa [0{,}585937;\ 0{,}745908]. Fisher aralığına (0,587–0,748) çok yakındır. Yaş–BMI için R boot (farklı RNG) yüzdelik [0{,}0764;\ 0{,}3503], BCa [0{,}0750;\ 0{,}3472]; MerQur [0{,}0804;\ 0{,}3465] ve [0{,}0776;\ 0{,}3445]: fark Monte Carlo hatası düzeyindedir.
Adım 9 — Eksik veri (türetilmiş kopya). Çiftli silmede n 148–180 arasıdır; BMI–glukoz n=148, r=0{,}370705. Liste bazında bütün çiftler n=148 ile hesaplanır; yaş–BMI çiftli silmede r=0{,}2115 (n=167), liste bazında r=0{,}1333 (n=148, p=0{,}106): silme biçimi bu çiftin anlamlılık kararını değiştirir.
Adım 10 — Sıralı ve ikili değişkenler (türetilmiş kopya). BMI_kat × sbp_kat: kodlar üzerinde Pearson r=0{,}4157, polikorik \hat\rho=0{,}502023. glukoz_yuksek × kolesterol_yuksek: \varphi=0{,}1592, tetrakorik 0{,}257663. Yaş × glukoz_yuksek (p=57/180): r_{pb}=0{,}047189, biserial 0{,}061654. Gizil korelasyonlar, kategorilere ayırmanın zayıflattığı ilişkiyi geri kazanır.
38.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonuç nesnesinden alınmıştır; motor sayısal değerleri yuvarlamaz (dogrulama/correlation/merqur_calistir.py). Her satır, bir büyüklüğün bütün çiftlerdeki en büyük farkını verir; gösterilen değer temsilci çifttir (yaş × SKB; kısmi korelasyonda BMI × SKB). R 4.5.3: cor.test (Spearman/Kendall exact = FALSE), p.adjust, ppcor::pcor.test/spcor.test, shapiro.test, Mardia formülü (MVN::mvn yalnız 3 ondalık verir), polycor::polyserial(ML = FALSE); polikorik için mvtnorm::pmvnorm + optimize(tol = 1e-10). Bootstrap satırlarında R sütunu boştur: Python aynı algoritmayı aynı tohumla yeniden yazmıştır.
| Büyüklük (tüm çiftler) | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Pearson: r | 0,675415 | 0,675415 | 0,675415 | 8,4e−15 | ✓ |
| Pearson: p (çift yönlü) | 2,5053·10−25 | 2,5053·10−25 | 2,5053·10−25 | 7,9e−15 | ✓ |
| Pearson: %95 GA alt | 0,587156 | 0,587156 | 0,587156 | 9,2e−15 | ✓ |
| Pearson: %95 GA üst | 0,747804 | 0,747804 | 0,747804 | 7,4e−15 | ✓ |
| Pearson: p (sağ yönlü) | 1,2526·10−25 | 1,2526·10−25 | 1,2526·10−25 | 3,9e−15 | ✓ |
| Pearson: tek yönlü %95 GA alt | 0,602460 | 0,602460 | 0,602460 | 9,0e−15 | ✓ |
| Pearson: %99 GA alt | 0,555999 | 0,555999 | 0,555999 | 9,3e−15 | ✓ |
| Pearson: %99 GA üst | 0,767512 | 0,767512 | 0,767512 | 7,0e−15 | ✓ |
| Pearson: bonferroni düzeltilmiş p | 2,5053·10−24 | 2,5053·10−24 | 2,5053·10−24 | 3,1e−14 | ✓ |
| Pearson: holm düzeltilmiş p | 2,5053·10−24 | 2,5053·10−24 | 2,5053·10−24 | 9,2e−15 | ✓ |
| Pearson: fdr_bh düzeltilmiş p | 2,5053·10−24 | 2,5053·10−24 | 2,5053·10−24 | 8,0e−15 | ✓ |
| Spearman: r | 0,668968 | 0,668968 | 0,668968 | 5,6e−16 | ✓ |
| Spearman: p (çift yönlü) | 1,0329·10−24 | 1,0329·10−24 | 1,0329·10−24 | 1,9e−15 | ✓ |
| Spearman: %95 GA alt | 0,579396 | 0,579396 | 0,579396 | 4,7e−16 | ✓ |
| Spearman: %95 GA üst | 0,742574 | 0,742574 | 0,742574 | 4,4e−16 | ✓ |
| Spearman: p (sağ yönlü) | 5,1644·10−25 | 5,1644·10−25 | 5,1644·10−25 | 1,0e−15 | ✓ |
| Spearman: tek yönlü %95 GA alt | 0,594915 | 0,594915 | 0,594915 | 5,1e−16 | ✓ |
| Spearman: %99 GA alt | 0,547821 | 0,547821 | 0,547821 | 6,1e−16 | ✓ |
| Spearman: %99 GA üst | 0,762636 | 0,762636 | 0,762636 | 4,7e−16 | ✓ |
| Kendall τ_b: r | 0,491109 | 0,491109 | 0,491109 | 3,9e−16 | ✓ |
| Kendall τ_b: p (çift yönlü) | 9,9467·10−22 | 9,9467·10−22 | 9,9467·10−22 | 2,2e−16 | ✓ |
| Kendall τ_b: %95 GA alt | 0,413527 | 0,413527 | 0,413527 | 5,0e−16 | ✓ |
| Kendall τ_b: %95 GA üst | 0,561612 | 0,561612 | 0,561612 | 4,4e−16 | ✓ |
| Kendall τ_b: p (sağ yönlü) | 4,9733·10−22 | 4,9733·10−22 | 4,9733·10−22 | 5,6e−17 | ✓ |
| Kendall τ_b: tek yönlü %95 GA alt | 0,426458 | 0,426458 | 0,426458 | 5,0e−16 | ✓ |
| Kendall τ_b: %99 GA alt | 0,387767 | 0,387767 | 0,387767 | 3,6e−16 | ✓ |
| Kendall τ_b: %99 GA üst | 0,582259 | 0,582259 | 0,582259 | 4,4e−16 | ✓ |
| Spearman: Bonett–Wright GA alt | 0,568905 | 0,568905 | 0,568905 | 6,1e−16 | ✓ |
| Spearman: Bonett–Wright GA üst | 0,749514 | 0,749514 | 0,749514 | 5,0e−16 | ✓ |
| Spearman: Bonett–Wright tek yönlü alt | 0,586362 | 0,586362 | 0,586362 | 5,6e−16 | ✓ |
| Kendall: Fieller GA (ek tablo) alt | 0,413527 | 0,413527 | 0,413527 | 5,0e−16 | ✓ |
| Kendall: Fieller GA (ek tablo) üst | 0,561612 | 0,561612 | 0,561612 | 4,4e−16 | ✓ |
| Kısmi Pearson r (kontrol age) | 0,530970 | 0,530970 | 0,530970 | 5,8e−16 | ✓ |
| Yarı-kısmi Pearson r | 0,518236 | 0,518236 | 0,518236 | 2,0e−15 | ✓ |
| Kısmi Pearson t | 8,336287 | 8,336287 | 8,336287 | 5,3e−15 | ✓ |
| Kısmi Pearson p | 2,0755·10−14 | 2,0755·10−14 | 2,0755·10−14 | 1,9e−17 | ✓ |
| Kısmi Spearman r (kontrol age) | 0,528051 | 0,528051 | 0,528051 | 5,6e−16 | ✓ |
| Yarı-kısmi Spearman r | 0,514138 | 0,514138 | 0,514138 | 3,1e−16 | ✓ |
| Kısmi Spearman t | 8,272668 | 8,272668 | 8,272668 | 8,0e−15 | ✓ |
| Kısmi Spearman p | 3,0516·10−14 | 3,0516·10−14 | 3,0516·10−14 | 5,0e−18 | ✓ |
| Kısmi Kendall r (kontrol age) | 0,341051 | 0,341051 | 0,341051 | 3,3e−16 | ✓ |
| Yarı-kısmi Kendall r | 0,337252 | 0,337252 | 0,337252 | 3,3e−16 | ✓ |
| Kısmi Kendall z | 6,778110 | 6,778110 | 6,778110 | 4,9e−15 | ✓ |
| Kısmi Kendall p | 1,2176·10−11 | 1,2176·10−11 | 1,2176·10−11 | 1,4e−17 | ✓ |
| Kısmi Pearson r (kontrol age + BMI) | 0,014216 | 0,014216 | 0,014216 | 4,0e−16 | ✓ |
| Yarı-kısmi Pearson r (age + BMI) | 0,008884 | 0,008884 | 0,008884 | 7,1e−16 | ✓ |
| Kısmi p, Holm (age + BMI) | 1 | 1 | 1 | 0,0e+00 | ✓ |
| Ortalama (5 değişken; gösterilen age) | 57,405556 | 57,405556 | 57,405556 | 4,3e−13 | ✓ |
| SS | 12,660014 | 12,660014 | 12,660014 | 5,0e−14 | ✓ |
| Shapiro–Wilk W | 0,958602 | 0,958602 | 0,958602 | 3,4e−10 | ✓ |
| Shapiro–Wilk p | 3,7894·10−5 | 3,7894·10−5 | 3,7894·10−5 | 3,0e−08 | ✓ |
| Mardia çarpıklık χ² | 34,382962 | 34,382962 | 34,382962 | 3,6e−14 | ✓ |
| Mardia çarpıklık p | 0,497719 | 0,497719 | 0,497719 | 1,2e−15 | ✓ |
| Mardia basıklık z | −1,612838 | −1,612838 | −1,612838 | 2,7e−14 | ✓ |
| Mardia basıklık p | 0,106780 | 0,106780 | 0,106780 | 4,9e−15 | ✓ |
| Bootstrap Pearson yüzdelik alt | 0,594295 | 0,594295 | — | 0,0e+00 | ✓ (aynı tohum) |
| Bootstrap Pearson yüzdelik üst | 0,749462 | 0,749462 | — | 0,0e+00 | ✓ (aynı tohum) |
| Bootstrap Pearson BCa alt | 0,585937 | 0,585937 | — | 0,0e+00 | ✓ (aynı tohum) |
| Bootstrap Pearson BCa üst | 0,745908 | 0,745908 | — | 0,0e+00 | ✓ (aynı tohum) |
| Bootstrap Spearman yüzdelik alt (3 çift) | 0,577494 | 0,577494 | — | 0,0e+00 | ✓ (aynı tohum) |
| Bootstrap Spearman BCa üst (3 çift) | 0,747135 | 0,747135 | — | 0,0e+00 | ✓ (aynı tohum) |
| Eksik veri, çiftli: r (gösterilen BMI × glukoz, n = 148) | 0,370705 | 0,370705 | 0,370705 | 8,5e−15 | ✓ |
| Eksik veri, çiftli: p | 3,5194·10−6 | 3,5194·10−6 | 3,5194·10−6 | 1,4e−14 | ✓ |
| Eksik veri, liste bazında: r (gösterilen age × BMI) | 0,133256 | 0,133256 | 0,133256 | 8,7e−15 | ✓ |
| Eksik veri, liste bazında: p | 0,106398 | 0,106398 | 0,106398 | 1,5e−14 | ✓ |
| Polikorik: BMI_kat × sbp_kat | 0,502023 | 0,502023 | 0,502023 | 1,5e−08 | ✓ |
| Polikorik: BMI_kat × glukoz_yuksek | 0,451203 | 0,451203 | 0,451203 | 2,4e−08 | ✓ |
| Polikorik: sbp_kat × kolesterol_yuksek | 0,191942 | 0,191942 | 0,191942 | 1,9e−08 | ✓ |
| Tetrakorik: glukoz_yuksek × kolesterol_yuksek | 0,257663 | 0,257663 | 0,257663 | 2,1e−08 | ✓ |
| Biserial: age × glukoz_yuksek | 0,061654 | 0,061654 | 0,061654 | 2,3e−16 | ✓ |
| Nokta-çift serili r_pb: age × glukoz_yuksek | 0,047189 | 0,047189 | 0,047189 | 1,8e−16 | ✓ |
Sonuç: 71 satırın tamamı ölçütü karşılar. En büyük fark polikorik katsayılarda 2{,}4\times10^{-8}'dir (MerQur eniyileyicisinin xatol = 1e-7 toleransı); Shapiro–Wilk p'sinde scipy ve R'nin Royston uygulamaları 3\times10^{-8} ayrılır.
38.7 Çıktıyı okuma
MerQur'un sonuç metni (Pearson, varsayılan ayarlar, kısaltılmış):
Yöntem: Pearson  ·  yön: Çift-yönlü (≠)  ·  p-düzeltmesi: Düzeltme yok

TÜM ÇİFTLER — r, p, güven aralığı ve çift başına n:
Değişken 1            Değişken 2                    r         p                  %95 GA      n
age                   BMI                     +0.2177    0.0033 **   [+0.0738, +0.3527]    180
age                   systolic_bp             +0.6754   <0.0001 ***  [+0.5872, +0.7478]    180
age                   glucose_mg_dL           -0.0173    0.8175 ns   [-0.1632, +0.1293]    180
BMI                   systolic_bp             +0.5292   <0.0001 ***  [+0.4151, +0.6269]    180
systolic_bp           glucose_mg_dL           +0.1623    0.0295 *    [+0.0165, +0.3014]    180
...
GÜÇLÜ İLİŞKİLER (|r| ≥ 0.75):
  (Bu eşiğin üstünde ilişki yok.)

── Kısmi korelasyonlar (kontrol: age; yöntem: Pearson) ──
Değişken 1          Değişken 2           r_partial   r_semi        t    df     n         p
BMI                 systolic_bp            +0.5310  +0.5182    8.336   177   180   <0.0001 ***
systolic_bp         glucose_mg_dL          +0.2360  +0.1741    3.231   177   180    0.0015 **
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Yöntem satırı | Yöntem, yön, p düzeltmesi | Düzeltme seçiliyse p sütunu düzeltilmiş p'dir. |
| TÜM ÇİFTLER | r, p, yıldız, GA, çift başına n | Yıldızlar seçilen \alpha'ya göre: p\ge\alpha "ns". GA sıfırı içermiyorsa ilişki anlamlıdır (düzeltmesiz). |
| GÜÇLÜ İLİŞKİLER | \lvert r\rvert\ge0{,}75 çiftler, azalan sırayla | Sabit eşik (HIGH_CORR_THRESHOLD, correlation.py:549); 0,90 üstü için çoklu doğrusallık notu. |
| Kısmi korelasyon tablosu | r_partial, r_semi, t (Kendall'da z), sd, n, p |
Kontrol sabitken ilişki; r_semi regresyondaki benzersiz katkı kökü. |
| Ek tablolar | Bonett–Wright/Fieller GA, bootstrap, Shapiro/Mardia, polikorik | Yalnız istenince. |
| Tablo sekmesi | Korelasyon matrisi (3 ondalık) | |
| Frekans sekmesi | p matrisi (4 ondalık); betimleyici seçiliyse altında çift başına N |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Yaş ile sistolik kan basıncı arasında güçlü ve pozitif bir doğrusal ilişki vardı, r(178) = 0{,}68, %95 GA [0,59; 0,75], p < 0{,}001. BMI ile sistolik kan basıncı arasındaki ilişki (r = 0{,}53) yaş sabit tutulduğunda değişmedi (kısmi r(177) = 0{,}53, p < 0{,}001). On çiftin karşılaştırmasında Holm düzeltmesi uygulandığında sistolik kan basıncı ile glukoz arasındaki zayıf ilişki (r = 0{,}16, ham p = 0{,}029) anlamlılığını yitirdi (düzeltilmiş p = 0{,}088).
38.8 Uzman soruları
S1. Spearman p'si neden R'dekinden farklı çıkabilir?
MerQur (scipy) Spearman p'sini her zaman t_{n-2} yaklaşımıyla verir. R cor.test bağsız ve n<1290 veride AS 89 algoritmasıyla kesin p hesaplar. Bağ varsa R de yaklaşıma geçer; bu veride iki yazılım aynıdır.
S2. Sıra korelasyonları için Fisher z aralığı geçerli mi?
Kaba bir yaklaşımdır. r_s'nin örnekleme varyansı 1/(n-3)'ten büyüktür; Bonett ve Wright (2000) (1+r_s^2/2)/(n-3) önerir, Kendall için Fieller ve ark. (1957) 0{,}437/(n-4). MerQur Kendall'da Fieller'i varsayılan yapar; Spearman'da Fisher'ı ana tabloda tutar, Bonett–Wright'ı ek tablo olarak verir. Bu veride Bonett–Wright aralığı Fisher'den yaklaşık %10 geniştir.
S3. Yönlü hipotezde GA neden bir ucu ±1 olan aralık?
Tek yönlü test ile tutarlı aralık tek yönlü güven sınırıdır: \rho>0 hipotezinde [L,\ 1], L=\tanh(z_r-z_{1-\alpha}\SH). R cor.test(alternative = "greater") aynı tanımı kullanır (regression.py:1704–1706).
S4. Çiftli silme mi, liste bazında silme mi?
Çiftli silme her çiftte en çok bilgiyi kullanır ama matrisin pozitif tanımlı olmasını garanti etmez ve farklı çiftler farklı alt örneklemlere dayanır. Matris başka bir analize (regresyon, faktör analizi) girecekse liste bazında silme tutarlıdır. Örnek kopyada yaş–BMI ilişkisi çiftli silmede anlamlı (r=0{,}21, n=167), liste bazında anlamsızdır (r=0{,}13, n=148). Eksiklik rastgele değilse ikisi de yanlı olabilir; çoklu atama düşünülmelidir.
S5. Yarı-kısmi korelasyon hangi değişkenden arındırılıyor?
MerQur'da (ppcor gibi) kontrol değişkenleri yalnız ikinci değişkenden çıkarılır: \operatorname{cor}(x,\ y-\hat y_Z). Değişken sırası bu yüzden önemlidir; tabloda "Değişken 2" sütunundaki değişken arındırılandır. Regresyonda x'in y'yi açıklamadaki benzersiz katkısını istiyorsanız Z'nin x'ten çıkarıldığı biçimi (değişkenlerin yerini değiştirerek) kullanın.
S6. p düzeltmesi seçildi; GA'lar da düzeltildi mi?
Hayır. Düzeltme yalnız p'lere uygulanır (regression.py:1752–1756). Aile bazında GA isteniyorsa güven düzeyini elle Bonferroni'ye göre artırın (1-\alpha/m).
S7. Bir çiftte n = 2 kaldı; p neden "—" yazıyor?
n<3'te iki noktadan geçen doğru her zaman tam uyar; test tanımsızdır. p=1 yazmak "ilişki yok" gibi okunacağı için MerQur p'yi ve GA'yı "—" yazar (regression.py:1738–1741). Bu satır "hesaplanamadı" olarak okunmalıdır.
S8. Polikorik katsayı neden Pearson'dan büyük?
Kategorilere ayırma, sürekli gizil değişkendeki bilgiyi kaybettirir ve Pearson r'yi sıfıra doğru çeker. Polikorik katsayı, gözlenen kategorilerin ardında iki değişkenli normal bir gizil yapı varsayarak bu zayıflamayı düzeltir (BMI_kat × sbp_kat: 0,416 → 0,502). Varsayım (gizil normallik) yanlışsa düzeltme de yanlıştır; MerQur SH ve test vermez.
S9. Bootstrap GA ile Fisher GA uyuşmazsa hangisi?
Fisher aralığı iki değişkenli normallik varsayar; ihlalde (ağır kuyruk, aykırı değer) kapsamı bozulur. BCa aralığı bu varsayımı istemez ve çarpıklığı düzeltir, ama n küçükken kendisi de değişkendir. Bu veride ikisi neredeyse aynıdır. MerQur B=2000 kullanır; yayımlanacak aralık için en az iki farklı tohumla sonucun kararlı olduğu gösterilmelidir.
38.9 Sık hatalar ve tuzaklar
- Korelasyonu uyum sanmak. İki tansiyon cihazı arasında r=0{,}95 olsa da biri sistematik olarak 10 mmHg yüksek ölçebilir. Uyum için Bland–Altman ya da ICC.
- Yıldızı GA ile karıştırmak. Yıldızlar seçilen güven düzeyinin \alpha'sına göre verilir (%99'da p\ge0{,}01 "ns"); tablo düzeltilmiş p gösteriyorsa yıldız da düzeltilmiş p'dendir, GA ise düzeltilmez.
- Düzeltilmiş p'yi ham p sanmak. Yöntem satırında "p-düzeltmesi" yazıyorsa tablo düzeltilmiş p gösterir (yöntemin adı, ör. Holm ya da FDR (BH), yazılır).
- n<3 çiftini sonuç gibi raporlamak. Test yapılamamıştır; p "—" yazılır.
- Kendall τ'yu Pearson r ölçeğinde yorumlamak. Aynı veride \tau sistematik olarak küçüktür (yaş–SKB: r=0{,}68, \tau_b=0{,}49). Normallikte yaklaşık \tau=\tfrac{2}{\pi}\arcsin\rho.
- Kısmi korelasyonda kontrolü değişken listesine de koymak. Kontrol değişkeni seçili değişkenlerde de varsa kontrol listesinden sessizce düşürülür (
correlation.py:148). - Polikorik için sürekli değişkeni seçmek. 10'dan çok düzeyli iki değişkenin çifti polikorik tabloya hiç girmez; ikili × sürekli çift biserial olur.
- Güçlü ilişkiler tablosunun boş çıkmasını "ilişki yok" diye okumak. Eşik |r|\ge0{,}75'tir; orta düzeyde anlamlı ilişkiler yalnız "TÜM ÇİFTLER" tablosundadır.
38.10 Kaynaklar
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Bonett, D. G., & Wright, T. A. (2000). Sample size requirements for estimating Pearson, Kendall and Spearman correlations. Psychometrika, 65(1), 23–28. https://doi.org/10.1007/BF02294183
- Efron, B. (1987). Better bootstrap confidence intervals. Journal of the American Statistical Association, 82(397), 171–185. https://doi.org/10.1080/01621459.1987.10478410
- Fieller, E. C., Hartley, H. O., & Pearson, E. S. (1957). Tests for rank correlation coefficients. I. Biometrika, 44(3–4), 470–481. https://doi.org/10.1093/biomet/44.3-4.470
- Fisher, R. A. (1915). Frequency distribution of the values of the correlation coefficient in samples from an indefinitely large population. Biometrika, 10(4), 507–521. https://doi.org/10.2307/2331838
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70.
- Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1–2), 81–93. https://doi.org/10.1093/biomet/30.1-2.81
- Kim, S. (2015). ppcor: An R package for a fast calculation to semi-partial correlation coefficients. Communications for Statistical Applications and Methods, 22(6), 665–674. https://doi.org/10.5351/CSAM.2015.22.6.665
- Mardia, K. V. (1970). Measures of multivariate skewness and kurtosis with applications. Biometrika, 57(3), 519–530. https://doi.org/10.1093/biomet/57.3.519
- Olsson, U. (1979). Maximum likelihood estimation of the polychoric correlation coefficient. Psychometrika, 44(4), 443–460. https://doi.org/10.1007/BF02296207
- Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London. Series A, 187, 253–318. https://doi.org/10.1098/rsta.1896.0007
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3–4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159