67. Rastgele Orman
Analiz kimliği: random_forest · Menü adı: Rastgele Orman · Panel: gui/panels/analyses/random_forest.py (form 38–86, read_options 88–96, execute 99–111) · Motor: ml/classification.py, Classification.random_forest (satır 455–495) ve ortak hat _run_sklearn_model (1089–1687); metin gui/panels/analyses/_classification_format.py (95–151, 184–286) · Çağrı: stats_panel.py:8443–8495
Bu bölüm üç makine öğrenmesi bölümünün (67 Rastgele Orman, 69 Gradyan Artırma, 70 Karar Ağacı) ortak altyapısını da anlatır: eğitim/test bölmesi, çapraz doğrulama, test metrikleri, dengesiz veri metrikleri ve permütasyon önemi tek bir işlevde (_run_sklearn_model) hesaplanır. Bölüm 69 ve 70 bu kısımlar için buraya gönderme yapar.
67.1 Ne işe yarar
Rastgele orman, aynı veriden çekilmiş önyükleme (bootstrap) örneklemlerinde büyütülmüş çok sayıda karar ağacının tahminlerini birleştirir. Her ağaç her düğümde değişkenlerin yalnız rastgele bir alt kümesine bakar; bu, ağaçları birbirinden farklılaştırır ve ortalamanın varyansını düşürür (Breiman 2001). Cevapladığı soru: "Bu gözlemin sınıfı (ya da sürekli hedefin değeri) X değişkenlerinden ne kadar doğru tahmin edilebilir ve hangi değişkenler tahmine en çok katkı verir?" Bir hipotez testi değildir; çıktısı bir tahmin kuralı ve onun yeni verideki başarımının kestirimidir.
Ne zaman kullanılır?
- Amaç tahminse; X ile Y arasındaki ilişki doğrusal olmayabilir, etkileşimler bilinmiyorsa.
- Değişkenler farklı ölçeklerde ya da çarpık dağılımlıysa: ağaçlar yalnız sıralamaya bakar.
- Çok sınıflı hedefte, bir model kurmadan önce hangi değişkenlerin bilgi taşıdığını görmek için.
Ne zaman kullanılmaz?
- Etki büyüklüğü, GA ve p değeri gerekiyorsa: İkili Lojistik Regresyon, Çok Terimli Lojistik Regresyon ya da Çoklu Doğrusal Regresyon.
- Okunur tek bir karar kuralı isteniyorsa: Karar Ağacı (CART) (Bölüm 70).
- Gözlemler bağımsız değilse (aynı hastanın tekrarlı ölçümleri): rastgele bölme aynı hastayı hem eğitime hem teste koyar. "Kat (grup) sütunu" ya da "Hazır bölme sütunu" kullanılmalıdır (67.5.1).
- Çok küçük örneklemde (sınıf başına birkaç gözlem): test kümesi ve CV katları anlamsızlaşır; MerQur bazı durumlarda durur (67.2).
Sık karıştırılan analizler. Gradyan artırma (Bölüm 69) da ağaç topluluğudur ama ağaçları sırayla, bir öncekinin hatasını düzeltecek biçimde kurar; rastgele ormanın ağaçları birbirinden bağımsızdır. Torbalama (bagging) rastgele ormanın her düğümde tüm değişkenlere bakan özel durumudur (mtry = p). Tek bir CART ağacı (Bölüm 70) budanır ve yorumlanır; ormandaki ağaçlar budanmaz.
67.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsız gözlemler | Eğitim ve test gözlemleri birbirinden bilgi taşımaz. | Denetlenmez; grup yapısı varsa kat/bölme sütunu verilmelidir. |
| Temsili örneklem | Test kümesi gelecekteki hastalara benzer. | Denetlenmez. Bölme sınıf oranlarını korur (tabakalı). |
| Hedef türü | Sınıflandırmada kategorik, regresyonda sayısal. | Regresyonda sayıya çevrilemeyen hedef hata verir (classification.py:1221–1224). |
| Dağılım varsayımı | Yok. Ölçekleme gereksiz. | — |
Eksik değer. Önce hedefi eksik satırlar atılır (classification.py:1204), sonra herhangi bir X'i eksik satırlar (liste bazında; ml/_preprocessing.py, prepare_numeric_data). Sabit (tek değerli) X sütunları da bu adımda düşer; ön işleme notu çıkarılan sütunları ve kalan sayıyı, "Özellik sayısı" satırı kalan sütun sayısını yazar.
Uç durumlar (koddan):
- Hedefte tek sınıf varsa "en az 2 sınıf" hatası (
classification.py:1237–1238). - Bir sınıfta 1 gözlem varsa tabakalı bölme yapılamaz; sınıf adlarıyla hata verilir (
classification.py:1239–1245). - Test ya da eğitim kümesi sınıf sayısından küçükse hata (
classification.py:1246–1252). - CV kat sayısı, eğitim kümesindeki en kalabalık sınıfın gözlem sayısını aşarsa hata; yalnız en küçük sınıfı aşıyorsa scikit-learn uyarıyla sürer (
classification.py:1333–1342). - En az satır: test kümesi varken \max(10,\ 2\lfloor 1/\text{test oranı}\rfloor) (
classification.py:1210). - Kategorik X (metin) k-1 gösterge değişkenine çevrilir; MerQur düzey sırasındaki ilk düzey referanstır (
classification.py:231–258). Düzey sırası Veri sekmesinde tanımlı sıradır; yoksa sayısal ya da doğal sıra, o da yoksa verideki ilk görülme sırası kullanılır.
67.3 Parametreler
Varsayılanlar random_forest.py:38–96, _ml_options.py:179–264 ve stats_panel.py:8454–8461'dan alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Hedef sınıf (Y) | ilk kategorik sütun | Tahmin edilen değişken. | — |
| Ağaç sayısı | 100 (10–1000) | Ormandaki ağaç sayısı B. | Büyüdükçe olasılıklar ve önem kararlılaşır; aşırı uyum artmaz. |
| Özellikler (X) | en az 1 | Açıklayıcılar. | Metin sütunları kukla kodlanır. |
| Görev | Sınıflandırma | Regresyon: sürekli hedef, R², RMSE, MAE, OOB R². | Kayıp ve mtry varsayılanı. |
| mtry (bölünmede değişken) | Varsayılan (√p) | Her düğümde rastgele denenen değişken sayısı. | Küçük mtry ağaçları farklılaştırır; mtry = p torbalamadır. |
| En küçük yaprak (nodesize) | 1 (1–100) | Her çocuk düğümdeki en az gözlem (scikit-learn min_samples_leaf). |
Büyüdükçe ağaçlar sığlaşır. |
| En büyük derinlik | Sınırsız | Ağaç derinliği sınırı. | Sınır, ağaçları düzgünleştirir. |
| Test oranı | 0,20 (0,10–0,50) | Tabakalı test kümesi payı. | Metriklerin hangi gözlemlerde hesaplandığı. |
| CV kat sayısı (k) | 5 (2–20) | Eğitim kümesinde k katlı CV. | Yalnız "CV doğruluğu" satırı. |
| CV tekrar sayısı | 1 | >1: tekrarlı karıştırmalı CV. | Yalnız CV satırı. |
| Rastgele tohum | 42 | Bölme, CV katları, ormanın tohumu, permütasyon. | Aynı tohum birebir aynı sonucu verir (67.5.8). |
| Hazır bölme sütunu / Test değeri | (yok) / "test" | Test kümesini bir sütunun değeri belirler. | Rastgele bölme yapılmaz. |
| Ayrı test dosyası | (yok) | Panel verisi eğitim, dosya test kümesi. | Bölme sütunu ve test oranı kullanılmaz. |
| Kat (grup) sütunu | (yok) | CV'de grup dışarıda bırakma. | CV satırı. |
| Dengesiz sınıflar: dengeli ağırlık | kapalı | Sınıf ağırlığı n/(K n_k). | Gini hesabı ağırlıklı yapılır. |
| Hiperparametre ayarı (grid search + CV) | kapalı | mtry ∈ {√p, 0,33, 0,5, 1,0} × nodesize ∈ {1, 3, 5}. | Model en iyi ayarla kurulur. |
| Permütasyon önemi (test kümesi) | kapalı | 10 karıştırmada doğruluk düşüşü. | Ek bölüm (67.5.7). |
| Tahmin ve olasılıkları veri setine kaydet | kapalı | RF_PRED, RF_P_<sınıf> sütunları. |
Veri sekmesi. |
| Olasılık eşiği (ikili) | Varsayılan (en olası sınıf) | İkili hedefte P(2. sınıf) ≥ eşik → 2. sınıf. | Test metrikleri. |
| Ek çıktılar | kapalı | Dengesiz veri metrikleri; kısmi bağımlılık (PDP). | Ek bölümler. |
| Grafik | Değişken önemi | ROC (test), PDP + ICE, 3B yüzey. | Yalnız grafik. |
mtry neden sınıflandırmada √p, regresyonda p/3?
mtry, ağaçlar arasındaki ilişki ile tek ağacın gücü arasındaki dengeyi kurar. Breiman'ın (2001) ve R randomForest'ın varsayılanları sınıflandırmada \lfloor\sqrt p\rfloor, regresyonda \max(1,\lfloor p/3\rfloor)'tür. scikit-learn'ün regresyon varsayılanı ise tüm değişkenlerdir (torbalama); MerQur regresyonda mtry'yi açıkça \lfloor p/3\rfloor'e çeker (classification.py:475–481, 1256–1258). Tıp örneğinde p=5: sınıflandırmada mtry = 2, regresyonda (p=4) mtry = 1.
"nodesize" adı R ile aynı anlamda değil
Arayüz etiketi R'deki nodesize'ı anar, ama MerQur scikit-learn'ün min_samples_leaf'ini kullanır: bir bölme ancak her iki çocukta en az bu kadar gözlem kalıyorsa yapılır. R randomForest'ta nodesize, bölünmeyecek en küçük düğüm büyüklüğüdür. Ayrıca scikit-learn önyükleme örnekleminde aynı gözlemin kopyalarını bir kez sayar (önyükleme sayısı ağırlık olarak taşınır). İpucu metni bu farkı söyler. Varsayılan 1'de iki tanım aynı ağacı verir.
67.4 Tıp örneği
Dosya: english/datasets/Tip/63_rf_cancer_type.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/63_rf_kanser_tipi.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #63'teki gibidir.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
cancer_type |
Hedef | 4 sınıf | breast 91, colon 87, lung 81, prostate 91 |
age |
X | sayısal (yıl) | ort. 63,0; SS 12,7; 30–90 |
sex_E |
X | 0/1 (erkek) | %24,3 erkek |
CA125 |
X | sayısal (U/mL) | ort. 11,3; SS 8,1; 0,4–36,5 |
creatinine |
X | sayısal (mg/dL) | ort. 0,89; SS 0,20 |
Hb_g_dL |
X | sayısal (g/dL) | ort. 12,5; SS 2,6 |
n ve eksik değer: 350 hasta, eksik değer yok. Tabakalı bölme: eğitim 280 (breast 73, colon 69, lung 65, prostate 73), test 70 (18, 18, 16, 18).
Klinik soru: Beş rutin ölçüm, dört kanser türünü ne kadar doğru ayırır ve hangi ölçüm ayırımı taşır?
Seçilen ayarlar: Arayüz varsayılanları (100 ağaç, mtry = 2, tohum 42). Ek çalıştırmalar: aynı tohumla ikinci kez; tohum 7; mtry = 5 (torbalama, R ile birebir karşılaştırma için); 500 ağaç; permütasyon önemi + dengesiz veri metrikleri; regresyon (hedef CA125, X = diğer dört değişken); tohum 1–50 dizisi.
67.5 Formüller ve hesap adımları
Hesap sırası: kategorik X'leri kodla → hedefi ve X'i eksik satırları at → sınıf etiketlerini MerQur düzey sırasıyla koda çevir → tabakalı eğitim/test bölmesi (tohum) → işlem hattı (z ölçekleme + orman) yalnız eğitime uydurulur → test kümesinde tahmin ve metrikler → Gini önemi ve OOB → eğitim kümesinde k katlı CV → isteğe bağlı permütasyon önemi, ek metrikler, PDP (classification.py:1089–1687).
67.5.1 Eğitim/test bölmesi ve ölçekleme (ortak hat)
Sınıflandırmada bölme scikit-learn train_test_split(test_size, random_state = tohum, stratify = kod) ile yapılır. Tabaka kodu sınıf adına değil, sınıfın veride ilk görüldüğü sıraya göre verilir (first_seen_codes, classification.py:219–228, 1233):
- \text{kod}(y_i): y_i sınıfının veride kaçıncı farklı sınıf olarak göründüğü (0'dan başlayarak).
- m(i): y_i sınıfının ilk göründüğü satır.
- Test kümesi büyüklüğü \lceil 0{,}2\,n\rceil; Tıp örneğinde \lceil 70\rceil=70.
Neden ilk görülme sırası?
Sınıf adlarının alfabetik sırası dile bağlıdır (Türkçe ve İngilizce veri kopyalarında farklıdır). scikit-learn'ün tabakalı bölmesi sınıf sırasına göre farklı satırlar seçer; alfabetik kodla aynı veri ve tohum iki dilde farklı doğruluk verirdi. İlk görülme sırası satır sırasına bağlıdır, dile değil. Çıktıdaki sınıf sırası (karışıklık matrisi, pozitif sınıf) da aynı ilkeyle MerQur düzey sırasıdır; alfabe hiçbir yerde kullanılmaz.
Regresyonda bölme tabakasızdır. "Hazır bölme sütunu" ya da "Ayrı test dosyası" verilirse rastgele bölme yapılmaz.
Ölçekleme bir işlem hattındadır: z_{ij}=(x_{ij}-\bar x_j)/s_j, \bar x_j ve s_j (bölen n) yalnız eğitim kümesinden (scikit-learn StandardScaler, classification.py:1278–1281). Tıp örneğinde eğitim ortalamaları (yaş 62,864; CA125 11,299; …) ve SS'ler (12,807; 8,141; …) test kümesine de uygulanır.
Koddaki tercih: ağaçlarda da ölçekleme
Rastgele orman ve gradyan artırma scale=True ile çağrılır; ağaçlar sıralamaya baktığından doğrusal ölçekleme bölmeleri değiştirmez (eşikler de aynı oranda ölçeklenir). Etkisi yalnız sayısaldır: scikit-learn ağaçları X'i float32'ye çevirir; çok ender olarak, test değeri tam bir eşiğe denk geldiğinde yön değişebilir (67.6.1). Karar ağacı (Bölüm 70) scale=False ile çalışır ve eşikleri özgün birimde yazar.
67.5.2 Tek ağaç: Gini safsızlığı ve bölme seçimi
Ormandaki her ağaç b, eğitim kümesinden iadeli çekilmiş n büyüklüğünde bir önyükleme örneklemiyle büyütülür. scikit-learn kopyaları ayrı satır olarak değil, sayı ağırlığı c_{ib} olarak taşır. Bir düğümün sınıf payları ve Gini safsızlığı:
- t: düğüm; i\in t, düğüme düşen eğitim gözlemleri.
- c_{ib}\in\{0,\,1,\,2,\dots\}: i. gözlemin b. önyükleme örneklemindeki kopya sayısı; \sum_i c_{ib}=n.
- p_k(t): düğümdeki k. sınıfın ağırlıklı payı; K: sınıf sayısı (burada 4).
- G(t): rastgele seçilen iki gözlemin farklı sınıftan olma olasılığı; saf düğümde 0.
Her düğümde p değişkenden mtry tanesi iadesiz rastgele seçilir; her biri için ardışık farklı değerlerin orta noktaları aday eşiktir ve ağırlıklı safsızlık azalışı en büyük olan bölme alınır:
- s: aday bölme "x_j\le c" (sol çocuk t_L); c ardışık iki farklı değerin orta noktası.
- w_t,\ w_L,\ w_R: düğümün ve çocuklarının ağırlıklı gözlem sayıları.
- Bölünme, düğüm saf olana ya da "En küçük yaprak" koşulu bölmeyi engelleyene kadar sürer (budama yoktur).
Neden ağaçlar budanmıyor?
Tek bir derin ağaç düşük yanlılıklı ama çok değişkendir. B ağacın ortalaması, ağaçlar arası ilişki \rho ise varyansı yaklaşık \rho\sigma^2+(1-\rho)\sigma^2/B'ye indirir (Hastie vd. 2009, §15.2). Önyükleme ve mtry \rho'yu küçültür; budama ise yanlılığı artırır. Bu yüzden orman ağaçları tam büyütülür.
Koddaki tercih: scikit-learn'ün düğüm ayrıntıları
mtry değişkeninin hiçbiri geçerli bölme vermezse scikit-learn başka değişkenler çekmeyi sürdürür. Değişkenlerin denenme sırası rastgele bir permütasyondur; iki bölmenin kazancı eşitse permütasyonda önce gelen seçilir. Bu eşitlik kuralı R randomForest ve ranger'dan farklıdır (67.6.1).
67.5.3 Ormanın tahmini: olasılık ortalaması
- t_b(\mathbf x): \mathbf x'in b. ağaçta düştüğü yaprak; p_k(\cdot) o yaprağın ağırlıklı sınıf payı.
- Eşitlikte sınıf listesindeki ilk sınıf (MerQur düzey sırası) seçilir.
R randomForest ile fark: yumuşak oylama
Breiman (2001) ve R randomForest sınıfı ağaçların çoğunluk oyuyla belirler; olasılık, oy oranıdır. scikit-learn yaprak olasılıklarının ortalamasını alır. Tam büyütülmüş ağaçlarda yapraklar çoğunlukla saftır ve iki tanım çoğu gözlemde aynıdır, ama sınırdaki gözlemlerde sınıf ve olasılık farklı çıkabilir. R ranger(probability = TRUE) MerQur'un tanımını kullanır.
67.5.4 OOB (torba dışı) hata
Her gözlem, ağaçların yaklaşık (1-1/n)^n\approx e^{-1}\approx0{,}368'inde önyükleme örnekleminde yoktur. Bu ağaçlar o gözlem için bağımsız bir test gibidir:
- c_{ib}=0: i. gözlem b. ağacın önyükleme örnekleminde yok.
- n': en az bir ağaçta torba dışında kalan gözlem sayısı (100 ağaçta pratikte n'=n).
- MerQur "OOB hata oranı" olarak 1-OOB doğruluğu yazar; sınıf bazlı OOB hata, gerçek sınıfı k olan eğitim gözlemleri arasında yanlış tahmin oranıdır (
classification.py:1453–1464).
Regresyonda OOB tahmini torba dışı ağaçların ortalamasıdır ve MerQur "OOB R²" olarak 1-\text{SSE}_{\text{OOB}}/\sum(y_i-\bar y)^2 yazar (scikit-learn oob_score_).
OOB R² ile R'nin "% Var explained" değeri
R randomForest'ın "% Var explained" değeri 1-\text{MSE}_{\text{OOB}}/\widehat{\text{Var}}(y)'dir ve varyansta n-1 böleni kullanır. MerQur'un değeri n bölenlidir ve çıktıda tanımıyla, "OOB R² (1 − OOB KT / toplam KT)" diye yazılır. Tıp regresyon örneğinde MerQur 0,394764, aynı OOB tahminleriyle R tanımı 0,396926 verir.
67.5.5 Gini önemi (MDI)
- v(t)=j: t düğümünü j. değişken bölüyor; \Delta, 67.5.2'deki ağırlıklı Gini azalışı.
- Her ağacın önemi önce kendi içinde toplamı 1 olacak biçimde ölçeklenir, sonra ağaçlar ortalanır (B': en az bir bölmesi olan ağaç sayısı) ve sonuç yeniden 1'e ölçeklenir.
- MerQur'un "Özellik Önemi" tablosu ve varsayılan grafiği budur (
classification.py:1443–1450).
Gini öneminin yanlılığı
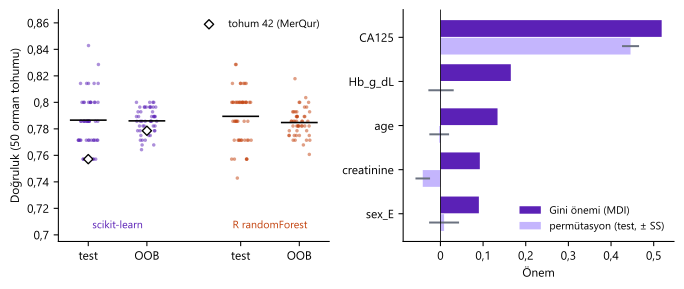
MDI eğitim verisinde hesaplanır ve çok sayıda farklı değeri olan sürekli değişkenleri, bilgi taşımasalar da kayırır (Strobl vd. 2007). Tıp örneğinde age (58 farklı değer) MDI'de üçüncüdür (0,134) ve iki değerli sex_E'yi geçer, ama test kümesinde permütasyon önemi negatiftir (−0,010): yaş tahmine katkı vermez. Değişken seçimi ya da yorum için permütasyon önemi tercih edilmelidir. R randomForest'ın MeanDecreaseGini değeri ölçeklenmemiş toplamdır; payları aynı tanıma karşılık gelir (67.6.1).
67.5.6 Test metrikleri ve CV (ortak hat)
Karışıklık matrisi C (C_{kl}: gerçek sınıfı k, tahmini l olan test gözlemi sayısı) üzerinden:
- İki sınıfta "Kesinlik", "Duyarlılık" ve "F1" pozitif sınıfın, yani sınıf listesindeki ikinci sınıfın değerleridir (ikili hedefte liste [referans, olay] biçimindedir ve olay ortak olay kuralıyla seçilir: 0/1'de 1, tanınan olumlu etiket, aksi hâlde düzey sırasındaki ikinci sınıf) (
average = "binary"; ROC ve karmaşıklık matrisiyle aynı kural). Pozitif sınıf çıktıda adıyla yazılır. - Üç ve daha çok sınıfta destek ağırlıklı ortalamadır: \sum_k (n_k/n_{\text{test}})\,\text{Kes}_k (
average = "weighted",classification.py:1402–1406). - ROC-AUC: ikili hedefte pozitif sınıf olasılığından; çok sınıfta bire-karşı-diğerleri AUC'lerinin aritmetik ortalaması (scikit-learn
multi_class = "ovr",average = "macro").
Çok sınıfta "Duyarlılık" her zaman doğruluğa eşittir
Ağırlıklı duyarlılık \sum_k (n_k/n)\,C_{kk}/n_k=\sum_k C_{kk}/n, yani doğruluğun kendisidir. Tıp örneğinde ikisi de 0,7571. Satır yeni bilgi taşımaz; çıktıdaki tanım satırı bunu söyler. Sınıf bazlı değerler "Sınıflandırma Raporu" tablosundadır.
CV yalnız eğitim kümesinde yapılır: sınıflandırmada StratifiedKFold(k, shuffle = True, random_state = tohum) (tabaka yine ilk görülme kodu), regresyonda KFold; her katta ölçekleme ve orman yeniden uydurulur (classification.py:1475–1505). "CV doğruluğu" katların ortalaması, ± değeri n-1 bölenli SS'dir (_classification_format.py:21–28).
Neden CV yalnız eğitim kümesinde?
Sınıflandırma CV'si yalnız eğitim kümesinde, karıştırılmış katlarla yapılır; tüm veride ve karıştırmasız katlarla yapılsaydı sıralı veride katlar homojen olmaz, test kümesi CV'ye sızardı. Test kümesi yalnız son değerlendirmede kullanılır; CV ve test doğruluğu iki ayrı, birbirine sızmayan kestirimdir.
67.5.7 Ek çıktılar: dengesiz veri metrikleri ve permütasyon önemi (ortak hat)
"Dengesiz veri metrikleri" test kümesinin karışıklık matrisinden hesaplanır (classification.py:290–329; R caret::confusionMatrix karşılıkları):
- p_o=\sum_k C_{kk}/n, p_e=\sum_k (t_k/n)(\hat t_k/n); t_k: gerçek sınıf k sayısı, \hat t_k: tahmin sayısı; c=\sum_k C_{kk}.
- MCC, Gorodkin'in (2004) K sınıflı genellemesidir; iki sınıfta Matthews katsayısına iner.
- κ'nın asimptotik SH'si Fleiss–Cohen–Everitt formülüdür (
stats/classification_eval.py:883–907; GA [-1{,}1]'e kırpılır). - Dengeli doğruluk: sınıf duyarlılıklarının ortalaması. Makro F1: sınıf F1'lerinin ortalaması.
- Doğruluk GA: Clopper–Pearson kesin GA, [\,B^{-1}_{\alpha/2}(c,\,n-c+1),\ B^{-1}_{1-\alpha/2}(c+1,\,n-c)\,].
- NIR (bilgisiz oran) = en kalabalık gerçek sınıfın payı; p=P(X\ge c), X\sim\text{Bin}(n,\text{NIR}), tek yönlü.
Permütasyon önemi (Breiman 2001) test kümesinde hesaplanır (classification.py:1509–1520, scikit-learn permutation_importance):
- \mathbf X_{\text{test}}^{(j,r)}: j. sütunu r. kez karıştırılmış test matrisi (karıştırma bir öncekinin üstüne yapılır).
- Tohum zinciri:
RandomState(tohum)bir alt tohum üretir; her sütun aynı alt tohumla başlayan kendi üretecini kullanır. Regresyonda ölçüt R^2'dir. - SS'nin böleni R-1'dir (R
sd()gibi).
Neden permütasyon önemi test kümesinde?
Değişken karıştırıldığında model o değişkenden yararlanamaz; doğruluktaki düşüş, değişkenin yeni veride taşıdığı bilgiyi ölçer. Eğitim verisinde ölçülen MDI, ezberlenmiş gürültüyü de önem sayar. Negatif değer, karıştırmanın tesadüfen doğruluğu artırdığını, yani değişkenin bilgi taşımadığını gösterir.
67.5.8 Tohum ve yeniden üretilebilirlik
Tek bir tohum (varsayılan 42) dört rastgele adımı belirler: tabakalı bölme, CV katları, ormanın tohumu (random_state) ve permütasyon önemi. scikit-learn ormanın tohumundan her ağaç için ayrı bir tamsayı tohum türetir; ağaç b'nin önyükleme örneklemi RandomState(tohum_b).randint(0, n, n), mtry çekilişleri de aynı üreteçten gelir. Bu yüzden:
- Aynı veri, aynı ayarlar ve aynı tohum her makinede ve her çekirdek sayısında birebir aynı orman, olasılık ve önemi verir. MerQur
n_jobs = -1kullanır, ama ağaç tohumları önceden belirlendiği için iş parçacığı sayısı sonucu değiştirmez (Bölüm 69'daki XGBoost alt örneklemesinden farklı olarak). - Tohum değişince hem bölme hem orman değişir; değişkenliğin büyüklüğü 67.6'da ölçülmüştür.
- Satır sırası değişirse bölme değişir: tohum satır dizinleri üzerinde çalışır.
67.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/random_forest/elle_hesap.py ile hesaplanmıştır. Betik MerQur kodunu çağırmaz: bölmeyi MerQur'un tanımıyla kurar, z ölçeklemeyi elle yapar, ormanı scikit-learn ile doğrudan kurar ve ardından OOB, MDI, olasılık, metrik, AUC ve permütasyon önemini ağaçların iç dizilerinden tanımla yeniden hesaplar.
Adım 1 — Bölme ve ölçek. İlk görülme kodları colon = 0, prostate = 1, breast = 2, lung = 3; tabakalı bölmeyle eğitim 280 (73, 69, 65, 73), test 70. Eğitim ortalaması ve SS'si (bölen n): yaş 62,864 / 12,807; sex_E 0,257 / 0,437; CA125 11,299 / 8,141; kreatinin 0,893 / 0,197; Hb 12,531 / 2,536.
Adım 2 — Birinci ağacın önyükleme örneklemi. 280 çekilişte 177 farklı gözlem seçildi, 103 gözlem (%36,8) torba dışında kaldı. 100 ağaçta torba dışı payın ortalaması 0,3706'dır (kuram (1-1/280)^{280}=0{,}3672). Kökte ağırlıklı sınıf sayıları (colon, prostate, breast, lung) = (67, 81, 63, 69), w=280:
Adım 3 — Kök bölmesi. Ağaç kökte CA125 ≤ −1,013180 (z; özgün birimde 3,05 U/mL) bölmesini seçmiştir. Sol çocuk (2, 0, 60, 0), sağ çocuk (65, 81, 3, 69). Düğüm başına Gini azalışı:
Aynı önyükleme ağırlıklarıyla her değişkenin en iyi eşiği kaba kuvvetle arandığında en büyük azalışlar: CA125 0,2102; sex_E 0,0891; Hb 0,0792; yaş 0,0670; kreatinin 0,0131. Kök için çekilen iki değişkenden biri CA125'tir ve onun en iyi eşiği ağaçtaki eşikle aynıdır. Ağaç 15 derinliğe ve 44 yaprağa kadar büyür.
Adım 4 — OOB. 280 gözlemin hepsi en az bir ağaçta torba dışındadır. Torba dışı olasılık ortalamalarının argmax'ı ile OOB doğruluk = 0,778571 (OOB hata 0,221429). Sınıf bazlı OOB hata: colon 0,115942, prostate 0,369863, breast 0, lung 0,415385. Akciğer ve prostat kanserleri birbirine karışır.
Adım 5 — Gini önemi. Ağaç içi ölçekleme ve ortalamayla: CA125 0,518687; Hb 0,164999; yaş 0,133862; kreatinin 0,092335; sex_E 0,090117.
Adım 6 — Test kümesi. 70 test gözleminde 100 yaprak olasılığının ortalaması alınır. Karışıklık matrisi (satır gerçek, sütun tahmin; sınıf sırası verideki ilk görülme sırasıdır):
| colon | prostate | breast | lung | |
|---|---|---|---|---|
| colon | 17 | 0 | 1 | 0 |
| prostate | 1 | 11 | 0 | 6 |
| breast | 0 | 0 | 18 | 0 |
| lung | 0 | 9 | 0 | 7 |
Doğruluk =53/70=0{,}757143. Sınıf kesinlikleri (0,9444; 0,5500; 0,9474; 0,5385) ve duyarlılıkları (0,9444; 0,6111; 1; 0,4375) destek ağırlığıyla: kesinlik 0,750972, duyarlılık 0,757143 (= doğruluk), F1 0,752267. Bire-karşı-diğerleri AUC'lerinin ortalaması 0,943343.
Adım 7 — CV. Eğitim kümesinde tabakalı karıştırmalı 5 kat: 0,696429; 0,803571; 0,803571; 0,750000; 0,803571. Ortalama 0,7714, SS 0,0479.
Adım 8 — Ek metrikler ve permütasyon önemi. p_o=0{,}757143, p_e=(18\cdot18+18\cdot20+18\cdot19+16\cdot13)/70^2=0{,}251837 → \kappa=0{,}675396; MCC 0,676692; dengeli doğruluk 0,748264; makro F1 0,744781; Clopper–Pearson GA [0,639885; 0,851711]; NIR =18/70=0{,}257143, p=3{,}1\times10^{-18}. Permütasyon önemi (10 tekrar, ± SS): CA125 0,4457 ± 0,0200; sex_E 0,0086 ± 0,0351; Hb 0,0014 ± 0,0297; yaş −0,0029 ± 0,0231; kreatinin −0,0414 ± 0,0171.
Adım 9 — Tohum değişince. Tohum 7: bölme ve orman değişir; test doğruluğu 0,742857, OOB 0,803571, CA125 MDI 0,527404. Tohum 1–50 dizisinde (her tohumda bölme de değişir) MerQur'un test doğruluğu ortalama 0,785, SS 0,037, aralık 0,714–0,886; OOB doğruluk ortalama 0,788, SS 0,021. Bölme sabit tutulup yalnız orman tohumu değiştirildiğinde test doğruluğunun SS'si 0,019'a iner: Tıp örneğinde değişkenliğin büyük kısmı 70 kişilik test kümesinin hangi hastalardan oluştuğundan gelir.
Adım 10 — Regresyon. Hedef CA125, p=4, mtry =\lfloor4/3\rfloor=1. OOB R^2=0{,}394764 (R "% Var explained" tanımıyla 0,396926); test R^2=0{,}251134, RMSE 5,8569, MAE 4,3414; CV R^2 ortalaması 0,3957.
Şekil 67.1. Sol: aynı eğitim/test bölmesinde 50 orman tohumuyla test ve OOB doğruluğu; mor scikit-learn (MerQur'un motoru), turuncu R randomForest; yatay çizgiler ortalama, beyaz baklava MerQur'un tohum 42 sonucu. Sağ: Gini önemi ile test kümesindeki permütasyon öneminin (± SS) karşılaştırması.
67.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan alınmıştır (ml.classification ad alanında round bellekte devre dışı). Python sütunu yukarıdaki bağımsız hesaptır. R: 4.5.3; ranger 0.18.0, randomForest 4.7-1.2, caret 7.0-1.
Rastgele orman R ile tek koşuda birebir eşleştirilemez: R'nin rastgele sayı üreteci, önyükleme ve mtry çekilişleri scikit-learn'den farklıdır. Bu nedenle üç düzeyde karşılaştırma yapılmıştır:
- Tanımdan, birebir: OOB, MDI, olasılık, metrikler, ek metrikler ve permütasyon önemi ağaçların iç yapısından yeniden hesaplanmış ve MerQur'la 10^{-15} düzeyinde aynı bulunmuştur; ek metrikler R
caretile de aynıdır. - Aynı önyükleme örneklemleri, R ranger: mtry = p (torbalama) seçilince ağaç içinde rastgele değişken seçimi kalmaz. scikit-learn ağaçlarının önyükleme sayıları
ranger(inbag = …)'a verilmiştir. 7000 (ağaç × test gözlemi) tahminin %95,3'ü aynıdır; farklı olan 328 çiftin hepsi iki nedene bağlanmıştır (ayrisma.py): 303'ünde ayrışma düğümünde iki programın seçtiği bölmelerin Gini azalışı tam eşittir (küçük düğümlerde iki değişken aynı ayrımı yapar; seçim değişkenlerin denenme sırasına bağlıdır), 25'inde test değeri eşiğin tam üstündedir ve scikit-learn'ün float32 karşılaştırması yönü değiştirir. Test sınıf tahminleri 70 gözlemin 69'unda aynıdır; ayrışan tek gözlemde MerQur'un iki sınıfa (prostate, lung) verdiği olasılık 0,5–0,5 eşittir ve sınıf listesinde önce gelen seçilir, ranger'da ise ağaç ayrışması dengeyi 0,49–0,50 yapar. Bu yüzden test doğrulukları 0,829 ve 0,814'tür. - Dağılım: varsayılan mtry = 2 için aynı bölmede 50 orman tohumu: scikit-learn ve R
randomForestortalamaları Welch testiyle ayırt edilemez.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| OOB doğruluğu (280 eğitim gözlemi) | 0,778571 | 0,778571 | — | 0,0e+00 | ✓ |
| Sınıf bazlı OOB hata (4) | 0,115942 | 0,115942 | — | 0,0e+00 | ✓ |
| Gini önemi MDI (5; gösterilen CA125) | 0,518687 | 0,518687 | — | 0,0e+00 | ✓ |
| Test olasılıkları (70 × 4) | 0,110000 | 0,110000 | — | 0,0e+00 | ✓ |
| Test doğruluğu | 0,757143 | 0,757143 | — | 0,0e+00 | ✓ |
| Test kesinliği (ağırlıklı) | 0,750972 | 0,750972 | — | 0,0e+00 | ✓ |
| Test duyarlılığı (ağırlıklı) | 0,757143 | 0,757143 | — | 1,1e−16 | ✓ |
| Test F1 (ağırlıklı) | 0,752267 | 0,752267 | — | 0,0e+00 | ✓ |
| Test ROC-AUC (bire-karşı-diğerleri, makro) | 0,943343 | 0,943343 | — | 0,0e+00 | ✓ |
| Dış 5 katlı CV doğrulukları (5) | 0,696429 | 0,696429 | — | 0,0e+00 | ✓ |
| Ek: κ, dengeli doğruluk, MCC, makro F1, doğruluk GA, NIR, NIR p (8; gösterilen κ) | 0,675396 | 0,675396 | 0,675396 | 3,3e−16 | ✓ |
| Permütasyon önemi ortalaması (5; gösterilen CA125) | 0,445714 | 0,445714 | — | 0,0e+00 | ✓ |
| Permütasyon önemi SS (n − 1; 5) | 0,019977 | 0,019977 | — | 0,0e+00 | ✓ |
| Aynı tohumla ikinci çalıştırma: test olasılıkları | 0,110000 | 0,110000 | — | 0,0e+00 | ✓ (birebir) |
| Aynı tohumla ikinci çalıştırma: OOB, MDI | 0,778571 | 0,778571 | — | 0,0e+00 | ✓ (birebir) |
| Tohum 7: test doğruluğu, OOB | 0,742857 | 0,742857 | — | 0,0e+00 | ✓ |
| Tohum 7: MDI (5) | 0,527404 | 0,527404 | — | 0,0e+00 | ✓ |
| Torbalama (mtry = 5): test olasılıkları, MerQur–Python | 0,170000 | 0,170000 | — | 0,0e+00 | ✓ |
| Torbalama: MDI (5) | 0,692296 | 0,692296 | — | 0,0e+00 | ✓ |
| Torbalama: test doğruluğu, MerQur–Python | 0,828571 | 0,828571 | — | 0,0e+00 | ✓ |
| Torbalama: test doğruluğu (R ranger, aynı önyükleme) | 0,828571 | 0,828571 | 0,814286 | 0,0143 | ≈ (1 gözlem; ağaç ayrışması, MerQur'da iki sınıf 0,5–0,5 eşit, listede ilk sınıf seçilir) |
| Torbalama: test olasılıkları, MerQur–R ranger (70 × 4) | 0,170000 | — | 0,150000 | 0,08 | ≈ (eşit kazanç) |
| Torbalama: test sınıf tahminleri aynı olan gözlem | 69/70 | — | 69/70 | 1 | ≈ (ağaç ayrışması) |
| Torbalama: ağaç × test gözlemi tahmini aynı | 6672/7000 | — | %95,3 | 328 çift | ≈ (303 eşit kazanç, 25 sınır değeri, 0 açıklanamayan) |
| Torbalama: OOB doğruluğu | 0,767857 | 0,767857 | 0,764286 | 0,0036 | ≈ (1 gözlem; ağaç ayrışması) |
| 50 tohum, sabit bölme: test doğruluğu ortalaması (sklearn / randomForest) | — | 0,7866 | 0,7894 | 0,0029 | dağılım (Welch p = 0,47) |
| 50 tohum, sabit bölme: OOB doğruluğu ortalaması (sklearn / randomForest) | — | 0,7860 | 0,7848 | 0,0012 | dağılım (Welch p = 0,54) |
| 50 tohum, sabit bölme: CA125 MDI payı ortalaması (sklearn / randomForest) | — | 0,5228 | 0,5247 | 0,0019 | dağılım (Welch p = 0,46) |
| Regresyon (CA125; mtry = ⌊4/3⌋ = 1): OOB R² | 0,394764 | 0,394764 | — | 0,0e+00 | ✓ |
| Regresyon: test R², RMSE, MAE | 0,251134 | 0,251134 | — | 8,9e−16 | ✓ |
| Regresyon: dış 5 katlı CV R² (5) | 0,405365 | 0,405365 | — | 2,2e−16 | ✓ |
| Regresyon: MDI (4) | 0,364903 | 0,364903 | — | 0,0e+00 | ✓ |
"≈" satırlarında fark yukarıdaki iki gerekçeyle açıklanmıştır; hesap hatası değildir. OOB doğruluğundaki 0,0036'lık fark tek bir eğitim gözleminin torba dışı tahminidir; ağaçlar yalnız eşit kazanç ve sınır değeri durumlarında ayrıştığından bu fark da aynı kaynaktandır.
67.7 Çıktıyı okuma
Sonuç metni (varsayılanlar; kısaltılmış):
Rastgele orman Sınıflandırma
  Hedef               = cancer_type
  Özellik sayısı      = 5
  Sınıflar            = colon, prostate, breast, lung
  Algoritma           = Rastgele orman
  Ön işleme           = Eksik değerli satırlar çıkarıldı (listwise). Standartlaştırma (z) ...

  ── Test Performansı ──
  Doğruluk            = 0.7571
  Kesinlik            = 0.7510
  Duyarlılık          = 0.7571
  F1                  = 0.7523
    ↳ Kesinlik, duyarlılık ve F1 sınıfların gözlem sayısıyla ağırlıklı ortalamasıdır
      (ağırlıklı duyarlılık doğruluğa eşittir); sınıf bazında değerler sınıflandırma raporundadır.
  ROC-AUC             = 0.9433
  5-katlı CV doğruluğu= 0.7714 (±0.0479)
  OOB hata oranı      = 0.2214  (OOB doğruluk = 0.7786)
    Sınıf bazlı OOB hata (eğitim kümesi): colon = 0.1159, prostate = 0.3699, breast = 0.0000,
      lung = 0.4154

── Özellik Önemi (ilk 10) ──
     Özellik     Önem
       CA125 0.518687
     Hb_g_dL 0.164999
         age 0.133862
...
── Model kurulumu ve yeniden üretilebilirlik ──
  Hiperparametreler (belirtilmeyenler kütüphane varsayılanı): n_estimators = 100, min_samples_leaf = 1
  Bölme: eğitim n = 280, test n = 70 tabakalı (tohum = 42); ölçekleme/doldurma yalnız eğitime uyduruldu
  CV: 5-kat tabakalı, karıştırmalı (tohum = 42); yalnız eğitim kümesinde (n = 280)
"Permütasyon önemi" ve "Dengesiz veri metrikleri" açıkken eklenen kısım:
── Permütasyon önemi (test kümesi; ölçütteki ortalama düşüş ± SS) ──
  CA125                    +0.4457  (SS 0.0200)
  age                      -0.0029  (SS 0.0231)
  creatinine               -0.0414  (SS 0.0171)
── Dengesiz veri metrikleri (test kümesi) ──
  Cohen's Kappa      = 0.6754  (ASE = 0.0678, %95 [0.5425, 0.8083])
  Dengeli doğruluk   = 0.7483
  MCC                = 0.6767
  Doğruluk = 0.7571, %95 kesin GA [0.6399, 0.8517]
  NIR = 0.2571, P(Doğruluk > NIR) = < .001
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Doğruluk | Test kümesinde doğru sınıflanan oran. | Yeni hastalar için başlıca başarım kestirimi; NIR ile karşılaştırılmalı. |
| Kesinlik / Duyarlılık / F1 | Çok sınıfta destek ağırlıklı ortalama. | Duyarlılık burada doğrulukla aynıdır; sınıf bazlı tablo okunmalı. |
| ROC-AUC | Bire-karşı-diğerleri AUC'lerinin ortalaması. | Sıralama başarısı; eşikten bağımsızdır. |
| 5-katlı CV doğruluğu (± SS) | Eğitim kümesinde CV. | Test doğruluğundan farklı bir kestirim; ikisi birlikte belirsizliği gösterir. |
| OOB hata oranı | Torba dışı tahminlerin hatası. | Ayrı test kümesi gerektirmeyen iç kestirim. |
| Özellik Önemi | Gini önemi (MDI), toplamı 1. | Değişken sıralaması için kaba gösterge; yanlıdır (67.5.5). |
| Permütasyon önemi | Test doğruluğundaki düşüş ± SS. | 0'a yakın ya da negatif: değişken yeni veride bilgi taşımıyor. |
| Dengesiz veri metrikleri | κ, MCC, dengeli doğruluk, kesin GA, NIR testi. | Sınıflar dengesizse doğruluk yerine bunlar raporlanır. |
| Tablo sekmesi | Değişken, Önem (ve açıksa permütasyon ortalaması, SS). | — |
Uyarılar: sınıf sayısı, tabakalanamayan sınıf ve kat sayısı iletileri yalnız hata durumunda çıkar (67.2).
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Dört kanser türü beş rutin ölçümle (yaş, cinsiyet, CA125, kreatinin, hemoglobin) rastgele ormanla sınıflandırıldı (100 ağaç, her bölmede 2 değişken; tohum 42). Veri tabakalı olarak eğitim (n = 280) ve test (n = 70) kümelerine ayrıldı. Test doğruluğu 0,757 (%95 kesin GA [0,640; 0,852]; bilgisiz oran 0,257, p < 0{,}001), Cohen \kappa = 0{,}675 ve makro ortalama AUC 0,943 oldu; torba dışı doğruluk 0,779, eğitim kümesinde beş katlı çapraz doğrulama doğruluğu 0{,}771 \pm 0{,}048 idi. Meme ve kolon kanserleri neredeyse hatasız ayrılırken akciğer ve prostat kanserleri birbirine karıştı. Test kümesindeki permütasyon önemine göre ayırımı yalnız CA125 taşıdı (doğrulukta ortalama düşüş 0,446).
67.8 Uzman soruları
S1. Aynı tohumla sonuç her bilgisayarda aynı mı?
Evet, aynı scikit-learn sürümünde. Bölme, CV katları ve her ağacın önyükleme ve mtry çekilişleri tohumdan türetilen sabit tamsayı tohumlarla yapılır; n_jobs = -1 yalnız ağaçların hangi çekirdekte kurulacağını belirler. Doğrulamada aynı tohumla iki çalıştırma bit düzeyinde aynıdır. Farklı bir scikit-learn sürümü ağaç kurma ayrıntılarını değiştirebilir; sürüm çıktıda yazmaz, kurulumdan okunmalıdır.
S2. R randomForest ile neden aynı sayıyı alamıyorum?
Üç neden vardır: (1) rastgele sayı üreteçleri farklıdır, aynı tohum farklı önyükleme ve mtry çekilişi verir; (2) R çoğunluk oyu, MerQur yaprak olasılıklarının ortalamasını kullanır; (3) eşit kazançlı bölmelerde seçim kuralları farklıdır. Aynı önyükleme örneklemleri verildiğinde bile (R ranger, mtry = p) ağaç tahminlerinin %4,7'si eşit kazanç ve float32 sınır durumları yüzünden ayrışır. Karşılaştırma dağılım düzeyinde yapılmalıdır: Tıp örneğinde 50 tohumda test doğruluğu ortalamaları 0,787 (scikit-learn) ve 0,789 (R), Welch p=0{,}47.
S3. Gini önemi mi, permütasyon önemi mi?
Yorum için permütasyon önemi. MDI eğitim verisinde ölçülür ve çok değerli sürekli değişkenleri kayırır (Strobl vd. 2007): Tıp örneğinde yaşın MDI'si 0,134 iken test kümesinde permütasyon önemi −0,003'tür. Permütasyon önemi de ilişkili değişkenlerde önemi paylaştırır; iki ilişkili değişkenden biri karıştırıldığında diğeri bilgiyi taşımayı sürdürür ve ikisi de küçük görünür.
S4. OOB hata varken test kümesine neden gerek var?
OOB, ormanın kendi eğitim verisinde bağımsıza yakın bir kestirimdir ve ek veri harcamaz. MerQur yine de tabakalı bir test kümesi ayırır, çünkü aynı test kümesi tüm modellerde (CART, gradyan artırma, SVM) ortak karşılaştırma zemini sağlar. Tıp örneğinde OOB doğruluk 0,779, test doğruluğu 0,757 ve CV ortalaması 0,771'dir; üçü birbirinin belirsizlik aralığı içindedir.
S5. Çok sınıflı AUC nasıl tanımlı? Hand–Till ile aynı mı?
Hayır. MerQur her sınıf için "bu sınıf / diğerleri" AUC'sini hesaplayıp aritmetik ortalamasını alır (scikit-learn ovr, macro). Hand ve Till (2001) sınıf çiftleri üzerinden ortalama alır (R pROC::multiclass.roc); iki değer genellikle yakın ama farklıdır. Bire-karşı-diğerleri AUC sınıf paylarına duyarlıdır.
S6. Sınıflar dengesizse ne değişir?
"Dengeli ağırlık" seçeneği sınıf ağırlığını n/(K\,n_k) yapar ve Gini hesapları bu ağırlıklarla yapılır (scikit-learn class_weight = "balanced"; ağırlıklar önyükleme örnekleminden değil, eğitim kümesinden hesaplanır). Olasılıklar ağırlıklı sınıf paylarıdır; artık gerçek sınıf olasılığı değildir. Raporlamada doğruluk yerine dengeli doğruluk, κ ve MCC kullanılmalı; NIR testi modelin "her zaman en kalabalık sınıf" kuralından iyi olup olmadığını sınar.
S7. Torbalama (mtry = p) ile rastgele orman arasındaki fark Tıp verisinde ne kadar?
Torbalamada test doğruluğu 0,829, OOB 0,768; CA125'in MDI'si 0,692'ye çıkar, çünkü her düğümde en güçlü değişken her zaman adaydır. mtry = 2'de zayıf değişkenler de bölme fırsatı bulur ve MDI'leri yapay olarak yükselir. Bu veride test doğruluğu farkı (0,829 − 0,757) tek bölmenin ötesinde genellenemez: 50 tohumda rastgele ormanın test doğruluğu SS'si 0,02–0,04'tür.
S8. Küçük örneklemde ve tek gözlemli sınıfta ne olur?
Bir sınıfta tek gözlem varsa tabakalı bölme olanaksızdır ve MerQur sınıfın adıyla durur. Test kümesi sınıf sayısından küçükse ya da CV kat sayısı en kalabalık sınıfın eğitimdeki sayısını aşarsa yine durur. Kat sayısı yalnız en küçük sınıfı aşıyorsa scikit-learn uyarı verip sürer: o sınıf bazı katlarda hiç bulunmaz ve CV doğruluğu iyimser olabilir.
67.9 Sık hatalar ve tuzaklar
- Gini önemini nedensel etki gibi okumak. MDI bir tahmin aracının iç istatistiğidir; çok değerli değişkenleri kayırır ve yönü yoktur.
- Çok sınıfta "Duyarlılık" satırını ayrı bir başarı ölçüsü sanmak. Ağırlıklı duyarlılık doğruluğun kendisidir.
- Tek bir tohumun sonucunu kesin sanmak. Tıp örneğinde yalnız tohum değiştirilerek test doğruluğu 0,70 ile 0,89 arasında oynar. Sonuç, birkaç tohumla ya da tekrarlı CV ile ("CV tekrar sayısı") birlikte verilmelidir.
- Tekrarlı ölçümleri rastgele bölmek. Aynı hastanın satırları hem eğitimde hem testte olursa başarım iyimserdir; "Kat (grup) sütunu" ya da "Hazır bölme sütunu" kullanılmalıdır.
- "nodesize"ı R'deki gibi ayarlamak. MerQur'da değer yapraktaki en az gözlemdir; R'de bölünmeyecek düğüm büyüklüğüdür.
- OOB R²'yi R'nin "% Var explained" değeriyle birebir karşılaştırmak. Bölenler farklıdır (n / n-1).
- Dengesiz veride doğrulukla yetinmek. NIR'i ve κ'yı birlikte raporlayın; tek bir sınıfı hiç tahmin etmeyen bir model yüksek doğruluk verebilir.
67.10 Kaynaklar
- Breiman, L. (1996). Bagging predictors. Machine Learning, 24(2), 123–140. https://doi.org/10.1007/BF00058655
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/A:1010933404324
- Clopper, C. J., & Pearson, E. S. (1934). The use of confidence or fiducial limits illustrated in the case of the binomial. Biometrika, 26(4), 404–413. https://doi.org/10.1093/biomet/26.4.404
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Gorodkin, J. (2004). Comparing two K-category assignments by a K-category correlation coefficient. Computational Biology and Chemistry, 28(5–6), 367–374. https://doi.org/10.1016/j.compbiolchem.2004.09.006
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2. baskı). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Liaw, A., & Wiener, M. (2002). Classification and regression by randomForest. R News, 2(3), 18–22.
- Probst, P., Wright, M. N., & Boulesteix, A.-L. (2019). Hyperparameters and tuning strategies for random forest. WIREs Data Mining and Knowledge Discovery, 9(3), e1301. https://doi.org/10.1002/widm.1301
- Strobl, C., Boulesteix, A.-L., Zeileis, A., & Hothorn, T. (2007). Bias in random forest variable importance measures: Illustrations, sources and a solution. BMC Bioinformatics, 8, 25. https://doi.org/10.1186/1471-2105-8-25
- Wright, M. N., & Ziegler, A. (2017). ranger: A fast implementation of random forests for high dimensional data in C++ and R. Journal of Statistical Software, 77(1), 1–17. https://doi.org/10.18637/jss.v077.i01