133. Karmaşık Örneklem Cox Regresyonu
Analiz kimliği: survey_phreg · Menü adı: Karmaşık Örneklem Cox Regresyonu (Ağırlıklı) · Panel: gui/panels/analyses/survey_phreg.py (form 51–193, execute 215–237, read_options 240–264) · Motor: stats/survival_advanced.py, run_survey_phreg (satır 587–970), _efron_score_info (100–149), _cluster_robust_cox (152–243), _design_meat (246–280), _global_wald (283–308), _coef_table_t (333–360), _jackknife_cov (486–507) · Çağıran: stats_panel.py:8658–8674
133.1 Ne işe yarar
Karmaşık örneklem Cox regresyonu, olay zamanı verisini (ölüm, nüks, terk) orantılı tehlikeler modeliyle çözümler; ama gözlemlerin bağımsız ve eşit olasılıkla seçildiğini varsaymaz. Ağırlık, küme (PSU) ve tabaka bilgisiyle evren düzeyindeki tehlike oranlarını (HR) ve onların tasarıma uygun standart hatalarını (SH) verir. Cevapladığı soru: "Bu örneklemin temsil ettiği hasta evreninde, yaştaki bir yıllık artış ölüm tehlikesini kaç kat değiştirir?"
- h(t\mid\mathbf x_i): i. birimin t anındaki tehlike (anlık olay hızı).
- h_0(t): temel tehlike; biçimi belirtilmez (yarı parametrik model). "Temel tehlike tabakası" seçilirse her tabakanın ayrı h_{0s}(t)'si olur.
- \boldsymbol\beta: log-HR katsayıları; e^{\beta_k}, x_k'daki bir birimlik artışın tehlikeyi kaç kat değiştirdiğidir.
- Model, klasik Cox modeliyle (Bölüm 129) aynıdır; fark kestirimin hedefi (evren katsayısı) ve SH'nin tanımındadır.
Ne zaman kullanılır? Sağkalım verisi ağırlıklı, kümeli ya da tabakalı bir örneklemden gelir (ulusal sağlık anketine bağlanmış ölüm kayıtları, hastanelerden küme örneklemiyle seçilmiş kohort); ya da aynı küme (klinik, hekim, okul) içindeki gözlemlerin ilişkili olabileceği ve SH'nin buna göre büyütülmesi gerektiği bir kohort.
Ne zaman kullanılmaz?
- Basit rastgele örneklem ya da randomize deney, küme yok: Cox Regresyonu (Bölüm 129). Olabilirlik oranı testleri, orantılı tehlike tanıları ve Schoenfeld artıkları oradadır.
- Küme etkisinin kendisi ilgi konusuysa (kümeye özgü tehlike çarpanı ve varyansı): Frailty Cox (Bölüm 135).
- Zamanla değişen yordayıcılar: Zamana Bağlı Cox Regresyonu (Bölüm 132).
- Yalnız sağkalım eğrisi ve log-rank karşılaştırması: Kaplan-Meier Sağkalım Analizi (Bölüm 128).
Sık karıştırılan analizler. Bölüm 129'daki Cox regresyonu küme-sağlam SH verebilir, ama örnekleme tasarımının tabakasını ve sonlu evren düzeltmesini kullanmaz; payda sd'si yoktur (z kullanır). Frailty Cox kümeyi rastgele etki olarak modeller ve koşullu (küme içi) HR verir; karmaşık örneklem Cox regresyonu ise marjinal (evren ortalaması) HR verir ve küme yapısını yalnız SH'de kullanır. "Tasarım tabakası" ile "temel tehlike tabakası" ayrı şeylerdir (133.3).
133.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Süre sayısal, olay 0/1 | Olay sütunu 0/1 ya da iki değerli sayısal kod. | 0/1 dışı iki değerli kodda büyük değer olay sayılır ve uyarı yazılır; ikiden çok değer ya da metin hata (_check_event_col, survival_advanced.py:38–82). |
| En az bir olay, en az 5 gözlem | Değilse hata (:737–739, :62–63). |
|
| Orantılı tehlikeler | h(t\mid\mathbf x)/h_0(t) zamanla sabit. | Denetlenmez (Schoenfeld testi Bölüm 129'da). |
| Bağımsız (bilgisiz) sansür | Sansür olay zamanıyla ilişkisiz. | Denetlenmez. |
| Tasarım bilgisi doğru | Ağırlık, PSU, tabaka, FPC. | Negatif ağırlık hata; sıfır ağırlıklı gözlem analiz ve tasarım dışı (:692–702). |
| Yeterli PSU | \nu=\#\text{PSU}-\#\text{tabaka}\ge1, Wald F için \nu+1-k\ge1. | \nu\le0 ise p ve GA "—" ve not (:333–362); Wald tanımsızsa "—". |
Eksik değer. Süre, olay, yordayıcı, ağırlık, küme ya da tabaka sütununda eksik olan satır liste bazında çıkar (sub = df.loc[keep_w, use_cols].dropna(), :734). Tasarım (ağırlık, küme, tabaka ya da FPC) verildiğinde yalnız tasarım sütunları eksik olan satırlar tasarımdan çıkar. Analiz değişkeni (süre, olay, yordayıcı) eksik olan satırlar alt evren dışı sayılır: modele sıfır katkıyla girer, tabaka, PSU ve sd tüm örneklemden kurulur (R svycoxph ve çok terimli ve sıralı anket modelleriyle aynı kural). Çıktı notu bu yolla dışarıda kalan gözlem sayısını, modeldeki ve tasarımdaki gözlem sayısını yazar. Alt evren (domain) seçildiğinde de alan içindeki analiz değişkeni eksik satırlar sıfır katkıyla tasarımda kalır (:704–732).
Uç durumlar.
- Tasarım (ağırlık, küme, tabaka) hiç verilmezse SH yine tasarım tabanlıdır: her gözlem kendi PSU'sudur, sd =n-1 (
:807–813). - Tek PSU'lu tasarım tabakası varyansa katkı vermez (
:217–218); her tabakada tek PSU varsa SH ve t de "—" olur. - Kategorik yordayıcı yokken "son düzey" referansı seçilirse, durum "İstenen ve uygulanan ayarlar" bloğuna yazılır (
:384–390). - Alt evren değişkeni seçili ama değer boşsa açık hata (
:676–677).
133.3 Parametreler
Form survey_phreg.py:51–193; seçenekler read_options (:240–264) ile okunur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Süre sütunu: | ilk sayısal sütun | Olay ya da sansür zamanı. | — |
| Olay sütunu (0/1): | ilk sütun | 1 olay, 0 sansür. | — |
| Ağırlık: | (yok) | Örnekleme ağırlığı. | Kestirim ve SH. |
| Küme / PSU: | (yok) | Birincil örnekleme birimi. | SH ve sd (C-1). |
| Tasarım tabakası: | (yok) | PSU'lar tabaka içinde; varyansta tabaka içi merkezleme. | Yalnız SH ve sd. |
| Temel tehlike tabakası: | (yok) | Her tabakaya ayrı h_0(t). | Kestirimi değiştirir. |
| Sonlu evren düzeltmesi (FPC) | (yok) | \le1 örnekleme oranı, >1 tabakadaki evren PSU sayısı; tabakada sabit olmalı. | SH'yi (1-f_h) ile küçültür. |
| Alt evren (domain) değişkeni / Alt evren değeri | (yok) / boş | Model alt evrende kurulur; tasarımın tamamı korunur. | Kestirim alt evrene ait. |
| Bağımsız değişkenler: | — | Sayısal ya da kategorik (gösterge kodlu). | — |
| Bağ (ties) yöntemi | Efron | Efron ya da Breslow. | Bağlı olay zamanlarında kestirimi değiştirir. |
| Kategorik referans | ilk düzey | İlk ya da son düzey referans. Düzeyler MerQur düzey sırasıyla dizilir: Veri sekmesinde tanımlı sıra, yoksa sayısal/doğal sıra, o da yoksa verideki ilk görülme sırası; alfabetik sıra kullanılmaz. | Kategorik katsayılar. |
| Varyans yöntemi | Taylor doğrusallaştırma | Taylor, Jackknife (JK1/JKn), BRR, Fay BRR, Bootstrap (Rao-Wu), Hazır replikasyon ağırlıkları. | SH, sd. |
| Jackknife sapma merkezi | Replikasyon ortalaması (varsayılan) | Replikasyon ortalaması ya da tam örneklem kestirimi; Taylor'da devre dışı. | SH (küçük). |
| Fay katsayısı (rho): | 0,50 | Yalnız Fay BRR. | SH. |
| Bootstrap replikasyon sayısı: / Rastgele tohum: | 500 / 12345 | Yalnız bootstrap. Tohum (seed) sabitse sonuç tekrarlanır. | SH. |
| Replikasyon ağırlık sütunları:, türü, ölçek, rscales | — | Yalnız "Hazır replikasyon ağırlıkları". | SH. |
| Ek çıktılar: Tasarım etkisi (DEFF) | kapalı | Katsayı başına V_{\text{tasarım}}/V_{\text{SRSWR}}. | Tabloya sütun. |
| Ek çıktılar: Artıkları kaydet | kapalı | Martingale, sapma (deviance) ve ağırlıklı dfbeta sütunları. | Veri setine sütun. |
| Güven Düzeyi: | %95 | HR GA'sı. | GA. |
Tasarım tabakası ile temel tehlike tabakası neden ayrı?
Tasarım tabakası örneklemenin bir özelliğidir: PSU'lar tabaka içinde bağımsız seçilmiştir; yalnız varyansı etkiler, katsayıyı etkilemez. Temel tehlike tabakası ise modelin bir özelliğidir: her tabakaya ayrı h_0(t) verir (R strata(h)), katsayıyı değiştirir ve tabakanın kendi etkisini kestirmez. Aynı değişken ikisine birden verilebilir; ama biri ötekinin yerine geçmez. Tıp örneğinde region temel tehlike tabakası yapılınca age katsayısı 0,012763'ten 0,011812'ye iner (133.6.1).
133.4 Tıp örneği
Dosya: english/datasets/Tip/91_survey_phreg_death.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/91_survey_phreg_olum.xlsx). Değişkenler VIDEO_SCRIPT_TR.txt #91'den alınmıştır; betikteki tek yordayıcıya (region) sürekli yordayıcı örneği olarak age eklenmiştir.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
duration_month |
Süre | sürekli (ay) | ort. 22,04; SS 18,06; 1–60; 21 gözlem 60. ayda |
death |
Olay | 0/1 | 162 ölüm, 138 sansür |
region |
Yordayıcı | metin, 3 düzey | A 93 (46 ölüm), B 95 (52), C 112 (64) |
age |
Yordayıcı | sürekli (yıl) | ort. 62,57; SS 13,18; 40–84 |
weight |
Ağırlık | sayısal | 0,521–2,496; \sum w=464{,}639; küme içinde değişir |
clinical_id |
Küme (PSU) | 15 klinik | 16–25 hasta; klinikler bölgelerle çaprazdır |
n ve eksik değer: 300 hasta, eksik değer yok. Tasarım tabakası yok; 15 küme, \nu=15-1=14.
Klinik soru: 15 klinikten küme örneklemiyle toplanmış ve ağırlıklandırılmış bu kohortun temsil ettiği evrende, bölge ve yaş ölüm tehlikesiyle ilişkili midir?
Seçilen ayarlar: Ağırlık weight, Küme / PSU clinical_id, yordayıcılar region (referans A, ilk düzey) ve age; öteki satırlar varsayılan (Efron, Taylor, %95). Ek çalıştırmalar: Breslow; jackknife (iki sapma merkezi); son düzey referans; DEFF ve artıklar; tasarımsız; temel tehlike tabakası region (yordayıcı age); alt evren region = A; %90 GA; bootstrap (200 replikasyon, tohum 2026).
Klinikler bölgelerin içinde değil
Bu veride her klinik üç bölgeden de hasta içerir; bölge bir tasarım tabakası değildir. region'ı "Tasarım tabakası" olarak vermek, PSU'ların tabaka içinde iç içe olduğu varsayımıyla çelişir ve aynı klinik kodu üç ayrı PSU sayılır. Bu yüzden örnekte region yalnız yordayıcıdır.
133.5 Formüller ve hesap adımları
MerQur'un hesap sırası: satır temizliği (sıfır ağırlık, eksik değer) → olay kodu denetimi → kategorik yordayıcılara gösterge kodlaması → nokta kestirimi (Efron: lifelines CoxPHFitter, sıkı yakınsama; Breslow: kendi Newton'u) → kendi Efron/Breslow skor artıkları ve gözlenen bilgi matrisi → PSU skor toplamlarıyla sandviç (Taylor) ya da replikasyon varyansı → t(\nu) testleri ve HR GA'sı → global Wald \chi^2, F ve düzeltilmiş F → Harrell C → isteğe bağlı DEFF ve artıklar.
133.5.1 Ağırlıklı kısmi olabilirlik ve bağlar
- \mathcal D: farklı olay zamanları; D_t: t anında ölenler, d_t=\lvert D_t\rvert; R_t: t anında risk altındakiler (T_j\ge t).
- \eta_i=\mathbf x_i^{\top}\boldsymbol\beta; w_i: örnekleme ağırlığı.
- \bar w_{D_t}=\frac1{d_t}\sum_{i\in D_t}w_i: bağlı ölenlerin ortalama ağırlığı.
- Efron: k/d_t terimi, bağlı ölenlerin risk kümesinden "kısmen" çıktığını varsayar. Breslow: k/d_t=0; sonlu toplam d_t\ln S_0(t)'ye iner (
_breslow_wloglik,:404–418). - Temel tehlike tabakası varsa \ell_w tabakaların toplamıdır; risk kümeleri tabaka içinde kurulur.
Neden bağ düzeltmesi?
Cox olabilirliği olayların sürekli zamanda tek tek gerçekleştiğini varsayar. Ölçüm ay olarak yuvarlanınca birkaç ölüm aynı ana düşer. Hangisinin önce olduğu bilinmediği için Breslow hepsinin tam risk kümesine karşı olduğunu varsayar; bu, bağlar çoksa katsayıları sıfıra doğru çeker. Efron, bağlı ölenleri risk kümesinden ortalamada eşit paylarla çıkarır ve gerçek (kesin) olabilirliğe daha yakındır (Efron 1977). Tıp örneğinde 124 olay zamanının 20'si bağlıdır; 60. ayda 13 ölüm aynı andadır.
Koddaki tercih: lifelines ile kestirim, kendi skor artıklarıyla varyans
Efron yolunda nokta kestirimi lifelines CoxPHFitter(weights_col=…) ile, sıkı yakınsamayla (precision = 1e-12, r_precision = 1e-14, en çok 500 adım; :18) yapılır. lifelines'ın kendi küme-sağlam SH'si kullanılmaz: kaynak koddaki nota göre bağlarda risk kümesini satır sırasıyla kurar ve C/(C-1) içermez (:160–170). SH, R coxph.detail/residuals(type = "score") ayrıştırmasıyla yazılmış kendi Efron skor artıklarından gelir (_efron_score_info, :100–149). Breslow yolunda nokta kestirimi de kendi Newton–Raphson'udur (adım yarılamalı, \max\lvert\Delta\beta\rvert<10^{-10}; :421–455). R coxph(ties = "efron", weights =) ile aynı ağırlıklı Efron tanımı kullanılır (\bar w_{D_t} çarpanı).
133.5.2 Skor artıkları ve bilgi matrisi
- \mathbf L_i: i. gözlemin (ağırlıksız) skor artığı; \sum_iw_i\mathbf L_i toplam skordur ve kestirimde sıfırdır.
- r_i=e^{\eta_i}: risk skoru; kodda sayısal kararlılık için e^{\eta_i-\max\eta} alınır, oranlar değişmez (
:189). - c_{ik}: i risk altında ama t'de ölmemişse 1; t'de ölenlerden ise 1-k/d_t (ölen, risk kümesinden kısmen çıkmış sayılır). i\notin R_t ise terim yoktur.
- S_1, S_2: \sum w_je^{\eta_j}\mathbf x_j ve \sum w_je^{\eta_j}\mathbf x_j\mathbf x_j^{\top} (risk kümesinde); D indisi ölenlerle sınırlıdır.
- \mathbf I: ağırlıklı gözlenen bilgi ("ekmek"). Breslow'da tüm k/d_t terimleri sıfırdır.
133.5.3 Taylor (küme-sağlam) sandviç
- \mathbf U_{ha}: h. tasarım tabakasındaki a. PSU'nun ağırlıklı skor toplamı.
- Tabaka yoksa tek tabaka vardır ve çarpan C/(C-1)'dir, C küme sayısı (
:222–231). Küme yoksa her gözlem bir PSU'dur. - f_h: FPC'den örnekleme oranı (yoksa 0;
_design_meat,:246–280). FPC ve alt evren yalnız_design_meatyolundadır. - Alt evrende alan dışı gözlemlerin \mathbf L_i'si 0'dır; PSU ve tabakalar tam tasarımdan sayılır.
Neden \mathbf I^{-1} tek başına yetmez ve neden C/(C-1)?
\mathbf I^{-1}, gözlemler bağımsız ve ağırlıklar gerçek tekrar sayıları olsaydı geçerli olurdu. Aynı klinikteki hastaların sağkalımı ortak bakım kalitesiyle ilişkilidir; skor artıkları küme içinde aynı yöne kayar ve PSU toplamları beklenenden çok değişir. Sandviç bu fazla değişkenliği doğrudan PSU toplamlarından ölçer (Lin ve Wei 1989; Binder 1992). C/(C-1), C toplamın kendi ortalamasından sapmalarıyla varyans kestirilirken kaybedilen bir sd'nin düzeltmesidir; R svycoxph (svydesign(ids = ~küme)) aynı çarpanı kullanır. R coxph(cluster =) bu çarpanı kullanmaz; R ile karşılaştırmada \sqrt{C/(C-1)} farkı buradan gelir.
133.5.4 Serbestlik derecesi, testler ve HR GA'sı
- Alt evrende \nu, alanı içeren PSU sayısından tabaka sayısının çıkarılmasıyla bulunur (
:817–824). - Replikasyon yöntemlerinde \nu=\operatorname{rank}(\text{replikasyon ağırlıkları})-1; jackknife'ta Taylor'daki \nu kullanılır.
- Metin çıktısındaki
zsütunu katsayı/SH oranıdır ve t(\nu) ile değerlendirilir (çıktı notunda yazılıdır); Tablo sekmesinde bu sütunun adı t'dir. - \nu\le0: p ve GA tanımsız ("—").
- k: katsayı sayısı; test "tüm \beta=0" global testidir. Terim başına test yoktur.
- F'nin payda sd'si \nu+1-k, R
regTermTest(svycoxph)varsayılanıdır (:886–890). Global testte F ile F_{\text{düz}}'ün payda sd'si aynı sayıdır. - Payda sd'si \le0 ise W, F ve p "—" basılır (
_wald_lines,:311–330).
133.5.5 Replikasyon varyansı (jackknife ve ötekiler)
- \hat{\boldsymbol\beta}_{(r)}: r. PSU çıkarılıp aynı tabakanın öteki PSU'larının ağırlıkları n_h/(n_h-1) ile çarpılarak yeniden kestirilen katsayı (
_jackknife_cov,:486–507). - \tilde{\boldsymbol\beta}: sapma merkezi; varsayılan replikasyonların ortalaması (R
mse = FALSE), seçenekle tam örneklem kestirimi (Rmse = TRUE). - Tabaka yoksa JK1 (c_r=(C-1)/C), tabaka varsa JKn.
- BRR, Fay, Rao-Wu bootstrap ve hazır replikasyon ağırlıkları ortak çekirdekten gelir (
stats/survey_replicate.py; Bölüm 93.5'teki tanımlar).
Çıkarılan PSU silinir, R'de 10^{-10} ağırlık alır
MerQur her replikasyonda ağırlığı sıfır olan satırları siler ve modeli kalanlarla kurar (_refit_weighted, :462). R svycoxph.svyrep.design ise satırları tutar ve ağırlığa 10^{-10} ekler. Breslow'da fark yoktur; Efron'da ise çıkarılan kümedeki ölümler aynı andaki bağ sayısı d_t'ye girmeye devam eder ve \bar w_{D_t}, k/d_t değişir. Tıp örneğinde 60. aydaki 13'lü bağ farklı kliniklere dağıldığından jackknife SH'leri R'den 5\cdot10^{-4} göreli farklıdır (133.6.1). MerQur'un silme tanımı jackknife'ın kendi tanımına (PSU'yu örneklemden çıkarmak) uyar ve matematiksel olarak kesindir. R'nin ε-ağırlığı bunun sayısal bir yaklaşımıdır.
133.5.6 Tasarım etkisi, uyum indeksi ve artıklar
- Pay: seçilen tasarımın varyansı; payda: aynı ağırlıklarla, her gözlem ayrı PSU, tabakasız iadeli basit rastgele örneklem varyansı (R
svydesign(ids = ~1, weights = ~w);:237–241,:863–882). Kümesiz tasarımda FPC verilmişse payda iadesiz varyanstır: (1-f) ile çarpılır, f=n/N. Kullanılan payda çıktıda "BRÖ paydası" satırında yazılır. - DEFF ağırlıklandırmanın etkisini paydaya katar; yalnız kümeleme ve tabakalamanın etkisini ölçer.
Uyum indeksi (C). Harrell C, her olay için risk altındaki karşılaştırılabilir çiftlerde yüksek risk skorunun erken olayla eşleşme oranıdır; \eta eşitlikleri yarım sayılır (stats/cox_tools.py:558–598). MerQur C'yi tasarım ağırlıklarıyla hesaplar: her olay–risk çifti w_iw_j ağırlığıyla sayılır (R coxph(weights =) concordance'ı ile aynı). Temel tehlike tabakası varsa C tabaka içinde kurulur. Ağırlık verilmemişse C ağırlıksız Harrell C'dir.
Artıklar (isteğe bağlı). Martingale M_i=\delta_i-r_i\hat\Lambda_0(T_i); sapma \operatorname{sign}(M_i)\sqrt{-2[M_i+\delta_i\ln(\delta_i-M_i)]}; ağırlıklı dfbeta w_i\mathbf L_i^{\top}\mathbf I^{-1} (_resid_columns, :550–564). R residuals(coxph(weights =), type = "martingale" | "deviance" | "dfbeta", weighted = TRUE) ile aynıdır.
133.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/survey_phreg/elle_hesap.py ile, MerQur ve lifelines çağrılmadan numpy ile hesaplanmıştır. Yordayıcı sırası: region B, region C, age.
Adım 1 — Risk kümeleri ve bağlar. 162 ölüm 124 farklı zamanda gerçekleşir; 20 zamanda birden çok ölüm vardır. En büyük bağ 60. aydadır: 21 hastanın 13'ü bu anda ölmüştür. Efron bu 13 ölüm için 13 ayrı payda kurar: S_0(60)-\frac{k}{13}S_{0D}(60), k=0,\dots,12.
Adım 2 — Newton–Raphson. Başlangıç \boldsymbol\beta=\mathbf 0:
| Yineleme | b_{\text{B}} | b_{\text{C}} | b_{\text{age}} | \ell_w | Skor (B; C; age) |
|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | −1321,335813 | −2,8707; 8,5646; 579,2063 |
| 1 | 0,058051 | 0,141253 | 0,012481 | −1317,139545 | 0,1211; 0,2162; 12,2414 |
| 2 | 0,064947 | 0,148165 | 0,012763 | −1317,136652 | 0,0003; 0,0004; 0,0123 |
| 3 | 0,064961 | 0,148180 | 0,012763 | −1317,136652 | 0; 0; 0 |
\hat{\boldsymbol\beta}=(0{,}064961;\ 0{,}148180;\ 0{,}012763). Kısmi \text{AIC}=-2(-1317{,}136652)+2\times3=2640{,}273304.
Adım 3 — Bilgi matrisi ve model tabanlı SH.
\sqrt{\operatorname{diag}\mathbf I^{-1}}=(0{,}163577;\ 0{,}158210;\ 0{,}004818). Bu SH'ler ağırlıkların gerçek tekrar sayısı olduğunu ve hastaların bağımsız olduğunu varsayar.
Adım 4 — Küme skor toplamları. Her kliniğin \mathbf U_c=\sum_{i\in c}w_i\mathbf L_i toplamı:
| Klinik | B | C | age | Klinik | B | C | age |
|---|---|---|---|---|---|---|---|
| 1 | 0,8702 | −3,4219 | 26,2147 | 9 | −0,6680 | 0,1053 | −21,8278 |
| 2 | 3,0689 | −3,6964 | 19,4920 | 10 | −3,9983 | 2,8869 | −162,9454 |
| 3 | 1,3672 | 3,1217 | −62,5531 | 11 | 5,0496 | 0,9642 | −1,1899 |
| 4 | −0,7565 | −1,8038 | −41,2620 | 12 | 1,1843 | 1,7058 | 7,4576 |
| 5 | −5,4986 | 1,9191 | 136,8806 | 13 | −2,1041 | 3,1874 | 19,3770 |
| 6 | −4,9769 | 2,8925 | −40,8522 | 14 | 7,0399 | −8,6771 | 102,2117 |
| 7 | −0,2293 | 0,6760 | 67,8272 | 15 | 2,3540 | −1,3748 | −59,4793 |
| 8 | −2,7024 | 1,5151 | 10,6488 |
Toplamları kestirimde sıfırdır (\bar{\mathbf U}=\mathbf 0). Bu yüzden et matrisi \mathbf G=\frac{15}{14}\sum_c\mathbf U_c\mathbf U_c^{\top}:
\mathbf G'nin köşegeni \mathbf I'nınkinden büyüktür (ör. B için 190,5 ve 57,5): klinik içi benzerlik ve ağırlık değişkenliği skorların varyansını büyütür.
Adım 5 — Sandviç ve katsayı tablosu.
\nu=14, t_{0{,}975;\,14}=2{,}144787.
| Terim | b | SH (Taylor) | SH (\mathbf I^{-1}) | t | p | HR | %95 GA (HR) | DEFF |
|---|---|---|---|---|---|---|---|---|
| region B | 0,064961 | 0,273994 | 0,163577 | 0,237 | 0,816023 | 1,067117 | [0,592919; 1,920564] | 1,651 |
| region C | 0,148180 | 0,234842 | 0,158210 | 0,631 | 0,538222 | 1,159721 | [0,700818; 1,919120] | 1,344 |
| age | 0,012763 | 0,006743 | 0,004818 | 1,893 | 0,079237 | 1,012845 | [0,998303; 1,027600] | 1,039 |
Örnek, age: t=0{,}012763/0{,}006743=1{,}8929; GA e^{0{,}012763\pm2{,}144787\times0{,}006743}=[0{,}99830;\ 1{,}02760]. DEFF'ler bölge katsayılarında 1,34–1,65'tir: klinikler arası değişkenlik bölge karşılaştırmasının belirsizliğini artırır. Yaşta DEFF 1'e yakındır.
Adım 6 — Global Wald testi.
Adım 7 — Seçeneklerin etkisi.
| Çalıştırma | b_{\text{B}} | b_{\text{C}} | b_{\text{age}} | SH B | SH C | SH age |
|---|---|---|---|---|---|---|
| Efron, Taylor (ana) | 0,064961 | 0,148180 | 0,012763 | 0,273994 | 0,234842 | 0,006743 |
| Breslow, Taylor | 0,076908 | 0,142553 | 0,012006 | 0,260113 | 0,233403 | 0,006301 |
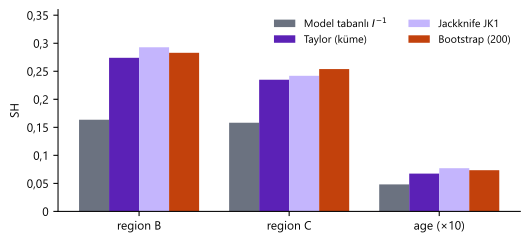
| Efron, jackknife (ortalama merkez) | aynı | aynı | aynı | 0,292860 | 0,241890 | 0,007712 |
| Efron, bootstrap (200, tohum 2026) | aynı | aynı | aynı | 0,282984 | 0,253907 | 0,007359 |
| Tasarımsız (ağırlık 1, sd 299) | −0,011980 | 0,120398 | 0,011992 | 0,197063 | 0,185065 | 0,006081 |
Breslow, bağlar (en çok 60. aydaki 13'lü bağ) yüzünden yaş katsayısını %6 küçültür. Jackknife ve bootstrap, 15 kümeyle Taylor'dan biraz büyük SH verir; bu küçük C'de beklenen bir farktır. Tasarımsız çalıştırmada ağırlıklar kalkınca bölge B'nin işareti bile değişir: ağırlıklar bu veride kestirimi belirgin biçimde etkiler.
Şekil 133.1. Dört varyans yöntemiyle katsayı SH'leri (age SH'si 10 ile çarpılmıştır; Tıp #91).
133.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan (coef_table, extra["global_wald"], summary_stats) alınmıştır; uyum indeksi ve log-olabilirlik motor modülünde round yalnız bellekte etkisizleştirilerek tam hassasiyetle okunmuştur. R: 4.5.3, survival 3.8 ve survey 4.5; svycoxph(design = svydesign(ids = ~clinical_id, weights = ~weight)), regTermTest(method = "Wald"), as.svrepdesign(type = "JK1"); Breslow için svycoxph(…, ties = "breslow") bu R sürümünde model.frame hatası verdiğinden coxph(cluster =, ties = "breslow") varyansı C/(C-1) ile çarpılmıştır. Log-olabilirlik ve artıklar coxph(weights =)'den, C concordance(…, reverse = TRUE)'dan (ağırlıksız) alınmıştır. Python başvurusu kendi Efron/Breslow Newton'u, kendi skor artıkları ve kendi jackknife'ıdır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b region B | 0,064961 | 0,064961 | 0,064961 | 5,3e−11 | ✓ |
| SH region B | 0,273994 | 0,273994 | 0,273994 | 1,7e−12 | ✓ |
| t region B | 0,237088 | 0,237088 | 0,237088 | 1,9e−10 | ✓ |
| p region B | 0,816023 | 0,816023 | 0,816023 | 1,5e−10 | ✓ |
| HR region B | 1,067117 | 1,067117 | 1,067117 | 5,7e−11 | ✓ |
| HR GA alt region B | 0,592919 | 0,592919 | 0,592919 | 2,9e−11 | ✓ |
| HR GA üst region B | 1,920564 | 1,920564 | 1,920564 | 1,1e−10 | ✓ |
| b region C | 0,148180 | 0,148180 | 0,148180 | 5,0e−11 | ✓ |
| SH region C | 0,234842 | 0,234842 | 0,234842 | 3,5e−12 | ✓ |
| t region C | 0,630975 | 0,630975 | 0,630975 | 2,1e−10 | ✓ |
| p region C | 0,538222 | 0,538222 | 0,538222 | 1,3e−10 | ✓ |
| HR region C | 1,159721 | 1,159721 | 1,159721 | 5,8e−11 | ✓ |
| HR GA alt region C | 0,700818 | 0,700818 | 0,700818 | 3,0e−11 | ✓ |
| HR GA üst region C | 1,919120 | 1,919120 | 1,919120 | 1,1e−10 | ✓ |
| b age | 0,012763 | 0,012763 | 0,012763 | 4,6e−13 | ✓ |
| SH age | 0,006743 | 0,006743 | 0,006743 | 4,0e−14 | ✓ |
| t age | 1,892851 | 1,892851 | 1,892851 | 5,7e−11 | ✓ |
| p age | 0,079237 | 0,079237 | 0,079237 | 8,2e−12 | ✓ |
| HR age | 1,012845 | 1,012845 | 1,012845 | 4,7e−13 | ✓ |
| HR GA alt age | 0,998303 | 0,998303 | 0,998303 | 3,8e−13 | ✓ |
| HR GA üst age | 1,027600 | 1,027600 | 1,027600 | 5,6e−13 | ✓ |
| Genel Wald \chi^2 | 6,809556 | 6,809556 | 6,809556 | 7,7e−10 | ✓ |
| p (\chi^2_3) | 0,078222 | 0,078222 | 0,078222 | 2,7e−11 | ✓ |
| Genel Wald F (3,\,12) | 2,269852 | 2,269852 | 2,269852 | 2,6e−10 | ✓ |
| p (F) | 0,132642 | 0,132642 | 0,132642 | 2,9e−11 | ✓ |
| Düzeltilmiş F | 1,945587 | 1,945587 | 1,945587 | 2,2e−10 | ✓ |
| p (düzeltilmiş F) | 0,176144 | 0,176144 | 0,176144 | 3,5e−11 | ✓ |
| F (regTermTest) | 2,269852 | 2,269852 | 2,269852 | 2,6e−10 | ✓ |
| F payda sd | 12 | 12 | 12 | 0,0e+00 | ✓ |
| Kısmi \ell(\hat\beta) | −1317,136652 | −1317,136652 | −1317,136652 | 4,8e−12 | ✓ |
| AIC (kısmi) | 2640,273304 | 2640,273304 | 2640,273304 | 9,5e−12 | ✓ |
| Harrell C (tasarım ağırlıklı) | 0,533561 | 0,533561 | 0,533561 | 3,3e−16 | ✓ |
Ek çalıştırmalar:
Breslow bağ yaklaşımı (R: coxph(cluster =) × C/(C − 1))
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b region B | 0,076908 | 0,076908 | 0,076908 | 5,6e−11 | ✓ |
| SH region B | 0,260113 | 0,260113 | 0,260113 | 1,9e−12 | ✓ |
| b region C | 0,142553 | 0,142553 | 0,142553 | 5,3e−11 | ✓ |
| SH region C | 0,233403 | 0,233403 | 0,233403 | 3,8e−12 | ✓ |
| b age | 0,012006 | 0,012006 | 0,012006 | 5,3e−13 | ✓ |
| SH age | 0,006301 | 0,006301 | 0,006301 | 3,0e−14 | ✓ |
Jackknife (JK1, 15 replikasyon). Üst satırlar: MerQur ve bağımsız Python (çıkarılan küme silinir). Alt satırlar: R svycoxph yolu (çıkarılan kümeye 10−10 ağırlık); Python bu yolu ayrıca yeniden üretir, MerQur sütununda da aynı Python değeri yazılıdır
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| SH region B | 0,292860 | 0,292860 | — | 2,9e−08 | ✓ |
| SH (tam örneklem merkezi) region B | 0,292881 | 0,292881 | — | 2,8e−08 | ✓ |
| SH region C | 0,241890 | 0,241890 | — | 6,8e−08 | ✓ |
| SH (tam örneklem merkezi) region C | 0,241891 | 0,241891 | — | 6,8e−08 | ✓ |
| SH age | 0,007712 | 0,007712 | — | 1,2e−09 | ✓ |
| SH (tam örneklem merkezi) age | 0,007714 | 0,007713 | — | 1,4e−09 | ✓ |
| R yolu (ε ağırlık) SH region B | 0,293006 | 0,293006 | 0,293006 | 1,6e−10 | ✓ |
| R yolu (ε ağırlık) SH tam merkez region B | 0,293023 | 0,293023 | 0,293023 | 1,5e−10 | ✓ |
| R yolu (ε ağırlık) SH region C | 0,241927 | 0,241927 | 0,241927 | 2,1e−10 | ✓ |
| R yolu (ε ağırlık) SH tam merkez region C | 0,241927 | 0,241927 | 0,241927 | 2,1e−10 | ✓ |
| R yolu (ε ağırlık) SH age | 0,007703 | 0,007703 | 0,007703 | 2,1e−11 | ✓ |
| R yolu (ε ağırlık) SH tam merkez age | 0,007704 | 0,007704 | 0,007704 | 2,2e−11 | ✓ |
Kategorik referans: son düzey (C)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b region A | −0,148180 | −0,148180 | −0,148180 | 5,0e−11 | ✓ |
| SH region A | 0,234842 | 0,234842 | 0,234842 | 3,5e−12 | ✓ |
| b region B | −0,083219 | −0,083219 | −0,083219 | 2,6e−12 | ✓ |
| SH region B | 0,267240 | 0,267240 | 0,267240 | 1,2e−12 | ✓ |
| b age | 0,012763 | 0,012763 | 0,012763 | 4,6e−13 | ✓ |
| SH age | 0,006743 | 0,006743 | 0,006743 | 4,0e−14 | ✓ |
Tasarımsız (ağırlık 1, her gözlem bir PSU, sd = n − 1)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b region B | −0,011980 | −0,011980 | −0,011980 | 7,9e−09 | ✓ |
| SH region B | 0,197063 | 0,197063 | 0,197063 | 3,2e−09 | ✓ |
| b region C | 0,120398 | 0,120398 | 0,120398 | 4,4e−08 | ✓ |
| SH region C | 0,185065 | 0,185065 | 0,185065 | 5,1e−10 | ✓ |
| b age | 0,011992 | 0,011992 | 0,011992 | 5,2e−09 | ✓ |
| SH age | 0,006081 | 0,006081 | 0,006081 | 1,3e−10 | ✓ |
Temel tehlike tabakası region, yordayıcı age
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b age | 0,011812 | 0,011812 | 0,011812 | 1,3e−09 | ✓ |
| SH age | 0,006907 | 0,006907 | 0,006907 | 2,5e−11 | ✓ |
| t age | 1,710138 | 1,710138 | 1,710138 | 2,0e−07 | ✓ |
| p age | 0,109300 | 0,109300 | 0,109300 | 3,8e−08 | ✓ |
| HR age | 1,011882 | 1,011882 | 1,011882 | 1,3e−09 | ✓ |
| HR GA alt age | 0,997002 | 0,997002 | 0,997002 | 1,4e−09 | ✓ |
| HR GA üst age | 1,026983 | 1,026983 | 1,026983 | 1,3e−09 | ✓ |
Alt evren region = A, yordayıcı age (tüm tasarım korunur)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b age | 0,017533 | 0,017533 | 0,017533 | 9,9e−09 | ✓ |
| SH age | 0,009036 | 0,009036 | 0,009036 | 1,7e−10 | ✓ |
| t age | 1,940297 | 1,940298 | 1,940298 | 1,1e−06 | ✓ |
| p age | 0,072757 | 0,072757 | 0,072757 | 1,4e−07 | ✓ |
| HR age | 1,017687 | 1,017687 | 1,017687 | 1,0e−08 | ✓ |
| HR GA alt age | 0,998154 | 0,998154 | 0,998154 | 9,5e−09 | ✓ |
| HR GA üst age | 1,037603 | 1,037603 | 1,037603 | 1,1e−08 | ✓ |
%90 güven düzeyi
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| %90 HR GA alt region B | 0,658608 | 0,658608 | 0,658608 | 3,3e−11 | ✓ |
| %90 HR GA üst region B | 1,729009 | 1,729009 | 1,729009 | 9,7e−11 | ✓ |
| %90 HR GA alt region C | 0,766860 | 0,766860 | 0,766860 | 3,4e−11 | ✓ |
| %90 HR GA üst region C | 1,753844 | 1,753844 | 1,753844 | 9,9e−11 | ✓ |
| %90 HR GA alt age | 1,000887 | 1,000887 | 1,000887 | 3,9e−13 | ✓ |
| %90 HR GA üst age | 1,024946 | 1,024946 | 1,024946 | 5,5e−13 | ✓ |
DEFF ve kaydedilen artıklar (ilk 5 gözlem)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| DEFF region B | 1,651404 | 1,651404 | 1,651404 | 1,2e−12 | ✓ |
| DEFF region C | 1,343614 | 1,343614 | 1,343614 | 1,9e−11 | ✓ |
| DEFF age | 1,039147 | 1,039147 | 1,039147 | 4,3e−12 | ✓ |
| Martingale artığı 1 | −1,160097 | −1,160097 | −1,160097 | 6,8e−11 | ✓ |
| Sapma artığı 1 | −0,883113 | −0,883113 | −0,883113 | 4,2e−11 | ✓ |
| dfbeta age 1 | −0,000352 | −0,000352 | −0,000352 | 2,7e−14 | ✓ |
| Martingale artığı 2 | −3,136217 | −3,136217 | −3,136217 | 7,4e−11 | ✓ |
| Sapma artığı 2 | −2,504483 | −2,504483 | −2,504483 | 2,9e−11 | ✓ |
| dfbeta age 2 | −0,002768 | −0,002768 | −0,002768 | 7,2e−14 | ✓ |
| Martingale artığı 3 | 0,765403 | 0,765403 | 0,765403 | 3,1e−12 | ✓ |
| Sapma artığı 3 | 1,170028 | 1,170028 | 1,170028 | 8,6e−12 | ✓ |
| dfbeta age 3 | −4,7658·10−5 | −4,7658·10−5 | −4,7658·10−5 | 1,8e−15 | ✓ |
| Martingale artığı 4 | 0,589256 | 0,589256 | 0,589256 | 1,4e−11 | ✓ |
| Sapma artığı 4 | 0,775280 | 0,775280 | 0,775280 | 2,6e−11 | ✓ |
| dfbeta age 4 | 0,000111 | 0,000111 | 0,000111 | 1,6e−15 | ✓ |
| Martingale artığı 5 | 0,984640 | 0,984640 | 0,984640 | 4,7e−13 | ✓ |
| Sapma artığı 5 | 2,526388 | 2,526388 | 2,526388 | 1,2e−11 | ✓ |
| dfbeta age 5 | 0,000756 | 0,000756 | 0,000756 | 3,2e−16 | ✓ |
Rao–Wu bootstrap (200 replikasyon, tohum 2026): tutarlılık
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Bootstrap SH (aynı tohum, 2 çalıştırma) region B | 0,282984 | 0,282984 | — | 0,0e+00 | ✓ |
| Bootstrap SH (aynı tohum, 2 çalıştırma) region C | 0,253907 | 0,253907 | — | 0,0e+00 | ✓ |
| Bootstrap SH (aynı tohum, 2 çalıştırma) age | 0,007359 | 0,007359 | — | 0,0e+00 | ✓ |
103 değerin tamamı 10^{-6} ölçütüyle eşleşir. Jackknife'ta MerQur ve Python (çıkarılan küme silinir) birbiriyle; Python'un ε-ağırlıklı yeniden üretimi R ile eşleşir; iki tanım arasındaki fark 133.5.5'te açıklanmıştır.
133.7 Çıktıyı okuma
Sonuç metni (ana çalıştırma; olduğu gibi):
Karmaşık Örneklem Cox Regresyonu (Ağırlıklı)
  N (gözlem)                    = 300
  Olay sayısı                   = 162
  Sansürlü                      = 138
  Uyum indeksi (C)              = 0.5336
  Log-olabilirlik               = -1317.1367
  AIC (kısmi)                   = 2640.2733
  Ağırlık                       = weight
  Küme (PSU)                    = clinical_id
  Tasarım tabakası              = —
  Temel tehlike tabakası        = —
  Genel Wald χ² (H₀: tüm β = 0) = χ²(3) = 6.8096, p = 0.07822
  Genel Wald F                  = F(3, 12) = 2.2699, p = 0.1326
  Düzeltilmiş Wald F            = F(3, 12) = 1.9456, p = 0.1761
  Wald F payda df               = ν + 1 - k = 14 + 1 - 3 = 12 (varsayılan: artık df; ayarlı F'de ν - p + 1)

── Katsayılar ──
  Değişken Katsayı       SE      z       p     HR HR alt HR üst
  region_B 0.06496   0.2740 0.2371  0.8160 1.0671 0.5929 1.9206
  region_C  0.1482   0.2348 0.6310  0.5382 1.1597 0.7008 1.9191
       age 0.01276 0.006743 1.8929 0.07924 1.0128 0.9983 1.0276
  HR alt / HR üst: %95 güven aralığı sınırları.

  Küme-sağlam SE: Efron bağ düzeltmeli skor artıklarıyla sandviç (Taylor
  doğrusallaştırma, WR), C/(C−1) sonlu küme düzeltmeli (C = 15 küme/PSU);
  p ve GA t(sd = 14) ile. 'z' sütunu = katsayı/SE (t istatistiği).
  Uyum indeksi (C) tasarım ağırlıklarıyla hesaplanır: her olay–risk çifti
  w_i·w_j ağırlığıyla sayılır; değer evreni tanımlar.
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| N, Olay sayısı, Sansürlü | Analize giren satırlar (sıfır ağırlıklı ve eksikli satırlar hariç). | Ağırlıksız sayılardır. |
| Uyum indeksi (C) | Tasarım ağırlıklı Harrell C. | 0,5 rastgele sıralama; burada 0,53 zayıf ayrım. Evrendeki ayrımı kestirir, ama SH'siz verilir (133.8 S5). |
| Log-olabilirlik, AIC (kısmi) | Ham ağırlıklı kısmi \ell_w. | Yalnız aynı ağırlık ve aynı veriyle kurulan modeller arasında; LR testi kurulmaz. |
| Genel Wald χ², F, Düzeltilmiş F | Tüm katsayılar için global test. | Küçük C'de düzeltilmiş F esas alınır. |
| Wald F payda df | \nu+1-k. | \nu\le k-1 ise test tanımsız. |
z sütunu |
b/\SH; t(\nu) ile değerlendirilir. | Metin çıktısında adı z, Tablo sekmesinde t'dir; dağılımı t'dir. |
| HR alt / HR üst | t(\nu) tabanlı GA. | %95 dışında güven düzeyi satırda yazılır. |
| "Olay sütunu 0/1 kodlu değil" uyarısı | 0/2, 1/2 gibi kodda büyük değer olay. | Kodlamayı denetleyin (:52–58). |
| "Tasarım belirtilmedi" notu | Her gözlem PSU, sd =n-1. | Model tabanlı SH değil, SRSWR sandviçidir. |
| Varyans yöntemi satırı | Replikasyon türü, sayısı, tohum, sapma merkezi. | Bootstrap'ta tohum raporlanmalıdır. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
15 klinikten küme örneklemiyle seçilen ve ağırlıklandırılan 300 hastada (162 ölüm) ölüm tehlikesi, bölge ve yaşla tasarım tabanlı ağırlıklı Cox regresyonuyla (Efron bağ düzeltmesi) modellendi; standart hatalar küme düzeyinde Taylor doğrusallaştırmasıyla hesaplandı (tasarım sd = 14). Model genel olarak anlamlı değildi, düzeltilmiş Wald F(3,\ 12) = 1{,}95, p = 0{,}18. Yaştaki bir yıllık artış tehlikeyi %1,3 artırma eğilimindeydi, ancak bu artış anlamlı değildi (HR = 1,013; %95 GA [0,998; 1,028]; t(14) = 1{,}89; p = 0{,}079). B ve C bölgelerinin tehlikesi A bölgesinden farklı değildi (HR = 1,07 ve 1,16; p = 0{,}82 ve 0{,}54).
133.8 Uzman soruları
S1. Neden t(\nu)? R `svycoxph` ne kullanır?
R summary(svycoxph(...)) katsayı tablosunda z basar; confint da z ile GA verir. MerQur t(\nu) kullanır (_coef_table_t, :333–362). Tıp örneğinde \nu=14 olduğu için fark büyüktür: age için z ile p=0{,}058, t(14) ile p=0{,}079. Küme sayısı azsa t daha dürüsttür. R ile karşılaştırmada p ve GA'yı t(\nu) ile hesaplamak gerekir (doğrulama böyle yapılmıştır).
S2. Neden lifelines'ın kendi küme-sağlam SH'si kullanılmıyor?
Kaynak kodundaki nota göre lifelines 0.30.x bağlı sürelerde skor artıklarını risk kümesini satır sırasıyla kurarak hesaplar ve C/(C-1) düzeltmesi içermez (:160–170). MerQur skor artıklarını R coxph.detail ayrıştırmasıyla kendisi yazar; R svycoxph ile SH'ler 10^{-8} düzeyinde aynıdır. lifelines yalnız Efron nokta kestirimi için kullanılır.
S3. Efron ve Breslow arasında ne zaman belirgin fark olur?
Bir zamanda çok sayıda olay bağlıysa ve bağlı gözlemlerin risk skorları farklıysa. Tıp örneğinde 60. aydaki 13 ölüm yüzünden yaş katsayısı Efron'da 0,012763, Breslow'da 0,012006'dır. R coxph ve MerQur'un varsayılanı Efron'dur; bazı yaygın yazılımlarınki Breslow'dur. Bağ oranı %5'in altındaysa fark genellikle üçüncü ondalıktan sonradır.
S4. Jackknife SH'si neden R ile birebir aynı değil?
Tanım farkı vardır (133.5.5). MerQur çıkarılan PSU'nun satırlarını siler; R svycoxph.svyrep.design onları 10^{-10} ağırlıkla tutar. Efron'da bu satırlar bağ sayısını değiştirdiği için replikasyon kestirimleri küçük farklarla ayrışır. Bağımsız Python hesabı iki tanımı da yeniden üretir: silme tanımı MerQur'la, ε-ağırlık tanımı R ile 10^{-9} düzeyinde aynıdır. Breslow'da ya da bağsız veride fark yoktur.
S5. Uyum indeksi neden tasarım ağırlıklı?
Tasarıma dayalı analizde bütün özet ölçüler ağırlıklı olmalıdır. Ağırlıksız C yalnız örneklemdeki ayrımı tanımlar; örneklem eşit olmayan olasılıklarla çekildiyse evrendeki ayrımı yanlı kestirir. MerQur C'yi concordance_cox ile her çifti w_iw_j ağırlığıyla sayarak hesaplar (stats/cox_tools.py:558–564); bu, R coxph(weights =) özetindeki concordance ile aynıdır (Tıp #91'de R 0,5336; ağırlıksız değer 0,5285). Ağırlıklı C de tasarım tabanlı SH ile verilmez.
S6. Küme yoksa SH model tabanlı mı?
Hayır. Her zaman sandviç kullanılır: küme yoksa her gözlem bir PSU, çarpan n/(n-1), sd n-1 (:807–813). Bu, R svycoxph(svydesign(ids = ~1, weights = ~w)) varsayılanıdır. Ağırlık ve tasarım hiç verilmediğinde de aynıdır; sonuç Bölüm 129'daki model tabanlı SH'den farklı çıkabilir (Tıp örneğinde tasarımsız çalıştırmada region B için SH 0,197063, sd 299).
S7. Az sayıda kümede ne olur?
\nu=C-1 küçüldükçe sandviçin kendisi değişken hâle gelir ve t(\nu) GA'sı genişler. C\le k olduğunda \widehat{\mathbf V}'nin rankı k'dan küçüktür ve global Wald tanımsızdır; MerQur "—" basar (:299–302, _wald_lines :311–330). Tıp örneğinde C=15, k=3; düzeltilmiş F'nin payda sd'si yalnız 12'dir. Küme sayısı 20–30'un altındaysa jackknife ile Taylor'u karşılaştırmak yararlıdır.
S8. Alt evren analizi neden veriyi süzmekle aynı değil?
Alt evren seçildiğinde alan dışı satırlar tasarımda kalır ve skor katkıları 0 olur (_design_meat, :246–280). PSU ortalaması \bar{\mathbf U}_h ve n_h tam tasarımdan gelir. Süzmek ise alan içermeyen PSU'ları ve tabaka yapısını değiştirir. Tıp örneğinde region = A alt evreninde age SH'si 0,009036, \nu=14'tür (her klinikte A bölgesinden hasta vardır).
133.9 Sık hatalar ve tuzaklar
- Tasarım tabakası ile temel tehlike tabakasını karıştırmak. Birincisi yalnız SH'yi, ikincisi modeli değiştirir. Örneklem tasarımında tabaka yoksa "Tasarım tabakası"nı boş bırakın.
- Kümeleri tabaka içinde iç içe olmayan bir değişkeni tasarım tabakası yapmak. Tıp #91'de klinikler bölgelerle çaprazdır;
regiontasarım tabakası yapılırsa her klinik üç ayrı PSU sayılır ve sd yanlış büyür. zsütununu normal dağılımla yorumlamak. p ve GA t(\nu) iledir; küçük C'de fark büyüktür.- Az kümeyle güçlü sonuç beklemek. 15 kümede payda sd'si 12'dir; düzeltilmiş F temkinlidir.
- Uyum indeksini kesin bir evren değeri sanmak. C ağırlıklıdır ama SH'siz verilir; belirsizliği bilinmez.
- Log-olabilirlikle LR testi kurmak. Sözde olabilirlik farkı \chi^2 dağılmaz; global ve iç içe testler Wald iledir.
- Bootstrap tohumunu raporlamamak. Tohum değişirse SH değişir; aynı tohum aynı sonucu verir (doğrulamada iki çalıştırma birebir aynı).
- Olay kodunu denetlememek. 1/2 kodunda 2 olay sayılır ve uyarı yazılır; 0/1/2 (rekabet eden riskler) kodu hata verir.
133.10 Kaynaklar
- Binder, D. A. (1983). On the variances of asymptotically normal estimators from complex surveys. International Statistical Review, 51(3), 279–292. https://doi.org/10.2307/1402588
- Binder, D. A. (1992). Fitting Cox's proportional hazards models from survey data. Biometrika, 79(1), 139–147. https://doi.org/10.1093/biomet/79.1.139
- Breslow, N. (1974). Covariance analysis of censored survival data. Biometrics, 30(1), 89–99. https://doi.org/10.2307/2529620
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187–202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Efron, B. (1977). The efficiency of Cox's likelihood function for censored data. Journal of the American Statistical Association, 72(359), 557–565. https://doi.org/10.1080/01621459.1977.10480613
- Fellegi, I. P. (1980). Approximate tests of independence and goodness of fit based on stratified multistage samples. Journal of the American Statistical Association, 75(370), 261–268. https://doi.org/10.1080/01621459.1980.10477462
- Harrell, F. E., Lee, K. L., & Mark, D. B. (1996). Multivariable prognostic models: Issues in developing models, evaluating assumptions and adequacy, and measuring and reducing errors. Statistics in Medicine, 15(4), 361–387. https://doi.org/10.1002/(SICI)1097-0258(19960229)15:4<361::AID-SIM168>3.0.CO;2-4
- Lin, D. Y., & Wei, L. J. (1989). The robust inference for the Cox proportional hazards model. Journal of the American Statistical Association, 84(408), 1074–1078. https://doi.org/10.1080/01621459.1989.10478874
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08
- Rao, J. N. K., & Wu, C. F. J. (1988). Resampling inference with complex survey data. Journal of the American Statistical Association, 83(401), 231–241. https://doi.org/10.1080/01621459.1988.10478591
- Therneau, T. M., & Grambsch, P. M. (2000). Modeling survival data: Extending the Cox model. Springer. https://doi.org/10.1007/978-1-4757-3294-8