99. Karmaşık Örneklem Çok Terimli Lojistik Regresyon
Analiz kimliği: survey_multinomial · Menü adı: Karmaşık Örneklem Çok Terimli Lojistik Regresyon · Panel: gui/panels/analyses/survey_multinomial.py (form 49–98, execute 109–123), ortak form gui/panels/analyses/_survey_polytomous_ui.py · Motor: stats/survey_polytomous.py, run_survey_multinomial (satır 862–950), _fit_multinomial (275–329), _prepare (412–560), _sandwich (563–568), _wald_from_W (585–604) · Taylor “et” matrisi stats/survey_design.py, _taylor_meat (443–487) · Çağıran: stats_panel.py:8226–8255
99.1 Ne işe yarar
Karmaşık örneklem çok terimli lojistik regresyon, üç ya da daha çok sırasız kategorisi olan bir sonucun (sigara içmiyor / bırakmış / az içiyor / çok içiyor) olasılıklarını açıklayıcılarla modeller. Ağırlıklı, tabakalı ya da kümeli bir örneklemden gelen veride evren düzeyindeki odds oranlarını tasarıma uygun standart hatalarla (SH) verir. Cevapladığı soru: "Bu örneklemin temsil ettiği evrende, kentte yaşamak 'az içici' olma odds'unu 'hiç içmeyen' olmaya göre kaç kat değiştirir?"
Model, genelleştirilmiş logit (baseline-category logit) modelidir. J kategoriden biri referans r seçilir; kalan her j için ayrı bir denklem kurulur:
- Y_i: i. birimin kategorisi; J\ge3 düzey.
- r: referans kategori. Varsayılan, düzey sırasında son düzeydir (99.3).
- \alpha_j: j. denklemin sabiti; \boldsymbol\beta_j: j. denklemin eğimleri (log-odds ölçeğinde).
- e^{\beta_{jk}}: x_k bir birim artınca "j yerine r" odds'unun kaç kat değiştiği (OR).
- Toplam parametre sayısı (J-1)(p+1)'dir; p denklem başına eğim sayısıdır.
Olasılıklar denklemlerden şöyle geri elde edilir:
- \eta_{ij}: j. denklemin doğrusal öngörücüsü; referans için \eta_{ir}=0 sayılır.
- Tüm olasılıkların toplamı 1'dir; bu yüzden J kategori için J-1 denklem yeterlidir.
Ne zaman kullanılır? Sonuç üç ya da daha çok sırasız kategoridir; veri ağırlıklı ve/veya tabakalı ya da kümeli bir örneklemden gelir; amaç evren düzeyinde kategori odds'larının açıklayıcılarla ilişkisidir.
Ne zaman kullanılmaz?
- Kategoriler doğal bir sıraya sahipse ve orantılı odds varsayımı makulse: Karmaşık Örneklem Sıralı Lojistik Regresyon (Bölüm 98). Daha az parametreyle daha güçlü testler verir.
- Sonuç iki kategoriliyse: Ağırlıklı Lojistik Regresyon (Karmaşık Örneklem) (Bölüm 97). Bu modül iki düzeyli Y'de hata verir.
- Veri basit rastgele örneklem ya da deneyse: Çok Terimli Lojistik Regresyon (Bölüm 50). Olabilirlik oranı testleri ve model tabanlı SH oradadır.
- Yalnız kategori oranları ya da iki kategorik değişkenin bağımsızlığı soruluyorsa: Ağırlıklı Frekans (Karmaşık Örneklem) (Bölüm 94).
Sık karıştırılan analizler. Bölüm 50'deki çok terimli lojistik, gözlemleri bağımsız sayar; ağırlık verilse bile onu frekans ağırlığı gibi kullanır ve SH'yi bilgi matrisinden alır. Bu modül nokta kestirimini aynı biçimde (ağırlıklı) bulur, ama SH'yi örnekleme tasarımından (Taylor doğrusallaştırması) hesaplar ve testleri tasarım serbestlik derecesiyle (sd) yapar. Sıralı modelle (Bölüm 98) karıştırmamak gerekir: sıralı modelde her yordayıcının tek katsayısı vardır, burada J-1 katsayısı vardır.
99.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Nominal sonuç, 3\le J\le 25 | En az üç, en çok 25 farklı düzey. | Değilse hata (survey_polytomous.py:642–645). |
| Her düzeyde pozitif ağırlık | Her kategoride ağırlığı sıfırdan büyük en az bir gözlem. | Değilse hata, boş düzeyler adlandırılır (:647–651). |
| Tasarım bilgisi doğru | Ağırlık, tabaka, PSU, FPC örneklemeyi yansıtır. | Negatif ağırlık hata (:446–448); tek PSU'lu tabaka kuralı seçilebilir. |
| Logitte doğrusallık | Sürekli x ile her denklemin logiti doğrusal. | Denetlenmez. |
| Alakasız seçeneklerden bağımsızlık (IIA) | İki kategorinin odds oranı üçüncü bir kategorinin varlığına bağlı değil. | Denetlenmez (Hausman–McFadden testi yoktur). |
| Ayrışma yok | Bir kategori bir yordayıcıyla tam ayrılmıyor. | Doğrusal programla denetlenir (Albert–Anderson tanımı; 99.5.7); ayrışma varsa uyarı. |
Eksik değer. "Eksik değerli gözlemler" satırının bu panelde varsayılanı Tasarımda tut (sıfır katkı)'dır (_survey_polytomous_ui.py:105–113). Analiz değişkeni (Y ya da bir x) eksik olan satır, w_i=0 ile tasarımda kalır: PSU sayısı ve tabaka yapısı tam tasarımdan hesaplanır (R svy_vglm'in design[-na, ] davranışı). "Tasarımdan çıkar" seçilirse satır tasarımdan da düşer. Nokta kestirimi iki kuralda aynıdır; yalnız SH değişebilir (survey_polytomous.py:455–464). Ağırlık, tabaka, küme ya da FPC sütunu eksik satırlar her iki kuralda da çıkar ve bir not yazılır (_prep_design).
Uç durumlar.
- J=2: "en az 3 düzey gerektirir" hatası; Bölüm 97'ye yönlendirir.
- Yordayıcı seçilmemişse hata (
:867–868); yalnız sabitli model kurulamaz. - Sabit ya da öteki sütunlarla doğrusal bağımlı bir yordayıcı sütunu, pozitif ağırlıklı satırlarda rank denetimiyle düşürülür ve not yazılır (
:532–547). Katsayı satırında "kestirilemez" görünür. - Tasarım sd'si \nu-p\le0 ise p değerleri ve GA "—" olur.
- Newton–Raphson 200 yinelemede yakınsamazsa uyarı yazılır, sonuç yine basılır (
:905–906).
99.3 Parametreler
Tasarım satırları (Ağırlık, Tabaka, Küme / PSU, FPC, Tek PSU'lu tabaka, Alt-popülasyon) Bölüm 93.3 ve 96.3'teki anlamla aynıdır. Bu panelin satırları (survey_multinomial.py:49–98, _survey_polytomous_ui.py:17–140):
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Ağırlık: | (yok) | Örnekleme ağırlığı. (yok) seçilirse tüm ağırlıklar 1. | Kestirimi ve SH'yi değiştirir. |
| Tabaka: | (yok) | Tasarım tabakası; yalnız varyansta kullanılır. | Yalnız SH ve \nu. |
| Küme / PSU: | (yok) | Birincil örnekleme birimi. Yoksa her gözlem kendi PSU'su. | SH ve \nu. |
| FPC (popülasyon): | (yok) | \le1 örnekleme oranı, >1 tabakadaki evren PSU sayısı. | SH'yi (1-f_h) ile küçültür. |
| Bağımlı değişken (Y, nominal): | ilk sütun | Sırasız sonuç. | — |
| Referans kategori: | (son düzey) | Öteki kategorilerin karşılaştırıldığı Y düzeyi. Y seçilince düzeylerle dolar. | Tüm katsayıları değiştirir; model uyumu (\ell, Wald testleri) aynı kalır. |
| Bağımsız değişkenler: | — | Sayısal ya da kategorik yordayıcılar. | — |
| Güven Düzeyi: | %95 | GA düzeyi. | GA ve OR GA'sı. |
| Referans düzeyleri | boş | Kategorik yordayıcıda karşılaştırma düzeyi: region=urban. |
Kukla kodlamasını değiştirir. |
| Etkileşim terimleri | boş | a*b: çarpım terimleri; ana etkiler ayrıca seçilmelidir. |
Yeni katsayı satırları ve terim testi. |
| Alt-popülasyon (domain) sütunu / Domain değeri | boş | Model yalnız bu alt evrende kurulur; öteki satırlar w_i=0 ile tasarımda kalır. | Kestirim alt evrene ait olur; tasarım korunur. |
| Tek PSU'lu tabaka | Katkısız (certainty) | Tek PSU'lu tabakanın varyans katkısı. | Yalnız SH. |
| Eksik değerli gözlemler: | Tasarımda tut (sıfır katkı) | 99.2. | Yalnız SH (eksik varsa). |
| Test dağılımı: | t (tasarım df) | t(\nu-p) ya da Normal (z). | p ve GA. |
Referans kategori kuralı (koddan)
Y düzeyleri _resolve_levels ile ortak düzey sırası kuralına göre dizilir (survey_polytomous.py): Veri sekmesinde tanımlı sıralı kategori varsa onun sırası; sayısal ya da sayı içeren etiketlerde sayısal sıra; aksi hâlde verideki ilk görülme sırası. Alfabetik sıra kendiliğinden kullanılmaz; kullanılan sıra ve kaynağı çıktıda yazılır. Referans verilmezse son düzey alınır: r = J - 1 (:874; VGAM multinomial() varsayılanı). Yazılan referans Y'nin düzeyleri arasında yoksa sayıya çevrilip yeniden aranır; yine yoksa bu durum "İstenen ve uygulanan ayarlar" bloğuna kaydedilir ve son düzey kullanılır (:876–889). Tıp örneğinde düzey sırası old, active low, none, active high olduğundan varsayılan referans active hightır; yorum için istenen none (hiç içmeyen) elle seçilir. Kategorik yordayıcıların referansı ise aynı kuralla dizilmiş düzeylerin ilkidir (Tıp #79'da verideki ilk görülen urban; örnekte region=rural elle verilmiştir); R factor() alfabetik (yerel ayara göre) sıraladığından R ile MerQur farklı referans seçebilir (99.8 S6).
Neden referans değişince uyum değişmez?
Referansı r'den s'ye taşımak yalnız yeniden parametrelemedir: \ln(P_j/P_s)=\ln(P_j/P_r)-\ln(P_s/P_r). Olasılıklar, \ell_w, McFadden R^2 ve bir terimin tüm denklemlerdeki ortak Wald testi aynı kalır; yalnız denklemler ve katsayılar değişir. Tıp örneğinde iki referansla W=20{,}6652 aynıdır (99.6, Adım 6).
99.4 Tıp örneği
Tıp setinde bu analize özel bir dosya yoktur. Bölüm 94'teki tasarım aynen kullanılmıştır: english/datasets/Tip/79_survey_freq_smoking.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/79_survey_freq_sigara.xlsx; VIDEO_SCRIPT_TR.txt #79: ağırlık weight, tabaka region). Sigara durumu dört kategorili ve sırasızdır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
smoking |
Bağımlı | nominal, 4 düzey | active high 17, active low 70, none 183, old 130 |
region |
Yordayıcı ve tabaka | metin, 2 düzey | rural 152, urban 248 |
weight |
Ağırlık | sayısal | tabakada sabit: rural 0,85; urban 1,10; \sum w=402 |
Hücre sayıları ve ağırlıklı toplamlar:
| smoking | rural n | rural \sum w | urban n | urban \sum w |
|---|---|---|---|---|
| active high | 8 | 6,80 | 9 | 9,90 |
| active low | 11 | 9,35 | 59 | 64,90 |
| none | 87 | 73,95 | 96 | 105,60 |
| old | 46 | 39,10 | 84 | 92,40 |
n ve eksik değer: 400 kişi, eksik değer yok; küme yok, her kişi bir PSU. İki tabaka, \nu=400-2=398.
Klinik soru: Bölgeye göre tabakalanmış bu örneklemin temsil ettiği evrende, kentte (urban) yaşayanların her sigara kategorisinde bulunma odds'u, hiç içmeyenlere (none) göre kırsaldakilerden farklı mıdır?
Seçilen ayarlar: Ağırlık weight, tabaka region, yordayıcı region, referans kategori none (elle seçildi), Referans düzeyleri region=rural (elle; boş bırakılırsa ortak düzey sırasının ilk düzeyi, burada verideki ilk görülen urban referans olur ve katsayılar "kır − kent" yönünde yazılır), öteki satırlar varsayılan. Ek çalıştırmalar: referans kategori boş (varsayılan: sıranın son düzeyi active high), z dağılımı, %99 GA, ağırlıksız çalıştırma; sürekli yordayıcı denetimi için Tıp #81 (region ~ age + BMI, yalnız sayısal denetim); kümeli tasarım denetimi için Limnoloji 079_survey_frequency_trophic_status_distribution.xlsx (4 tabaka, 84 PSU; trofik durum ~ bölge).
Bu örnekte yordayıcı aynı zamanda tabakadır
region hem tabaka hem tek yordayıcıdır. Model doymuştur (her bölge × kategori hücresi için bir serbest olasılık) ve ağırlık bölge içinde sabittir. Bu yüzden ağırlıklar kestirimde birbirini götürür (99.6, Adım 1) ve SH kapalı biçimde yazılabilir (Adım 3). Bu, hesabı elle izlemeyi kolaylaştırır; ama ağırlığın kestirimi değiştirdiği genel durumu göstermez. Genel durum sürekli yordayıcılı denetimde (99.6.1) sınanmıştır.
99.5 Formüller ve hesap adımları
MerQur'un hesap sırası: veri ve tasarım hazırlığı (_prepare; Bölüm 98 ile ortak) → Y düzeyleri ve referans → tasarım matrisi (sabit + yordayıcılar; kategorikte kukla) → ağırlıklı sözde olabilirliğin Newton–Raphson ile en büyüklenmesi → her gözlemin skor katkısı → tabakalı Taylor sandviç \mathbf V=\mathbf H^{-1}\mathbf G\mathbf H^{-1} → t(\nu-p) ya da z testleri, GA ve OR → terim başına ve model geneli Wald F ile ayarlı F → McFadden R^2.
99.5.1 Ağırlıklı sözde olabilirlik
- w_i: örnekleme ağırlığı (alt evren dışında ve "tasarımda tut" kuralındaki eksik satırlarda 0).
- y_{ij}: i. birim j. kategorideyse 1, değilse 0.
- p_{ij}: modelin i. birim için j. kategori olasılığı (99.1).
- \boldsymbol\theta: denklem-içi sıralı parametre vektörü; kodda
θ = vec(B)(survey_polytomous.py:276–277).
Neden "sözde" olabilirlik?
Örneklem eşit olasılıklı ve bağımsız seçilmediği için gerçek olabilirlik yazılamaz. \ell_w, evrenin tamamına model uydurulsaydı yazılacak log-olabilirliğin ağırlıklı kestirimidir. Onu en büyükleyen \hat{\boldsymbol\theta} evren parametresinin tutarlı kestiricisidir (Binder 1983; Roberts, Rao ve Kumar 1987). Ama \ell_w'nin eğriliği SH vermez ve olabilirlik oranı testleri \chi^2 dağılmaz; SH sandviçle, testler Wald ile yapılır (Bölüm 97.5.1).
99.5.2 Skor, Hessian ve Newton–Raphson
- \mathbf x_i=(1,x_{i1},\dots,x_{ip})^{\top}: sabitli yordayıcı vektörü.
- \mathbf u_i: i. birimin skor katkısı; (J-1)(p+1) uzunlukta. Kodda
U(:285–286). - \mathbf H: ağırlıklı negatif Hessian; (j,l) bloğu (p+1)\times(p+1) boyutlu (
:287–291). \delta_{jl}: j=l ise 1. - \lambda: adım uzunluğu; 1'den başlar, \ell_w düşerse yarıya iner (en çok 60 kez).
Koddaki tercih: Newton, marjinal başlangıç, adım yarılama
_fit_multinomial (survey_polytomous.py:275–328) kendi Newton–Raphson'unu kullanır (statsmodels MNLogit çağrılmaz). Başlangıç: eğimler 0, sabitler ağırlıklı marjinal log oranları \ln(\hat p_j/\hat p_r) (oranlar 10^{-8}'den küçükse 10^{-8}; :296–301). Bu başlangıçta \ell_w tam olarak boş model log-olabilirliğidir. Adım, \ell_w^{\text{yeni}}\ge\ell_w-10^{-12}(1+\lvert\ell_w\rvert) olana dek yarılanır (:312–321). Durma: \max_k\lvert\Delta\theta_k\rvert/(1+\lvert\theta_k\rvert)<10^{-10}, en çok 200 yineleme. \mathbf H çözülemezse sözde ters kullanılır (:304–307). Olasılıklar taşmayı önlemek için \max(0,\max_j\eta_{ij}) çıkarılarak hesaplanır (_mn_probs, :265–272).
Neden gözlenen ve beklenen bilgi aynı?
Çok terimli logit kanonik bağlantıdır: \partial^2\ell_w/\partial\boldsymbol\theta\partial\boldsymbol\theta^{\top} y_{ij}'ye bağlı değildir. Bu yüzden \mathbf H hem gözlenen hem beklenen bilgidir; sıralı modeldeki "gözlenen / beklenen bilgi" seçeneği (Bölüm 98) burada yoktur ve gerekmez. Çıktıdaki tanım notu bunu açıkça yazar.
99.5.3 Taylor sandviç kovaryansı
- \mathbf H: kestirim noktasındaki negatif Hessian ("ekmek"); kodda sözde tersi alınır (
:566). - \mathbf G: "et"; h. tabakanın a. PSU'sundaki ağırlıklı skor katkılarının toplamı \mathbf z_{ha}'nın tabaka içi kovaryansı (
survey_design.py:443–495). - n_h: tabakadaki PSU sayısı; \bar{\mathbf z}_h: tabaka ortalaması; f_h: FPC'den örnekleme oranı (yoksa 0).
- Tek PSU'lu tabaka: "Katkısız" kuralında atlanır; "Ortalamaya göre" kuralında PSU toplamı tüm PSU'ların ortalamasına göre merkezlenir.
- Ayrıntılı türetme ve tek PSU kuralları için Bölüm 93.5.2–93.5.3 ve 96.5.2'ye bakın.
Neden Taylor doğrusallaştırması?
\hat{\boldsymbol\theta}, \mathbf g(\boldsymbol\theta)=\mathbf 0 denkleminin çözümüdür. Birinci derece açılımla \hat{\boldsymbol\theta}-\boldsymbol\theta\approx\mathbf H^{-1}\sum_iw_i\mathbf u_i olur; yani kestirim, ağırlıklı skor katkılarının bir toplamı gibi davranır. Toplamın tasarım varyansı, PSU toplamlarının tabaka içi varyansıdır (Bölüm 93.5.3). Tabakalama varyansı azaltır, kümeleme artırır, eşit olmayan ağırlıklar çoğu zaman artırır; üçü de yalnız \mathbf G'de görünür (Binder 1983).
Ölçekleme yok
MerQur \mathbf G'yi (n-1)/(n-p) gibi bir küçük örneklem çarpanıyla büyütmez; çıktı notu bunu yazar ("ölçeklendirmesiz Taylor kovaryansı"). R svyVGAM::svy_vglm ile aynıdır. Ağırlıkların ölçeği (toplam n, evren büyüklüğü ya da ortalama 1) \hat{\boldsymbol\theta} ve \widehat{\mathbf V}'yi değiştirmez; yalnız \ell_w'yi ölçekler.
99.5.4 Serbestlik derecesi, t testleri, GA ve OR
- \nu: pozitif ağırlıklı satırları içeren PSU ve tabaka sayılarından (
survey_polytomous.py:548–553). - p: denklem başına eğim sayısı (sabit hariç); kodda
coef_df = nu - p(:903). - c=t_{1-\alpha/2;\,\nu-p}; "Normal (z)" seçilirse c=z_{1-\alpha/2} ve p değeri normalden (
_row,:607–627). - \SH_{jk}=\sqrt{\widehat V_{jk,jk}}.
Neden \nu-p, \nu-(J-1)(p+1) değil?
Payda sd'si, tasarımın bağımsız bilgi miktarı olan \nu'den "kestirilen eğim sayısı" çıkarılarak bulunur. MerQur bunu denklem başına sayar (p); ikili lojistikteki \nu+1-k kuralıyla (k=p+1) aynı sayıdır (Bölüm 97.5.3). R svy_vglm'in summary çıktısı ise z kullanır; bu yüzden R ile birebir p değeri için "Normal (z)" seçilmelidir (99.6.1, z satırları). \nu büyükken iki seçim aynı kararı verir; birkaç düzine PSU'lu tasarımda t daha temkinlidir.
99.5.5 Wald testleri
- S: sınanan katsayıların indeksleri. Model geneli: tüm denklemlerdeki tüm eğimler, q=p(J-1). Terim testi: bir yordayıcının (kategorikte tüm kuklalarının) tüm denklemlerdeki katsayıları (
:924–933). - \widehat{\mathbf V}_{SS}: \widehat{\mathbf V}'nin bu indekslere ait alt matrisi; çözülemezse sözde ters (
:571–582). - F: Wald F; z seçilirse payda sd'si sonsuz ve p=P(\chi^2_q>W) (
:592–595). - F_{\text{ayarlı}}: Fellegi (1980) ayarlı Wald F'si (Korn ve Graubard 1990); APA satırı bunu yazar.
İki F'nin payda sd'leri farklı tanımlıdır
Wald F'nin payda sd'si \nu-p, ayarlı F'ninki \nu-q+1'dir. Tek eğimli Tıp örneğinde (p=1, q=3) bunlar 397 ve 396'dır. Çok eğimli modelde terim testinde ayarlı sd, Wald sd'sinden büyük olabilir: Tıp #81 denetiminde age terimi için \nu=319, p=2, q=2: Wald F(2,\,317), ayarlı F(2,\,318). Bu bir hata değil, iki ayrı küçük örneklem yaklaşımıdır; raporda hangisinin kullanıldığı yazılmalıdır.
99.5.6 Uyum ölçüsü
- W_j=\sum_iw_iy_{ij}: j. kategorinin ağırlıklı toplamı; W_\bullet=\sum_iw_i.
- \ell_{w,0}: yalnız sabitli modelin (ağırlıklı marjinal oranlar) sözde log-olabilirliği (
_null_loglik,:630–637). - \ell_w ham ağırlıklarla hesaplanır; ağırlıklar 2 ile çarpılırsa \ell_w ve \ell_{w,0} iki katına çıkar, R^2_{\text{McF}} değişmez. Çıktıda bu ölçek notu yazılıdır.
99.5.7 Ayrışma ve tanımsız katsayılar
Bir kategori bir yordayıcı düzeyinde hiç gözlenmezse ilgili log-odds sonsuza gider. MerQur bunu ikili ve sıralı modellerdeki gibi doğrusal programla yakalar (_multinomial_separation): referans r'ye göre her denklemin olasılığı sınırsız artırabilen bir parametre yönü varsa (Albert ve Anderson 1984 tanımı) "tam ya da yarı-tam ayrışma" uyarısı yazılır ve ayrışmayı taşıyan değişkenler adlandırılır. Sabitler ölçüte ayrıca girmez; sonuç yordayıcıların konumuna ve ölçeğine bağlı değildir.
99.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/survey_multinomial/elle_hesap.py ile, MerQur çağrılmadan numpy ile hesaplanmıştır.
Adım 1 — Doymuş modelde kapalı biçim kestirim. Tek yordayıcı ikili ve model doymuş olduğundan \hat p_{ij}, bölge içindeki ağırlıklı oranlara eşittir. Sabit rural bölgenin, eğim urban − rural farkının log oranıdır:
- W_{j,h}: h bölgesinde j. kategorinin ağırlıklı toplamı (99.4 tablosu).
- Ağırlık bölge içinde sabit olduğundan W_{j,h}/W_{\text{none},h}=n_{j,h}/n_{\text{none},h}: ağırlıklar birbirini götürür.
active high için: \hat\alpha=\ln(6{,}80/73{,}95)=\ln(8/87)=-2{,}386467; \hat\beta=\ln(9{,}90/105{,}60)+2{,}386467=-2{,}367124+2{,}386467=0{,}019343. Aynı yolla active low: \hat\alpha=-2{,}068013, \hat\beta=1{,}581202; old: \hat\alpha=-0{,}637267, \hat\beta=0{,}503735.
Adım 2 — Newton–Raphson izi. MerQur'un başlangıç kuralıyla (sabitler ağırlıklı marjinal log oranları, eğimler 0):
| Yineleme | \alpha_{\text{AH}} | \beta_{\text{AH}} | \alpha_{\text{AL}} | \beta_{\text{AL}} | \alpha_{\text{old}} | \beta_{\text{old}} | \ell_w |
|---|---|---|---|---|---|---|---|
| 0 | −2,375045 | 0 | −0,883016 | 0 | −0,311447 | 0 | −470,193792 |
| 1 | −2,389598 | 0,021446 | −1,772696 | 1,311039 | −0,667785 | 0,525102 | −459,323959 |
| 2 | −2,386413 | 0,019293 | −2,032390 | 1,545820 | −0,636313 | 0,502850 | −458,852548 |
| 3 | −2,386467 | 0,019343 | −2,067488 | 1,580677 | −0,637269 | 0,503738 | −458,847075 |
| 4 | −2,386467 | 0,019343 | −2,068013 | 1,581202 | −0,637267 | 0,503735 | −458,847073 |
AH: active high, AL: active low. Yineleme 0'daki \ell_w, boş modelin \ell_{w,0}'ıdır. MerQur 6. yinelemede durur (göreli adım <10^{-10}).
Adım 3 — SH'nin kapalı biçimi. Doymuş modelde her bölgenin skor katkılarının ağırlıklı toplamı kestirimde tam sıfırdır (\sum_{i\in h}w_i(\mathbf y_i-\hat{\mathbf p}_h)=\mathbf 0). Tabaka ortalaması \bar{\mathbf z}_h=\mathbf 0 olur ve ağırlık tabakada sabit olduğu için sandviç, model tabanlı varyansın n_h/(n_h-1) katına iner:
- n_r=152, n_u=248: rural ve urban tabakadaki PSU (kişi) sayısı.
- n_{j,h}: h bölgesinde j. kategorideki kişi sayısı.
- 1/n_j+1/n_{\text{ref}}: iki oranın log oranının bilinen (Woolf) varyansı; n_h/(n_h-1) ise Taylor "et"indeki tabaka çarpanıdır.
- İki tabaka bağımsız olduğundan \hat\beta_j'nin varyansı iki bölgedeki varyansların toplamıdır.
active high için: rural \frac{152}{151}\big(\frac18+\frac1{87}\big)=1{,}006623\times0{,}136494=0{,}137398; \SH(\hat\alpha)=0{,}370673. Urban \frac{248}{247}\big(\frac19+\frac1{96}\big)=0{,}122020; \SH(\hat\beta)=\sqrt{0{,}137398+0{,}122020}=0{,}509331.
| Katsayı | \hat\theta | rural varyans | urban varyans | SH |
|---|---|---|---|---|
| \alpha_{\text{AH}} | −2,386467 | 0,137398 | — | 0,370673 |
| \alpha_{\text{AL}} | −2,068013 | 0,103082 | — | 0,321063 |
| \alpha_{\text{old}} | −0,637267 | 0,033453 | — | 0,182903 |
| \beta_{\text{AH}} | 0,019343 | 0,137398 | 0,122020 | 0,509331 |
| \beta_{\text{AL}} | 1,581202 | 0,103082 | 0,027477 | 0,361328 |
| \beta_{\text{old}} | 0,503735 | 0,033453 | 0,022412 | 0,236358 |
Aynı veride ağırlıksız ve tabakasız çalıştırmada çarpan tüm örneklem için 400/399 olur; \SH(\hat\alpha_{\text{AH}})=\sqrt{\tfrac{400}{399}\times0{,}136494}=0{,}369914. Fark küçüktür; çünkü bu tasarımda Taylor varyansını model varyansından ayıran tek şey n_h/(n_h-1) çarpanıdır.
Adım 4 — Katsayı tablosu. \nu=398, \nu-p=397, t_{0{,}975;\,397}=1{,}965957.
| Denklem | Terim | b | SH | t | p | OR | %95 GA (OR) |
|---|---|---|---|---|---|---|---|
| old / none | Sabit | −0,637267 | 0,182903 | −3,484 | 0,000549 | — | — |
| active low / none | Sabit | −2,068013 | 0,321063 | −6,441 | 3,43·10⁻¹⁰ | — | — |
| active high / none | Sabit | −2,386467 | 0,370673 | −6,438 | 3,49·10⁻¹⁰ | — | — |
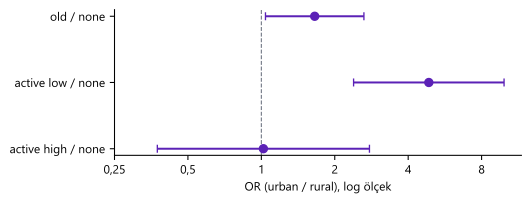
| old / none | urban | 0,503735 | 0,236358 | 2,131 | 0,033683 | 1,654891 | [1,039838; 2,633742] |
| active low / none | urban | 1,581202 | 0,361328 | 4,376 | 1,55·10⁻⁵ | 4,860795 | [2,388931; 9,890336] |
| active high / none | urban | 0,019343 | 0,509331 | 0,038 | 0,969725 | 1,019531 | [0,374569; 2,775042] |
Örnek, active low: t=1{,}581202/0{,}361328=4{,}3761; GA e^{1{,}581202\pm1{,}965957\times0{,}361328}=[2{,}3889;\ 9{,}8903].
Adım 5 — Wald testi. Eğimlerin kovaryans matrisi (sıra AH, AL, old):
Köşegen dışı terim, üç denklemin aynı referansı (none) paylaşmasından gelir: \frac{152}{151}\cdot\frac1{87}+\frac{248}{247}\cdot\frac1{96}=0{,}011570+0{,}010459=0{,}022029.
Tek yordayıcı olduğu için region terim testi model geneli testiyle aynıdır.
Adım 6 — Uyum. \ell_w=-458{,}847073, \ell_{w,0}=-470{,}193792; R^2_{\text{McF}}=1-458{,}847073/470{,}193792=0{,}024132. Referans kategori boş bırakılınca sıranın son düzeyi active high referans olur; katsayılar değişir (\beta_{\text{none}/\text{AH}}=-0{,}019343, işareti dönmüş; \beta_{\text{old}/\text{AH}}=0{,}484392), ama \ell_w, W=20{,}6652 ve F_{\text{ayarlı}}=6{,}8538 aynıdır.
Şekil 99.1. Kentte yaşamanın üç sigara kategorisi için odds oranı (referans: hiç içmeyen) ve %95 GA; log ölçek (Tıp #79).
99.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan (rows, wald_model, wald_terms, loglik) tam hassasiyetle alınmıştır; bu motor değerleri yuvarlamadan saklar. R: 4.5.3, survey 4.5 ve svyVGAM; svy_vglm(family = multinomial(refLevel = ...)). R'de p değerleri ve GA, MerQur'un t(\nu-p) tanımıyla coef() ve vcov() üzerinden hesaplanmıştır; Wald ve ayarlı F tanımdan. svy_vglm VGAM'ın varsayılan yakınsama ölçütüyle (10^{-7}) çalıştırılınca SH'lerde 10^{-5} düzeyinde fark kalıyordu; epsilon = 1e-13 ile fark kaybolmuştur. Python başvurusu kendi Newton'u ve kendi tabakalı “et” hesabıyla, ayrıca kapalı biçim (Adım 1 ve 3) ile karşılaştırılmıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b \alpha old | −0,637267 | −0,637267 | −0,637267 | 3,6e−15 | ✓ |
| SH \alpha old | 0,182903 | 0,182903 | 0,182903 | 3,9e−15 | ✓ |
| p \alpha old | 0,000549 | 0,000549 | 0,000549 | 9,9e−17 | ✓ |
| GA alt \alpha old | −0,996846 | −0,996846 | −0,996846 | 2,3e−14 | ✓ |
| GA üst \alpha old | −0,277687 | −0,277687 | −0,277687 | 1,7e−14 | ✓ |
| b \alpha AL | −2,068013 | −2,068013 | −2,068013 | 1,3e−14 | ✓ |
| SH \alpha AL | 0,321063 | 0,321063 | 0,321063 | 4,4e−15 | ✓ |
| p \alpha AL | 3,4330·10−10 | 3,4330·10−10 | 3,4330·10−10 | 1,4e−22 | ✓ |
| GA alt \alpha AL | −2,699209 | −2,699209 | −2,699209 | 8,0e−15 | ✓ |
| GA üst \alpha AL | −1,436816 | −1,436816 | −1,436816 | 2,4e−14 | ✓ |
| b \alpha AH | −2,386467 | −2,386467 | −2,386467 | 1,2e−14 | ✓ |
| SH \alpha AH | 0,370673 | 0,370673 | 0,370673 | 3,2e−15 | ✓ |
| p \alpha AH | 3,4937·10−10 | 3,4937·10−10 | 3,4937·10−10 | 2,9e−23 | ✓ |
| GA alt \alpha AH | −3,115193 | −3,115193 | −3,115193 | 4,8e−14 | ✓ |
| GA üst \alpha AH | −1,657740 | −1,657740 | −1,657740 | 2,4e−14 | ✓ |
| b \beta old | 0,503735 | 0,503735 | 0,503735 | 8,0e−15 | ✓ |
| SH \beta old | 0,236358 | 0,236358 | 0,236358 | 1,5e−09 | ✓ |
| p \beta old | 0,033683 | 0,033683 | 0,033683 | 1,1e−09 | ✓ |
| GA alt \beta old | 0,039065 | 0,039065 | 0,039065 | 2,9e−09 | ✓ |
| GA üst \beta old | 0,968406 | 0,968406 | 0,968406 | 2,9e−09 | ✓ |
| b \beta AL | 1,581202 | 1,581202 | 1,581202 | 4,4e−15 | ✓ |
| SH \beta AL | 0,361328 | 0,361328 | 0,361328 | 1,2e−09 | ✓ |
| p \beta AL | 1,5467·10−5 | 1,5467·10−5 | 1,5467·10−5 | 9,6e−13 | ✓ |
| GA alt \beta AL | 0,870846 | 0,870846 | 0,870846 | 2,3e−09 | ✓ |
| GA üst \beta AL | 2,291558 | 2,291558 | 2,291558 | 2,3e−09 | ✓ |
| b \beta AH | 0,019343 | 0,019343 | 0,019343 | 8,7e−14 | ✓ |
| SH \beta AH | 0,509331 | 0,509331 | 0,509331 | 9,0e−08 | ✓ |
| p \beta AH | 0,969725 | 0,969725 | 0,969725 | 5,3e−09 | ✓ |
| GA alt \beta AH | −0,981980 | −0,981980 | −0,981980 | 1,8e−07 | ✓ |
| GA üst \beta AH | 1,020666 | 1,020666 | 1,020666 | 1,8e−07 | ✓ |
| OR \beta old | 1,654891 | 1,654891 | — | 4,4e−16 | ✓ |
| OR GA alt \beta old | 1,039838 | 1,039838 | — | 4,4e−16 | ✓ |
| OR GA üst \beta old | 2,633742 | 2,633742 | — | 4,4e−16 | ✓ |
| OR \beta AL | 4,860795 | 4,860795 | — | 5,3e−15 | ✓ |
| OR GA alt \beta AL | 2,388931 | 2,388931 | — | 5,8e−15 | ✓ |
| OR GA üst \beta AL | 9,890336 | 9,890336 | — | 5,3e−15 | ✓ |
| OR \beta AH | 1,019531 | 1,019531 | — | 2,4e−15 | ✓ |
| OR GA alt \beta AH | 0,374569 | 0,374569 | — | 9,4e−16 | ✓ |
| OR GA üst \beta AH | 2,775042 | 2,775042 | — | 6,2e−15 | ✓ |
| Kapalı biçim \alpha old | −0,637267 | −0,637267 | — | 2,2e−16 | ✓ |
| Kapalı biçim SH \beta old | 0,236358 | 0,236358 | — | 1,2e−15 | ✓ |
| Kapalı biçim \alpha AL | −2,068013 | −2,068013 | — | 1,3e−15 | ✓ |
| Kapalı biçim SH \beta AL | 0,361328 | 0,361328 | — | 2,6e−15 | ✓ |
| Kapalı biçim \alpha AH | −2,386467 | −2,386467 | — | 4,4e−16 | ✓ |
| Kapalı biçim SH \beta AH | 0,509331 | 0,509331 | — | 2,9e−15 | ✓ |
| Wald W (region, 3 sd) | 20,665241 | 20,665241 | 20,665241 | 8,0e−09 | ✓ |
| Wald F | 6,888414 | 6,888414 | 6,888414 | 2,7e−09 | ✓ |
| Wald p | 0,000156 | 0,000156 | 0,000156 | 5,7e−13 | ✓ |
| Ayarlı F | 6,853799 | 6,853799 | 6,853799 | 2,6e−09 | ✓ |
| Ayarlı p | 0,000164 | 0,000164 | 0,000164 | 5,9e−13 | ✓ |
| \ell (ham ağırlık) | −458,847073 | −458,847073 | −458,847073 | 1,7e−13 | ✓ |
| \ell_0 | −470,193792 | −470,193792 | — | 0,0e+00 | ✓ |
| McFadden R^2 | 0,024132 | 0,024132 | — | 0,0e+00 | ✓ |
| Tasarım sd \nu | 398 | 398 | 398 | 0,0e+00 | ✓ |
Ek çalıştırmalar:
Varsayılan referans (son düzey: active high)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b \alpha old | 1,749200 | 1,749200 | 1,749200 | 3,4e−14 | ✓ |
| SH \alpha old | 0,384332 | 0,384332 | 0,384332 | 4,9e−14 | ✓ |
| b \alpha AL | 0,318454 | 0,318454 | 0,318454 | 3,0e−14 | ✓ |
| SH \alpha AL | 0,466196 | 0,466196 | 0,466196 | 2,3e−14 | ✓ |
| b \alpha none | 2,386467 | 2,386467 | 2,386467 | 2,2e−14 | ✓ |
| SH \alpha none | 0,370673 | 0,370673 | 0,370673 | 3,3e−14 | ✓ |
| b \beta old | 0,484392 | 0,484392 | 0,484392 | 4,4e−14 | ✓ |
| SH \beta old | 0,520792 | 0,520792 | 0,520792 | 8,8e−08 | ✓ |
| b \beta AL | 1,561859 | 1,561859 | 1,561859 | 3,3e−14 | ✓ |
| SH \beta AL | 0,588148 | 0,588148 | 0,588148 | 7,7e−08 | ✓ |
| b \beta none | −0,019343 | −0,019343 | −0,019343 | 5,2e−14 | ✓ |
| SH \beta none | 0,509331 | 0,509331 | 0,509331 | 9,0e−08 | ✓ |
Normal (z) test dağılımı
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| p (z) \alpha old | 0,000494 | 0,000494 | 0,000494 | 9,2e−17 | ✓ |
| p (z) \alpha AL | 1,1858·10−10 | 1,1858·10−10 | 1,1858·10−10 | 5,1e−23 | ✓ |
| p (z) \alpha AH | 1,2089·10−10 | 1,2089·10−10 | 1,2089·10−10 | 1,0e−23 | ✓ |
| p (z) \beta old | 0,033070 | 0,033070 | 0,033070 | 1,1e−09 | ✓ |
| p (z) \beta AL | 1,2083·10−5 | 1,2083·10−5 | 1,2083·10−5 | 7,9e−13 | ✓ |
| p (z) \beta AH | 0,969706 | 0,969706 | 0,969706 | 5,3e−09 | ✓ |
| Wald p (\chi^2_3) | 0,000124 | 0,000124 | 0,000124 | 4,7e−13 | ✓ |
%99 GA
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| %99 GA alt \alpha old | −1,110669 | −1,110669 | −1,110669 | 1,7e−13 | ✓ |
| %99 GA üst \alpha old | −0,163865 | −0,163865 | −0,163865 | 1,6e−13 | ✓ |
| %99 GA alt \alpha AL | −2,899011 | −2,899011 | −2,899011 | 2,5e−13 | ✓ |
| %99 GA üst \alpha AL | −1,237015 | −1,237015 | −1,237015 | 2,8e−13 | ✓ |
| %99 GA alt \alpha AH | −3,345867 | −3,345867 | −3,345867 | 3,4e−13 | ✓ |
| %99 GA üst \alpha AH | −1,427066 | −1,427066 | −1,427066 | 3,1e−13 | ✓ |
| %99 GA alt \beta old | −0,108024 | −0,108024 | −0,108024 | 3,8e−09 | ✓ |
| %99 GA üst \beta old | 1,115495 | 1,115495 | 1,115495 | 3,8e−09 | ✓ |
| %99 GA alt \beta AL | 0,645987 | 0,645987 | 0,645987 | 3,0e−09 | ✓ |
| %99 GA üst \beta AL | 2,516417 | 2,516417 | 2,516417 | 3,0e−09 | ✓ |
| %99 GA alt \beta AH | −1,298943 | −1,298943 | −1,298943 | 2,3e−07 | ✓ |
| %99 GA üst \beta AH | 1,337629 | 1,337629 | 1,337629 | 2,3e−07 | ✓ |
Ağırlıksız, tasarımsız (ağırlık seçilmedi)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b \alpha old | −0,637267 | −0,637267 | −0,637267 | 1,1e−14 | ✓ |
| SH \alpha old | 0,182529 | 0,182529 | 0,182529 | 1,0e−15 | ✓ |
| b \alpha AL | −2,068013 | −2,068013 | −2,068013 | 4,4e−15 | ✓ |
| SH \alpha AL | 0,320406 | 0,320406 | 0,320406 | 8,3e−15 | ✓ |
| b \alpha AH | −2,386467 | −2,386467 | −2,386467 | 1,3e−14 | ✓ |
| SH \alpha AH | 0,369914 | 0,369914 | 0,369914 | 1,3e−14 | ✓ |
| b \beta old | 0,503735 | 0,503735 | 0,503735 | 4,1e−15 | ✓ |
| SH \beta old | 0,235996 | 0,235996 | 0,235996 | 1,5e−09 | ✓ |
| b \beta AL | 1,581202 | 1,581202 | 1,581202 | 2,8e−14 | ✓ |
| SH \beta AL | 0,360686 | 0,360686 | 0,360686 | 1,2e−09 | ✓ |
| b \beta AH | 0,019343 | 0,019343 | 0,019343 | 9,5e−14 | ✓ |
| SH \beta AH | 0,508595 | 0,508595 | 0,508595 | 9,0e−08 | ✓ |
Sürekli yordayıcılar (Tıp #81, yalnız sayısal denetim: region ~ age + BMI, referans rural)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b \alpha urban | 0,213874 | 0,213874 | 0,213874 | 5,4e−11 | ✓ |
| SH \alpha urban | 0,966132 | 0,966132 | 0,966132 | 1,9e−12 | ✓ |
| b \alpha Marmara | −0,511943 | −0,511943 | −0,511943 | 6,2e−11 | ✓ |
| SH \alpha Marmara | 0,966276 | 0,966276 | 0,966276 | 2,5e−12 | ✓ |
| b age urban | −0,005360 | −0,005360 | −0,005360 | 7,4e−13 | ✓ |
| SH age urban | 0,007845 | 0,007845 | 0,007845 | 2,0e−15 | ✓ |
| b age Marmara | 0,004319 | 0,004319 | 0,004319 | 5,3e−13 | ✓ |
| SH age Marmara | 0,007705 | 0,007705 | 0,007705 | 1,9e−14 | ✓ |
| b BMI urban | 0,005857 | 0,005857 | 0,005857 | 1,1e−12 | ✓ |
| SH BMI urban | 0,033114 | 0,033114 | 0,033114 | 3,8e−14 | ✓ |
| b BMI Marmara | 0,017334 | 0,017334 | 0,017334 | 1,6e−12 | ✓ |
| SH BMI Marmara | 0,032433 | 0,032433 | 0,032433 | 8,5e−14 | ✓ |
| Model Wald W (4 sd) | 1,724253 | 1,724253 | 1,724253 | 1,4e−11 | ✓ |
| age Wald W (2 sd) | 1,430643 | 1,430643 | 1,430643 | 6,4e−11 | ✓ |
| age ayarlı F | 0,713079 | 0,713079 | 0,713079 | 3,2e−11 | ✓ |
Tabakalı kümeli tasarım (Limnoloji 079: 4 tabaka, 84 PSU)
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b Sabit [hyper] | 0,253687 | 0,253687 | 0,253687 | 1,1e−16 | ✓ |
| SH Sabit [hyper] | 0,661936 | 0,661936 | 0,661936 | 1,8e−14 | ✓ |
| b Sabit [eu] | 0,737102 | 0,737102 | 0,737102 | 5,6e−16 | ✓ |
| SH Sabit [eu] | 0,629646 | 0,629646 | 0,629646 | 1,6e−14 | ✓ |
| b Sabit [meso] | 0,635437 | 0,635437 | 0,635437 | 4,4e−16 | ✓ |
| SH Sabit [meso] | 0,674862 | 0,674862 | 0,674862 | 1,5e−14 | ✓ |
| b Marmara [hyper] | 0,401242 | 0,401242 | 0,401242 | 2,5e−15 | ✓ |
| SH Marmara [hyper] | 0,742657 | 0,742657 | 0,742657 | 2,3e−11 | ✓ |
| b Marmara [eu] | 0,162775 | 0,162775 | 0,162775 | 2,8e−15 | ✓ |
| SH Marmara [eu] | 0,711606 | 0,711606 | 0,711606 | 2,2e−11 | ✓ |
| b Marmara [meso] | 0,248524 | 0,248524 | 0,248524 | 1,8e−15 | ✓ |
| SH Marmara [meso] | 0,738792 | 0,738792 | 0,738792 | 1,8e−11 | ✓ |
| b black_sea [hyper] | −0,620652 | −0,620652 | −0,620652 | 1,8e−15 | ✓ |
| SH black_sea [hyper] | 0,763176 | 0,763176 | 0,763176 | 3,5e−13 | ✓ |
| b black_sea [eu] | −0,106022 | −0,106022 | −0,106022 | 1,2e−15 | ✓ |
| SH black_sea [eu] | 0,652690 | 0,652690 | 0,652690 | 4,6e−15 | ✓ |
| b black_sea [meso] | −0,238953 | −0,238953 | −0,238953 | 3,1e−16 | ✓ |
| SH black_sea [meso] | 0,761392 | 0,761392 | 0,761392 | 4,1e−14 | ✓ |
| b inner_anat. [hyper] | 0,497475 | 0,497475 | 0,497475 | 1,1e−15 | ✓ |
| SH inner_anat. [hyper] | 0,827752 | 0,827752 | 0,827752 | 2,5e−10 | ✓ |
| b inner_anat. [eu] | 0,110490 | 0,110490 | 0,110490 | 2,4e−15 | ✓ |
| SH inner_anat. [eu] | 0,789984 | 0,789984 | 0,789984 | 2,4e−10 | ✓ |
| b inner_anat. [meso] | 0,489223 | 0,489223 | 0,489223 | 6,7e−16 | ✓ |
| SH inner_anat. [meso] | 0,839425 | 0,839425 | 0,839425 | 2,6e−10 | ✓ |
| Model Wald W (9 sd) | 5,815952 | 5,815952 | 5,815952 | 1,3e−09 | ✓ |
| Ayarlı F | 0,581595 | 0,581595 | 0,581595 | 1,3e−10 | ✓ |
| Tasarım sd \nu | 80 | 80 | 80 | 0,0e+00 | ✓ |
139 değerin tamamı 10^{-6} ölçütüyle eşleşir. R'nin factor() işlevi düzeyleri alfabetik dizdiği için R'de ve bağımsız Python'da düzey sırası MerQur'unkine göre verilmiştir: Y düzeyleri verideki ilk görülme sırasıyla; Tıp #79'da region referansı rural; Tıp #81 ve Limnoloji denetimlerinde yordayıcı referansı ortak düzey sırasının ilk düzeyi.
99.7 Çıktıyı okuma
Sonuç metni (Tıp #79, referans none, Referans düzeyleri region=rural; kısaltılmış, sütunlar daraltılmış):
Karmaşık Örneklem — Çok Terimli Lojistik Regresyon (genelleştirilmiş logit)
  Y düzeyleri                    = old, active low, none, active high  (verideki ilk görülme sırası
                                   (etiketlerde sayı yok; sıra tanımlanmadı))
  Referans kategori              = none
  N (gözlem)                     = 400
  PSU sayısı                     = 400 (küme yok: her gözlem bir PSU)
  Tabaka sayısı                  = 2
  Tasarım df (ν)                 = 398
  Test df (ν − p)                = 397
  Log-olabilirlik                = -458.8471
  McFadden R²                    = 0.0241

Katsayılar (log(P(Y = j) / P(Y = referans)) = α_j + x'β_j)
  Değişken      Denklem          Katsayı     SE       t        p   %95 GA               OR
  Sabit         old / none       -0.6373  0.1829  -3.484   0.0005  [-0.9968, -0.2777]    —
  Sabit         active low / n   -2.0680  0.3211  -6.441  <0.0001  [-2.6992, -1.4368]    —
  Sabit         active high /    -2.3865  0.3707  -6.438  <0.0001  [-3.1152, -1.6577]    —
  region_urban  old / none        0.5037  0.2364   2.131   0.0337  [0.0391, 0.9684]   1.6549
  region_urban  active low / n    1.5812  0.3613   4.376  <0.0001  [0.8708, 2.2916]   4.8608
  region_urban  active high /     0.0193  0.5093   0.038   0.9697  [-0.9820, 1.0207]  1.0195

Model etkilerinin testleri (ayarlı Wald F, Taylor kovaryansı)
  Terim                       df1  Wald χ²       F  df2       p  Ayarlı F  df2       p
  Model geneli (sabit hariç)    3  20.6652  6.8884  397  0.0002    6.8538  396  0.0002
  region                        3  20.6652  6.8884  397  0.0002    6.8538  396  0.0002

── APA 7 ÖZET ──
  Model geneli (ayarlı Wald): F(3, 396) = 6.85, p < .001
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Y düzeyleri (sıra kaynağı) | Düzeyler ve sıranın kaynağı: kullanıcı sırası, Veri sekmesinde tanımlı sıra, sayısal/doğal sıra ya da verideki ilk görülme sırası ("etiketlerde sayı yok; sıra tanımlanmadı"). | Varsayılan referans bu sıradaki son düzeydir. |
| Referans kategori | Kullanılan r. | Her katsayı "j yerine r" log-odds'udur. |
| Tasarım df (ν), Test df (ν − p) | \nu ve katsayı testlerinin sd'si. | \nu küçükse t ile z belirgin farklıdır. |
| Log-olabilirlik | Ham ağırlıklı \ell_w. | Yalnız aynı ağırlıklarla kurulan modeller arasında karşılaştırılır. |
| McFadden R² | 1-\ell_w/\ell_{w,0}. | Ağırlık ölçeğinden bağımsızdır; küçük değerler çok kategorili modellerde olağandır. |
| Denklem | "j / r". | Sütun genişliği en uzun etikete göre ayarlanır; ad kesilmez. |
| OR | e^{b}; sabitlerde "—". | Kentte, active low olma odds'u none'a göre 4,86 kat. |
| Model etkilerinin testleri | Wald \chi^2, F, ayarlı F. | Terim testi, yordayıcının tüm denklemlerdeki etkisini birlikte sınar. |
| "Tam ya da yarı-tam ayrışma" uyarısı | Doğrusal program ayrışma yönü buldu (99.5.7); uyarı ilgili değişkenleri adlandırır. | Katsayı ve testler güvenilmez; kategorileri birleştirmek gerekebilir. |
| "Yakınsamadı" uyarısı | 200 yinelemede durma ölçütü sağlanmadı (:905–906). |
Ayrışma ya da çok seyrek kategori olasıdır. |
| Doğrusal bağımlı sütun notu | Düşürülen sütunlar (:547). |
Katsayı satırında "kestirilemez". |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Bölgeye göre tabakalanmış ve ağırlıklandırılmış örneklemde (n = 400; tasarım sd = 398) sigara durumu, hiç içmeyenler referans alınarak tasarım tabanlı çok terimli lojistik regresyonla modellendi; standart hatalar Taylor doğrusallaştırmasıyla hesaplandı. Bölge, sigara durumuyla anlamlı biçimde ilişkiliydi, ayarlı Wald F(3,\ 396) = 6{,}85, p < 0{,}001. Kentte yaşayanların az içici olma odds'u hiç içmeyenlere göre kırsaldakilerin 4,86 katıydı (%95 GA [2,39; 9,89]; t(397) = 4{,}38; p < 0{,}001); eski içici olma odds'u 1,65 kat (%95 GA [1,04; 2,63]; p = 0{,}034) idi. Çok içici olma odds'unda bölge farkı yoktu (OR = 1,02; %95 GA [0,37; 2,78]; p = 0{,}97).
99.8 Uzman soruları
S1. Varsayılan referans neden son düzey? R ne yapar?
Kod r = J - 1 alır (survey_polytomous.py:874). VGAM multinomial() de son düzeyi referans alır; R nnet::multinom ve Bölüm 50 ise ilk düzeyi. Metin düzeyleri, sıra tanımlanmamışsa verideki ilk görülme sırasıyla dizildiği için "son düzey" çoğu zaman analiz için anlamlı kategori değildir. Referansı formda açıkça seçmek gerekir.
S2. Katsayı testleri neden t(\nu-p)? `svy_vglm` z veriyor.
MerQur, ikili ve sıralı modellerle tutarlı olarak t'yi tasarım sd'siyle kullanır: \nu-p, ikili lojistikteki \nu+1-k ile aynı sayıdır. R svy_vglm özetinde z basar. "Normal (z)" seçeneği de vardır; seçilince p değerleri R özetiyle birebir aynıdır (99.6.1). \nu=398 olan Tıp örneğinde fark dördüncü ondalıktadır.
S3. Model doymuşken Taylor SH'si neden model SH'sine bu kadar yakın?
Ağırlık tabaka içinde sabit ve küme yok. Doymuş modelde skor katkılarının tabaka toplamı sıfırdır; "et" matrisi tabaka içi model bilgisinin n_h/(n_h-1) katına iner (99.6, Adım 3). Ağırlık tabaka içinde değişseydi ya da küme olsaydı fark büyürdü: kümede birbirine benzeyen birimlerin skor katkıları aynı PSU toplamında birikir ve \mathbf G büyür. Limnoloji kümeli denetiminde 240 gözlem yalnız 84 PSU'dadır ve \nu=80'e iner; t(77) kritik değeri 1,9913'tür.
S4. Terim testi neden tüm denklemleri birlikte içeriyor? Tek denklem için test var mı?
Bir yordayıcının "etkisi yok" hipotezi, onun J-1 denklemdeki katsayılarının hepsinin sıfır olmasıdır; bu nedenle terim testi q=(J-1)\times(\text{terimin sütun sayısı}) sd'lidir (:928–933). Tek denklemdeki katsayının testi katsayı tablosundaki t'dir. "Yordayıcının iki kategori arasındaki etkisi aynı mı" gibi doğrusal kısıtlar (\beta_{j}=\beta_{l}) için arayüzde test yoktur; res.V ve res.beta ile elle hesaplanabilir.
S5. Ayrışma neden katsayı büyüklüğüyle değil doğrusal programla yakalanıyor?
Büyüklüğe dayalı bir sezgi (ör. \lvert\hat\theta\rvert>15 ya da SH >10^3) sabitleri de sayar: büyük ölçekli ve merkezlenmemiş bir yordayıcıyla sabit -16 çıkarsa ayrışma olmadan uyarı verir; yarı-tam ayrışmada katsayı 15'e varmadan Newton durursa uyarıyı kaçırır. Ayrışmanın tanımı (Albert ve Anderson 1984) olabilirliği sınırsız artıran bir yönün varlığıdır; doğrusal program bunu doğrudan sınar, konum ve ölçekten etkilenmez. İkili, sıralı ve çok terimli modeller aynı ölçütü kullanır. Uyarı çıktığında ilgili çapraz tabloya bakmak (Bölüm 94) seyrek hücreyi gösterir.
S6. R ile kategorik yordayıcının referansı neden farklı çıkabilir?
MerQur kukla kodlamasında ortak düzey sırasının ilk düzeyini referans alır: tanımlı sıra, sayısal sıra ya da verideki ilk görülme sırası. R factor() ise yerel ayara göre alfabetik sıralar (black_sea < Marmara). Alfabetik sıra etiketin dilinden ve yazımından gelen keyfi bir sıra olduğu için MerQur onu kendiliğinden kullanmaz. Katsayılar aynı modelin farklı parametrelemesidir; karşılaştırmada "Referans düzeyleri" alanı (region=Marmara) ya da R'de levels = ile sıra eşitlenmelidir.
S7. Alt evren modeli ile veriyi süzmek arasında fark var mı?
Var. Alt evren seçeneği alan dışındaki satırlara w_i=0 verir; satırlar tasarımda kalır, \mathbf z_{ha}'larına sıfır katkı verirler (:521–526). Böylece PSU sayısı ve tabaka içi merkezleme tam tasarımdan gelir. Veriyi süzmek ise yalnız alt evrenin bulunduğu PSU'ları bırakır ve tabaka yapısını değiştirir; SH genellikle yanlış (çoğu zaman küçük) çıkar (Bölüm 96.8 S4).
S8. "Tasarımda tut" eksik değer kuralı nokta kestirimini neden değiştirmez?
Eksik satırın w_i'si 0 yapılır; kestirim denklemi aynı satırlarla çözülür. Satır yalnız \mathbf G'ye sıfır katkıyla girer: PSU'su ve tabakası sayılır, tabaka ortalaması ve n_h değişir. Küme yoksa eksik satır kendi PSU'sudur; n_h büyür ve SH biraz değişir. Tıp örneğinde eksik değer yoktur; iki kural aynı sonucu verir.
99.9 Sık hatalar ve tuzaklar
- Varsayılan referansı denetlememek. Metin Y'de varsayılan referans, düzey sırasının (sıra tanımlanmamışsa verideki ilk görülme sırasının) son düzeyidir. Referansı yorumlanacak kategoriye göre seçin.
- Sıralı kategorilere çok terimli model kurmak. Sıra bilgisi atılır, parametre sayısı (J-1) katına çıkar. Önce sıralı modeli (Bölüm 98) ve orantılı odds testini deneyin.
- Tek denklemin t testini yordayıcının genel etkisi sanmak. Genel etki, terim satırındaki ayarlı F'dir.
- Seyrek kategoriyle model kurmak. Tıp örneğinde
active high17 kişidir; OR GA'sı [0,37; 2,78] kadar geniştir. Seyrek kategorileri birleştirmek gerekebilir. - Ham log-olabilirliği farklı ağırlık ölçekli modellerle karşılaştırmak. \ell_w ağırlık toplamıyla ölçeklenir.
- Metin çıktısındaki kesik denklem adına güvenmek. "active high /" kesiktir; tam ad Tablo sekmesinde "active high / none" olarak yazılıdır.
- Bölüm 50'nin frekans ağırlığını örnekleme ağırlığı için kullanmak. n ağırlık toplamına çıkar, SH yanlış küçülür; tabaka ve küme yok sayılır.
99.10 Kaynaklar
- Agresti, A. (2013). Categorical data analysis (3. baskı). Wiley.
- Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1–10. https://doi.org/10.1093/biomet/71.1.1
- Binder, D. A. (1983). On the variances of asymptotically normal estimators from complex surveys. International Statistical Review, 51(3), 279–292. https://doi.org/10.2307/1402588
- Fellegi, I. P. (1980). Approximate tests of independence and goodness of fit based on stratified multistage samples. Journal of the American Statistical Association, 75(370), 261–268. https://doi.org/10.1080/01621459.1980.10477462
- Korn, E. L., & Graubard, B. I. (1990). Simultaneous testing of regression coefficients with complex survey data: Use of Bonferroni t statistics. The American Statistician, 44(4), 270–276. https://doi.org/10.1080/00031305.1990.10475737
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8). https://doi.org/10.18637/jss.v009.i08
- Lumley, T., & Scott, A. (2017). Fitting regression models to survey data. Statistical Science, 32(2), 265–278. https://doi.org/10.1214/16-STS605
- Roberts, G., Rao, J. N. K., & Kumar, S. (1987). Logistic regression analysis of sample survey data. Biometrika, 74(1), 1–12. https://doi.org/10.1093/biomet/74.1.1
- Yee, T. W. (2010). The VGAM package for categorical data analysis. Journal of Statistical Software, 32(10). https://doi.org/10.18637/jss.v032.i10