53. Lasso Regresyon
Analiz kimliği: lasso · Menü adı: Lasso Regresyon · Panel: gui/panels/analyses/lasso_regression.py (form 41–102, execute 107–116; ortak çağrı ridge_regression.pen_execute 164–177) · Motor: stats/regression.py, Regression._regularized (satır 1479–1675); ızgara, CV, relaxed, kararlılık ve cezalı GLM stats/regularized_extras.py; katsayı yolu metni stats/regression_extras.py (623–672) · Çağrı: stats_panel.py:6080–6098
53.1 Ne işe yarar
Lasso (least absolute shrinkage and selection operator), doğrusal regresyon katsayılarını mutlak değerlerinin toplamıyla cezalandırarak kestirir. Ceza bazı katsayıları tam sıfıra indirir; böylece kestirim ve değişken seçimi tek adımda yapılır. Cevapladığı soru: "Çok sayıda aday açıklayıcı arasından, yeni hastalarda iyi tahmin veren seyrek bir model hangisidir?" Model Bölüm 52'dekiyle aynıdır, y_i=\beta_0+\sum_j\beta_jz_{ij}+\varepsilon_i; değişen yalnız kestirim ölçütüdür (53.5.1).
Ne zaman kullanılır?
- Aday açıklayıcı sayısı fazla, gerçekten etkili olanların az olduğu düşünülüyorsa (seyreklik varsayımı).
- Amaç tahmin ve yorumlanabilir, kısa bir değişken listesiyse.
- p, n'ye yakın ya da büyükse; lasso en çok \min(n,p) değişken seçer.
Ne zaman kullanılmaz?
- Açıklayıcılar güçlü ilişkili gruplar oluşturuyorsa: lasso gruptan genellikle birini rastgele seçer. Ridge Regresyon ya da Düzenlileştirilmiş Regresyon içindeki ElasticNet daha kararlıdır.
- Seçilen değişkenler için geçerli p değeri ve GA gerekiyorsa: lasso bunları vermez; "Seçilenlerle OLS" çıktısının p değerleri seçim sonrası iyimserdir (53.5.7).
- Değişken seçimi kuramsal olarak önceden belirlenmişse: Çoklu Doğrusal Regresyon.
- Sonuç ikili ya da sayımsa ve OR/oran oranı yorumu gerekiyorsa: İkili Lojistik Regresyon, Poisson / Negatif Binom Regresyon. Lasso'nun "Hedef türü" seçeneği cezalı tahmin modeli verir.
Sık karıştırılan analizler. Adımsal seçim (Çoklu Doğrusal Regresyon menüsünde) değişkenleri tek tek ekleyip çıkarır ve katsayıları büzmez; lasso ise süreklidir: λ küçüldükçe değişkenler sırayla modele girer. Ridge hiç sıfırlamaz. ElasticNet iki cezayı karıştırır. MerQur'da Düzenlileştirilmiş Regresyon menüsünün "LASSO (L1)" yöntemi aynı lasso modelini aynı birimle kestirir; ama varsayılanı otomatik α'dır, R^2(CV) tanımı farklıdır ve kat karıştırma, tekrarlı CV, bootstrap kararlılığı sunar (Bölüm 107).
53.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Doğrusal ilişki | E(y\mid\mathbf x) doğrusal. | Denetlenmez. |
| Bağımsız gözlemler | Her satır ayrı birim. | Denetlenmez. |
| Seyreklik | Gerçek katsayıların çoğu sıfır ya da çok küçük. | Denetlenmez; "Seçim kararlılığı" dolaylı bilgi verir. |
| Sayısal ölçek | Açıklayıcılar standartlaştırılır. | Otomatik (1/n-SS, 52.5.1). |
| Ceza düzeyi | α, tahmin hatasını en küçükleyecek biçimde seçilmeli. | İsteğe bağlı otomatik α (k-kat CV; λ_min ya da λ_1SE). |
Eksik değer. Ridge ile aynıdır (52.2): hedefi eksik satırlar, sonra herhangi bir açıklayıcısı eksik satırlar atılır.
Uç durumlar (koddan):
- Sabit açıklayıcı atılır ve uyarılır; en az p+2 gözlem gerekir (30 açıklayıcıda 32).
- α ≥ λ_max ise bütün katsayılar sıfırdır; otomatik α kapalıyken "α = 2 ≥ λ_max = 1.48562: bu ceza düzeyinde tüm katsayılar sıfırdır (boş model)." uyarısı yazılır (
regression.py:1560–1562). - Koordinat inişi yineleme sınırına (200000) ulaşıp ikilik boşluğu toleransa inmezse "Lasso koordinat inişi yineleme sınırında yakınsamadı" uyarısı çıkar.
- Hedef sabitse R^2 ve λ_max tanımsızdır; MerQur açık bir hata iletisiyle durur (R
glmnetve Düzenlileştirilmiş Regresyon menüsü gibi). - Kategorik açıklayıcılar kukla kodlanır, kuklalar da standartlaştırılıp cezalandırılır; bir faktörün kuklaları birbirinden bağımsız seçilebilir (grup cezası yoktur).
53.3 Parametreler
Varsayılanlar lasso_regression.py:41–102, ridge_regression.py:85–137 ve stats_panel.py:6052–6070'den alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken | ilk sayısal sütun | Tahmin edilen değişken. | — |
| Bağımsız değişkenler | en az 1 | Aday açıklayıcılar. | Kategorikler kukla kodlanır. |
| α (Düzenlileştirme) | 0,1 (aralık 10^{-6}–10^{6}, 6 ondalık) | Ceza katsayısı; amaç \frac{1}{2n}\text{RSS}+\alpha\lVert\boldsymbol\beta\rVert_1. | α büyüdükçe daha çok katsayı sıfırlanır; α ≥ λ_max boş model. |
| Otomatik α (çapraz-doğrulama) | kapalı | α'yı k-kat CV ile seçer. | Model seçilen α ile kurulur. |
| CV kat sayısı | 5 (3–20) | Ardışık kat sayısı. | Otomatik α, öneri satırı ve CV performansı. |
| λ seçim kuralı | λ_min | λ_min ya da λ_1SE. | λ_1SE daha seyrek model verir. |
| Katsayı yolu | kapalı | Izgara boyunca standart katsayılar ve giriş sırası. | Ek bölüm ve grafik paneli. |
| Hedef türü | Sürekli (doğrusal) | İkili: cezalı lojistik; sayım: cezalı Poisson. | Amaç fonksiyonu ve çıktı. |
| Kategorik öngörücüler | boş | Sayısal kodlu sütunları kukla kodlatır. | Tasarım matrisi. |
| Ek çıktı: CV performansı | kapalı | Seçilen α'da dışarıda bırakılmış hata. | Ek bölüm. |
| Ek çıktı: Seçilenlerle OLS | kapalı | Sıfırdan farklı katsayılı değişkenlerle cezasız yeniden uydurma (relaxed lasso, γ = 0). | Ek tablo. |
| Ek çıktı: Seçim kararlılığı | kapalı | 100 alt örneklemde seçilme sıklığı. | Ek bölüm. |
| Grafik | Katsayı grafiği (varsayılan) | Standart katsayı çubukları (+ yol + CV panelleri); ya da 3B yüzey. | Yalnız Grafik sekmesi. |
Varsayılan α neden ridge'de 1, lasso'da 0,1?
İki amaç farklı ölçeklidir. Ridge'de kayıp \text{RSS}'dir (n ile büyür); lasso'da \frac{1}{2n}\text{RSS}'dir (gözlem başına). Lasso'nun α'sı doğrudan \frac1n\lvert\mathbf z_j^{\top}\mathbf y_c\rvert ile, yani standart açıklayıcı ile y arasındaki kovaryansla karşılaştırılır (53.5.2). Bu nedenle lasso α'sı y'nin biriminde bir "eşik"tir ve y'nin SS'si büyükse 0,1 neredeyse cezasız, küçükse çok güçlü olabilir. Varsayılan bir başlangıç değeridir; öneri satırı ya da otomatik α ile denetlenmelidir.
Otomatik α kapalıyken kural ve kat sayısı
Kural λ_1SE seçilir ya da kat sayısı 5'ten farklıysa, MerQur otomatik α kapalı olsa da bu ayarla k-kat CV'yi çalıştırır ve "α SEÇİM ÖLÇÜTÜNÜN ÖNERİSİ" bölümünde önerilen α'yı yazar; model elle girilen α ile kurulur (regularized_extras.py:411–450). Tıp örneğinde λ_1SE seçiliyken: "λ_1SE ölçütünün önerdiği α = 0.278377 (5-katlı çapraz doğrulama)."
53.4 Tıp örneği
Dosya: english/datasets/Tip/50_lasso_30_pred_5_active.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/50_lasso_30_pred_5_aktif.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #50'deki gibidir.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
treatment_response |
Bağımlı | sürekli (yanıt puanı) | ort. −0,037; SS 2,875; −8,17–10,53 |
x01 … x30 |
Aday açıklayıcı (30) | sürekli | ortalamalar −0,08–0,15; SS 0,90–1,10 |
patient_id |
— | kimlik | kullanılmaz |
n ve eksik değer: 250 hasta, eksik değer yok. Açıklayıcılar arası en büyük mutlak korelasyon 0,168'dir: neredeyse bağımsızdırlar. Dosya adı ("30 aday, 5 etkin") veriyi üreten senaryoyu yansıtır; tek başına y ile en güçlü ilişkili beş değişken x22 (r=0{,}518), x04 (0,455), x28 (−0,338), x10 (−0,329) ve x15 (0,277)'tir; geri kalanların hepsinde \lvert r\rvert<0{,}15.
Klinik soru: 30 aday biyolojik özellikten hangileri tedavi yanıtını tahmin etmek için gereklidir?
Seçilen ayarlar: Arayüz varsayılanları (α = 0,1, otomatik α kapalı). Ek çalıştırmalar: otomatik α (5 kat, λ_min ve λ_1SE; 10 kat), α = 2 (boş model), katsayı yolu, CV performansı, Seçilenlerle OLS ve Seçim kararlılığı açık. Cezalı lojistik yolunu göstermek için türetilmiş ikili hedef: yanit_var = 1{treatment_response > 0} (122 olay, 128 olay yok; yalnız bu doğrulama için).
53.5 Formüller ve hesap adımları
Hesap sırası Ridge ile aynı iskelettedir (52.5): sayısallaştırma ve liste bazında silme → 1/n-SS ile standartlaştırma → veriye dayalı λ ızgarası (otomatik α kapalıyken de, λ_max uyarısı ve yol için) → otomatik α açıksa k-kat CV → scikit-learn Lasso ile sıkı toleranslı uydurma → özgün ölçeğe dönüş → R^2 → ek çıktılar (regression.py:1479–1675). Standartlaştırma (52.5.1) ve özgün ölçeğe dönüş (52.5.4) ridge'dekiyle aynıdır.
53.5.1 Amaç fonksiyonu
- \frac{1}{2n}: kayıp gözlem başına ortalamadır; \tfrac12 türevi sadeleştirir. scikit-learn
Lassove glmnet (alpha = 1) ile aynı amaç; MerQur'un α'sı glmnet'in λ'sıdır. - \alpha\lVert\boldsymbol\beta\rVert_1: L_1 cezası; \beta_0 cezalandırılmaz, \hat\beta_0=\bar y.
- \mathbf z_i: standart açıklayıcılar (52.5.1).
Neden L_1 cezası katsayıları tam sıfırlar?
Kısıtlı biçimde yazılırsa lasso, \sum\lvert\beta_j\rvert\le t bölgesinde kareler toplamını en küçükler. Bu bölge köşeleri eksenler üzerinde olan bir "elmas"tır; kareler toplamının eş-değer elipsleri bölgeye çoğu zaman bir köşede değer ve köşede bazı koordinatlar sıfırdır. Ridge'in bölgesi (\sum\beta_j^2\le t) ise yuvarlaktır ve teğet noktası neredeyse hiç eksen üzerinde olmaz. Cebirsel olarak: \lvert\beta\rvert'in sıfırdaki alt türevi [-1{,}1] aralığıdır; bu aralık, gradyanı küçük olan katsayılar için sıfır çözümünü optimum yapar (53.5.2).
53.5.2 Optimum koşulu (KKT) ve λ_max
Optimumda her j için
- Sol taraf: j. standart açıklayıcı ile artığın gözlem başına kovaryansı.
- Sıfırdan farklı her katsayıda bu kovaryans tam \pm\alpha'dır; sıfır katsayılarda α'yı aşamaz.
Bütün katsayılar sıfırken artık \mathbf y_c'dir; ikinci koşulun her j için sağlanması \alpha\ge\max_j\lvert\mathbf z_j^{\top}\mathbf y_c\rvert/n demektir:
- \lambda_{\max}: boş modelin optimum olduğu en küçük ceza; bunun üstündeki her α aynı (boş) modeli verir.
- İlk giren değişken, \lvert\mathbf z_j^{\top}\mathbf y_c\rvert'si en büyük olan, yani y ile korelasyonu en büyük olandır.
53.5.3 Koordinat inişi ve yumuşak eşikleme
Diğer katsayılar sabitken \beta_j'nin optimumu kapalı biçimlidir:
- \mathbf r=\mathbf y_c-\mathbf Z_c\boldsymbol\beta: güncel artık.
- S: yumuşak eşikleme; \lvert u\rvert\le\gamma ise sonuç tam 0.
- c_j=1: standartlaştırma sayesinde (52.5.1).
Koordinatlar sırayla döngüyle güncellenir (Friedman vd. 2007, 2010). MerQur bu döngüyü scikit-learn Lasso'nun derlenmiş koordinat inişine bırakır.
Koddaki tercih: sıkı tolerans
scikit-learn varsayılanı tol = 1e-4 (ikilik boşluğu) kötü koşullu veride katsayının 3. anlamlı basamağını bozabilir. MerQur tol = 1e-12 ve max_iter = 200000 kullanır (regularized_extras.py:40–41, 481–498) ve yakınsama uyarısını yakalar. "Sıfırlandı" bayrağı katsayının tam sıfır olmasına göre konur (regression.py:1594). Katsayı yolu tablosu ise ayrı bir çağrıyla tol = 1e-8 kullanır (regression_extras.py:630–631); giriş λ'ları bu yoldan okunur.
53.5.4 λ ızgarası (glmnet tanımı)
Izgara yol boyunca uydurulur ve glmnet'in yol durdurma kuralı uygulanır: m\ge5 iken açıklanan varyans artışı R^2_m-R^2_{m-1}<10^{-5}R^2_m ya da R^2_m>0{,}999 olursa ızgara \lambda_m'de kesilir (regularized_extras.py:57–74, 77–88, 117–144).
- \varepsilon:
lambda.min.ratio; glmnet varsayılanı. - R^2_m: tam veride \lambda_m'deki eğitim R^2'si.
- Sonuç, R
glmnet(x, y)çağrısının kendi λ dizisiyle aynıdır (doğrulamada 69 değerin hepsi 5\times10^{-15} içinde).
Neden ızgara veriden kuruluyor?
Lasso için anlamlı α aralığı (0,\lambda_{\max}]'dır ve λ_max verinin ölçeğine bağlıdır. Sabit bir ızgara (ör. 10^{-3}–10^{2}) bazı verilerde boş modele hiç ulaşmaz, bazılarında ızgaranın çoğunu boş modelde harcar; bu yüzden ızgara veriden, λ_max'tan kurulur. Yol durdurma kuralı, R^2'nin artık değişmediği çok küçük λ'larda boşuna uydurma yapılmasını önler.
53.5.5 Otomatik α: k-kat CV
Ardışık K kat; her eğitim katında 1/n-SS ile yeniden ölçekleme ve tam ızgara boyunca yol; kat MSE'leri kat büyüklüğüyle ağırlıklı ortalanır; SE ve λ_min/λ_1SE tanımları ridge'dekiyle aynıdır (52.5.6). Bu, R cv.glmnet(foldid = ardışık, lambda = ızgara) tanımıdır (regularized_extras.py:501–539). Kural λ_1SE ise α = λ_1SE alınır; λ_1SE, CV hatası \text{CV}(\lambda_{\min})+\text{SE}(\lambda_{\min})'i aşmayan en büyük λ'dır. Seçilen α ızgaranın ucundaysa uyarılır.
Koddaki tercih: Lasso CV her zaman k-kat
Lasso panelinde LOO, GCV gibi ölçütler yoktur; otomatik α yalnız k-kat CV ile yapılır. Uyarı satırı "Çapraz-doğrulama ile seçilen α = … (5-katlı CV)" biçimindedir; kullanılan kural "ÇAPRAZ DOĞRULAMA EĞRİSİ" bölümündeki "Kullanılan kural" satırında yazılır.
53.5.6 Uyum ölçüleri
R^2 ve düzeltilmiş R^2 ridge'dekiyle aynı formüllerdir (52.5.5).
Düzeltilmiş R²'nin serbestlik derecesi
Düzeltilmiş R^2 etkin serbestlik derecesiyle hesaplanır. Lasso uyumu etkin küme A üzerinde yerel olarak doğrusaldır; şapka matrisinin izi \mathrm{df}_H=1+\operatorname{rank}(\mathbf Z_{c,A})'dır (sabit dahil; Zou, Hastie ve Tibshirani 2007; regression.py:50–69). Sıfırlanan katsayılar sayılmaz: α ≥ λ_max'ta boş modelde \mathrm{df}_H=1 ve düzeltilmiş R^2=0'dır. Sonuç metni df'yi "Düzeltilmiş R² etkin serbestlik derecesiyle: df = tr(H_λ) = …" satırında yazar.
53.5.7 Seçilenlerle OLS (relaxed lasso, γ = 0)
Sıfırdan farklı (\lvert\beta_j\rvert>10^{-10}) katsayılı değişkenler \mathcal S ile ham ölçekte cezasız EKK kurulur (regularized_extras.py:590–602, statsmodels OLS):
- \mathbf X_{\mathcal S}: sabit sütunu ve seçilen değişkenlerin ham değerleri.
- Katsayılar lasso'nun büzme yanlılığından kurtulur (Meinshausen 2007'nin γ = 0 durumu).
Seçim sonrası çıkarım
Bu p değerleri ve GA'lar seçimin veriden yapıldığını hesaba katmaz; aynı veriyle hem seçip hem test etmek p'leri küçültür. MerQur bunu tablonun altında "Not: p ve GA seçim sürecini hesaba katmaz" diye yazar. Geçerli çıkarım için ayrı bir doğrulama örneklemi ya da seçim sonrası çıkarım yöntemleri gerekir.
53.5.8 Seçim kararlılığı
B=100 alt örneklem çekilir; her biri m=\lfloor n/2\rfloor gözlemden iadesiz oluşur (numpy default_rng(42)); her alt örneklem kendi 1/n-SS'siyle ölçeklenir ve aynı α ile lasso uydurulur (regularized_extras.py:605–628):
- \hat\Pi_j: j. değişkenin seçilme sıklığı.
- 0,6 eşiği Meinshausen ve Bühlmann'ın (2010) önerdiği 0,6–0,9 aralığının alt ucudur.
- Tohum (seed) sabit olduğundan sonuç her çalıştırmada aynıdır; formda tohum değiştirilemez.
Meinshausen–Bühlmann ile fark
Özgün kararlılık seçimi her alt örneklemde bütün λ yolunu dolaşır ve \max_\lambda\hat\Pi_j(\lambda)'ya bakar; hata kontrolü (beklenen yanlış seçim sayısı sınırı) bu tanıma dayanır. MerQur tek α'da sıklık verir: betimleyicidir, hata sınırı taşımaz. Bölüm 107'deki "Bootstrap kararlılık" ise iadeli, n büyüklüğünde örneklem ve 10^{-8} eşiği kullanır; iki sıklık aynı veride farklı çıkar.
53.5.9 Cezalı lojistik ve Poisson lasso
- \ell: Bernoulli ya da Poisson log-olabilirliği (standart ölçekte).
- Bu amaç glmnet
family = "binomial"/"poisson",alpha = 1ile birebir aynıdır.
IRLS dış döngüsünde her adımda ağırlıklı lasso alt problemi \frac{1}{2n}\sum w_i(z_i-\beta_0-\mathbf z_i^{\top}\boldsymbol\beta)^2+\alpha\lVert\boldsymbol\beta\rVert_1 scikit-learn koordinat inişiyle (ağırlıklar \sum w=n'ye ölçeklendiği için \alpha_{\text{sk}}=\alpha n/\sum w_i) çözülür; amaç azalmazsa adım yarılanır (regularized_extras.py:654–712). Izgara λ_max ile aynı formülden kurulur, durdurma kuralı açıklanan sapmanın mutlak artışına (<10^{-5}) dayanır (regularized_extras.py:715–733; glmnet'in lojistik kuralı). CV ölçütü test katındaki ortalama sapmadır; olasılıklar [10^{-5},1-10^{-5}]'e kırpılır. Çıktıda R^2 yerine D^2=1-D/D_0 verilir; "Seçilenlerle OLS" burada seçilenlerle cezasız GLM'dir (z testleri). Seçim kararlılığı yalnız Gauss modelde hesaplanır.
53.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/lasso/elle_hesap.py ile (MerQur ve scikit-learn çağrılmadan; kendi koordinat inişimiz, durma ölçütü \max\lvert\Delta\beta\rvert<10^{-15}) hesaplanmıştır.
Adım 1 — Standartlaştırma ve kovaryanslar. \bar y=-0{,}037336. Örnek: x04 için \bar x=-0{,}019432, s=0{,}937505. Gözlem başına kovaryanslar \frac1n\mathbf z_j^{\top}\mathbf y_c:
| Açıklayıcı | x22 | x04 | x28 | x10 | x15 | x01 |
|---|---|---|---|---|---|---|
| \frac1n\mathbf z_j^{\top}\mathbf y_c | 1,485616 | 1,304469 | −0,969217 | −0,944687 | 0,793490 | −0,157929 |
Adım 2 — λ_max ve ızgara. \lambda_{\max}=1{,}485616 (x22). Izgara 1{,}485616\times10^{-4}'e kadar 100 değer olarak kurulur; yol durdurma kuralı 69. değerde (\lambda_{69}=0{,}0026572) keser. α = 2 > λ_max olduğundan o çalıştırmada bütün katsayılar 0, \hat\beta_0=\bar y ve b_0=-0{,}037336'dır.
Adım 3 — α = 0,1'de ilk koordinat turu. \boldsymbol\beta=\mathbf 0, \mathbf r=\mathbf y_c'den başlanır ve j=1,\dots,30 sırayla güncellenir. Örneğin ilk adım: \beta_{01}=S(-0{,}157929;\,0{,}1)=-0{,}057929. Tur sonunda 16 katsayı sıfırdan farklıdır, ör. \beta_{04}=1{,}202609, \beta_{22}=1{,}191214, \beta_{21}=0{,}250972, \beta_{06}=-0{,}164946. Sonraki turlarda zayıf olanlar yeniden sıfıra iner; 19 turda yakınsar.
Adım 4 — Çözüm ve KKT denetimi. α = 0,1'de 12 katsayı sıfırdan farklıdır:
| Açıklayıcı | β (std.) | B (ham) | Açıklayıcı | β (std.) | B (ham) | |
|---|---|---|---|---|---|---|
| x22 | 1,210506 | 1,161903 | x21 | 0,109411 | 0,121949 | |
| x04 | 1,197555 | 1,277386 | x27 | 0,053562 | 0,057474 | |
| x10 | −0,825242 | −0,813085 | x06 | −0,050638 | −0,048854 | |
| x28 | −0,745072 | −0,704910 | x16 | −0,048387 | −0,047566 | |
| x15 | 0,641611 | 0,635618 | x24 | −0,041672 | −0,039689 | |
| x12 | 0,006706 | 0,006797 | x08 | −0,040666 | −0,042599 |
Sabit: \hat\beta_0=\bar y=-0{,}037336; ham ölçekte b_0=0{,}037957. KKT: sıfırdan farklı 12 katsayının hepsinde \frac1n\mathbf z_j^{\top}\mathbf r=\pm0{,}100000 (işaretleri katsayıyla aynı); sıfır katsayılarda en büyük \lvert\frac1n\mathbf z_j^{\top}\mathbf r\rvert=0{,}094414 (x01) < 0,1. \lVert\hat{\boldsymbol\beta}\rVert_1=4{,}971031, \text{RSS}=570{,}671958, amaç 570{,}671958/500+0{,}1\times4{,}971031=1{,}638447.
Adım 5 — Uyum. R^2=0{,}722814; 12 katsayı sıfırdan farklı olduğundan \mathrm{df}_H=1+12=13 ve R^2_{\text{düz}}=1-(1-0{,}722814)\times249/(250-13)=0{,}708779.
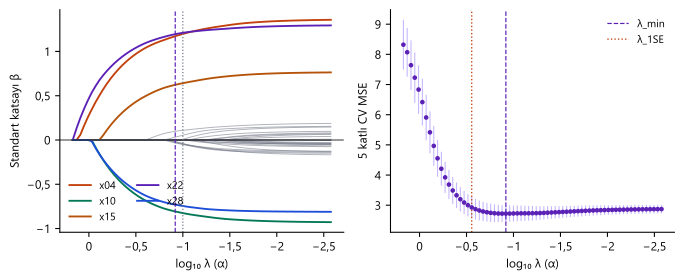
Adım 6 — Katsayı yolu. Değişkenlerin modele girdiği λ'lar (yolda ilk sıfırdan farklı olduğu ızgara noktası): x22 1,3536; x04 1,2334; x28 ve x10 0,9330; x15 0,7058; x21 0,2311; x06 0,1593; x27 ve x16 0,1451. İlk beş giriş, tek başına en güçlü ilişkili beş değişkendir.
Adım 7 — 5 katlı CV. Ardışık 5 kat (her biri 50 hasta), her katta yeniden ölçekleme ve 69 λ'lık yol:
λ_1SE, CV hatası 2{,}722430+0{,}274652=2{,}997082'yi aşmayan en büyük λ'dır. λ_min modeli 11 değişken seçer (α = 0,1'deki listeden x12 düşer), R^2=0{,}717043. λ_1SE modeli tam olarak beş güçlü değişkeni (x04, x10, x15, x22, x28) seçer, R^2=0{,}673403. 10 katlı CV'de \lambda_{\min}=0{,}100044, \lambda_{1\text{SE}}=0{,}278377.
Şekil 53.1. Sol: lasso katsayı yolu (λ sağdan sola küçülür; renkli beş güçlü değişken, gri diğer 25; noktalı çizgi α = 0,1, kesikli λ_min). Sağ: 5 katlı CV hatası ± SE; kesikli λ_min, noktalı λ_1SE.
Adım 8 — CV performansı (α = 0,1). Dışarıda bırakılmış tahminlerden \text{MSE}_{\text{CV}}=2{,}726820, RMSE 1,651309, MAE 1,318031, R^2_{\text{CV}}=0{,}651350 (beş kat R^2'sinin kat büyüklüğüyle ağırlıklı ortalaması, 52.5.8). Eğitim R^2'si (0,7228) ile fark 0,071'dir.
Adım 9 — Seçilenlerle OLS. 12 değişkenle EKK: R^2=0{,}737726, R^2_{\text{düz}}=0{,}724446, sd=237. x04: B=1{,}420502 (lasso: 1,277386), SH 0,104112, t=13{,}644. Büzme kalkınca güçlü katsayılar büyür; zayıf olanlar (x06 p=0{,}182, x12 p=0{,}106) cezasız modelde de anlamlı değildir.
Adım 10 — Seçim kararlılığı. 100 alt örneklem, m=125: beş güçlü değişken 1,00; x21 0,85; x27 0,72; x06 0,69; x08 0,66; x16 0,63 (≥ 0,6, "✓"); x24 0,59 eşiğin hemen altındadır. Hiç seçilmeyen değişken yoktur (en düşük x29, 0,17): α = 0,1, yarım örneklemde gürültü değişkenlerini de ara sıra modele alacak kadar küçüktür.
Adım 11 — Cezalı lojistik lasso. yanit_var hedefinde α = 0,05: IRLS 6 dış adımda yakınsar; 8 katsayı sıfırdan farklıdır (x04 0,709485; x22 0,634650; x28 −0,452680; x10 −0,440530; x15 0,358020; x06, x27, x05 küçük); D=214{,}855027, D_0=346{,}429576, D^2=0{,}379802. Otomatik α: λ_max = 0,186835, ızgara 74 değer (sapma kuralıyla), \lambda_{\min}=0{,}010446, \lambda_{1\text{SE}}=0{,}031899; λ_min modelinde D^2=0{,}569214 ve 22 katsayı sıfırdan farklıdır.
53.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucunun coefficients tablosundan ve extras/extra_tables alanlarından alınmıştır (R^2'nin 6 ondalık yuvarlaması bellekte devre dışı). R: 4.5.3, glmnet 5.1 (alpha = 1, standardize = TRUE, thresh = 1e-14): katsayılar; glmnet'in kendi λ dizisi (uzunluk ve değerler); cv.glmnet(foldid = ardışık, lambda = aynı dizi); lm() (relaxed); seçim kararlılığında Python'un default_rng(42) ile ürettiği aynı 100 alt örneklem R'ye dosyayla aktarılmıştır; lojistik lasso ve relaxed GLM glmnet(family = "binomial") ve glm() ile.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| α = 0,1: standart katsayılar β (30 + sabit) | 1,197555 | 1,197555 | 1,197555 | 2,2e−09 | ✓ |
| α = 0,1: özgün ölçek katsayıları B (30 + sabit) | 1,277386 | 1,277386 | 1,277386 | 2,2e−09 | ✓ |
| α = 0,1: sabit terim b₀ | 0,037957 | 0,037957 | 0,037957 | 6,8e−11 | ✓ |
| α = 0,1: sıfırdan farklı katsayı sayısı | 12 | 12 | 12 | 0,0e+00 | ✓ |
| α = 0,1: R² | 0,722814 | 0,722814 | 0,722814 | 3,1e−11 | ✓ |
| α = 0,1: düzeltilmiş R² (df = 13) | 0,708779 | 0,708779 | 0,708779 | 3,2e−11 | ✓ |
| λ_max (boş modelin başladığı ceza) | 1,485616 | 1,485616 | 1,485616 | 4,9e−15 | ✓ |
| λ ızgarası uzunluğu (yol durdurma kuralı) | 69 | 69 | 69 | 0,0e+00 | ✓ |
| λ ızgarası: 69 değer (gösterilen en küçük) | 0,002657 | 0,002657 | 0,002657 | 4,9e−15 | ✓ |
| 5 kat: λ_min | 0,120503 | 0,120503 | 0,120503 | 3,2e−16 | ✓ |
| 5 kat: λ_1SE | 0,278377 | 0,278377 | 0,278377 | 4,4e−16 | ✓ |
| 5 kat: CV MSE (λ_min) | 2,722430 | 2,722430 | 2,722430 | 1,6e−10 | ✓ |
| 5 kat: SE (λ_min) | 0,274652 | 0,274652 | 0,274652 | 6,4e−11 | ✓ |
| Otomatik α (λ_min): B (30 + sabit) | 1,250492 | 1,250492 | 1,250492 | 2,4e−09 | ✓ |
| Otomatik α (λ_min): R² | 0,717043 | 0,717043 | 0,717043 | 7,3e−12 | ✓ |
| Otomatik α (λ_1SE): B (30 + sabit) | 1,078492 | 1,078492 | 1,078492 | 2,7e−10 | ✓ |
| 10 kat: λ_min | 0,100044 | 0,100044 | 0,100044 | 4,2e−17 | ✓ |
| 10 kat: λ_1SE | 0,278377 | 0,278377 | 0,278377 | 4,4e−16 | ✓ |
| α = 2 (≥ λ_max): B (30 + sabit; boş model) | −0,037336 | −0,037336 | −0,037336 | 0,0e+00 | ✓ |
| CV performansı α = 0,1: MSE | 2,726820 | 2,726820 | 2,726820 | 4,2e−09 | ✓ |
| CV performansı α = 0,1: MAE | 1,318031 | 1,318031 | 1,318031 | 5,7e−10 | ✓ |
| CV performansı α = 0,1: R²_CV | 0,651350 | 0,651350 | 0,651350 | 3,7e−10 | ✓ |
| Relaxed OLS: B (12 + sabit) | 1,420502 | 1,420502 | 1,420502 | 4,7e−15 | ✓ |
| Relaxed OLS: SH | 0,104112 | 0,104112 | 0,104112 | 3,7e−16 | ✓ |
| Relaxed OLS: t | 13,643972 | 13,643972 | 13,643972 | 3,7e−14 | ✓ |
| Relaxed OLS: p | 0,181934 | 0,181934 | 0,181934 | 2,7e−15 | ✓ |
| Relaxed OLS: %95 GA alt | 1,215399 | 1,215399 | 1,215399 | 1,1e−13 | ✓ |
| Relaxed OLS: R² | 0,737726 | 0,737726 | 0,737726 | 2,2e−16 | ✓ |
| Relaxed OLS: düzeltilmiş R² | 0,724446 | 0,724446 | 0,724446 | 4,4e−16 | ✓ |
| Kararlılık: seçilme sıklığı (30; gösterilen x21) | 0,850000 | 0,850000 | 0,850000 | 0,0e+00 | ✓ (aynı alt örneklemler) |
| Lojistik lasso α = 0,05: β (30 + sabit) | 0,709485 | 0,709485 | 0,709485 | 1,1e−10 | ✓ |
| Lojistik lasso α = 0,05: B (30 + sabit) | 0,756780 | 0,756780 | 0,756780 | 1,2e−10 | ✓ |
| Lojistik lasso α = 0,05: sapma | 214,855027 | 214,855027 | 214,855027 | 5,4e−09 | ✓ |
| Lojistik lasso α = 0,05: D² | 0,379802 | 0,379802 | 0,379802 | 1,6e−11 | ✓ |
| Lojistik relaxed GLM: B (8 + sabit) | 1,918602 | 1,918602 | 1,918602 | 6,0e−10 | ✓ |
| Lojistik ızgara: λ_max | 0,186835 | 0,186835 | 0,186835 | 1,7e−16 | ✓ |
| Lojistik ızgara uzunluğu | 74 | 74 | 74 | 0,0e+00 | ✓ |
| Lojistik lasso CV: λ_min | 0,010446 | 0,010446 | 0,010446 | 4,7e−17 | ✓ |
| Lojistik lasso CV: λ_1SE | 0,031899 | 0,031899 | 0,031899 | 5,6e−17 | ✓ |
| Lojistik lasso CV (λ_min): D² | 0,569214 | 0,569214 | 0,569214 | 4,8e−09 | ✓ |
| Lojistik lasso CV (λ_min): B (30) | 1,592783 | 1,592783 | 1,592783 | 8,0e−08 | ✓ |
En büyük farklar lasso katsayılarındadır (2\times10^{-9}) ve CV λ_min modelindeki lojistik katsayılardadır (8\times10^{-8}); bunlar MerQur'un ikilik boşluğu (10^{-12}) ile glmnet'in durma ölçütünün (10^{-14}, sapma değişimi) farklı tanımlarından gelir. Izgara uzunluğu, λ_min ve λ_1SE üç kaynakta aynı ızgara noktasıdır.
53.7 Çıktıyı okuma
Sonuç metni (α = 0,1, katsayı yolu, CV performansı, Seçilenlerle OLS ve Seçim kararlılığı açık; kısaltılmış):
MODEL: Lasso Regresyon (α=0.1)
──────────────────────────────────────────────────
n = 250  |  Hedef: treatment_response
R² = 0.722814  Düzeltilmiş R² = 0.708779
Düzeltilmiş R² etkin serbestlik derecesiyle: df = tr(H_λ) = 13 (sabit dahil; Düz.R² = 1 − (1 − R²)(n − 1)/(n − df)).

── LASSO KATSAYI YOLU ──
    Giriş sırası (katsayının sıfırdan ayrıldığı en büyük λ): x22 (λ=1.354), x04 (λ=1.233),
    x28 (λ=0.933), x10 (λ=0.933), x15 (λ=0.7058), x21 (λ=0.2311), ...

── ÇAPRAZ DOĞRULAMA TAHMİN PERFORMANSI ──
    5-katlı CV (seçilen α): MSE = 2.7268, RMSE = 1.6513, MAE = 1.318, R²_CV = 0.6513
    Etkili serbestlik derecesi df(α) = 12.000

── SEÇİLEN DEĞİŞKENLERLE OLS YENİDEN FİTİ (relaxed lasso) ──
    12 değişken: R² = 0.7377, Düz. R² = 0.7244
                                       B         SE        t        p   95% CI
    Sabit terim                 0.062145    0.09608    0.647   0.5184   [-0.1271, 0.2514]
    x04                           1.4205     0.1041   13.644  <0.0001   [1.215, 1.626]
    x06                         -0.12667    0.09462   -1.339   0.1819   [-0.3131, 0.05973]
    ...
    Not: p ve GA seçim sürecini hesaba katmaz (seçim sonrası çıkarım iyimserdir).

── SEÇİM KARARLILIĞI (alt-örneklem) ──
    100 alt-örneklem (m = 125, iadesiz), α = 0.1; seçilme sıklığı (✓: ≥ 0.6)
    x04                       1.00  ✓
    ...
    x21                       0.85  ✓
    ...
    Hiç seçilmeyen: 0 değişken
Otomatik α açıkken (λ_min) metin şunu ekler:
── ÇAPRAZ DOĞRULAMA EĞRİSİ ──
    λ_min = 0.1205  (CV MSE = 2.7224 ± 0.2747)
    λ_1SE = 0.27838  (CV MSE = 2.9276 ± 0.3529)
    Kullanılan kural: λ_min → α (λ) = 0.1205
UYARILAR:
  ⚠ Çapraz-doğrulama ile seçilen α = 0.120503 (5-katlı CV).
Tablo sekmesi: Değişken · Katsayı (ham) · Katsayı (std.) · Sıfırlandı ("Evet" ya da "—").
| Öğe | Nasıl yorumlanır |
|---|---|
| "Sıfırlandı: Evet" | Bu α'da değişken modelde yok. Başka bir α'da (ya da başka örneklemde) girebilir; "etkisiz" kanıtı değildir. |
| Katsayı (std.) | Büzülmüş etki; aynı ölçekte karşılaştırılabilir ama sıfıra doğru yanlıdır. |
| Giriş sırası | Değişkenlerin önem sırasına kaba bir gösterge; ilişkili değişkenlerde sıra kararsızdır. |
| λ_min / λ_1SE | λ_1SE, tahmin hatasından az ödün verip belirgin biçimde daha seyrek model verir (burada 11 yerine 5 değişken). |
| R^2_{\text{CV}} | Yeni veride beklenen açıklama oranı. |
| Seçilenlerle OLS | Büzmesiz etki büyüklüğü; p ve GA iyimserdir. |
| Seçilme sıklığı | 1'e yakın değerler seçimin örneklemden bağımsız olduğunu gösterir. |
| Yorum satırı | "Lasso 18/30 özelliğin katsayısını sıfıra çekti" — sıfırlanan sayısı. |
Tabloda "−0"
scikit-learn sıfırlanan katsayıların bir kısmı için işaretli sıfır (−0,0) döndürür; gösterim bunu "0" olarak yazar (stats_panel.py:10355–10357). Değer tam sıfırdır; "Sıfırlandı" sütunu "Evet" yazar.
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Tedavi yanıtını 30 aday açıklayıcıdan tahmin etmek için lasso regresyon kullanıldı (n = 250; açıklayıcılar 1/n-standart sapmayla standartlaştırıldı). Ceza katsayısı beş katlı çapraz doğrulamayla seçildi; bir standart hata kuralı (\lambda_{1\text{SE}} = 0{,}278) beş açıklayıcıyı (x04, x10, x15, x22, x28) seçti ve model eğitim verisinde varyansın %67,3'ünü açıkladı. En küçük çapraz doğrulama hatasını veren ceza (\lambda_{\min} = 0{,}121; CV MSE = 2{,}72 \pm 0{,}27) 11 açıklayıcı seçti (R^2 = 0{,}717). Beş açıklayıcı 100 alt örneklemin hepsinde seçildi.
53.8 Uzman soruları
S1. MerQur'un α'sı glmnet'in λ'sı mı?
Gauss ailesinde evet: amaç \frac{1}{2n}\text{RSS}+\alpha\lVert\boldsymbol\beta\rVert_1, açıklayıcılar 1/n-SS ile standart. glmnet Gauss ailesinde y'yi de içeride ölçekler, ama L_1 cezası ölçeğe göre doğrusal olduğundan lasso'da bu, λ'nın anlamını değiştirmez; katsayılar 2\times10^{-9} içinde aynıdır. Elastik ağda (0<\text{l1}<1) bu eşdeğerlik bozulur (Bölüm 107). Ridge panelindeki α ise farklı birimdedir (52.5.2).
S2. λ_max neden "x22'nin kovaryansı"?
KKT koşuluna göre bütün katsayılar sıfırken optimumun bozulmaması için her j'de \lvert\mathbf z_j^{\top}\mathbf y_c\rvert/n\le\alpha olmalıdır. Standart açıklayıcılarda bu, s_y\lvert r_{jy}\rvert'dir; en büyüğü x22'ye aittir (1,4856) ve ilk giren de odur. α bu değerin üstündeyse model boştur ve MerQur uyarır.
S3. Ardışık katlar neden? Sonuç veri sırasına bağlı mı?
Evet. Katlar karıştırılmadan ardışık bloklardır (scikit-learn KFold(shuffle = False), cv.glmnet(foldid = …)); bu deterministik ve yeniden üretilebilirdir ama veri hasta kabul sırasına göre diziliyse katlar homojen olmayabilir. Bu panelde karıştırma yoktur; Bölüm 107'deki menü tohumlu karıştırma ve tekrarlı CV sunar. Sıralı veride satırlar önceden karıştırılmalıdır.
S4. λ_1SE neden önerilir?
CV eğrisi minimumun etrafında genellikle düzdür ve λ_min, CV'nin rastgele dalgalanmasına duyarlıdır; özellikle gürültü değişkenlerini almaya eğilimlidir. λ_1SE, istatistiksel olarak ayırt edilemeyen modeller arasından en sadesini seçer (Hastie vd. 2009, §7.10). Bu veride λ_1SE tam olarak beş güçlü değişkeni seçer; λ_min 11 değişken seçer ve fazladan altısının seçilme sıklığı 0,63–0,85 arasındadır.
S5. Seçim kararlılığı neden alt örneklem, neden 0,6?
Meinshausen ve Bühlmann (2010) \lfloor n/2\rfloor'lik iadesiz alt örneklemleri önerir: iadeli bootstrap'te yinelenen gözlemler seçimi yapay olarak kararlılaştırır. 0,6, önerilen 0,6–0,9 eşik aralığının alt ucudur. MerQur tek α'da çalışır ve hata sınırı vermez; yöntem betimleyici kullanılmalıdır. Tohum 42 sabittir; sonuç her çalıştırmada aynıdır.
S6. Bir faktörün kuklaları ayrı ayrı mı seçiliyor?
Evet. Kuklalar sıradan sütunlar gibi standartlaştırılıp L_1 ile cezalandırılır; bir faktörün yalnız bazı düzeyleri modelde kalabilir ve sonuç referans düzeyin seçimine bağlıdır. Bütün düzeyleri birlikte seçen grup lasso MerQur'da yoktur. Bu durumda faktörü tek bir sayısal kodla girmek de doğru değildir; düzeylerin birlikte yorumlanması gerekir.
S7. Lasso'nun serbestlik derecesi nedir? "df(α) = 12.000" nereden geliyor?
Zou, Hastie ve Tibshirani (2007), Gauss lasso'da sıfırdan farklı katsayı sayısının serbestlik derecesinin yansız kestiricisi olduğunu göstermiştir. "CV performansı" bölümündeki df satırı bu sayıdır (regularized_extras.py:918–921). Ridge'deki df(\alpha) ise iz formülüdür ve tamsayı değildir.
S8. Relaxed lasso neden γ = 0? glmnet'in `relax = TRUE`'su ile aynı mı?
MerQur yalnız γ = 0 durumunu, yani seçilenlerle tam cezasız EKK'yı verir. glmnet relax = TRUE aynı EKK katsayılarını hesaplar ve CV ile \hat\beta(\gamma)=\gamma\hat\beta_{\text{lasso}}+(1-\gamma)\hat\beta_{\text{EKK}} karışımını seçer. MerQur'un tablosu bu karışımın γ = 0 ucudur; p değerleri seçim sonrası iyimserdir. Doğrulamada R lm() ile 10^{-13} düzeyinde aynıdır.
S9. Lojistik lasso'da ızgara neden Gauss'takinden farklı biçimde kesiliyor?
glmnet'in yol durdurma kuralı ailelere göre farklıdır: Gauss'ta açıklanan varyans artışının göreli değeri (<10^{-5}R^2), lojistik ve Poisson'da açıklanan sapma artışının mutlak değeri (<10^{-5}) kullanılır. MerQur bu ayrımı izler (regularized_extras.py:733); bu veride lojistik ızgara 74 değerde kesilir ve R glmnet'in kendi dizisiyle aynı uzunluktadır.
53.9 Sık hatalar ve tuzaklar
- Seçilen değişkenleri "gerçek nedenler" diye sunmak. Lasso tahmin için seçer; ilişkili değişkenlerden birini alıp diğerini bırakabilir. Kararlılık sıklıkları ve λ_1SE ile birlikte raporlanmalıdır.
- Varsayılan α = 0,1'i veriden bağımsız sanmak. α, y'nin biriminde bir eşiktir; y başka birimle ölçülse aynı α farklı model verir. Otomatik α ya da öneri satırı kullanılmalıdır.
- Seçilenlerle OLS'nin p değerlerini kanıt gibi okumak. Seçim aynı veriyle yapılmıştır; p'ler iyimserdir.
- Düzeltilmiş R^2'yi genelleme ölçüsü sanmak. Etkin serbestlik derecesiyle düzeltilse de eğitim verisine dayanır; yeni veride beklenen başarım için R^2_{\text{CV}} kullanılmalıdır.
- "−0" görünen katsayıyı negatif etki sanmak. Tam sıfırdır; "Sıfırlandı" sütununa bakın.
- Sıralı veride ardışık katlar. Satırlar zamana ya da merkeze göre diziliyse CV yanlı olabilir; bu panelde karıştırma yoktur.
- Ridge ve lasso α'larını karşılaştırmak. Biri \text{RSS}, diğeri \text{RSS}/(2n) ölçeğindedir; aynı sayı aynı ceza değildir.
53.10 Kaynaklar
- Belloni, A., & Chernozhukov, V. (2013). Least squares after model selection in high-dimensional sparse models. Bernoulli, 19(2), 521–547. https://doi.org/10.3150/11-BEJ410
- Efron, B., Hastie, T., Johnstone, I., & Tibshirani, R. (2004). Least angle regression. The Annals of Statistics, 32(2), 407–499. https://doi.org/10.1214/009053604000000067
- Friedman, J., Hastie, T., Höfling, H., & Tibshirani, R. (2007). Pathwise coordinate optimization. The Annals of Applied Statistics, 1(2), 302–332. https://doi.org/10.1214/07-AOAS131
- Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2. baskı). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Hastie, T., Tibshirani, R., & Wainwright, M. (2015). Statistical learning with sparsity: The lasso and generalizations. CRC Press. https://doi.org/10.1201/b18401
- Meinshausen, N. (2007). Relaxed lasso. Computational Statistics & Data Analysis, 52(1), 374–393. https://doi.org/10.1016/j.csda.2006.12.019
- Meinshausen, N., & Bühlmann, P. (2010). Stability selection. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 72(4), 417–473. https://doi.org/10.1111/j.1467-9868.2010.00740.x
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x
- Tibshirani, R. J., Taylor, J., Lockhart, R., & Tibshirani, R. (2016). Exact post-selection inference for sequential regression procedures. Journal of the American Statistical Association, 111(514), 600–620. https://doi.org/10.1080/01621459.2015.1108848
- Zou, H., Hastie, T., & Tibshirani, R. (2007). On the "degrees of freedom" of the lasso. The Annals of Statistics, 35(5), 2173–2192. https://doi.org/10.1214/009053607000000127