97. Ağırlıklı Lojistik Regresyon (Karmaşık Örneklem)
Analiz kimliği: survey_logistic · Menü adı: Ağırlıklı Lojistik Regresyon (Karmaşık Örneklem) · Panel: gui/panels/analyses/survey_logistic.py · Motor: stats/survey_design.py, _run_survey_glm (satır 1615–2085) ve run_survey_logistic (2105–2121); ek çıktılar stats/survey_extras.py (pseudo_r2, classification, archer_lemeshow; satır 320–361)
97.1 Ne işe yarar
Ağırlıklı lojistik regresyon, karmaşık örneklem tasarımıyla toplanmış veride iki kategorili bir sonucun (diyabet var/yok) olasılığını açıklayıcılarla modeller ve evren düzeyindeki odds oranlarını (OR) tasarıma uygun belirsizlikle verir. Cevapladığı soru: "Bu örneklemin temsil ettiği evrende, BMI'daki bir birimlik artış diyabet odds'unu kaç kat değiştirir?"
Model, ikili lojistik regresyonla (Bölüm 46) aynıdır:
- \pi_i: i. birimde olay olasılığı; Y_i=1 "olay (Y = 1) düzeyi"dir.
- \mathbf x_i=(1,x_{i1},\dots,x_{ip})^{\top}; \boldsymbol\beta log-odds ölçeğinde katsayılar, e^{\beta_j} OR.
- Bölüm 46'dan farkı yalnız kestirimin hedefi ve SH'nin tanımıdır: burada \boldsymbol\beta, evrenin tamamına lojistik model uydurulsaydı bulunacak değerdir; SH örnekleme tasarımından gelir.
Neden sözde olabilirlik?
Gözlemler bağımsız ve aynı olasılıkla seçilmediği için gerçek olabilirlik yazılamaz. Bunun yerine evren log-olabilirliği \sum_{i\in U}\ell_i(\boldsymbol\beta)'nın ağırlıklı kestirimi en büyüklenir: \ell_w(\boldsymbol\beta)=\sum_{i\in s}w_i\ell_i(\boldsymbol\beta). Buna sözde en çok olabilirlik (pseudo-ML) denir (Roberts, Rao ve Kumar 1987; Binder 1983). Kestirim tutarlıdır; ama \ell_w gerçek bir olabilirlik olmadığı için olabilirlik oranı testleri ve bilgi matrisi SH'si geçersizdir. SH sandviçle, testler Wald ile yapılır.
Ne zaman kullanılır? Sonuç iki kategorili, veri ağırlıklı/tabakalı/kümeli bir örneklemden; amaç evren OR'leri ya da evren olasılık modelidir.
Ne zaman kullanılmaz?
- Basit rastgele örneklem ya da deney verisi: İkili Lojistik Regresyon (Bölüm 46); profil olabilirlik GA'sı, LR testleri ve Firth düzeltmesi oradadır.
- Üç ya da daha çok sıralı kategori: Karmaşık Örneklem Sıralı Lojistik Regresyon (Bölüm 98); sırasız kategoriler: Karmaşık Örneklem Çok Terimli Lojistik Regresyon (Bölüm 99).
- Sürekli sonuç: Ağırlıklı Doğrusal Regresyon (Bölüm 96).
- Olay zamanı: Karmaşık Örneklem Cox Regresyonu (Bölüm 133).
Sık karıştırılan analizler. Bölüm 46'daki "Küme değişkeni" küme-sağlam SH verir ama tabakayı ve örnekleme ağırlığını hesaba katmaz; "Frekans ağırlığı" ise satırları çoğaltır, n'yi şişirir. Bu modül ikisinin yerine geçer. Ağırlıklı oran (Bölüm 94) bu modelin yalnız sabit terimli özel hâlidir: sabitin ters logiti ağırlıklı orandır.
97.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| İkili sonuç | Bağımlı değişkende tam iki farklı değer. | Değilse hata (survey_design.py:1821–1824). |
| Tasarım bilgisi doğru | Ağırlık, tabaka, PSU, FPC. | Negatif ağırlık hata; tek PSU'lu tabakada uyarı. |
| Logitte doğrusallık | Sürekli x ile logit arasında doğrusal ilişki. | Denetlenmez (Box–Tidwell yalnız Bölüm 46'da). |
| Ayrışma yok | Bir açıklayıcı birleşimi olayları kusursuz ayırmamalı. | Konis doğrusal programı, yalnız w>0 satırlarda (:1858–1874). |
| Yeterli PSU | Taylor yaklaşımı ve t(\nu+1-k) geçerliliği. | Denetlenmez; sd çıktıda yazılır. |
Eksik değer. "Eksik değerli gözlemler" seçeneği iki kural sunar. Tasarımdan çıkar (bu panelde varsayılan): analiz değişkeni eksik satır tasarımdan da düşer. Tasarımda tut (sıfır katkı): satır \mathbf z_i=\mathbf 0 ile tasarımda kalır; PSU sayısı ve tabaka yapısı tam tasarımdan hesaplanır (R svyglm'in design[-na, ] davranışı). Nokta kestirimleri iki kuralda aynıdır; yalnız SH değişebilir (survey_design.py:1689–1697, 1892–1900). Ağırlık, tabaka, küme ya da FPC sütunu eksik satırlar her iki kuralda da çıkar.
Uç durumlar. Tek değerli açıklayıcı düşürülür ve uyarılır; ayrışmada uyarı yazılır ama kestirim yine basılır (97.5.6); katsayı sd'si \le0 ise p ve GA "—".
97.3 Parametreler
Bölüm 96.3'teki tasarım satırları (Ağırlık, Tabaka, Küme / PSU, FPC, tabaka sabit etkisi, Güven Düzeyi, Referans düzeyleri, Etkileşim terimleri, Alt-popülasyon, Tek PSU'lu tabaka, Varyans yöntemi) bu panelde de aynı anlam ve varsayılanla vardır. Lojistiğe özgü satırlar (survey_logistic.py:51–174, _survey_glm_extras_ui.py:18–52):
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken (ikili) | ilk sütun | İki değerli sonuç. | — |
| Olay (Y = 1) düzeyi | (otomatik) | Hangi düzeyin olay sayılacağı; Y seçilince düzeylerle dolar. | Otomatik: ikili sonuçlardaki ortak olay kuralı: 0/1 ya da 1/2 sayısal kodda büyük değer; iki düzeyden yalnız biri tanınan olumlu etiketse (evet, yes, var, present, pozitif, event, case, died …) o düzey; aksi hâlde MerQur düzey sırasındaki ikinci düzey ve "olay kategorisi seçilmedi" uyarısı. Değiştirmek tüm katsayıların işaretini çevirir. |
| Ek çıktılar: Sınıflama tablosu | kapalı | Gözlenen × öngörülen; ağırlıksız sayı ve ağırlıklı toplam. | Ek bölüm. |
| Ek çıktılar: Archer-Lemeshow uyum iyiliği testi | kapalı | Tasarım tabanlı uyum testi. | Ek bölüm. |
| Ek çıktılar: Tahmin ve artıkları veri setine kaydet | kapalı | SVY_PRED_P, SVY_RESID. |
Veri setine sütun. |
| Sınıflama kesim değeri | 0,50 | \hat\pi\ge c ise olay. | Yalnız sınıflama tablosu. |
| Eksik değerli gözlemler | Tasarımdan çıkar | 97.2. | Yalnız SH (eksik varsa). |
Cox–Snell ve Nagelkerke R^2 her zaman küçük bir satır olarak yazılır; kutusu yoktur (_survey_glm_extras_ui.py:143–144).
Olay düzeyi kuralı (koddan)
Olay düzeyi bütün ikili sonuç analizlerinin ortak işleviyle seçilir (core/binary_event.py): 0/1 ya da 1/2 sayısal kodda büyük değer; iki düzeyden yalnız biri tanınan olumlu etiketse (evet, yes, var, present, pozitif, event, case, died …) o düzey; aksi hâlde MerQur düzey sırasındaki ikinci düzey ve "olay kategorisi seçilmedi" uyarısı. 0/1'de olay 1; "Evet/Hayır"da olay Evet'tir. Alfabetik sıra kullanılmaz; Bölüm 46 aynı kuralı kullanır. Sonuç metni olay ve referans düzeyini ve seçim gerekçesini yazar: Olay kategorisi: diabetes = 1; referans: 0 (0/1 ya da 1/2 kodda büyük değer).
97.4 Tıp örneği
Dosya: english/datasets/Tip/82_survey_logistic_diabetes.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/82_survey_logistic_diabet.xlsx). Değişkenler VIDEO_SCRIPT_TR.txt #82'den alınmıştır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
diabetes |
Bağımlı | 0/1 | 118 olay (%36,9); ağırlıklı 114,05 / 311,25 = %36,6 |
age |
Açıklayıcı | sürekli (yıl) | ort. 56,71; SS 13,99; 30–79 |
BMI |
Açıklayıcı | sürekli (kg/m²) | ort. 28,12; SS 4,22; 18,00–40,02 |
weight |
Ağırlık | sayısal | tabakada sabit: rural 0,85; urban 1,10 |
region |
Tabaka | metin | rural 163 (63 olay), urban 157 (55 olay) |
n ve eksik değer: 320 kişi, eksik değer yok; küme yok, her kişi bir PSU. \sum w_i=311{,}25; \nu=320-2=318.
Klinik soru: Bölgeye göre tabakalanmış bu örneklemin temsil ettiği evrende yaş ve BMI diyabet odds'uyla nasıl ilişkilidir?
Seçilen ayarlar: Arayüz varsayılanları; "Sınıflama tablosu" ve "Archer-Lemeshow" kutuları açık. Karşılaştırma: olay düzeyi 0, tabaka sabit etki ve ağırlıksız çalıştırma.
97.5 Formüller ve hesap adımları
Hesap sırası doğrusal modelle (Bölüm 96.5) aynı motordadır: satır temizliği → tasarım matrisi → statsmodels GLM (Binomial, freq_weights = w) ile katsayılar → ayrışma denetimi → Taylor sandviç → t(\nu+1-k) testleri → Wald F ve ayarlı F → sözde R^2 → isteğe bağlı sınıflama ve Archer–Lemeshow. Burada yalnız lojistiğe özgü adımlar yazılmıştır.
97.5.1 Ağırlıklı sözde olabilirlik ve IRLS
- \mathbf W=\operatorname{diag}(w_i): örnekleme ağırlıkları; \mathbf V=\operatorname{diag}\{\pi_i(1-\pi_i)\}: Bernoulli varyansları.
- \mathbf U_w: ağırlıklı skor; kestirimde sıfırdır.
- IRLS adımı Bölüm 46.5.2'deki adımın ağırlıklı biçimidir: her adım, çalışma yanıtı \mathbf z'nin w_i\pi_i(1-\pi_i) ağırlıklı EKK regresyonudur.
Koddaki tercih: statsmodels GLM, başlangıç \mu=(y+0{,}5)/2
sm.GLM(y, X, family=Binomial(), freq_weights=w).fit() (survey_design.py:1855–1856). statsmodels 0.14.6 GLM varsayılanları: IRLS, başlangıç \hat\mu_i=(y_i+0{,}5)/2 (R glm ile aynı), sapmanın değişimiyle durma (10^{-8}), en çok 100 yineleme. Bölüm 46'daki sm.Logit (Newton, başlangıç β = 0) burada kullanılmaz. Kestirim ağırlık ölçeğinden bağımsızdır; R svyglm ağırlıkları ortalama 1'e ölçekler ve aynı katsayıyı bulur.
97.5.2 Taylor sandviç
Bölüm 96.5.2'deki formül v_i=\hat\pi_i(1-\hat\pi_i) ile kullanılır:
- \mathbf A: ağırlıklı Fisher bilgisi (logit kanonik bağlantı olduğundan gözlenen ve beklenen bilgi aynıdır).
- \mathbf z_i: skor katkısı; \mathbf G bunların tabakalı PSU toplamlarından (Bölüm 93.5.3, 96.5.2).
- \hat\pi_i, kestirilen \hat{\boldsymbol\beta}'dan
1/(1+exp(−Xβ))ile yeniden hesaplanır (:1881–1883).
Neden bilgi matrisinin tersi (\mathbf A^{-1}) tek başına yetmez?
\mathbf A^{-1}, gözlemler bağımsız ve w_i gerçek tekrar sayısı olsaydı geçerli olurdu. Örnekleme ağırlığı tekrar sayısı değildir; kümedeki gözlemler ilişkili olabilir; tabakalama varyansı azaltır. Bu üç etki yalnız \mathbf G'de görünür. Tıp örneğinde ağırlıklar tabakada sabit ve küme yoktur; \mathbf G\approx\mathbf A çıkar ve iki SH yakındır (sabit 1,2264 ve 1,2449). Küme örnekleminde Taylor SH'si çoğu zaman belirgin biçimde büyüktür.
97.5.3 Testler, OR ve GA
- Bölüm 46'dan farkla dağılım z değil t(\nu+1-k)'dır (R
summary.svyglm); GA log-odds ölçeğinde kurulup üstel alınır. - Wald F ve Fellegi ayarlı F Bölüm 96.5.4'teki gibidir; APA satırı ayarlı F'yi yazar.
- Olabilirlik oranı testi ve profil olabilirlik GA'sı yoktur: \ell_w gerçek olabilirlik olmadığından LR istatistiği \chi^2 dağılmaz (Rao–Scott düzeltmesi gerekir; Lumley ve Scott 2017).
97.5.4 Sözde R^2
- \ell_{w,0}=\sum_iw_i[y_i\ln\bar y_w+(1-y_i)\ln(1-\bar y_w)]: yalnız sabitli modelin ağırlıklı log-olabilirliği; \bar y_w ağırlıklı olay oranı.
- N_w=\sum_iw_i: Cox–Snell ve Nagelkerke'de n yerine (R
survey::psrsqtanımı;survey_extras.py:274–284). - McFadden, ölçek bağımsızdır; Cox–Snell ve Nagelkerke N_w ile ağırlık ölçeğine bağlıdır. Ağırlıklar örneklem büyüklüğüne değil evren büyüklüğüne ölçeklenmişse (ör. toplam 80 milyon) Cox–Snell sıfıra, Nagelkerke McFadden'a yaklaşır.
97.5.5 Sınıflama tablosu ve Archer–Lemeshow testi
Sınıflama. \hat\pi_i\ge c ise olay tahmini. Tablo hücreleri ağırlıksız sayı ve parantezde ağırlık toplamıdır; doğruluk, duyarlılık ve özgüllük ağırlıksız ve ağırlıklı ölçekte ayrı ayrı verilir; tablonun altındaki not hücrelerin iki ölçeğini açıklar (survey_extras.py).
Archer–Lemeshow (2006) testi, Hosmer–Lemeshow'un tasarım tabanlı karşılığıdır:
- c_0,\dots,c_g: \hat\pi'nin ağırlıklı yüzdelikleri (0, 1/g, …, 1; ağırlıklı ampirik dağılımın tersi, R
svyquantile(qrule = "math")); ilk aralık alt sınırı da içerir; g=10. - \bar r_k: k. gruptaki ağırlıklı ortalama artık; iyi uyumda her grupta sıfıra yakındır.
- \widehat{\mathbf V}(\bar{\mathbf r}): \bar r_k'ların Taylor kovaryansı; gruptaki gözlemin doğrusallaştırılmış katkısı w_i(r_i-\bar r_k)/\sum_{G_k}w (
survey_extras.py:320–361). - \nu-g+1: R
svyglm(r ~ 0 + g)modelinin artık sd'si (\nu+1-k, k=g). Ayarlı F de verilir.
Koddaki tercih: sınırlar ağırlıklı yüzdeliklerden, eşit \hat\pi aynı grupta
Grup sınırları ağırlıklı yüzdeliklerdir ve pd.cut(include_lowest=True) ile sağdan kapalı aralıklar kurulur (R svylogitgof kuralı). Yinelenen sınırlar birleşir, g azalabilir. Varyans yöntemi replikasyon seçilmiş olsa bile Archer–Lemeshow Taylor ile hesaplanır ve bu not çıktıya yazılır (_survey_glm_extras_ui.py:185–186).
97.5.6 Ayrışma
İkili modelde MerQur, Bölüm 46.5.9'daki Konis doğrusal programını yalnız pozitif ağırlıklı satırlarda çözer (survey_design.py:1858–1874). Ayrışma varsa uyarı ayrışmayı taşıyan değişkenleri adlandırır. Sözde-ML kestirimi sonlu değildir; basılan katsayı yakınsama ölçütünün durduğu yerdir. Sandviç SH ayrışan yönde sınırlı kaldığı için t ve p yapay olarak aşırı anlamlı çıkar; uyarı bunu açıkça yazar. Firth düzeltmesi bu modülde yoktur.
97.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/survey_logistic/elle_hesap.py ile, MerQur çağrılmadan numpy ile hesaplanmıştır (IRLS başlangıcı β = 0; statsmodels'in başlangıcı farklıdır ama yakınsama noktası aynıdır).
Adım 1 — IRLS yinelemeleri (-2\ell_w ham ağırlık ölçeğinde):
| Yineleme | b_0 | b_{\text{age}} | b_{\text{BMI}} | -2\ell_w |
|---|---|---|---|---|
| 1 | −6,448744 | 0,038743 | 0,132219 | 359,409076 |
| 2 | −8,000780 | 0,048725 | 0,163383 | 356,989144 |
| 3 | −8,162115 | 0,049791 | 0,166572 | 356,968436 |
| 4 | −8,163725 | 0,049802 | 0,166603 | 356,968434 |
| 5 | −8,163725 | 0,049802 | 0,166603 | 356,968434 |
Adım 2 — Skor katkısı. 1 numaralı kişi: age 39, BMI 23,96, urban, w=1{,}1, diabetes 0.
Adım 3 — Ekmek ve et.
\mathbf G ile \mathbf A'nın yakınlığı, bu tasarımda (küme yok, ağırlık tabakada sabit) model tabanlı ve tasarım tabanlı varyansın yakın olacağını gösterir.
Adım 4 — Katsayı tablosu. \nu=318, \sd_t=318+1-3=316, t_{0{,}975;\,316}=1{,}967500.
| Terim | b | SH (Taylor) | SH (\mathbf A^{-1}) | t | p | OR | %95 GA (OR) |
|---|---|---|---|---|---|---|---|
| Sabit | −8,163725 | 1,244924 | 1,226416 | −6,558 | 2,23·10⁻¹⁰ | 0,000285 | [0,000025; 0,003298] |
| age | 0,049802 | 0,010212 | 0,010019 | 4,877 | 1,71·10⁻⁶ | 1,051063 | [1,030155; 1,072395] |
| BMI | 0,166603 | 0,033747 | 0,032988 | 4,937 | 1,29·10⁻⁶ | 1,181285 | [1,105399; 1,262381] |
Örnek, BMI: t=0{,}166603/0{,}033747=4{,}9369; GA e^{0{,}166603\pm1{,}9675\times0{,}033747}=[1{,}1054;\ 1{,}2624].
Adım 5 — Wald testleri. Model geneli: W=39{,}5669, F=19{,}7834 (F(2,\,316), p=8{,}04\cdot10^{-9}); ayarlı F=\frac{318-1}{636}\times39{,}5669=19{,}7212 (F(2,\,317), p=8{,}46\cdot10^{-9}).
Adım 6 — Sözde R^2. \ell_w=-178{,}484217, \ell_{w,0}=-204{,}499324, N_w=311{,}25.
\text{AIC}=356{,}9684+2\times3=362{,}9684.
Adım 7 — Sınıflama (kesim 0,5).
| Gözlenen \ Tahmin | 0 | 1 |
|---|---|---|
| 0 | 177 (172,95) | 25 (24,25) |
| 1 | 64 (62,40) | 54 (51,65) |
Doğruluk ağırlıksız 231/320 = %72,19; ağırlıklı (172,95 + 51,65)/311,25 = %72,16. Duyarlılık (ağırlıklı) 51,65/114,05 = %45,29; özgüllük 172,95/197,20 = %87,70. Ağırlıksız duyarlılık 54/118 = %45,76, özgüllük 177/202 = %87,62.
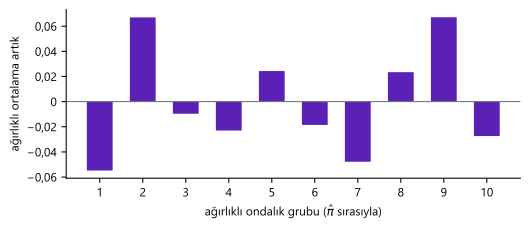
Adım 8 — Archer–Lemeshow (10 grup).
| Grup | \hat\pi aralığı | n | \sum w | \bar r_k |
|---|---|---|---|---|
| 1 | 0,041–0,132 | 32 | 31,45 | −0,0548 |
| 2 | 0,132–0,187 | 31 | 30,85 | 0,0670 |
| 3 | 0,187–0,238 | 33 | 31,55 | −0,0096 |
| 4 | 0,238–0,292 | 32 | 30,70 | −0,0230 |
| 5 | 0,292–0,348 | 33 | 32,05 | 0,0243 |
| 6 | 0,348–0,397 | 31 | 30,60 | −0,0185 |
| 7 | 0,397–0,447 | 32 | 31,45 | −0,0478 |
| 8 | 0,447–0,543 | 32 | 30,70 | 0,0234 |
| 9 | 0,543–0,663 | 33 | 31,05 | 0,0671 |
| 10 | 0,663–0,896 | 31 | 30,85 | −0,0274 |
W_{\text{AL}}=4{,}6648, F=0{,}4665 (F(10,\,309), p=0{,}911); ayarlı F=0{,}4533 (p=0{,}919). Gruplarda ortalama artıklar sıfır çevresinde dağılır; uyumsuzluk kanıtı yoktur.
Şekil 97.1. Archer–Lemeshow gruplarında ağırlıklı ortalama artık (Tıp #82).
Adım 9 — Seçeneklerin etkisi. Olay düzeyi 0 seçilince tüm katsayıların işareti döner, SH'ler aynı kalır (age OR 1/1,0511 = 0,9514). Tabaka sabit etkisinde urban kuklası -0{,}1656 (SH 0,2536); age 0,04979, BMI 0,16678. Ağırlıksız çalıştırmada b_{\text{BMI}}=0{,}17106 (SH 0,03378).
97.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan (rows, wald_model, wald_terms, log_likelihood, svy2) tam hassasiyetle alınmıştır. R: 4.5.3, survey 4.5; svyglm(family = quasibinomial()) (epsilon = 1e-14), regTermTest(method = "Wald"), psrsq(); Archer–Lemeshow R'de svyquantile(qrule = "math"), cut(include.lowest = TRUE), svyglm(r ~ 0 + g) ve regTermTest ile; ayarlı F ve log-olabilirlik R'de tanımdan hesaplanmıştır. AIC ve ağırlıksız doğruluğun R karşılığı ayrıca hesaplanmamıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b Sabit | −8,163725 | −8,163725 | −8,163725 | 3,0e−13 | ✓ |
| SH Sabit | 1,244924 | 1,244924 | 1,244924 | 1,8e−08 | ✓ |
| t Sabit | −6,557610 | −6,557610 | −6,557610 | 9,7e−08 | ✓ |
| p Sabit | 2,2297·10−10 | 2,2297·10−10 | 2,2297·10−10 | 1,3e−16 | ✓ |
| b age | 0,049802 | 0,049802 | 0,049802 | 2,0e−15 | ✓ |
| SH age | 0,010212 | 0,010212 | 0,010212 | 1,8e−11 | ✓ |
| t age | 4,876768 | 4,876768 | 4,876768 | 8,5e−09 | ✓ |
| p age | 1,7115·10−6 | 1,7115·10−6 | 1,7115·10−6 | 6,9e−14 | ✓ |
| OR age | 1,051063 | 1,051063 | 1,051063 | 3,3e−15 | ✓ |
| OR GA alt age | 1,030155 | 1,030155 | 1,030155 | 3,6e−11 | ✓ |
| OR GA üst age | 1,072395 | 1,072395 | 1,072395 | 3,8e−11 | ✓ |
| b BMI | 0,166603 | 0,166603 | 0,166603 | 6,1e−15 | ✓ |
| SH BMI | 0,033747 | 0,033747 | 0,033747 | 2,1e−10 | ✓ |
| t BMI | 4,936879 | 4,936879 | 4,936879 | 3,1e−08 | ✓ |
| p BMI | 1,2876·10−6 | 1,2876·10−6 | 1,2876·10−6 | 1,9e−13 | ✓ |
| OR BMI | 1,181285 | 1,181285 | 1,181285 | 7,3e−15 | ✓ |
| OR GA alt BMI | 1,105399 | 1,105399 | 1,105399 | 4,7e−10 | ✓ |
| OR GA üst BMI | 1,262381 | 1,262381 | 1,262381 | 5,3e−10 | ✓ |
| Model Wald F | 19,783441 | 19,783441 | 19,783442 | 5,0e−07 | ✓ |
| Model Wald p | 8,0351·10−9 | 8,0351·10−9 | 8,0351·10−9 | 3,6e−15 | ✓ |
| Model ayarlı F | 19,721229 | 19,721229 | 19,721230 | 5,0e−07 | ✓ |
| Model ayarlı F p | 8,4639·10−9 | 8,4639·10−9 | 8,4639·10−9 | 3,8e−15 | ✓ |
| \ell (ham ağırlık) | −178,484217 | −178,484217 | −178,484217 | 2,8e−14 | ✓ |
| McFadden R^2 | 0,127214 | 0,127214 | 0,127214 | 2,8e−16 | ✓ |
| Terim F age | 23,782863 | 23,782863 | 23,782863 | 8,3e−08 | ✓ |
| Terim F BMI | 24,372773 | 24,372773 | 24,372774 | 3,1e−07 | ✓ |
| Cox–Snell R^2 | 0,153940 | 0,153940 | 0,153940 | 3,6e−16 | ✓ |
| Nagelkerke R^2 | 0,210511 | 0,210511 | 0,210511 | 8,3e−17 | ✓ |
| AIC (k = 3) | 362,968434 | 362,968434 | — | 0,0e+00 | ✓ |
| Ağırlıklı DN (0→0) | 172,950000 | 172,950000 | 172,950000 | 2,8e−14 | ✓ |
| Ağırlıklı DP (1→1) | 51,650000 | 51,650000 | 51,650000 | 7,1e−15 | ✓ |
| Doğruluk (ağırlıksız) | 0,721875 | 0,721875 | — | 0,0e+00 | ✓ |
| Duyarlılık (ağırlıklı) | 0,452872 | 0,452872 | 0,452872 | 5,6e−17 | ✓ |
| Özgüllük (ağırlıklı) | 0,877028 | 0,877028 | 0,877028 | 0,0e+00 | ✓ |
| Archer–Lemeshow F | 0,466476 | 0,466476 | 0,466476 | 5,6e−14 | ✓ |
| Archer–Lemeshow p | 0,910928 | 0,910928 | 0,910928 | 3,4e−14 | ✓ |
| Archer–Lemeshow ayarlı F | 0,453274 | 0,453274 | 0,453274 | 5,5e−14 | ✓ |
| Archer–Lemeshow ayarlı p | 0,918696 | 0,918696 | 0,918696 | 3,1e−14 | ✓ |
Ek çalıştırmalar:
Olay düzeyi 0
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b Sabit | 8,163725 | 8,163725 | 8,163725 | 2,3e−13 | ✓ |
| SH Sabit | 1,244924 | 1,244924 | 1,244924 | 1,8e−08 | ✓ |
| t Sabit | 6,557610 | 6,557610 | 6,557610 | 9,7e−08 | ✓ |
| p Sabit | 2,2297·10−10 | 2,2297·10−10 | 2,2297·10−10 | 1,3e−16 | ✓ |
| b age | −0,049802 | −0,049802 | −0,049802 | 1,4e−15 | ✓ |
| SH age | 0,010212 | 0,010212 | 0,010212 | 1,8e−11 | ✓ |
| t age | −4,876768 | −4,876768 | −4,876768 | 8,5e−09 | ✓ |
| p age | 1,7115·10−6 | 1,7115·10−6 | 1,7115·10−6 | 6,9e−14 | ✓ |
| OR age | 0,951418 | 0,951418 | 0,951418 | 1,6e−15 | ✓ |
| OR GA alt age | 0,932492 | 0,932492 | 0,932492 | 3,3e−11 | ✓ |
| OR GA üst age | 0,970727 | 0,970727 | 0,970727 | 3,4e−11 | ✓ |
| b BMI | −0,166603 | −0,166603 | −0,166603 | 9,5e−15 | ✓ |
| SH BMI | 0,033747 | 0,033747 | 0,033747 | 2,1e−10 | ✓ |
| t BMI | −4,936879 | −4,936879 | −4,936879 | 3,1e−08 | ✓ |
| p BMI | 1,2876·10−6 | 1,2876·10−6 | 1,2876·10−6 | 1,9e−13 | ✓ |
| OR BMI | 0,846536 | 0,846536 | 0,846536 | 8,0e−15 | ✓ |
| OR GA alt BMI | 0,792154 | 0,792154 | 0,792154 | 3,3e−10 | ✓ |
| OR GA üst BMI | 0,904651 | 0,904651 | 0,904651 | 3,8e−10 | ✓ |
| Model Wald F | 19,783441 | 19,783441 | 19,783442 | 5,0e−07 | ✓ |
| Model Wald p | 8,0351·10−9 | 8,0351·10−9 | 8,0351·10−9 | 3,6e−15 | ✓ |
| Model ayarlı F | 19,721229 | 19,721229 | 19,721230 | 5,0e−07 | ✓ |
| Model ayarlı F p | 8,4639·10−9 | 8,4639·10−9 | 8,4639·10−9 | 3,8e−15 | ✓ |
| \ell (ham ağırlık) | −178,484217 | −178,484217 | −178,484217 | 2,8e−14 | ✓ |
| McFadden R^2 | 0,127214 | 0,127214 | 0,127214 | 1,7e−16 | ✓ |
Tabaka sabit etki
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b Sabit | −8,078143 | −8,078143 | −8,078143 | 7,4e−13 | ✓ |
| SH Sabit | 1,245539 | 1,245539 | 1,245539 | 2,2e−08 | ✓ |
| t Sabit | −6,485662 | −6,485662 | −6,485663 | 1,2e−07 | ✓ |
| p Sabit | 3,4165·10−10 | 3,4165·10−10 | 3,4165·10−10 | 2,3e−16 | ✓ |
| b age | 0,049794 | 0,049794 | 0,049794 | 6,1e−15 | ✓ |
| SH age | 0,010245 | 0,010245 | 0,010245 | 2,5e−11 | ✓ |
| t age | 4,860258 | 4,860258 | 4,860258 | 1,2e−08 | ✓ |
| p age | 1,8523·10−6 | 1,8523·10−6 | 1,8523·10−6 | 1,0e−13 | ✓ |
| OR age | 1,051055 | 1,051055 | 1,051055 | 6,4e−15 | ✓ |
| OR GA alt age | 1,030080 | 1,030080 | 1,030080 | 5,0e−11 | ✓ |
| OR GA üst age | 1,072457 | 1,072457 | 1,072457 | 5,3e−11 | ✓ |
| b BMI | 0,166783 | 0,166783 | 0,166783 | 1,3e−14 | ✓ |
| SH BMI | 0,033761 | 0,033761 | 0,033761 | 2,2e−10 | ✓ |
| t BMI | 4,940164 | 4,940164 | 4,940164 | 3,3e−08 | ✓ |
| p BMI | 1,2695·10−6 | 1,2695·10−6 | 1,2695·10−6 | 2,0e−13 | ✓ |
| OR BMI | 1,181498 | 1,181498 | 1,181498 | 1,5e−14 | ✓ |
| OR GA alt BMI | 1,105567 | 1,105567 | 1,105567 | 4,8e−10 | ✓ |
| OR GA üst BMI | 1,262645 | 1,262645 | 1,262645 | 5,5e−10 | ✓ |
| b urban | −0,165630 | −0,165630 | −0,165630 | 9,9e−15 | ✓ |
| SH urban | 0,253618 | 0,253618 | 0,253618 | 6,2e−10 | ✓ |
| t urban | −0,653071 | −0,653071 | −0,653071 | 1,6e−09 | ✓ |
| p urban | 0,514187 | 0,514187 | 0,514187 | 1,0e−09 | ✓ |
| OR urban | 0,847359 | 0,847359 | 0,847359 | 9,2e−15 | ✓ |
| OR GA alt urban | 0,514464 | 0,514464 | 0,514464 | 6,3e−10 | ✓ |
| OR GA üst urban | 1,395662 | 1,395662 | 1,395662 | 1,7e−09 | ✓ |
| Model Wald F | 13,261684 | 13,261684 | 13,261685 | 3,5e−07 | ✓ |
| Model Wald p | 3,5633·10−8 | 3,5633·10−8 | 3,5633·10−8 | 1,6e−14 | ✓ |
| Model ayarlı F | 13,178278 | 13,178278 | 13,178278 | 3,5e−07 | ✓ |
| Model ayarlı F p | 3,9589·10−8 | 3,9589·10−8 | 3,9589·10−8 | 1,8e−14 | ✓ |
| \ell (ham ağırlık) | −178,277468 | −178,277468 | −178,277468 | 5,1e−13 | ✓ |
| McFadden R^2 | 0,128225 | 0,128225 | 0,128225 | 3,3e−16 | ✓ |
| Terim F region | 0,426501 | 0,426501 | 0,426501 | 2,1e−09 | ✓ |
Ağırlıksız
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b Sabit | −8,280508 | −8,280508 | −8,280508 | 1,1e−12 | ✓ |
| SH Sabit | 1,241147 | 1,241147 | 1,241147 | 8,8e−13 | ✓ |
| t Sabit | −6,671656 | −6,671656 | −6,671656 | 3,9e−12 | ✓ |
| p Sabit | 1,1329·10−10 | 1,1329·10−10 | 1,1329·10−10 | 2,6e−21 | ✓ |
| b age | 0,049799 | 0,049799 | 0,049799 | 6,8e−15 | ✓ |
| SH age | 0,010058 | 0,010058 | 0,010058 | 3,3e−15 | ✓ |
| t age | 4,951163 | 4,951163 | 4,951163 | 1,0e−12 | ✓ |
| p age | 1,2029·10−6 | 1,2029·10−6 | 1,2029·10−6 | 6,0e−18 | ✓ |
| OR age | 1,051060 | 1,051060 | 1,051060 | 7,1e−15 | ✓ |
| OR GA alt age | 1,030465 | 1,030465 | 1,030465 | 6,4e−15 | ✓ |
| OR GA üst age | 1,072067 | 1,072067 | 1,072067 | 1,4e−14 | ✓ |
| b BMI | 0,171062 | 0,171062 | 0,171062 | 2,2e−14 | ✓ |
| SH BMI | 0,033776 | 0,033776 | 0,033776 | 1,9e−14 | ✓ |
| t BMI | 5,064629 | 5,064629 | 5,064629 | 2,2e−12 | ✓ |
| p BMI | 6,9686·10−7 | 6,9686·10−7 | 6,9686·10−7 | 7,4e−18 | ✓ |
| OR BMI | 1,186564 | 1,186564 | 1,186564 | 2,7e−14 | ✓ |
| OR GA alt BMI | 1,110275 | 1,110275 | 1,110275 | 3,3e−14 | ✓ |
| OR GA üst BMI | 1,268095 | 1,268095 | 1,268095 | 7,6e−14 | ✓ |
| Model Wald F | 20,533598 | 20,533598 | 20,533598 | 2,3e−11 | ✓ |
| Model Wald p | 4,1311·10−9 | 4,1311·10−9 | 4,1311·10−9 | 8,4e−20 | ✓ |
| Model ayarlı F | 20,469027 | 20,469027 | 20,469027 | 2,3e−11 | ✓ |
| Model ayarlı F p | 4,3586·10−9 | 4,3586·10−9 | 4,3586·10−9 | 8,9e−20 | ✓ |
| \ell (ham ağırlık) | −183,430215 | −183,430215 | −183,430215 | 4,5e−13 | ✓ |
| McFadden R^2 | 0,129226 | 0,129226 | 0,129226 | 3,1e−16 | ✓ |
118 değerin tamamı 10^{-6} ölçütüyle eşleşir.
97.7 Çıktıyı okuma
Sonuç metni (Sınıflama ve Archer-Lemeshow açık; kısaltılmış, sütun aralıkları daraltılmış):
Karmaşık Anket — Ağırlıklı Lojistik Regresyon
  N (gözlem)     = 320
  PSU sayısı     = 320
  Tabaka sayısı  = 2
  Tasarım df     = 318
  AIC            = 362.9684
  McFadden R²    = 0.1272
  Log-olabilirlik = -178.4842
  Değişken   Katsayı      SE      t       p        OR       OR %95 GA
  Sabit      -8.1637  1.2449  -6.56  0.0000    0.0003  [0.000, 0.003]
  age         0.0498  0.0102   4.88  0.0000    1.0511  [1.030, 1.072]
  BMI         0.1666  0.0337   4.94  0.0000    1.1813  [1.105, 1.262]
  Katsayı t testleri ve GA: t(ν + 1 - k) = t(316); ν = 318 ...
  Olay kategorisi: diabetes = 1; referans: 0 (0/1 ya da 1/2 kodda büyük değer).
Model etkilerinin testleri (ayarlı Wald F, Taylor kovaryansı)
  Terim          df1  Wald χ²        F  df2       p  Ayarlı F  df2       p
  Model geneli     2  39.5669  19.7834  316  0.0000   19.7212  317  0.0000
── APA 7 ÖZET ──
  Model geneli (ayarlı Wald): F(2, 317) = 19.72, p < .001
Sözde R²: Cox-Snell = 0.1539, Nagelkerke = 0.2105, McFadden = 0.1272  (N = Σw)
── Sınıflama Tablosu (kesim = 0.50; ağırlıksız n (ağırlıklı)) ──
                 Öngörülen 0     Öngörülen 1
Gözlenen 0       177 (172.9)      25 ( 24.2)
Gözlenen 1        64 ( 62.4)      54 ( 51.7)
  Doğru sınıflama: ağırlıksız %72.2, ağırlıklı %72.2;
  duyarlılık: ağırlıksız %45.8, ağırlıklı %45.3;
  özgüllük: ağırlıksız %87.6, ağırlıklı %87.7
  Hücreler: ağırlıksız gözlem sayısı (parantez içinde ağırlık toplamı).
  Ağırlıklı oranlar evreni, ağırlıksız oranlar örneklemi tanımlar.
── Archer-Lemeshow Uyum İyiliği Testi ──
  10 grup: F(10, 309) = 0.4665, p = 0.911;
  ayarlı F(10, 309) = 0.4533, p = 0.919
| Öğe | Nasıl yorumlanır |
|---|---|
| Olay düzeyi satırı | Katsayıların hangi düzeyin log-odds'unu modellediği; önce buna bakın. |
| Katsayı, SE, t, p | Log-odds ölçeğinde; Taylor SH, t(\nu+1-k). |
| OR ve GA | BMI 1,181: diğerleri sabitken BMI'daki 1 kg/m² artış evrende diyabet odds'unu %18 artırır; 5 kg/m² için e^{5\times0{,}1666}=2{,}30 (%95 GA [1,65; 3,21]). age 10 yıl için 1,646. |
| Ayarlı F | Model geneli testi; Bölüm 46'daki LR χ²'nin yerini alır. |
| McFadden / Cox–Snell / Nagelkerke | 46'daki tanımların ağırlıklı karşılıkları; ölçek notu 97.5.4. |
| Sınıflama | Oranlar iki ölçekte yazılır: ağırlıksız (tablodaki sayılardan; duyarlılık 54/118 = %45,8) ve ağırlıklı. Raporda hangisinin kullanıldığı belirtilmelidir. |
| Archer–Lemeshow | p>\alpha: kalibrasyon bozukluğu kanıtı yok; gücü düşüktür. |
| "Tam/yarı-tam ayrışma" uyarısı | O değişkenin katsayı, SH, t, p, OR değerleri yorumlanmaz. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Bölgeye göre tabakalanmış ve ağırlıklandırılmış örneklemde (n = 320; 118 diyabet; tasarım sd = 318) diyabet varlığı, yaş ve BMI ile tasarım tabanlı ağırlıklı lojistik regresyonla modellendi; standart hatalar Taylor doğrusallaştırmasıyla hesaplandı. Model anlamlıydı, ayarlı Wald F(2,\ 317) = 19{,}72, p < 0{,}001, McFadden R^2 = 0{,}13, Nagelkerke R^2 = 0{,}21. Diğer değişken sabitken yaş (OR = 1,05; %95 GA [1,03; 1,07]; t(316) = 4{,}88; p < 0{,}001) ve BMI (OR = 1,18; %95 GA [1,11; 1,26]; t(316) = 4{,}94; p < 0{,}001) diyabet odds'unu anlamlı biçimde artırdı. Archer–Lemeshow testi uyumsuzluk göstermedi, F(10,\ 309) = 0{,}47, p = 0{,}91.
97.8 Uzman soruları
S1. Neden LR testi ya da profil GA yok?
Sözde log-olabilirlik \ell_w gerçek olabilirlik değildir; 2(\ell_w-\ell_{w,0}) tasarım etkileri nedeniyle \chi^2_q dağılmaz, ağırlıklı ki-karelerin doğrusal birleşimi olarak dağılır. Rao–Scott düzeltmeli LR testi (R anova.svyglm) mümkündür ama MerQur'da yoktur. Wald testi yalnız \hat{\boldsymbol\beta} ve \widehat{\mathbf V} gerektirir; tasarımla tutarlıdır.
S2. Bölüm 46'daki modelle aynı veride katsayılar neden farklı?
Ağırlıklar eşit değilse sözde-ML kestirimi ağırlıksız ML'den farklıdır; Tıp örneğinde BMI ağırlıklı 0,16660, ağırlıksız 0,17106'dır. Ağırlıklar sonuçla ilişkili bir seçimi düzeltiyorsa fark gerçek bir yanlılık düzeltmesidir. Model doğru belirlenmişse ve seçim yalnız açıklayıcılara bağlıysa iki kestirim aynı parametreyi kestirir; o zaman ağırlıksız kestirim daha verimlidir (DuMouchel ve Duncan 1983).
S3. t ve z farkı: hangisi kullanılmalı?
MerQur R summary.svyglm'i izler: t(\nu+1-k). Bazı yazılımlar katsayı tablosunda Wald χ² (normal yaklaşım), bazıları tasarım sd'sine dayalı t ve ayarlı F verir; sd kuralı yazılıma ve seçeneklere göre değişir. \nu büyükken hepsi aynı karara götürür; birkaç düzine PSU'lu küme örneklemlerinde t belirgin biçimde daha temkinlidir.
S4. Ayrışma nasıl denetleniyor? Sıralı modelle aynı mı?
İkili modelde Konis doğrusal programı kullanılır (Bölüm 46.5.9); ağırlığı pozitif satırlarla sınırlıdır ve açıklayıcıların konumundan bağımsızdır. Sıralı ve çok terimli modellerde de aynı ölçüt kullanılır: Albert–Anderson ayrışması, yığılmış veride Konis doğrusal programıyla denetlenir (Bölüm 98). Böylece üç modelin kararı aynı tanıma dayanır ve eşiklerin büyüklüğünden etkilenmez.
S5. Cox–Snell ve Nagelkerke neden ağırlık ölçeğine bağlı?
İkisi de N_w=\sum w_i ile normalleştirilir (R psrsq). Ağırlıklar evren büyüklüğüne ölçeklenmişse N_w çok büyür; R^2_{\text{CS}}\to0 ve R^2_{\text{N}} McFadden'a yaklaşır. McFadden oranı ölçekten bağımsızdır; raporda tercih edilebilir.
S6. Archer–Lemeshow ile Hosmer–Lemeshow farkı nedir?
Hosmer–Lemeshow gözlenen ve beklenen sayıları Pearson χ² ile karşılaştırır ve bağımsız gözlem varsayar. Archer–Lemeshow, grup ortalama artıklarını tasarım tabanlı kovaryansla Wald testi olarak sınar; gruplama ağırlıklı yüzdeliklerdedir ve sd F(g,\ \nu-g+1)'dir. Ağırlıksız, tabakasız, kümesiz tasarımda bile iki test aynı sayıyı vermez.
S7. Alt evren modeli ile veriyi süzmek arasında fark var mı?
Var; Bölüm 96.8 S4. Lojistikte ayrıca alan dışı satırlar ayrışma denetimine de girmez (yalnız w>0). Alt evren modelinde ayarlı F'nin payda sd'si tam tasarım ν'sünü kullanır (Bölüm 96.5.4 uyarısı).
S8. "Tasarımda tut" eksik değer kuralı nokta kestirimini neden değiştirmez?
Eksik satır \mathbf z_i=\mathbf 0 ile yalnız \mathbf G'ye girer: PSU'su ve tabakası varyans hesabında kalır, tabaka ortalaması ve n_h değişir. Kestirim denklemi aynı satırlarla çözülür. Kümesiz tasarımda eksik satır kendi PSU'sudur; n_h büyür, merkezleme değişir ve SH bir miktar değişir.
97.9 Sık hatalar ve tuzaklar
- Olay düzeyini denetlememek. Metin kodlu hedefte etiket tanınmazsa olay, düzey sırasındaki ikinci düzeydir ve uyarı yazılır. Olay düzeyini açıkça seçin ve çıktıdaki "Olay kategorisi" satırını denetleyin.
- OR'yi risk oranı gibi okumak. Olay oranı %37'dir; OR, RR'den belirgin biçimde büyüktür.
- Bölüm 46'nın frekans ağırlığını örnekleme ağırlığı için kullanmak. n ağırlık toplamına çıkar, SH'ler yanlış küçülür; tabaka ve küme yok sayılır.
- Cox–Snell/Nagelkerke'yi farklı ağırlık ölçekli çalışmalar arasında karşılaştırmak. 97.5.4.
- Sınıflama oranlarının ölçeğini karıştırmak. Çıktı ağırlıksız ve ağırlıklı oranları ayrı verir; evren için ağırlıklı oran raporlanır.
- Ayrışma uyarısını görmezden gelmek. Katsayı sonsuzdur; p yapay olarak küçüktür.
- Eksik değer kuralını rapora yazmamak. Eksik değer varsa iki kural farklı SH verir.
97.10 Kaynaklar
- Archer, K. J., & Lemeshow, S. (2006). Goodness-of-fit test for a logistic regression model fitted using survey sample data. The Stata Journal, 6(1), 97–105. https://doi.org/10.1177/1536867X0600600106
- Binder, D. A. (1983). On the variances of asymptotically normal estimators from complex surveys. International Statistical Review, 51(3), 279–292. https://doi.org/10.2307/1402588
- DuMouchel, W. H., & Duncan, G. J. (1983). Using sample survey weights in multiple regression analyses of stratified samples. Journal of the American Statistical Association, 78(383), 535–543. https://doi.org/10.1080/01621459.1983.10478006
- Fellegi, I. P. (1980). Approximate tests of independence and goodness of fit based on stratified multistage samples. Journal of the American Statistical Association, 75(370), 261–268. https://doi.org/10.1080/01621459.1980.10477462
- Lumley, T. (2004). Analysis of complex survey samples. Journal of Statistical Software, 9(8), 1–19. https://doi.org/10.18637/jss.v009.i08
- Lumley, T. (2010). Complex surveys: A guide to analysis using R. Wiley. https://doi.org/10.1002/9780470580066
- Lumley, T., & Scott, A. (2017). Fitting regression models to survey data. Statistical Science, 32(2), 265–278. https://doi.org/10.1214/16-STS605
- Roberts, G., Rao, J. N. K., & Kumar, S. (1987). Logistic regression analysis of sample survey data. Biometrika, 74(1), 1–12. https://doi.org/10.1093/biomet/74.1.1