108. Kısmi En Küçük Kareler Regresyonu (PLS)
Analiz kimliği: pls · Menü adı: Kısmi En Küçük Kareler Regresyonu (Partial Least Squares, PLS) · Panel: gui/panels/analyses/pls_regression.py · Motor: stats/specialized_regression.py, run_pls_regression (satır 67–186), _pls_cv5 (189–207); stats/specialized_extras.py (açıklanan varyans, CV eğrisi); stats/pls_probit_tobit_extras.py (yükler, jackknife, PLS2)
108.1 Ne işe yarar
PLS regresyonu, sürekli bir yanıtı birbiriyle güçlü ilişkili çok sayıda açıklayıcıyla yordar. Açıklayıcıları doğrudan kullanmak yerine, onların az sayıda doğrusal birleşimini, yani gizil bileşenleri kurar; bileşenler y ile kovaryansı en büyük olacak biçimde seçilir. Regresyon bu bileşenler üzerinden yapılır ve sonunda katsayılar özgün değişkenlere geri çevrilir. Cevapladığı soru şudur: "12 genin ifade düzeyi, birbirleriyle ilişkili olsalar da, hastalık ilerleme skorunu ne kadar iyi yordar ve hangi genler en çok katkı yapar?"
- \mathbf X_s: sütunları ortalamadan arındırılmış ve SS'ye bölünmüş n\times p açıklayıcı matrisi.
- \mathbf T (n\times A): A gizil bileşenin skorları; \mathbf P (p\times A): X yükleri; \mathbf q (A): y yükleri.
- \mathbf R: skorları doğrudan \mathbf X_s'ten üreten ağırlıklar (\mathbf R=\mathbf W(\mathbf P^{\top}\mathbf W)^{-1}).
- \mathbf E, \mathbf f: bileşenlerce açıklanmayan artıklar; b_0, \mathbf b: özgün birimlerde sabit ve katsayılar.
Ne zaman kullanılır? Açıklayıcılar arasında güçlü çoklu doğrusal bağıntı varsa (spektrum dalga boyları, gen ifadeleri, duyusal puanlar); açıklayıcı sayısı gözlem sayısına yakın ya da ondan büyükse; amaç yordama ve değişken önemini (VIP) sıralamaksa.
Ne zaman kullanılmaz?
- Katsayılar için klasik t testi ve GA isteniyorsa ve bağıntı ılımlıysa: Çoklu Doğrusal Regresyon (PLS'nin klasik SH'si yoktur; burada yalnız jackknife).
- Amaç seyrek bir model (değişken seçimi) ise: LASSO; yalnız katsayı kararlılığı isteniyorsa Ridge Regresyon.
- Yanıt kategorikse: PLS-DA bu modülde yoktur; Diskriminant Analizi ya da Lojistik Regresyon.
- Gizil yapı ölçme modeli olarak kurulacaksa: PLS-SEM (Kısmi En Küçük Kareler Yol Modellemesi); o yöntem aynı adı taşır ama başka bir modeldir.
Sık karıştırılan analizler. Temel bileşenler regresyonu (PCR) da bileşen kurar ama bileşenleri yalnız X'in varyansına göre seçer, y'ye bakmaz; PLS her bileşeni y ile kovaryansı en büyük olacak biçimde seçer ve çoğunlukla daha az bileşenle aynı yordamayı sağlar. Ridge regresyon tüm yönleri sürekli büzer; PLS ise bileşen sayısıyla kesikli bir düzenlileştirme yapar.
108.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Sürekli y | Tek sürekli yanıt (PLS1); isteğe bağlı ek y'ler PLS2 bölümüne. | Sabit y hata (specialized_regression.py:95–96). |
| Doğrusal ilişki | y, bileşenlerin doğrusal fonksiyonu. | Tahmin–gözlenen grafiğiyle (isteğe bağlı). |
| Bağımsız gözlemler | Satırlar bağımsız. | Denetlenmez; CV katları ardışık olduğundan sıralı veride önem kazanır. |
| Dağılım varsayımı | Yok; çıkarım yalnız jackknife ile. | — |
| Bileşen sayısı ≤ rank | A\le\min(p,\ n-1,\ \operatorname{rank}\mathbf X_s). | Fazlası sınırlanır ve uyarılır (106–112). |
Eksik değer. y ve seçilen açıklayıcılarda eksik değeri olan satır çıkarılır (liste bazında, _drop_na, 57–61). Metin (object) ya da kategori sütunları kukla değişkenlere açılır (ilk düzey referans, _build_X, 39–54) ve kuklalar da standartlaştırılır.
Uç durumlar (koddan). y sabitse hata; tüm X sütunları sabitse hata (94–97). İstenen bileşen sayısı \min(p,\ n-1,\ \operatorname{rank})'ı aşarsa bu değere indirilir ve uyarı yazılır. En az 2 açıklayıcı gerekir (stats_panel._run_specialized_reg).
108.3 Parametreler
Varsayılanlar add_form_rows (pls_regression.py:45–105) ve read_options (108–123) kodundan alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken | ilk sayısal sütun | Sürekli y. | — |
| Bileşen sayısı | 2 (1–20) | Modeldeki gizil bileşen sayısı A. | Tüm katsayılar, VIP, R^2; asıl ayar budur. |
| Bağımsız değişkenler | en az 2 | Sayısal ya da kategorik. | Kategorikler kukla kodlanır. |
| Bileşen sayısını CV ile seç | kapalı | 0…en çok bileşen için PRESS, RMSECV, Q^2 tablosu. | Ek tablo; en küçük RMSECV işaretlenir ama model değiştirilmez. |
| CV türü | LOO | LOO ya da 10-kat (ardışık). | CV tablosu ve jackknife segmentleri. |
| En çok bileşen (CV) | 10 (1–30) | CV tablosunun üst sınırı. | Tablo uzunluğu. |
| Ek Y'ler (PLS2) | hiçbiri | İşaretli sütunlar PLS2 modeline. | Ayrı bölüm; ana tablo PLS1 kalır. |
| Ek çıktı: Ağırlık/yük/skor | kapalı | \mathbf W, \mathbf P, \mathbf q tablosu; yük ve skor grafikleri. | Ek bölüm. |
| Ek çıktı: Jackknife GA | kapalı | CV segmentleri üzerinden katsayı SH'si, t, p, %95 GA. | Ek bölüm. |
| Ek çıktı: Tahmin–gözlenen grafiği | kapalı | Grafik paneli. | Yalnız Grafik. |
| Grafik | VIP (varsayılan) | VIP çubukları; 3B t ya da u skorları. | Yalnız Grafik. |
Bileşen sayısı neden bu kadar önemli?
A=1'de PLS tek bir yönde regresyondur ve katsayılar güçlü biçimde büzülür; A=\operatorname{rank}(\mathbf X) olduğunda PLS, OLS'nin aynısıdır. Aradaki değerler yanlılık–varyans dengesini belirler: az bileşen kararlı ama yanlı katsayı, çok bileşen yansız ama gürültülü katsayı verir. Bu yüzden A çapraz doğrulamayla seçilmelidir. MerQur'un varsayılanı (2) bir başlangıçtır, öneri değildir.
108.4 Tıp örneği
Dosya: english/datasets/Tip/44_pls_gene_progression.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/44_pls_gen_progresyon.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #44'ten alınmıştır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
progression_score |
Bağımlı | sürekli | ort. 57,01; SS 33,61; medyan 59,3; −38,6–132,0 |
gene_01 … gene_12 |
Açıklayıcı | sürekli (standart ifade) | ortalamalar −0,19 ile 0,23 arası; SS 0,43–1,75 |
n ve eksik değer: 200 hasta, eksik değer yok. Genler arasında güçlü ilişki vardır: en yüksek korelasyon gene_02–gene_05 arasında r=-0{,}859; OLS'deki VIF'ler 1,23–7,71 (en yüksek gene_12 7,71, gene_05 7,14). y ile en güçlü ilişkili genler gene_05 (r=0{,}914), gene_02 (-0{,}890) ve gene_09 (-0{,}848).
Klinik soru: 12 genin ifade düzeyi ilerleme skorunu ne kadar iyi yordar; yordamaya en çok hangi genler katkı yapar?
Seçilen ayarlar: Arayüz varsayılanları (2 bileşen). Hesap yürüyüşü için ikinci bir çalıştırmada CV ile bileşen seçimi (LOO), ağırlık/yük/skor ve jackknife GA açılmış; ayrıca 10 ardışık katlı CV ve 3 bileşenli model çalıştırılmıştır.
108.5 Formüller ve hesap adımları
MerQur sırayla: (1) liste bazında eksikleri atar, kategorikleri kuklaya açar; (2) X sütunlarını standartlaştırır, y'yi ham bırakır; (3) scikit-learn PLSRegression(n_components=A, scale=False) ile NIPALS PLS1 modelini kurar; (4) katsayıları özgün birime çevirir; (5) eğitim R^2'si, 5 ardışık katta R^2_{CV} ve Q^2, VIP ve bileşen başına açıklanan varyansı hesaplar; (6) istenirse CV eğrisi, yükler, jackknife ve PLS2 ekler.
108.5.1 Standartlaştırma
- s_j: n'ye bölünmüş SS (
StandardScaler). - y ölçeklenmez; yalnız model içinde merkezlenir.
Neden standartlaştırma? n ile n-1 fark eder mi?
PLS ağırlıkları \mathbf X^{\top}\mathbf y kovaryanslarıyla orantılıdır; ölçeklenmezse büyük varyanslı değişken (burada gene_12, SS 1,75) yalnız birimi yüzünden baskın olur. Tüm sütunları aynı sabitle çarpmak (ör. \sqrt{n/(n-1)}) PLS yönlerini değiştirmez, yalnız skorları ölçekler; tahminler ve özgün birim katsayıları aynı kalır. Bu nedenle MerQur'un n'ye bölünmüş SS'si R pls::plsr(scale = TRUE)'nin n-1'e bölünmüş SS'siyle aynı sonucu verir. y'nin ölçeklenmemesi tek yanıtlı modelde katsayıları etkilemez.
108.5.2 NIPALS PLS1
\mathbf E_0=\mathbf X_s, \mathbf f_0=\mathbf y-\bar y\mathbf 1 ile her a=1,\dots,A için:
- \mathbf w_a: birim uzunluklu X ağırlıkları; \mathbf E_{a-1}^{\top}\mathbf f_{a-1} ile orantılı olduğundan \operatorname{Cov}(\mathbf E\mathbf w,\mathbf f)'yi \lVert\mathbf w\rVert=1 koşulunda en büyükler.
- \mathbf t_a: skor; \mathbf p_a: X yükü; q_a: y yükü (\mathbf f'nin \mathbf t_a üzerine regresyon katsayısı).
- Deflasyon: bir sonraki bileşen, önceki bileşenin açıkladığı kısmı çıkarılmış X'ten kurulur; böylece skorlar birbirine diktir.
Koddaki tercih: sklearn NIPALS, tek yanıtta tek adım
PLSRegression(scale=False) (specialized_regression.py:114–115) NIPALS kullanır; tek yanıtta iç döngü ilk adımda yakınsar, sonuç kesindir (yineleme toleransına bağlı değildir). scikit-learn skor/ağırlık işaretlerini kendi kuralıyla (en büyük bileşen yönü) çevirebilir: bu örnekte MerQur çıktısında q_2=-3{,}5663, elle hesapta +3{,}5663'tür (\mathbf w_2 de ters işaretli). İşaret keyfidir; katsayılar, VIP ve R^2 değişmez.
108.5.3 Katsayılar
- \boldsymbol\beta^{s}: standartlaştırılmış X birimlerinde katsayılar (sklearn
coef_). - b_j: özgün birimde katsayı; b_0: sabit (
119–120).
108.5.4 VIP (değişken önemi)
- \text{SS}_a: a. bileşenin açıkladığı y kareler toplamı.
- (w_{aj}/\lVert\mathbf w_a\rVert)^2: j. değişkenin a. bileşen yönündeki payı; her bileşende toplamı 1'dir.
- Bu nedenle \sum_j\text{VIP}_j^2=p: VIP karelerinin ortalaması 1'dir ve "VIP > 1" ortalamanın üzerinde katkı demektir (Wold vd. 2001; Chong ve Jun 2005).
Koddaki tercih: Wold tanımı
specialized_regression.py:146–153; sklearn x_scores_ birim normlu olmadığı için \mathbf t_a^{\top}\mathbf t_a açıkça çarpılır. Bu terim atlanırsa bileşenler y varyansındaki paylarına göre değil eşit ağırlıkla toplanır; tanım R pls ile hesaplanan Wold VIP'iyle aynıdır (108.6.1). VIP bileşen sayısına bağlıdır.
108.5.5 Açıklanan varyans
- \lVert\mathbf X_s\rVert_F^2=np (n'ye bölünen SS ile); burada 200\times12=2400.
- \%Y_{\le a}: ilk a bileşenin birikimli R^2'si; tablodaki "Y %" ardışık farklardır (
specialized_extras.py:24–45; Rpls::explvarveR2(…, estimate = "train")).
108.5.6 Çapraz doğrulama ölçüleri
Her zaman verilen 5 kat ölçüleri (_pls_cv5, 188–206): veri sıra bozulmadan 5 ardışık parçaya bölünür; her katta model kalan dört parçayla kurulur.
- \hat y_{(-k)i}: i'nin bulunduğu kat dışarıda bırakılarak kurulan modelin tahmini.
- \bar y_k: k. katın kendi ortalaması (scikit-learn
r2_score); bu yüzden kat R^2'si, katın içindeki varyansa göredir ve tek bir kat ortalamayı çok düşürebilir. - Q^2: tüm dışarıda-bırakma tahminlerinin toplam KT'ye göre başarısı (R
pls::R2(…, estimate = "CV")ile aynı).
İsteğe bağlı CV eğrisi (pls_cv_curve, specialized_extras.py:55–86): a=0,\dots,A_{\max} için
a=0'da tahmin eğitim katlarının ortalamasıdır. En küçük RMSECV'li a işaretlenir.
Koddaki tercih: katlar içinde yeniden ölçekleme, karıştırma yok
Her iki CV'de de ölçekleme katın içinde yinelenir: CV eğrisinde açıkça StandardScaler().fit(X[tr]), 5 kat ölçülerinde PLSRegression()'ın varsayılan scale=True ayarıyla (kat SS'si n-1'e bölünür). Bu, test katının bilgisinin ölçeklemeye sızmasını önler ve R pls'in crossval davranışıyla aynıdır. Katlar karıştırılmaz (KFold(n_splits=5), np.array_split); veri y'ye ya da bir gruba göre sıralıysa katlar dengesiz olur. 10-kat seçeneği de ardışıktır; kat sayısı arayüzden değiştirilemez. Sonuç metni bunu bir not satırıyla hatırlatır: katlar karıştırılmaz ve her katta X yeniden ölçeklenir.
108.5.7 Jackknife SH (isteğe bağlı)
CV segmentlerinin her birinde (S segment; LOO'da S=n) model yeniden kurulur ve katsayılar o segmentin ölçeklenmiş birimine çevrilir (\beta^{s}_{(s)j}=b_{(s)j}\,s^{(s)}_j, s^{(s)}_j: n-1'e bölünmüş segment SS'si):
- \bar\beta^s_j: segment katsayılarının ortalaması (pls
var.jack(use.mean = TRUE)). - s^{*}_j: tam verinin n-1'e bölünmüş SS'si; SH özgün birime bu bölümle döner.
- GA: b_j\pm t_{S-1;\,0{,}975}\,\SH(b_j); güven düzeyi %95'e sabittir.
Jackknife SH neden "iyimser"?
Bileşen sayısı aynı CV ile seçildiyse ve segmentler birbirine çok benziyorsa (LOO'da her segment n-1 ortak gözlem paylaşır), segment katsayıları arasındaki değişkenlik gerçek örnekleme değişkenliğini tam yansıtmaz. Martens ve Martens (2000) bu SH'yi değişken seçimi için önerir, kesin çıkarım için değil. MerQur bu uyarıyı metne yazar.
108.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/pls/elle_hesap.py ile, MerQur ve scikit-learn çağrılmadan, NIPALS numpy ile elle yazılarak hesaplanmıştır.
Adım 1 — Standartlaştırma. Örnek gene_05: \bar x=0{,}226480, s=1{,}185563 (n'ye bölünmüş). \lVert\mathbf X_s\rVert_F^2=200\times12=2400; \bar y=57{,}0095; \text{SST}=224813{,}232.
Adım 2 — Birinci bileşen. \mathbf X_s^{\top}(\mathbf y-\bar y) vektörünün uzunluğu 14019{,}670; gene_05 bileşeni 6128{,}193:
Diğer büyük ağırlıklar gene_02 (−0,4259), gene_09 (−0,4054), gene_07 (−0,3168); ağırlıklar y ile korelasyonların işaretini izler. Skorlar \mathbf t_1=\mathbf X_s\mathbf w_1 (1. hasta 1{,}370645); \mathbf t_1^{\top}\mathbf t_1=1012{,}030 ve
Birinci bileşen y varyansının 194214{,}667/224813{,}232=\%86{,}39'unu, X varyansının %42,94'ünü açıklar.
Adım 3 — İkinci bileşen. Deflasyondan sonra \mathbf t_2^{\top}\mathbf t_2=532{,}541, |q_2|=3{,}566336, \text{SS}_2=6773{,}254. İkinci bileşen X'in %24,40'ını ama y'nin yalnız %3,01'ini açıklar; birikimli R^2=0{,}894022.
Adım 4 — Katsayılar. gene_05 için standart birimde \beta^s=6{,}805784:
| Gen | PLS b (2 bileşen) | VIP | OLS b | Jackknife SH (LOO) | t_{199} |
|---|---|---|---|---|---|
| gene_01 | 6,139542 | 0,7231 | 1,7381 | 1,00284 | 6,122 |
| gene_02 | −6,940666 | 1,4609 | −9,3699 | 0,28884 | −24,030 |
| gene_03 | −3,394262 | 0,2233 | −1,1020 | 1,08945 | −3,116 |
| gene_04 | −4,180169 | 0,5376 | −5,2873 | 0,45421 | −9,203 |
| gene_05 | 5,740549 | 1,4916 | 7,5195 | 0,24520 | 23,412 |
| gene_06 | −8,832929 | 0,9385 | −1,5227 | 0,97479 | −9,061 |
| gene_07 | −4,325848 | 1,0904 | −4,3357 | 0,39849 | −10,856 |
| gene_08 | 8,081756 | 1,0170 | 3,9548 | 0,91404 | 8,842 |
| gene_09 | −7,642881 | 1,3818 | −8,7213 | 0,39602 | −19,299 |
| gene_10 | 0,584257 | 0,4029 | 1,4338 | 0,54363 | 1,075 |
| gene_11 | 4,124973 | 0,9087 | 0,6482 | 0,57977 | 7,115 |
| gene_12 | −1,327267 | 0,8819 | −2,4156 | 0,17700 | −7,499 |
OLS (R^2=0{,}9094) ile karşılaştırıldığında PLS katsayıları ilişkili gen kümesinde yükü paylaştırır: gene_02 ile gene_05 OLS'de daha büyük, küçük varyanslı gene_01, gene_06, gene_08 PLS'de daha büyüktür. İki bileşenli PLS'nin R^2'si OLS'ninkinin yalnız 0,015 altındadır.
Adım 5 — VIP (gene_05). (w_{1j})^2=0{,}191069, (w_{2j})^2=0{,}022864:
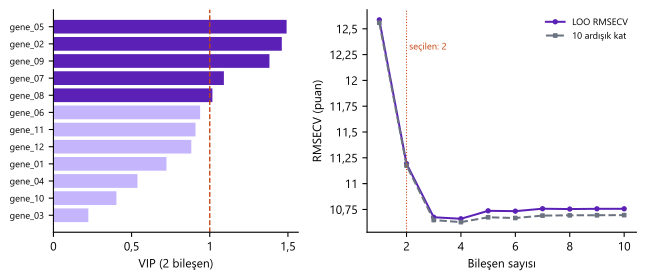
VIP > 1 olan genler: gene_05, gene_02, gene_09, gene_07, gene_08. VIP karelerinin toplamı tam 12'dir.
Adım 6 — 5 kat ölçüleri. Ardışık 5 katın (her biri 40 hasta) R^2'leri: 0,8685; 0,8909; 0,8936; 0,8289; 0,9167. Ortalama R^2_{CV}=0{,}879713. Tüm dışarıda-bırakma tahminleriyle Q^2=1-\text{PRESS}/224813{,}232=0{,}888539. Eğitim R^2'si (0,894) ile fark küçüktür: aşırı uyum yoktur.
Adım 7 — Bileşen sayısı (LOO).
| Bileşen | 0 | 1 | 2 | 3 | 4 | 5 | 10 |
|---|---|---|---|---|---|---|---|
| RMSECV | 33,6956 | 12,5866 | 11,1928 | 10,6743 | 10,6595 | 10,7366 | 10,7563 |
| Q^2 | −0,0101 | 0,8591 | 0,8885 | 0,8986 | 0,8989 | 0,8974 | 0,8971 |
En küçük RMSECV 4 bileşendedir; ancak 3 bileşenden sonraki kazanç 0,015 puandır. MerQur yalnız en küçüğü işaretler; "tek SH kuralı" gibi daha tutumlu bir seçim uygulamaz ve modeli 2 bileşenle bırakır (metinde "En küçük RMSECV: 4 bileşen (model 2 bileşenle kuruldu)" yazar). 10 ardışık katta da en küçük RMSECV 4 bileşendedir (10,6271).
Adım 8 — Tek hasta. 1. hasta için \hat y=50{,}847358+\sum_jx_{1j}b_j=75{,}30; gözlenen 70,4.
Şekil 108.1. Sol: 2 bileşenli modelde VIP; koyu çubuklar VIP ≥ 1, turuncu kesikli çizgi eşik. Sağ: LOO ve 10 ardışık katlı RMSECV; dikey çizgi modelde kullanılan bileşen sayısı.
108.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundaki rows, summary_stats ve extras'tan alınmıştır; summary_stats alanları motor içinde round(…, 4) ile yazıldığı için ikinci çalıştırmada stats.specialized_regression ad alanında round yalnız bellekte etkisizleştirilmiştir. R: 4.5.3, pls 2.9.0: plsr(scale = TRUE, method = "oscorespls"), coef, explvar, R2, RMSEP(…, estimate = "CV") (validation = "LOO" ve segments = 10 | 5, segment.type = "consecutive"), jack.test; VIP Wold tanımıyla R'de elle (loading.weights, scores, Yloadings).
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Sabit b_0 | 50,847358 | 50,847358 | 50,847358 | 2,1e−14 | ✓ |
| b (gene_01) | 6,139542 | 6,139542 | 6,139542 | 4,4e−15 | ✓ |
| b (gene_02) | −6,940666 | −6,940666 | −6,940666 | 2,7e−15 | ✓ |
| b (gene_05) | 5,740549 | 5,740549 | 5,740549 | 5,3e−15 | ✓ |
| b (gene_06) | −8,832929 | −8,832929 | −8,832929 | 1,8e−15 | ✓ |
| b (gene_09) | −7,642881 | −7,642881 | −7,642881 | 3,6e−15 | ✓ |
| b (gene_10) | 0,584257 | 0,584257 | 0,584257 | 1,4e−15 | ✓ |
| VIP (gene_02) | 1,460888 | 1,460888 | 1,460888 | 3,6e−15 | ✓ |
| VIP (gene_05) | 1,491577 | 1,491577 | 1,491577 | 4,0e−15 | ✓ |
| VIP (gene_07) | 1,090373 | 1,090373 | 1,090373 | 1,8e−15 | ✓ |
| VIP (gene_08) | 1,016976 | 1,016976 | 1,016976 | 4,7e−15 | ✓ |
| VIP (gene_03) | 0,223333 | 0,223333 | 0,223333 | 1,9e−16 | ✓ |
| R^2 (eğitim) | 0,894022 | 0,894022 | 0,894022 | 2,2e−16 | ✓ |
| Açıklanan X varyansı, bileşen 1 (%) | 42,941785 | 42,941785 | 42,941785 | 2,1e−14 | ✓ |
| Açıklanan X varyansı, bileşen 2 (%) | 24,400852 | 24,400852 | 24,400852 | 2,5e−14 | ✓ |
| Kümülatif Y varyansı, 2 bileşen (%) | 89,402176 | 89,402176 | 89,402176 | 1,4e−14 | ✓ |
| R^2_{CV} (5 kat ortalaması) | 0,879713 | 0,879713 | 0,879713 | 0,0e+00 | ✓ |
| Q^2 (5 kat, PRESS) | 0,888539 | 0,888539 | 0,888539 | 2,2e−16 | ✓ |
CV eğrisi ve jackknife:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| LOO RMSECV, 0 bileşen | 33,695574 | 33,695574 | 33,695574 | 1,4e−14 | ✓ |
| LOO RMSECV, 1 bileşen | 12,586614 | 12,586614 | 12,586614 | 4,6e−14 | ✓ |
| LOO RMSECV, 2 bileşen | 11,192796 | 11,192796 | 11,192796 | 1,1e−14 | ✓ |
| LOO RMSECV, 4 bileşen | 10,659515 | 10,659515 | 10,659515 | 3,9e−14 | ✓ |
| LOO RMSECV, 10 bileşen | 10,756283 | 10,756283 | 10,756283 | 4,6e−14 | ✓ |
| LOO Q^2, 4 bileşen | 0,898916 | 0,898916 | 0,898916 | 2,2e−16 | ✓ |
| 10 ardışık kat RMSECV, 2 bileşen | 11,174783 | 11,174783 | 11,174783 | 2,1e−14 | ✓ |
| 10 ardışık kat RMSECV, 4 bileşen | 10,627117 | 10,627117 | 10,627117 | 1,4e−14 | ✓ |
| Jackknife t (gene_01) | 6,122142 | 6,122142 | 6,122142 | 6,0e−14 | ✓ |
| Jackknife t (gene_03) | −3,115572 | −3,115572 | −3,115572 | 9,3e−15 | ✓ |
| Jackknife t (gene_10) | 1,074726 | 1,074726 | 1,074726 | 2,0e−15 | ✓ |
| Jackknife p (gene_10) | 0,283799 | 0,283799 | 0,283799 | 1,0e−15 | ✓ |
| Jackknife SH (gene_03) | 1,089451 | 1,089451 | 1,089451 | 3,3e−15 | ✓ |
31 büyüklüğün tamamı 10^{-13} düzeyinde eşleşir. Jackknife SH için R jack.test doğrudan SH vermez; R satırı b_j/t_j olarak hesaplanmıştır.
108.7 Çıktıyı okuma
Sonuç metni (varsayılan ayarlar, kısaltılmış):
PLS Regresyon
  N (gözlem)         = 200
  Yordayıcı sayısı   = 12
  Bileşen sayısı       = 2
  R² (eğitim)          = 0.894
  R²_CV (5 katlı)      = 0.8797
  Q² (5 katlı, PRESS)  = 0.8885
  5 katlı ölçüler karıştırılmamış ardışık katlarla hesaplanır (her katta X yeniden
  ölçeklenir); veri dosyası bir değişkene göre sıralıysa R²_CV ve Q² yanıltıcı olabilir.
      Değişken      Katsayı          VIP
         Sabit      50.8474            —
       gene_02      -6.9407       1.4609
       gene_05       5.7405       1.4916
       gene_10       0.5843       0.4029
── PLS BİLEŞENLERİNİN AÇIKLADIĞI VARYANS (%) ──
    Bileşen          X %      Küm. X %       Y %      Küm. Y %
    1              42.94         42.94     86.39         86.39
    2              24.40         67.34      3.01         89.40
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Bileşen sayısı | Kullanılan bileşen sayısı | Rank sınırına takıldıysa uyarıda istenen ve kullanılan sayı yazılır. |
| R² (eğitim) | Eğitim R^2'si | Model verisindeki uyum; iyimserdir. |
| R^2_{CV} (5 katlı) | Kat R^2 ortalaması | Tek bir kat ortalamayı çok düşürebilir; Q^2 ile birlikte okuyun. |
| Q^2 (5 katlı, PRESS) | Dışarıda-bırakma başarısı | R^2 ile büyük fark aşırı uyum işaretidir. |
| Katsayı | Özgün birimde b_j | Diğer genler sabitken bir birimlik artışın etkisi; ilişkili genlerde tek başına yorumlanması zordur. |
| VIP | Değişken önemi | > 1: ortalamanın üstünde katkı. 0,8–1 "orta" bölge sayılır; kesin eşik değildir. |
| Açıklanan varyans | X % ve Y % | X'in az bir bölümü y'nin çoğunu açıklıyorsa, y'ye ilişkin bilgi birkaç yönde toplanmıştır. |
| CV tablosu | PRESS, RMSECV, Q^2; ← en küçük | Öneri işaretidir; model otomatik değişmez. |
| Jackknife | SH, t, p, %95 GA | İyimser olabilir; değişken eleme için ölçüt. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Hastalık ilerleme skoru, 12 genin standartlaştırılmış ifade düzeyleriyle iki bileşenli kısmi en küçük kareler (PLS) regresyonuyla yordandı (N = 200). İki bileşen genlerdeki varyansın %67,3'ünü, ilerleme skorundaki varyansın %89,4'ünü açıkladı (R^2 = 0{,}89); beş katlı çapraz doğrulamada Q^2 = 0{,}89 bulundu. Yordamaya en çok katkı yapan genler
gene_05(VIP = 1,49; b = 5{,}74),gene_02(VIP = 1,46; b = -6{,}94) vegene_09(VIP = 1,38; b = -7{,}64) idi. Birini dışarıda bırakma çapraz doğrulamasında en küçük hata dört bileşende elde edildi (RMSECV = 10,66; iki bileşende 11,19).
108.8 Uzman soruları
S1. Hangi PLS algoritması? SIMPLS ile aynı mı?
scikit-learn PLSRegression NIPALS'tir (scale=False, X MerQur'da önceden standartlaştırılır). Tek yanıtta NIPALS, SIMPLS ve R pls'in kernelpls/oscorespls yöntemleri aynı katsayıları verir; fark çok yanıtlı (PLS2) modelde ortaya çıkar. Doğrulamada oscorespls (ortogonal skorlu NIPALS) kullanılmıştır.
S2. X neden n ile ölçekleniyor? R `scale = TRUE` n-1 kullanıyor.
Tüm sütunlara aynı c sabitinin uygulanması PLS yönlerini değiştirmez: ağırlıklar \mathbf w ve X yükleri \mathbf p aynı kalır, skorlar c katı, y yükleri 1/c katı ölçeklenir; tahminler ve özgün birim katsayıları değişmez. Bu yüzden R ile katsayılar 10^{-15} düzeyinde eşleşir. MerQur'un skorları R'ninkinden \sqrt{n/(n-1)} katı büyük, q değerleri aynı oranda küçüktür.
S3. VIP > 1 eşiğinin dayanağı nedir?
Tanım gereği \sum_j\text{VIP}_j^2=p; VIP karelerinin ortalaması 1'dir. "VIP > 1" bu yüzden "ortalama değişkenden fazla katkı" anlamına gelir (Wold vd. 2001). Eşik keyfidir; ilişkili değişkenlerde 1'den küçük eşiklerin (ör. 0,8) de kullanıldığı görülür (Chong ve Jun 2005; Mehmood vd. 2012). VIP bileşen sayısına bağlıdır: 3 bileşende sıralama değişebilir.
S4. Bileşen sayısı CV ile seçiliyor mu?
Hayır. "Bileşen sayısını CV ile seç" kutusu yalnız tabloyu üretir ve en küçük RMSECV'yi işaretler; model kullanıcının girdiği bileşen sayısıyla kurulur (pls3_best iletisi). Tutumlu seçim için "en küçük RMSECV'nin bir SH'si içindeki en az bileşen" kuralı sık kullanılır; MerQur tabloda her bileşen için MSE'nin SH'sini hesaplar (se_mse) ama metne yazmaz ve kuralı uygulamaz.
S5. R^2_{CV} ile Q^2 neden farklı?
R^2_{CV} her katın kendi ortalamasına göre R^2'sini alıp ortalar; kat içi varyans küçükse o katın R^2'si düşer (bu örnekte 4. kat 0,829). Q^2 tüm dışarıda-bırakma hatalarını toplam KT'ye böler; tek bir kattan daha az etkilenir ve R pls::R2(estimate = "CV") ile aynıdır. Raporlamada Q^2 önerilir.
S6. Veri y'ye göre sıralı olsaydı?
5 kat ve 10 kat ardışık parçalardır; karıştırma yoktur. Sıralı veride her kat y'nin dar bir aralığını içerir; model dış değerleme yapmak zorunda kalır ve Q^2 ile özellikle kat R^2'leri kötüleşir. LOO bu sorundan etkilenmez. Sıralı veride satırları önceden karıştırmak ya da LOO kullanmak gerekir.
S7. Bileşen sayısı rankı aşarsa ne olur?
NIPALS deflasyonunda artık matris sıfıra yaklaşır ve ağırlıklar sayısal gürültüden kurulur; katsayılar anlamsızlaşır. MerQur A'yı \min(\text{istenen},\ p,\ n-1,\ \operatorname{rank}\mathbf X_s)'e indirir ve uyarı yazar (106–112). CV eğrisinde de üst sınır aynı biçimde kısıtlanır.
S8. Jackknife p değerleri ne kadar güvenilir?
Tanım R pls::jack.test ile aynıdır ve 10^{-14} düzeyinde eşleşir. Ancak segment katsayıları güçlü biçimde bağımlıdır; SH iyimser olabilir ve t_{S-1} dağılımı yaklaşık bir dayanaktır (Martens ve Martens 2000). Bu örnekte gene_10 dışında tüm genler "anlamlı" çıkar; bu, VIP'i 0,4 olan gene_03'ü bile kapsar. Jackknife sonucunu değişken önemi kanıtı gibi okumamak gerekir.
108.9 Sık hatalar ve tuzaklar
- Varsayılan 2 bileşeni öneri sanmak. Bileşen sayısı CV tablosuyla seçilmeli ve modelde elle değiştirilmelidir; CV kutusu modeli değiştirmez.
- Katsayıları OLS katsayısı gibi yorumlamak. PLS katsayıları büzülmüştür ve ilişkili değişkenler arasında paylaştırılmıştır; işaret bile OLS'den farklı olabilir.
- VIP'i anlamlılık testi sanmak. VIP yalnız göreli katkıyı sıralar; eşik keyfidir.
- Sıralı veride ardışık katlar. Karıştırma yoktur; veri dosyası y'ye ya da tarihe göre sıralıysa 5 kat ölçüleri yanıltır.
- Eğitim R^2'sini rapor etmek. Asıl yordama başarısı Q^2 (ya da RMSECV) ile verilmelidir.
- Bileşen işaretini yorumlamak. Skor, ağırlık ve q işaretleri keyfidir (bu örnekte ikinci bileşen R ile ters işaretli).
- PLS2 bölümündeki katsayıları ana tablo ile karıştırmak. PLS2'de tüm y'ler standartlaştırılır ve ortak bileşenler kullanılır; ana tablo yalnız birinci y'nin PLS1 modelidir.
108.10 Kaynaklar
- Chong, I.-G., & Jun, C.-H. (2005). Performance of some variable selection methods when multicollinearity is present. Chemometrics and Intelligent Laboratory Systems, 78(1–2), 103–112. https://doi.org/10.1016/j.chemolab.2004.12.011
- Geladi, P., & Kowalski, B. R. (1986). Partial least-squares regression: A tutorial. Analytica Chimica Acta, 185, 1–17. https://doi.org/10.1016/0003-2670(86)80028-9
- Martens, H., & Martens, M. (2000). Modified jack-knife estimation of parameter uncertainty in bilinear modelling by partial least squares regression (PLSR). Food Quality and Preference, 11(1–2), 5–16. https://doi.org/10.1016/S0950-3293(99)00039-7
- Mehmood, T., Liland, K. H., Snipen, L., & Sæbø, S. (2012). A review of variable selection methods in partial least squares regression. Chemometrics and Intelligent Laboratory Systems, 118, 62–69. https://doi.org/10.1016/j.chemolab.2012.07.010
- Mevik, B.-H., & Wehrens, R. (2007). The pls package: Principal component and partial least squares regression in R. Journal of Statistical Software, 18(2). https://doi.org/10.18637/jss.v018.i02
- Wold, S., Sjöström, M., & Eriksson, L. (2001). PLS-regression: A basic tool of chemometrics. Chemometrics and Intelligent Laboratory Systems, 58(2), 109–130. https://doi.org/10.1016/S0169-7439(01)00155-1