41. Kanonik Korelasyon Analizi
Analiz kimliği: cca · Menü adı: Kanonik Korelasyon · Panel: gui/panels/analyses/cca_panel.py (execute satır 132–159, _manova_tests 176–220, cca_extras 223–270) · Motor: stats/canonical_correlation.py, run_cca (satır 91–328), format_cca_text (satır 333–412)
41.1 Ne işe yarar
Kanonik korelasyon analizi (CCA), iki değişken seti arasındaki doğrusal ilişkinin en güçlü olduğu yönleri bulur. Cevapladığı soru şudur: "X setindeki değişkenlerin hangi ağırlıklı toplamı, Y setindeki değişkenlerin hangi ağırlıklı toplamıyla en yüksek korelasyonu verir; bu ilişkiden kaç bağımsız boyut çıkar?"
Model, her iki setten birer doğrusal bileşen (kanonik değişken) kurar:
- \mathbf x=(X_1,\dots,X_p)^{\top}: birinci set (p değişken); \mathbf y=(Y_1,\dots,Y_q)^{\top}: ikinci set (q değişken).
- \mathbf a_i,\ \mathbf b_i: i. çiftin ham kanonik katsayıları (ağırlıklar).
- U_i,\ V_i: i. kanonik değişken çifti; her birinin varyansı 1'dir.
- r_i: i. kanonik korelasyon. r_1\ge r_2\ge\dots\ge r_K\ge0, K=\min(p,q).
- Kısıt: i\ne j için U_i ile U_j, V_i ile V_j ve U_i ile V_j ilişkisizdir. Her yeni çift, öncekilerin açıklamadığı ortak yapıyı arar.
Sıralı hipotezler, i=1,\dots,K için:
Ne zaman kullanılır? İki set de aralık ya da oran ölçeğinde birden çok sürekli değişkenden oluşuyorsa ve soru "setler arasında kaç boyutlu bir ilişki var, her boyutu hangi değişkenler taşıyor" ise. Tipik örnekler: laboratuvar paneli ile klinik skorlar, tutum ölçeği alt boyutları ile davranış ölçümleri, toprak özellikleri ile bitki örtüsü ölçümleri.
Ne zaman kullanılmaz?
- Y seti tek değişkense: CCA çoklu regresyona indirgenir (r_1=R); Çoklu Doğrusal Regresyon kullanın.
- Bir set kategorik grup değişkeniyse: MANOVA ya da Diskriminant Analizi.
- İki set de kategorikse: Uyum Analizi (Bölüm 42) ya da çoklu uyum analizi.
- Amaç Y'yi X'ten kestirmek ise ve setlerde çok sayıda, yüksek korelasyonlu değişken varsa: PLS Regresyon. CCA ilişkiyi tanımlar, en iyi kestirimi değil.
- Değişkenler tek bir setin iç yapısını özetlemek içinse (iki set yok): Temel Bileşenler Analizi ya da Değişken Kümeleme (Bölüm 43).
- n, p+q'ya yakınsa: kanonik korelasyonlar 1'e doğru şişer; düzenlileştirilmiş CCA gerekir (MerQur'da yoktur).
Sık karıştırılan analizler. Ekolojideki "kanonik uyum analizi" (CCA, ter Braak) tür bolluğu matrisini çevre değişkenleriyle ilişkilendiren ayrı bir yöntemdir ve aynı kısaltmayı paylaşır. MANOVA, CCA'nın bir set gösterge (kukla) değişkenlerden oluştuğu özel durumdur; çok değişkenli testler (Wilks, Pillai …) iki analizde aynı özdeğerlerden çıkar (Bölüm 13). PLS iki setin kovaryansını, CCA korelasyonunu en büyükler.
41.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
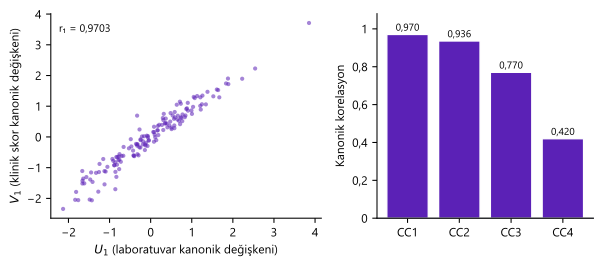
| Doğrusallık | Setler arası ilişki doğrusal bileşenlerle yakalanabilir. | Denetlenmez; grafiklerle (3B kanonik skorlar, U_1–V_1 saçılımı) gözle bakılır. |
| Çok değişkenli normallik | Sıralı Bartlett \chi^2 testi ve tam model F testleri \mathbf x\cup\mathbf y'nin çok değişkenli normal olduğunu varsayar. Kestirimler (r, katsayı, yük) normallik gerektirmez. | "Varsayım tanıları" kutusu: Mardia çarpıklık ve basıklık (\mathbf x\cup\mathbf y birlikte). |
| Set içinde tam çoklu doğrusallık yok | \mathbf R_{xx} ve \mathbf R_{yy} tersinir olmalı. | Özdeğer \le10^{-12} ise hata (canonical_correlation.py:164–168); "Varsayım tanıları" kutusu set içi VIF verir, >10 ise ⚠. |
| Yeterli örneklem | Kanonik korelasyonlar en büyükleme ürünü olduğu için küçük n'de yukarı yanlıdır. | n<p+q+1 ise hata; n<30 ise uyarı (canonical_correlation.py:134–140). |
| Bağımsız gözlemler | Her satır ayrı bir birim. | Denetlenmez. |
Eksik değer. X ve Y'de seçilen tüm sütunlar pd.to_numeric(errors="coerce") ile sayıya çevrilir, sonra liste bazında silinir: tek bir sütunu eksik olan satır tüm analizden çıkar (canonical_correlation.py:130). Ek çıktılar aynı alt kümeyi yeniden kurar (cca_panel.py:228).
Uç durumlar.
- Setlerden biri boşsa, bir sette 2'den az değişken varsa ya da iki set ortak sütun içeriyorsa hata (
canonical_correlation.py:111–117; panel ayrıcastats_panel.py:9512–9526). - n<p+q+1: korelasyon matrisi tekildir, hata (
canonical_correlation.py:134–137). - Sabit (SS = 0) bir sütun ya da set içi tam doğrusal bağımlılık: "Set içi korelasyon matrisi tekil" hatası (
canonical_correlation.py:157–168). - Bir kanonik korelasyon sayısal olarak 1'e ulaşırsa Wilks \Lambda=0 olur; kod bu durumda \chi^2=0 ve p=1 yazar (bkz. 41.9).
41.3 Parametreler
Varsayılanlar cca_panel.py:60–120 ve _hypothesis_forms.py:331–336 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| X seti (numeric, ≥2) | veriye bağlı | Birinci değişken seti; en az 2 sayısal sütun. | Setlerin yeri değişirse r'ler aynı kalır; işaret kuralı (41.5.3) X yüklerine bağlı olduğu için işaretler ve "Red(X|Y)/Red(Y|X)" sütunları yer değiştirir. |
| Y seti (numeric, ≥2) | veriye bağlı | İkinci set; X ile kesişmemeli. | — |
| Bileşen sayısı | 0 = Otomatik → \min(p,q) | Gösterilen kanonik çift sayısı (0–20). | Yalnız gösterimi sınırlar. Wilks \Lambda_i, tam model testleri ve özdeğer oranları her zaman tüm K kökle hesaplanır (canonical_correlation.py:186–189, cca_panel.py:242–245). K'yı aşan istek K'ya indirilir ve ayar bloğuna not düşülür (cca_panel.py:145–149). |
| Güven düzeyi | %95 | %90, %95, %99 ya da özel; \alpha=1-\text{düzey}. | Fisher-z GA genişliğini ve anlamlılık yıldızının eşiğini değiştirir (canonical_correlation.py:200, 360–362). Testlerin kendisi değişmez. |
| Ek çıktılar: Çapraz yükler | kapalı | \operatorname{kor}(X_j,V_i) ve \operatorname{kor}(Y_k,U_i). | Ek tablo. |
| Ek çıktılar: Çok değişkenli testler | kapalı | Pillai, Wilks (Rao F), Hotelling–Lawley (McKeon F), Roy. | Ek tablo; H_0: tüm kanonik korelasyonlar 0. |
| Ek çıktılar: Özdeğerler | kapalı | r_i^2/(1-r_i^2), oranı ve birikimli oranı. | Ek tablo. |
| Ek çıktılar: Varsayım tanıları | kapalı | Mardia (\mathbf x\cup\mathbf y) ve set içi VIF. | Ek satırlar. |
| Ek çıktılar: Skorları kaydet | kapalı | CCA_U1…, CCA_V1… sütunlarını veri setine ekler. |
Veri seti değişir; eksik satırlarda boş kalır. |
| Grafik | Kanonik korelasyonlar | Çubuk grafik; ya da ilk üç U (ya da V) skorunun 3B saçılımı. | Yalnız Grafik sekmesi. Çubuk rengi sıralı Wilks p<\alpha'ya göredir (cca_panel.py:400–405). |
Neden bileşen sayısı testleri değiştirmiyor?
Sıralı Wilks \Lambda_i=\prod_{j\ge i}(1-r_j^2) tanımı gereği i'den sonraki tüm kökleri içerir. Kullanıcı 2 bileşen istediğinde \Lambda_1 yalnız ilk iki kökle hesaplansaydı, kalan iki kökün katkısı yok sayılır ve \Lambda_1 olduğundan büyük (test daha tutucu) çıkardı. MerQur bütün kökleri all_canonical_correlations içinde saklar ve testlerde onları kullanır (canonical_correlation.py:186–188, 223). Bu veride bileşen sayısı 2 seçildiğinde CC1 ve CC2 satırları, 4 seçildiğindekiyle birebir aynıdır (dogrulama/cca/merqur_cca.txt, senaryo k2).
41.4 Tıp örneği
Dosya: english/datasets/Tip/36_cca_lab_clinical.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/36_cca_lab_klinik.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #36 bölümünden alınmıştır.
| Değişken | Rol | Tür | Açıklama (ortalama; SS) |
|---|---|---|---|
WBC_K_uL |
X | sürekli | Lökosit, 10³/µL (7,15; 1,82) |
CRP_mg_L |
X | sürekli | C-reaktif protein (3,01; 1,56) |
creatinine_mg_dL |
X | sürekli | Kreatinin (0,918; 0,270) |
AST_U_L |
X | sürekli | AST, U/L (26,99; 12,47) |
Hb_g_dL |
X | sürekli | Hemoglobin (12,95; 2,07) |
APACHE_score |
Y | sayım/skor | APACHE II (14,75; 7,02) |
SOFA_score |
Y | sayım/skor | SOFA (5,46; 4,09) |
SAPS_score |
Y | sayım/skor | SAPS (39,81; 10,77) |
GCS |
Y | sıralı skor | Glasgow koma skalası (12,69; 2,03) |
patient_id |
kullanılmaz |
n ve eksik değer: 150 yoğun bakım hastası; hiçbir sütunda eksik değer yoktur. p=5, q=4, K=\min(5{,}4)=4 kanonik çift.
Klinik soru: Laboratuvar bulguları seti ile yoğun bakım ağırlık skorları seti arasında kaç bağımsız ortak boyut vardır, her boyutu hangi laboratuvar ve hangi skor taşır?
Seçilen ayarlar: Bileşen sayısı Otomatik, %95 güven düzeyi; hesap yürüyüşü için beş ek çıktı kutusundan dördü (çapraz yükler, çok değişkenli testler, özdeğerler, varsayım tanıları) açılarak ikinci bir çalıştırma yapılmıştır.
Veri sentetiktir
Tıp paketi öğretim amaçlı üretilmiştir. Kanonik korelasyonlar (0,97; 0,94) gerçek klinik verilerde nadir görülecek kadar yüksektir ve bazı yük işaretleri klinik beklentiyle örtüşmez (ör. CC1'de SOFA ile APACHE ters yönde). Bölümde sayıların nasıl hesaplandığına odaklanılır; klinik yorum yalnız örnek amaçlıdır.
41.5 Formüller ve hesap adımları
MerQur'un hesap sırası şudur: (1) X ∪ Y sütunlarını sayıya çevir ve liste bazında eksikleri sil; (2) birleşik korelasyon matrisini kur ve \mathbf R_{xx}, \mathbf R_{yy}, \mathbf R_{xy} bloklarına ayır; (3) \mathbf M=\mathbf R_{xx}^{-1/2}\mathbf R_{xy}\mathbf R_{yy}^{-1/2} matrisinin tekil değer ayrışımından kanonik korelasyonları ve standart katsayıları bul; (4) işaretleri sabitle; (5) Fisher-z GA, sıralı Bartlett testi, yapı yükleri, açıklanan varyans ve artıklık indeksini hesapla; (6) istenirse ham katsayılar üzerinden kanonik skorları kurup çapraz yükleri, tam model testlerini, özdeğerleri ve tanıları ekle.
41.5.1 Korelasyon blokları
- \mathbf R: (p+q)\times(p+q) Pearson korelasyon matrisi;
np.corrcoef(XY.T)(canonical_correlation.py:159). - \mathbf R_{xx} (p\times p) ve \mathbf R_{yy} (q\times q): set içi korelasyonlar.
- \mathbf R_{xy} (p\times q): setler arası korelasyonlar; \mathbf R_{yx}=\mathbf R_{xy}^{\top}.
Neden kovaryans değil korelasyon?
Kanonik korelasyonlar ölçek değişimine karşı değişmezdir: bir değişkeni sabitle çarpmak ham katsayıyı aynı sabite böler, r_i'yi değiştirmez. Korelasyon matrisiyle çalışmak doğrudan standartlaştırılmış katsayıları verir ve birimleri çok farklı değişkenlerde (AST 27 U/L, kreatinin 0,9 mg/dL) sayısal dengeyi korur. Ham katsayılar sonra standart sapmalara bölünerek elde edilir (41.5.4).
41.5.2 Kapalı biçim çözüm: beyazlatma ve SVD
- \mathbf R_{xx}^{-1/2}: simetrik ters karekök; \mathbf R_{xx}=\mathbf V\mathbf W\mathbf V^{\top} özayrışımından \mathbf V\mathbf W^{-1/2}\mathbf V^{\top} (
_inv_sqrt,canonical_correlation.py:164–168). - \mathbf M: "beyazlatılmış" setler arası korelasyon matrisi; iki set de birim kovaryanslı hâle getirildikten sonraki çapraz korelasyon.
- \mathbf P\boldsymbol\Sigma\mathbf Q^{\top}: tekil değer ayrışımı (SVD); \sigma_1\ge\sigma_2\ge\dots tekil değerler, \mathbf p_i, \mathbf q_i sol ve sağ tekil vektörler.
- \mathbf a_i^{*},\ \mathbf b_i^{*}: standartlaştırılmış kanonik katsayılar; z-puanlarına uygulanır.
Neden tekil değerler kanonik korelasyonlardır?
\operatorname{kor}(U,V)=\mathbf a^{*\top}\mathbf R_{xy}\mathbf b^{*}, kısıtlar \mathbf a^{*\top}\mathbf R_{xx}\mathbf a^{*}=1 ve \mathbf b^{*\top}\mathbf R_{yy}\mathbf b^{*}=1. Değişken değiştirerek \mathbf u=\mathbf R_{xx}^{1/2}\mathbf a^{*}, \mathbf v=\mathbf R_{yy}^{1/2}\mathbf b^{*} yazılırsa sorun, \lVert\mathbf u\rVert=\lVert\mathbf v\rVert=1 altında \mathbf u^{\top}\mathbf M\mathbf v'yi en büyüklemeye dönüşür. Bunun çözümü SVD'dir: en büyük değer \sigma_1, \mathbf u=\mathbf p_1, \mathbf v=\mathbf q_1'de elde edilir; ortogonallik kısıtıyla sonraki tekil çiftler sonraki kanonik çiftleri verir (Hotelling 1936). Eşdeğer biçim, \mathbf R_{xx}^{-1}\mathbf R_{xy}\mathbf R_{yy}^{-1}\mathbf R_{yx}'in özdeğerlerinin r_i^2 olmasıdır.
Koddaki tercih: kapalı biçim, NIPALS değil
MerQur yinelemeli NIPALS (sklearn.cross_decomposition.CCA) yerine kapalı biçimi kullanır; yinelemeli yolda birbirine yakın r'lerde ağırlıklar yakınsamayabilir ve yapı yükleri sapar (canonical_correlation.py:152–175); bu R cancor/CCA::cc ile aynı çözümdür. Tekil değerler [0,\,1] aralığına kırpılır (canonical_correlation.py:188).
41.5.3 İşaret kuralı
Her kanonik çiftte (\mathbf a_i^{*},\mathbf b_i^{*}) ile (-\mathbf a_i^{*},-\mathbf b_i^{*}) aynı r_i'yi verir; işaret keyfidir.
Koddaki tercih: en büyük X yapı yükü pozitif
MerQur her çiftte X yapı yüklerini (\mathbf R_{xx}\mathbf a_i^{*}) hesaplar; mutlak değerce en büyük olanı negatifse \mathbf a_i^{*} ve \mathbf b_i^{*}'yi birlikte -1 ile çarpar (canonical_correlation.py:179–184). Böylece farklı makinelerde ve platformlarda aynı işaret çıkar. R cancor/CCA::cc böyle bir kural uygulamaz; aynı veride bazı sütunların işareti ters görünebilir. Doğrulamada R değerleri aynı kurala çevrilmiştir.
41.5.4 Ham katsayılar ve kanonik skorlar
- \mathbf D_x=\operatorname{diag}(s_{X_1},\dots,s_{X_p}): X değişkenlerinin standart sapmaları (
ddof=1,canonical_correlation.py:322–325). - \mathbf a_i,\ \mathbf b_i: ham kanonik katsayılar; ortalamadan sapmalara uygulanır.
- U_{ti},\ V_{ti}: t. hastanın i. kanonik değişken skorları (
cca_panel.py:232–235). - Bu ölçeklemede \operatorname{Var}(U_i)=\operatorname{Var}(V_i)=1 (n-1 paydalı).
Neden n − 1 paydalı birim varyans?
R CCA::cc (xcoef) kanonik değişkeni n-1 paydalı varyansı 1 olacak biçimde ölçekler. R taban cancor() ise \sum U^2=1 ölçeğini kullanır; onun katsayıları MerQur'unkinin 1/\sqrt{n-1} katıdır. Ham katsayının büyüklüğü değişkenin birimine bağlıdır (kreatinin katsayısı −1,33, AST katsayısı 0,067); değişkenlerin göreli önemini karşılaştırmak için standart katsayılar ya da yapı yükleri kullanılır.
41.5.5 Yapı yükleri, çapraz yükler, açıklanan varyans ve artıklık
- \ell^{X}_{ji}=\operatorname{kor}(X_j,U_i): yapı yükü (kanonik yük); X_j ile kendi setinin kanonik değişkeni arasındaki korelasyon (
canonical_correlation.py:252–254). - \operatorname{kor}(X_j,V_i): çapraz yük; X_j'nin karşı setin kanonik değişkeniyle korelasyonu. Kod bunu skorlardan doğrudan
np.corrcoefile hesaplar (cca_panel.py:237–241); sonuç r_i\ell^{X}_{ji}'ye eşittir. - \operatorname{Var}(X)_i: U_i'nin X setinin standartlaştırılmış toplam varyansından açıkladığı pay (
canonical_correlation.py:257). - \operatorname{Red}(X\mid Y)_i: artıklık indeksi (Stewart ve Love 1968); X setinin varyansının karşı setin i. kanonik değişkeni V_i tarafından açıklanan payı (
canonical_correlation.py:261–262).
Neden yükler, katsayılar değil?
Standart katsayılar, set içi değişkenler korelasyonluysa birbirinin etkisini paylaşır; işaretleri ve büyüklükleri kararsızdır (bu veride Y setinde SOFA ile GCS r=-0{,}77, CC4'te katsayılar −2,08 ve −2,03 gibi 1'i aşan değerler alır). Yapı yükü ise basit bir korelasyondur ve "bu kanonik değişken en çok hangi gözlenen değişkene benziyor" sorusunu doğrudan cevaplar. Kanonik korelasyonu yorumlarken yükler, ağırlıkları neden aldığını anlamak için katsayılar okunur (Sherry ve Henson 2005).
Artıklık simetrik değildir
r_i^2 iki kanonik değişkenin paylaştığı varyanstır; artıklık ise gözlenen değişkenlerin varyansıdır. Bu veride CC1 için \operatorname{Red}(Y\mid X)=\%52{,}25 iken \operatorname{Red}(X\mid Y)=\%19{,}24'tür: laboratuvar seti klinik skorların yarısından fazlasını açıklar, tersi ise geçerli değildir. r_1=0{,}97 tek başına "iki set neredeyse aynı bilgiyi taşıyor" anlamına gelmez.
41.5.6 Kanonik korelasyon için Fisher-z güven aralığı
- \operatorname{artanh}: Fisher z dönüşümü; Pearson r'nin örnekleme dağılımını yaklaşık normalleştirir (Fisher 1915).
- z_{1-\alpha/2}: standart normal kantil; %95 için 1,959964.
- \cap[0{,}1]: kanonik korelasyon negatif olamayacağı için sınırlar [0,\,1]'e kırpılır (
canonical_correlation.py:211–213).
Bu aralık yaklaşıktır ve iyimserdir
Fisher dönüşümü tek bir Pearson korelasyonu için geliştirilmiştir. Kanonik korelasyon ise p+q ağırlık üzerinden en büyüklenmiş bir istatistiktir; yukarı yanlıdır ve standart hatası p ile q'ya da bağlıdır. MerQur bunu kodda ve çıktıda not eder ("Kanonik r güven aralığı yaklaşıktır"). R CCA paketi kanonik r için GA vermez. GA sınırları sonuç nesnesinde tam değerleriyle saklanır; yuvarlama yalnız gösterimde yapılır (canonical_correlation.py:214–217).
41.5.7 Sıralı Bartlett testi
- \Lambda_i: i. ve sonraki köklerin birlikte sıfır olduğu hipotezi için Wilks lambda (
canonical_correlation.py:231). - Köşeli parantez: Bartlett (1941) çarpanı; bu veride 150-1-5=144.
- \sd_i: kod sıfırdan başlayan indeksle
(p - i) * (q - i)yazar (canonical_correlation.py:232); i=1'de pq=20. - p değeri 1-F_{\chi^2}(\chi^2_i;\sd_i) ile hesaplanır (
canonical_correlation.py:240).
Neden ardışık test ve neden -\left[n-1-(p+q+1)/2\right]?
\Lambda_1 tüm kökleri içerir ve "setler ilişkisiz" hipotezini sınar. \Lambda_1 anlamlıysa en az \rho_1\neq0'dır; ardından \rho_1 çıkarılıp \Lambda_2 ile "geri kalan kökler sıfır mı" diye bakılır. -n\ln\Lambda olabilirlik oranı istatistiğidir; Bartlett, n yerine n-1-(p+q+1)/2 kullanmanın \chi^2 yaklaşımını küçük örneklemde belirgin biçimde iyileştirdiğini gösterdi. Yorum kuralı: p_i<\alpha olan ilk ardışık kökler anlamlı sayılır; \Lambda_3 anlamlı ama \Lambda_2 anlamsız gibi bir durum mantıksal olarak yorumlanmaz.
Koddaki tercih: Bartlett χ², Rao F değil
Ardışık testler aynı \Lambda_i üzerinden Rao F yaklaşımıyla da hesaplanabilir; R CCA paketinin p.asym yardımcısı da F ya da farklı \chi^2 yaklaşımları sunar. MerQur Bartlett \chi^2'sini kullanır. \Lambda değerleri aynıdır; p değerleri büyük n'de birbirine çok yakın, küçük n'de farklıdır. Tam model (i=1) için Rao F'si "Çok değişkenli testler" kutusunda ayrıca verilir.
Anlamlılık yıldızı formdaki \alpha ile verilir (canonical_correlation.py:377–379); sabit 0,05 eşiği kullanılmaz.
41.5.8 Tam model çok değişkenli testleri
"Çok değişkenli testler" kutusu Y'nin X üzerine çok değişkenli regresyonu için dört testi kanonik korelasyonlardan kurar (_manova_tests, cca_panel.py:176–220):
- \lambda_i: \mathbf E^{-1}\mathbf H'nin özdeğeri; \mathbf H regresyonun, \mathbf E artıkların SSCP matrisi. Kanonik korelasyonla bağı: r_i^2=\lambda_i/(1+\lambda_i).
- Testlerde yanıt sayısı q (Y), hipotez sd'si \nu_H=p (X sayısı), hata sd'si \nu_E=n-p-1. Kod içinde adlar ters yazılmıştır (
p = len(ys),q = len(xs),cca_panel.py:248); sonuç doğrudur. - F yaklaşımları: Wilks için Rao, Pillai için standart, Hotelling–Lawley için McKeon (1974) (MANOVA paneliyle aynı), Roy için üst sınır. Formüller Bölüm 13.5.3'tedir.
Hotelling–Lawley F'sinde neden McKeon?
McKeon (1974) yaklaşımı Hotelling–Lawley izinin dağılımına, R summary.manova'nın kullandığı Pillai–Samson yaklaşımından (F=\frac{2(sn+1)U}{s^2(2m+s+1)}, sd \left(s(2m+s+1),\ 2(sn+1)\right)) daha iyi uyar (Rencher ve Christensen 2012). MerQur bütün MANOVA yollarında ve CCA'da aynı yaklaşımı kullanır; aynı nicelik için iki F tanımı iç tutarsızlık olurdu. Değer (U) iki tanımda aynıdır; F ve payda sd'si farklıdır. n=(\nu_E-q-1)/2\le0 olduğunda McKeon tanımsızdır ve Pillai–Samson'a geçilir (cca_panel.py:219–226).
41.5.9 Varsayım tanıları
Mardia (correlation.py:284–303), \mathbf z_t=(\mathbf x_t,\mathbf y_t) birleşik vektörü ve n paydalı kovaryans \mathbf S_n ile:
- P=p+q: birleşik boyut (bu veride 9; çarpıklık sd'si 165).
- n<20 ise çarpıklığa küçük örneklem düzeltmesi uygulanır (
correlation.py:296–298). - Bu tanım R
MVN::mvn(mvn_test = "mardia")ile aynıdır.psych::mardian-1 paydalı kovaryans kullanır; b_1 ve b_2'si (n/(n-1))^3 ve (n/(n-1))^2 çarpanı kadar farklıdır.
VIF, set başına: \mathrm{VIF}_j=\left[\mathbf R^{-1}\right]_{jj} (cca_panel.py:259–263; tersi pinv ile). VIF yüksekse standart katsayılar kararsızdır; yükler etkilenmez.
41.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Aşağıdaki ara değerler dogrulama/cca/elle_hesap.py ile, MerQur kodu çağrılmadan hesaplanmıştır. Bağımsız hesap SVD yerine kovaryans matrislerinden genelleştirilmiş özdeğer sorununu (\mathbf S_{xy}\mathbf S_{yy}^{-1}\mathbf S_{yx}\mathbf a=r^2\mathbf S_{xx}\mathbf a, scipy.linalg.eigh) çözer; çok değişkenli testler için \mathbf H ve \mathbf E doğrudan regresyondan kurulur.
Adım 1 — Korelasyon blokları. Set içi korelasyonlar X'te küçüktür (en büyük |r|=0{,}162, WBC–CRP); Y'de büyüktür:
Setler arası korelasyonların en büyükleri: AST–APACHE -0{,}753, AST–SOFA 0{,}718, WBC–SAPS 0{,}675, kreatinin–GCS 0{,}662, kreatinin–SOFA -0{,}626.
Adım 2 — Kanonik korelasyonlar. \mathbf M'nin tekil değerleri (eşdeğer olarak genelleştirilmiş özdeğerlerin karekökleri):
| CC1 | CC2 | CC3 | CC4 | |
|---|---|---|---|---|
| r_i | 0,970304 | 0,935717 | 0,770340 | 0,419817 |
| r_i^2 | 0,941491 | 0,875565 | 0,593424 | 0,176246 |
| 1-r_i^2 | 0,058509 | 0,124435 | 0,406576 | 0,823754 |
Adım 3 — Sıralı Bartlett testi. Çarpan n-1-(p+q+1)/2=150-1-5=144.
| i | \Lambda_i | \ln\Lambda_i | \chi^2_i | sd | p |
|---|---|---|---|---|---|
| 1 | 0,0024384 | −6,016410 | 866,3631 | 20 | 1{,}12\times10^{-170} |
| 2 | 0,0416755 | −3,177842 | 457,6093 | 12 | 2{,}29\times10^{-90} |
| 3 | 0,3349189 | −1,093867 | 157,5168 | 6 | 1{,}99\times10^{-31} |
| 4 | 0,8237539 | −0,193883 | 27,9192 | 2 | 8{,}66\times10^{-7} |
Dört kök de anlamlıdır. MerQur p'yi \chi^2'nin sağ kuyruk fonksiyonuyla (sf) hesaplar; çok küçük p'ler de sıfıra inmeden saklanır.
Adım 4 — Fisher-z GA. \SH_z=1/\sqrt{147}=0{,}082479, z_{0{,}975}=1{,}959964:
Diğer kökler için %95 GA: CC2 [0{,}912256;\ 0{,}953058], CC3 [0{,}696004;\ 0{,}828338], CC4 [0{,}278278;\ 0{,}543511].
Adım 5 — Standart katsayılar ve yapı yükleri (CC1).
| X | a_{j1}^{*} | \ell^{X}_{j1} | Y | b_{k1}^{*} | \ell^{Y}_{k1} |
|---|---|---|---|---|---|
| WBC | −0,055175 | −0,019967 | APACHE | −0,397259 | −0,878108 |
| CRP | −0,307995 | −0,241763 | SOFA | 0,569390 | 0,934511 |
| Kreatinin | −0,359847 | −0,427241 | SAPS | −0,139301 | −0,425620 |
| AST | 0,839672 | 0,849416 | GCS | −0,095167 | −0,628085 |
| Hb | −0,236519 | −0,242957 |
İşaret kuralı: X yüklerinde mutlak değerce en büyük AST'dir (0,849) ve pozitiftir; işaret çevrilmez. AST yükünün elle hesabı, \mathbf R_{xx}'in AST satırıyla \mathbf a_1^{*}'nin çarpımıdır:
X setinde değişkenler neredeyse ilişkisiz olduğu için (\mathbf R_{xx}\approx\mathbf I) yükler katsayılara çok yakındır. Y setinde ise SOFA–GCS korelasyonu yüzünden GCS'nin katsayısı küçük (−0,095), yükü büyüktür (−0,628): GCS, SOFA üzerinden kanonik değişkenle güçlü ilişkilidir.
Adım 6 — Ham katsayı ve skor. Kreatinin için a_{j1}=a^{*}_{j1}/s_j=-0{,}359847/0{,}269828=-1{,}333614. İlk hastanın skorları U_{11}=2{,}226914, V_{11}=1{,}894684; tüm hastalarda \operatorname{Var}(U_1)=1 ve \operatorname{kor}(U_1,V_1)=0{,}970304=r_1.
Adım 7 — Açıklanan varyans ve artıklık (CC1).
Dört kökte \operatorname{Red}(Y\mid X): 0,5225; 0,2979; 0,0438; 0,0054; toplam 0,8697. Laboratuvar seti, klinik skorların standartlaştırılmış varyansının yaklaşık %87'sini dört kanonik boyut üzerinden açıklar.
Adım 8 — Çapraz yükler. \operatorname{kor}(\text{AST},V_1)=r_1\ell^{X}_{\text{AST},1}=0{,}970304\times0{,}849416=0{,}824192; MerQur skorlardan doğrudan hesaplar ve aynı değeri bulur.
Adım 9 — Tam model testleri. \lambda_i=r_i^2/(1-r_i^2): 16,091269; 7,036354; 1,459562; 0,213955.
| Test | Değer | F | sd₁ | sd₂ | p |
|---|---|---|---|---|---|
| Pillai | V=\sum r_i^2=2{,}586726 | 52,712841 | 20 | 576 | 6{,}57\times10^{-116} |
| Wilks | \Lambda=0{,}002438 | 120,312341 | 20 | 468,594 | 3{,}76\times10^{-170} |
| Hotelling–Lawley | U=24{,}801140 | 173,513840 | 20 | 302,839 | 9{,}67\times10^{-153} |
| Roy | \Theta=16{,}091269 | 463,428534 | 5 | 144 | 7{,}50\times10^{-87} |
Wilks için s=\min(4{,}5)=4, t=\sqrt{(16\cdot25-4)/(16+25-5)}=\sqrt{11}=3{,}316625, payda sd'si \left(144-\frac{4-5+1}{2}\right)3{,}316625-\frac{20-2}{2}=468{,}594. Hotelling–Lawley için McKeon (1974): yanıt sayısı 5, hipotez sd'si 4, hata sd'si 145, n=(145-5-1)/2=69{,}5; b=\frac{(5+139)(4+139)}{2\cdot140\cdot68{,}5}=1{,}073618, payda sd'si 4+\frac{22}{b-1}=302{,}839, c=\frac{302{,}839-2}{139}=2{,}164306, F=\frac{U}{c}\cdot\frac{302{,}839}{20}=173{,}513840. Özdeğer oranları: 0,6488; 0,2837; 0,0589; 0,0086.
Adım 10 — Tanılar. Mardia: b_1=20{,}804918, \chi^2_{\text{çarp}}=150\times20{,}804918/6=520{,}1229 (sd 165, p=2{,}13\times10^{-38}); b_2=121{,}0707, z_{\text{bas}}=9{,}6050 (p=7{,}6\times10^{-22}). Çok değişkenli normallik reddedilir; skorların çoğu tam sayılı ve sınırlı aralıklı klinik ölçeklerdir. VIF: X setinde 1,01–1,05; Y setinde APACHE 2,43, SOFA 5,42, SAPS 2,23, GCS 4,56.
Şekil 41.1. Solda ilk kanonik değişken çifti: laboratuvar kanonik değişkeni U_1 ile klinik skor kanonik değişkeni V_1 (150 hasta). Sağda dört kanonik korelasyon; dördü de sıralı Bartlett testinde anlamlıdır.
41.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan alınmıştır; stats.canonical_correlation ad alanında round() yalnız bellekte etkisizleştirilmiştir (dogrulama/cca/merqur_calistir.py). R: 4.5.3, CCA::cc (kanonik r, ham katsayılar, yapı ve çapraz yükler; işaretler MerQur kuralına çevrildi), taban cancor (r, ek denetim), car::linearHypothesis (dört tam model testi; car'ın Pillai/Wilks/HL/Roy işlevleri, HL R tanımıyla), psych::mardia (n-1 paydalı değerler n paydasına çevrilerek; MVN::mvn sonucu 3 ondalıkta aynı: 520,123 ve 9,605). Bartlett \chi^2 ve Fisher-z GA'nın R karşılığı paket işlevi olmadığından R'de, R'nin kendi r değerlerinden formülle hesaplanmıştır. Ölçüt: en büyük fark \le10^{-6} (değer 1'den büyükse göreli).
Kanonik korelasyonlar, testler, GA ve artıklık:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| r_1 | 0,970304 | 0,970304 | 0,970304 | 2,2e−16 | ✓ |
| r_2 | 0,935717 | 0,935717 | 0,935717 | 6,7e−16 | ✓ |
| r_3 | 0,770340 | 0,770340 | 0,770340 | 1,4e−15 | ✓ |
| r_4 | 0,419817 | 0,419817 | 0,419817 | 1,7e−15 | ✓ |
| Wilks \Lambda_1 | 0,002438 | 0,002438 | 0,002438 | 3,2e−17 | ✓ |
| Bartlett \chi^2_1 | 866,363061 | 866,363061 | 866,363061 | 1,8e−12 | ✓ |
| p_1 | 1,1246·10−170 | 1,1246·10−170 | 1,1246·10−170 | 1,0e−182 | ✓ |
| Wilks \Lambda_2 | 0,041675 | 0,041675 | 0,041675 | 2,4e−16 | ✓ |
| Bartlett \chi^2_2 | 457,609310 | 457,609310 | 457,609310 | 8,5e−13 | ✓ |
| p_2 | 2,2861·10−90 | 2,2861·10−90 | 2,2861·10−90 | 9,8e−103 | ✓ |
| Wilks \Lambda_3 | 0,334919 | 0,334919 | 0,334919 | 2,1e−15 | ✓ |
| Bartlett \chi^2_3 | 157,516831 | 157,516831 | 157,516831 | 8,0e−13 | ✓ |
| p_3 | 1,9872·10−31 | 1,9872·10−31 | 1,9872·10−31 | 6,6e−44 | ✓ |
| Wilks \Lambda_4 | 0,823754 | 0,823754 | 0,823754 | 1,0e−15 | ✓ |
| Bartlett \chi^2_4 | 27,919211 | 27,919211 | 27,919211 | 2,4e−13 | ✓ |
| p_4 | 8,6581·10−7 | 8,6581·10−7 | 8,6581·10−7 | 8,4e−20 | ✓ |
| GA alt, r_1 | 0,959201 | 0,959201 | 0,959201 | 7,8e−16 | ✓ |
| GA üst, r_1 | 0,978419 | 0,978419 | 0,978419 | 2,2e−16 | ✓ |
| GA alt, r_2 | 0,912256 | 0,912256 | 0,912256 | 1,0e−15 | ✓ |
| GA üst, r_2 | 0,953058 | 0,953058 | 0,953058 | 2,2e−16 | ✓ |
| GA alt, r_3 | 0,696004 | 0,696004 | 0,696004 | 1,2e−15 | ✓ |
| GA üst, r_3 | 0,828338 | 0,828338 | 0,828338 | 1,0e−15 | ✓ |
| GA alt, r_4 | 0,278278 | 0,278278 | 0,278278 | 1,9e−15 | ✓ |
| GA üst, r_4 | 0,543511 | 0,543511 | 0,543511 | 1,1e−15 | ✓ |
| Var(X), CC1 | 0,204384 | 0,204384 | 0,204384 | 4,4e−16 | ✓ |
| Var(Y), CC1 | 0,555007 | 0,555007 | 0,555007 | 1,2e−15 | ✓ |
| Red(X | Y), CC1 | 0,192425 | 0,192425 | 0,192425 | 5,0e−16 |
| Red(Y | X), CC1 | 0,522534 | 0,522534 | 0,522534 | 1,2e−15 |
| Var(X), CC2 | 0,196081 | 0,196081 | 0,196081 | 1,7e−16 | ✓ |
| Var(Y), CC2 | 0,340241 | 0,340241 | 0,340241 | 1,1e−15 | ✓ |
| Red(X | Y), CC2 | 0,171682 | 0,171682 | 0,171682 | 4,2e−16 |
| Red(Y | X), CC2 | 0,297903 | 0,297903 | 0,297903 | 8,3e−16 |
| Var(X), CC3 | 0,201742 | 0,201742 | 0,201742 | 8,3e−17 | ✓ |
| Var(Y), CC3 | 0,073875 | 0,073875 | 0,073875 | 1,8e−16 | ✓ |
| Red(X | Y), CC3 | 0,119719 | 0,119719 | 0,119719 | 4,7e−16 |
| Red(Y | X), CC3 | 0,043839 | 0,043839 | 0,043839 | 1,9e−16 |
| Var(X), CC4 | 0,187539 | 0,187539 | 0,187539 | 3,9e−16 | ✓ |
| Var(Y), CC4 | 0,030877 | 0,030877 | 0,030877 | 9,4e−17 | ✓ |
| Red(X | Y), CC4 | 0,033053 | 0,033053 | 0,033053 | 3,3e−16 |
| Red(Y | X), CC4 | 0,005442 | 0,005442 | 0,005442 | 5,8e−17 |
Katsayılar ve yükler (CC1–CC2; CC3–CC4 de eşleşir, tabloyu kısaltmak için gösterilmedi):
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Std. katsayı WBC, CC1 | −0,055175 | −0,055175 | −0,055175 | 7,3e−15 | ✓ |
| Std. katsayı CRP, CC1 | −0,307995 | −0,307995 | −0,307995 | 1,7e−15 | ✓ |
| Std. katsayı kreatinin, CC1 | −0,359847 | −0,359847 | −0,359847 | 7,6e−15 | ✓ |
| Std. katsayı AST, CC1 | 0,839672 | 0,839672 | 0,839672 | 2,0e−15 | ✓ |
| Std. katsayı Hb, CC1 | −0,236519 | −0,236519 | −0,236519 | 3,9e−15 | ✓ |
| Std. katsayı APACHE, CC1 | −0,397259 | −0,397259 | −0,397259 | 2,8e−15 | ✓ |
| Std. katsayı SOFA, CC1 | 0,569390 | 0,569390 | 0,569390 | 2,9e−15 | ✓ |
| Std. katsayı SAPS, CC1 | −0,139301 | −0,139301 | −0,139301 | 7,7e−15 | ✓ |
| Std. katsayı GCS, CC1 | −0,095167 | −0,095167 | −0,095167 | 4,8e−15 | ✓ |
| Std. katsayı WBC, CC2 | 0,761077 | 0,761077 | 0,761077 | 1,6e−15 | ✓ |
| Std. katsayı CRP, CC2 | 0,149238 | 0,149238 | 0,149238 | 1,6e−15 | ✓ |
| Std. katsayı kreatinin, CC2 | −0,550361 | −0,550361 | −0,550361 | 5,0e−15 | ✓ |
| Std. katsayı AST, CC2 | −0,103587 | −0,103587 | −0,103587 | 9,4e−15 | ✓ |
| Std. katsayı Hb, CC2 | 0,394602 | 0,394602 | 0,394602 | 1,9e−15 | ✓ |
| Std. katsayı APACHE, CC2 | 0,007305 | 0,007305 | 0,007305 | 1,8e−15 | ✓ |
| Std. katsayı SOFA, CC2 | −0,089614 | −0,089614 | −0,089614 | 7,0e−15 | ✓ |
| Std. katsayı SAPS, CC2 | 0,679024 | 0,679024 | 0,679024 | 3,6e−15 | ✓ |
| Std. katsayı GCS, CC2 | −0,603686 | −0,603686 | −0,603686 | 3,1e−15 | ✓ |
| Ham katsayı WBC, CC1 | −0,030261 | −0,030261 | −0,030261 | 4,0e−15 | ✓ |
| Ham katsayı CRP, CC1 | −0,197101 | −0,197101 | −0,197101 | 1,1e−15 | ✓ |
| Ham katsayı kreatinin, CC1 | −1,333618 | −1,333618 | −1,333618 | 3,2e−14 | ✓ |
| Ham katsayı AST, CC1 | 0,067344 | 0,067344 | 0,067344 | 2,2e−16 | ✓ |
| Ham katsayı Hb, CC1 | −0,114134 | −0,114134 | −0,114134 | 1,8e−15 | ✓ |
| Yapı yükü WBC, CC1 | −0,019967 | −0,019967 | −0,019967 | 7,5e−15 | ✓ |
| Yapı yükü CRP, CC1 | −0,241763 | −0,241763 | −0,241763 | 6,7e−16 | ✓ |
| Yapı yükü kreatinin, CC1 | −0,427241 | −0,427241 | −0,427241 | 7,8e−15 | ✓ |
| Yapı yükü AST, CC1 | 0,849416 | 0,849416 | 0,849416 | 1,8e−15 | ✓ |
| Yapı yükü Hb, CC1 | −0,242957 | −0,242957 | −0,242957 | 2,5e−15 | ✓ |
| Yapı yükü APACHE, CC1 | −0,878108 | −0,878108 | −0,878108 | 2,8e−15 | ✓ |
| Yapı yükü SOFA, CC1 | 0,934511 | 0,934511 | 0,934511 | 3,2e−15 | ✓ |
| Yapı yükü SAPS, CC1 | −0,425620 | −0,425620 | −0,425620 | 9,5e−15 | ✓ |
| Yapı yükü GCS, CC1 | −0,628085 | −0,628085 | −0,628085 | 8,5e−15 | ✓ |
| Yapı yükü WBC, CC2 | 0,749670 | 0,749670 | 0,749670 | 1,9e−15 | ✓ |
| Yapı yükü CRP, CC2 | −0,058642 | −0,058642 | −0,058642 | 1,1e−15 | ✓ |
| Yapı yükü kreatinin, CC2 | −0,552547 | −0,552547 | −0,552547 | 5,1e−15 | ✓ |
| Yapı yükü AST, CC2 | −0,122374 | −0,122374 | −0,122374 | 9,5e−15 | ✓ |
| Yapı yükü Hb, CC2 | 0,307699 | 0,307699 | 0,307699 | 1,7e−15 | ✓ |
| Yapı yükü APACHE, CC2 | 0,208632 | 0,208632 | 0,208632 | 8,3e−15 | ✓ |
| Yapı yükü SOFA, CC2 | 0,237241 | 0,237241 | 0,237241 | 1,1e−14 | ✓ |
| Yapı yükü SAPS, CC2 | 0,864464 | 0,864464 | 0,864464 | 4,8e−15 | ✓ |
| Yapı yükü GCS, CC2 | −0,716836 | −0,716836 | −0,716836 | 8,1e−15 | ✓ |
| Çapraz yük WBC × V_1 | −0,019374 | −0,019374 | −0,019374 | 7,0e−15 | ✓ |
| Çapraz yük CRP × V_1 | −0,234583 | −0,234583 | −0,234583 | 5,6e−17 | ✓ |
| Çapraz yük kreatinin × V_1 | −0,414554 | −0,414554 | −0,414554 | 6,8e−15 | ✓ |
| Çapraz yük AST × V_1 | 0,824192 | 0,824192 | 0,824192 | 2,2e−15 | ✓ |
| Çapraz yük Hb × V_1 | −0,235743 | −0,235743 | −0,235743 | 3,5e−15 | ✓ |
| Çapraz yük APACHE × U_1 | −0,852032 | −0,852032 | −0,852032 | 1,6e−15 | ✓ |
| Çapraz yük SOFA × U_1 | 0,906760 | 0,906760 | 0,906760 | 2,1e−15 | ✓ |
| Çapraz yük SAPS × U_1 | −0,412981 | −0,412981 | −0,412981 | 8,7e−15 | ✓ |
| Çapraz yük GCS × U_1 | −0,609434 | −0,609434 | −0,609434 | 7,5e−15 | ✓ |
Ek çıktılar:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Özdeğer \lambda_1 | 16,091269 | 16,091269 | 16,091269 | 1,6e−13 | ✓ |
| Özdeğer oranı 1 | 0,648812 | 0,648812 | 0,648812 | 2,9e−15 | ✓ |
| Özdeğer \lambda_2 | 7,036354 | 7,036354 | 7,036354 | 6,0e−14 | ✓ |
| Özdeğer oranı 2 | 0,283711 | 0,283711 | 0,283711 | 2,8e−15 | ✓ |
| Özdeğer \lambda_3 | 1,459562 | 1,459562 | 1,459562 | 6,4e−15 | ✓ |
| Özdeğer oranı 3 | 0,058851 | 0,058851 | 0,058851 | 3,0e−16 | ✓ |
| Özdeğer \lambda_4 | 0,213955 | 0,213955 | 0,213955 | 1,5e−15 | ✓ |
| Özdeğer oranı 4 | 0,008627 | 0,008627 | 0,008627 | 8,7e−18 | ✓ |
| Değer (Pillai) | 2,586726 | 2,586726 | 2,586726 | 4,4e−15 | ✓ |
| F (Pillai) | 52,712841 | 52,712841 | 52,712841 | 2,3e−13 | ✓ |
| sd payda (Pillai) | 576 | 576 | 576 | 0,0e+00 | ✓ |
| p (Pillai) | 6,5688·10−116 | 6,5688·10−116 | 6,5688·10−116 | 5,2e−128 | ✓ |
| Değer (Wilks) | 0,002438 | 0,002438 | 0,002438 | 4,1e−17 | ✓ |
| F (Wilks) | 120,312341 | 120,312341 | 120,312341 | 7,1e−13 | ✓ |
| sd payda (Wilks) | 468,593970 | 468,593970 | 468,593970 | 4,5e−13 | ✓ |
| p (Wilks) | 3,7588·10−170 | 3,7588·10−170 | 3,7588·10−170 | 4,5e−182 | ✓ |
| Değer (Hotelling–Lawley) | 24,801140 | 24,801140 | 24,801140 | 1,8e−13 | ✓ |
| F (Hotelling–Lawley) | 173,513840 | 173,513840 | 173,513840 | 1,4e−12 | ✓ |
| sd payda (Hotelling–Lawley) | 302,838527 | 302,838527 | 302,838527 | 4,0e−13 | ✓ |
| p (Hotelling–Lawley) | 9,6695·10−153 | 9,6695·10−153 | 9,6695·10−153 | 1,2e−164 | ✓ |
| Değer (Roy) | 16,091269 | 16,091269 | 16,091269 | 2,6e−13 | ✓ |
| F (Roy) | 463,428534 | 463,428534 | 463,428534 | 8,6e−12 | ✓ |
| sd payda (Roy) | 144 | 144 | 144 | 0,0e+00 | ✓ |
| p (Roy) | 7,5006·10−87 | 7,5006·10−87 | 7,5006·10−87 | 9,0e−99 | ✓ |
| Mardia çarpıklık \chi^2 | 520,122941 | 520,122941 | 520,122941 | 8,3e−12 | ✓ |
| Mardia basıklık z | 9,605024 | 9,605024 | 9,605024 | 4,2e−13 | ✓ |
| VIF WBC (X) | 1,036446 | 1,036446 | 1,036446 | 3,3e−15 | ✓ |
| VIF CRP (X) | 1,051196 | 1,051196 | 1,051196 | 6,7e−16 | ✓ |
| VIF kreatinin (X) | 1,011375 | 1,011375 | 1,011375 | 2,4e−15 | ✓ |
| VIF AST (X) | 1,008669 | 1,008669 | 1,008669 | 4,4e−16 | ✓ |
| VIF Hb (X) | 1,025628 | 1,025628 | 1,025628 | 2,0e−15 | ✓ |
| VIF APACHE (Y) | 2,434218 | 2,434218 | 2,434218 | 1,8e−15 | ✓ |
| VIF SOFA (Y) | 5,416056 | 5,416056 | 5,416056 | 4,4e−15 | ✓ |
| VIF SAPS (Y) | 2,231139 | 2,231139 | 2,231139 | 4,4e−15 | ✓ |
| VIF GCS (Y) | 4,561820 | 4,561820 | 4,561820 | 3,6e−15 | ✓ |
Sonuç: 125 büyüklüğün tamamı ölçütü karşılar. İlk üç sıralı p çok küçüktür (10^{-31}–10^{-170}); MerQur bunları sağ kuyruk olasılığıyla tam hesaplar, gösterimde "p < .001" yazılır.
41.7 Çıktıyı okuma
Ek çıktılar açık çalıştırmanın sonuç metni (kısaltılmış):
Kanonik Korelasyon (CCA)
  N (gözlem)   : 150
  X seti (5): WBC_K_uL, CRP_mg_L, creatinine_mg_dL, AST_U_L, Hb_g_dL
  Y seti (4): APACHE_score, SOFA_score, SAPS_score, GCS
  Bileşen sayısı: 4

Kanonik korelasyonlar (Bartlett sıralı testi):
  CC1: r = 0.9703, %95 GA [0.959, 0.978], r² = 0.9415, Λ = 0.0024, χ²(20) = 866.36, p < .001 *
  CC2: r = 0.9357, %95 GA [0.912, 0.953], r² = 0.8756, Λ = 0.0417, χ²(12) = 457.61, p < .001 *
  CC3: r = 0.7703, %95 GA [0.696, 0.828], r² = 0.5934, Λ = 0.3349, χ²(6) = 157.52, p < .001 *
  CC4: r = 0.4198, %95 GA [0.278, 0.544], r² = 0.1762, Λ = 0.8238, χ²(2) = 27.92, p < .001 *
  Kanonik r güven aralığı yaklaşıktır (Fisher z; [0, 1]'e kırpıldı).

Açıklanan varyans ve artıklık indeksi (%):
  CC1: Var(X) = %20.44, Var(Y) = %55.50, Red(X|Y) = %19.24, Red(Y|X) = %52.25
  CC2: Var(X) = %19.61, Var(Y) = %34.02, Red(X|Y) = %17.17, Red(Y|X) = %29.79
  ...
── APA 7 ÖZET ──
CC1: r = .97, Wilks' Λ = 0.002, χ²(20, N = 150) = 866.36, p < .001
── Kanonik katsayılar (ağırlıklar) ──
Standartlaştırılmış kanonik katsayılar — X seti
                                   CC1         CC2         CC3         CC4
  AST_U_L                       0.8397     -0.1036     -0.0517      0.5336
  ...
── Çok değişkenli testler (tam model) ──
                         Değer         F     df1      df2         p
  Pillai                2.5867    52.713      20   576.00   <0.0001
  Wilks                 0.0024   120.312      20   468.59   <0.0001
  Hotelling-Lawley     24.8011   173.514      20   302.84   <0.0001
  Roy                  16.0913   463.429       5   144.00   <0.0001
── Varsayım tanıları ──
  Mardia: çarpıklık χ² = 520.123 (df = 165), p < 0.0001; basıklık z = 9.605, p < 0.0001
  VIF (Y): APACHE_score: 2.43, SOFA_score: 5.42, SAPS_score: 2.23, GCS: 4.56
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
Künye (N, setler, bileşen sayısı) |
Liste bazında silmeden sonra kalan n | Beklenenden küçükse eksik değerli satırlar vardır. |
CCk: r = … |
r_i, Fisher-z GA, r_i^2, \Lambda_i, Bartlett \chi^2_i, sd, p, yıldız | \Lambda_i ve p i'den sonraki tüm kökleri birlikte sınar. Yıldız p<\alpha demektir. |
| GA notu | Fisher-z'nin yaklaşık olduğu | Kanonik r için GA yayın tablosunda raporlanacaksa "yaklaşık" diye nitelenmelidir. |
Var(X), Var(Y) |
Kendi kanonik değişkeninin setinden açıkladığı pay | CC1 Y setinin %55,5'ini taşır; X setinde her bileşen yaklaşık %20 taşır (X değişkenleri birbirinden bağımsız). |
Red(X|Y), Red(Y|X) |
Artıklık indeksi | Hangi setin diğerini daha çok açıkladığını gösterir; asimetrik okunur. |
| APA satırı | Yalnız CC1 | Diğer anlamlı kökler rapora elle eklenmelidir. |
| Kanonik katsayılar | Standart ve ham | İşaret bileşen içinde keyfidir; yorum için Frekans sekmesindeki yapı yükleri kullanılır. |
| Çok değişkenli testler | Dört test, tam model | \Lambda burada sıralı tablodaki \Lambda_1 ile aynıdır; F yaklaşımı ise farklıdır. Roy F'si üst sınırdır. |
| Varsayım tanıları | Mardia ve VIF | Mardia anlamlıysa \chi^2/F p'leri yaklaşık okunmalıdır; VIF > 10 ise katsayılar kararsızdır. |
| Uyarı (varsa) | ⚠ Küçük örneklem (n = … < 30) |
canonical_correlation.py:139–140, 378–379. |
Tablo sekmesi bileşen başına özeti (r, GA, r^2, Λ, χ², sd, p, Var, Red), Frekans sekmesi X ve Y yapı yüklerini ve dört katsayı tablosunu verir (cca_panel.py:364–384).
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Beş laboratuvar ölçümü (WBC, CRP, kreatinin, AST, Hb) ile dört yoğun bakım skoru (APACHE II, SOFA, SAPS, GCS) arasındaki ilişki kanonik korelasyon analiziyle incelendi (N = 150). Dört kanonik korelasyonun dördü de sıralı Bartlett testinde anlamlıydı; ilk kanonik korelasyon r_1 = 0{,}97 (Wilks \Lambda = 0{,}002, \chi^2(20, N = 150) = 866{,}36, p < 0{,}001), ikincisi r_2 = 0{,}94 (\Lambda = 0{,}042, \chi^2(12) = 457{,}61, p < 0{,}001) idi. Birinci boyutu laboratuvar tarafında AST (yapı yükü 0,85) ve kreatinin (−0,43), skor tarafında SOFA (0,93), APACHE (−0,88) ve GCS (−0,63) tanımladı. Laboratuvar seti, ilk iki kanonik boyut üzerinden klinik skorların standartlaştırılmış varyansının %82'sini açıkladı (artıklık indeksi 0,52 ve 0,30).
41.8 Uzman soruları
S1. Kanonik korelasyonlar neden SVD ile, sklearn CCA ile değil?
sklearn CCA PLS ailesinden yinelemeli bir NIPALS algoritmasıdır; yakınsama ölçütüne bağlıdır ve birbirine yakın kanonik korelasyonlarda ağırlıkları kararlı bulamaz. Kapalı biçim (beyazlatma + SVD) tam çözümdür ve R ile aynı sayıyı verir (canonical_correlation.py:152–175). Bu veride MerQur ile R CCA::cc arasındaki en büyük fark 10^{-14} düzeyindedir.
S2. Bileşen sayısını 2 seçtim; Wilks Λ₁ neden dört kökü de içeriyor?
Çünkü tanım budur: \Lambda_1=\prod_{j=1}^{K}(1-r_j^2), "setler arasında hiçbir doğrusal ilişki yok" hipotezidir. Bileşen sayısı yalnız gösterilen satırları, katsayı ve yük tablolarını sınırlar. \Lambda yalnız gösterilen köklerle hesaplansaydı kalan köklerin katkısı yok sayılır ve test gereksiz yere tutucu olurdu. Özdeğer oranlarının paydası da tüm köklerdir (cca_panel.py:242–253).
S3. Ardışık Bartlett testi Rao F testiyle aynı mı?
\Lambda_i değerleri aynıdır; dönüşüm farklıdır. Bazı yazılımlar her \Lambda_i için Rao F yaklaşımını raporlar; MerQur Bartlett \chi^2'sini. İki yaklaşım büyük n'de aynı kararı verir; küçük n'de (ör. n=20, p+q=8) p değerleri birbirinden belirgin ayrılabilir ve Rao F genellikle daha doğrudur. Tam model (i=1) için Rao F "Çok değişkenli testler" kutusundadır (bu veride F(20,\ 468{,}59)=120{,}31).
S4. Kanonik r için verilen Fisher-z aralığı güvenilir mi?
Kabaca. Fisher dönüşümü sabit iki değişken arasındaki Pearson r için türetilmiştir; kanonik r ise p+q ağırlık üzerinden veriye göre seçilmiş en büyük korelasyondur ve yukarı yanlıdır. Bu yüzden aralığın merkezi de iyimserdir. Kod bunu not eder. Daha savunulabilir seçenekler bootstrap (MerQur'da bu analiz için yok) ya da yanlılığı düzeltilmiş r olabilir. Küçük r'de alt sınır 0'a kırpılır.
S5. Bir kanonik korelasyon tam 1 çıkarsa ne olur?
Bu, bir Y değişkeninin X'lerin tam doğrusal bileşimi olduğu durumdur (ör. bir skor diğer ölçümlerden türetilmişse). Kod tekil değeri 1'e kırpar ve \Lambda_1=0 olur; \chi^2=-c\ln\Lambda sonsuzdur ve test anlamını yitirir. MerQur bu kökü kapsayan sıralı Wilks testlerini ve tam model testlerini tanımsız sayar (\chi^2, F ve p "—") ve tam kanonik korelasyonu bildiren bir uyarı yazar (canonical_correlation.py:231–245). R CCP::p.asym aynı durumda Rao F=\infty, p=0 verir. Böyle bir veride türetilmiş değişken setten çıkarılmalıdır.
S6. Neden yapı yüklerinin işareti hep "en büyük X yükü pozitif"?
SVD'nin işaretleri LAPACK sürümüne ve platforma göre değişebilir; aynı veride iki makinede ters işaretli tablo görmek kullanıcıyı şaşırtır. MerQur her çiftte en büyük mutlak X yapı yükünü pozitife çevirir (canonical_correlation.py:179–184). Bu bir gösterim kuralıdır; r, \Lambda, artıklık ve testler işaretten bağımsızdır. R ile karşılaştırırken bütün bir sütunun işareti ters görünebilir; bu hata değildir.
S7. Hotelling–Lawley F'si R `summary.manova` ile neden aynı değil?
MerQur, MANOVA panelinde olduğu gibi McKeon (1974) yaklaşımını kullanır; R summary.manova Pillai–Samson yaklaşımını kullanır. Değer U=\sum\lambda_i aynıdır; payda sd'si ve F farklıdır. Bu veride McKeon F(20;\ 302{,}84)=173{,}51, Pillai–Samson F(20;\ 558)=172{,}99'dur. Raporda hangi yaklaşımın kullanıldığı yazılmalıdır.
S8. n = 20 ile çalıştırabilir miyim?
Evet. Yalnız n<p+q+1 hata verir, n<30 uyarıdır (canonical_correlation.py:131–140). Ancak küçük n'de kanonik korelasyonlar belirgin biçimde yukarı yanlıdır (rastgele veride bile r_1 yüksek çıkar), Bartlett \chi^2 yaklaşımı zayıflar ve yükler kararsızdır. Analizin kendi açıklama metni ideal olarak n\ge5\max(p,q) önerir (cca_panel.py:43–45); yükleri yorumlamak için bundan da büyük örneklem gerekir.
S9. Mardia neden X ∪ Y için, setler ayrı ayrı değil?
Sıralı test ve tam model testlerinin dağılımsal varsayımı birleşik vektörün çok değişkenli normalliğidir; setlerin ayrı ayrı normal olması bunu garanti etmez. Bu veride Mardia iki bileşende de reddeder. Kestirimler (r, yükler) normallik gerektirmez; etkilenen yalnız p değerleridir ve bu veride p'ler eşiğin çok altında olduğu için karar değişmez.
41.9 Sık hatalar ve tuzaklar
- Standart katsayıları yük gibi okumak. Set içinde korelasyon yüksekse katsayılar işaret değiştirebilir ve 1'i aşabilir (bu veride CC4'te SOFA −2,08). Yorum için yapı yükleri kullanılır.
- r_1'i "setler arası açıklanan varyans" sanmak. r_1^2 iki kanonik değişkenin ortak varyansıdır. Gözlenen değişkenler için artıklık indeksine bakılır; bu veride r_1^2=0{,}94 iken \operatorname{Red}(X\mid Y)_1=0{,}19'dur.
- Sıralı testleri tek tek yorumlamak. \Lambda_2, "yalnız ikinci kök anlamlı mı" değil, "ikinci ve sonraki kökler birlikte sıfır mı" sorusunu sınar.
- Tam doğrusal türetilmiş değişken. Bir Y skoru X'lerden hesaplanmışsa r=1 çıkar ve testler tanımsızdır (41.8 S5); türetilmiş değişken setten çıkarılmalıdır.
- "<0.0001" p'yi sıfır sanmak. Gösterim sınırıdır; p sağ kuyruk fonksiyonuyla hesaplandığı için sıfır değildir.
- Bileşen sayısını düşürerek testi değiştirmeye çalışmak. Testler değişmez; yalnız gösterim kısalır.
- İşaret farkını hata sanmak. R çıktısıyla karşılaştırırken bir sütunun bütünüyle ters işaretli olması normaldir (41.5.3).
- CCA'yı kestirim modeli olarak kullanmak. Kanonik katsayılar örneklemde ilişkiyi en büyükler; yeni veride kestirim için çapraz doğrulama yapılmadan kullanılmamalıdır.
- Grafik renginin anlamı. Çubuk grafikte mor, sıralı Wilks p<\alpha demektir; tam model testine göre değildir.
41.10 Kaynaklar
- Bartlett, M. S. (1941). The statistical significance of canonical correlations. Biometrika, 32(1), 29–37. https://doi.org/10.1093/biomet/32.1.29
- Fisher, R. A. (1915). Frequency distribution of the values of the correlation coefficient in samples from an indefinitely large population. Biometrika, 10(4), 507–521. https://doi.org/10.2307/2331838
- González, I., Déjean, S., Martin, P. G. P., & Baccini, A. (2008). CCA: An R package to extend canonical correlation analysis. Journal of Statistical Software, 23(12), 1–14. https://doi.org/10.18637/jss.v023.i12
- Hotelling, H. (1936). Relations between two sets of variates. Biometrika, 28(3–4), 321–377. https://doi.org/10.1093/biomet/28.3-4.321
- Mardia, K. V. (1970). Measures of multivariate skewness and kurtosis with applications. Biometrika, 57(3), 519–530. https://doi.org/10.1093/biomet/57.3.519
- McKeon, J. J. (1974). F approximations to the distribution of Hotelling's T_0^2. Biometrika, 61(2), 381–383. https://doi.org/10.1093/biomet/61.2.381
- Rencher, A. C., & Christensen, W. F. (2012). Methods of multivariate analysis (3rd ed.). Wiley.
- Sherry, A., & Henson, R. K. (2005). Conducting and interpreting canonical correlation analysis in personality research: A user-friendly primer. Journal of Personality Assessment, 84(1), 37–48. https://doi.org/10.1207/s15327752jpa8401_09
- Stewart, D., & Love, W. (1968). A general canonical correlation index. Psychological Bulletin, 70(3, Pt. 1), 160–163. https://doi.org/10.1037/h0026143