71. Yapay Sinir Ağı (MLP)
Analiz kimliği: mlp_network · Menü adı: Yapay Sinir Ağı (MLP) · Panel: gui/panels/analyses/mlp_network.py (form 50–95, read_options 109–125, execute 128–135, metin 147–237) · Motor: ml/classification.py, Classification.mlp (satır 758–911), ortak hat _run_sklearn_model (1089–1687), çoklu başlangıç _NnetMultiStart (366–406); varsayılan "nnet" motoru ml/nnet_mlp.py (amaç 62–94, BFGS 111–183, sınıflar 203–271); öteki motorlar scikit-learn MLPClassifier/MLPRegressor
71.1 Ne işe yarar
Yapay sinir ağı (çok katmanlı algılayıcı, MLP), girdileri bir ya da daha çok "gizli katmandan" geçirip doğrusal olmayan bir tahmin fonksiyonu kurar. Cevapladığı soru: "Bu özelliklerden hedefi (sınıf ya da sürekli değer) ne kadar iyi tahmin edebilirim?" MerQur'un varsayılan motoru, R nnet paketiyle aynı modeli kurar: tek gizli katman, lojistik gizli birimler, ağırlık azaltma (weight decay) cezası ve BFGS eniyilemesi.
- \mathbf x=(x_1,\dots,x_p): eğitim kümesine göre z'lenmiş girdiler.
- H: gizli birim sayısı ("Gizli katmanlar"; varsayılan 5).
- w_{j0}, w_{jk}: j. gizli birimin yanlılığı ve girdi ağırlıkları.
- \sigma(z)=1/(1+e^{-z}): lojistik etkinleştirme.
- v_0, v_j: çıktı biriminin yanlılığı ve gizli birim ağırlıkları.
- g: çıktı fonksiyonu; regresyonda özdeşlik, ikili sınıflamada lojistik, K>2 sınıfta softmax.
Model bir hipotez testi değildir. Ağırlıklar tek tek yorumlanmaz; aynı veriye farklı başlangıçlardan farklı ağırlıklar uyar (71.5.5). Değerlendirme ölçüsü ayrılmış test kümesi ve CV başarımıdır.
Ne zaman kullanılır?
- İlişki doğrusal değil, etkileşimler önceden bilinmiyor ve amaç tahminse.
- Gözlem sayısı ağırlık sayısından açıkça fazlaysa (Tıp örneğinde 608 eğitim gözlemi, 41 ağırlık).
- Girdiler sayısal ya da az düzeyli kategorikse.
Ne zaman kullanılmaz?
- Etkilerin büyüklüğü ve anlamlılığı gerekiyorsa: Çoklu Doğrusal Regresyon, İkili Lojistik Regresyon.
- Örneklem küçükse (yüz civarı ya da daha az): ağ kolayca aşırı uyar. Ridge Regresyon, Lasso Regresyon ya da Random Forest daha kararlıdır.
- Hangi değişkenin önemli olduğu asıl soruysa: Random Forest önem tablosu ya da bu panelde permütasyon önemi.
- Tablo biçimli, karışık türlü verilerde en yüksek başarım aranıyorsa çoğu zaman Gradient Boosting daha iyidir.
Sık karıştırılan analizler. Gizli birimi olmayan bir ağ (H=0) doğrusal ya da lojistik regresyondur; MerQur'da H\ge1 zorunludur. Gizli katman eklemek, lojistik regresyonun "doğrusal yordayıcısını" esnek bir fonksiyonla değiştirmek demektir. "Gizli katmanlar" alanına "10,5" yazılırsa iki katmanlı ağ kurulur; bu yalnız Adam, SGD ve L-BFGS motorlarında mümkündür (71.5.6).
71.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Hedef türü | Sınıflamada kategorik, regresyonda sürekli. | "Görev" seçimi; regresyonda sayıya çevrilemeyen hedef hata verir (classification.py:1220–1224). |
| Sayısal ve ölçekli girdiler | Gradyan ve başlangıç ağırlıkları ölçeğe duyarlıdır. | Otomatik z ölçekleme (1/n bölenli SS), yalnız eğitime uydurulur. Regresyonda hedef de z'lenir. |
| Yeterli örneklem | Gözlem sayısı ağırlık sayısından büyük olmalı. | Denetlenmez; çıktı ağırlık sayısını yazar. |
| Bağımsız gözlemler | Test ve CV başarımının geçerliliği için. | Denetlenmez; tekrarlı ölçümde "Kat (grup) sütunu". |
| Yakınsama | Eniyileme bir yerel en küçüğe ulaşmalı. | "yakınsadı: evet/hayır" satırı ve uyarı. |
Eksik değer. SVM ile aynıdır (Bölüm 68.2): hedefi eksik satırlar, sonra özelliği eksik satırlar liste bazında atılır.
Uç durumlar (koddan):
- "Gizli katmanlar" pozitif tamsayılar değilse durur (
mlp_network.py:98–106). - nnet motoruna birden çok gizli katman verilirse durur: "Tek gizli katmanlı BFGS motoru yalnız bir gizli katmanı destekler" (
classification.py:792–793). - Tek sınıflı hedef, 1 gözlemli sınıf, sınıf sayısından küçük test kümesi ve kat sayısından küçük sınıflar SVM'deki gibi durdurur (Bölüm 68.2).
- "Test oranı" 0 seçilebilir ("Yok (tüm veri)"): model tüm veride kurulur, ölçüler eğitim verisindedir ve iyimserdir (
classification.py:1196–1200). - nnet motorunda gizli birim girdisi \lvert z\rvert>15 ise birim 0 ya da 1'e doyurulur ve türevi 0 olur (
nnet_mlp.py:43–48). - En çok yinelemeye ulaşılırsa "UYARI: en çok yinelemeye ulaşıldı, yakınsama sağlanamadı" yazılır; sonuç yine verilir.
71.3 Parametreler
Varsayılanlar mlp_network.py:50–125 ve _ml_options.py:179–271'den alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Hedef sınıf (Y) / Özellikler (X) | — | Hedef ve girdiler. | Kategorik X, k-1 göstergeye çevrilir. |
| Görev | Sınıflandırma | Sınıflandırma ya da regresyon. | Çıktı fonksiyonu ve amaç (71.5.2). |
| Motor / çözücü | Tek gizli katmanlı ağ (BFGS) | nnet eşdeğeri; ya da sklearn Adam, SGD, L-BFGS. | Amaç fonksiyonu, ceza tanımı ve eniyileme yolu farklıdır (71.5.6). |
| Gizli katmanlar (birim sayıları) | 5 | Virgülle katmanlar: "10,5". | Ağırlık sayısı H(p+1)+K(H+1). |
| Etkinleştirme | ReLU | relu, lojistik, tanh, doğrusal. | nnet motoru her zaman lojistik kullanır; seçim yalnız sklearn motorlarına uygulanır. |
| Düzenlileştirme (L2: ağırlık azaltma / alpha) | 0,01 | nnet'te \lambda; sklearn'de alpha. | Büyük değer ağırlıkları küçültür, düzgün fonksiyon verir. İki motorda aynı sayı aynı ceza değildir (71.8, S4). |
| Öğrenme oranı (Adam/SGD) | 0,001 | Başlangıç adım büyüklüğü. | Yalnız Adam/SGD; öteki motorlarda değiştirilirse ayar kaydına not düşer. |
| En çok yineleme | 500 | nnet: BFGS yinelemesi; Adam/SGD: dönem (epoch); L-BFGS: yineleme. | Az olursa yakınsamaz. |
| Erken durdurma (Adam/SGD) | kapalı | Eğitimin %10'u doğrulama; 10 dönem iyileşme yoksa durur. | Yalnız Adam/SGD. |
| Tohum tekrarı (başlangıç sayısı) | 1 | Aynı bölme ve katlarla tohum, tohum+1, … başlangıçları. | Tekrar tablosu ve ortalama ± SS (71.5.5). |
| Test oranı | 0,20 (0–0,50) | Tabakalı (sınıflamada) bölme; 0 = test yok. | |
| CV kat sayısı / CV tekrar sayısı / Rastgele tohum | 5 / 1 / 42 | Eğitim kümesinde CV; tohum bölmeyi, katları ve başlangıç ağırlıklarını belirler. | 71.6.1. |
| Hazır bölme sütunu / Ayrı test dosyası / Kat (grup) sütunu | yok | Bölme ve kat düzeni. | |
| Permütasyon önemi (test kümesi) | kapalı | Her özelliği 10 kez karıştırıp başarım düşüşü. | Tablo; grafik seçeneği "Permütasyon önemi". |
| Tahmin ve olasılıkları veri setine kaydet | kapalı | MLP_PRED, MLP_P_<sınıf>. |
|
| Olasılık eşiği / Ek çıktılar / Grafik | argmax / kapalı / Öğrenme eğrisi | SVM ile aynı q5 seçenekleri. |
"Dengesiz sınıflar" ve "Hiperparametre ayarı" kutuları bu panelde yoktur (mlp_network.py:90–91).
Neden varsayılan λ = 0,01 ve 500 yineleme? R nnet'inkinden farklı mı?
R nnet varsayılanı decay = 0, maxit = 100'dür. Cezasız ağ ayrılabilir verilerde ağırlıkları büyütür ve BFGS 100 yinelemede çoğu zaman durmadan sınıra takılır. MerQur küçük bir ceza ve daha uzun yineleme sınırıyla yakınsamış, düzgün bir çözüm hedefler. R ile karşılaştırırken decay = 0.01, maxit = 500 açıkça yazılmalıdır.
Koddaki tercih: etkinleştirme kutusunun varsayılanı ReLU, nnet'te kullanılmaz
Arayüz kutusunun ilk öğesi ReLU'dur (mlp_network.py:78–81); motor ise varsayılan olarak nnet'tir. nnet motoru her zaman lojistik gizli birim kullanır (classification.py:883). Kutuda hangi etkinleştirme seçili olursa olsun (varsayılan ReLU dahil), nnet motorunda kullanılmadığı ayar bloğuna yazılır (classification.py:871–875). Çıktıdaki "Mimari" satırı her durumda fiilen kullanılanı ("Lojistik (sigmoid)") yazar.
71.4 Tıp örneği
Ana örnek (regresyon): english/datasets/Tip/122_mlp_fasting_glucose.xlsx. Tıp setinde bu analize ayrılmış dosya budur.
| Değişken | Rol | Tür | Ort. (SS) |
|---|---|---|---|
| fasting_glucose_mg_dL | Y | sürekli | 107,83 (18,36) mg/dL |
| bmi | X | sürekli | 28,64 (5,17) kg/m² |
| sleep_hours | X | sürekli | 7,01 (1,22) saat |
| physical_activity_min_week | X | sayım | 148,54 (78,81) dk/hafta |
| diet_quality_score | X | puan | 54,28 (14,21) |
| age | X | sayım | 52,08 (11,51) yıl |
| height_cm | X | sayım | 167,50 (9,02) cm |
n ve eksik değer: 760 kişi, eksik değer yok; tohum 42 ile 608 eğitim, 152 test.
Klinik soru: Yaşam tarzı ve antropometri bulguları açlık glukozunu ne kadar iyi tahmin eder? (Boy, olası bir "gürültü" değişkeni olarak eklenmiştir.)
İkinci örnek (ikili sınıflama): Bölüm 68'in sepsis verisi (64_svm_sepsis.xlsx, 250 hasta, 4 girdi). nnet motorunun sınıflama yolunu R ile birebir karşılaştırmak için kullanılmıştır.
Seçilen ayarlar: Arayüz varsayılanları: nnet motoru, 5 gizli birim, λ = 0,01, 500 yineleme, test oranı 0,20, 5 katlı CV, tohum 42. Görev regresyon (ana örnek) ve sınıflama (ikinci örnek). Tekrarlanabilirlik için ayrıca tohum 43 ve "Tohum tekrarı = 3" çalıştırılmıştır.
71.5 Formüller ve hesap adımları
MerQur'un hesap sırası: (1) eksik satırları atar, kategorik X'i göstergeye çevirir; (2) eğitim/test bölmesi yapar (sınıflamada tabakalı); (3) girdileri eğitim kümesine göre z'ler, regresyonda hedefi de z'ler; (4) başlangıç ağırlıklarını U(-0{,}7;\,0{,}7)'den çeker; (5) amaç fonksiyonunu BFGS ile en küçükler, regresyonda bunu 5 başlangıçtan yapıp en düşük amaç değerlisini seçer; (6) test kümesinde tahmin ve ölçüleri hesaplar; (7) eğitim kümesinde 5 katlı CV'yi her katta yeniden ölçekleyip yeniden uydurarak yineler; (8) "Tohum tekrarı" > 1 ise (4)–(7)'yi tohum+1, tohum+2, … başlangıçlarıyla aynı bölmede tekrarlar.
71.5.1 Ağırlık düzeni ve ileri geçiş
nnet motorunda ağırlık vektörü R nnet ile aynı sıradadır (nnet_mlp.py:21–22, 55–59): her gizli birim için [w_{j0},w_{j1},\dots,w_{jp}], ardından her çıktı birimi için [v_0,v_1,\dots,v_H]. Ağırlık sayısı:
- p: girdi sayısı (göstergeler dahil).
- K: çıktı birimi sayısı; regresyonda ve ikili sınıflamada 1, K>2 sınıfta sınıf sayısı.
- Tıp örneğinde W=5\cdot7+1\cdot6=41; sepsis örneğinde 5\cdot5+6=31.
Gizli birimler:
- a_j: j. gizli birimin girdisi.
- h_j: gizli birimin çıktısı (lojistik).
Neden ±15'te doyurma?
R nnet C kodu lojistiği bu sınırlarda tam 0 ve 1'e keser. MerQur aynısını yapar (_sigmoid_hidden); böylece doyurulmuş birimin türevi tam 0 olur ve iki programın BFGS yolu aynı kalır. Fark, e^{-15}\approx3\cdot10^{-7} düzeyindedir.
71.5.2 Amaç fonksiyonu
nnet'in "value" değeri (nnet_mlp.py:62–94):
- y_i^{z}: z'lenmiş hedef ((y_i-\bar y^{tr})/s_y^{tr}, 1/n bölenli SS).
- \hat p_i: pozitif sınıf (sınıf listesinde ikinci; MerQur düzey sırası) olasılığı; \hat p_{ik}: softmax olasılıkları.
- \lambda: "Düzenlileştirme"; ceza yanlılık ağırlıkları dahil bütün W ağırlığa uygulanır.
- Toplamlar ortalama değil toplamdır; bu yüzden \lambda'nın etkisi n büyüdükçe göreli olarak küçülür.
Neden regresyonda hedef z'lenir?
Kareler toplamı hedefin birimine bağlıdır: mg/dL'de SS 17 iken kayıp, cezaya göre çok büyük olur ve BFGS'in vardığı yerel en küçük başlangıca aşırı duyarlı kalır. MerQur hedefi de z'ler (TransformedTargetRegressor, classification.py:823–831), tahminleri geri çevirir. Bu yüzden çıktıdaki amaç değeri (96,0941) z ölçeğindedir. R nnet hedefi ölçeklemez; karşılaştırmada hedef elle z'lenmiştir.
71.5.3 Başlangıç ağırlıkları
Üreteç NumPy default_rng(tohum)'dur (nnet_mlp.py:213–220). R nnet'in rang = 0.7 varsayılanıyla aynı aralıktır, ama R'nin RNG'si farklı olduğundan R aynı tohumla başka başlangıç çeker.
Koddaki tercih: regresyonda 5 başlangıç
nnet regresyonunda MerQur 5 başlangıçtan uydurur ve en düşük amaç değerli olanı tutar (_NnetMultiStart, classification.py:366–406; sayı n_starts, 723). Başlangıç 1 tohumun kendisidir; ötekiler SeedSequence(tohum).generate_state(4) ile türetilir. Tohum 42 için: 42, 3444837047, 2669555309, 2046530742, 3581440988. Sınıflamada tek başlangıç kullanılır; gerekçe kodda "sınıflama R nnet ile birebir kalır" diye yazılıdır. Bu seçenek arayüzde görünmez.
71.5.4 BFGS (Nash, 1990, Algoritma 21)
nnet motoru R optim(method = "BFGS") ile aynı değişken metrik algoritmasını uygular (nnet_mlp.py:111–183). Her yinelemede \mathbf B ters Hessian yaklaşığı olmak üzere arama yönü \mathbf t=-\mathbf B\mathbf g'dir. Geri izlemeli doğru araması adımı 1'den başlatır ve
sağlanana dek s'yi 0,2 ile çarpar. Kabul edilen adımdan sonra \mathbf B BFGS formülüyle güncellenir:
- \mathbf g: amaç fonksiyonunun analitik gradyanı (geri yayılım).
- \mathbf d=s\,\mathbf t: ağırlık değişimi; \mathbf c=\mathbf g_{\text{yeni}}-\mathbf g_{\text{eski}}: gradyan değişimi.
- \mathbf d^{\top}\mathbf c\le0 ise güncelleme yapılmaz ve bir sonraki adımda \mathbf B=\mathbf I'ya dönülür.
Durma ölçütü göreli değişimdir:
Bu koşul \mathbf B=\mathbf I ile denenen adımda da sağlanırsa algoritma "yakınsadı" der; yineleme sayısı 500'e ulaşırsa "yakınsamadı".
Neden gradyan sıfıra inmeden durur?
Ölçüt amaç değerinin göreli değişimine bakar, gradyanın büyüklüğüne bakmaz. Düz bir vadi tabanında (E\approx96) amaç 10^{-6}'dan az değişirken gradyan bileşenleri 10^{-2} mertebesinde kalabilir. Tıp örneğinde seçilen modelde sayısal gradyanın en büyük bileşeni 0,0142'dir. Bu durum R nnet ile aynıdır ve ağırlıkların küçük farklarla (burada 1{,}6\cdot10^{-3}) belirlenebildiğini, tahminlerin ise çok daha kararlı olduğunu gösterir.
71.5.5 Tohum, çoklu başlangıç ve tekrarlar
Tohum üç şeyi belirler: (i) eğitim/test bölmesi, (ii) CV katları, (iii) başlangıç ağırlıkları. "Tohum tekrarı" R>1 seçilince bölme ve katlar tohumla sabit kalır, yalnız başlangıç değişir (r. tekrarda tohum+r; classification.py:854–870). Tekrarların test başarımı için:
- m_r: r. başlangıcın test R^2'si (regresyon) ya da doğruluğu (sınıflama).
- s_m: başlangıç kaynaklı değişkenlik; n-1 bölenli.
Neden tekrarlar aynı bölmede?
Amaç, sonucun başlangıç ağırlıklarına ne kadar bağlı olduğunu ayırmaktır. Bölme de değişseydi test kümesinin rastgeleliği ile eniyilemenin rastgeleliği karışırdı. Tablonun ilk satırı tek çalıştırmanın sonucudur; ana çıktı her zaman bu ilk başlangıca aittir.
71.5.6 Öteki motorlar (sklearn)
Adam, SGD ve L-BFGS seçilince MLPClassifier/MLPRegressor kullanılır (classification.py:834–845). Fark üç yerdedir:
- \ell: sınıflamada log-kayıp, regresyonda \tfrac12(y-\hat y)^2; ortalama alınır.
- \alpha: arayüzdeki "Düzenlileştirme" değeri; ceza yanlılıkları içermez ve 2n'ye bölünür.
- Çoklu katman, ReLU/tanh/doğrusal etkinleştirme, öğrenme oranı ve erken durdurma yalnız bu motorlarda geçerlidir.
Adam ve SGD küçük gruplarla (en çok 200 gözlem) karıştırarak ilerler; sonuç tohuma nnet'ten daha duyarlıdır. Regresyonda hedef burada da z'lenir.
71.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/mlp_network/elle_hesap.py ile hesaplanmıştır. Betik MerQur'u çağırmaz: MerQur'un vardığı ağırlıklar verildiğinde ileri geçişi döngüyle, amaç fonksiyonunu ve sayısal gradyanı tanımdan hesaplar. Eniyilemenin kendisi R nnet ile bağımsız olarak yinelenmiştir (71.6.1).
Adım 1 — Bölme ve ölçekleme. 608 eğitim, 152 test. Eğitim ortalamaları ve 1/n bölenli SS'ler:
| bmi | sleep | activity | diet | age | height | |
|---|---|---|---|---|---|---|
| \bar x^{\,tr} | 28,4975 | 6,9987 | 150,8503 | 54,0691 | 51,8651 | 167,2599 |
| s^{\,tr} | 5,1706 | 1,1791 | 78,7814 | 14,1566 | 11,4347 | 9,1830 |
Hedef: \bar y^{tr}=106{,}881579, s_y^{tr}=17{,}327983.
Adım 2 — Başlangıçlar. Beş başlangıç tohumu 42, 3444837047, 2669555309, 2046530742, 3581440988'dir; her biri 41 ağırlığı U(-0{,}7;\,0{,}7)'den çeker (tohum 42'nin ilk üç ağırlığı 0,383538; −0,085570; 0,502037). BFGS sonrası amaç değerleri:
| Başlangıç | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| E(\hat{\mathbf w}) | 97,2285 | 96,6715 | 96,0941 | 109,8817 | 112,4007 |
Beş başlangıç dört farklı yerel en küçüğe varır; en düşük değerli 3. başlangıç seçilir (253 yineleme, yakınsadı). Ceza terimi 0{,}01\sum w^2=3{,}781862'dir; kalan 92,312238 z ölçeğindeki hata kareler toplamıdır.
Adım 3 — Seçilen ağırlıklar. Gizli katman (satır: birim; sütunlar: yanlılık, bmi, sleep, activity, diet, age, height):
Çıktı birimi: \mathbf v=(3{,}422949;\ -5{,}947570;\ -10{,}942723;\ 10{,}893477;\ 8{,}195346;\ -1{,}700382).
Boy sütununun (son sütun) bütün ağırlıkları küçüktür (\le0{,}12): ağ, boyu neredeyse yok saymıştır. Bu bir yorum ipucudur, test değildir; değişken katkısı için permütasyon önemi kullanılmalıdır.
Adım 4 — Bir ileri geçiş. Test kümesinin ilk kişisi (ham verideki 396. satır): bmi 34,8; uyku 6,2; aktivite 109; diyet 19; yaş 36; boy 154; gözlenen glukoz 113 mg/dL. z değerleri:
Birinci gizli birim:
Beş gizli birim:
| Birim | a_j | h_j |
|---|---|---|
| 1 | 1,334798 | 0,791633 |
| 2 | 0,807922 | 0,691666 |
| 3 | −0,433098 | 0,393387 |
| 4 | −0,074411 | 0,481406 |
| 5 | −3,365043 | 0,033406 |
Çıktı (z ölçeğinde) ve geri dönüşüm:
Gözlenen 113 mg/dL; artık 17,9 mg/dL. Bu kişinin diyet puanı çok düşüktür (z = −2,48); diyetin büyük ağırlık taşıdığı 1. ve 4. birimlerin girdisi (0{,}67\times(-2{,}48) ve 0{,}73\times(-2{,}48)) belirgin biçimde azalır ve tahmin ortalamanın altında kalır.
Adım 5 — Test ölçüleri. 152 test tahmini ileri geçişle yeniden hesaplandı (MerQur'la en büyük fark 1{,}4\cdot10^{-13}):
R^2, test kümesinin kendi ortalamasına göre hesaplanır (sklearn r2_score).
Adım 6 — CV. Eğitim kümesinde 5 kat (KFold, karıştırmalı, tohum 42); her katta girdiler ve hedef yeniden z'lenir ve 5 başlangıçla yeniden uydurulur. Kat R^2'leri 0,8237; 0,8061; 0,7998; 0,8063; 0,8000; ortalama 0,8072, SS (n-1) 0,0098.
Adım 7 — Durağanlık. Seçilen ağırlıklarda amaç fonksiyonunun merkezi sonlu farklarla (h=10^{-6}) sayısal gradyanı alındı; en büyük bileşen 0,0142'dir (71.5.4). Sınıflama örneğinde (73 yineleme) en büyük bileşen 3{,}2\cdot10^{-5}'tir.
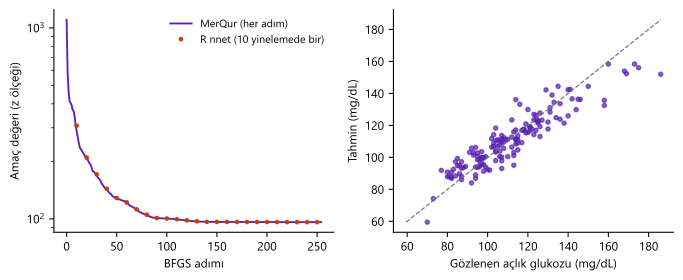
Şekil 71.1. Sol: seçilen başlangıcın BFGS amaç değeri izi (logaritmik eksen) ve aynı başlangıçtan R nnet'in 10 yinelemede bir yazdığı değerler. Sağ: test kümesinde gözlenen ve tahmin edilen açlık glukozu; kesikli çizgi y=\hat y.
71.6.1 Doğrulama: MerQur, Python ve R
R sütunu nnet::nnet ile hesaplanmıştır. R'nin RNG'si NumPy'ınkini üretemediği için R'ye MerQur'un başlangıç ağırlıkları Wts argümanıyla verilmiş; bölme, CV katları ve 1/n bölenli z ölçekleme de MerQur'dan alınmıştır. Böylece "aynı başlangıçtan aynı yerel en küçüğe varılıyor mu?" sorusu sınanır. Python sütunu, MerQur'un ağırlıklarıyla tanımdan yapılan bağımsız hesaptır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 (nnet) | En büyük fark | Durum |
|---|---|---|---|---|---|
| Regresyon (122, açlık glukozu; 5 başlangıç) | |||||
| z ölçek ortalamaları (6) | 28,497533 | 28,497533 | — | 7,1e−15 | ✓ |
| z ölçek SS'leri, 1/n bölenli (6) | 5,170648 | 5,170648 | — | 4,3e−14 | ✓ |
| Hedef ortalaması / SS (z'leme) | 106,881579 | 106,881579 | 106,881579 | 4,3e−13 | ✓ |
| Başlangıç tohumları (5) | 42 | 42 | — | 0,0e+00 | ✓ |
| Ağırlık sayısı H(p+1)+K(H+1) | 41 | 41 | 41 | 0,0e+00 | ✓ |
| Başlangıç 1–4: amaç değerleri | 97,228503 | — | 97,228502 | 1,2e−06 | ✓ (tol. 1,0e−07, göreli) |
| Seçilen başlangıç (en düşük amaç) | 3 | — | 3 | 0,0e+00 | ✓ |
| Seçilen modelin amaç değeri | 96,094100 | 96,094100 | 96,094100 | 1,6e−07 | ✓ (tol. 1,0e−07, göreli) |
| Amaç değeri, MerQur ağırlıklarından tanımla | 96,094100 | 96,094100 | — | 9,9e−14 | ✓ |
| Ağırlıklar (41) | 1,916898 | — | 1,916801 | 1,6e−03 | ✓ (tol. 5,0e−03) |
| Test tahminleri, mg/dL (152) | 95,094676 | 95,094676 | 95,095411 | 5,2e−03 | ✓ (tol. 1,0e−04, göreli) |
| Test R^2 | 0,838642 | 0,838642 | 0,838648 | 5,6e−06 | ✓ (tol. 1,0e−04, göreli) |
| Test RMSE | 8,656157 | 8,656157 | 8,656007 | 1,5e−04 | ✓ (tol. 1,0e−04, göreli) |
| Test MAE | 6,628468 | 6,628468 | 6,628408 | 6,1e−05 | ✓ (tol. 1,0e−04, göreli) |
| 5 kat CV R^2 (5) | 0,823720 | — | 0,823712 | 7,3e−05 | ✓ (tol. 1,0e−04, göreli) |
| İkili sınıflama (64, sepsis; tek başlangıç) | |||||
| Ağırlık sayısı | 31 | 31 | 31 | 0,0e+00 | ✓ |
| Ağırlıklar (31) | 0,274123 | — | 0,274123 | 1,2e−14 | ✓ |
| Amaç değeri (entropi + ceza) | 0,904946 | 0,904946 | 0,904946 | 4,3e−15 | ✓ |
| Test olasılıkları P(1\mid x) (50) | 0,997079 | 0,997079 | 0,997079 | 6,7e−16 | ✓ |
| Test doğruluğu | 1 | 1 | 1 | 0,0e+00 | ✓ |
| 5 kat CV doğrulukları (5) | 1 | — | 1 | 0,0e+00 | ✓ |
Tekrarlanabilirlik (tohum).
| Çalıştırma | Bölme | Başlangıç tohumları | Test R^2 | Amaç değeri | Yineleme |
|---|---|---|---|---|---|
| Tohum 42 | tohum 42 | 42 + 4 türetilmiş | 0,838642 | 96,094100 | 253 |
| Tohum 42, ikinci çalıştırma | tohum 42 | aynı | 0,838642 | 96,094100 | 253 |
| Tohum 43 | tohum 43 | 43 + 4 türetilmiş | 0,801525 | 86,517437 | 292 |
| Tohum tekrarı = 3, başlangıç 42 | tohum 42 | 42 + 4 türetilmiş | 0,838642 | — | 253 |
| Tohum tekrarı = 3, başlangıç 43 | tohum 42 | 43 + 4 türetilmiş | 0,805375 | — | 337 |
| Tohum tekrarı = 3, başlangıç 44 | tohum 42 | 44 + 4 türetilmiş | 0,851412 | — | 265 |
R'nin RNG'si NumPy'ın PCG64 üretecini üretemediği için R'ye MerQur'un başlangıç ağırlıkları (Wts) verilmiştir. Sınıflamada iki program aynı yerel en küçüğe 1e−14 farkla varır. Regresyonda BFGS yolu R'nin 10 yinelemede bir yazdığı 6 ondalıklı değerle aynıdır; fark ilk kez başlangıç 3'te 170., başlangıç 5'te 210. yinelemede 1e−5'i aşar: kayan nokta toplama sırası farkı büyür. Seçilen modelde fark göreli durma ölçütü (reltol = 1e−8) düzeyinde kalır. Başlangıç 5'te MerQur 112,4007 değerinde durmuş ("yakınsadı"), R aynı başlangıçtan 500 yinelemede 108,1742'ye inip sınıra takılmıştır; bu başlangıç iki programda da seçilmez. "Python (bağımsız)" sütunu MerQur'un vardığı ağırlıklarla ileri geçişi, amaç fonksiyonunu ve başarım ölçülerini döngüyle, tanımdan yeniden hesaplar; seçilen regresyon modelinde amaç fonksiyonunun sayısal gradyanının en büyük bileşeni 0,0142, sınıflamada 3,2e−05 olarak bulunur.
Gerekçeli tolerans. Sınıflamada (73 yineleme) iki program 10^{-14} farkla aynı noktaya varır; bu, algoritmanın birebir aynı olduğunu gösterir. Regresyonda yol (iz_karsilastir.py) R'nin 6 ondalıkla yazdığı değerlerle 160. yinelemeye kadar aynıdır; sonra iki programın toplama sırasından gelen 10^{-15} düzeyindeki farklar BFGS'in doğru aramasında büyür. Düz amaç yüzeyinde iki program göreli durma ölçütünü (10^{-8}) biraz farklı noktalarda sağlar: amaç değeri 1{,}6\cdot10^{-7} (göreli 1{,}7\cdot10^{-9}), ağırlıklar 1{,}6\cdot10^{-3}, tahminler en çok 0,005 mg/dL farklıdır. Bu fark bir hata değil, aynı yerel en küçüğün sayısal belirlenebilirlik sınırıdır. Seçilmeyen 5. başlangıçta MerQur 112,40'ta "yakınsadı" derken R aynı başlangıçtan devam edip 500 yinelemede 108,17'ye inmiştir; düz bölgede durma ölçütü iki programda farklı yinelemede tetiklenmiştir.
Tohum ve tekrarlanabilirlik. Aynı tohumla iki çalıştırma bit düzeyinde aynıdır (R^2, amaç değeri, yineleme sayısı). Tohum 43 hem bölmeyi hem başlangıçları değiştirir: R^2=0{,}8015 (başka test kümesi). "Tohum tekrarı = 3" aynı bölmede başlangıçları değiştirir: R^2 = 0,8386; 0,8054; 0,8514; ortalama 0,8318, SS 0,0238. Yani bu veride başlangıç kaynaklı R^2 oynaklığı yaklaşık ±0,02'dir; tek bir çalıştırmanın üçüncü ondalığı yorumlanmamalıdır.
71.7 Çıktıyı okuma
MerQur'un gerçek çıktısı (regresyon, varsayılan ayarlar, kısaltılmış):
MLP — Regresyon
  Hedef               = fasting_glucose_mg_dL
  Özellik sayısı      = 6
  Algoritma           = Yapay sinir ağı — tek gizli katman, BFGS (Nash 1990)
  Ön işleme           = Eksik değerli satırlar çıkarıldı (listwise). Standartlaştırma (z) ...

  ── Test Performansı ──
  R²                  = 0.8386
  RMSE                = 8.6562
  MAE                 = 6.6285
  CV R² (ort ± SS)    = 0.8072 (±0.0098)

── Model kurulumu ve yeniden üretilebilirlik ──
  Hiperparametreler (belirtilmeyenler kütüphane varsayılanı): hidden = 5, decay = 0.01, max_iter = 500
  Bölme: eğitim n = 608, test n = 152 (tohum = 42); ölçekleme/doldurma yalnız eğitime uyduruldu
  CV: 5-kat, karıştırmalı (tohum = 42); yalnız eğitim kümesinde (n = 608)

── Sinir ağı ayrıntıları ──
  Mimari: 6 girdi → gizli [5] (Lojistik (sigmoid)) → 1 çıktı (doğrusal); ağırlık sayısı = 41
  Motor: Yapay sinir ağı — tek gizli katman, BFGS (Nash 1990)
  Düzenlileştirme = 0.01; yineleme = 253 / 500; yakınsadı: evet
  Son amaç fonksiyonu değeri = 96.094100
  Regresyon: hedef z-standartlaştırıldı (girdiler gibi); tahminler özgün ölçeğe geri
     dönüştürüldü, amaç değeri standart ölçekte.
  Çoklu başlangıç: 5 tohumlu başlangıçtan en düşük amaç değerli #3 seçildi (amaç değerleri:
     97.2285, 96.6715, 96.0941, 109.8817, 112.4007).
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| R², RMSE, MAE | Test kümesinde, özgün birimde. | RMSE ve MAE mg/dL'dir; R^2 test ortalamasına göredir. |
| CV R² (ort ± SS) | Eğitim kümesinde 5 kat; SS n-1 bölenli. | Test R^2'si CV aralığının çok üstündeyse şanslı bölme olabilir. |
| Mimari | Girdi, gizli birim, etkinleştirme, çıktı türü, ağırlık sayısı. | Ağırlık sayısını eğitim n'siyle karşılaştırın. |
| yineleme / yakınsadı | BFGS yinelemesi ve durma ölçütünün sağlanıp sağlanmadığı. | "hayır" ise yineleme sınırını ya da λ'yı artırın. |
| Son amaç fonksiyonu değeri | E(\hat{\mathbf w}), cezayla birlikte; regresyonda z ölçeğinde. | R nnet'in value değeriyle karşılaştırılabilir (aynı ölçekte). |
| Çoklu başlangıç | 5 başlangıcın amaç değerleri ve seçilen. | Değerler çok dağınıksa amaç yüzeyi çok tepeli; birim sayısını ya da λ'yı gözden geçirin. |
| Çoklu tohum tekrarları tablosu | Her başlangıcın test ölçüsü, CV ortalaması ve SS'si, yinelemesi. | Başlangıç kaynaklı belirsizliğin ölçüsüdür. |
| Öğrenme eğrisi (grafik) | nnet'te her BFGS adımındaki amaç değeri. | Eksen "Yineleme" yazar; eğri, \mathbf B'nin sıfırlandığı adımları da içerdiği için noktası yineleme sayısından birkaç fazladır (255'e karşı 253). |
APA cümlesi MerQur'un ürettiği metinden uyarlanmıştır (Türkçe ondalık virgülle):
Tek gizli katmanlı (5 lojistik birim) ileri beslemeli bir yapay sinir ağı (BFGS eniyileme, ağırlık azaltma λ = 0,01; girdiler ve hedef eğitim kümesine göre standartlaştırıldı; 5 başlangıçtan en düşük amaç değerlisi seçildi) açlık glukozunu test kümesinde (n=152) R^2=0{,}84, RMSE = 8,66 mg/dL ile tahmin etti; eğitim kümesinde 5 katlı CV R^2 Ort = 0,81 (SS = 0,01). Aynı bölmede üç başlangıç tohumunda test R^2 Ort = 0,83 (SS = 0,02) bulundu.
71.8 Uzman soruları
S1. MerQur'un nnet motoru R nnet ile gerçekten aynı mı?
Model, amaç fonksiyonu, ağırlık sırası, ±15 doyurma, BFGS (Nash 1990) ve durma ölçütleri aynıdır (nnet_mlp.py başlığı). Sınıflama örneğinde aynı başlangıç ağırlıklarından ağırlıklar 1{,}2\cdot10^{-14} farkla aynıdır. Farklar iki yerdedir: (i) başlangıç ağırlıklarının RNG'si (NumPy, R değil), (ii) uzun yollarda kayan nokta toplama sırası (71.6.1). İlki Wts ile giderilir; ikincisi sonucu göreli durma toleransı içinde etkiler.
S2. Neden regresyonda 5 başlangıç, sınıflamada 1?
Kod gerekçesi: ölçeklenmemiş hedefte nnet regresyonu başlangıca çok duyarlıydı; hedef z'lendi ve 5 başlangıç eklendi (classification.py:795–801). Sınıflama, R nnet ile tek başlangıçta birebir karşılaştırılabilir kalsın diye değiştirilmedi. Sınıflamada başlangıç duyarlılığı "Tohum tekrarı" ile ölçülebilir.
S3. Amaç değeri neden "96,09"? Bu MSE mi?
Hayır. z'lenmiş hedefte hata kareler toplamı (92,31) artı ceza (3,78)'dir. MSE'ye çevirmek için ceza çıkarılır, n_{tr}=608'e bölünür ve s_y^2 ile çarpılır: 92{,}312/608\times17{,}328^2=45{,}59; eğitim RMSE'si yaklaşık 6,75 mg/dL'dir (test RMSE'si 8,66).
S4. "Düzenlileştirme = 0,01" nnet ve Adam'da aynı ceza mı?
Hayır. nnet: \lambda\sum w^2, yanlılıklar dahil, toplam kayba eklenir. sklearn: \frac{\alpha}{2n}\sum w^2, yanlılıklar hariç, ortalama kayba eklenir. Ortalama kayba göre yazılırsa nnet cezası \lambda/n, sklearn cezası \alpha/(2n)'dir; aynı sayıda nnet cezası kabaca iki kat güçlüdür ve yanlılıkları da büzer.
S5. Yakınsadı "evet" olduğu hâlde gradyan neden sıfır değil?
nnet'in ölçütü göreli amaç değişimidir (71.5.4). Düz vadi tabanında amaç değişmezken gradyan 10^{-2} mertebesinde kalabilir. Bu R nnet'te de böyledir. Ağırlıklar bu nedenle 10^{-3} düzeyinde belirsizdir; tahminler çok daha kararlıdır (0,005 mg/dL).
S6. Tek bir tohumla bulunan test R²'si raporlanabilir mi?
Raporlanabilir ama belirsizliği eksik kalır. Tohum hem bölmeyi hem başlangıcı değiştirir. Tıp örneğinde tohum 42 → 43 geçişi R^2'yi 0,839'dan 0,802'ye indirir; yalnız başlangıç değiştiğinde ±0,02 oynar. "Tohum tekrarı" ve tekrarlı CV ile ortalama ve SS verilmelidir.
S7. Gizli birimler doyarsa ne olur?
\lvert a_j\rvert>15 olan birim 0 ya da 1 verir ve türevi 0'dır; o gözlem için birimin girdi ağırlıkları güncellenmez. Girdiler z'lendiği ve başlangıç ağırlıkları küçük olduğu için başta nadirdir; ceza yoksa ve ağırlıklar büyürse sıklaşır. Bu, λ = 0'ın yakınsamayı yavaşlatma nedenlerinden biridir.
S8. Ağırlıklardan değişken önemi okunabilir mi?
Doğrudan okunmamalıdır. Ağırlıklar başlangıca bağlıdır ve gizli birimlerin yer değiştirmesi (permütasyon) ile işaret değişimi aynı fonksiyonu verir. Tıp örneğinde boyun bütün ağırlıklarının küçük olması bir ipucudur; önem için test kümesinde permütasyon önemi ya da kısmi bağımlılık grafiği kullanılmalıdır.
71.9 Sık hatalar ve tuzaklar
- ReLU'nun kullanıldığını sanmak. Varsayılan motor (nnet) her zaman lojistik gizli birim kullanır; kutudaki ReLU yalnız sklearn motorlarında etkilidir. Çıktıdaki "Mimari" satırı ve ayar bloğu bunu yazar.
- Tek çalıştırmanın üçüncü ondalığını yorumlamak. Başlangıç ve bölme kaynaklı oynaklık ±0,02 R^2 düzeyindedir.
- "Tohum tekrarı"nın bölmeyi de değiştirdiğini sanmak. Tekrarlar aynı bölmededir; bölme etkisini görmek için tohumu elle değiştirin.
- Amaç değerini MSE gibi okumak. Toplamdır, cezayı içerir; regresyonda z ölçeğindedir.
- R'de varsayılanlarla karşılaştırmak. R
nnet:decay = 0,maxit = 100, ölçekleme yok, farklı RNG. Aynı sonuç içindecay = 0.01, maxit = 500, 1/n bölenli z'lenmiş veri, z'lenmiş hedef (regresyon),linout = TRUEya daentropy = TRUEve MerQur'un başlangıç ağırlıkları gerekir. - Adam/SGD'de yakınsama uyarısını önemsememek. Bu motorlarda en çok yineleme dönem sayısıdır; 500 dönem küçük öğrenme oranıyla yetmeyebilir. sklearn'ün yakınsama uyarısı MerQur'da bastırılır; yalnız "yakınsadı: hayır" satırı ve uyarı görünür.
- Test oranı 0 ile çalışıp başarımı genellemek. "Yok (tüm veri)" seçiliyse ölçüler eğitim verisindedir.
71.10 Kaynaklar
- Fletcher, R. (1970). A new approach to variable metric algorithms. The Computer Journal, 13(3), 317–322. https://doi.org/10.1093/comjnl/13.3.317
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning (2. baskı). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Hornik, K., Stinchcombe, M., & White, H. (1989). Multilayer feedforward networks are universal approximators. Neural Networks, 2(5), 359–366. https://doi.org/10.1016/0893-6080(89)90020-8
- Nash, J. C. (2018). Compact numerical methods for computers: Linear algebra and function minimisation (2. baskının yeniden basımı; ilk yayın 1990). Routledge. https://doi.org/10.1201/9781315139784
- Ripley, B. D. (1996). Pattern recognition and neural networks. Cambridge University Press. https://doi.org/10.1017/CBO9780511812651
- Rumelhart, D. E., Hinton, G. E., & Williams, R. J. (1986). Learning representations by back-propagating errors. Nature, 323(6088), 533–536. https://doi.org/10.1038/323533a0
- Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4. baskı). Springer. https://doi.org/10.1007/978-0-387-21706-2