3. Normallik Testleri
Analiz kimliği: normality · Menü adı: Normallik Testleri · Panel: gui/panels/analyses/normality.py (execute, satır 198–257) · Motor: stats/normality.py, NormalityTester.run_all (satır 310–406), _run_test (489–583), lilliefors_nortest (117–148), anderson_darling_nortest (86–114), ks_one_sample_dist (201–272)
3.1 Ne işe yarar
Normallik testleri, bir örneklemin normal (Gauss) dağılımlı bir anakütleden gelip gelmediğini sınar. Cevapladığı soru şudur: "Gözlenen dağılım ile aynı ortalama ve SS'li normal dağılım arasındaki fark, yalnız örnekleme rastlantısıyla açıklanabilir mi?"
- \mu, \sigma: veriden kestirilir. Bu yüzden testler "bileşik" sıfır hipotezini sınar; dağılımları parametrelerin bilindiği duruma göre farklıdır (Lilliefors etkisi).
- p<\alpha ise H₀ reddedilir: "normal değil". p\ge\alpha normalliği kanıtlamaz; yalnız reddedilemediğini söyler.
Ne zaman kullanılır? Parametrik bir testten (t testi, ANOVA, Pearson korelasyonu, normal tolerans aralığı) önce değişkenin ya da artıkların normalliğini görmek için; ölçüm aracının dağılımını tanımak için; bir referans dağılımına (tekdüze, üstel, Poisson) uyumu sınamak için (tek örneklem K-S bölümü).
Ne zaman kullanılmaz?
- Regresyon ya da ANOVA'da varsayım artıklar içindir: ham bağımlı değişkene değil, ilgili modülün artık tanılarına bakılır (ör. Çoklu Regresyon artık normalliği).
- Grupları karşılaştıracaksanız normallik her grupta ayrı incelenir: "Gruba göre" seçeneği.
- Çok büyük örneklemde (n binlerle) karar aracı olarak kullanılmaz: önemsiz sapmalar bile anlamlı çıkar; Q–Q grafiği ve çarpıklık/basıklık büyüklüğüne bakılır.
- Birden çok değişkenin ortak normalliği için: çok değişkenli normallik (Mardia) MANOVA ve Doğrulayıcı Faktör Analizi modüllerinin ek çıktılarındadır.
Sık karıştırılan analizler. Tanımlayıcı İstatistikler çarpıklık ve basıklığı verir ama sınamaz (Bölüm 1). Tek örneklem K-S (bu modülün "diğer dağılımlar" bölümü) parametreleri bilinen ya da kestirilen tekdüze, üstel ve Poisson dağılımlarına uyumu sınar; Lilliefors ise parametreleri kestirilmiş normal dağılım içindir. Ki-kare uyum iyiliği testi kategorik frekanslar içindir.
3.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsız gözlemler | Her gözlem ayrı birimden. Zaman serisinde ardışık bağımlılık testleri yanıltır. | Denetlenmez. |
| Sürekli değişken | Testlerin dağılımları bağsız sürekli veri içindir; çok bağlı (yuvarlanmış) veride Shapiro–Wilk ve Lilliefors sapmayı abartabilir. | Denetlenmez. |
| En küçük n | Her testin geçerli olduğu bir alt sınır vardır. | Shapiro–Wilk 3, Lilliefors 5, Anderson–Darling 8, D'Agostino 8, Jarque–Bera 3, Cramér–von Mises 8, Shapiro–Francia 5 (normality.py:454–455); seçilen test sınırın altındaysa atlanır ve not yazılır. |
| En büyük n | Shapiro–Wilk ve Shapiro–Francia n\le5000. | Aşılırsa atlanır, not yazılır (normality.py:470–473). |
Eksik değer. pd.to_numeric(..., errors="coerce").dropna() ile sayıya çevrilemeyen ve eksik değerler atılır (normality.py:327). Gruba göre çalıştırmada değer ve grup sütunları birlikte liste bazında silinir (normality.py panel, satır 219–221).
Uç durumlar.
- n<3: test satırı yerine "Yeterli veri yok" yazılır; karar "BELİRSİZ", güven "Düşük" (
normality.py:349–355, 377–380). - Sabit seri (SS = 0): analiz yapılmaz; "'x' sabit (bütün geçerli değerler aynı, varyans 0); normallik testi uygulanamaz" iletisi verilir ve bir normallik kararı basılmaz (R
shapiro.testde bu durumda hata verir). - n\le3'te basıklığın SH'si, n\le2'de çarpıklığınki tanımsızdır; metinde "—" ve açıklama satırı çıkar (
normality.pypanel, satır 327–337).
3.3 Parametreler
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Sütun | ilk sayısal sütun | Sınanacak tek değişken. | |
| α (alfa) | 0,05 | Karar eşiği; 0,01–0,10 (normality.py panel, satır 65–70). |
Her testin "Normal / Normal Değil" etiketi ve genel karar; p değerleri değişmez. |
| Gruba göre | (Gruplama yok) | Kategorik ya da sayısal kodlu faktör. | Her düzey için ayrı testler ve tablo; ana sonuç tüm veri içindir. |
| Testler (7 kutu) | hiçbiri | Shapiro-Wilk, K-S (Lilliefors), Anderson-Darling, D'Agostino K², Jarque-Bera, Cramér-von Mises, Shapiro-Francia. | Hiçbiri işaretli değilse n'ye göre otomatik seçim; işaretlenirse yalnız seçilenler. |
| Tek örneklem K-S, diğer dağılımlar | kapalı | Tekdüze, üstel, Poisson. | Ek bölüm; normallik kararına katılmaz. |
| K-S tekdüze parametreleri / üstel ortalaması / Poisson ortalaması | boş | Boşsa parametre veriden kestirilir; doluysa sabit alınır. | Doluysa asimptotik p, boşsa (varsayılan) Monte Carlo p. |
| K-S p (parametre veriden) | Monte Carlo | Monte Carlo (parametre yeniden kestirimli) ya da asimptotik. | Asimptotik p kestirilmiş parametrede fazla büyüktür. |
| K-S Monte Carlo örneklem sayısı | 10000 | 100–1000000 benzetim. | p'nin Monte Carlo hatası \approx\sqrt{p(1-p)/B}. |
| K-S Monte Carlo tohumu | 2000000 | Rastgele sayı üretecinin tohumu. | Aynı tohum aynı p'yi verir. |
| 2. grafik | Q-Q | Q–Q, eğilimden arındırılmış Q–Q, P–P ya da kutu grafiği. | Yalnız grafik. |
| Toplu test (ek sütunlar) | hiçbiri | İşaretlenen ek sütunlar aynı testlerle. | Ek bölüm. |
Neden test seçilmezse otomatik seçim?
Testlerin gücü ve geçerli olduğu n aralığı farklıdır. MerQur'un otomatik kuralı (_auto_tests, normality.py:439–451): n<50 yalnız Shapiro–Wilk; 50\le n<300 Shapiro–Wilk + Lilliefors; n\ge300 Lilliefors + Anderson–Darling; ayrıca n\ge20 ise D'Agostino K². Shapiro–Wilk küçük ve orta örneklemde en güçlü genel test olarak bilinir (Razali ve Wah 2011'in benzetimleri); büyük örneklemde EDF testleri (Lilliefors, Anderson–Darling) ve moment tabanlı D'Agostino eklenir. Otomatik seçim, kullanıcı tek bir test seçmeyi bilmiyorsa makul bir varsayılan sağlar; yayımlanacak analizde test önceden belirlenmeli ve elle seçilmelidir.
3.4 Tıp örneği
Dosya: english/datasets/Tip/02_normality_BMI_bp_HbA1c.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/02_normallik_BMI_KB_HbA1c.xlsx).
| Değişken | Rol | Tür | Açıklama/özet |
|---|---|---|---|
HbA1c_pct |
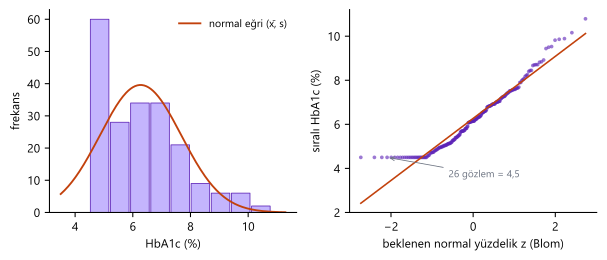
Sütun | sürekli (%) | 4,50–10,79; ortalama 6,27, SS 1,41; 26 gözlem tam 4,50 (alt sınırda yığılma). |
BMI |
Toplu test | sürekli | 16,00–37,83; ortalama 25,84. |
systolic_bp |
Toplu test; Poisson K-S örneği | tamsayı (mmHg) | 90–161; ortalama 125,18. |
patient_id |
kullanılmaz |
n ve eksik değer: 200 hasta, eksik değer yok.
Klinik soru: HbA1c, BMI ve sistolik kan basıncı normal dağılıyor mu? Sonraki t testi, ANOVA ve korelasyon analizlerinde parametrik yöntem kullanılabilir mi?
Seçilen ayarlar: Önce varsayılanlar (otomatik seçim; n=200 olduğundan Shapiro–Wilk, Lilliefors, D'Agostino) ve toplu testte BMI ile systolic_bp. Hesap yürüyüşü için ikinci çalıştırmada yedi testin tümü ve K-S tekdüze/üstel/Poisson işaretlenmiştir (Monte Carlo, 10000 örneklem, tohum 2000000).
Şekil 3.1. HbA1c histogramı (numpy "auto" kuralıyla 9 kutu) ve aynı ortalama/SS'li normal eğri; sağda Blom konumlu Q–Q grafiği ve \bar x+s\,z başvuru doğrusu. Sol uçtaki yatay basamak 4,5'te yığılan 26 gözlemdir; sağ uçta noktalar doğrunun üstüne çıkar (sağa çarpıklık).
3.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) sayıya çevir, eksikleri at; (2) ortalama, SS, G_1, G_2 ve z'lerini hesapla; (3) n<3 ya da sabit seri değilse seçilen (ya da otomatik) testleri çalıştır; (4) her testin p'sini \alpha ile karşılaştır; (5) genel kararı ve güvenini ver; (6) grafik verisini, gruplu ve toplu raporları, tek örneklem K-S bölümünü ekle.
3.5.1 Çarpıklık ve basıklık z'leri
G_1, G_2, SES ve SEK tanımları Bölüm 1.5.3 ile aynıdır (normality.py:331–344):
- SES ve SEK: normal anakütlede G_1 ve G_2'nin kesin SH'leri.
- Metindeki kural: \lvert z\rvert>1{,}96 (n<50) ya da 3{,}29 (orta n) normallikten sapma işaretidir (Kim 2013'te önerilen eşikler).
Koddaki tercih
Rapor nesnesinde G_1, G_2 ve z'ler 4 ondalığa yuvarlanarak saklanır (normality.py:396–399); metin bunları 4 ve 3 ondalıkla yazar. Doğrulamada bu round bellekte etkisizleştirilmiş, tam değerler karşılaştırılmıştır.
3.5.2 Shapiro–Wilk
- x_{(i)}: sıralı gözlemler.
- a_i: normal sıra istatistiklerinin beklenen değerleri ve kovaryanslarından türetilen katsayılar; \sum a_i^2=1, a_i=-a_{n+1-i}.
- W: sıralı verinin normal beklenen değerlerle "doğrusallığının" karesi; 1'e yakınsa normal. Küçük W reddi gösterir.
MerQur scipy.stats.shapiro kullanır (normality.py:494); bu, Royston'ın (1992, 1995) AS R94 algoritmasıdır. Katsayılar ve p yaklaşımı (n\ge12):
- m_i: Blom yaklaşımıyla beklenen normal sıra istatistikleri; c_i=m_i/\sqrt{\sum m_j^2}: normlanmış hâlleri.
- a_n, a_{n-1}: uçtaki iki katsayı polinomla düzeltilir; ortadakiler m_i ile orantılıdır. Simetriyle a_1=-a_n, a_2=-a_{n-1}.
- L=\ln n; \ln(1-W) yaklaşık normal dağılır, \mu ve \sigma onun ortalaması ve SS'sidir.
Neden bu yaklaşım?
Shapiro ve Wilk (1965) a_i'leri n\le50 için tablolarla vermişti; tam kovaryans matrisi büyük n'de hesaplanamaz. Royston uç katsayıları polinomla, ortadakileri m_i ile yaklaştırdı ve \ln(1-W)'nin normal dönüşümüyle p'yi n=5000'e kadar genişletti. R shapiro.test ve scipy aynı algoritmayı kullanır; doğrulamada MerQur, bağımsız Python ve R'nin W'si 10^{-10} düzeyinde aynı çıkar.
3.5.3 Kolmogorov–Smirnov (Lilliefors)
Veri \bar x ve s ile standartlaştırılır, F_i=\Phi\!\left((x_{(i)}-\bar x)/s\right):
p, Dallal ve Wilkinson (1986) yaklaşımıyla hesaplanır; n>100 ise K_d=D\,(n/100)^{0{,}49}, n_d=100, değilse K_d=D, n_d=n:
p>0{,}1 çıkarsa Stephens'ın değiştirilmiş istatistiği K^{*}=(\sqrt n-0{,}01+0{,}85/\sqrt n)\,D üzerinden parçalı dördüncü derece polinoma geçilir (normality.py:136–147).
- \Phi: standart normal birikimli dağılım; s n-1 ile hesaplanır.
- D: deneysel ve kestirilmiş normal birikimli dağılımlar arasındaki en büyük dikey uzaklık.
- K_d, n_d: Dallal–Wilkinson formülünün n\le100 için kurulmuş olmasından gelen ölçek düzeltmesi.
Neden klasik K-S p'si değil?
Klasik Kolmogorov dağılımı F_0'ın tam bilindiğini varsayar. Ortalama ve SS veriden kestirildiğinde kestirilmiş normal veriye daha iyi oturur, D sistematik olarak küçülür; klasik p aşırı büyük çıkar ve test gücünü yitirir. Lilliefors (1967) doğru dağılımı benzetimle tablolaştırdı; Dallal ve Wilkinson analitik yaklaşımı verdi.
Koddaki tercih
MerQur, R nortest::lillie.test ile aynı p'yi verir (lilliefors_nortest, normality.py:117–148). statsmodels'in "table" yöntemi ise p<0{,}001'de 0,0010'a kırpar ve orta bölgede farklı p verir. Dallal–Wilkinson ile Stephens formülleri p=0{,}1'de birleşmez; p bu sınırda küçük bir sıçrama yapar (R ile aynı davranış).
3.5.4 Anderson–Darling
- F_i: 3.5.3'teki gibi standartlaştırılmış verinin normal birikimli değerleri.
- A^2: deneysel ve kuramsal dağılım farklarının, kuyruklara daha çok ağırlık veren karesel ortalaması.
- A^{*}: Stephens'ın kestirilmiş parametre düzeltmesi; p D'Agostino ve Stephens (1986) parçalı formülüyle. A^{*}\ge10 için p=3{,}7\times10^{-24}.
Koddaki tercih
MerQur \ln F_i ve \ln(1-F_i)'yi norm.logcdf ve norm.logsf ile alır (normality.py:99–100); uç z'lerde \ln(0) taşmasını önler. Tanım nortest::ad.test ile aynıdır ve scipy sürümünden bağımsızdır. En küçük n 8'dir: n<8'de test yapılmaz ve bunu bildiren bir not yazılır. nortest de n\ge8 ister.
3.5.5 Cramér–von Mises ve Shapiro–Francia
Cramér–von Mises (normality.py:549–568):
p, W^{*} üzerinden dört parçalı üstel formülle (Stephens 1974; nortest::cvm.test) hesaplanır. Metinde W^2 (düzeltmesiz) yazılır.
Shapiro–Francia (normality.py:570–580):
- m_i: 3.5.2'deki Blom kantilleri; u=\ln n, v=\ln u.
- W': sıralı veri ile beklenen normal kantiller arasındaki korelasyonun karesi. Shapiro–Wilk'in kovaryans yerine yalnız beklenen değerleri kullanan basitleştirmesidir (Shapiro ve Francia 1972).
- p=1-\Phi\left((\ln(1-W')-\mu)/\sigma\right): Royston (1993) yaklaşımı.
3.5.6 D'Agostino K² ve Jarque–Bera
İkisi de momentlerden kurulur: g_1=m_3/m_2^{3/2}, b_2=m_4/m_2^2 (yanlı, n'ye bölünmüş momentler).
D'Agostino–Pearson K² (scipy.stats.normaltest, normality.py:528). Çarpıklık bileşeni (D'Agostino ve Pearson 1973; D'Agostino, Belanger ve D'Agostino 1990):
Basıklık bileşeni (Anscombe ve Glynn 1983):
- Y: g_1'in normal altında standartlaştırılmış hâli; Z_1 onu Johnson S_U dönüşümüyle normale yaklaştırır.
- x: b_2'nin standartlaştırılmış hâli; Z_2 Wilson–Hilferty küp kök dönüşümüyle normale yaklaştırır.
- K^2: iki bileşenin kareleri toplamı; normal altında yaklaşık 2 sd'li ki-kare.
Neden ayrıca dönüşüm?
g_1 ve b_2'nin örnekleme dağılımları normalden uzaktır; özellikle b_2 küçük n'de belirgin biçimde çarpıktır. Dönüşümler her bileşeni orta n'de yaklaşık standart normale getirir; K^2 ancak bundan sonra \chi^2_2 ile değerlendirilebilir. Basıklık dönüşümü n\ge20 için önerilir (D'Agostino, Belanger ve D'Agostino 1990). MerQur'un otomatik seçimi testi bu yüzden n\ge20'de ekler (normality.py:449); elle seçimde sınır 8'dir (:454–455) ve R fBasics::dagoTest n<20'de hata verir.
İlginç bir özdeşlik: Y tam olarak G_1/\mathrm{SES}'e, x tam olarak G_2/\mathrm{SEK}'e eşittir. 3.5.1'deki kaba z'ler, D'Agostino bileşenlerinin dönüşüm öncesi hâlleridir.
Jarque–Bera (scipy.stats.jarque_bera, normality.py:542):
Neden JB küçük örneklemde tutucu değil?
JB, g_1 ve b_2'nin asimptotik varyanslarını (6/n ve 24/n) kullanır; dağılımı ancak büyük n'de \chi^2_2'ye yaklaşır. Küçük ve orta n'de birinci tür hata oranı nominalden sapar. Ekonometride artık denetimi için yaygındır (Jarque ve Bera 1987); MerQur'da otomatik seçime girmez, elle seçilir.
3.5.7 Genel karar
Güven: en az iki test aynı yöndeyse "Yüksek", tek testse "Orta", ayrışma varsa "Orta", hiç p yoksa "Düşük" (normality.py:372–386). Karar yalnız p'si olan testlerle verilir. "NORMAL DEĞİL" kararında öneri satırı parametrik olmayan karşılıkları sıralar (Mann–Whitney U, Wilcoxon, Kruskal–Wallis, Friedman).
Tutarsızlığa dikkat
Genel karar bir oy birliği kuralıdır; testler aynı sorunun farklı biçimlerine duyarlı olduğundan (Shapiro–Wilk genel, D'Agostino çarpıklık ve basıklık, Anderson–Darling kuyruk) ayrışma doğaldır. Birden çok test yapmak birinci tür hatayı da şişirir. Karar yardımcı bir özettir; çıkarım için önceden seçilmiş tek bir test ve grafik kullanılmalıdır.
3.5.8 Tek örneklem K-S: tekdüze, üstel, Poisson
- F_n: deneysel birikimli dağılım; F_0: varsayılan dağılım. Tekdüze: F_0=(x-a)/(b-a), a ve b verinin en küçük/en büyük değeri; üstel: F_0=1-e^{-x/\bar x}; Poisson: \lambda=\bar x ile birikimli olasılık.
- Poisson'da iki fonksiyon da tamsayılarda sıçrayan basamak fonksiyonudur; supremum 0,\dots,\max(x) tamsayılarında alınır (
_ks_d_poisson,normality.py:163–177). - Asimptotik p=\Pr(K>Z)=2\sum_{k\ge1}(-1)^{k-1}e^{-2k^2Z^2} (Kolmogorov dağılımı;
kstwobign.sf).
Monte Carlo p (parametreler veriden kestirildiğinde, varsayılan): kestirilen dağılımdan B örneklem çekilir, her birinde parametreler yeniden kestirilir ve D^{*}_b hesaplanır (_ks_mc_p, normality.py:262–312):
Neden parametrik bootstrap?
Parametre veriden kestirildiğinde asimptotik Kolmogorov p'si, Lilliefors etkisi nedeniyle fazla büyüktür. Benzetimde parametreyi her örneklemde yeniden kestirmek, gözlenen D'nin kurulduğu süreci aynen yineler; böylece doğru sıfır dağılımı elde edilir. Parametre elle verilirse (sabit F_0) asimptotik p doğrudur ve Monte Carlo yapılmaz (normality.py:259–260).
Koddaki tercih
Rastgele sayı üreteci numpy.random.default_rng(tohum) (varsayılan 2000000); bellek için benzetimler \lfloor 2\cdot10^6/n\rfloor'lik parçalarla üretilir. p_{MC}=(b+1)/(B+1)'dir; b, D^{*}_b\ge D olan benzetim sayısıdır (Davison ve Hinkley 1997; Phipson ve Smyth 2010). Hiçbir benzetim gözleneni aşmasa da p sıfır olmaz: en küçük değer 1/(B+1)'dir. %99 GA aynı p ile kurulur. Bu bölümün sonuçları normallik kararına katılmaz.
3.5.9 Grafikler
Histogram np.histogram(x, bins="auto") ile çizilir (numpy "auto" = Sturges ile Freedman–Diaconis'in büyüğü; Betimsel modül yalnız Sturges kullanır). Normal eğri \bar x ve s (n-1) ile frekans ölçeğinde çizilir. Q–Q grafiği Blom konumlarını (i-3/8)/(n+1/4) ve \bar x+s\,z başvuru doğrusunu kullanır (normality.py:616–627); R qqline() ise birinci ve üçüncü çeyrekten geçen doğruyu çizer.
3.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/normality/elle_hesap.py ile hesaplanmıştır. Shapiro–Wilk dahil bütün testler, MerQur ve scipy'nin test işlevleri çağrılmadan formüllerden kurulmuştur; scipy yalnız normal ve ki-kare dağılım işlevleri için kullanılmıştır.
Adım 1 — Momentler. n=200, \bar x=6{,}2698, s=1{,}408447; m_2=1{,}973805, m_3=1{,}907452, m_4=11{,}685400.
Belirgin sağa çarpıklık (z=4{,}03>3{,}29), normal basıklık.
Adım 2 — Shapiro–Wilk. u=1/\sqrt{200}=0{,}070711; m_{200}=2{,}734780, m_{199}=2{,}403708, \sum m_i^2=196{,}546256.
Adım 3 — Lilliefors. D^{+}=0{,}081241, D^{-}=0{,}104456, D=0{,}104456. n>100 olduğundan K_d=0{,}104456\times2^{0{,}49}=0{,}146703, n_d=100:
Adım 4 — Anderson–Darling, Cramér–von Mises, Shapiro–Francia.
| Test | İstatistik | Düzeltilmiş | p |
|---|---|---|---|
| Anderson–Darling | A^2=2{,}660817 | A^{*}=2{,}670945 | 9{,}935\times10^{-7} |
| Cramér–von Mises | W^2=0{,}328421 | W^{*}=0{,}329242 | 1{,}550\times10^{-4} |
| Shapiro–Francia | W'=0{,}941674 | z=4{,}654136 | 1{,}627\times10^{-6} |
Anderson–Darling için 0{,}6\le A^{*}<10 dalı: p=\exp(1{,}2937-5{,}709\times2{,}670945+0{,}0186\times2{,}670945^2).
Adım 5 — D'Agostino K². Çarpıklık: Y=4{,}031207 (Adım 1'deki z_{G_1} ile aynı), \beta_2=3{,}159828, W^2=1{,}078378, \delta=5{,}148280, \alpha_D=5{,}051471:
Basıklık: E=2{,}970149, V=0{,}111360, x=(2{,}999405-2{,}970149)/\sqrt{0{,}111360}=0{,}087669; \sqrt{\beta_1}=0{,}967701, A=42{,}066673, Z_2=0{,}238392.
Adım 6 — Jarque–Bera.
Adım 7 — Karar. Otomatik seçimde (n=200) Shapiro–Wilk, Lilliefors ve D'Agostino'nun üçü de p<0{,}05 verir: "NORMAL DEĞİL (Güven: Yüksek)". Yedi testin tümü de reddeder. Toplu testte BMI (Shapiro–Wilk p=0{,}881) ve sistolik KB (p=0{,}275) "NORMAL" çıkar.
HbA1c'deki reddin iki kaynağı vardır: sağa çarpıklık (G_1=0{,}69) ve 26 gözlemin tam 4,5'te yığılması. Q–Q grafiğinin sol ucundaki yatay basamak bu yığılmadır (Şekil 3.1). Böyle bir alt sınır (ölçüm alt sınırı ya da veri üretiminde kırpma) normallik testlerinin gücünü belirgin biçimde artırır.
Adım 8 — Tek örneklem K-S.
| Dağılım | Parametre | D^{+} | D^{-} | D | Z | Asimptotik p | Monte Carlo p |
|---|---|---|---|---|---|---|---|
| Tekdüze | a=4{,}50, b=10{,}79 (veriden) | 0,364205 | 0,005000 | 0,364205 | 5,1506 | 1{,}81\times10^{-23} | 1/10001 |
| Üstel | ortalama 6,2698 (veriden) | 0,201064 | 0,512140 | 0,512140 | 7,2427 | 5{,}46\times10^{-46} | 1/10001 |
| Tekdüze | a=4, b=11 (elle) | 0,343571 | 0,071429 | 0,343571 | 4,8588 | 6{,}24\times10^{-21} | yapılmaz |
| Poisson (systolic_bp) | \lambda=125{,}18 (veriden) | 0,110810 | 0,106268 | 0,110810 | 1,5671 | 0,0147 | 1/10001 |
Tekdüze ve üstel benzetimlerde 10000 D^{*}'ın en büyüğü 0,1537 ve 0,1330'dur; gözlenen D bunların çok üstündedir. Üç dağılımda da hiçbir benzetim gözlenen D'ye ulaşmaz (b=0); bu yüzden p_{MC}=(0+1)/(10000+1)=0{,}0000999 olur ve %99 GA 0{,}0000999\pm2{,}5758\times0{,}0000999=[0;\ 0{,}000358]'dir. MerQur bunu "p<0{,}0001" ve "%99 GA [0.0000, 0.0004]" diye yazar. HbA1c üstel değildir (D⁻ büyük: küçük değerlerde üstel birikimli olasılık deneyselin çok üstünde). Poisson'da asimptotik p=0{,}015 iken Monte Carlo p çözünürlüğün alt sınırındadır (1/10001): kestirilmiş parametrede asimptotik p tutucudur. Sistolik KB'nin varyansı (247,8) Poisson'un öngördüğünün (125,2) iki katıdır.
3.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri normality.execute() çağrısından alınmıştır (dogrulama/normality/merqur_calistir.py); motor modülünde yalnız ondalıklı round bellekte etkisizleştirilmiştir. R: 4.5.3; shapiro.test, nortest::lillie.test/ad.test/cvm.test/sf.test, fBasics::dagoTest, tseries::jarque.bera.test, e1071::skewness/kurtosis(type = 2), ks.test(exact = FALSE). R'de Poisson K-S için hazır işlev kurulu olmadığından (dgof yok) D R'de ecdf ve ppois ile tamsayı ızgarasında elle hesaplanmıştır. Ölçüt: en büyük fark \le10^{-6}; p<10^{-3} olan değerlerde göreli fark. Monte Carlo p R'de yeniden üretilemez (farklı üreteç); MerQur ile ayrı Python uygulaması aynı tohumla karşılaştırılmıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Ortalama | 6,269800 | 6,269800 | 6,269800 | 0,0e+00 | ✓ |
| SS | 1,408447 | 1,408447 | 1,408447 | 4,2e−15 | ✓ |
| Çarpıklık G_1 | 0,693064 | 0,693064 | 0,693064 | 4,4e−16 | ✓ |
| Basıklık G_2 | 0,030000 | 0,030000 | 0,030000 | 8,5e−16 | ✓ |
| Çarpıklık z | 4,031207 | 4,031207 | 4,031207 | 0,0e+00 | ✓ |
| Basıklık z | 0,087669 | 0,087669 | 0,087669 | 2,5e−15 | ✓ |
| Shapiro–Wilk istatistiği | 0,939148 | 0,939148 | 0,939148 | 2,4e−10 | ✓ |
| Shapiro–Wilk p | 1,9335·10−7 | 1,9335·10−7 | 1,9335·10−7 | 9,1e−15 | ✓ |
| Lilliefors istatistiği | 0,104456 | 0,104456 | 0,104456 | 2,8e−17 | ✓ |
| Lilliefors p | 1,5666·10−5 | 1,5666·10−5 | 1,5666·10−5 | 2,7e−19 | ✓ |
| Anderson–Darling istatistiği | 2,660817 | 2,660817 | 2,660817 | 2,5e−14 | ✓ |
| Anderson–Darling p | 9,9350·10−7 | 9,9350·10−7 | 9,9350·10−7 | 1,6e−19 | ✓ |
| D'Agostino K^2 istatistiği | 14,224849 | 14,224849 | 14,224849 | 3,6e−15 | ✓ |
| D'Agostino K^2 p | 0,000815 | 0,000815 | 0,000815 | 2,2e−18 | ✓ |
| Jarque–Bera istatistiği | 15,771511 | 15,771511 | 15,771511 | 3,0e−14 | ✓ |
| Jarque–Bera p | 0,000376 | 0,000376 | 0,000376 | 1,7e−17 | ✓ |
| Cramér–von Mises istatistiği | 0,328421 | 0,328421 | 0,328421 | 5,6e−17 | ✓ |
| Cramér–von Mises p | 0,000155 | 0,000155 | 0,000155 | 3,0e−19 | ✓ |
| Shapiro–Francia istatistiği | 0,941674 | 0,941674 | 0,941674 | 1,6e−15 | ✓ |
| Shapiro–Francia p | 1,6267·10−6 | 1,6267·10−6 | 1,6267·10−6 | 4,4e−19 | ✓ |
| D'Agostino Z_1 (çarpıklık) | — | 3,764043 | 3,764043 | 7,5e−15 | ✓ |
| D'Agostino Z_2 (basıklık) | — | 0,238392 | 0,238392 | 3,4e−15 | ✓ |
| Shapiro–Wilk p (BMI) | 0,880784 | 0,880784 | 0,880784 | 9,3e−09 | ✓ |
| Lilliefors p (BMI) | 0,906091 | 0,906091 | 0,906091 | 7,2e−15 | ✓ |
| D'Agostino K^2 p (BMI) | 0,767130 | 0,767130 | 0,767130 | 9,0e−15 | ✓ |
| Shapiro–Wilk p (systolic_bp) | 0,274601 | 0,274600 | 0,274600 | 2,3e−08 | ✓ |
| Lilliefors p (systolic_bp) | 0,249138 | 0,249138 | 0,249138 | 7,2e−15 | ✓ |
| D'Agostino K^2 p (systolic_bp) | 0,350571 | 0,350571 | 0,350571 | 1,8e−15 | ✓ |
| K-S tekdüze D | 0,364205 | 0,364205 | 0,364205 | 3,9e−16 | ✓ |
| K-S tekdüze asimptotik p | 1,8121·10−23 | 1,8121·10−23 | 1,8121·10−23 | 5,9e−39 | ✓ |
| K-S üstel D | 0,512140 | 0,512140 | 0,512140 | 2,2e−16 | ✓ |
| K-S üstel asimptotik p | 5,4588·10−46 | 5,4588·10−46 | 5,4588·10−46 | 3,9e−61 | ✓ |
| K-S tekdüze D (elle a=4, b=11) | 0,343571 | 0,343571 | 0,343571 | 5,0e−16 | ✓ |
| K-S tekdüze p (elle parametre) | 6,2395·10−21 | 6,2395·10−21 | 6,2395·10−21 | 3,0e−36 | ✓ |
| K-S Poisson D (systolic_bp) | 0,110810 | 0,110810 | 0,110810 | 2,8e−17 | ✓ |
| K-S Poisson asimptotik p | 0,014722 | 0,014722 | 0,014722 | 4,0e−16 | ✓ |
| K-S Monte Carlo p (tekdüze / üstel; tohum 2000000, 10000 örneklem) | 9,9990·10−5 / 9,9990·10−5 | 9,9990·10−5 / 9,9990·10−5 | — | 0 | ✓ (aynı tohum) |
Sonuç: 37 büyüklüğün tamamı ölçütü karşılar. En büyük mutlak fark Shapiro–Wilk p'sinde (sistolik KB) 2{,}3\times10^{-8}'dir; R swilk.c ile scipy'nin Fortran uygulaması arasındaki kayan nokta farkıdır.
3.7 Çıktıyı okuma
MerQur'un sonuç metni (HbA1c; varsayılan otomatik seçim, toplu testte BMI ve systolic_bp):
Künyeye eklenen alanlar (build_extras): Ortalama 6.2698, SS 1.4084, Çarpıklık 0.6931, Basıklık 0.0300, Genel Karar "NORMAL DEĞİL (Güven: Yüksek)". Gövde metni:
TEST SONUÇLARI:
  Shapiro-Wilk                    ist.=0.9391  p<0.0001  ❌ Normal Değil
  Kolmogorov-Smirnov (Lilliefors)  ist.=0.1045  p<0.0001  ❌ Normal Değil
  D'Agostino-Pearson              ist.=14.2248  p=0.0008  ❌ Normal Değil

Çarpıklık = 0.6931 (SE = 0.1719, z = 4.031)  ·  Basıklık = 0.0300 (SE = 0.3422, z = 0.088)  — |z| > 1.96 (n < 50) / 3.29 (orta n) normallikten sapma işaretidir

Öneri: Parametrik olmayan karşılık (desene göre): bağımsız 2 grup → Mann-Whitney U, eşli → Wilcoxon, 3+ grup → Kruskal-Wallis, tekrarlı → Friedman

Toplu normallik testleri (ek sütunlar):
  [BMI] n=200  skew z=0.717  kurt z=-0.151  Genel Karar: NORMAL
      Shapiro-Wilk                    ist.=0.9960  p=0.8808
  [systolic_bp] n=200  skew z=-0.234  kurt z=-1.228  Genel Karar: NORMAL
      Shapiro-Wilk                    ist.=0.9913  p=0.2746
(Toplu testte her sütun için Lilliefors ve D'Agostino satırları da yazılır; burada kısaltılmıştır.)
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Künye: Ortalama, SS, Çarpıklık, Basıklık | 4 ondalıkla \bar x, s, G_1, G_2 | Betimsel modülüyle aynı tanım. |
Genel Karar |
NORMAL / NORMAL DEĞİL / BELİRSİZ ve güven | Oy birliği kuralı (3.5.7); tek başına karar aracı değildir. |
| Test satırları | Test adı, istatistik, p, etiket | p<0{,}0001 ise "p<0.0001" yazılır; etiket p>\alpha'ya göredir. |
| Çarpıklık/basıklık satırı | G_1, G_2, SES, SEK, z | Sapmanın türünü gösterir: burada çarpıklık, basıklık değil. |
Öneri |
Parametrik olmayan karşılıklar | Yalnız "NORMAL DEĞİL" kararında çıkar. |
| Atlanan test notu | "Not: … atlandı: n = …" | Seçilen testin n sınırı dışında kaldığını söyler (normality.py panel, satır 398–404). |
| Tek örneklem K-S bölümü | D (D⁺/D⁻), Z, p ve p türü | Monte Carlo satırında örneklem sayısı, tohum, %99 GA ve asimptotik p yazılır. |
| α satırı | "Karar ölçütü α = …" | Yalnız \alpha\neq0{,}05 ise çıkar. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
HbA1c değerlerinin normal dağılmadığı görüldü; Shapiro–Wilk W = 0{,}939, p < 0{,}001 (n = 200). Dağılım sağa çarpıktı (G_1 = 0{,}69; z = 4{,}03), basıklık normaldi (G_2 = 0{,}03; z = 0{,}09); 26 hastanın değeri ölçüm alt sınırı olan %4,5'teydi. BMI (W = 0{,}996, p = 0{,}88) ve sistolik kan basıncı (W = 0{,}991, p = 0{,}27) için normallik reddedilmedi. Bu nedenle HbA1c içeren karşılaştırmalarda parametrik olmayan yöntemler kullanıldı.
3.8 Uzman soruları
S1. Otomatik seçim neden n\ge300'de Shapiro–Wilk'i bırakıyor? Shapiro–Wilk 5000'e kadar geçerli.
Kural bir tercihtir (normality.py:439–451): büyük n'de MerQur EDF testlerine (Lilliefors, Anderson–Darling) ve D'Agostino'ya geçer. Royston yaklaşımı n\le5000'de geçerlidir ve güçlüdür; Shapiro–Wilk istenirse elle seçilebilir. Büyük örneklemde hangi test seçilirse seçilsin küçük sapmalar anlamlı çıkar; karar Q–Q grafiği ve etki büyüklüğüyle (çarpıklık/basıklık değerleri) verilmelidir.
S2. Lilliefors p'si R ile aynı mı?
Evet. MerQur Dallal–Wilkinson yaklaşımını ve p>0{,}1 bölgesinde Stephens formülünü nortest::lillie.test ile birebir uygular (normality.py:117–148); doğrulamada fark 10^{-19} düzeyindedir. statsmodels lilliefors farklı (tabloya dayalı) p verir; Python kullanıcısı bu farkı görebilir.
S3. Anderson–Darling neden n<8'de yapılmıyor?
Kullanılan p yaklaşımı (Stephens 1986; D'Agostino ve Stephens 1986) n\ge8 için türetilmiştir. Daha küçük n'de formül geçerli bir p vermez; geçersiz bir p yazmak, testi hiç yapmamaktan daha yanıltıcıdır. MerQur bu yüzden n<8'de testi atlar ve not yazar; R nortest::ad.test de n<8'i reddeder. Küçük örneklemde Shapiro–Wilk kullanılmalıdır.
S4. D'Agostino K²'yi n=12'de seçebiliyorum. Geçerli mi?
Elle seçimde alt sınır 8'dir (normality.py:461); scipy hesaplar ve 8\le n<20'de sonuca, basıklık yaklaşımının bu n'de zayıf olduğunu bildiren bir not eklenir. Basıklık bileşeninin normal yaklaşımı n\ge20 için önerilir ve R fBasics::dagoTest n<20'de hata verir. MerQur'un otomatik seçimi bu nedenle testi yalnız n\ge20'de ekler. Küçük örneklemde Shapiro–Wilk tercih edilmelidir.
S5. Monte Carlo p neden (b+1)/(B+1) ile hesaplanır?
Gözlenen veri de sıfır hipotezi altındaki olası örneklemlerden biridir; paya ve paydaya onu eklemek p'yi geçerli kılar. b/B birinci tür hatayı şişirir ve hiçbir benzetim gözleneni aşmadığında p=0 verir; bu geçersizdir (Davison ve Hinkley 1997; Phipson ve Smyth 2010). R chisq.test(simulate.p.value = TRUE) de aynı tanımı kullanır. B=10000'de en küçük p 1/10001\approx0{,}0001'dir; raporda "p\le0{,}0001 (Monte Carlo, B=10000)" biçiminde yazılır.
S6. Bağlı (yuvarlanmış) veride testler güvenilir mi?
Shapiro–Wilk ve EDF testleri sürekli veri varsayar. Çok sayıda bağ (ör. 26 gözlemin 4,5'te toplanması ya da tamsayı mmHg) W'yi küçültür ve D'yi büyütür; test "normal değil" demeye yatkınlaşır. Bu veride HbA1c reddinin bir kısmı yığılmadan gelir. Yığılma bir ölçüm sınırıysa sansürlü veri yöntemleri, yuvarlamaysa Q–Q grafiği ile birlikte yorum önerilir.
S7. Q–Q grafiğindeki doğru R'dekiyle neden aynı değil?
MerQur \bar x+s\,z doğrusunu ve Blom konumlarını kullanır (normality.py:616–627). R qqnorm + qqline ise n\le10'da (i-3/8)/(n+1-3/4), büyük n'de (i-1/2)/n konumunu ve birinci–üçüncü çeyrekten geçen doğruyu çizer. Çarpık veride iki doğru belirgin biçimde ayrılır; noktalar aynı, başvuru doğrusu farklıdır.
S8. \alpha'yı değiştirmek p'yi etkiler mi?
Hayır; yalnız etiketleri ve genel kararı etkiler. \alpha\ne0{,}05 ise metne "Karar ölçütü α = …" satırı eklenir (normality.py panel, satır 316–319). Form aralığı 0,01–0,10'dur.
S9. Genel karar "BELİRSİZ" çıktı. Hangi teste güvenmeliyim?
Testler farklı sapmalara duyarlıdır: D'Agostino çarpıklık/basıklığa, Anderson–Darling kuyruklara, Lilliefors dağılımın ortasına, Shapiro–Wilk genele. Ayrışma, sapmanın türünü gösterir. Önceden belirlenmiş tek testin (çoğu durumda Shapiro–Wilk) sonucu raporlanmalı, Q–Q grafiği ve z_{G_1}, z_{G_2} ile birlikte yorumlanmalıdır. Birden çok testin "en uygununu" sonradan seçmek birinci tür hatayı şişirir.
3.9 Sık hatalar ve tuzaklar
- p>0{,}05'i "normal olduğu kanıtlandı" diye okumak. Küçük örneklemde testlerin gücü düşüktür; reddedilmemek normallik kanıtı değildir.
- Büyük örneklemde her reddi ciddiye almak. n=2000'de önemsiz bir çarpıklık bile p<0{,}001 verir; t testi ve ANOVA bu sapmalara sağlamdır.
- Ham değişkeni sınamak, artıkları sınamamak. Regresyon ve ANOVA'nın varsayımı artıklar içindir; gruplar arası ortalama farkı, ham değişkeni "normal değil" gösterebilir.
- Gruplu tasarımda tüm veriyi birlikte sınamak. İki farklı merkezli normal grup birleşince çift tepeli bir dağılım çıkar; "Gruba göre" seçeneği kullanılmalıdır.
- Yığılmayı gözden kaçırmak. Alt ya da üst ölçüm sınırında toplanan değerler (HbA1c = 4,5) testleri reddettirir; sorun dağılımın biçimi değil ölçümdür.
- Tek örneklem K-S'de asimptotik p'yi kestirilmiş parametreyle kullanmak. Parametre veriden geliyorsa Monte Carlo p (varsayılan) raporlanmalıdır.
- Monte Carlo p'nin çözünürlüğünü unutmak. En küçük değer 1/(B+1)'dir; daha küçük bir p iddia edilemez, B raporda yazılmalıdır.
- Elle seçilen testin atlandığını fark etmemek. n sınırı dışındaki testler sonuçta görünmez; yalnız "Not: … atlandı" satırı vardır.
3.10 Kaynaklar
- Anderson, T. W., & Darling, D. A. (1952). Asymptotic theory of certain "goodness of fit" criteria based on stochastic processes. The Annals of Mathematical Statistics, 23(2), 193–212. https://doi.org/10.1214/aoms/1177729437
- Anscombe, F. J., & Glynn, W. J. (1983). Distribution of the kurtosis statistic b₂ for normal samples. Biometrika, 70(1), 227–234. https://doi.org/10.1093/biomet/70.1.227
- D'Agostino, R. B., Belanger, A., & D'Agostino, R. B., Jr. (1990). A suggestion for using powerful and informative tests of normality. The American Statistician, 44(4), 316–321. https://doi.org/10.1080/00031305.1990.10475751
- D'Agostino, R., & Pearson, E. S. (1973). Tests for departure from normality. Empirical results for the distributions of b₂ and √b₁. Biometrika, 60(3), 613–622. https://doi.org/10.1093/biomet/60.3.613
- D'Agostino, R. B., & Stephens, M. A. (Ed.). (1986). Goodness-of-fit techniques. Marcel Dekker.
- Dallal, G. E., & Wilkinson, L. (1986). An analytic approximation to the distribution of Lilliefors's test statistic for normality. The American Statistician, 40(4), 294–296. https://doi.org/10.1080/00031305.1986.10475419
- Davison, A. C., & Hinkley, D. V. (1997). Bootstrap methods and their application. Cambridge University Press. https://doi.org/10.1017/CBO9780511802843
- Ghasemi, A., & Zahediasl, S. (2012). Normality tests for statistical analysis: A guide for non-statisticians. International Journal of Endocrinology and Metabolism, 10(2), 486–489. https://doi.org/10.5812/ijem.3505
- Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review, 55(2), 163–172. https://doi.org/10.2307/1403192
- Kim, H.-Y. (2013). Statistical notes for clinical researchers: Assessing normal distribution (2) using skewness and kurtosis. Restorative Dentistry & Endodontics, 38(1), 52–54. https://doi.org/10.5395/rde.2013.38.1.52
- Lilliefors, H. W. (1967). On the Kolmogorov-Smirnov test for normality with mean and variance unknown. Journal of the American Statistical Association, 62(318), 399–402. https://doi.org/10.1080/01621459.1967.10482916
- Razali, N. M., & Wah, Y. B. (2011). Power comparisons of Shapiro-Wilk, Kolmogorov-Smirnov, Lilliefors and Anderson-Darling tests. Journal of Statistical Modeling and Analytics, 2(1), 21–33.
- Royston, P. (1992). Approximating the Shapiro-Wilk W-test for non-normality. Statistics and Computing, 2(3), 117–119. https://doi.org/10.1007/BF01891203
- Royston, P. (1993). A pocket-calculator algorithm for the Shapiro-Francia test for non-normality: An application to medicine. Statistics in Medicine, 12(2), 181–184. https://doi.org/10.1002/sim.4780120209
- Royston, P. (1995). Remark AS R94: A remark on algorithm AS 181: The W-test for normality. Applied Statistics, 44(4), 547–551. https://doi.org/10.2307/2986146
- Shapiro, S. S., & Francia, R. S. (1972). An approximate analysis of variance test for normality. Journal of the American Statistical Association, 67(337), 215–216. https://doi.org/10.1080/01621459.1972.10481232
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3–4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Stephens, M. A. (1974). EDF statistics for goodness of fit and some comparisons. Journal of the American Statistical Association, 69(347), 730–737. https://doi.org/10.1080/01621459.1974.10480196