5. Bağımsız İki Örneklem t Testi
Analiz kimliği: ttest · Menü adı: Bağımsız t-Testi · Panel: gui/panels/analyses/independent_ttest.py · Motor: stats/hypothesis.py, HypothesisTests.independent_ttest (satır 3336–3572)
5.1 Ne işe yarar
Bağımsız t testi, birbirinden bağımsız iki grubun sürekli bir değişkendeki ortalamalarının eşit olup olmadığını sınar. Cevapladığı soru şudur: "İki grubun ortalamaları arasındaki gözlenen fark, yalnız örnekleme rastlantısıyla açıklanabilir mi?"
Sıfır ve seçenek hipotezleri, varsayılan çift yönlü sınamada şöyledir:
- \mu_1,\ \mu_2: birinci ve ikinci grubun evren ortalaması (bilinmez; örneklem ortalamalarıyla kestirilir).
- Grupların hangisinin "1." olduğu MerQur'da verideki ilk görülme sırasıyla belirlenir (bkz. 5.5.1).
Ne zaman kullanılır? Gruplar farklı kişilerden oluşuyorsa (ilaç ve plasebo, kadın ve erkek), bağımlı değişken aralık ya da oran ölçeğindeyse ve her grupta dağılım kabaca normalse ya da grup büyüklükleri merkezi limit teoreminin işlemesine yetecek kadar büyükse.
Ne zaman kullanılmaz?
- Aynı kişilerde iki ölçüm (öncesi–sonrası) varsa: gözlemler eşleşiktir, Eşleştirilmiş t Testi gerekir.
- İkiden çok grup varsa: Tek Yönlü ANOVA (MerQur grup sayısı 2 değilse hata verir).
- Küçük örneklemde belirgin çarpıklık ya da aykırı değer varsa: Mann–Whitney U veya permütasyon testi.
- Gözlemler kümeli ise (aynı hekimin hastaları, aynı sınıfın öğrencileri): bağımsızlık bozulur; karma model gerekir.
- Sonuç ikili ya da sayım verisiyse: oranlar için ki-kare, sayımlar için Poisson modeli.
Sık karıştırılan analizler. Tek örneklem t testi bir grubu sabit bir değerle karşılaştırır. Eşleştirilmiş t testi farkların ortalamasını sınar. Welch t testi ayrı bir analiz değildir; bu modülün varyans seçeneklerinden biridir. Bayesçi t testi (BEST) aynı soruyu sonsal dağılımla yanıtlar.
5.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsızlık | Her gözlem tek bir kişiden gelir; gruplar arasında ve grup içinde gözlemler birbirini etkilemez. | Tasarımla sağlanır; istatistiksel denetimi yoktur. |
| Normallik | Her grupta değişken (ya da ortalamanın örnekleme dağılımı) yaklaşık normaldir. | Varsayılan açık Shapiro–Wilk (grup başına, 3\le n\le 5000). |
| Varyans eşitliği | Yalnız Student t için gerekir: \sigma_1^2=\sigma_2^2. Welch t bu varsayımı istemez. | Varsayılan açık Levene (ortalama merkezli); ek olarak Brown–Forsythe satırı; isteğe bağlı Bartlett ve folded F. |
| Ölçek | Bağımlı değişken sayısal; grup değişkeninde tam iki düzey. | Sayısal olmayan değerler pd.to_numeric(..., errors="coerce") ile eksik sayılıp atılır; düzey sayısı 2 değilse hata. |
Eksik değer. Grup değeri eksik olan satır hiçbir gruba girmez. Bağımlı değişkeni eksik ya da sayıya çevrilemeyen satır kendi grubundan çıkarılır (hypothesis.py:3357–3358). Künyedeki n, df[[grup, değer]].dropna() satır sayısıdır (stats_panel.py:5625–5626).
Uç durumlar (hypothesis.py:3362–3375): n_1<1, n_2<1 ya da n_1+n_2<3 ise hata; Welch zorlanmış ve bir grupta n<2 ise hata; iki grupta da tüm değerler sabitse (s_1=s_2=0) hata. Otomatik seçimde bir grupta n=1 ise Levene tanımsız olduğundan Student kullanılır.
5.3 Parametreler
Aşağıdaki tablo, formdaki her seçeneği arayüzdeki Türkçe adıyla verir. Varsayılanlar independent_ttest.py:39–117 ve _advanced_options.py içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Grup Sütunu | veriye bağlı | Tam iki düzeyli gruplama değişkeni. | Düzey sırası (5.5.1) farkın, t'nin ve d'nin işaretini belirler. |
| Değer Sütunu | veriye bağlı | Karşılaştırılan sayısal değişken; çoklu seçilebilir. | Birden çok sütun seçilirse her biri için ayrı test yapılır; çoklu karşılaştırma düzeltmesi uygulanmaz. |
| Varyans | Otomatik (Levene) | Otomatik: Levene p>\alpha ise Student, değilse Welch. Eşit (klasik t): her zaman Student. Welch (eşit değil): her zaman Welch. | t, sd, p, SH ve GA değişir; d değişmez (her durumda havuzlanmış SS). |
| Güven Düzeyi | %95 | %90, %95, %99 ya da 80–99,9 arası özel değer; \alpha=1-\text{düzey}. | GA genişliği, H₀ kararı ve Otomatik modda Levene eşiği bu \alpha ile belirlenir. |
| Hipotez yönü | Çift yönlü (≠) | Sağ yönlü: H_1:\mu_1>\mu_2; sol yönlü: H_1:\mu_1<\mu_2. | p tek kuyruktan hesaplanır; ana GA çift yönlü kalır, ayrıca tek yönlü GA satırı eklenir. |
| Etki büyüklükleri: Hedges g | kapalı | g=d\cdot J (kesin gama biçimi). | Ek satır. |
| Etki büyüklükleri: Glass Δ | kapalı | (Deney − kontrol) / kontrol grubunun SS'si (Glass 1976, düzeltmesiz); kontrol grubu adıyla yazılır. | İki ek satır: düzeltmesiz Δ ve küçük örneklem düzeltmeli Δ. |
| Glass Δ kontrol grubu | boş (2. grup) | Paydası alınacak grubun adı. | Payda ve farkın yönü bu gruba göre kurulur; bulunamazsa 2. grup kullanılır ve not yazılır. |
| Etki büyüklükleri: CLES | kapalı | \Phi(d/\sqrt2). | Ek satır. |
| Etki büyüklükleri: %GA | kapalı | d için normal yaklaşımlı GA. | Ek satır. |
| Etki büyüklükleri: d GA (nct) | kapalı | d için merkezî olmayan t dağılımına dayalı kesin GA. | Ek satır. |
| Varsayım kontrolleri: Shapiro | açık | Grup başına Shapiro–Wilk W ve p. | Yalnız bilgi; test seçimini değiştirmez. |
| Varsayım kontrolleri: Levene | açık | Ortalama merkezli Levene + Brown–Forsythe satırı. | Yalnız gösterim; Otomatik kararı bu kutudan bağımsız olarak her zaman hesaplanır. |
| Varsayım kontrolleri: Bartlett | kapalı | Normallik altında varyans eşitliği testi. | Ek satır. |
| Varsayım kontrolleri: Varyans oranı (folded F) | kapalı | Büyük/küçük varyans oranı, iki yönlü p. | Ek satır. |
| Ek çıktı: Betimsel | açık | Grup başına n, ortalama, SS, SH, medyan, en küçük/en büyük, çarpıklık, basıklık. | Ek bölüm. |
| Ek çıktı: Bootstrap GA | kapalı | Ortalama farkı için 5000 yinelemeli yüzdelik GA. | Ek satır; Tohum ile tekrarlanabilir. |
| Ek çıktı: Student + Welch iki satır | kapalı | İki testin satırlarını birlikte tablo olarak verir. | Ek tablo; ana sonuç seçilen teste göre kalır. |
| Eşdeğerlik testi: TOST, alt, üst | kapalı; −0,5 ve 0,5 | İki tek yönlü test (ham birimde sınırlar). | Ek bölüm. |
| Grafik | Kutu grafiği | Kutu grafiği, grup başına normal Q–Q ya da ortalama ± GA. | Yalnız Grafik sekmesi. |
| Tohum | 12345 | Bootstrap rastgele sayı üretecinin tohumu. | Yalnız bootstrap GA'sını etkiler. |
Neden Levene eşiği güven düzeyine bağlı?
Otomatik seçim, use_equal_var = lev_p > alpha satırıyla yapılır (hypothesis.py:3378) ve alpha formdaki güven düzeyinden gelir (stats_panel.py:4823–4843). Güven düzeyi %99 seçilirse Levene eşiği 0,01 olur; varyanslar arasında 0,01 < p ≤ 0,05 aralığında bir fark varsa %95'te Welch, %99'da Student uygulanır. Bu, kullanıcının yalnız GA genişliğini değiştirdiğini sanırken testin kendisinin de değişebileceği anlamına gelir.
5.4 Tıp örneği
Dosya: english/datasets/Tip/04_independent_t_drug_HbA1c.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/04_bagimsiz_t_ilac_HbA1c.xlsx; aynı sayılar, sütun adları Türkçe).
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
group |
Grup Sütunu | metin, 2 düzey | drug (yeni ilaç), placebo |
HbA1c_change |
Değer Sütunu | sürekli | Çalışma sonu HbA1c − başlangıç HbA1c (yüzde puanı); negatif değer düşüş demektir. |
patient_id, age |
kullanılmaz |
n ve eksik değer: 115 hasta; drug 55, placebo 60. Hiçbir sütunda eksik değer yoktur. Veride ilk satır drug olduğundan 1. grup drug, fark yönü \mu(\text{drug})-\mu(\text{placebo})'dur.
Klinik soru: Yeni ilaç, plaseboya göre HbA1c'yi daha fazla düşürüyor mu? Fark varsa büyüklüğü klinik olarak anlamlı mı?
Seçilen ayarlar: Arayüz varsayılanları (Varyans: Otomatik (Levene); %95; çift yönlü; Shapiro, Levene ve Betimsel açık). Etki büyüklüğü ve ek satırların sayısal yürüyüşü için tüm isteğe bağlı kutular da işaretlenerek ikinci bir çalıştırma yapılmıştır.
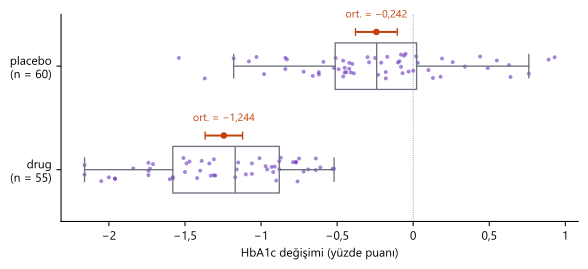
Şekil 5.1. İki grupta HbA1c değişimi. Noktalar hastalar, kutular çeyrekler arası aralık, turuncu çizgi ortalama ± %95 GA.
5.5 Formüller ve hesap adımları
MerQur'un izlediği sıra şudur: (1) grupları ayır, (2) uç durumları denetle, (3) Levene ile Student/Welch kararını ver, (4) t ve p'yi hesapla, (5) ortalama farkının GA'sını seçilen testin SH ve sd'siyle kur, (6) etki büyüklüklerini ve istenen ek satırları ekle.
5.5.1 Grupların belirlenmesi
Gruplar MerQur'un ortak düzey sırası kuralıyla alınır (_ordered_levels, core.cat_order): (1) kullanıcının Veri sekmesinde tanımladığı sıra ya da sıralı kategorik; (2) etiketler sayıysa ya da sayı içeriyorsa sayısal/doğal sıra ("hafta4" < "hafta12"); (3) hiçbiri yoksa verideki ilk görülme sırası. Alfabetik sıra kendiliğinden kullanılmaz. Bu veride etiketler metin olduğundan ilk görülme sırası geçerlidir: 1. grup drug.
Neden alfabetik sıra kullanılmaz?
Alfabetik sıra etiketin dilinden ve yazımından gelen keyfi bir sıradır: aynı veride "Hasta/Sağlıklı" ile "Patient/Healthy" ters düşer ve farkın işareti arayüz diline göre değişir. Kullanıcının verisini girdiği sıra, sıra bilgisinin en iyi vekilidir. Aynı kural Mann–Whitney U ve öteki iki grup testlerinde de geçerlidir; fark yönü sonuç metninde (μ(drug) − μ(placebo)) açıkça yazılır. R'de t.test(y ~ g) faktör düzeylerini alfabetik alır; R ile karşılaştırırken factor(g, levels = …) ile sıra verilmelidir.
5.5.2 Betimsel istatistikler
- x_{ij}: i. gruptaki j. hastanın HbA1c değişimi.
- n_i: i. gruptaki geçerli gözlem sayısı.
- \bar x_i: grup ortalaması; s_i^2: grup varyansı; s_i: standart sapma (SS).
- \SH(\bar x_i): ortalamanın standart hatası.
Neden n-1?
Sapmalar evren ortalaması \mu_i'den değil, aynı veriden kestirilen \bar x_i'den alınır. \sum (x_{ij}-\bar x_i)=0 kısıtı nedeniyle n_i sapmadan yalnız n_i-1 tanesi serbesttir; n_i'ye bölmek \sigma^2'yi sistematik olarak küçük kestirir. n_i-1'e bölme kestiriciyi yansız yapar: E(s_i^2)=\sigma_i^2. Kodda g1.var() pandas varsayılanı ddof=1 ile hesaplanır.
5.5.3 Levene testi ve Student/Welch kararı
MerQur Levene testini ortalama merkezli çalıştırır: scipy_stats.levene(g1, g2, center="mean") (hypothesis.py:3377). Önce her gözlemin kendi grup ortalamasından mutlak sapması alınır, sonra bu sapmalar üzerinde tek yönlü ANOVA yapılır:
- z_{ij}: gözlemin grup ortalamasından mutlak uzaklığı (yayılımın gözlem düzeyindeki ölçüsü).
- \bar z_i: i. grupta z'lerin ortalaması; \bar z: tüm z'lerin ortalaması.
- N=n_1+n_2; k=2 grup sayısı.
- W: F_{k-1,N-k} dağılımına göre değerlendirilir; büyük W yayılımların farklı olduğunu gösterir.
Neden ortalama merkezli?
scipy'nin varsayılanı center="median" (Brown–Forsythe biçimi) iken MerQur ortalama merkezli biçimi seçer; bu, R car::leveneTest(center = mean) ile aynı tanımdır. Medyan merkezli biçim çarpık dağılımlarda daha sağlamdır; bu yüzden MerQur onu da ek bilgi olarak "Brown-Forsythe (medyan merkezli Levene)" satırında verir (_levene_lines, hypothesis.py:393–405). Otomatik karar yalnız ortalama merkezli p ile verilir.
Karar kuralı (hypothesis.py:3378): Varyans "Otomatik" ise p_{\text{Levene}}>\alpha \Rightarrow Student, aksi halde Welch.
5.5.4 Student t (eşit varyans)
- s_p^2: havuzlanmış (birleştirilmiş) varyans; iki grubun varyanslarının serbestlik dereceleriyle ağırlıklı ortalaması.
- \SH_S: iki ortalama arasındaki farkın standart hatası (eşit varyans altında).
- t: farkın kendi standart hatasına oranı; H₀ doğruysa t_{\sd} dağılımına uyar.
- \sd=n_1+n_2-2: iki ortalama kestirildiği için toplam gözlemden 2 düşülür.
Neden havuzlanmış varyans ve neden n_1+n_2-2?
Varyanslar eşitse (\sigma_1^2=\sigma_2^2=\sigma^2), her iki grup aynı \sigma^2'nin kestirimini taşır. En verimli ortak kestirim, her grubun kareler toplamını birleştirip toplam serbestlik derecesine bölmektir. Payda (n_1-1)+(n_2-1)'dir; çünkü her grupta bir ortalama kestirilmiştir. Bu durumda t, normallik altında tam olarak t_{n_1+n_2-2} dağılımına uyar (Student 1908).
5.5.5 Welch t (eşit olmayan varyans)
- v_i: i. grubun ortalamasının kestirilen varyansı (\SH^2).
- \SH_W: varyanslar havuzlanmadan bulunan fark standart hatası.
- \nu: Welch–Satterthwaite yaklaşık serbestlik derecesi; genellikle tam sayı değildir.
Neden Welch–Satterthwaite serbestlik derecesi?
Varyanslar farklıysa (\bar x_1-\bar x_2)/\SH_W tam bir t dağılımına uymaz (Behrens–Fisher sorunu). Satterthwaite (1946), v_1+v_2 gibi varyans bileşenleri toplamının dağılımını, ilk iki momenti eşleyen ölçeklenmiş bir \chi^2 dağılımıyla yaklaştırdı; bu eşleştirmeden yukarıdaki \nu çıkar. Welch (1947) aynı yaklaşımı iki örneklem sorununa uyguladı. \nu, \min(n_1,n_2)-1 ile n_1+n_2-2 arasında kalır; varyanslar ve grup büyüklükleri dengeliyse üst sınıra yaklaşır. MerQur p'yi scipy.stats.ttest_ind(..., equal_var=False) ile, kesirli sd'li t dağılımından hesaplar; yuvarlama yapmaz.
5.5.6 p değeri ve karar
p<\alpha ise "H₀ REDDEDİLİR" yazılır (hypothesis.py:3405). Anlamlılık yıldızı seçilen \alpha'ya bağlıdır (_sig_alpha): p\ge\alpha ise ns; p<\alpha ise p<0{,}001 → ***, <0{,}01 → **, <0{,}05 → *; \alpha>0{,}05 ve 0{,}05\le p<\alpha ise *. Yıldız ile karar bu yüzden çelişmez.
5.5.7 Ortalama farkının güven aralığı
Kodda ci_df ve se, uygulanan testin değerleridir (hypothesis.py:3393–3402): Student'ta \SH_S ve n_1+n_2-2, Welch'te \SH_W ve \nu. Ana GA, tek yönlü hipotez seçilse bile çift yönlüdür; tek yönlü seçimde ek bir satır [\,\hat\Delta-t_{1-\alpha}\SH,\ \infty) ya da (-\infty,\ \hat\Delta+t_{1-\alpha}\SH\,] verir (_one_sided_ci, hypothesis.py:1898–1904).
5.5.8 Etki büyüklükleri
Cohen d (ana tabloda her zaman verilir):
Koddaki tercih
_cohen_d (hypothesis.py:226–229) her zaman havuzlanmış SS kullanır; Welch seçildiğinde de d değişmez. Büyüklük etiketi |d|'ye göredir: <0{,}2 önemsiz, <0{,}5 küçük, <0{,}8 orta, aksi halde büyük (hypothesis.py:232–237).
Hedges g (küçük örneklem düzeltmesi):
- J: d'nin beklenen değerindeki yukarı yanlılığı gideren çarpan; her zaman <1.
- \Gamma: gama fonksiyonu; kodda sayısal taşmayı önlemek için logaritmik biçimde (
gammaln) hesaplanır. - \nu_p: havuzlanmış varyansın serbestlik derecesi (Welch seçilse de bu değer kullanılır).
Neden düzeltme ve neden kesin biçim?
d, evren etki büyüklüğü \delta'nın yanlı bir kestiricisidir: E(d)\approx\delta/J. Hedges (1981) yansız kestiricinin J\cdot d olduğunu gösterdi. Sık kullanılan J\approx 1-3/(4\nu_p-1) yaklaşık biçimdir. MerQur kesin gama biçimini kullanır (_hedges_J, hypothesis.py:298–307). Bu veride fark ihmal edilebilir (J_{\text{kesin}}=0{,}993346, J_{\text{yaklaşık}}=0{,}993348); küçük sd'de üçüncü ondalıkta ayrılır.
Glass Δ ve CLES:
- K: kontrol grubu; "Glass Δ kontrol grubu" kutusunda adıyla seçilir, boşsa düzey sırasındaki 2. grup alınır. D: öteki (deney) grubu. Çıktı kontrol grubunu adıyla yazar.
- s_K: kontrol grubunun SS'si (Glass 1976'nın özgün, düzeltmesiz tanımı; ana değer).
- \Delta_{\text{düz}}: Hedges (1981) J çarpanıyla küçük örneklem düzeltmeli Δ (\nu=n_K-1); ek satırda verilir.
- \Phi: standart normal birikimli dağılım fonksiyonu.
- CLES: rastgele seçilen bir 1. grup hastasının değerinin, rastgele seçilen bir 2. grup hastasının değerinden büyük olma olasılığı; iki normal dağılım ve eşit varyans varsayar (McGraw ve Wong 1992).
d için güven aralıkları. "%GA" kutusu normal yaklaşımı kullanır (_d_se_ind, hypothesis.py:328–329):
"d GA (nct)" kutusu kesin aralığı verir (_nct_ci, hypothesis.py:1807–1827). Student t istatistiği, merkezî olmayan t dağılımına uyar; merkezî olmama parametresi \lambda=\delta/\sqrt{1/n_1+1/n_2}'dir. \lambda için sınırlar
denklemlerinin kökleridir (Brent yöntemi); d sınırları \lambda\sqrt{1/n_1+1/n_2} ile bulunur. Bu tanım R effectsize::cohens_d ve MBESS::ci.smd ile aynıdır (Cumming ve Finch 2001).
5.5.9 Ek varyans testleri
Bartlett (hypothesis.py:692):
Payda, küçük örneklemde \chi^2 yaklaşımını iyileştiren düzeltme çarpanıdır (C). Bartlett normallikten sapmaya duyarlıdır; bu yüzden MerQur'da varsayılan kapalıdır.
Folded F (hypothesis.py:3485–3506): F=s_{\text{büyük}}^2/s_{\text{küçük}}^2, sd (n_{\text{büyük}}-1,\ n_{\text{küçük}}-1), p=\min\{1,\ 2\,P(F_{d_1,d_2}\ge F)\}. R var.test ile aynıdır.
5.5.10 Bootstrap ve TOST
Bootstrap GA (_boot_diff_ci, hypothesis.py:348–359): iki grup ayrı ayrı yerine koyarak yeniden örneklenir (her grupta kendi n_i'si korunur), B=5000 fark ortalaması hesaplanır; sınırlar bu dağılımın \alpha/2 ve 1-\alpha/2 yüzdelikleridir (yüzdelik yöntem; BCa değil). Rastgele sayı üreteci numpy.random.default_rng(tohum) ve varsayılan tohum 12345'tir.
TOST (_tost_lines, hypothesis.py:1870–1896): eşdeğerlik sınırları [\Delta_L,\Delta_U] ham birimdedir.
p_{\text{TOST}}<\alpha ise eşdeğerlik kabul edilir; bu, (1-2\alpha) GA'nın sınırlar içinde kalmasıyla aynı karardır. SH ve sd uygulanan testten (Student ya da Welch) alınır.
5.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Aşağıdaki ara değerler dogrulama/elle_hesap.py ile, MerQur kodu çağrılmadan numpy ile hesaplanmıştır. Metinde 6 anlamlı ondalık gösterilir; hesap tam hassasiyetle yürütülmüştür.
Adım 1 — Grup toplamları ve ortalamalar.
Adım 2 — Kareler toplamı, varyans, SS ve SH.
| drug (1) | placebo (2) | |
|---|---|---|
| n_i | 55 | 60 |
| \sum (x-\bar x)^2 | 11,216153 | 16,643298 |
| s_i^2 | 11,216153 / 54 = 0,207707 | 16,643298 / 59 = 0,282090 |
| s_i | 0,455748 | 0,531121 |
| \SH(\bar x_i)=s_i/\sqrt{n_i} | 0,061453 | 0,068567 |
| Medyan | −1,1700 | −0,2400 |
| Çarpıklık / basıklık | −0,314 / −0,939 | 0,031 / 0,111 |
Adım 3 — Levene (ortalama merkezli). Mutlak sapmaların grup ortalamaları \bar z_1=0{,}389898, \bar z_2=0{,}410167. Gruplar arası kareler toplamı 0{,}011789 (sd 1), grup içi kareler toplamı 9{,}404145 (sd 113):
p=0{,}7073>0{,}05 olduğu için Otomatik modda Student t uygulanır. Brown–Forsythe (medyan merkezli) aynı sonucu verir: W=0{,}155210, p=0{,}694347.
Adım 4 — Student t.
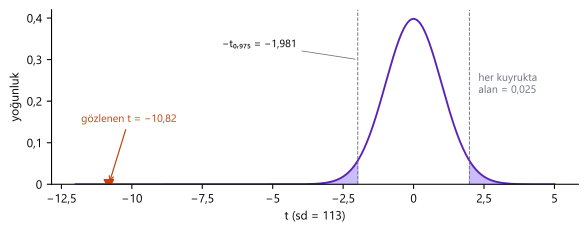
Adım 5 — Güven aralığı. t_{0{,}975;\,113}=1{,}981180; yarı genişlik 1{,}981180\times0{,}092691=0{,}183638:
Şekil 5.2. H₀ altında t(113) dağılımı. Gölgeli alanlar %5'lik çift yönlü red bölgesidir (|t| > 1,981). Gözlenen t = −10,82 red bölgesinin çok dışındadır.
Adım 6 — Welch (karşılaştırma için).
Varyans oranı 1,36 ve grup büyüklükleri yakın olduğundan \nu (112,53) Student sd'sine (113) çok yakındır; iki test pratikte aynı sonucu verir.
Adım 7 — Etki büyüklükleri.
Glass Δ'da kontrol grubu kutusu boş bırakıldığından kontrol grubu düzey sırasındaki 2. grup, yani placebo'dur (n_K=60, s_K=0{,}531121):
CLES = 0,077: rastgele seçilen bir ilaç hastasının HbA1c değişiminin rastgele seçilen bir plasebo hastasınınkinden büyük (yani daha az düşüş) olma olasılığı yaklaşık %7,7'dir. Tersinden okunursa ilaç hastalarının yaklaşık %92'si plasebo hastalarından daha fazla düşüş gösterir.
d için normal yaklaşımlı GA:
d için merkezî olmayan t GA: \lambda_{\text{alt}}=-13{,}213215, \lambda_{\text{üst}}=-8{,}386086; \sqrt{1/55+1/60}=0{,}186677 ile çarpılınca [-2{,}466610;\ -1{,}565493].
Adım 8 — Normallik ve diğer varyans testleri.
| Test | İstatistik | p | MerQur etiketi |
|---|---|---|---|
| Shapiro–Wilk, drug | W=0{,}9570 | 0,0472 | İHLAL |
| Shapiro–Wilk, placebo | W=0{,}9872 | 0,7831 | karşılanıyor |
| Bartlett | T=1{,}298353 (C=1{,}008873) | 0,254514 | karşılanıyor |
| Folded F | F(59,\,54)=0{,}282090/0{,}207707=1{,}358117 | 0,256159 | karşılanıyor |
| Bootstrap %95 GA (tohum 12345) | [-1{,}1850;\ -0{,}8228] |
İlaç grubunda Shapiro–Wilk p=0{,}047 ile sınırda bir normallik ihlali vardır. Basıklığın negatif (−0,94), çarpıklığın küçük (−0,31) olması dağılımın kuyruklarının normalden ince olduğunu gösterir; bu tür sapma t testinin geçerliliğini pek etkilemez. n=55'te ortalamanın örnekleme dağılımı merkezi limit teoremiyle normale yakındır. Dağılımdan bağımsız bootstrap aralığı [-1{,}185;\ -0{,}823], Student aralığıyla neredeyse aynıdır; bu da sonucun normallik varsayımına dayanmadığını doğrular.
5.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() çağrısının döndürdüğü sonuç nesnesinden alınmıştır. Motor modülündeki gösterim yuvarlamaları doğrulama sırasında devre dışı bırakılmış (yalnız round(); hesap mantığı değişmemiştir, dogrulama/merqur_calistir.py --tam), böylece tam hassasiyetli değerler karşılaştırılmıştır. Yalnız sonuç metninde yazılan değerlerde (Brown–Forsythe, Bartlett, Shapiro–Wilk, Hedges g, Glass Δ, CLES) MerQur'un gösterdiği ondalık sayısında eşleşme aranmıştır. R: 4.5.3, t.test, car::leveneTest, bartlett.test, var.test, shapiro.test, effectsize::cohens_d/hedges_g, effectsize::glass_delta(adjust = FALSE) ve glass_delta(adjust = TRUE). Ölçüt: en büyük mutlak fark \le 10^{-6} (değer 1'den büyükse göreli).
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Ortalama farkı \bar x_1-\bar x_2 | −1,002530 | −1,002530 | −1,002530 | 3,6e−15 | ✓ |
| Student SH | 0,092691 | 0,092691 | 0,092691 | 1,4e−17 | ✓ |
| Student t | −10,815796 | −10,815796 | −10,815796 | 1,6e−14 | ✓ |
| Student sd | 113 | 113 | 113 | 0,0e+00 | ✓ |
| Student p | 3,8101·10−19 | 3,8101·10−19 | 3,8101·10−19 | 6,0e−33 | ✓ |
| Student %95 GA alt | −1,186168 | −1,186168 | −1,186168 | 3,7e−12 | ✓ |
| Student %95 GA üst | −0,818892 | −0,818892 | −0,818892 | 3,7e−12 | ✓ |
| Welch SH | 0,092076 | 0,092076 | 0,092076 | 1,4e−17 | ✓ |
| Welch t | −10,888081 | −10,888081 | −10,888081 | 1,2e−14 | ✓ |
| Welch sd | 112,525695 | 112,525695 | 112,525695 | 4,7e−13 | ✓ |
| Welch p | 2,7191·10−19 | 2,7191·10−19 | 2,7191·10−19 | 2,2e−33 | ✓ |
| Welch %95 GA alt | −1,184958 | −1,184958 | −1,184958 | 3,8e−12 | ✓ |
| Welch %95 GA üst | −0,820103 | −0,820103 | −0,820103 | 3,8e−12 | ✓ |
| Levene W (ortalama) | 0,141660 | 0,141660 | 0,141660 | 2,2e−16 | ✓ |
| Levene p | 0,707342 | 0,707342 | 0,707342 | 6,7e−15 | ✓ |
| Brown–Forsythe W | 0,1552 | 0,155210 | 0,155210 | 2,6e−15 | ✓ (4 ondalık) |
| Bartlett T | 1,2984 | 1,298353 | 1,298353 | 2,9e−14 | ✓ (4 ondalık) |
| Folded F | 1,358117 | 1,358117 | 1,358117 | 3,6e−15 | ✓ |
| Folded F p | 0,256159 | 0,256159 | 0,256159 | 1,4e−15 | ✓ |
| Shapiro–Wilk W (drug) | 0,9570 | 0,956991 | 0,956991 | 1,0e−10 | ✓ (4 ondalık) |
| Shapiro–Wilk p (drug) | 0,0472 | 0,047224 | 0,047224 | 5,1e−10 | ✓ (4 ondalık) |
| Cohen d | −2,019066 | −2,019066 | −2,019066 | 1,8e−15 | ✓ |
| d GA alt (nct) | −2,466610 | −2,466610 | −2,466610 | 2,6e−08 | ✓ |
| d GA üst (nct) | −1,565493 | −1,565493 | −1,565493 | 3,8e−08 | ✓ |
| Hedges g | −2,0056 | −2,005630 | −2,005630 | 2,2e−14 | ✓ (4 ondalık) |
| Glass \Delta (kontrol: placebo, düzeltmesiz) | −1,8876 | −1,887573 | −1,887573 | 2,9e−15 | ✓ (4 ondalık) |
| Glass \Delta (küçük örneklem düzeltmeli) | −1,8635 | −1,863459 | −1,863459 | 3,3e−15 | ✓ (4 ondalık) |
| CLES | 0,0767 | 0,076690 | 0,076690 | 4,2e−17 | ✓ (4 ondalık) |
Sonuç: 28 büyüklüğün tamamı ölçütü karşılar. En büyük fark, d'nin merkezî olmayan t GA sınırında 2{,}6\times10^{-8}'dir (R effectsize kök bulmayı daha gevşek toleransla yapar).
5.7 Çıktıyı okuma
MerQur'un sonuç metni varsayılan ayarlarla şöyledir (kısaltılmış):
t-Testi: t(113)=-10.816, p < .001 ***. Cohen d=-2.019 (Büyük etki). H₀ REDDEDİLİR.
    μ(drug) − μ(placebo): Ortalama farkı = -1.0025, SE = 0.0927, %95 GA [-1.1862, -0.8189]
── VARSAYIM KONTROLLERİ ──
Shapiro–Wilk [drug]: W = 0.957, p = 0.0472 → İHLAL
Shapiro–Wilk [placebo]: W = 0.9872, p = 0.7831 → karşılanıyor
Levene (varyans homojenliği, ortalama merkezli): W = 0.1417, p = 0.7073 → karşılanıyor
Brown-Forsythe (medyan merkezli Levene): W = 0.1552, p = 0.6943 → karşılanıyor
── BETİMSEL İSTATİSTİKLER ──
    drug: n=55, M=-1.2444, SD=0.4557, SE=0.0615, medyan=-1.1700, ...
    placebo: n=60, M=-0.2418, SD=0.5311, SE=0.0686, medyan=-0.2400, ...
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Test adı | "Bağımsız İki Örneklem t-Testi" ya da sonuna "(Welch)" eklenmiş hâli | Otomatik modda hangi testin uygulandığını buradan okuyun. |
t(113)=-10.816 |
t ve sd; Welch'te sd iki ondalıklı yazılır (ör. 112.53) | İşaret, 1. grubun (drug) ortalamasının daha düşük olduğunu gösterir. |
p < .001 *** |
APA biçimli p ve yıldız | Ana tabloda p tam değeriyle saklanır (3,81·10⁻¹⁹); metin APA kuralıyla "< .001" yazar. |
Cohen d=-2.019 (Büyük etki) |
Havuzlanmış SS ile d ve etiketi | Mutlak değer yorumlanır; işaret yalnız yönü gösterir. |
Ortalama farkı, SE, %95 GA |
\bar x_1-\bar x_2, uygulanan testin SH'si ve GA'sı | GA sıfırı içermiyor; fark −1,19 ile −0,82 puan arasında. |
| VARSAYIM KONTROLLERİ | Shapiro, Levene, Brown–Forsythe; "İHLAL" ya da "karşılanıyor" | Etiket p<\alpha ise "İHLAL" der; bu bir uyarıdır, testi otomatik değiştirmez. |
| Uyarı (varsa) | "Levene testi: Varyans eşitsizliği (...), Welch t-Testi kullanıldı." | Yalnız Welch uygulanmış ve Levene anlamlıysa çıkar (hypothesis.py:3569–3570). Kullanıcı Student'ı zorlamışsa Levene anlamlı olsa da uyarı yazılmaz. |
| APA satırı | t(113) = -10.82, p < .001, d = -2.02 |
Arayüz dili Türkçe olsa da APA satırı ondalık noktayla yazılır; Türkçe metne aktarırken virgüle çevirin. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
İlaç grubunda HbA1c değişimi (O = −1,24; SS = 0,46; n = 55), plasebo grubuna göre (O = −0,24; SS = 0,53; n = 60) anlamlı düzeyde daha büyük bir düşüş gösterdi; t(113) = -10{,}82, p < 0{,}001. Ortalama fark −1,00 yüzde puanıdır (%95 GA [−1,19; −0,82]) ve etki büyüklüğü çok büyüktür (Cohen d = -2{,}02; %95 GA [−2,47; −1,57]). Varyansların eşit olduğu varsayımı Levene testiyle desteklendi (F(1, 113) = 0{,}14, p = 0{,}71); Welch düzeltmesi aynı sonucu verdi (t(112{,}53) = -10{,}89, p < 0{,}001).
5.8 Uzman soruları
S1. Neden varsayılan Student değil de "Otomatik (Levene)"? Ön test yaklaşımı eleştirilmiyor mu?
Eleştiriliyor. Levene sonucuna göre test seçmek iki aşamalı bir yordamdır; koşullu olarak seçilen testin birinci tür hata oranı nominal \alpha'dan sapabilir ve Levene'in gücü küçük örneklemde düşüktür (Zimmerman 2004). Pek çok yazar Welch'i varsayılan önerir (Delacre, Lakens ve Leys 2017). Kullanıcı "Welch (eşit değil)" seçerek bu sorunu ortadan kaldırabilir. Varyanslar eşitken Welch'in güç kaybı çok küçüktür. Bu veride iki yol aynı kararı verir.
S2. Welch seçildiğinde Cohen d neden değişmiyor?
_cohen_d her durumda havuzlanmış SS kullanır (hypothesis.py:226–229). Bu, R effectsize::cohens_d(pooled_sd = TRUE) tanımıyla uyumludur. Varyanslar çok farklıysa havuzlanmış SS iki grubun hiçbirini temsil etmez; o durumda Glass Δ (denetim grubu SS'si) daha savunulabilir. MerQur bağımsız t testinde ortalama varyanslı d_{av} seçeneği sunmaz.
S3. Hedges g'de hangi J kullanılıyor?
Kesin gama biçimi: J=\Gamma(\nu/2)/[\sqrt{\nu/2}\,\Gamma((\nu-1)/2)] (hypothesis.py:298–307). R effectsize::hedges_g de kesin biçimi kullanır; bu veride iki değer 10^{-14} düzeyinde eşleşir. Sık görülen 1-3/(4\nu-1) ifadesi bunun yaklaşığıdır. Yaklaşık biçim bu veride g'yi yalnız 5\times10^{-6} değiştirir, ama \nu=4 gibi küçük değerlerde üçüncü ondalıkta fark yaratır.
S4. Shapiro–Wilk ilaç grubunda p = 0,047 verdi. Test geçersiz mi?
Hayır. (i) t testi ortalamanın örnekleme dağılımının normalliğini gerektirir; n=55'te merkezi limit teoremi bunu büyük ölçüde sağlar. (ii) Sapma biçimi ince kuyruktur (basıklık −0,94); bu tür sapma t'nin birinci tür hata oranını pek etkilemez. (iii) Büyük örneklemde normallik testleri, önemsiz sapmalarda da anlamlı çıkar. (iv) Dağılımdan bağımsız bootstrap GA [-1{,}185;\,-0{,}823], Student GA'sıyla neredeyse aynıdır. Gerekirse Mann–Whitney U ile duyarlılık analizi raporlanabilir.
S5. Levene neden ortalama merkezli? scipy'nin varsayılanı medyan değil mi?
Evet; scipy levene varsayılanı center="median"dır (Brown–Forsythe 1974). MerQur center="mean" seçer (hypothesis.py:3377), çünkü Levene testinin özgün tanımı budur ve R car::leveneTest(center = mean) de bu tanımı kullanır. Medyan merkezli biçim çarpık dağılımlarda daha sağlam olduğu için ayrı satırda raporlanır, ama otomatik karar ortalama merkezli p ile verilir.
S6. Güven düzeyini %99 yaparsam test değişebilir mi?
Evet. Otomatik modda Levene eşiği \alpha=1-\text{güven düzeyi}'dir (hypothesis.py:3378). %99'da eşik 0,01 olur; Levene p değeri 0,01 ile 0,05 arasındaysa %95'te Welch, %99'da Student uygulanır. Bu davranış belgelenmiştir ama sezgisel değildir; yayımlanacak analizlerde varyans seçimini açıkça yapmak önerilir.
S7. d için iki farklı GA var. Hangisi doğru?
Normal varsayımı ve eşit varyans altında kesin olan, merkezî olmayan t dağılımına dayanan aralıktır (Steiger–Fouladi tanımı; Cumming ve Finch 2001). Normal yaklaşımlı aralık büyük n ve küçük |d|'de ona yaklaşır; büyük |d|'de simetrik olduğu için sapar. Bu veride normal yaklaşım [-2{,}468;\,-1{,}570], nct [-2{,}467;\,-1{,}565] verir. Raporlamada nct aralığı tercih edilmelidir.
S8. Tek yönlü test seçildiğinde güven aralığı da tek yönlü mü?
Ana GA her zaman çift yönlüdür (hypothesis.py:3228 hep 1-\alpha/2 kantilini kullanır). Tek yönlü seçimde ek bir satır, tek yönlü (1-\alpha) sınırını verir (R t.test(alternative = ...)$conf.int tanımı). p değeri tek kuyruktan hesaplanır; bu veride sol yönlü p=1{,}91\times10^{-19}'dur.
S9. Welch sd'si tam sayı değil. p nasıl hesaplanıyor?
t dağılımının yoğunluğu ve birikimli fonksiyonu kesirli sd için de tanımlıdır (beta fonksiyonu üzerinden). scipy ve R, \nu=112{,}5257 ile doğrudan hesap yapar. Eski ders kitaplarındaki "sd'yi aşağı yuvarla" kuralı tablo kullanımından kalmadır ve MerQur'da uygulanmaz.
S10. Birden çok değer sütunu seçtim. p değerleri düzeltiliyor mu?
Hayır. Çoklu bağımlı değişken modunda her değişken için bağımsız bir test yapılır ve sonuçlar tek tabloda toplanır (stats_panel.py:5576–5607); Bonferroni ya da Holm düzeltmesi uygulanmaz. Aile bazında hata oranı korunmak isteniyorsa düzeltme elle yapılmalı ya da MANOVA gibi çok değişkenli bir yaklaşım kullanılmalıdır.
5.9 Sık hatalar ve tuzaklar
- Eşleşik veriyi bağımsız sanmak. Aynı hastanın öncesi ve sonrası ölçümlerini iki "grup" gibi girmek, hasta içi korelasyonu yok sayar ve SH'yi şişirir.
- Fark yönünü yanlış okumak. Düzey sırası tanımlanmamış metin etiketlerinde 1. grup veride ilk görülen düzeydir; fark yönü sonuç metninde yazılır.
- Glass Δ'da kontrol grubunu belirtmemek. Kutu boş bırakılırsa 2. grup kontrol sayılır; payda bu grubun SS'sidir. Çıktıdaki kontrol grubu adı denetlenmelidir.
- Levene anlamsızlığını "varyanslar eşit" diye okumak. Anlamsız sonuç eşitliği kanıtlamaz; özellikle küçük n'de güç düşüktür.
- "İHLAL" etiketini testi geçersiz sayma nedeni yapmak. Etiket yalnız p<\alpha demektir; sapmanın büyüklüğü ve biçimi grafikle (Q–Q) değerlendirilmelidir.
- Çoklu değişkende düzeltme yapmamak. MerQur düzeltme uygulamaz.
- APA satırını olduğu gibi Türkçe metne almak. MerQur APA satırını ondalık noktayla yazar.
- Kümeli veride t testi. Aynı klinikten gelen hastalar bağımsız değildir; etkin örneklem küçülür ve p yapay olarak küçük çıkar.
- TOST sınırlarını veriden sonra seçmek. Eşdeğerlik sınırları çalışma öncesi, klinik gerekçeyle belirlenmelidir; varsayılan ±0,5 yalnız bir yer tutucudur.
5.10 Kaynaklar
- Bartlett, M. S. (1937). Properties of sufficiency and statistical tests. Proceedings of the Royal Society of London. Series A, 160(901), 268–282. https://doi.org/10.1098/rspa.1937.0109
- Brown, M. B., & Forsythe, A. B. (1974). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2. baskı). Lawrence Erlbaum. (Routledge yeniden basımı: https://doi.org/10.4324/9780203771587)
- Cumming, G., & Finch, S. (2001). A primer on the understanding, use, and calculation of confidence intervals that are based on central and noncentral distributions. Educational and Psychological Measurement, 61(4), 532–574. https://doi.org/10.1177/0013164401614002
- Delacre, M., Lakens, D., & Leys, C. (2017). Why psychologists should by default use Welch's t-test instead of Student's t-test. International Review of Social Psychology, 30(1), 92–101. https://doi.org/10.5334/irsp.82
- Hedges, L. V. (1981). Distribution theory for Glass's estimator of effect size and related estimators. Journal of Educational Statistics, 6(2), 107–128. https://doi.org/10.3102/10769986006002107
- Levene, H. (1960). Robust tests for equality of variances. I. Olkin (Ed.), Contributions to probability and statistics içinde (ss. 278–292). Stanford University Press.
- McGraw, K. O., & Wong, S. P. (1992). A common language effect size statistic. Psychological Bulletin, 111(2), 361–365. https://doi.org/10.1037/0033-2909.111.2.361
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Schuirmann, D. J. (1987). A comparison of the two one-sided tests procedure and the power approach for assessing the equivalence of average bioavailability. Journal of Pharmacokinetics and Biopharmaceutics, 15(6), 657–680. https://doi.org/10.1007/BF01068419
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3–4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Welch, B. L. (1947). The generalization of 'Student's' problem when several different population variances are involved. Biometrika, 34(1–2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Zimmerman, D. W. (2004). A note on preliminary tests of equality of variances. British Journal of Mathematical and Statistical Psychology, 57(1), 173–181. https://doi.org/10.1348/000711004849222