109. Probit Regresyon
Analiz kimliği: probit · Menü adı: Probit Regresyon · Panel: gui/panels/analyses/probit_regression.py · Motor: stats/specialized_regression.py, run_probit_regression (satır 263–596); ek çıktılar stats/pls_probit_tobit_extras.py (satır 156–358), stats/regression_extras.py (hosmer_lemeshow, satır 581–597), stats/glm_scale.py
109.1 Ne işe yarar
Probit regresyon, ikili bir sonucun (yanıt var/yok, ölü/canlı) olasılığını standart normal birikimli dağılım fonksiyonu \Phi üzerinden modeller. Soru ikili lojistik regresyonla (Bölüm 46) aynıdır; değişen yalnız bağlantı fonksiyonudur:
- \pi_i: i. gözlemde olayın olasılığı; \Phi^{-1}(\pi) "probit"tir (Bliss 1934'te bu değere 5 eklenirdi).
- \eta_i=\mathbf x_i^{\top}\boldsymbol\beta: doğrusal yordayıcı; \mathbf x_i başında 1 içerir.
- \beta_j: x_j bir birim arttığında olasılığın normal sapma (z) ölçeğindeki değişimi. Odds oranı yorumu yoktur.
Neden normal bağlantı? Gizil değişken ve tolerans yorumu
Gözlenmeyen sürekli bir "yatkınlık" Y^{*}=\mathbf x^{\top}\boldsymbol\beta+\varepsilon, \varepsilon\sim N(0{,}1) düşünülür; Y^{*}>0 ise olay gözlenir. O zaman P(Y=1)=P(\varepsilon>-\eta)=\Phi(\eta) olur. Toksikolojideki klasik yorumda her bireyin bir tolerans dozu vardır; toleranslar (çoğunlukla log ölçekte) normal dağılır ve doz bireyin toleransını aşınca yanıt görülür (Bliss 1934; Finney 1971). Hata varyansı 1'e sabitlendiği için \boldsymbol\beta yalnız \boldsymbol\beta/\sigma olarak tanımlanabilir; lojistik dağılımın standart sapması \pi/\sqrt3\approx1{,}81 olduğundan logit katsayıları kabaca probit katsayılarının 1,6–1,8 katıdır.
Ne zaman kullanılır? Sonuç ikiliyse ve normal gizil değişken ya da tolerans dağılımı kuramsal olarak uygunsa: doz-yanıt deneyleri (ED50/LD50 ve güven sınırları), ekonometride ikili seçim modelleri, sıralı ya da iki denklemli normal modellerle tutarlılık gereken durumlar.
Ne zaman kullanılmaz?
- Etkiler odds oranı olarak raporlanacaksa: İkili Lojistik Regresyon.
- Göreli risk (RR) istenirse: Göreli Risk ve Prevalans Oranı (Log-Binom / Değiştirilmiş Poisson).
- Sonuç üç ya da daha çok kategoriliyse: Multinomial ya da Sıralı Lojistik Regresyon (sıralı probit, Sıralı Lojistik panelinde "Kümülatif probit" bağlantısıyla).
- Sonuç sansürlü sürekli bir değerse: Tobit Regresyon (Sansürlü).
- Gözlemler kümeli ya da tekrarlıysa: GLMM ya da GEE.
Sık karıştırılan analizler. Lojistik regresyon neredeyse her zaman aynı olasılık eğrisini verir; fark kuyruklardadır (normalin kuyrukları daha incedir). Panelin "Bağ fonksiyonu (dağılım)" seçeneği Logit yapıldığında aynı panel lojistik modeli kestirir; katsayılar Bölüm 46'daki modelle aynıdır, ama çıktı ED/LD ve doz-yanıt odaklıdır.
109.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| İkili sonuç | Bağımlı değişkende tam iki değer (ya da olay/deneme sayıları). | İki değilse hata (specialized_regression.py:382–385). |
| Bağımsız gözlemler | Her satır ayrı birey ya da bağımsız deneme grubu. | Denetlenmez. |
| Bağlantının doğruluğu | \Phi^{-1}(\pi), açıklayıcılarla doğrusal. Doz-yanıtta çoğunlukla log doza göre. | İsteğe bağlı Hosmer–Lemeshow; olay/deneme biçiminde Pearson X^2. |
| Aşırı yayılım yok | Gruplanmış veride binom varyansı yeterli. | İsteğe bağlı ölçek ve heterojenlik eşiği. |
| Ayrışma yok | Doz olayları kusursuz ayırmamalı. | Denetlenmez; ayrışmada Newton yakınsamaz ya da SH çok büyür. |
Eksik değer. Bağımlı değişkende, açıklayıcılarda ya da deneme sütununda eksik olan satırlar çıkarılır (specialized_regression.py:316). "log10(doz)" seçiliyse dozu \le0 olan satırlar da çıkarılır ve sayıları uyarıyla yazılır; "Doğal yanıt" da seçiliyse doz 0 satırları kontrol grubu olarak tutulur (344–362).
Uç durumlar. Deneme sütunu yanıt ya da açıklayıcıyla aynıysa açık hata (312–313). Olay sayısı negatif ya da deneme sayısından büyükse hata (319–320). Kesirli olay/deneme sayılarında (Abbott düzeltmeli veriler) model ağırlıklı binom olabilirliğiyle kestirilir; birey düzeyindeki sınıflama, AME ve Hosmer–Lemeshow hesaplanmaz (321–339).
109.3 Parametreler
Varsayılanlar probit_regression.py:43–118 (form) ve 121–139 (read_options) satırlarından alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken (ikili) | ilk sütun | 0/1 (ya da iki değerli) hedef; olay/deneme biçiminde olay sayısı. | — |
| Bağımsız değişkenler | en az 1 | Sayısal ya da kategorik. İlk açıklayıcı doz kabul edilir. | ED/LD ve log10 dönüşümü ilk açıklayıcıya uygulanır. |
| Kategorik (faktör) değişkenler | boş | Sayısal kodlu sütunları kukla kodlatır; metin ve kategorik açıklayıcılarda referans MerQur düzey sırasının ilk düzeyidir. | Tasarım matrisi; AME düzey karşıtlığı. |
| Güven Düzeyi | %95 | Katsayı GA'sı, AME GA'sı ve Fieller sınırları. | GA genişliği. |
| Hosmer-Lemeshow | kapalı | Ondalık gruplarla uyum testi. | Ek satır. |
| Olay kategorisi | Otomatik | Otomatik (ortak olay kuralı), Büyük değer ya da Küçük değer; modellenen olasılık P(Y=\text{olay}). | Tüm katsayıların işareti. |
| Sınıflama kesimi | 0,50 | \hat\pi\ge kesim ise olay. | Doğruluk, duyarlılık, özgüllük, 2×2 tablo. |
| Ek çıktı: AME | kapalı | Ortalama marjinal etki ve delta SH. | Ek tablo. |
| Ek çıktı: Sınıflama tablosu | kapalı | 2×2 tablo. | Ek tablo. |
| Ek çıktı: Doz-yanıt (ED/LD) | kapalı | 15 olasılık düzeyi için etkili doz ve Fieller sınırları. | Ek tablo. |
| Doz-yanıt seçenekleri: log10(doz) | kapalı | İlk açıklayıcı \log_{10}'a çevrilir. | Tüm model değişir. |
| Doz-yanıt seçenekleri: Doğal yanıt | kapalı | Abbott modeli P=C+(1-C)\Phi(\eta). | C sınırda değilse katsayı tablosu bu modelden. |
| Deneme sayısı (n) sütunu | — (yok) | Olay/deneme biçimi: Y = olay sayısı, bu sütun = deneme sayısı. | Veri biçimi ve ölçeğin gruplanması. |
| Bağ fonksiyonu (dağılım) | Probit (normal) | Probit ya da logit. | F; katsayı ölçeği, ED/LD. |
| Aşırı yayılım ölçeği | Yok (ölçek = 1) | Pearson ya da sapma \varphi. | SH, z, p, GA ve Fieller sınırları. |
| Heterojenlik eşiği | Ölçek seçiliyse her zaman uygula | Ölçek yalnız uyum p < eşik ise uygulanır (0,15 / 0,10). | Ölçeğin uygulanıp uygulanmayacağı. |
| Frekans ağırlığı | Yok (ağırlıksız) | Satır çoğaltma. | n ve tüm kestirimler. |
| Grafik | Katsayı orman grafiği | Orman grafiği ya da 3B olasılık yüzeyi. | Yalnız Grafik sekmesi. |
Olay kategorisi kuralı
Bağımlı değişkenin iki değeri ortak düzey sırasıyla dizilir (natural_cat_order_values): sayısal ya da sayı içeren etiketlerde sayısal sıra ("9" < "10"), aksi hâlde Veri sekmesindeki tanımlı sıra ya da verideki ilk görülme sırası. Varsayılan "Otomatik", bütün ikili sonuç analizlerinin ortak olay kuralını uygular (core/binary_event.py): 0/1 ya da 1/2 sayısal kodda büyük değer; iki düzeyden yalnız biri tanınan olumlu etiketse (evet, yes, var, present, pozitif …) o düzey; aksi hâlde bu sıranın ikinci düzeyi ve "olay kategorisi seçilmedi" uyarısı. Olay ve referans notlarda yazılır. "Büyük değer" sıranın sonuncusunu, "Küçük değer" ilkini olay kabul eder. 0/1 kodlamada olay 1'dir; "Evet"/"Hayır"da Evet. Alfabetik sıra kullanılmaz. Özetteki "Modellenen olasılık" satırı her zaman hangi değerin modellendiğini yazar, örneğin P(Y=1|X).
109.4 Tıp örneği
Dosya: english/datasets/Tip/45_probit_drug_dose_response.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/45_probit_ilac_dose_response.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #45'ten alınmıştır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
response |
Bağımlı | 0/1 | 77 yanıt (%42,8), 103 yanıt yok |
dose_mg |
Açıklayıcı (doz) | 6 düzey (mg) | 10, 25, 50, 100, 200, 400; her düzeyde 30 hasta |
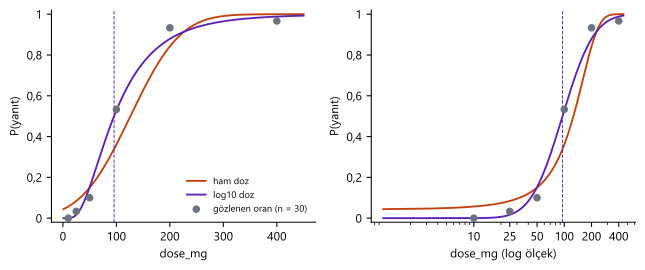
Doz düzeylerinde gözlenen yanıt oranları: 0/30, 1/30, 3/30, 16/30, 28/30, 29/30.
n ve eksik değer: 180 hasta, eksik değer yok.
Klinik soru: İlaca yanıt olasılığı dozla nasıl artıyor? Hastaların yarısında yanıt sağlayan doz (ED50) nedir ve güven sınırları nelerdir?
Seçilen ayarlar: Önce arayüz varsayılanları (ham doz, probit, %95). Dozlar geometrik dizi izlediği için doz-yanıt geleneğine uygun ikinci model log10(doz) ile kurulmuştur. Hesap yürüyüşü için Hosmer–Lemeshow, AME, sınıflama tablosu ve Doz-yanıt (ED/LD) kutuları açılmış; ayrıca Pearson ölçekli, heterojenlik eşikli, doğal yanıtlı, logit bağlantılı, olay = küçük değer, %99 güvenli çalıştırmalar ve aynı verinin olay/deneme biçimiyle (doz başına r/n) çalıştırmaları yapılmıştır.
109.5 Formüller ve hesap adımları
MerQur'un hesap sırası: liste bazında silme → (varsa) olay/deneme biçiminin Bernoulli satırlarına açılması → (varsa) log10 doz → faktör kodlama → olay kategorisi → statsmodels Probit ile Newton–Raphson → (varsa) doğal yanıt modeli → katsayı tablosu ve "marjinal etki" sütunu → (varsa) ölçek ve heterojenlik kararı → sınıflama ölçüleri ve AUC → model LR testi → isteğe bağlı HL, AME, 2×2 tablo, ED/LD.
109.5.1 Olabilirlik ve türevler
- \Phi_i=\Phi(\eta_i), \phi_i=\phi(\eta_i): standart normal birikimli dağılım ve yoğunluk.
- \mathbf I_{\text{bek}}: beklenen (Fisher) bilgi; y_i içermez.
- \mathbf I_{\text{göz}}: gözlenen bilgi (log-olabilirliğin eksi Hessian'ı); y_i'ye bağlıdır. Probit kanonik bağlantı değildir; iki matris ML noktasında da farklıdır.
Koddaki tercih: Newton–Raphson ve gözlenen bilgi
MerQur Probit(y, X).fit(disp=False) çağırır (specialized_regression.py:413–420). statsmodels 0.14.6 varsayılanları: Newton–Raphson, en çok 35 yineleme, başlangıç \boldsymbol\beta=\mathbf 0, durma ölçütü parametre değişiminin 10^{-8}'in altına inmesi. Kovaryans matrisi gözlenen bilginin tersidir. R glm(binomial(link = "probit")) Fisher skorlamasıyla kestirir ve summary() SH'lerini beklenen bilgiden verir; katsayılar aynıdır, SH'ler farklıdır (Tıp örneğinde 0,209654'e karşı 0,213778; 109.8 S2). Efron ve Hinkley (1978) gözlenen bilginin koşullu çıkarım için daha uygun olduğunu savunmuştur.
Başlangıç \boldsymbol\beta=\mathbf 0'da ilk adımın kapalı biçimi. \eta=0'da \Phi=0{,}5, \phi=1/\sqrt{2\pi}, \phi'=0 olduğundan gözlenen ve beklenen bilgi aynıdır: \mathbf I(\mathbf 0)=\frac{2}{\pi}\mathbf X^{\top}\mathbf X. Skor \mathbf U(\mathbf 0)=\frac{4}{\sqrt{2\pi}}\mathbf X^{\top}(\mathbf y-\tfrac12)'dir. Bu yüzden
yani ilk Newton adımı, doğrusal olasılık modelinin (0/1 sonuçla OLS) katsayılarının \sqrt{2\pi}\approx2{,}5066 katıdır (sabitte ayrıca kayma). Lojistikteki karşılığı 4 kattır (Bölüm 46.5.2).
109.5.2 Wald testi, GA ve "marjinal etki" sütunu
- GA katsayı ölçeğindedir; üstel alınmaz (probitte OR yoktur).
- \text{ME}_j: katsayı tablosundaki "Marjinal etki" sütunu; ortalama açıklayıcı değerinde olasılığın x_j'ye göre türevi (MEM;
specialized_regression.py:467–469). Logit bağlantıda \phi yerine lojistik yoğunluk kullanılır. - Sabit satırında marjinal etki tanımsızdır ve "—" yazılır.
109.5.3 Model testi, sözde R² ve sınıflama
AIC =-2\ell+2k, BIC =-2\ell+k\ln n, k=p+1. Sınıflama ölçüleri (doğruluk, duyarlılık, özgüllük; \hat\pi\ge kesim) ve AUC (roc_auc_score, bağlara yarım puan) özet bloğunda her çalıştırmada verilir (specialized_regression.py:525–544). Tanımlar Bölüm 46.5.6 ile aynıdır.
109.5.4 Hosmer–Lemeshow testi
Tanım Bölüm 46.5.7'dekiyle aynıdır (regression_extras.py:581–597): \hat\pi'nin ondalık kesim noktaları (pandas.qcut, duplicates="drop"), sağdan kapalı aralıklar, sd =\max(g'-2,\,1).
Az sayıda farklı tahmin olasılığında grup sayısı düşer
Tek açıklayıcı altı düzeyli olduğunda yalnız altı farklı \hat\pi vardır. Ondalık kesim noktalarının çoğu çakışır, altı aralıktan biri boş kalır ve g'=5 grup oluşur: sd =3. MerQur sd'yi dolu grup sayısından hesaplar. R ResourceSelection::hoslem.test ise boş aralığı da tabloda tutar (beklenen sayı 0, katkı tanımsız) ve sd'yi her zaman g-2=8 alır; bu veride sonuç vermez. Gruplanmış doz-yanıt verisinde uyum için olay/deneme biçimindeki Pearson X^2 (109.5.7) daha doğal bir ölçüdür.
109.5.5 Ortalama marjinal etki (AME)
- \hat{\mathbf V}: gözlenen bilgiye dayalı kovaryans (ölçek uygulanmış olsa bile ölçeksiz; çıktı notu bunu belirtir).
- \mathbf e_j: j. birim vektör. 0/1 sütunlarda türev yerine ayrık değişim alınır: \frac1n\sum[\Phi(\eta_i^{(1)})-\Phi(\eta_i^{(0)})] (statsmodels
get_margeff(at="overall", dummy=True);pls_probit_tobit_extras.py:156–205). - Çok düzeyli faktörlerde her düzey, grubun tüm kuklaları sıfırken o düzeyin kuklası 1 yapılarak referansa karşı hesaplanır (R
marginaleffects::avg_slopesile aynı tanım).
AME ile katsayı tablosundaki "Marjinal etki" neden farklı?
MEM, türevi tek bir noktada (\bar\eta) alır; AME türevleri her gözlemde alıp ortalar. Probit eğrisi doğrusal olmadığı için ikisi farklıdır. Tıp örneğinde \bar\eta=0{,}063 eğrinin dik bölgesindedir: MEM =0{,}005421; AME =0{,}002534, çünkü düşük ve yüksek dozlardaki gözlemler eğrinin düz kuyruklarındadır. Klinik raporlarda AME tercih edilir (Williams 2012).
109.5.6 Etkili doz (ED/LD) ve Fieller güven sınırları
Diğer açıklayıcılar ortalamada tutulduğunda p olasılığını veren doz (fieller_ed, pls_probit_tobit_extras.py:212–255):
- d: doz sütunu (ilk açıklayıcı); \mathbf c: sabit için 1, doz için 0, diğer açıklayıcılar için örneklem ortalaması.
- log10(doz) seçiliyse \hat x_p log ölçektedir; tabloda 10^{\hat x_p} yazılır, log değeri ayrı sütundadır.
- Tablo 15 düzey verir: 0,01; 0,05; 0,10; 0,20; 0,25; 0,30; 0,40; 0,50; 0,60; 0,70; 0,75; 0,80; 0,90; 0,95; 0,99.
Fieller (1954) sınırları, (a+b\,x_p)-\Phi^{-1}(p)'nin sıfır olduğu hipotezini tersine çevirir. t kritik değer (z_{1-\alpha/2} ya da heterojenlikte t_{\text{sd}}), v_{aa}=\mathbf c^{\top}\hat{\mathbf V}\mathbf c, v_{bb}=\hat V_{dd}, v_{ab}=\mathbf c^{\top}\hat{\mathbf V}_{\cdot d} ve m=\Phi^{-1}(p)-a ile
- A>0, yani g<1 ise sınırlar sonludur. g\ge1 olduğunda eğim sıfırdan anlamlı ayrılmaz ve Fieller aralığı sınırsız olur; MerQur "—" (NaN) yazar.
- Delta yöntemi SH'si de hesaplanır: \SH(\hat x_p)=\sqrt{v_{aa}+2\hat x_pv_{ab}+\hat x_p^2v_{bb}}/|b| (iç değişken
se_x); tabloya yazılmaz.
Neden Fieller, delta yöntemi değil?
\hat x_p iki normal kestiricinin oranıdır; dağılımı çarpıktır ve paydası sıfıra yaklaştıkça sonsuz momentlidir. Delta yöntemi simetrik bir aralık verir ve küçük örneklemde kapsamı düşer. Fieller aralığı oranın dağılımına doğrudan dayanır, asimetriktir ve g küçükken delta aralığına yaklaşır. Probit analizinde gelenek budur (Finney 1971).
109.5.7 Ölçek (heterojenlik) düzeltmesi
- Olay/deneme biçiminde h her satırdır (bir doz grubu): r_h olay, m_h deneme sayısı; sd = satır sayısı -k (
_probit_dispersion,specialized_regression.py:670–713). - Gözlem bazındaki (0/1) veri önce ortak değişken örüntülerine (doz gruplarına) toplulaştırılır; h her örüntüdür ve sd = örüntü sayısı -k. Böylece aynı veri iki giriş biçiminde aynı X^2'yi verir. Örüntü sayısı gözlem sayısının yarısını aşarsa (sürekli ortak değişken) X^2 hesaplanmaz, otomatik düzeltme uygulanmaz ve bu çevrilmiş bir notla yazılır.
- Sapma seçilirse X^2 yerine binom sapması kullanılır.
- "Heterojenlik eşiği" bir sayı ise ölçek yalnız P(\chi^2_{\text{sd}}\ge X^2) eşikten küçükse uygulanır; değilse hiçbir şey ölçeklenmez (
443–478).
Neden toplulaştırılmış veride?
Pearson X^2 uyum testi yalnız gruplanmış binom veride anlamlıdır (McCullagh ve Nelder 1989): bireysel 0/1 veride her hücrede tek deneme vardır ve X^2/\text{sd}'nin dağılımı tanımsızdır, aşırı yayılımı ölçmez. Bireyler üzerinden toplanırsa Tıp örneğinde (log10 doz) X^2=215{,}05, sd =178, p=0{,}030 çıkar ve 0,15 eşiğiyle yapay bir düzeltme uygulanırdı; doz başına toplulaştırıldığında X^2=3{,}209, sd =4, p=0{,}523 olur ve düzeltme uygulanmaz. Aynı verinin iki giriş biçimi aynı sonucu vermelidir; MerQur bu yüzden bireysel veriyi önce örüntülere toplulaştırır.
109.5.8 Doğal yanıt (Abbott) modeli
- C: dozdan bağımsız kendiliğinden yanıt oranı (kontrol grubunda gözlenen ölüm gibi; Abbott 1925).
- C=1/(1+e^{-\gamma}) ile \gamma üzerinden BFGS (
gtol10^{-9}, üç başlangıç değeri), SH optimumda sayısal Hessian'dan (probit_natres,pls_probit_tobit_extras.py:258–303). - \hat C<10^{-4} ise "sınırda" sayılır; katsayı tablosu ve ED/LD standart modelden verilir ve uyarı yazılır. Log10 dozda doz 0 satırları olabilirliğe P=C ile girer.
109.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/probit/elle_hesap.py ile, MerQur çağrılmadan, analitik gözlenen Hessian'lı Newton–Raphson ile hesaplanmıştır.
Adım 1 — Başlangıç (\boldsymbol\beta=\mathbf 0). Her hastada \Phi=0{,}5; -2\ell=360\ln2=249{,}532985.
Adım 2 — İlk adım ve yakınsama. \boldsymbol\beta^{(1)}=\sqrt{2\pi}\,(\mathbf X^{\top}\mathbf X)^{-1}\mathbf X^{\top}(\mathbf y-\tfrac12)=(-1{,}061421;\ 0{,}006729).
| Yineleme | b_0 | b_{\text{dose}} | -2\ell |
|---|---|---|---|
| 0 | 0 | 0 | 249,532985 |
| 1 | −1,061421 | 0,006729 | 134,881674 |
| 2 | −1,468649 | 0,010573 | 117,799977 |
| 3 | −1,681281 | 0,013148 | 114,433396 |
| 4 | −1,717900 | 0,013608 | 114,356522 |
| 5 | −1,718468 | 0,013615 | 114,356504 |
| 6 | −1,718468 | 0,013615 | 114,356504 |
Adım 3 — Katsayı tablosu (ham doz).
| Terim | b | SH (gözlenen) | SH (beklenen, R glm) |
z | %95 GA | ME (MEM) |
|---|---|---|---|---|---|---|
| Sabit | −1,718468 | 0,209654 | 0,213778 | −8,197 | [−2,129383; −1,307553] | −0,684217 |
dose_mg |
0,013615 | 0,001729 | 0,001920 | 7,874 | [0,010226; 0,017004] | 0,005421 |
\ell=-57{,}178252; \ell_0=77\ln(77/180)+103\ln(103/180)=-122{,}882130; LR χ²(1) =131{,}407756, p=2{,}0\times10^{-30}; AIC =118{,}356504; BIC =124{,}742417; McFadden R^2=0{,}534690. Sınıflama (kesim 0,5): DN = 100, YP = 3, YN = 20, DP = 57; doğruluk 0,872222, duyarlılık 0,740260, özgüllük 0,970874; AUC 0,952024. MEM: \bar\eta=\bar{\mathbf x}^{\top}\hat{\boldsymbol\beta}=-1{,}718468+0{,}013615(130{,}8333)=0{,}062839, \phi(0{,}062839)\times0{,}013615=0{,}005421.
Adım 4 — Uyum: ham doz yeterli mi? Kestirilen ve gözlenen oranlar:
| Doz (mg) | 10 | 25 | 50 | 100 | 200 | 400 |
|---|---|---|---|---|---|---|
| Gözlenen | 0,000 | 0,033 | 0,100 | 0,533 | 0,933 | 0,967 |
| Probit, ham doz | 0,057 | 0,084 | 0,150 | 0,361 | 0,842 | 0,99990 |
| Probit, log10 doz | 0,0002 | 0,017 | 0,152 | 0,528 | 0,879 | 0,988 |
Ham dozlu model 100 mg'de yanıtı az, 400 mg'de neredeyse 1 kestirir. Hosmer–Lemeshow (5 dolu grup):
| Grup | n | O_1 | E_1 | Katkı |
|---|---|---|---|---|
| 1 (10 ve 25 mg) | 60 | 1 | 4,2263 | 2,6495 |
| 2 (50 mg) | 30 | 3 | 4,4911 | 0,5822 |
| 3 (100 mg) | 30 | 16 | 10,8168 | 3,8841 |
| 4 (200 mg) | 30 | 28 | 25,2733 | 1,8671 |
| 5 (400 mg) | 30 | 29 | 29,9971 | 342,8566 |
| Toplam | \hat C=351{,}840 |
\text{sd}=5-2=3, p=6{,}0\times10^{-76}. Toplamın neredeyse tamamı tek hücreden gelir: 400 mg grubunda beklenen yanıtsız sayısı 30-29{,}9971=0{,}0029 iken bir yanıtsız hasta gözlenmiştir; (1-0{,}0029)^2/0{,}0029\approx342{,}82; yanıt hücresinin katkısı (0,03) eklenince grup 342,86 verir. Bu, kuyruktaki uyumsuzluğun gerçek olduğunu ama χ² yaklaşımının bu kadar küçük beklenen sayıda geçersiz olduğunu birlikte gösterir.
Adım 5 — log10 doz modeli. b_0=-7{,}234649 (SH 0,947937), b_1=3{,}652834 (SH 0,472917); \ell=-48{,}046026, LR χ²(1) =149{,}672208, AIC =100{,}092052, McFadden R^2=0{,}609007. AIC 18,3 puan düşer. Hosmer–Lemeshow \hat C=3{,}1848, sd 3, p=0{,}364. Log ölçekte doğrusallık bu veriye çok daha iyi uyar.
Şekil 109.1. Doz düzeylerinde gözlenen yanıt oranları (gri) ve kestirilen probit eğrileri; sol doğrusal, sağ logaritmik doz ekseni. Kesikli çizgi log10 modelinin ED50'sidir (95,6 mg).
Adım 6 — ED50 ve Fieller sınırları (log10 modeli). a=-7{,}234649, b=3{,}652834, \Phi^{-1}(0{,}5)=0:
Kovaryans: v_{aa}=0{,}898585, v_{bb}=0{,}223650, v_{ab}=-0{,}443112; t=1{,}959964:
g=1{,}959964^2(0{,}223650)/3{,}652834^2=0{,}0644; aralık ED50 çevresinde asimetriktir (−16,0, +19,3 mg). Delta yöntemi log ölçekte SH 0,039348 verir.
| p | Ham doz: ED (mg) | Fieller %95 | log10 doz: ED (mg) | Fieller %95 |
|---|---|---|---|---|
| 0,01 | −44,648 | [−95,662; −12,064] | 22,065 | [12,865; 30,920] |
| 0,10 | 32,091 | [2,369; 53,520] | 42,630 | [30,286; 53,680] |
| 0,50 | 126,218 | [107,173; 149,406] | 95,622 | [79,575; 114,879] |
| 0,90 | 220,345 | [190,092; 267,178] | 214,484 | [170,412; 301,635] |
Ham dozlu model ED01 için negatif doz verir: normal tolerans dağılımı doğrusal doz ölçeğinde sıfırın altına taşar. Log ölçekte bu olmaz.
Adım 7 — AME. Ham doz: AME =0{,}002534 (SH 0,000168, z=15{,}13); log10 doz: AME =0{,}551862 (SH 0,002200, z=250{,}9). Log10 modelinde AME'nin z'si katsayınınkinin (z=7{,}72) 30 katıdır; 109.8 S5 nedenini açıklar.
Adım 8 — Ölçek, logit bağlantı ve olay kategorisi.
- Pearson ölçeği (log10): heterojenlik X^2'si doz gruplarına toplulaştırılmış veride hesaplanır (109.5.7): X^2=3{,}209409, sd 4, \varphi=0{,}802352. Ölçek seçildiğinde SH'ler \sqrt\varphi=0{,}8957 ile çarpılır (b_1 SH 0,423611), ED50 Fieller sınırları t_4 ve \varphi\hat{\mathbf V} ile [75,355; 121,294] olur. Heterojenlik eşiği 0,15 verilirse uyum p=0{,}523 eşiğin üstünde kaldığından düzeltme uygulanmaz ve sonuçlar ölçeksiz kalır.
- Olay/deneme biçimi (doz başına r/n): kestirimler ve heterojenlik istatistiği bireysel biçimle aynıdır (X^2=3{,}2094, sd 4, \varphi=0{,}8024, p=0{,}523).
- Logit bağlantı (ham doz): b_0=-3{,}304508, b_1=0{,}028790; \ell=-53{,}610705 (probitten iyi), ED50 =114{,}78 mg. Logit/probit eğim oranı 2,11'dir; kuyruklardaki uyumsuzluk iki bağlantıyı farklı etkilediği için 1,6–1,8 kuralı burada tutmaz.
- Olay = küçük değer: tüm katsayıların işareti tersine döner, \ell ve LR değişmez; duyarlılık ve özgüllük yer değiştirir.
- Doğal yanıt (log10): \hat C<10^{-5} sınırdadır (10 mg'de 0/30 yanıt); tablo standart modelden verilir.
109.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan tam hassasiyetle alınmıştır (özet bloktaki dört ondalık yuvarlama bellekte devre dışı bırakılmıştır). Python: analitik gözlenen Hessian'lı Newton. R 4.5.3: glm(binomial(link = "probit")) kestirimi gözlenen bilgiyle üç Newton adımı daha cilalanmış (glm sapma ölçütüyle 3\times10^{-8}'de durur); SH'ler gözlenen bilgiden elle, AME marginaleffects::avg_slopes(vcov = gözlenen), AUC pROC, ED50 ayrıca MASS::dose.p; Hosmer–Lemeshow ve Fieller tanımları R'de elle yazılmıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| \beta Sabit | −1,718468 | −1,718468 | −1,718468 | 1,1e−13 | ✓ |
| SH Sabit (gözlenen bilgi) | 0,209654 | 0,209654 | 0,209654 | 7,8e−14 | ✓ |
| z Sabit | −8,196676 | −8,196676 | −8,196676 | 3,6e−12 | ✓ |
| %95 GA alt Sabit | −2,129383 | −2,129383 | −2,129383 | 8,0e−14 | ✓ |
| %95 GA üst Sabit | −1,307553 | −1,307553 | −1,307553 | 2,6e−13 | ✓ |
| Marjinal etki sütunu Sabit | — | −0,684217 | −0,684217 | 2,3e−14 | ✓ |
| \beta dose_mg | 0,013615 | 0,013615 | 0,013615 | 1,5e−15 | ✓ |
| SH dose_mg (gözlenen bilgi) | 0,001729 | 0,001729 | 0,001729 | 1,7e−15 | ✓ |
| z dose_mg | 7,873666 | 7,873666 | 7,873666 | 8,5e−12 | ✓ |
| %95 GA alt dose_mg | 0,010226 | 0,010226 | 0,010226 | 4,8e−15 | ✓ |
| %95 GA üst dose_mg | 0,017004 | 0,017004 | 0,017004 | 2,1e−15 | ✓ |
| Marjinal etki sütunu dose_mg | 0,005421 | 0,005421 | 0,005421 | 5,7e−16 | ✓ |
| Log-olabilirlik ℓ | −57,178252 | −57,178252 | −57,178252 | 4,1e−13 | ✓ |
| ℓ0 (yalnız sabit) | −122,882130 | −122,882130 | −122,882130 | 6,1e−09 | ✓ |
| LR χ²(1) | 131,407756 | 131,407756 | 131,407756 | 1,2e−08 | ✓ |
| AIC | 118,356504 | 118,356504 | 118,356504 | 8,1e−13 | ✓ |
| BIC | 124,742417 | 124,742417 | 124,742417 | 1,2e−12 | ✓ |
| McFadden R^2 | 0,534690 | 0,534690 | 0,534690 | 2,3e−11 | ✓ |
| Doğruluk (kesim 0,5) | 0,872222 | 0,872222 | 0,872222 | 2,2e−16 | ✓ |
| AUC | 0,952024 | 0,952024 | 0,952024 | 1,1e−16 | ✓ |
| Hosmer–Lemeshow χ² (sd 3) | 351,839599 | 351,839599 | 351,839599 | 3,5e−12 | ✓ |
| AME dose_mg | 0,002534 | 0,002534 | 0,002534 | 2,3e−13 | ✓ |
| AME SH (delta) | 0,000168 | 0,000168 | 0,000168 | 7,3e−13 | ✓ |
| ED10 (mg) | 32,090607 | 32,090607 | 32,090607 | 4,9e−12 | ✓ |
| ED10 Fieller alt | 2,368843 | 2,368843 | 2,368843 | 2,3e−11 | ✓ |
| ED10 Fieller üst | 53,519711 | 53,519711 | 53,519711 | 1,5e−12 | ✓ |
| ED50 (mg) | 126,217920 | 126,217920 | 126,217920 | 5,2e−12 | ✓ |
| ED50 Fieller alt | 107,172994 | 107,172994 | 107,172994 | 1,8e−12 | ✓ |
| ED50 Fieller üst | 149,405837 | 149,405837 | 149,405837 | 2,6e−11 | ✓ |
| ED90 (mg) | 220,345232 | 220,345232 | 220,345232 | 1,6e−11 | ✓ |
| ED90 Fieller alt | 190,091580 | 190,091580 | 190,091580 | 1,3e−11 | ✓ |
| ED90 Fieller üst | 267,177526 | 267,177526 | 267,177526 | 8,8e−11 | ✓ |
| ED50 (MASS::dose.p ile) | 126,217920 | 126,217920 | 126,217920 | 5,2e−12 | ✓ |
log10 doz, ölçek ve logit bağlantı:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| \beta Sabit | −7,234649 | −7,234649 | −7,234649 | 7,1e−15 | ✓ |
| SH Sabit | 0,947937 | 0,947937 | 0,947937 | 8,7e−14 | ✓ |
| \beta log10(dose_mg) | 3,652834 | 3,652834 | 3,652834 | 1,8e−15 | ✓ |
| SH log10(dose_mg) | 0,472917 | 0,472917 | 0,472917 | 4,5e−14 | ✓ |
| log10: ℓ | −48,046026 | −48,046026 | −48,046026 | 2,1e−14 | ✓ |
| log10: Hosmer–Lemeshow χ² | 3,184765 | 3,184765 | 3,184765 | 8,4e−14 | ✓ |
| log10: AME | 0,551862 | 0,551862 | 0,551862 | 2,4e−10 | ✓ |
| log10: AME SH | 0,002200 | 0,002200 | 0,002200 | 1,6e−10 | ✓ |
| log10: ED10 (mg) | 42,630490 | 42,630490 | 42,630490 | 4,3e−14 | ✓ |
| log10: ED10 Fieller alt | 30,285759 | 30,285759 | 30,285759 | 8,8e−13 | ✓ |
| log10: ED10 Fieller üst | 53,680314 | 53,680314 | 53,680314 | 3,6e−13 | ✓ |
| log10: ED50 (mg) | 95,622029 | 95,622029 | 95,622029 | 8,5e−14 | ✓ |
| log10: ED50 Fieller alt | 79,575269 | 79,575269 | 79,575269 | 8,0e−13 | ✓ |
| log10: ED50 Fieller üst | 114,878669 | 114,878669 | 114,878669 | 1,7e−12 | ✓ |
| log10: ED90 (mg) | 214,484337 | 214,484337 | 214,484337 | 2,0e−13 | ✓ |
| log10: ED90 Fieller alt | 170,411814 | 170,411814 | 170,411814 | 1,9e−12 | ✓ |
| log10: ED90 Fieller üst | 301,635060 | 301,635060 | 301,635060 | 6,1e−12 | ✓ |
| Pearson X^2 (doz gruplarına toplulaştırılmış, sd 4) | 3,209409 | 3,209409 | 3,209409 | 4,4e−14 | ✓ |
| Pearson \varphi | 0,802352 | 0,802352 | 0,802352 | 1,1e−14 | ✓ |
| Ölçekli SH log10(dose_mg) | 0,423611 | 0,423611 | 0,423611 | 4,3e−14 | ✓ |
| Ölçekli ED50 Fieller alt | 75,355131 | 75,355131 | 75,355131 | 1,3e−12 | ✓ |
| Ölçekli ED50 Fieller üst | 121,293550 | 121,293550 | 121,293550 | 1,8e−12 | ✓ |
| Olay/deneme biçimi: gruplanmış Pearson X^2 (sd 4) | 3,209409 | 3,209409 | — | 3,1e−14 | ✓ |
| Olay/deneme biçimi: uyum p | 0,523412 | 0,523412 | — | 4,8e−15 | ✓ |
| Logit bağlantı: \beta Sabit | −3,304508 | −3,304508 | −3,304508 | 1,5e−13 | ✓ |
| Logit bağlantı: SH Sabit | 0,459085 | 0,459085 | 0,459085 | 8,2e−14 | ✓ |
| Logit bağlantı: \beta dose_mg | 0,028790 | 0,028790 | 0,028790 | 2,0e−15 | ✓ |
| Logit bağlantı: SH dose_mg | 0,004466 | 0,004466 | 0,004466 | 1,4e−15 | ✓ |
| Logit bağlantı: AME | 0,002582 | 0,002582 | 0,002582 | 1,1e−11 | ✓ |
| Logit bağlantı: ED50 | 114,780163 | 114,780163 | 114,780163 | 2,4e−12 | ✓ |
| %99 GA alt Sabit | −2,258502 | −2,258502 | −2,258502 | 1,2e−13 | ✓ |
| %99 GA üst Sabit | −1,178434 | −1,178434 | −1,178434 | 3,2e−13 | ✓ |
| %99 GA alt dose_mg | 0,009161 | 0,009161 | 0,009161 | 5,8e−15 | ✓ |
| %99 GA üst dose_mg | 0,018069 | 0,018069 | 0,018069 | 3,0e−15 | ✓ |
67 büyüklüğün tamamı ölçütü karşılar. Olay/deneme biçimindeki gruplanmış X^2 satırında R sütunu boştur (tanım Python'da bağımsız yazılmıştır).
109.7 Çıktıyı okuma
Sonuç metni (log10 doz; HL, AME, sınıflama tablosu ve ED/LD açık; kısaltılmış):
Probit Regresyon
  N (gözlem)         = 180
  Yordayıcı sayısı   = 1
  Log-olabilirlik      = -48.046
  AIC                  = 100.0921
  BIC                  = 106.478
  Pseudo R² (McFadden) = 0.609
  Modellenen olasılık  = P(Y=1|X)
  SINIFLANDIRMA METRİKLERİ (kesim 0.5) =
    Doğruluk           = 0.8833
    Duyarlılık         = 0.9481
    Özgüllük           = 0.835
    AUC                = 0.952

      Değişken  Katsayı      SE        z       p  Marjinal etki   GA alt   GA üst
         Sabit  -7.2346  0.9479  -7.6320  0.0000              —  -9.0926  -5.3767
  log10(dose_m   3.6528  0.4729   7.7241  0.0000         1.2611   2.7259   4.5797
  (sütun aralıkları sayfaya sığması için daraltılmıştır)

── MODEL UYUMU ──
    LR χ²(1) = 149.6722, p = 2.045e-34 (sıfır model LL = -122.8821)
    Hosmer-Lemeshow: χ² = 3.185, df = 3, p = 0.364 → karşılanıyor (anlamsız ise model uyumu iyi)

── ORTALAMA MARJİNAL ETKİLER (AME) ──
    log10(dose_mg)          0.55186   0.00220  250.896  <0.0001      0.54755    0.55617

── DOZ-YANIT: ETKİLİ DOZLAR (ED/LD) VE %95 FIELLER GÜVEN SINIRLARI ──
         P           Doz        GA alt        GA üst       log10
      0.10         42.63        30.286         53.68     1.62972
      0.50        95.622        79.575        114.88     1.98056  ← ED50
      0.90        214.48        170.41        301.64     2.33140
    ED_p = (Φ⁻¹(p) − a)/b; Fieller sınırları (normal kritik değer,
    heterojenlik çarpanı yok); g = 0.0644
| Öğe | Nasıl yorumlanır |
|---|---|
| Modellenen olasılık | Hangi değerin olay sayıldığı; katsayıların işareti buna bağlıdır. |
| Katsayı | Normal sapma ölçeğinde etki: log10 dozdaki 1 birim (10 kat doz) artış probit'i 3,65 artırır. |
| Marjinal etki sütunu | Ortalama \eta'da olasılık türevi (MEM); sabit satırında "—". |
| AME | Gözlemler üzerinden ortalama türev; log10 dozda 0,1 birimlik (≈ %26 doz) artış ortalama 0,055 olasılık artışı. |
| Hosmer–Lemeshow | p\ge\alpha: kalibrasyon bozukluğu kanıtı yok. Az sayıda farklı \hat\pi olduğunda sd küçülür. |
| ED/LD tablosu | Modelin dozu tersine çevirmesi; ED50 ve Fieller sınırları. g 1'e yaklaştıkça sınırlar güvenilmezleşir; g\ge1'de "—". |
| Negatif ED | Ham doz ölçeğinde düşük p'lerde görülür; log doz gerekir. |
p sütununda 0.0000 |
p<0{,}00005; raporda "p<0{,}001". |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
İlaca yanıt olasılığını doza göre modellemek için log10 dozlu probit regresyon kuruldu (n = 180; altı doz düzeyinde 30'ar hasta; 77 yanıt). Doz, yanıt olasılığıyla güçlü biçimde ilişkiliydi (b = 3{,}65; %95 GA [2,73; 4,58]; z = 7{,}72; p < 0{,}001), \chi^2(1, N = 180) = 149{,}67, p < 0{,}001, McFadden R^2 = 0{,}61. Hosmer–Lemeshow testi uyumsuzluk göstermedi, \chi^2(3) = 3{,}18, p = 0{,}36. Hastaların yarısında yanıt sağlayan doz ED50 = 95,6 mg (%95 Fieller güven sınırları 79,6–114,9 mg), ED90 = 214,5 mg (170,4–301,6 mg) olarak kestirildi.
109.8 Uzman soruları
S1. Lojistik yerine neden probit? Sonuçlar ne kadar farklı?
Olasılık eğrileri orta bölgede neredeyse aynıdır; fark kuyruklardadır. Probit, normal tolerans ya da gizil normal hata kuramına dayanan alanlarda (toksikoloji, ekonometride ikili seçim, iki denklemli modeller) tercih edilir. Odds oranı yorumu istenirse lojistik kullanılmalıdır. Bu veride ham dozla logit bağlantının log-olabilirliği daha iyidir (−53,61'e karşı −57,18), log10 dozla probit ikisinden de iyidir (−48,05).
S2. R `glm` ile SH'ler neden farklı?
R glm probit modeli Fisher skorlamasıyla kestirir ve summary.glm SH'leri beklenen bilgiden verir (\SH(b_1)=0{,}001920). MerQur (statsmodels Probit) Newton–Raphson kullanır ve gözlenen bilgiden verir (0{,}001729). Probit kanonik bağlantı olmadığı için iki matris farklıdır; katsayılar aynıdır. Doğrulamada R'de gözlenen bilgi elle hesaplanmış ve 10^{-12} düzeyinde eşleşmiştir. Logit bağlantıda (kanonik) iki yol aynı SH'yi verir.
S3. Hosmer–Lemeshow sd'si neden 3? R'de test hiç sonuç vermiyor.
Altı doz düzeyi yalnız altı farklı \hat\pi üretir; ondalık kesim noktaları çakışır, beş dolu grup kalır. MerQur sd'yi dolu grup sayısından alır (5-2=3). ResourceSelection::hoslem.test boş aralığı tabloda bırakır (0/0 katkı) ve sd'yi g-2=8 sayar; bu veride NaN döner. Ham doz modelindeki 351,84'lük değerin 342,86'sı tek gruptan gelir (beklenen 0,0029); χ² yaklaşımı geçersizdir ama uyumsuzluğun yönü gerçektir.
S4. Fieller sınırları neden ED50 çevresinde simetrik değil? g neyi gösterir?
ED, iki normal kestiricinin oranıdır; dağılımı çarpıktır. Fieller aralığı oranın dağılımını doğrudan tersine çevirdiği için asimetriktir (log10 modelinde ED50 = 95,6; sınırlar −16,0 / +19,3 mg). g=t^2v_{bb}/b^2, eğimin göreli belirsizliğidir: g küçükse (burada 0,064) Fieller ve delta aralıkları birbirine yakındır; g\to1 olduğunda üst sınır sonsuza gider; g\ge1'de aralık sınırsızdır ve MerQur "—" yazar.
S5. AME'nin z'si 250 çıktı. Hata mı?
Hayır; R marginaleffects aynı değeri verir. Delta yöntemi açıklayıcıları sabit kabul eder. Doz düzeyleri olasılık eğrisinin hemen tamamını (0,0002'den 0,988'e) kapsadığında, ortalama türev \frac1n\sum\phi(\eta_i)b yaklaşık "toplam olasılık değişimi / doz aralığı"na eşittir ve eğim ile konumdaki belirsizlik bu ortalamayı neredeyse değiştirmez. Bu yüzden AME, katsayıdan çok daha kesin kestirilir. AME'nin GA'sı "bu doz tasarımında ortalama eğim" içindir; başka bir doz aralığına genellenemez.
S6. Heterojenlik testi neden bireysel 0/1 veride de doz grupları üzerinden yapılıyor?
X^2 doz grupları üzerinden (sd = grup − parametre) hesaplanır; Pearson uyum testinin dağılımı ancak gruplanmış binom veride tanımlıdır. Bireyler üzerinden toplanırsa bu veride p=0{,}030<0{,}15 çıkar ve yapay bir düzeltme uygulanır; doz gruplarında p=0{,}523 olur ve düzeltme uygulanmaz. MerQur bireysel veriyi önce ortak değişken örüntülerine toplulaştırır; böylece "Deneme sayısı (n) sütunu" ile ya da 0/1 satırlarla girilen aynı veri aynı kararı verir. Sürekli bir ortak değişkende örüntü sayısı n'ye yakın olduğundan test yapılmaz ve not yazılır.
S7. "Doğal yanıt" seçince neden katsayılar değişmedi?
Abbott modeli \hat C'yi kestirir; bu veride en düşük dozda hiç yanıt yoktur ve \hat C sıfır sınırına gider (<10^{-4}). MerQur bu durumda "sınırda" uyarısı yazar ve tabloyu standart modelden verir. Kontrol grubunda kendiliğinden yanıt varsa (ör. böcek ölüm deneylerinde %5–10) \hat C sınırdan uzaklaşır ve ED'ler düzeltilmiş olasılığa göre hesaplanır.
S8. Katsayı tablosundaki "Marjinal etki" ile AME farklı. Hangisi raporlanmalı?
Tablo sütunu, ortalama doğrusal yordayıcıdaki türevdir (MEM; ham dozda 0,005421). AME her gözlemdeki türevlerin ortalamasıdır (0,002534). Doğrusal olmayan modelde ikisi farklıdır; ortalama \eta'ya karşılık gelen "ortalama hasta" gerçek bir hasta olmayabilir. Güncel uygulamada AME tercih edilir; MEM'in SH'si MerQur'da verilmez.
109.9 Sık hatalar ve tuzaklar
- Probit katsayısını odds oranı gibi okumak. e^{\beta} probitte anlamsızdır; katsayı normal sapma ölçeğindedir. Olasılık ölçeğinde etki için AME kullanılmalıdır.
- Geometrik doz dizisinde ham dozu kullanmak. Bu veride ham doz modeli negatif ED01 ve 400 mg'de neredeyse kesin yanıt kestirir; HL testi uyumsuzluğu gösterir. Doz-yanıtta log10 doz önce denenmelidir.
- Doz sütununu ilk sıraya koymamak. ED/LD ve log10 dönüşümü ilk açıklayıcıya uygulanır; doz ikinci sırada seçilirse tablo yanlış değişkene göre hesaplanır.
- Sürekli ortak değişkende heterojenlik düzeltmesi beklemek. Her gözlemin kendi örüntüsü olduğunda uyum X^2'si tanımsızdır; MerQur düzeltme uygulamaz ve notla bildirir.
- Olay kategorisini metin kodlu hedefte denetlememek. Sıra tanımlanmamışsa olay, verideki ilk görülme sırasına bağlıdır; "Modellenen olasılık" satırı okunmalıdır.
- HL p'sini az grupla yorumlamak. sd 3'e düştüğünde ve beklenen sayılar 1'in altına indiğinde test güvenilmez.
- g'yi görmezden gelmek. g 0,5'i aşıyorsa Fieller sınırları çok geniştir; eğim zayıf belirlenmiştir.
109.10 Kaynaklar
- Abbott, W. S. (1925). A method of computing the effectiveness of an insecticide. Journal of Economic Entomology, 18(2), 265–267. https://doi.org/10.1093/jee/18.2.265a
- Bliss, C. I. (1934). The method of probits. Science, 79(2037), 38–39. https://doi.org/10.1126/science.79.2037.38
- Efron, B., & Hinkley, D. V. (1978). Assessing the accuracy of the maximum likelihood estimator: Observed versus expected Fisher information. Biometrika, 65(3), 457–483. https://doi.org/10.1093/biomet/65.3.457
- Fieller, E. C. (1954). Some problems in interval estimation. Journal of the Royal Statistical Society: Series B (Methodological), 16(2), 175–185. https://doi.org/10.1111/j.2517-6161.1954.tb00159.x
- Finney, D. J. (1971). Probit analysis (3. baskı). Cambridge University Press.
- Hosmer, D. W., & Lemeshow, S. (1980). Goodness of fit tests for the multiple logistic regression model. Communications in Statistics – Theory and Methods, 9(10), 1043–1069. https://doi.org/10.1080/03610928008827941
- McCullagh, P., & Nelder, J. A. (1989). Generalized linear models (2. baskı). Chapman and Hall. https://doi.org/10.1007/978-1-4899-3242-6
- Williams, R. (2012). Using the margins command to estimate and interpret adjusted predictions and marginal effects. The Stata Journal, 12(2), 308–331. https://doi.org/10.1177/1536867X1201200209