54. Doğrusal Karma Model (LMM)
Analiz kimliği: lmm · Menü adı: LMM (Linear Mixed Models) · Panel: gui/panels/analyses/lmm.py, execute (satır 663–1146), _execute_engine (1272–1339), _fill_extras (1173–1237) · Motor: stats/mixed_reml.py, LMMEngine (satır 101–792), term_tests (1063–1104), containment_df (1107–1170), emmeans (1301–1380), lrt_random/lrt_fixed (1527–1548) · Hata yapıları: stats/mixed_rside.py
54.1 Ne işe yarar
Doğrusal karma model (LMM), gözlemlerin gruplar halinde toplandığı ve aynı gruptaki gözlemlerin birbirine benzediği verilerde sabit etkileri (tedavi, zaman, yaş) doğru standart hatayla kestirir ve gruplar arası değişkenliği bir varyans bileşeni olarak ölçer. Tipik örnek: aynı hastanın dört vizitte ölçülen HbA1c değerleri. Hasta 1'in değerleri hep düşük, hasta 3'ün değerleri hep yüksektir; bu "hasta etkisi" modele rastgele bir terim olarak girer.
Model, Laird ve Ware (1982) gösterimiyle:
- \mathbf y (n\times1): bağımlı değişken; n gözlem sayısı.
- \mathbf X (n\times p): sabit etki tasarım matrisi (sabit terim, kovaryatlar, kategorik değişkenlerin gösterge sütunları); \boldsymbol\beta (p\times1): sabit etkiler.
- \mathbf Z (n\times q): rastgele etki tasarım matrisi; her grup için bir kesişim sütunu (ve varsa eğim sütunları); \mathbf b (q\times1): rastgele etkiler.
- \mathbf G: rastgele etkilerin kovaryansı; blok köşegen, her grupta aynı r\times r blok \boldsymbol\Sigma (r: grup başına rastgele etki sayısı).
- \sigma^2: grup içi (artık) varyans.
- Gözlemlerin marjinal kovaryansı: \mathbf V=\mathbf Z\mathbf G\mathbf Z^\top+\sigma^2\mathbf I.
En basit biçimi, rastgele kesişimli modeldir. Tıp örneğinde i. hastanın j. vizitteki değeri:
- D_{ij}^{V3}, D_{ij}^{V6}, D_{ij}^{V12}: vizit göstergeleri (0/1); V0 referanstır (54.9'da düzey sırası tuzağına bakın).
- u_i: i. hastanın kalıcı sapması; \sigma^2_u hastalar arası varyans.
- Aynı hastanın iki ölçümü arasındaki korelasyon \rho=\sigma^2_u/(\sigma^2_u+\sigma^2), yani ICC'dir.
Cevaplanan sorular: (1) Sabit etkiler sıfırdan farklı mı (H_0:\mathbf L\boldsymbol\beta=\mathbf 0; ör. dört vizit ortalaması eşit mi)? (2) Gruplar arası varyans ne kadar (\sigma^2_u, ICC)? (3) Hangi kovaryans yapısı veriye daha uygun (LRT, AIC)?
Ne zaman kullanılır
- Boylamsal veri: aynı denekte zaman içinde tekrarlı ölçüm, eksik vizitler olsa da (MAR altında liste bazında silme gerekmez; denek ölçülen vizitleriyle modele girer).
- Hiyerarşik veri: hasta → doktor → klinik, öğrenci → sınıf → okul (ikinci gruplama değişkeni "iç içe").
- Çapraz gruplama: hem denek hem uyaran rastgele (ikinci gruplama "çapraz").
- Denek başına farklı eğim (rastgele eğim) ya da zamana bağlı hata korelasyonu (AR(1), UN …) modellenmek isteniyorsa.
Ne zaman kullanılmaz
- Bağımlı değişken ikili, sayım ya da oran ise: GLMM (Bölüm 58) ya da popülasyon ortalaması için GEE (Bölüm 57).
- Grup yapısı yoksa (her birim bir kez ölçülmüş): Çoklu Doğrusal Regresyon (Bölüm 45).
- Tam dengeli, eksiksiz tekrarlı ölçüm ve yalnız grup × zaman testleri isteniyorsa: Karma Desen ANOVA (Bölüm 11) aynı testleri klasik F ve küresellik düzeltmeleriyle verir.
- Replikasyon × üst grup × iç içe alt grup desenleri için EMS tablosu da isteniyorsa: Nested LMM (Bölüm 55); iki çapraz faktörün EMS tablosu için Crossed LMM (Bölüm 56).
- Grup sayısı çok küçükse (ör. 3 klinik): varyans bileşeni güvenilir kestirilemez; grubu sabit etki olarak modelleyin.
Sık karıştırılan analizler. Tekrarlı ölçümler ANOVA (Bölüm 10) bileşik simetri varsayar ve eksik vizitli deneği tümüyle atar; rastgele kesişimli LMM dengeli veride aynı F'yi verir, eksik veride deneği korur. GEE popülasyon ortalaması etkisini kestirir ve rastgele etkiye dayanmaz. Varyans bileşenleri paneli (Bölüm 100) yalnız rastgele faktörlerden oluşan modeller içindir.
54.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Sürekli bağımlı değişken | Aralık/oran ölçeği | Sayısala zorlanır (lmm.py:818); sabitse hata (lmm.py:829–830) |
| Doğrusal sabit etkiler | E[\mathbf y\mid\mathbf b]=\mathbf X\boldsymbol\beta+\mathbf Z\mathbf b | Denetlenmez |
| Rastgele etkilerin normalliği | \mathbf b\sim N(\mathbf 0,\mathbf G) | Denetlenmez; BLUP listesi "Artık tanıları + BLUP" kutusunda incelenebilir |
| Artıkların normalliği ve sabit varyansı | \boldsymbol\varepsilon\sim N(\mathbf 0,\sigma^2\mathbf I) (ya da seçilen R yapısı) | "Artık tanıları" kutusu: koşullu artıkların Shapiro–Wilk testi, çarpıklık, basıklık, \lvert e/\hat\sigma\rvert>3 sayısı (lmm.py:1240–1261) |
| Gruplar bağımsız | Farklı hastaların rastgele etkileri ve hataları bağımsız | Denetlenmez |
| Eksik veri MAR | Eksiklik gözlenen değerlere bağlı olabilir, gözlenmeyenlere değil | Denetlenmez; olabilirlik tabanlı kestirim MAR altında yansızdır |
| Yeterli grup | En az 2 grup; n\ge p+2 | Altında hata (lmm.py:870–873); n<30 ya da grup <5 ise uyarı (lmm.py:875–876) |
Eksik değer. Bağımlı değişken, sabit etkiler, grup, eğim, ikinci grup, EMM faktörleri ve R yapısı değişkenlerinden herhangi biri eksik olan satır çıkarılır (stats/missing_rows.drop_missing_rows, lmm.py:819–820). Satır bazında silme yapılır, denek bazında değil: bir vizitte HbA1c eksik olan hasta, öteki vizitleriyle modelde kalır.
Uç durumlar (kod satırlarıyla):
- Sabit bir sayısal sabit etki modelden düşülür ve uyarı yazılır (lme4 gibi); tek düzeyli kategorik sabit etki hata verir (
lmm.py:836–858). - Grup değişkeni aynı zamanda kategorik sabit etki seçilmişse hata: rastgele kesişim sabit etki göstergeleriyle tam eşdoğrusaldır (
lmm.py:777–779). Çapraz ikinci grup için aynı denetimlmm.py:769–772'dedir. - Sabit etki matrisi rank eksikse motor durur: "rank deficient" (
mixed_reml.py:114–115). - Bir rastgele etki varyansı sıfır sınırındaysa (göreli SS <10^{-6}) "Tekil uyum" uyarısı yazılır (
lmm.py:1311–1312); o bileşenin GA'sı "—" olur (mixed_reml.py:846–863). - Gözlem/parametre oranı 10'un altındaysa uyarı (
lmm.py:1307–1310). - Kenward–Roger n>4000'de çalışmaz (
mixed_reml.py:679–680); analitik Hessian n>3000'de sayısal Richardson türevine döner (mixed_reml.py:437,425–428). - Kapsama sd'si yalnız tek gruplamalı, yalnız kesişimli modelde uygulanır; öteki durumlarda Satterthwaite'e dönülür ve uyarı + "İstenen ve uygulanan ayarlar" kaydı yazılır (
lmm.py:941–951,1283–1287). - REML motoru hata verirse, yapısal seçenek (ek eğim, VC, ikinci grup) ya da KR/kapsama istenmemişse statsmodels MixedLM yedek yoluna Wald z ile düşülür ve uyarı yazılır (
lmm.py:974–980).
54.3 Parametreler
Varsayılanlar lmm.py:135–409 (form, read_options) ve stats_panel.py:6187–6241 (çağrı) içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken | ilk sayısal sütun | Sürekli yanıt. | |
| Sabit etkiler | boş (en az 1) | Sayısal sütun kovaryat, metin sütunu kategorik (gösterge kodlu) olarak girer. | Kategoriklerde ilk sıralı düzey referanstır (54.9). |
| Etkileşim | kapalı | İlk iki seçili sabit etki arasında A×B ekler. | Tek sabit etkide yok sayılır ve ayar kaydına not düşer (stats_panel.py:6209–6216). |
| Ek etkileşim terimleri | boş | a:b, a:b:c, a*b biçiminde serbest terimler. |
Değişkenler sabit etkilerden olmalı (lmm.py:755–764). |
| Grup değişkeni (rastgele kesişim) | ilk sütun | Rastgele kesişimin grubu. | |
| Rastgele eğim (isteğe bağlı) | (yok) | Sayısal bir değişkene grup başına eğim. | Kovaryans tipi "Rastgele etki kovaryansı" ile belirlenir. |
| Kestirim yöntemi | REML | REML ya da ML. | ML varyansları aşağı yanlı kestirir (54.5.1); sabit etkili modelleri LRT/AIC ile karşılaştırmak için ML gerekir. |
| Sabit etki df yöntemi | Satterthwaite t (varsayılan) | Satterthwaite, Kenward–Roger, Wald z, Gruplar arası–grup içi (kapsama). | Yalnız sd, p ve GA'yı değiştirir; KR ayrıca SH'yi büyütür (54.5.6). |
| Ek rastgele eğimler | boş | Birden çok sayısal eğim. | |
| Rastgele etki kovaryansı | Yapılandırılmamış (UN, ilişkili) | UN ya da VC (köşegen, ilişkisiz). | VC'de kesişim–eğim kovaryansı sıfırdır. |
| 2. gruplama değişkeni | (yok) | İkinci rastgele kesişim. | |
| 2. grup ilişkisi | iç içe (1. grup içinde) | İç içe: (1\mid g_1{:}g_2); çapraz: (1\mid g_2). | |
| Kestirilen marjinal ortalama (EMM) faktörü | (yok) | Kategorik sabit etkinin düzey EMM'leri + ikili karşılaştırma. | Ek bölüm. |
| EMM p düzeltmesi | Bonferroni | Bonferroni, Šidák, Holm, Tukey, yok. | |
| EMM ikinci faktör | (yok) | İki faktörlü hücre EMM'leri ve her düzeyde basit karşılaştırmalar. | |
| Düzeltme kapsamı | Her düzeyde ayrı aile | Basit karşılaştırmalarda aile tanımı. | |
| Referans düzeyi | boş | faktör=düzey ile gösterge kodlamasının referansı. |
Katsayılar değişir; model uyumu değişmez. |
| Düzey sırası | boş | EMM listelerinin sırası. | Kestirim değişmez. |
| Özel kontrast (L) | boş | L matrisi ile kontrastlar; sd yöntemi tabloyla aynı. | Ek bölüm. |
| Hata kovaryans yapısı (R / REPEATED) | σ²I — bağımsız | ID, AR(1), CS, UN, TOEP, CSH, ARH(1). | ID dışı seçimlerde stats/mixed_rside.py motoru (54.5.9). |
| Zaman/sıra değişkeni (REPEATED) | (yok) | R yapısının zaman ekseni. | ID dışı yapı ve karşılaştırma için zorunlu (lmm.py:806–808). |
| Tekrarlı ölçüm deneği | grupla aynı | R bloklarının deneği. | |
| Rastgele etki yok (yalnız R yapısı) | kapalı | gls / MMRM modeli. | |
| R yapılarını AIC/BIC ile karşılaştır | kapalı | Aynı sabit etkiler ve G ile bütün R yapılarını uydurur. | Ek tablo. |
| Olabilirlik oranı testleri | kapalı | Rastgele terim LRT'leri (REML) + sabit terim LRT'leri (ML). | Ek bölüm. |
| Artık tanıları + BLUP | kapalı | Koşullu artık özeti, Shapiro–Wilk, BLUP ± koşullu SS. | Ek bölüm. |
| Tahmin ve artıkları kaydet | kapalı | PRED_LMM, RESID_LMM, FIXPRED_LMM sütunları. | Veri setine eklenir. |
| Güven Düzeyi | %95 | Sabit etki, EMM ve kovaryans parametresi GA'ları. | ★ işareti seçilen düzeyin \alpha'sına göre verilir. |
Neden varsayılan Satterthwaite, Wald z değil?
Wald z, sabit etki kestiricisinin SH'sini kesin bilinen bir sayı gibi kullanır. Gerçekte SH varyans bileşenlerinin kestirimine dayanır ve bu kestirim grup sayısı kadar bilgi içerir. Satterthwaite sd'si bu belirsizliği ölçer: Tıp örneğinde sabit terimin (V0 ortalaması) sd'si yalnız 54'tür, çünkü varyansında hastalar arası bileşen baskındır ve o bileşen 50 hastadan kestirilir. z yerine t_{54} kullanmak GA'yı %1–2 genişletir; grup sayısı küçükken fark büyür. R lmerTest varsayılanı da Satterthwaite'tir.
54.4 Tıp örneği
- Dosya:
english/datasets/Tip/53_lmm_patient_visit_HbA1c.xlsx(Türkçe kopya:samples/Tum_Analiz_Tip/53_lmm_hasta_vizit_HbA1c.xlsx). - Değişken seçimi:
VIDEO_SCRIPT_TR.txt#53: bağımlı HbA1c; yordayıcı visit; küme patient_id (rastgele).
| Değişken | Rol | Tür | Açıklama/özet |
|---|---|---|---|
| HbA1c | Bağımlı | Sürekli (%) | Genel ortalama 7,5793 |
| visit | Sabit etki | Kategorik, 4 düzey | V0, V3, V6, V12 (ay); ortalamalar 8,2888; 7,8308; 7,3768; 6,8206 |
| patient_id | Grup (rastgele kesişim) | Kimlik, 50 hasta | Her hastada 4 ölçüm |
| month | Türetilmiş | Sayısal | Rastgele eğim senaryosu için visit'ten türetildi: 0, 3, 6, 12 |
n ve eksik değer. 200 satır, eksik yok; 50 hasta × 4 vizit, tam dengeli. Rastgele eğim senaryosunda month sütunu veride yoktur; doğrulama betiğinde visit etiketinden türetilmiştir (yalnız bellekte).
Klinik soru. HbA1c 12 ay içinde düşüyor mu, düşüş hangi vizitlerde anlamlı? Hastalar arası fark ölçüm değişkenliğinin ne kadarını oluşturuyor?
Seçilen ayarlar. Varsayılanlar (REML, Satterthwaite, rastgele kesişim, σ²I) ve hesap yürüyüşü için EMM faktörü = visit (Bonferroni), olabilirlik oranı testleri ve artık tanıları açık. Ek senaryolar: Kenward–Roger; kapsama; ML + Wald z; month ile rastgele eğim (UN ve VC); dengesiz alt örnek (hasta 1–10'un V12'si ve 11–15'in V6'sı çıkarılmış, 185 gözlem; Satterthwaite ve KR); AR(1) hata yapısı (rastgele etkisiz ve rastgele kesişimli).
54.5 Formüller ve hesap adımları
MerQur'un hesap sırası (lmm.py:663–1146, mixed_reml.py): (1) eksik satırlar çıkarılır, patsy ile \mathbf X (gösterge kodlu) ve \mathbf Z kurulur; (2) varyans parametreleri, profillenmiş REML (ya da ML) sapması en küçüklenerek bulunur (lme4 yöntemi; Bates vd. 2015); (3) optimumda analitik gradyan/Hessian ile Newton cilası yapılır; (4) \hat{\boldsymbol\beta} ve \mathrm{Var}(\hat{\boldsymbol\beta}) cezalı en küçük karelerden alınır; (5) kovaryans parametrelerinin asimptotik kovaryansı gözlenen Hessian'ın tersinden (2\mathbf H^{-1}) hesaplanır; (6) her sabit etki ve kontrast için seçilen yöntemle sd bulunur; (7) III. tür F testleri, EMM, LRT, R², ICC ve tanılar eklenir. Wald z dahil her sd yöntemi aynı REML motorunu kullanır (lmm.py:781–786); statsmodels yalnız motor hatasında yedektir.
54.5.1 Olabilirlik: ML ve REML
\mathbf y\sim N(\mathbf X\boldsymbol\beta,\mathbf V) olduğundan ML ölçütü (−2 log-olabilirlik):
- \boldsymbol\psi: varyans–kovaryans parametreleri (\sigma^2_u, varsa eğim varyansı ve kovaryans, \sigma^2); \mathbf V=\mathbf V(\boldsymbol\psi).
- Verilen \boldsymbol\psi için en iyi \boldsymbol\beta genelleştirilmiş en küçük kareler (GLS) çözümüdür: \hat{\boldsymbol\beta}=(\mathbf X^\top\mathbf V^{-1}\mathbf X)^{-1}\mathbf X^\top\mathbf V^{-1}\mathbf y.
ML, \boldsymbol\beta'nın kestirildiğini hesaba katmaz; varyansları aşağı yanlı bulur (klasik örnek: \hat\sigma^2_{ML}=\mathrm{RSS}/n, yansız olan \mathrm{RSS}/(n-p)). REML (kısıtlı en çok olabilirlik; Patterson & Thompson 1971), \boldsymbol\beta'dan bağımsız n-p doğrusal kontrastın olabilirliğini en büyükler:
- \mathbf y^\top\mathbf P\mathbf y=(\mathbf y-\mathbf X\hat{\boldsymbol\beta})^\top\mathbf V^{-1}(\mathbf y-\mathbf X\hat{\boldsymbol\beta}): GLS artıklarının ağırlıklı kareler toplamı.
- \log|\mathbf X^\top\mathbf V^{-1}\mathbf X|: \boldsymbol\beta'nın kestirilmesinin bedeli; bu terim ML'de yoktur.
Neden REML varsayılan?
Dengeli tek gruplamalı modelde REML kestirimleri ANOVA (KO) kestirimlerine eşittir ve yansızdır: \hat\sigma^2=\mathrm{MS}_E, \hat\sigma^2_u=(\mathrm{MS}_S-\mathrm{MS}_E)/k. ML aynı veride \hat\sigma^2_u'yu (1-1/G) oranına yakın küçültür (Tıp örneğinde 1,7238 yerine 1,6893). Sabit etki SH'leri varyanslara dayandığından ML, SH'leri de küçültür ve testleri liberalleştirir. Buna karşılık REML olabilirlikleri yalnız aynı sabit etkili modeller arasında karşılaştırılabilir; sabit etki LRT'si için ML gerekir (54.5.8).
REML −2ℓ değeri sabit etki kodlamasına bağlıdır
\log|\mathbf X^\top\mathbf V^{-1}\mathbf X| terimi \mathbf X'in ölçeğine ve kodlamasına duyarlıdır: \mathbf X yerine \mathbf X\mathbf T kullanılırsa −2ℓ_R, 2\log|\det\mathbf T| kadar kayar. Varyans kestirimleri, \hat{\boldsymbol\beta}, F ve sd'ler değişmez. MerQur ve lme4 patsy/R gösterge kodlu \mathbf X'i kullanır; toplam-sıfır kodlu bir program (ya da referans düzeyi değiştirilmiş bir çalıştırma) farklı −2ℓ_R ve AIC basabilir (Bölüm 55.6.1'de sayısal örnek).
54.5.2 Profillenmiş sapma ve cezalı en küçük kareler
MerQur, lme4'ün parametrelemesini kullanır (mixed_reml.py:101–226). Rastgele etkiler göreli kovaryans faktörü \boldsymbol\Lambda_\theta ile yazılır: \mathbf b=\boldsymbol\Lambda_\theta\mathbf u, \mathbf u\sim N(\mathbf 0,\sigma^2\mathbf I), böylece \mathbf G=\sigma^2\boldsymbol\Lambda_\theta\boldsymbol\Lambda_\theta^\top. Rastgele kesişimli modelde \boldsymbol\Lambda_\theta=\theta\,\mathbf I_G ve \theta=\sigma_u/\sigma (göreli SS) tek parametredir.
Verilen \theta için cezalı en küçük kareler (PLS) sistemi Cholesky ile çözülür (_pls_core, satır 193–213):
- \mathbf L_\theta: q\times q alt üçgen Cholesky çarpanı; \mathbf R_X: p\times p üst üçgen.
- \hat{\boldsymbol\beta}, \hat{\mathbf u} geri yerine koyma ile; r^2_\theta=\lVert\mathbf y-\mathbf X\hat{\boldsymbol\beta}-\mathbf Z\boldsymbol\Lambda_\theta\hat{\mathbf u}\rVert^2+\lVert\hat{\mathbf u}\rVert^2 cezalı artık kareler toplamıdır (koddaki
prss).
\sigma^2 kapalı biçimde profillenir (\hat\sigma^2=r^2_\theta/(n-p) REML'de, r^2_\theta/n ML'de) ve geriye yalnız \theta'ya bağlı profillenmiş sapma kalır (deviance, satır 215–226):
- \log|\mathbf L_\theta|^2=\log|\mathbf V|-n\log\sigma^2; \log|\mathbf R_X|^2=\log|\mathbf X^\top\mathbf V^{-1}\mathbf X|+p\log\sigma^2. Yerine konunca d_R(\theta)=-2\ell_R(\hat\sigma^2(\theta),\theta) olur; yani 54.5.1'deki ölçütün \sigma^2 üzerinden en küçüklenmiş hâlidir.
- Çıktıdaki "−2LL (REML)" değeri d_R(\hat\theta)'dır; "Log-Olabilirlik" bunun -1/2 katıdır.
Neden bu parametreleme?
(1) \sigma^2 analitik olarak çıkar, en küçükleme boyutu bir azalır. (2) \mathbf L_\theta, \theta=0'da (varyans sıfır) bile tanımlıdır; \mathbf G tekil olsa da sistem çözülür. Bu yüzden sınırdaki (\hat\sigma^2_u=0) çözümler sorunsuz bulunur. (3) \theta'nın köşegen öğeleri \ge0 sınırıyla, köşegen dışı öğeleri sınırsız optimize edilir (mixed_reml.py:131–140).
Koddaki tercih: koşullandırma
\mathbf X PLS'den önce içeride merkezlenip ölçeklenir (\mathbf X_c=\mathbf X\mathbf T, _condition, satır 811–826); \hat{\boldsymbol\beta}, (\mathbf R_X^\top\mathbf R_X)^{-1} ve \log|\mathbf R_X|^2 özgün parametrelemeye geri çevrilir (pls, satır 174–191). Böylece merkezlenmemiş kovaryatlarda (ör. yaş 40–80) sayısal kararlılık korunur ve −2ℓ_R kodlama bağımlılığı (54.5.1 uyarısı) özgün \mathbf X'e göre kalır.
54.5.3 Optimizasyon ve Newton cilası
fit (satır 240–288) üç başlangıç noktası (köşegen θ = 1; 0,5; 2) ve iki yöntemle (L-BFGS-B, Powell) arar, en iyi sonucu Nelder–Mead ile parlatır. Ardından iç optimumda Newton cilası yapılır (_newton_polish, satır 300–365): (\theta,\sigma) uzayında analitik gradyan ve Hessian ile Newton adımları, gradyan normu 10^{-10}'a inene kadar; sapmayı artıran adım yarılanır, sınırdaki bileşenler sabit tutulur.
Koddaki tercih: neden cila?
Türevsiz ve yarı-Newton yöntemler gradyanı tam sıfırlamadan durabilir; SH'ler ve Satterthwaite sd'leri Hessian'a dayandığından durma noktasındaki küçük sapma sonuca taşınır. Kod yorumunda belgelendiği gibi cilasız kestirimde kovaryans parametresi kovaryansı üçüncü ondalıkta sapabilir (mixed_reml.py:307–313). Cila ile bu doğrulamada MerQur, bağımsız Python ve R değerleri 10^{-9} düzeyinde örtüşür; R (lme4, bobyqa) kendi durma toleransı nedeniyle varyans bileşenlerinde 10^{-7} göreli kadar ayrılabilir (54.6.1).
54.5.4 Kovaryans parametrelerinin standart hataları
Kovaryans parametresi tablosu her varyans/kovaryans için kestirim, SH, Wald Z, p ve GA verir (covparm_table, satır 567–619). SH'ler gözlenen bilgi matrisinden gelir. Kovaryans parametrelemesinde (\boldsymbol\psi: \mathbf G öğeleri ve \sigma^2) \mathbf V doğrusaldır, \partial\mathbf V/\partial\psi_a=\mathbf V_a sabittir ve Harville (1977) türevleri kapalı biçimdedir (_psi_hessian, satır 459–505):
- \mathbf Q=\mathbf P (REML) ya da \mathbf V^{-1} (ML).
- \mathbf V_a: rastgele kesişim için \mathbf Z\mathbf Z^\top (aynı gruptaki gözlem çiftlerinde 1); artık varyansı için \mathbf I; eğim varyansı için (\mathbf z_i x_i)(\mathbf z_j x_j)^\top; kesişim–eğim kovaryansı için iki çapraz terimin toplamı.
Hessian (\theta,\sigma)'ya zincir kuralıyla taşınır (\mathbf H_v=\mathbf J^\top\mathbf H_\psi\mathbf J+\sum_a g_a\,\partial^2\psi_a/\partial\mathbf v^2; varpar_hessian, satır 406–428), asimptotik kovaryans \mathbf A_v=2\mathbf H_v^{-1} alınır (vcov_varpar, 556–564; lmerTest ile aynı) ve delta yöntemiyle \boldsymbol\psi'ye döndürülür:
- \mathbf v=(\theta,\sigma); "2" çarpanı, \mathbf H'nin -2\ell'nin Hessian'ı olmasından gelir (\mathrm{Cov}=[\partial^2(-\ell)]^{-1}=2[\partial^2(-2\ell)]^{-1}).
- İç optimumda gradyan sıfır olduğundan sonuç 2\mathbf H_\psi^{-1}'e eşittir (bağımsız Python bu yolu kullanır).
Wald Z=\hat\psi/\mathrm{SH}, iki yönlü normal p. Varyanslar için log-Wald GA \hat\psi\exp(\pm z\,\mathrm{SH}/\hat\psi) (_log_ci, 872–877), kovaryanslar için düz Wald GA \hat\psi\pm z\,\mathrm{SH}; kovaryans satırında ayrıca korelasyon r=\hat\sigma_{01}/\sqrt{\hat\sigma^2_0\hat\sigma^2_1} yazılır.
Wald Z bir varyans testi değildir
\sigma^2_u=0 parametre uzayının sınırındadır; Wald Z'nin normal yaklaşımı orada geçersizdir ve küçük grup sayısında \hat\sigma^2_u'nun dağılımı çok çarpıktır. Bir rastgele terimin gerekli olup olmadığı LRT ile (karışım dağılımı, 54.5.8) sınanmalıdır. MerQur tablonun altına bu notu yazar.
54.5.5 Sabit etkiler, Wald z ve kapsama sd'si
\widehat{\mathrm{Var}}(\hat{\boldsymbol\beta})=\boldsymbol\Phi=\hat\sigma^2(\mathbf R_X^\top\mathbf R_X)^{-1}=(\mathbf X^\top\hat{\mathbf V}^{-1}\mathbf X)^{-1} (vcov_beta, 368–373). Bir kontrast \mathbf c^\top\boldsymbol\beta için t=\mathbf c^\top\hat{\boldsymbol\beta}/\sqrt{\mathbf c^\top\boldsymbol\Phi\mathbf c}; GA \mathbf c^\top\hat{\boldsymbol\beta}\pm t_{1-\alpha/2,\nu}\sqrt{\mathbf c^\top\boldsymbol\Phi\mathbf c} (fixed_table, 1240–1267). Yöntemler yalnız \nu'yu (ve KR'de SH'yi) değiştirir:
- Wald z: \nu=\infty, normal dağılım.
- Kapsama (gruplar arası–grup içi): grup içinde sabit sütunlar (grup düzeyi değişkenler ve sabit terim) \nu_b=G-\mathrm{rank}(\mathbf X_b); grup içinde değişen sütunlar \nu_w=n-G-\mathrm{rank}(\tilde{\mathbf X}_w), \tilde{\mathbf X}_w grup içi merkezlenmiş (
containment_df, 1076–1139). Bir kontrastın sd'si, katsayısı sıfır olmayan sütunların en küçük sd'sidir (R emmeans kuralı; 1142–1150). Tıp örneğinde \nu_b=50-1=49, \nu_w=200-50-3=147.
Kapsama sd'sinde sabit terim
MerQur sabit terime grup düzeyi sd'sini (49) verir. R nlme::lme sabit terim satırında en içteki sd'yi (147) basar (mixed_reml.py:1117–1119). Yalnız sabit terim satırı ayrışır; visit testleri her iki programda F(3,\,147)=168{,}087'dir (54.6.1, Tablo 2).
54.5.6 Satterthwaite ve Kenward–Roger serbestlik dereceleri
Satterthwaite (tek sd). \mathbf c^\top\hat{\boldsymbol\beta}'nın varyansı v(\boldsymbol\psi)=\mathbf c^\top\boldsymbol\Phi(\boldsymbol\psi)\mathbf c, kestirilen parametrelere bağlı bir rastgele değişkendir. Ölçekli ki-kare yaklaşımı \nu\hat v/v\sim\chi^2_\nu altında \mathrm{Var}(\hat v)=2v^2/\nu; delta yöntemiyle \mathrm{Var}(\hat v)\approx\mathbf g^\top\mathbf A\mathbf g (satterthwaite_1d, 632–644):
- \mathbf A: kovaryans parametrelerinin asimptotik kovaryansı (54.5.4).
- \mathbf g: varyansın parametrelere göre gradyanı; analitik (
_var_grad, 543–554; \partial\boldsymbol\Phi/\partial\psi_a=\boldsymbol\Phi\mathbf X^\top\mathbf V^{-1}\mathbf V_a\mathbf V^{-1}\mathbf X\boldsymbol\Phi).
Neden bu formül klasik Satterthwaite'in genellemesidir?
Dengeli tek gruplamalı modelde V0 ortalamasının varyansı (\sigma^2_u+\sigma^2)/G=[\mathrm{MS}_S+(k-1)\mathrm{MS}_E]/(kG)'dir; KO'lar bağımsız ki-kareler olduğundan Satterthwaite (1946) formülü \nu=[\mathrm{MS}_S+(k-1)\mathrm{MS}_E]^2/[\mathrm{MS}_S^2/\nu_S+(k-1)^2\mathrm{MS}_E^2/\nu_E] verir. Genel formül bu durumda aynı sayıyı üretir (54.6, Adım 5). Avantajı, KO'ların tanımlanamadığı dengesiz, eğimli ya da çapraz modellerde de çalışmasıdır (Giesbrecht & Burns 1985).
Satterthwaite (çok sd, F). q satırlı \mathbf L için \mathbf L\boldsymbol\Phi\mathbf L^\top=\mathbf U\mathbf D\mathbf U^\top özdeğer ayrışımı yapılır; \tilde{\mathbf L}=\mathbf U^\top\mathbf L'nin satırları ilişkisiz tek sd'li kontrastlardır (satterthwaite_F, 646–666; Fai & Cornelius 1996):
- d_m: özdeğerler; \nu_m: m. satırın tek sd'li Satterthwaite sd'si.
- E: qF'nin beklenen değerinin yaklaşığı; F_{q,\nu}'nun ortalaması \nu/(\nu-2) olduğundan \nu bu eşitlikten çözülür. E\le q ise sd 0 yazılır.
Koddaki tercih: III. tür hipotez ve taban
Terim testleri (term_tests, 1032–1073) III. türdür: bir etkileşimde yer alan terim, kategorikleri toplam-sıfır kodlu yeniden kurulmuş \mathbf X_s'de sınanır (REML kestirimi doğrusal yeniden parametrelemeye değişmez; \theta aynı kalır, yalnız \boldsymbol\beta ve \boldsymbol\Phi yeniden hesaplanır). Etkileşimde yer almayan terim özgün gösterge kodlu \mathbf X'te sınanır. Hipotez tabanı, terim sütunlarının öteki sütunlardan arındırılmış çapraz çarpımının eşelon biçimidir (_type3_basis, 1196–1223); çok sd'li durumda QR ile ortonormalleştirilir (1063–1064). Fai–Cornelius paydası tabana ve koordinata duyarlıdır; F ve KR değildir. lmerTest'le içerilen terimlerde 10^{-4} göreli düzeyde ayrışma görülebilir (Bölüm 55.6.1).
Kenward–Roger. KR (Kenward & Roger 1997) iki düzeltme yapar (_kr_setup, 669–713; kenward_roger, 715–743): (1) \boldsymbol\Phi'nin küçük örneklem yanlılığını düzelten büyütülmüş kovaryans \boldsymbol\Phi_A; (2) F'yi ölçekleyen \lambda ve payda sd'si m.
- \mathbf P_i=-\mathbf X^\top\mathbf V^{-1}\mathbf V_i\mathbf V^{-1}\mathbf X, \mathbf Q_{ij}=\mathbf X^\top\mathbf V^{-1}\mathbf V_i\mathbf V^{-1}\mathbf V_j\mathbf V^{-1}\mathbf X; \mathbf P_\perp: REML izdüşümü (\mathbf P).
- \mathbf W: beklenen bilgiden asimptotik kovaryans (Satterthwaite'ten farklı olarak gözlenen değil).
- \mathbf V doğrusal olduğundan ikinci türev terimi (\mathbf R_{ij}) sıfırdır.
\boldsymbol\Theta=\mathbf L^\top(\mathbf L\boldsymbol\Phi\mathbf L^\top)^{-1}\mathbf L, \ell=\mathrm{rank}(\mathbf L) ile
- F_{KR}\sim F(\ell,\ m) yaklaşığı; \lambda ölçek çarpanı ("scale" alanı).
- Tek sd'li kontrastta SH =\sqrt{\mathbf c^\top\boldsymbol\Phi_A\mathbf c}, sd =m (
kr_1d, 745–751).
Satterthwaite mi, Kenward–Roger mi?
Dengeli desenlerde iki yöntem aynı sd'yi verir ve \boldsymbol\Phi_A=\boldsymbol\Phi'dir (Tıp örneğinde \lambda=1). Dengesiz ve küçük örneklemlerde KR, SH'yi de büyüttüğü için daha tutucudur ve benzetim çalışmalarında I. tip hatayı nominal düzeye daha yakın tutar. Bedeli hesaptır: n\times n matrisler kurulur (n\le4000). Dengesiz alt örnekte V12 katsayısının SH'si 0,073480'dan 0,073483'e, sd'si 132,235'ten 132,213'e değişir.
54.5.7 III. tür testler, EMM, R² ve ICC
EMM (emmeans, 1270–1353): referans ızgarası bütün kategorik düzey kombinasyonlarıdır (eşit ağırlık), sayısal kovaryatlar ortalamalarında tutulur. Bir düzeyin EMM vektörü \mathbf c_j ızgaranın o düzeydeki satırlarının ortalamasıdır; EMM =\mathbf c_j^\top\hat{\boldsymbol\beta}, SH ve sd seçilen yöntemle. İkili farklar \mathbf c_j-\mathbf c_{j'}; Bonferroni \min(1,mp), Šidák 1-(1-p)^m, Tukey P(q_{k,\nu}>\sqrt2\lvert t\rvert), Holm adım adım; m=k(k-1)/2.
R² (Nakagawa & Schielzeth 2013; Johnson 2014) (nakagawa_r2, 789–808):
- \mathrm{Var}(\mathbf X\hat{\boldsymbol\beta}): n-1 paydalı örneklem varyansı (R
performance::r2_nakagawaile aynı). - \mathbf e_{ik}: i. gözlemin k. rastgele terimdeki tasarım satırı (kesişim için 1, eğim için x_i); rastgele eğimde \sigma^2_r gözleme göre değişir ve ortalaması alınır (Johnson 2014).
ICC. Çıktıdaki ICC, ilk terimin kesişim varyansının, bütün kesişim varyanslarının ve \hat\sigma^2'nin toplamına oranıdır (lmm.py:1298–1302): \mathrm{ICC}=\hat\sigma^2_{u,1}/(\sum_k\hat\sigma^2_{u,k}+\hat\sigma^2). Rastgele eğimli modelde eğim varyansını içermez; eğimi de içeren "düzeltilmiş ICC" \sigma^2_r/(\sigma^2_r+\hat\sigma^2) ayrıca saklanır (icc_adjusted).
54.5.8 Olabilirlik oranı testleri
Rastgele terimler (lrt_random, 1453–1478; lmerTest ranova karşılığı): eğimli terimde eğimler çıkarılır, yalnız kesişimli terimde terimin kendisi; model aynı yöntemle (REML ise REML) yeniden uydurulur. \mathrm{LRT}=d_{\text{indirgenmiş}}-d_{\text{tam}}, sd = parametre farkı, p=P(\chi^2_{sd}>\mathrm{LRT}). Bütün rastgele terimler çıkarılınca model OLS olur ve REML sapması kapalı biçimde hesaplanır: \log|\mathbf X^\top\mathbf X|+(n-p)[1+\log(2\pi\,\mathrm{RSS}/(n-p))] (_refit_dev, 1486–1496).
Neden "p'yi ikiye bölün" notu?
H_0:\sigma^2_u=0 sınırdadır. Self ve Liang (1987) bu durumda LRT'nin dağılımının \tfrac12\chi^2_0+\tfrac12\chi^2_1 karışımı olduğunu gösterir; \chi^2_1 ile hesaplanan p iki kat tutucudur. Tek bir varyansın çıkarıldığı testte MerQur karışım p'sini de saklar (p_mixture); metin, p'nin ikiye bölünmesi gerektiğini not eder. Eğim çıkarılırken (varyans + kovaryans, sd 2) karışım \tfrac12\chi^2_1+\tfrac12\chi^2_2 olur; kod bu durumda karışım p'si vermez.
Sabit terimler (lrt_fixed, 1504–1525; drop1 benzeri): marjinallik ilkesine uyan her terim (daha yüksek dereceli bir terimin alt kümesi olmayan) çıkarılır; tam ve indirgenmiş model ML ile uydurulur. REML olabilirlikleri farklı \mathbf X'li modeller arasında karşılaştırılamaz (54.5.1).
54.5.9 Hata (R) kovaryans yapıları
R yapısı seçildiğinde model \mathbf V=\mathbf Z\mathbf G\mathbf Z^\top+\mathbf R, \mathbf R=\mathrm{blokköşegen}_i\,\boldsymbol\Sigma(t_i,t_i) olur (stats/mixed_rside.py). Desteklenen yapılar:
| Yapı | \boldsymbol\Sigma_{jk} | Parametre sayısı (T zaman) |
|---|---|---|
| ID | \sigma^2\mathbf 1[j=k] | 1 |
| CS | \sigma_1+\sigma^2\mathbf 1[j=k] | 2 |
| AR(1) | \sigma^2\rho^{\lvert j-k\rvert} | 2 |
| TOEP | \sigma_{\lvert j-k\rvert} | T |
| UN | serbest | T(T+1)/2 |
| CSH | \sigma_j\sigma_k\,(\rho\ \text{ya da}\ 1) | T+1 |
| ARH(1) | \sigma_j\sigma_k\rho^{\lvert j-k\rvert} | T+1 |
Zaman düzeyleri doğal sırayla dizilir ("V3" < "V12"; mixed_rside.py:811–841); AR(1) komşuluğu bu sıraya dayanır ve aralıklar eşit sayılır. Kestirim, denek blokları Cholesky ile beyazlatıldıktan sonra aynı profillenmiş PLS'yle yapılır (Wolfinger vd. 1994). Toeplitz korelasyonları kısmi otokorelasyonlarla parametrelenir; matris her zaman pozitif tanımlıdır. SH ve sd'ler sayısal (Richardson) Hessian'la hesaplanır.
54.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/lmm/elle_hesap.py ile, MerQur çağrılmadan hesaplanmıştır. Bağımsız kestirici (dogrulama/lmm/reml_bagimsiz.py) lme4 parametrelemesini kullanmaz: tam \mathbf V=\sum_a\psi_a\mathbf V_a matrisini kurar, −2ℓ_R'yi 54.5.1'deki tanımla doğrudan hesaplar ve Harville türevleriyle Newton yinelemesi yapar.
Adım 1 — Dengeli desenin KO'ları. 50 hasta × 4 vizit tablosunu hasta × vizit iki yönlü ayrıştırmasıyla çözelim. Genel ortalama \bar y=7{,}57925.
Vizit KT'si 50\sum_j(\bar y_{\cdot j}-\bar y)^2=59{,}163721 (\nu=3).
Adım 2 — REML kestirimi (kapalı biçim). Dengeli desende REML = ANOVA:
\hat\theta=\sqrt{1{,}723787/0{,}117328}=3{,}8330. ICC =1{,}723787/(1{,}723787+0{,}117328)=0{,}936274: aynı hastanın iki vizitteki HbA1c değerleri arasındaki korelasyon 0,94'tür. Toplam değişkenliğin büyük kısmı hastalar arasındadır.
Şekil 54.1. Profillenmiş REML sapması d_R(\theta). En küçük değer \hat\theta=3{,}833'te 352,32'dir; kesikli gri çizgi, profil olabilirlik %95 GA'sının eşiği (minimum + 3,84).
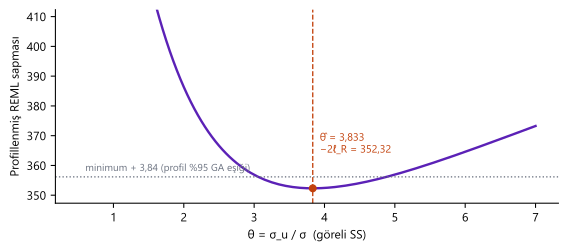
Adım 3 — Sayısal REML ve yakınsama. Bağımsız kestirici (\sigma^2_u,\sigma^2)=(1;\ 1)'den başlatılınca:
| Yineleme | \sigma^2_u | \sigma^2 | -2\ell_R |
|---|---|---|---|
| 0 | 1,000000 | 1,000000 | 540,7039 |
| 2 | 1,024324 | 0,801486 | 512,8641 |
| 8 | 1,081173 | 0,204232 | 376,6957 |
| 9 | 1,136419 | 0,131307 | 357,8386 |
| 10 | 1,432983 | 0,113546 | 353,2625 |
| 11 | 1,640596 | 0,117091 | 352,3786 |
| 12 | 1,716239 | 0,117327 | 352,3198 |
| 13 | 1,723722 | 0,117328 | 352,319383 |
| 14 | 1,723787 | 0,117328 | 352,319383 |
İlk sekiz adımda Hesse matrisi pozitif tanımlı olmadığından adımlar gradyan yönünde kısa tutulur; optimumun yakınında (9. adımdan sonra) Newton'ın karesel yakınsaması görülür. Son değer Adım 2'deki kapalı biçimle 10^{-8} içinde eşleşir; -2\ell_R=352{,}319383, MerQur'un "−2LL (REML)" satırıyla aynıdır.
Adım 4 — Kovaryans parametresi SH'leri. Gözlenen Hessian'ın tersinin iki katı:
\mathrm{SH}(\hat\sigma^2_u)=\sqrt{0{,}125458}=0{,}354200, \mathrm{SH}(\hat\sigma^2)=0{,}013685. Dengeli desende kapalı biçim: \mathrm{SH}(\hat\sigma^2)=\sqrt{2\mathrm{MS}_E^2/147}=0{,}013685; \mathrm{SH}(\hat\sigma^2_u)=\sqrt{(2/16)(\mathrm{MS}_S^2/49+\mathrm{MS}_E^2/147)}=0{,}354200. Wald Z=1{,}723787/0{,}354200=4{,}867; log-Wald %95 GA: 1{,}723787\,e^{\pm1{,}959964\times0{,}354200/1{,}723787}=[1{,}1523;\ 2{,}5786].
Adım 5 — Sabit terimin Satterthwaite sd'si. V0 ortalaması \hat\beta_0=8{,}2888, \mathrm{Var}(\hat\beta_0)=(\hat\sigma^2_u+\hat\sigma^2)/50=0{,}036822, SH =0{,}191891. Gradyan \mathbf g=(1/50,\ 1/50):
Klasik Satterthwaite: [\mathrm{MS}_S+3\mathrm{MS}_E]^2/[\mathrm{MS}_S^2/49+(3\mathrm{MS}_E)^2/147]=53{,}997. İki yol aynıdır. t=8{,}2888/0{,}191891=43{,}195.
Adım 6 — Vizit katsayıları. Vizit farklarında hasta etkisi sadeleşir: \mathrm{Var}(\hat\beta_{V12})=2\hat\sigma^2/50, SH =\sqrt{2\cdot0{,}117328/50}=0{,}068506; varyans yalnız \hat\sigma^2'ye dayandığından \nu=\nu_E=147. \hat\beta_{V12}=6{,}8206-8{,}2888=-1{,}4682, t=-21{,}432, %95 GA -1{,}4682\pm1{,}976233\times0{,}068506=[-1{,}6036;\ -1{,}3328]. III. tür F (vizit): F=\mathrm{MS}_V/\mathrm{MS}_E=19{,}721240/0{,}117328=168{,}087, F(3,\,147), p=2{,}63\cdot10^{-47}. Kenward–Roger aynı sonucu verir (\lambda=1).
Adım 7 — EMM ve ikili karşılaştırma. EMM'ler vizit ortalamalarıdır: V0 8,2888; V3 7,8308; V6 7,3768; V12 6,8206; her birinin SH'si 0,191891 ve sd'si 53,997. Karşılaştırmalar düzey sırasında yazılır (öndeki eksi arkadaki). V3 − V12 farkı 1{,}0102, SH 0,068506, t=14{,}746, \nu=147; Bonferroni p=6\times8{,}82\cdot10^{-31}=5{,}29\cdot10^{-30}.
Şekil 54.2. Elli hastanın HbA1c yörüngeleri (gri) ve vizit EMM'leri (%95 GA, Satterthwaite sd). Yörüngelerin paralel ama farklı yüksekliklerde olması rastgele kesişim yapısını, aralarındaki geniş yayılım yüksek ICC'yi gösterir.
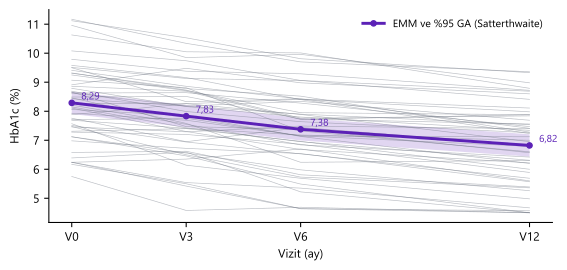
Adım 8 — R², BLUP ve LRT. \sigma^2_f=\mathrm{Var}(\mathbf X\hat{\boldsymbol\beta})=0{,}297305; R^2_m=0{,}297305/(0{,}297305+1{,}723787+0{,}117328)=0{,}139030, R^2_c=0{,}945134. Hasta 1'in BLUP'u: hasta ortalaması 5,8925, vizit ortalaması 7,57925; büzülme çarpanı \hat\sigma^2_u/(\hat\sigma^2_u+\hat\sigma^2/4)=0{,}983269:
Rastgele kesişim LRT'si: hasta terimi çıkarılınca OLS REML sapması 691,5047; \mathrm{LRT}=691{,}5047-352{,}3194=339{,}185, \chi^2_1. Vizit için ML LRT: indirgenmiş -2\ell_{ML}=562{,}7733, tam 339,5016; \chi^2_3=223{,}272.
Adım 9 — Rastgele eğim (UN). month sabit + (1+\text{month}\mid\text{patient\_id}): \hat\sigma^2_0=1{,}682812, \hat\sigma_{01}=0{,}001348 (r=0{,}030), \hat\sigma^2_1=0{,}001204, \hat\sigma^2=0{,}091890; \hat\beta_{\text{month}}=-0{,}121429 (SH 0,006886, \nu=49{,}000). Eğim terimi LRT =358{,}7498-349{,}2599=9{,}490, sd 2, p=0{,}0087: hastaların düşüş hızları farklıdır. VC yapısında \nu=49{,}875'e çıkar; kovaryans sıfırlanınca sd'yi tek bir KO belirlemez.
54.6.1 Doğrulama: MerQur, Python ve R
Betikler dogrulama/lmm/ klasöründedir: merqur_calistir.py (MerQur execute(); round ve p_yuvarla yalnız bellekte etkisizleştirildi), elle_hesap.py + reml_bagimsiz.py + elle_ar1.py (bağımsız Python), r_dogrulama.R (R 4.5.3: lme4, lmerTest, pbkrtest, nlme, emmeans, performance). R'de kovaryans parametresi SH'leri lmerTest'in (\theta,\sigma) asimptotik kovaryansından (numDeriv sayısal Hessian) delta yöntemiyle alınmıştır. Bu yüzden R'nin varyans SH'leri ve Satterthwaite/KR sd'leri 10^{-6} göreli düzeyde sapabilir; tabloda bu satırlar "R: sayısal Hessian" notuyla 5\cdot10^{-6} göreli toleransla değerlendirildi. MerQur ve bağımsız Python her satırda 10^{-6} ölçütünü sağlar.
Tablo 1. Varsayılan model (REML, Satterthwaite): sabit etkiler, kovaryans parametreleri, R², bilgi ölçütleri, III. tür F, EMM, LRT, BLUP.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Intercept b | 8,288800 | 8,288800 | 8,288800 | 7,2e−13 | ✓ |
| Intercept SH | 0,191891 | 0,191891 | 0,191891 | 8,0e−10 | ✓ |
| Intercept sd | 53,997096 | 53,997096 | 53,997095 | 7,8e−07 | ✓ (R: sayısal Hessian) |
| Intercept p | 1,4719·10−43 | 1,4719·10−43 | 1,4719·10−43 | 1,8e−49 | ✓ (R: sayısal Hessian) |
| visit[T.V12] b | −1,468200 | −1,468200 | −1,468200 | 1,8e−14 | ✓ |
| visit[T.V12] SH | 0,068506 | 0,068506 | 0,068506 | 1,0e−10 | ✓ |
| visit[T.V12] sd | 147,000000 | 147,000000 | 147,000000 | 2,3e−07 | ✓ (R: sayısal Hessian) |
| visit[T.V12] p | 4,4302·10−47 | 4,4302·10−47 | 4,4302·10−47 | 1,1e−53 | ✓ (R: sayısal Hessian) |
| visit[T.V3] b | −0,458000 | −0,458000 | −0,458000 | 1,7e−14 | ✓ |
| visit[T.V3] SH | 0,068506 | 0,068506 | 0,068506 | 1,0e−10 | ✓ |
| visit[T.V3] sd | 147,000000 | 147,000000 | 147,000000 | 2,3e−07 | ✓ (R: sayısal Hessian) |
| visit[T.V3] p | 4,4702·10−10 | 4,4702·10−10 | 4,4702·10−10 | 2,5e−17 | ✓ (R: sayısal Hessian) |
| visit[T.V6] b | −0,912000 | −0,912000 | −0,912000 | 2,1e−14 | ✓ |
| visit[T.V6] SH | 0,068506 | 0,068506 | 0,068506 | 1,0e−10 | ✓ |
| visit[T.V6] sd | 147,000000 | 147,000000 | 147,000000 | 2,3e−07 | ✓ (R: sayısal Hessian) |
| visit[T.V6] p | 4,9744·10−27 | 4,9744·10−27 | 4,9744·10−27 | 7,4e−34 | ✓ (R: sayısal Hessian) |
| \hat\sigma^2_u kestirimi | 1,723787 | 1,723787 | 1,723787 | 1,6e−08 | ✓ |
| \hat\sigma^2_u SH | 0,354200 | 0,354200 | 0,354200 | 5,5e−09 | ✓ (R: sayısal Hessian) |
| \hat\sigma^2_u GA alt | 1,152340 | 1,152340 | — | 3,0e−13 | ✓ |
| \hat\sigma^2_e kestirimi | 0,117328 | 0,117328 | 0,117328 | 3,5e−10 | ✓ |
| \hat\sigma^2_e SH | 0,013685 | 0,013685 | 0,013685 | 5,1e−11 | ✓ (R: sayısal Hessian) |
| \hat\sigma^2_e GA alt | 0,093350 | 0,093350 | — | 2,7e−14 | ✓ |
| ICC | 0,936274 | 0,936274 | — | 1,1e−16 | ✓ |
| Nakagawa R^2_m | 0,139030 | 0,139030 | 0,139030 | 1,0e−09 | ✓ |
| Nakagawa R^2_c | 0,945134 | 0,945134 | 0,945134 | 5,6e−10 | ✓ |
| −2LL (REML) | 352,319383 | 352,319383 | 352,319383 | 7,2e−11 | ✓ |
| AIC | 364,319383 | 364,319383 | 364,319383 | 7,2e−11 | ✓ |
| BIC | 384,109287 | 384,109287 | 384,109287 | 7,2e−11 | ✓ |
| AICC | 364,754616 | 364,754616 | — | 6,3e−11 | ✓ |
| III. tür F (visit) | 168,087004 | 168,087004 | 168,087004 | 5,0e−07 | ✓ |
| III. tür payda sd | 147,000000 | 147,000000 | 147,000000 | 2,3e−07 | ✓ (R: sayısal Hessian) |
| EMM V0 | 8,288800 | 8,288800 | 8,288800 | 7,2e−13 | ✓ |
| EMM V12 | 6,820600 | 6,820600 | 6,820600 | 7,0e−13 | ✓ |
| EMM sd (V0) | 53,997096 | 53,997096 | 53,997095 | 7,8e−07 | ✓ (R: sayısal Hessian) |
| Bonferroni p V3 - V12 | 5,2909·10−30 | 5,2909·10−30 | 5,2909·10−30 | 8,9e−37 | ✓ (R: sayısal Hessian) |
| Bonferroni p V3 - V6 | 3,6387·10−9 | 3,6387·10−9 | 3,6387·10−9 | 2,0e−16 | ✓ (R: sayısal Hessian) |
| Rastgele terim LRT | 339,185362 | 339,185362 | 339,185362 | 7,2e−11 | ✓ |
| Rastgele terim LRT p | 9,6003·10−76 | 9,6003·10−76 | 9,6003·10−76 | 3,5e−86 | ✓ |
| Sabit terim LRT (ML) χ² | 223,271687 | 223,271687 | 223,271687 | 4,2e−11 | ✓ |
| Sabit terim LRT AIC (indirgenmiş) | 568,773279 | 568,773279 | 568,773279 | 2,2e−12 | ✓ |
| BLUP hasta 1 | −1,658529 | −1,658529 | −1,658529 | 3,4e−10 | ✓ |
| BLUP hasta 2 | −1,326675 | −1,326675 | −1,326675 | 2,7e−10 | ✓ |
| BLUP koşullu SS | 0,169827 | 0,169827 | 0,169827 | 2,3e−10 | ✓ |
Tablo 2. Kenward–Roger, kapsama sd'si ve ML + Wald z.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Intercept KR sd | 53,997096 | 53,997096 | 53,997096 | 6,0e−08 | ✓ (R: sayısal Hessian) |
| Intercept KR SH | 0,191891 | 0,191891 | 0,191891 | 8,0e−10 | ✓ |
| visit[T.V12] KR sd | 147,000000 | 147,000000 | 147 | 4,5e−13 | ✓ (R: sayısal Hessian) |
| visit[T.V12] KR SH | 0,068506 | 0,068506 | 0,068506 | 1,0e−10 | ✓ |
| KR III. tür F | 168,087004 | 168,087004 | 168,087004 | 5,0e−07 | ✓ |
| KR payda sd | 147,000000 | 147,000000 | 147 | 9,1e−13 | ✓ (R: sayısal Hessian) |
| Kapsama sd: sabit terim | 49 | 49 | — | 0,0e+00 | ✓ |
| nlme sabit terim sd (başka tanım) | — | — | 147 | 0,0e+00 | ✓ |
| Kapsama sd: visit katsayıları | 147 | 147 | 147 | 0,0e+00 | ✓ |
| Kapsama visit p (V12) | 4,4302·10−47 | 4,4302·10−47 | 4,4302·10−47 | 9,3e−58 | ✓ |
| Kapsama F (visit) | 168,087004 | 168,087004 | 168,087004 | 6,3e−11 | ✓ |
| ML Intercept SH | 0,189963 | 0,189963 | 0,189963 | 5,3e−09 | ✓ |
| ML Intercept z | 43,633818 | 43,633818 | 43,633816 | 1,2e−06 | ✓ |
| ML visit[T.V12] SH | 0,067818 | 0,067818 | 0,067818 | 6,7e−10 | ✓ |
| ML visit[T.V12] z | −21,649214 | −21,649214 | −21,649215 | 2,1e−07 | ✓ |
| ML \hat\sigma^2_u | 1,689311 | 1,689311 | 1,689311 | 1,0e−07 | ✓ |
| ML \hat\sigma^2_u SH | 0,343627 | 0,343627 | 0,343627 | 3,6e−08 | ✓ (R: sayısal Hessian) |
| ML \hat\sigma^2_e | 0,114981 | 0,114981 | 0,114981 | 2,3e−09 | ✓ |
| ML \hat\sigma^2_e SH | 0,013277 | 0,013277 | 0,013277 | 3,3e−10 | ✓ (R: sayısal Hessian) |
| −2LL (ML) | 339,501592 | 339,501592 | 339,501592 | 4,4e−11 | ✓ |
Tablo 3. Rastgele eğim (UN, VC), dengesiz alt örnek (Satterthwaite ve KR) ve AR(1) hata yapısı.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Intercept SH (UN) | 0,186437 | 0,186437 | 0,186437 | 4,9e−08 | ✓ |
| Intercept sd (UN) | 49,000000 | 49,000000 | 49,000041 | 4,1e−05 | ✓ (R: sayısal Hessian) |
| month SH (UN) | 0,006886 | 0,006886 | 0,006886 | 3,0e−10 | ✓ |
| month sd (UN) | 49,000000 | 49,000000 | 49,000004 | 4,2e−06 | ✓ (R: sayısal Hessian) |
| Var(Intercept) (UN) | 1,682812 | 1,682812 | 1,682811 | 9,3e−07 | ✓ (R: sayısal Hessian) |
| Var(Intercept) SH (UN) | 0,351205 | 0,351205 | 0,351204 | 3,2e−07 | ✓ (R: sayısal Hessian) |
| Cov(Intercept, month) (UN) | 0,001348 | 0,001348 | 0,001348 | 2,2e−09 | ✓ (R: sayısal Hessian) |
| Cov(Intercept, month) SH (UN) | 0,009236 | 0,009236 | 0,009236 | 5,7e−09 | ✓ (R: sayısal Hessian) |
| Var(month) (UN) | 0,001204 | 0,001204 | 0,001204 | 5,6e−10 | ✓ (R: sayısal Hessian) |
| Var(month) SH (UN) | 0,000507 | 0,000507 | 0,000507 | 3,7e−11 | ✓ (R: sayısal Hessian) |
| Var(Residual) (UN) | 0,091890 | 0,091890 | 0,091890 | 2,8e−08 | ✓ (R: sayısal Hessian) |
| Var(Residual) SH (UN) | 0,012995 | 0,012995 | 0,012995 | 5,0e−09 | ✓ (R: sayısal Hessian) |
| −2LL (UN) | 349,259942 | 349,259942 | 349,259942 | 1,1e−10 | ✓ |
| Intercept SH (VC) | 0,186802 | 0,186802 | 0,186802 | 3,9e−09 | ✓ |
| Intercept sd (VC) | 49,874689 | 49,874689 | 49,874685 | 3,7e−06 | ✓ (R: sayısal Hessian) |
| month SH (VC) | 0,006899 | 0,006899 | 0,006899 | 5,9e−11 | ✓ |
| month sd (VC) | 49,874689 | 49,874689 | 49,874688 | 1,1e−06 | ✓ (R: sayısal Hessian) |
| Var(Intercept) (VC) | 1,689724 | 1,689724 | 1,689724 | 7,4e−08 | ✓ (R: sayısal Hessian) |
| Var(Intercept) SH (VC) | 0,349357 | 0,349357 | 0,349357 | 2,6e−08 | ✓ (R: sayısal Hessian) |
| Var(month) (VC) | 0,001215 | 0,001215 | 0,001215 | 7,3e−11 | ✓ (R: sayısal Hessian) |
| Var(month) SH (VC) | 0,000502 | 0,000502 | 0,000502 | 1,1e−11 | ✓ (R: sayısal Hessian) |
| Var(Residual) (VC) | 0,091715 | 0,091715 | 0,091715 | 2,6e−09 | ✓ (R: sayısal Hessian) |
| Var(Residual) SH (VC) | 0,012890 | 0,012890 | 0,012890 | 4,6e−10 | ✓ (R: sayısal Hessian) |
| −2LL (VC) | 349,281104 | 349,281104 | 349,281104 | 1,4e−10 | ✓ |
| Eğim terimi LRT (UN) | 9,489889 | 9,489889 | 9,489889 | 1,2e−10 | ✓ |
| Johnson R^2_c (UN) | 0,957012 | 0,957012 | 0,957012 | 3,1e−08 | ✓ (R: sayısal Hessian) |
| Intercept sd (dengesiz, Satt.) | 53,810824 | 53,810824 | 53,810823 | 1,3e−06 | ✓ (R: sayısal Hessian) |
| Intercept sd (dengesiz, KR) | 53,787515 | 53,787515 | 53,787515 | 1,1e−07 | ✓ (R: sayısal Hessian) |
| Intercept SH (dengesiz, KR) | 0,191055 | 0,191055 | 0,191055 | 1,4e−09 | ✓ |
| visit[T.V12] sd (dengesiz, Satt.) | 132,235325 | 132,235325 | 132,235326 | 4,0e−07 | ✓ (R: sayısal Hessian) |
| visit[T.V12] sd (dengesiz, KR) | 132,213358 | 132,213358 | 132,213358 | 4,6e−09 | ✓ (R: sayısal Hessian) |
| visit[T.V12] SH (dengesiz, KR) | 0,073483 | 0,073483 | 0,073483 | 2,2e−10 | ✓ |
| F visit (dengesiz, Satt.) | 141,284446 | 141,284446 | 141,284447 | 8,4e−07 | ✓ |
| payda sd (dengesiz, Satt.) | 132,179246 | 132,179246 | 132,179272 | 2,6e−05 | ✓ (R: sayısal Hessian) |
| F visit (dengesiz, KR) | 141,274865 | 141,274865 | 141,274866 | 8,4e−07 | ✓ (R: sayısal Hessian) |
| payda sd (dengesiz, KR) | 132,157336 | 132,157336 | 132,157336 | 3,4e−09 | ✓ (R: sayısal Hessian) |
| ρ (AR(1)) | 0,954119 | 0,954119 | 0,954119 | 1,6e−08 | ✓ (sayısal optimizasyon) |
| σ² (AR(1)) | 1,826980 | 1,826980 | 1,826980 | 4,6e−07 | ✓ (sayısal optimizasyon) |
| visit[T.V12] SH (AR(1)) | 0,098002 | 0,098002 | 0,098002 | 3,8e−09 | ✓ (sayısal optimizasyon) |
| −2LL (AR(1)) | 335,463704 | 335,463704 | 335,463704 | 5,6e−12 | ✓ |
| ρ (kesişim + AR(1)) | 0,654104 | 0,654104 | 0,654104 | 8,3e−08 | ✓ (sayısal optimizasyon) |
| σ² (kesişim + AR(1)) | 0,242344 | 0,242345 | 0,242345 | 7,7e−08 | ✓ (sayısal optimizasyon) |
| \sigma^2_u (kesişim + AR(1)) | 1,590627 | 1,590627 | 1,590627 | 5,8e−07 | ✓ (sayısal optimizasyon) |
| visit[T.V12] SH (kesişim + AR(1)) | 0,083552 | 0,083552 | 0,083552 | 7,1e−09 | ✓ (sayısal optimizasyon) |
| −2LL (kesişim + AR(1)) | 332,424583 | 332,424583 | 332,424583 | 9,5e−11 | ✓ |
AR(1) satırlarında Python ve R (nlme::gls, nlme::lme + corAR1) eşit aralıklı sıra indeksiyle kurulmuştur; MerQur'un doğal sıralı zaman indeksiyle aynı modeldir. R yapılı modellerde MerQur ρ'yu dönüştürülmüş iç parametre üzerinden türevsiz/sayısal türevli optimizasyonla bulur (mixed_rside.py); kesişim + AR(1) modelinde ρ ve varyanslar öteki iki kaynaktan \approx7\cdot10^{-7} göreli ayrılır, −2LL ise 10^{-10} içinde aynıdır (düz bir optimum). Bu satırlar "sayısal optimizasyon" notuyla 5\cdot10^{-6} göreli toleransla değerlendirildi.
54.7 Çıktıyı okuma
MerQur'un sonuç metni (varsayılan ayarlar + EMM + LRT, kısaltılmış):
══ LMM — DOĞRUSAL KARMA MODELLER ══
Bağımlı değişken : HbA1c
Grup değişkeni   : patient_id
Yöntem           : REML
Sabit etki testi : t testi, Satterthwaite serbestlik derecesi

── SABİT ETKİLER ──
Etki                        Katsayı        SE        df         t         p                %95 GA
Sabit                        8.2888    0.1919     54.00    43.195   <0.0001        (7.904, 8.674) ★
visit[T.V3]                 -0.4580    0.0685    147.00    -6.686   <0.0001      (-0.593, -0.323) ★
visit[T.V6]                 -0.9120    0.0685    147.00   -13.313   <0.0001      (-1.047, -0.777) ★
visit[T.V12]                -1.4682    0.0685    147.00   -21.432   <0.0001      (-1.604, -1.333) ★

── VARYANS BİLEŞENLERİ ──
Grup varyansı (rastgele kesişim) : 1.7238
Hata varyansı (artık)            : 0.1173
ICC = 0.9363
Nakagawa R²: marjinal (sabit) = 0.1390  ·  koşullu (sabit+rastgele) = 0.9451

── BİLGİ KRİTERLERİ ──
  -2LL (REML) = 352.3194   k = 6
  AIC = 364.3194   AICC = 364.7546   BIC = 384.1093   CAIC = 390.1093

── KOVARYANS PARAMETRELERİ (kovaryans parametresi kestirimleri) ──
patient_id          Var(Sabit)                    1.72379   0.35420    4.867   < .001        (1.1523, 2.5786)
Artık               Var(Artık)                    0.11733   0.01369    8.573   < .001        (0.0933, 0.1475)

── TİP III SABİT ETKİ TESTLERİ (Satterthwaite) ──
visit                           3     147.00    168.0870    < .001

── RASTGELE TERİM LRT (ranova) ──
(1 | patient_id)                                 5     691.505     701.505   339.185    1    < .001
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Künye | DV, grup, eğim, yöntem, sd yöntemi | Kapsama/KR uygulanamadıysa uyarı ve "İstenen ve uygulanan ayarlar" kaydı eklenir. |
| Örneklem | n, grup sayısı, en küçük/büyük/ortalama grup | Dengesizliği burada görün. |
| Sabit etkiler | b, SH, sd, t (Wald z'de z), p, GA, ★ | Kategoriklerde katsayı referans düzeyine farktır (V0). ★, p<\alpha demektir (\alpha = 1 − güven düzeyi). |
| Varyans bileşenleri | Grup ve hata varyansı, ICC, Nakagawa R² | ICC eğim varyansını içermez (54.5.7). |
| Model uyumu | Log-olabilirlik, yakınsama, yöntem | Yakınsama, durma noktasındaki gradyanla denetlenir (lme4 ölçütü, tolerans 2·10⁻³); ölçüt sağlanmazsa "HAYIR" ve uyarı yazılır. |
| Bilgi kriterleri | −2LL, k, AIC, AICC, BIC, CAIC | k sabit etkileri de sayar (lme4); BIC'te n gözlem sayısıdır (54.8, S6). |
| Kovaryans parametreleri | Kestirim, SH, Wald Z, p, GA, r | Sınırdaki varyansın GA'sı "—". |
| Tip III testleri | Pay/payda sd, F, p | Satterthwaite ya da KR'de; Wald z'de bu tablo yoktur. |
| Sabit etkiler ve EMM | Katsayılar, düzey EMM'leri, ikili farklar, düzeltilmiş p | Kukla satırları ve düzeyler MerQur düzey sırasındadır (sayı içeren etiketlerde doğal sıra: V0, V3, V6, V12); "Düzey sırası" ile değiştirilebilir. |
| LRT | İndirgenmiş model, −2LL, AIC, LRT, sd, p | Tek varyansın testinde p'yi ikiye bölün. |
| R yapısı | Kestirilen R ve korelasyon matrisi, AIC/BIC karşılaştırması | Yalnız R yapısı seçildiğinde. |
| Uyarılar | Küçük örneklem, düşük gözlem/parametre, tekil uyum, düşen kovaryat, yedek yol | Koşullar: lmm.py:843–876, 1307–1316, 979. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
HbA1c, vizit (V0, V3, V6, V12) sabit etkisi ve hasta düzeyinde rastgele kesişim içeren doğrusal karma modelle incelendi (REML; 50 hasta, 200 ölçüm; sd'ler Satterthwaite yöntemiyle). HbA1c vizitler arasında anlamlı biçimde değişti, F(3,\ 147)=168{,}09, p<0{,}001. Başlangıca göre HbA1c 3. ayda 0,46 (%95 GA [0,32; 0,59]), 6. ayda 0,91 ([0,78; 1,05]) ve 12. ayda 1,47 puan ([1,33; 1,60]) düşük bulundu; Bonferroni düzeltmeli bütün ikili farklar anlamlıydı (p<0{,}001). Hastalar arası varyans \hat\sigma^2_u=1{,}72 (SH =0{,}35), hasta içi varyans \hat\sigma^2=0{,}12 (SH =0{,}014) idi; ICC =0{,}94, R^2_m=0{,}14, R^2_c=0{,}95.
54.8 Uzman soruları
S1. Satterthwaite sd'si hangi Hessian'la hesaplanıyor, lmerTest ile aynı mı?
Gözlenen bilgi: -2\ell'nin (\theta,\sigma)'ya göre Hessian'ı, analitik (Harville türevleri + zincir kuralı; mixed_reml.py:412–511), \mathbf A=2\mathbf H^{-1}. lmerTest aynı parametrelemeyi ve aynı \mathbf A'yı kullanır, Hessian'ı numDeriv ile sayısal hesaplar. İç optimumda ikisi aynı sd'yi verir; fark yalnız sayısal türev hatasıdır (10^{-6} göreli; 54.6.1).
S2. Kenward–Roger'da neden beklenen bilgi kullanılıyor?
Kenward ve Roger (1997) düzeltmeyi beklenen bilgiyle türetmiştir; pbkrtest de öyledir. MerQur _kr_setup'ta \mathbf W=2[\mathrm{tr}(\mathbf P\mathbf V_i\mathbf P\mathbf V_j)]^{-1} kurar (mixed_reml.py:700–706). Satterthwaite ise gözlenen bilgiyle çalışır; dengesiz veride iki yöntemin sd'leri bu yüzden de ayrılır (dengesiz alt örnekte 132,235 ve 132,213).
S3. Varyans bileşeni sıfır sınırındaysa ne olur?
Optimizasyon sınırı (\theta=0) kabul eder. Panel "Tekil uyum" uyarısı yazar (lmm.py:1311–1312), o bileşenin log-Wald GA'sı "—" olur (mixed_reml.py:846–863), Newton cilası bu bileşeni sabit tutar (mixed_reml.py:319–323). SH ve Wald Z değerleri anlamını yitirir. Sabit etki testleri yine geçerlidir; ama Satterthwaite sd'si sınırdaki parametreyi serbest saymadığı için sd'ler kaynakları havuzlar (Bölüm 55.6, Adım 8'de 9 + 60 = 69).
S4. Eğim için UN mu VC mi seçmeliyim?
UN, kesişim–eğim kovaryansını kestirir ve konumdan bağımsızdır (eğim değişkeni ötelenince model değişmez). VC kovaryansı sıfıra sabitler; eğim değişkeninin sıfır noktası değişirse model değişir. Tıp örneğinde kovaryans neredeyse sıfırdır (r=0{,}03); VC'nin AIC'si (359,28) UN'den (361,26) düşüktür. Genel öneri: UN ile başlayın, kovaryans sıfırdan ayırt edilemiyor ve yakınsama sorunluysa VC'ye geçin.
S5. REML ile kestirilmiş iki modelin AIC'lerini karşılaştırabilir miyim?
Yalnız sabit etkileri aynıysa (ör. kesişim modeli ile kesişim + eğim modeli, ya da σ²I ile AR(1)). Sabit etkiler farklıysa REML olabilirlikleri farklı veri dönüşümlerine dayanır; ML'ye geçin. Tıp örneğinde σ²I ve AR(1) + kesişim modelleri aynı sabit etkilere sahiptir: −2LL 352,32 ve 332,42; AR(1) eklemek bir ek parametreyle (ρ) 19,9 puanlık iyileşme getirir.
S6. MerQur'un AIC ve BIC'i bazı yazılımlardan neden farklı?
Tanım farkı. MerQur lme4'ü izler: REML'de de k=p+(\text{kovaryans parametreleri}) sayılır ve BIC'te \log n (n: gözlem sayısı) kullanılır (mixed_reml.py:400–409). Bazı yazılımlar REML'de yalnız kovaryans parametrelerini sayar ve BIC'te denek sayısının logaritmasını kullanır. Tıp örneğinde MerQur AIC =352{,}32+2\cdot6=364{,}32; yalnız kovaryans parametreleri sayılırsa 352{,}32+2\cdot2=356{,}32 olur. Model karşılaştırmasında sıralama değişmez (aynı sabit etkili modellerde p sabittir), mutlak değerler değişir.
S7. Kapsama yöntemi neden yalnız rastgele kesişimli modelde var?
Gruplar arası–grup içi sd'si yalnız tek gruplamalı kesişim modelinde iyi tanımlıdır. Rastgele eğimde eğim sütunlarının kalıntı sd'sinden düşülüp düşülmemesi tanıma göre değişir (nlme düşmez); tanımlar ayrışır (mixed_reml.py:1120–1121). MerQur bu durumlarda Satterthwaite'e döner ve bunu uyarı ile ayar kaydında açıkça yazar (lmm.py:941–951).
S8. Grup sayısı 5'ten azsa ne olur?
Analiz çalışır, uyarı yazılır (lmm.py:875–876). Varyans bileşeni çok az bilgiyle kestirilir ve sınırda kalabilir; Satterthwaite sd'leri küçülür, GA'lar genişler. Örneğin 3 klinikli bir çalışmada klinik etkisini rastgele değil sabit almak, ya da yalnız betimsel raporlamak daha savunulabilirdir.
S9. Wald z seçildiğinde de REML motoru mu çalışıyor?
Evet. Bütün sd yöntemleri aynı REML motorunu kullanır (lmm.py:781–786); böylece varyans bileşenleri ve R² sd yönteminden bağımsızdır. statsmodels ile ayrı bir uydurma, varyans bileşenlerinde 10^{-3} düzeyinde, eğim varyansı yüzünden R²'de daha çok ayrılırdı. statsmodels yalnız motor hatasında, yapısal seçenek yoksa yedek yoldur.
54.9 Sık hatalar ve tuzaklar
- Referans düzeyini denetlememek. MerQur düzeyleri ortak kuralla dizer (sayı içeren etiketlerde doğal sıra: V0, V3, V6, V12; sayı içermeyenlerde verideki ilk görülme sırası) ve ilk düzeyi referans alır. Sayı içermeyen etiketlerde bu klinik referans olmayabilir; referans düzeyi alanıyla referansı, "Düzey sırası" alanıyla listeleme sırasını belirleyin; R yapısındaki zaman ekseni ise doğal sıralıdır (
mixed_rside.py:811–841). - Grubu aynı anda sabit etki seçmek. Hasta kimliği hem sabit etki hem grup seçilirse model tanımlanamaz; MerQur hata verir (
lmm.py:777–779). - Sayısal kodlu kategorik değişken. 1/2/3 olarak kodlanmış klinik ya da vizit sayısal kovaryat olarak girer (tek eğim). Kategorik olarak kullanmak için metin sütuna çevirin.
- REML ile sabit etki LRT'si. Farklı sabit etkili REML modellerinin −2LL'leri karşılaştırılamaz. MerQur'un "Sabit terim LRT" bölümü bu yüzden ML ile yeniden uydurur.
- Wald Z ile varyans testi. Kovaryans parametresi tablosundaki p bir rastgele terimin gerekliliğine kanıt değildir; LRT'yi (karışım p'si) kullanın.
- ICC'yi eğimli modelde yorumlamak. Rastgele eğim varsa çıktıdaki ICC yalnız kesişim varyansına dayanır ve "aynı hastanın iki ölçümünün korelasyonu" anlamını yitirir (korelasyon ölçümün zamanına bağlıdır).
- Kovaryans parametresi SH'leri büyük n'de. n>3000'de analitik Hessian yerine sayısal Richardson türevi kullanılır; n>4000'de KR hata verir. Çok büyük veride Satterthwaite ya da Wald z seçin.
- R yapısı + rastgele etki eşdeğerliği. Rastgele kesişim + σ²I modeli CS hata yapısıyla aynıdır; ikisini birlikte seçmek tanımlanamaz model üretir (iki parametre aynı varyansı paylaşır). AR(1) gibi farklı yapılarla rastgele kesişim birlikte kullanılabilir.
54.10 Kaynaklar
- Laird, N. M., & Ware, J. H. (1982). Random-effects models for longitudinal data. Biometrics, 38(4), 963–974. https://doi.org/10.2307/2529876
- Patterson, H. D., & Thompson, R. (1971). Recovery of inter-block information when block sizes are unequal. Biometrika, 58(3), 545–554. https://doi.org/10.1093/biomet/58.3.545
- Harville, D. A. (1977). Maximum likelihood approaches to variance component estimation and to related problems. Journal of the American Statistical Association, 72(358), 320–338. https://doi.org/10.1080/01621459.1977.10480998
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Giesbrecht, F. G., & Burns, J. C. (1985). Two-stage analysis based on a mixed model: Large-sample asymptotic theory and small-sample simulation results. Biometrics, 41(2), 477–486. https://doi.org/10.2307/2530872
- Fai, A. H.-T., & Cornelius, P. L. (1996). Approximate F-tests of multiple degree of freedom hypotheses in generalized least squares analyses of unbalanced split-plot experiments. Journal of Statistical Computation and Simulation, 54(4), 363–378. https://doi.org/10.1080/00949659608811740
- Kenward, M. G., & Roger, J. H. (1997). Small sample inference for fixed effects from restricted maximum likelihood. Biometrics, 53(3), 983–997. https://doi.org/10.2307/2533558
- Halekoh, U., & Højsgaard, S. (2014). A Kenward-Roger approximation and parametric bootstrap methods for tests in linear mixed models – The R package pbkrtest. Journal of Statistical Software, 59(9), 1–32. https://doi.org/10.18637/jss.v059.i09
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- Self, S. G., & Liang, K.-Y. (1987). Asymptotic properties of maximum likelihood estimators and likelihood ratio tests under nonstandard conditions. Journal of the American Statistical Association, 82(398), 605–610. https://doi.org/10.1080/01621459.1987.10478472
- Nakagawa, S., & Schielzeth, H. (2013). A general and simple method for obtaining R² from generalized linear mixed-effects models. Methods in Ecology and Evolution, 4(2), 133–142. https://doi.org/10.1111/j.2041-210x.2012.00261.x
- Johnson, P. C. D. (2014). Extension of Nakagawa & Schielzeth's R²GLMM to random slopes models. Methods in Ecology and Evolution, 5(9), 944–946. https://doi.org/10.1111/2041-210X.12225
- Wolfinger, R., Tobias, R., & Sall, J. (1994). Computing Gaussian likelihoods and their derivatives for general linear mixed models. SIAM Journal on Scientific Computing, 15(6), 1294–1310. https://doi.org/10.1137/0915079
- Searle, S. R., Casella, G., & McCulloch, C. E. (1992). Variance components. Wiley. https://doi.org/10.1002/9780470316856