51. Sıralı Lojistik Regresyon
Analiz kimliği: ordinal_logistic · Menü adı: Sıralı Lojistik Regresyon · Panel: gui/panels/analyses/ordinal_logistic.py · Motor: stats/glm_advanced.py, run_ordinal_logistic (satır 1227–1557); ek çıktılar stats/glm_extras.py (satır 146–331), stats/glm_count_ordinal_extras.py, stats/glm_scale.py
51.1 Ne işe yarar
Sıralı lojistik regresyon, kategorileri doğal bir sıra izleyen bir sonucu (tedavi yanıtı: yok < kısmi < iyi < tam; Likert maddesi; hastalık evresi) açıklayıcılarla modeller. Her kategori için ayrı denklem kuran multinomial modelin (Bölüm 50) aksine, sırayı kullanır ve her açıklayıcı için tek katsayı kestirir. MerQur'un varsayılan modeli orantılı odds (kümülatif logit) modelidir (McCullagh 1980):
- Y_i\in\{1,\dots,J\}: sıralı sonuç; Tıp örneğinde J=4.
- \theta_j: j. eşik (kesim noktası); \theta_1<\theta_2<\dots<\theta_{J-1}. Ayrı bir sabit terim yoktur; eşikler sabitin yerini tutar.
- \boldsymbol\beta: tüm eşiklerde ortak eğim vektörü; \mathbf x_i sabit sütunu içermez.
- Eksi işaret: \beta_k>0 ise x_k arttıkça P(Y\le j) azalır, yani yüksek kategorilere kayma olasılığı artar.
Kategori olasılıkları iki komşu kümülatif olasılığın farkıdır:
- F: bağlantı dağılımının birikimli dağılım fonksiyonu; logit için F(t)=1/(1+e^{-t}).
- Eşiklerin artan olması, tüm olasılıkların pozitif olmasını güvence altına alır.
Neden "orantılı odds"?
İki farklı açıklayıcı değeri için kümülatif log-odds farkı -(\mathbf x_1-\mathbf x_2)^{\top}\boldsymbol\beta'dır ve j'ye bağlı değildir. Yani "\le j olma" odds'unun oranı her eşikte aynıdır. Gizil değişken yorumuyla: gözlenmeyen sürekli bir Y^{*}=\mathbf x^{\top}\boldsymbol\beta+\varepsilon vardır, \varepsilon lojistik dağılır ve Y^{*} eşikleri aştıkça gözlenen kategori yükselir. Açıklayıcı tüm dağılımı kaydırır; eşikler sabittir. Bu yüzden e^{\beta_k} tek sayıyla özetlenir: x_k bir birim arttığında "j'den yüksek kategoride olma" odds'u, her j için e^{\beta_k} katına çıkar.
Ne zaman kullanılır? Sonuç en az üç sıralı kategoriden oluşuyorsa ve bir açıklayıcının sonucu "yukarı ya da aşağı kaydırdığı" düşünülüyorsa.
Ne zaman kullanılmaz?
- Kategoriler sırasızsa: Multinomial Lojistik Regresyon.
- Sonuç iki kategoriliyse: İkili Lojistik Regresyon (MerQur bu modülde 3'ten az sınıfta hata verir).
- Orantılı odds varsayımı açıkça çiğneniyorsa: aynı panelde Kısmi PO değişkenleri alanı (kısmi orantılı odds) ya da multinomial model.
- Sonuç çok sayıda düzeyli ve aralıklı ölçekliyse (ör. 0–100 puan): doğrusal regresyon daha uygundur.
- Gözlemler kümeli ya da tekrarlıysa: GLMM ya da GEE.
Sık karıştırılan analizler. Multinomial lojistik aynı veriye (J-1)\cdot p eğim kestirir ve sırayı kullanmaz. Sürekleme oranı (continuation-ratio) ve bitişik kategori (adjacent-category) modelleri başka sıralı modellerdir; MerQur'da yoktur. Sıralı probit, aynı modelin normal bağlantılı biçimidir ve bu panelde "Kümülatif probit" seçeneğiyle kestirilir.
51.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| En az üç sıralı sınıf | Bağımlı değişkende en az üç değer ve doğru sıra. | Üçten azsa hata (glm_advanced.py:1318–1320); sıra 51.3'teki kurala göre. |
| Orantılı odds (paralel çizgiler) | Eğimler tüm eşiklerde aynı. | İsteğe bağlı Paralel çizgiler testi (LR). |
| Bağımsız gözlemler | Her satır ayrı kişi. | Denetlenmez. |
| Bağlantıda doğrusallık | Sürekli x ile kümülatif logit arasında doğrusal ilişki. | Denetlenmez. |
| Sabit olmayan açıklayıcı | Her açıklayıcı en az iki değer almalı. | Sabit sütunda hata (1280–1282). |
| Tanımlanabilirlik | Bilgi matrisi tekil olmamalı (ayrışma, boş hücre). | Kovaryans hesaplanamazsa açıklayıcı hata (1307–1314). |
Eksik değer. Bağımlı değişkende ya da açıklayıcılardan herhangi birinde eksik olan satır çıkarılır (liste bazında silme, glm_advanced.py:1260). Frekans ağırlığı seçilmişse satırlar önce çoğaltılır (ordinal_logistic.py:147–148).
Uç durumlar. Kullanıcının yazdığı sırada veride olmayan etiketler atlanır ve uyarılır; veride olup sırada yazılmayan bir değer varsa hata verilir (1230–1237). Sırası tanınamayan metin etiketlerinde analiz yapılmaz: sıralı modelde sıra satır sırasından ya da alfabeden tahmin edilmez; ileti, düzey sırasının Veri sekmesinde ya da "Kategori sırası" alanında tanımlanmasını ister (glm_advanced.py:1362–1372).
51.3 Parametreler
Varsayılanlar ordinal_logistic.py:50–126 (form) ve 218–232 (read_options) satırlarından alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken (sıralı) | ilk sütun | 3+ sıralı kategori. | Sıra aşağıdaki kuralla belirlenir. |
| Kategori sırası | boş | Düşükten yükseğe virgüllü sıra. | Boşsa otomatik. Yanlış sıra tüm modeli değiştirir. |
| Bağ fonksiyonu | Kümülatif logit | Logit, probit, tamamlayıcı log-log, negatif log-log, Cauchit. | F; katsayıların ölçeği ve log-olabilirlik. |
| Bağımsız değişkenler | en az 1 | Sayısal ya da kategorik açıklayıcılar. | Metin sütunları kukla kodlanır (ilk düzey referans). |
| Kategorik (faktör) değişkenler | boş | Sayısal kodlu sütunları kukla kodlatır. | Tasarım matrisi. |
| Güven Düzeyi | %95 | \beta, eşik ve OR GA'ları. | Yalnız GA. |
| Ek çıktı: Paralel çizgiler testi | kapalı | Eşiğe özgü eğimli genel modele karşı LR. | Ek bölüm. |
| Ek çıktı: Pearson / sapma uyum iyiliği | kapalı | Kovaryat örüntüleri üzerinden χ². | Ek bölüm. |
| Ek çıktı: Sınıflama tablosu | kapalı | Gözlenen × en olası kategori; ortalama tahmin olasılıkları. | Ek bölüm. |
| Kısmi PO değişkenleri | boş | Seçilen değişkenlerin eğimi eşiğe özgü olur. | Ek model ve LR testi; ana tablo değişmez. |
| Aşırı yayılım ölçeği | Yok (ölçek = 1) | SH'ler (eşikler dahil) \sqrt\varphi katı. | SH, z, p, GA. |
| Frekans ağırlığı | Yok (ağırlıksız) | Satır çoğaltma. | n ve tüm kestirimler. |
| Grafik | Katsayı orman grafiği | Orman grafiği ya da kategori başına 3B olasılık yüzeyi. | Yalnız Grafik sekmesi. |
Koddaki tercih: kategori sırası nasıl belirlenir?
run_ordinal_logistic sırayı şu öncelikle belirler (glm_advanced.py:1214–1264):
- "Kategori sırası" alanı doluysa o sıra (büyük/küçük harf duyarsız eşleme).
- Bağımlı değişken sayısalsa sayısal sıra.
- Veri sekmesinde düzey sırası tanımlanmışsa (sıralı ya da sırasız kategorik) o sıra.
- Etiketler 24 hazır sıralı sözlükten birinin alt kümesiyse o sözlüğün sırası (Likert, kalite, risk, eğitim, tedavi yanıtı vb.;
1029–1066). - Sözcük puanlı yedek sıralayıcı: son sözcük bir puan alır (
low0,2,medium0,5,high0,8,good0,75 …), önündekivery,somewhat,high,lowgibi değiştiriciler puanı kaydırır (1100–1154). - Sayı içeren etiketler ("1", "2", "10", "1-Hafif") sayısal/doğal sıra.
- Hiçbiri olmazsa analiz yapılmaz; çevrilmiş ileti sıranın tanımlanmasını ister. Verideki ilk görülme sırası ve alfabetik sıra sıralı yanıt için kullanılmaz: satırlar karıştırıldığında sonuç değişmemelidir.
Tıp verisindeki nonresponsive, partial, good, full etiketleri 4. adımdaki ["Nonresponsive", "Partial", "Good", "Full"] sözlüğüyle eşleşir; notlarda "sıra etiketlerden otomatik belirlendi" yazar. R polr ve clm faktör düzeylerinin sırasını kullanır. Otomatik sözlük MerQur'a özgüdür.
Bağ fonksiyonu neyi değiştirir?
Bağlantı, gizil hata \varepsilon'nin dağılımını seçer: logit (lojistik, simetrik), probit (normal, simetrik, daha ince kuyruk), tamamlayıcı log-log F(t)=1-\exp(-e^{t}) (sağa çarpık uç değer), negatif log-log F(t)=\exp(-e^{-t}) (sola çarpık), Cauchit (çok kalın kuyruk). Katsayıların ölçeği bağlantıya göre değişir (probit katsayıları kabaca logit/1,7). Parametre sayısı aynı olduğundan bağlantılar log-olabilirlik ya da AIC ile karşılaştırılabilir. Yalnız logit bağlantıda e^{\beta} bir odds oranıdır.
51.4 Tıp örneği
Dosya: english/datasets/Tip/43_ordinal_response_level.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/43_ordinal_yanit_seviyesi.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #43'ten alınmıştır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
response_level |
Bağımlı | metin, 4 sıralı düzey | nonresponsive 17, partial 65, good 77, full 41 |
dose_mg |
Açıklayıcı | sürekli (mg) | ort. 56,94; SS 26,92; 10,7–99,9 |
age |
Açıklayıcı | sürekli (yıl) | ort. 59,24; SS 12,17; 40–79 |
Kategori ortalamaları: dose_mg 19,9 / 34,6 / 68,5 / 86,0 ve age 70,2 / 62,1 / 57,9 / 52,7 (yanıt düzeyine göre artan sırada). Doz yanıtla artıyor, yaş yanıtla azalıyor.
n ve eksik değer: 200 hasta, eksik değer yok. En küçük kategori 17 hastadır.
Klinik soru: Yaş sabitken doz artışı daha iyi bir tedavi yanıtı düzeyine geçme odds'unu ne kadar artırıyor? Yaşın etkisi nedir?
Seçilen ayarlar: Arayüz varsayılanları (otomatik sıra, kümülatif logit, %95). Hesap yürüyüşü için üç ek çıktı kutusu açık ikinci bir çalıştırma, dose_mg kısmi PO değişkeni olarak, Pearson ölçekli, %99 güvenli ve diğer dört bağlantıyla çalıştırmalar yapılmıştır.
51.5 Formüller ve hesap adımları
MerQur'un hesap sırası: liste bazında silme → kategori sırası → tasarım matrisi (sabitsiz) → açıklayıcıların standart sapmaya bölünmesi (merkezleme yok) → statsmodels OrderedModel ile BFGS → sayısal Hessian'dan kovaryans → delta yöntemiyle özgün parametrelere dönüş → model LR testi ve sözde R^2'ler → isteğe bağlı ek çıktılar (kendi kümülatif model kestiricisiyle) → isteğe bağlı ölçek.
51.5.1 Olabilirlik ve türevler
- y_i: i. kişinin kategorisi; F(\theta_0-\eta)=0, F(\theta_J-\eta)=1.
- Her kişi olabilirliğe yalnız kendi kategorisinin "aralığıyla" katkı verir: üst eşik u_i=\theta_{y_i}-\eta_i, alt eşik l_i=\theta_{y_i-1}-\eta_i.
Parametre vektörü \boldsymbol\psi=(\boldsymbol\theta,\boldsymbol\beta) için u_i ve l_i, \boldsymbol\psi'nin doğrusal fonksiyonlarıdır: u_i=\mathbf a_i^{\top}\boldsymbol\psi, l_i=\mathbf c_i^{\top}\boldsymbol\psi (\mathbf a_i'de ilgili eşik konumunda 1, \boldsymbol\beta konumlarında -\mathbf x_i). P_i=F(u_i)-F(l_i) ile:
- f=F': yoğunluk; logit için f=F(1-F), f'=f(1-2F).
- İkinci ifade gözlenen bilgi matrisidir. Kümülatif bağlantılar kanonik değildir; gözlenen ve beklenen bilgi farklıdır.
51.5.2 Kestirim: BFGS, ölçekleme ve iç parametreler
Koddaki tercih: OrderedModel, BFGS ve sayısal Hessian
MerQur OrderedModel(y, X_fit, distr=…).fit(method="bfgs", maxiter=1000, gtol=1e-8) çağırır (glm_advanced.py:1362–1364). Ayrıntılar:
- Ölçekleme: her açıklayıcı standart sapmasına (ddof = 0) bölünür, merkezlenmez (
1287–1293). Merkezleme eşikleri kaydırırdı; bölme yalnız \boldsymbol\beta'yı ölçekler. Kod yorumu, ölçeksiz veride (bütçe gibi ~10⁵ büyüklükte) sayısal Hessian SH'lerinin %1–2,5 sapıttığını not eder. - İç parametreler: statsmodels eşikleri (\theta_1,\ \delta_2,\ \delta_3,\dots), \delta_m=\ln(\theta_m-\theta_{m-1}) olarak kestirir; böylece eşiklerin artan olması kısıtsız en iyilemeyle sağlanır.
- Başlangıç: eşikler örneklemdeki kümülatif oranların F^{-1}'i, \boldsymbol\beta=\mathbf 0 (yalnız eşikli modelin ML çözümü).
- Kovaryans: statsmodels log-olabilirliğin sayısal Hessian'ını (
approx_hess) iç parametrelerde alır; MerQur bunu \mathbf J\mathbf C\mathbf J^{\top} ile özgün parametrelere çevirir (1316–1337):
Bu yol, analitik Hessian'la Newton–Raphson kullanan R ordinal::clm ile katsayılarda 2\times10^{-7}, SH'lerde 3\times10^{-9} düzeyinde aynı sonucu verir. R MASS::polr de sayısal Hessian kullanır ama ölçeklemesizdir; bu veride SH'leri clm'den 5\times10^{-5} (göreli) kadar ayrılır. Sonuç metnindeki not, SH'lerin gözlenen bilgiden geldiğini ve Fisher skorlaması kullanan yazılımlardan küçük farklar görülebileceğini söyler.
51.5.3 Wald testleri, OR ve eşikler
- \text{OR}_k: x_k bir birim arttığında, her j için P(Y>j)/P(Y\le j) odds'unun çarpanı.
- Eşik satırlarında OR yazılmaz. Eşiğin z testi H_0:\theta_j=0, yani "tüm açıklayıcılar sıfırken P(Y\le j)=0{,}5" hipotezini sınar; klinik anlamı yoktur.
- Eşik adları
alt/üstbiçimindedir (nonresponsive/partial): eşik iki komşu kategoriyi ayırır.
Logit dışı bağlantıda e^{\beta} sütunu
Logit bağlantıda e^{\hat\beta} sütunu "OR" başlığıyla, öteki bağlantılarda "exp(β)" başlığıyla yazılır (glm_advanced.py:1404–1411). Probit, log-log ve Cauchit bağlantılarında e^{\beta} bir odds oranı değildir; yorumlanmamalıdır. Probit bağlantıda \beta, gizil normal ölçekte standart sapma birimiyle kaymadır.
51.5.4 Model testi ve sözde R²
- \ell_0: yalnız eşikli model; kategori oranları her kişiye verilir. Bu model bağlantıdan bağımsızdır (eşikler oranları birebir üretir).
- Sd =p: kukla dahil eğim sayısı. "df (artık)" =n-p-(J-1).
- McFadden, Cox–Snell, Nagelkerke 50.5.4'teki formüllerle (
glm_count_ordinal_extras.py:27–33).
Koddaki tercih: \ell_0 kapalı biçimden
Model uyum bloğu ve Cox–Snell/Nagelkerke \ell_0'ı kapalı biçimden hesaplar (glm_extras.py:250–251, glm_advanced.py:1480–1482). McFadden satırı için önce statsmodels'le sıfır model kestirimi denenir, olmazsa marjinal oranlarla aynı kapalı biçim kullanılır (1372–1394). Bu veride iki yol 10^{-16} düzeyinde aynıdır.
51.5.5 Paralel çizgiler testi
Genel (eşiğe özgü eğimli) model:
- \boldsymbol\beta_j: her eşiğe ayrı eğim vektörü; genel modelde (J-1)p, PO modelinde p eğim vardır.
- Sd =(J-2)p; Tıp örneğinde 2\times2=4.
- Değişken başına satırlar: yalnız o değişkenin eğimi serbest bırakılır, diğerleri ortak kalır; sd =(J-2)\times kukla sayısı.
Koddaki tercih: kendi kümülatif kestiricisi
Ek çıktılar statsmodels'i değil, MerQur'un fit_cumulative fonksiyonunu kullanır (glm_extras.py:175–241): analitik gradyanlı BFGS (gtol 10^{-9}), standart sapmaya bölünmüş açıklayıcılar, genel modelde PO çözümünden başlatma. LR istatistiği negatifse sıfıra kesilir (287). Aynı varsayım için skor testi de kullanılır; R brant paketi ise Wald (Brant 1990) testi verir; üç istatistik asimptotik olarak eşdeğerdir ama sonlu örneklemde farklı sayılar üretir.
Genel model olasılık üretmeyebilir
Eğimler eşiklere göre farklı olduğunda, açıklayıcıların bazı değerlerinde \theta_j-\mathbf x^{\top}\boldsymbol\beta_j sırası bozulabilir ve "olasılık" negatif çıkar. Genel model bu yüzden yalnız karşılaştırma modelidir; veri aralığı dışındaki tahminde kullanılmamalıdır. Kısmi PO çıktısı negatif olasılık oluşursa bunu işaretler (glm_count_ordinal_extras.py:986).
51.5.6 Kısmi orantılı odds modeli
- \mathbf x_s: ortak eğimli açıklayıcılar; \mathbf x_n: "Kısmi PO değişkenleri" alanına yazılan, eşiğe özgü eğimli açıklayıcılar (Peterson ve Harrell 1990).
- Çıktıdaki
dose_mg [≤ partial]satırı,partialilegoodarasındaki eşikteki doz eğimidir; işaret yönü ana modelle aynıdır (pozitif: yüksek kategoriye kayma). - R
ordinal::clm(nominal = ~ x)aynı modeli \theta_j+\mathbf x^{\top}\tilde{\boldsymbol\beta}_j biçiminde yazar: MerQur'un \boldsymbol\beta_j'si -\tilde{\boldsymbol\beta}_j'dir. - SH'ler analitik gradyanın merkezi farklarıyla bulunan sayısal Hessian'dan gelir (
glm_count_ordinal_extras.py:913–920); tekil Hessian'da LL ve LR verilir, SH'ler "—" olur.
51.5.7 Uyum iyiliği, sınıflama ve ölçek
Uyum iyiliği 50.5.7'deki örüntü tanımıyla hesaplanır; sd =g(J-1)-(J-1+p) (glm_extras.py:264–280). Sınıflama tablosu en yüksek olasılıklı kategoriyi kullanır ve kategori başına ortalama tahmin olasılığı ile gözlenen oranı yan yana verir. Ölçek seçilirse \varphi=X^2/\{n(J-1)-(J-1+p)\} ile eşikler dahil tüm SH'ler \sqrt\varphi katına çıkar (glm_advanced.py:1501–1512).
Neden ortalama tahmin olasılıkları gözlenen oranlara bu kadar yakın?
Kanonik bağlantılı modellerde (ikili ve multinomial lojistik) sabit terimin skor denklemi, kestirilen olasılıkların toplamını gözlenen sayıya tam eşitler; Bölüm 50'deki sınıflama çıktısında ortalama olasılıklar gözlenen oranlarla aynıdır. Kümülatif logit kanonik değildir; eşiklerin skor denklemleri bu eşitliği yalnız yaklaşık sağlar (yalnız eşikli modelde tamdır). Tıp örneğinde fark dördüncü ondalıktadır (0,0850 ile 0,0847). Bu tablo bir uyum testi değildir; büyük bir fark ise kestirimde sorun olduğunu gösterir.
51.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/ordinal_logistic/elle_hesap.py ile, MerQur çağrılmadan, özgün ölçekte analitik Hessian'lı Newton–Raphson ile hesaplanmıştır. Kategori kodları: nonresponsive = 1, partial = 2, good = 3, full = 4.
Adım 1 — Başlangıç (yalnız eşikli model). Kümülatif oranlar 17/200=0{,}085, 82/200=0{,}41, 159/200=0{,}795:
Bu nokta yalnız eşikli modelin ML çözümüdür: -2\ell=-2\ell_0=506{,}868403. Skor vektörünün eşik bileşenleri sıfırdır, eğim bileşenleri değildir:
dose_mg bileşeninin pozitif olması, dozun yüksek kategorilerle ilişkili olduğunu (artı yönlü \beta), age'in negatif bileşeni tersini gösterir. Bu skor vektörü, iki eğimin birlikte sıfır olduğu hipotezinin skor testinin temelidir.
Adım 2 — Yakınsama.
| Yineleme | \theta_1 | \theta_2 | \theta_3 | \beta_{\text{dose}} | \beta_{\text{age}} | -2\ell |
|---|---|---|---|---|---|---|
| 0 | −2,376273 | −0,363965 | 1,355332 | 0 | 0 | 506,868403 |
| 1 | −2,815875 | −0,025536 | 2,526375 | 0,078664 | −0,067937 | 287,724046 |
| 2 | −3,609678 | 0,378413 | 4,006677 | 0,101196 | −0,079027 | 251,231181 |
| 3 | −4,330968 | 0,570839 | 5,020793 | 0,122336 | −0,093546 | 242,996873 |
| 4 | −4,626968 | 0,641605 | 5,428347 | 0,131308 | −0,099935 | 242,278946 |
| 5 | −4,661782 | 0,649651 | 5,476585 | 0,132388 | −0,100711 | 242,271181 |
| 6 | −4,662197 | 0,649746 | 5,477165 | 0,132401 | −0,100720 | 242,271180 |
Eşikler, eğimler büyüdükçe birbirinden uzaklaşır. Gizil ölçekte hata \varepsilon'nin ölçeği sabittir (lojistik, varyans \pi^2/3); \eta=\mathbf x^{\top}\boldsymbol\beta'nın değişkenliği arttıkça Y^{*}'ın toplam yayılımı genişler ve aynı kategori oranlarını üretmek için eşikler açılır.
Adım 3 — Katsayı tablosu.
| Terim | b | SH | z | p | OR | %95 GA |
|---|---|---|---|---|---|---|
dose_mg |
0,132401 | 0,013598 | 9,737 | 2,10·10⁻²² | 1,141566 | [1,111544; 1,172400] |
age |
−0,100720 | 0,016502 | −6,104 | 1,04·10⁻⁹ | 0,904186 | [0,875410; 0,933907] |
| Eşik nonresponsive/partial | −4,662197 | 1,074157 | −4,340 | 1,42·10⁻⁵ | — | — |
| Eşik partial/good | 0,649746 | 0,968531 | 0,671 | 0,502 | — | — |
| Eşik good/full | 5,477165 | 1,118724 | 4,896 | 9,79·10⁻⁷ | — | — |
Örnek, dose_mg: z=0{,}132401/0{,}013598=9{,}737; OR =e^{0{,}132401}=1{,}141566; 10 mg için e^{1{,}32401}=3{,}758. age için 10 yıl: e^{-1{,}00720}=0{,}365.
Adım 4 — Tek bir hastanın olasılıkları. 1 numaralı hasta: doz 69,9 mg, yaş 61.
En olası kategori good; gerçek kategori de good'dur.
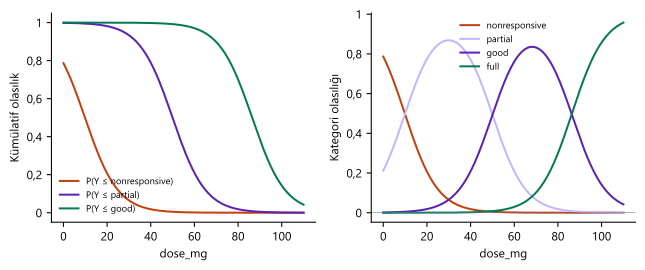
Şekil 51.1. Yaş ortalamada (59,2) sabitken doza göre kümülatif olasılıklar (sol) ve kategori olasılıkları (sağ). Sol paneldeki üç eğri logit ölçeğinde paraleldir; aralarındaki uzaklığı yalnız eşikler belirler.
Adım 5 — Model testi ve sözde R². Kategori sayıları 17, 65, 77, 41:
Adım 6 — Paralel çizgiler testi. Genel modelde -2\ell=241{,}130709:
Değişken başına: yalnız dose_mg serbest χ²(2) = 1,0725 (p=0{,}585), yalnız age serbest χ²(2) = 0,1561 (p=0{,}925). Orantılı odds varsayımı çiğnenmez.
Adım 7 — Kısmi PO modeli (dose_mg eşiğe özgü). Doz eğimleri üç eşikte 0,132047 (SH 0,036237), 0,144604 (0,019752), 0,117816 (0,019241); ortak age eğimi −0,100720. \ell=-120{,}599345, AIC =255{,}1987; PO modeline karşı LR χ²(2) =1{,}0725, Adım 6'daki değişken satırıyla aynıdır. Eğimler birbirine yakındır ve ortak eğim (0,1324) üçünün GA'sı içindedir; PO modeli yeterlidir.
Adım 8 — Diğer ek çıktılar.
- Sınıflama tablosu: doğru sınıflama nonresponsive 10/17, partial 51/65, good 63/77, full 26/41; genel %75,0. Ortalama tahmin olasılıkları (0,0847; 0,3272; 0,3833; 0,2048) gözlenen oranlara (0,085; 0,325; 0,385; 0,205) çok yakındır.
- Uyum iyiliği: 198 örüntü; X^2=433{,}6020, D=242{,}2712 (=-2\ell), sd =198\cdot3-5=589. Seyrek örüntü uyarısı çıkar; p'ler yorumlanmaz.
- Ölçek (Pearson): \varphi=433{,}6020/595=0{,}728743; SH'ler \sqrt{0{,}728743}=0{,}8537 ile çarpılır ve küçülür.
- Bağlantı karşılaştırması: log-olabilirlik logit −121,136; probit −122,068; negatif log-log −125,626; Cauchit −127,611; tamamlayıcı log-log −129,154. Parametre sayısı aynı olduğundan en iyi uyum logit bağlantıdadır. Probit bağlantıda \beta_{\text{dose}}=0{,}071962 (SH 0,006522), \beta_{\text{age}}=-0{,}057277 (SH 0,008988); logit katsayılarına oranı 1,84 ve 1,76'dır.
- Yanlış sıra: Kategori sırası alanına alfabetik sıra (
full, good, nonresponsive, partial) yazıldığında \ell=-167{,}236 ve McFadden R^2=0{,}340 olur, doz katsayısının işareti tersine döner. Sıra hatası modelin kendisini bozar.
51.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan tam hassasiyetle alınmıştır (McFadden alanındaki dört ondalık yuvarlama bellekte devre dışı bırakılmıştır). Python: özgün ölçekte analitik Hessian'lı Newton–Raphson. R 4.5.3: ordinal::clm (gradTol = 1e-12), genel ve kısmi genel modeller için VGAM::vglm(cumulative(parallel = FALSE)), kısmi PO için clm(nominal = ~ dose_mg) (işaret çevrilerek).
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| \beta dose_mg | 0,132401 | 0,132401 | 0,132401 | 1,8e−09 | ✓ |
| SH dose_mg | 0,013598 | 0,013598 | 0,013598 | 2,8e−09 | ✓ |
| z dose_mg | 9,736898 | 9,736896 | 9,736896 | 1,9e−06 | ✓ |
| OR %95 GA alt dose_mg | 1,111544 | 1,111544 | 1,111544 | 4,2e−09 | ✓ |
| OR %95 GA üst dose_mg | 1,172400 | 1,172400 | 1,172400 | 8,6e−09 | ✓ |
| \beta age | −0,100720 | −0,100720 | −0,100720 | 2,4e−09 | ✓ |
| SH age | 0,016502 | 0,016502 | 0,016502 | 9,9e−10 | ✓ |
| z age | −6,103689 | −6,103689 | −6,103689 | 5,1e−07 | ✓ |
| OR %95 GA alt age | 0,875410 | 0,875410 | 0,875410 | 3,6e−10 | ✓ |
| OR %95 GA üst age | 0,933907 | 0,933907 | 0,933907 | 4,0e−09 | ✓ |
| \theta nonresponsive/partial | −4,662197 | −4,662197 | −4,662197 | 2,1e−07 | ✓ |
| SH \theta nonresponsive/partial | 1,074157 | 1,074157 | 1,074157 | 3,3e−08 | ✓ |
| \theta partial/good | 0,649745 | 0,649746 | 0,649746 | 2,2e−07 | ✓ |
| SH \theta partial/good | 0,968531 | 0,968531 | 0,968531 | 5,8e−08 | ✓ |
| \theta good/full | 5,477165 | 5,477165 | 5,477165 | 2,9e−07 | ✓ |
| SH \theta good/full | 1,118724 | 1,118724 | 1,118724 | 1,7e−08 | ✓ |
| Log-olabilirlik ℓ | −121,135590 | −121,135590 | −121,135590 | 4,1e−13 | ✓ |
| −2ℓ0 (yalnız eşikler) | 506,868403 | 506,868403 | 506,868403 | 0,0e+00 | ✓ |
| LR χ²(2) | 264,597224 | 264,597224 | 264,597224 | 2,3e−13 | ✓ |
| AIC | 252,271180 | 252,271180 | 252,271180 | 2,3e−13 | ✓ |
| BIC | 268,762766 | 268,762766 | 268,762766 | 4,5e−13 | ✓ |
| McFadden R^2 | 0,522024 | 0,522024 | 0,522024 | 2,2e−16 | ✓ |
| Cox–Snell R^2 | 0,733661 | 0,733661 | 0,733661 | 1,1e−16 | ✓ |
| Nagelkerke R^2 | 0,796864 | 0,796864 | 0,796864 | 2,2e−16 | ✓ |
Ek çıktılar:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Paralel çizgiler χ²(4) | 1,140471 | 1,140471 | 1,140471 | 5,4e−14 | ✓ |
| Paralel çizgiler: −2ℓ genel model | 241,130709 | 241,130709 | — | 2,8e−14 | ✓ |
| Paralel: yalnız dose_mg serbest χ²(2) | 1,072490 | 1,072490 | 1,072490 | 3,0e−14 | ✓ |
| Paralel: yalnız age serbest χ²(2) | 0,156098 | 0,156098 | 0,156098 | 5,7e−14 | ✓ |
| Kısmi PO: log-olabilirlik | −120,599345 | −120,599345 | −120,599345 | 4,4e−13 | ✓ |
| Kısmi PO: \theta nonresponsive/partial | −4,664416 | −4,664416 | −4,664416 | 5,5e−10 | ✓ |
| Kısmi PO: dose_mg eğimi [nonresponsive/partial] | 0,132047 | 0,132047 | 0,132047 | 1,3e−11 | ✓ |
| Kısmi PO: SH dose_mg [nonresponsive/partial] | 0,036237 | 0,036237 | 0,036237 | 1,4e−11 | ✓ |
| Kısmi PO: \theta partial/good | 1,266399 | 1,266399 | 1,266399 | 2,1e−10 | ✓ |
| Kısmi PO: dose_mg eğimi [partial/good] | 0,144604 | 0,144604 | 0,144604 | 5,9e−12 | ✓ |
| Kısmi PO: SH dose_mg [partial/good] | 0,019752 | 0,019752 | 0,019752 | 1,8e−11 | ✓ |
| Kısmi PO: \theta good/full | 4,295585 | 4,295585 | 4,295585 | 7,6e−10 | ✓ |
| Kısmi PO: dose_mg eğimi [good/full] | 0,117816 | 0,117816 | 0,117816 | 1,8e−11 | ✓ |
| Kısmi PO: SH dose_mg [good/full] | 0,019241 | 0,019241 | 0,019241 | 4,4e−12 | ✓ |
| Kısmi PO: age (ortak) | −0,100720 | −0,100720 | −0,100720 | 1,1e−11 | ✓ |
| Kısmi PO: SH age | 0,016651 | 0,016651 | 0,016651 | 4,2e−12 | ✓ |
| Uyum iyiliği Pearson X^2 (198 örüntü) | 433,602023 | 433,602024 | — | 1,2e−06 | ✓ |
| Uyum iyiliği sapma | 242,271180 | 242,271180 | 242,271180 | 8,8e−13 | ✓ |
| Ölçek: Pearson X^2 (gözlem bazında) | 433,602008 | 433,602024 | 433,602024 | 1,6e−05 | ✓ |
| Ölçek \varphi | 0,728743 | 0,728743 | 0,728743 | 2,7e−08 | ✓ |
| Sınıflama: genel % doğru | 75 | 75 | — | 0,0e+00 | ✓ |
| Ortalama tahmin olasılığı: nonresponsive | 0,084695 | 0,084695 | — | 4,5e−10 | ✓ |
| Ortalama tahmin olasılığı: partial | 0,327244 | 0,327244 | — | 1,2e−09 | ✓ |
| Ortalama tahmin olasılığı: good | 0,383260 | 0,383260 | — | 1,7e−09 | ✓ |
| Ortalama tahmin olasılığı: full | 0,204801 | 0,204801 | — | 1,0e−09 | ✓ |
| OR %99 GA alt dose_mg | 1,102274 | 1,102274 | 1,102274 | 6,0e−09 | ✓ |
| OR %99 GA üst dose_mg | 1,182259 | 1,182259 | 1,182259 | 1,1e−08 | ✓ |
| OR %99 GA alt age | 0,866559 | 0,866559 | 0,866559 | 1,7e−10 | ✓ |
| OR %99 GA üst age | 0,943447 | 0,943447 | 0,943447 | 4,6e−09 | ✓ |
| Probit bağlantı: \beta dose_mg | 0,071962 | 0,071962 | 0,071962 | 1,3e−10 | ✓ |
| Probit bağlantı: SH dose_mg | 0,006522 | 0,006522 | 0,006522 | 5,2e−10 | ✓ |
| Probit bağlantı: \beta age | −0,057277 | −0,057277 | −0,057277 | 2,7e−10 | ✓ |
| Probit bağlantı: SH age | 0,008988 | 0,008988 | 0,008988 | 1,4e−10 | ✓ |
| Probit bağlantı: ℓ | −122,067751 | −122,067751 | −122,067751 | 4,3e−14 | ✓ |
| Probit bağlantı: McFadden R^2 | 0,518345 | 0,518345 | 0,518345 | 4,4e−16 | ✓ |
| Probit bağlantı: paralel χ²(4) | 1,233469 | 1,233469 | 1,233469 | 8,3e−14 | ✓ |
60 büyüklüğün tamamı ölçütü karşılar. En büyük fark birinci eşiktedir (2\times10^{-7}; MerQur'un BFGS durma ölçütü). Eğimlerin p değerleri 10^{-9}'un altında olduğundan karşılaştırma z üzerinden yapılmıştır: z'deki 10^{-7}'lik fark p=2\times10^{-22}'de göreli 10^{-5}'lik fark yaratır ve yorumla ilgisizdir.
51.7 Çıktıyı okuma
Sonuç metni (varsayılan ayarlar, kısaltılmış):
Sıralı Lojistik Regresyon
  N (gözlem)         = 200
  Yordayıcı sayısı   = 2
  Log-olabilirlik    = -121.1356
  AIC                = 252.2712
  BIC                = 268.7628
  Sapma              = 242.2712
  df (artık)         = 195
  McFadden pseudo R² = 0.5220
  Sınıf sayısı       = 4
  Sınıflar           = nonresponsive, partial, good, full

  Denklem   Değişken                 Katsayı      SE      z       p      OR       OR %95 GA
            dose_mg                   0.1324  0.0136   9.74  < .001   1.142  [1.112, 1.172]
            age                      -0.1007  0.0165  -6.10  < .001   0.904  [0.875, 0.934]
  (Eşik)    nonresponsive/partial    -4.6622  1.0742  -4.34  < .001       —               —
  (Eşik)    partial/good              0.6497  0.9685   0.67  0.5023       —               —
  (Eşik)    good/full                 5.4772  1.1187   4.90  < .001       —               —

── MODEL UYUM BİLGİSİ ──
  Yalnız eşikler         −2LL = 506.8684
  Son model              −2LL = 242.2712   LR χ²(2) = 264.5972, p = 3.495e-58
  Pseudo R²: Cox-Snell = 0.7337, Nagelkerke = 0.7969, McFadden = 0.5220

── Notlar ──
  Bağ fonksiyonu: Kümülatif logit. Sıralı kategoriler: nonresponsive < partial < good < full
  (sıra etiketlerden otomatik belirlendi; ...). Orantılı odds varsayımı: ...
  SH'ler gözlenen bilgi matrisinden (Hesse matrisi). ...
| Öğe | Nasıl yorumlanır |
|---|---|
| Sıralı kategoriler (Notlar) | Önce sırayı denetleyin; "otomatik" notu ya da büyük harfli "sıra tanımlanmadı" uyarısı varsa sıra elle yazılmalıdır. |
| Katsayı işareti | Pozitif: açıklayıcı arttıkça yüksek kategorilere kayma. dose_mg 0,132 pozitif, age −0,101 negatif. |
| OR | dose_mg 1,142: yaş sabitken 1 mg artış, "daha iyi yanıt düzeyinde olma" odds'unu her eşikte %14,2 artırır; 10 mg için 3,76 kat. |
| Eşikler | Gizil ölçekteki kesim noktaları; tek başına yorumlanmaz, olasılık hesabı için gerekir. |
| LR χ² | Eğimlerin birlikte katkısı (sd = p). |
| Paralel çizgiler p | p\ge0{,}05 ise "varsayım sağlanıyor" yazar; büyük n'de önemsiz farkları da reddedebilir. |
| Logit dışı bağlantıda exp(β) | Odds oranı değildir; yorumlanmaz (51.5.3 uyarısı). |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Tedavi yanıt düzeyini (yanıtsız < kısmi < iyi < tam) yordamak için doz ve yaşı içeren orantılı odds (kümülatif logit) modeli kuruldu (n = 200). Model, yalnız eşikli modelden anlamlı biçimde daha iyi uyum gösterdi, \chi^2(2, N = 200) = 264{,}60, p < 0{,}001, McFadden R^2 = 0{,}52, Nagelkerke R^2 = 0{,}80. Yaş sabitken her 1 mg doz artışı daha yüksek bir yanıt düzeyinde olma odds'unu artırdı (OR = 1,14; %95 GA [1,11; 1,17]; p < 0{,}001); yaş ise bu odds'u azalttı (OR = 0,90; %95 GA [0,88; 0,93]; p < 0{,}001). Paralel çizgiler testi orantılı odds varsayımının çiğnenmediğini gösterdi, \chi^2(4) = 1{,}14, p = 0{,}89.
51.8 Uzman soruları
S1. Bazı yazılımlarda katsayıların işareti ters çıkıyor. Hangisi doğru?
İkisi de doğrudur; parametreleme farklıdır. MerQur ve R polr/clm \logit P(Y\le j)=\theta_j-\mathbf x^{\top}\boldsymbol\beta yazar. \logit P(Y\le j)=\alpha_j+\mathbf x^{\top}\boldsymbol\beta parametrelemesinde eğimlerin işareti terstir, eşikler aynıdır. Bu parametrelemede kategori sırası ters çevrilirse eğimler MerQur ile aynı işaretli, eşikler ise ters sıralı ve ters işaretli olur.
S2. SH'ler sayısal Hessian'dan geliyor. Ne kadar güvenilir?
Bu veride analitik Hessian'lı R clm ile fark 3\times10^{-9}'dur. MerQur açıklayıcıları standart sapmalarına bölerek sayısal türevin adım boyunu dengeler; bu yapılmadığında ölçeksiz büyük değerli açıklayıcılarda %1–2,5 sapma gözlenmiştir (kod yorumu, glm_advanced.py:1340–1342). R polr ölçeklemesiz sayısal Hessian kullanır ve bu veride SH'lerde göreli 5\times10^{-5} ayrılır. Beklenen bilgiyle (Fisher skorlaması) çalışan yazılımlarda farklar daha büyük olabilir; sonuç metni bunu not eder.
S3. Paralel çizgiler testi orantılı odds skor testiyle aynı mı?
Hayır. MerQur genel modeli gerçekten kestirip LR istatistiği verir. Skor testi yalnız PO modelinde hesaplanır; Brant (1990) testi ayrı ikili lojistiklerin Wald karşılaştırmasıdır. Üçü aynı hipotezi sınar, sonlu örneklemde farklı sayılar verir. Skor testi, açıklayıcı sayısı çok ya da kategoriler seyrekken aşırı reddeder; LR testi genel modelin olasılık sırası bozulduğunda kararsız olabilir.
S4. Kategori sırası yanlış belirlenirse ne olur?
Model bambaşka bir hipotez kurar. Tıp verisinde alfabetik sıra (full < good < nonresponsive < partial) verildiğinde log-olabilirlik −121,1'den −167,2'ye düşer ve doz katsayısı negatif çıkar. MerQur bilinen sözlüklerle sırayı tanır; tanıyamadığında analizi yapmaz ve sıranın tanımlanmasını ister. Alfabetik sıra ve satır sırası bir sıra bilgisi taşımaz; bu yüzden kullanılmaz. Sıra her zaman "Kategori sırası" alanına açıkça yazılmalıdır.
S5. Hangi bağlantı seçilmeli?
Parametre sayısı aynı olduğundan log-olabilirlik ya da AIC doğrudan karşılaştırılır. Bu veride logit en iyisidir (ℓ = −121,14; probit −122,07). Kuramsal tercih de önemlidir: tamamlayıcı log-log, aralıklı izlenen bir olayın sürekli zamandaki orantılı tehlikeler modeliyle ilişkilidir; logit tek bağlantıdır ki katsayılar odds oranı olarak yorumlanır.
S6. Ölçek (Pearson) seçince SH'ler küçüldü. Doğru mu?
Hesap doğrudur ama yorum yanlıştır. Tek gözlemli veride X^2/\text{sd} aşırı yayılımın ölçüsü değildir; bu veride 0,729 çıkar. MerQur \varphi<1'i de uygular ve SH'leri %15 küçültür; bu, aşırı iyimser p değerleri demektir. Ölçek düzeltmesi yalnız gruplanmış veride ve \varphi>1 olduğunda düşünülmelidir.
S7. Kısmi PO çıktısındaki eğimler R `clm(nominal = ~ dose)` ile neden zıt işaretli?
clm eşiğe özgü etkileri eşiğe eklenen terim olarak yazar: \theta_j+\mathbf x^{\top}\tilde{\boldsymbol\beta}_j. MerQur ana modelle tutarlı olsun diye çıkarır: \theta_j-\mathbf x^{\top}\boldsymbol\beta_j. Bu yüzden \boldsymbol\beta_j=-\tilde{\boldsymbol\beta}_j'dir; doğrulamada üç doz eğimi ve SH'leri bu dönüşümle 10^{-9} düzeyinde eşleşir. Çıktının dipnotu bu işaret farkını belirtir.
S8. Eşiklerin p değerleri ne anlatır?
Neredeyse hiçbir şey. H_0:\theta_j=0, "tüm açıklayıcılar sıfırken (doz 0 mg, yaş 0) P(Y\le j)=0{,}5" demektir. Açıklayıcılar merkezlenmediği için bu nokta veri aralığının dışındadır. Eşikler model kurulumunun parçasıdır; raporda p'leri yazılmaz.
51.9 Sık hatalar ve tuzaklar
- Sırayı denetlememek. Otomatik sıra yalnız tanınan sözcüklerde güvenilirdir; sayısal kodlu Likert maddelerinde sayısal sıra, metin etiketlerde sözlük sırası kullanılır; sıra tanınmazsa analiz durur. Notlar satırındaki sıra her çalıştırmada okunmalıdır.
- OR'yi tek bir kategori geçişi gibi okumak. OR, "j veya altı" ile "j'nin üstü" ayrımının odds'unu her eşikte aynı oranda değiştirir; "kısmi yanıttan iyi yanıta geçme olasılığı" değildir.
- Logit dışı bağlantıda exp(β) sütununu OR gibi yorumlamak. Probit ve log-log bağlantılarda e^{\beta} odds oranı değildir.
- Paralel çizgiler p'sine körü körüne güvenmek. Büyük örneklemde önemsiz eğim farkları anlamlı çıkar; küçük örneklemde test güçsüzdür. Kısmi PO eğimlerinin GA'larına bakmak daha bilgilendiricidir.
- Eşiklerin p değerlerini raporlamak. Anlamlı bir hipotez sınamazlar.
- Seyrek örüntüde uyum iyiliğini yorumlamak. Sürekli açıklayıcıda D=-2\ell olur; p\approx1 "mükemmel uyum" demek değildir.
- Ölçek düzeltmesini gruplanmamış veride kullanmak. \varphi<1 çıkar ve SH'ler haksız yere küçülür.
- Grafikte sabit referans. 3B yüzeyde ve Şekil 51.1'de diğer açıklayıcılar ortalamada tutulur; olasılık eğrileri başka yaşlarda farklıdır.
51.10 Kaynaklar
- Agresti, A. (2010). Analysis of ordinal categorical data (2. baskı). Wiley. https://doi.org/10.1002/9780470594001
- Brant, R. (1990). Assessing proportionality in the proportional odds model for ordinal logistic regression. Biometrics, 46(4), 1171–1178. https://doi.org/10.2307/2532457
- Efron, B., & Hinkley, D. V. (1978). Assessing the accuracy of the maximum likelihood estimator: Observed versus expected Fisher information. Biometrika, 65(3), 457–483. https://doi.org/10.1093/biomet/65.3.457
- McCullagh, P. (1980). Regression models for ordinal data. Journal of the Royal Statistical Society: Series B (Methodological), 42(2), 109–127. https://doi.org/10.1111/j.2517-6161.1980.tb01109.x
- Peterson, B., & Harrell, F. E. (1990). Partial proportional odds models for ordinal response variables. Applied Statistics, 39(2), 205–217. https://doi.org/10.2307/2347760
- Williams, R. (2006). Generalized ordered logit/partial proportional odds models for ordinal dependent variables. The Stata Journal, 6(1), 58–82. https://doi.org/10.1177/1536867X0600600104