52. Ridge Regresyon
Analiz kimliği: ridge · Menü adı: Ridge Regresyon · Panel: gui/panels/analyses/ridge_regression.py (form 44–148, execute/pen_execute 164–177) · Motor: stats/regression.py, Regression._regularized (satır 1479–1675); ek çıktılar ve cezalı GLM stats/regularized_extras.py · Çağrı: stats_panel.py:6054–6072
52.1 Ne işe yarar
Ridge regresyon, doğrusal regresyon modelini kurar ama katsayıları küçültülmüş (büzülmüş) olarak kestirir. Cevapladığı soru şudur: "Açıklayıcılar birbiriyle güçlü ilişkiliyken, yeni hastalarda iyi tahmin veren ve kararlı katsayılar nasıl elde edilir?" Model, sıradan en küçük kareler (EKK, OLS) ile aynıdır:
Fark kestirim ölçütündedir: ridge, artık kareler toplamına katsayıların kareler toplamıyla orantılı bir ceza ekler ve bu toplamı en küçükler. Ceza katsayıları sıfıra doğru çeker ama hiçbirini tam sıfır yapmaz.
- y_i: i. hastanın bağımlı değişkeni (bu bölümde hastalık ilerleme puanı).
- z_{ij}: j. açıklayıcının standartlaştırılmış değeri (52.5.1).
- \beta_0: sabit terim; cezalandırılmaz.
- \beta_j: standart ölçekteki katsayı; MerQur tabloda bunu "Katsayı (std.)" sütununda verir.
- \varepsilon_i: hata terimi.
Ne zaman kullanılır?
- Açıklayıcılar arasında güçlü çoklu doğrusal bağıntı varsa ve tümünü modelde tutmak istiyorsanız (ör. aynı yolağı ölçen 15 biyobelirteç).
- Amaç tahminse ve EKK katsayılarının varyansı yüksekse.
- Açıklayıcı sayısı gözlem sayısına yakınsa; ridge p>n durumunda da tek çözüm verir.
Ne zaman kullanılmaz?
- Değişken seçimi isteniyorsa: ridge hiçbir katsayıyı sıfırlamaz. Lasso Regresyon ya da Düzenlileştirilmiş Regresyon (LASSO/Ridge/ElasticNet) içindeki ElasticNet kullanılmalıdır.
- Katsayılar için p değeri, GA ve hipotez testi gerekiyorsa: ridge bunları vermez. Çoklu Doğrusal Regresyon kullanılmalıdır (çoklu bağıntı ılımlıysa VIF ile birlikte).
- Gözlemler kümeli ya da tekrarlıysa: karma modeller (LMM).
- Sonuç ikili ya da sayımsa ve yorum için OR/oran oranı gerekiyorsa: İkili Lojistik Regresyon ya da Poisson / Negatif Binom Regresyon; ridge'in "Hedef türü" seçeneği yalnız cezalı tahmin modeli verir.
Sık karıştırılan analizler. Lasso aynı modeli L_1 cezasıyla kestirir ve bazı katsayıları tam sıfırlar. ElasticNet iki cezayı karıştırır. Temel bileşen regresyonu (PCR) küçük özdeğerli yönleri tümüyle atar; ridge onları atmaz, yalnız güçlü biçimde küçültür (52.5.3). Kısmi en küçük kareler (PLS) bileşenleri y ile kovaryansa göre kurar. MerQur'da Düzenlileştirilmiş Regresyon menüsünün "Ridge (L2)" yöntemi aynı ridge modelini başka bir motorla (otomatik α, k-kat CV ile) kestirir; bkz. Bölüm 107.
52.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Doğrusal ilişki | E(y\mid\mathbf x) açıklayıcıların doğrusal birleşimi. | Denetlenmez; 3B yüzey grafiği yalnız görsel ipucu verir. |
| Bağımsız gözlemler | Her satır ayrı birim. | Tasarım; denetlenmez. |
| Sabit varyanslı hata | Ridge kestiriminin kendisi varyans varsayımı gerektirmez; HKB/L-W ölçütleri \sigma^2'yi EKK artıklarından kestirir. | Denetlenmez. |
| Sayısal ölçek | Açıklayıcılar standartlaştırılır; ölçek farkı sonucu değiştirmez. | Otomatik (regression.py:1515–1517). |
| Ceza düzeyi | α tahmin hatasını en küçükleyecek biçimde seçilmeli. | İsteğe bağlı otomatik α (LOO, k-kat, GCV, HKB, L-W). |
Normallik ya da çoklu bağıntının yokluğu varsayılmaz; tersine, ridge çoklu bağıntı için tasarlanmıştır.
Eksik değer. Önce hedefi eksik olan satırlar atılır (regression.py:308–309), sonra seçilen açıklayıcıların herhangi birinde eksik olan satırlar çıkarılır (liste bazında silme, ml/_preprocessing.py, prepare_numeric_data). Tıp verisinde biomarker_p01'in ilk 10 değeri silinirse model 190 gözlemle kurulur.
Uç durumlar (koddan):
- Varyansı sıfır olan açıklayıcı atılır ve "1 özellik modelden çıkarıldı: k (sabit değer (varyans = 0))" uyarısı yazılır.
- Gözlem sayısı p+2'den azsa hata verilir: 15 açıklayıcıda en az 17 gözlem (
regression.py:321,min_rows=len(feature_cols)+2). - Hedef sabitse \text{TSS}=0 olur ve R^2 tanımsızdır; MerQur açık bir hata iletisiyle durur (Bölüm 107'deki motor gibi).
- Metin sütunları ya da "Kategorik öngörücüler" alanına yazılan sütunlar kukla değişkene açılır (ilk düzey referans); kukla sütunları da standartlaştırılıp cezalandırılır ve bu bir uyarıyla bildirilir (
regularized_extras.py:230–247). - Hedef türü "ikili" seçilirse hedefte tam iki farklı değer olmalıdır; büyük olan olay sayılır (
regularized_extras.py:836–845). "Sayım" seçilirse negatif ya da tam sayı olmayan değer hata verir.
52.3 Parametreler
Varsayılanlar ridge_regression.py:44–148 ve stats_panel.py:6054–6072'den alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken | ilk sayısal sütun | Tahmin edilen değişken. | — |
| Bağımsız değişkenler | en az 1 | Sayısal ya da kategorik açıklayıcılar. | Kategorikler kukla kodlanır. |
| α (Düzenlileştirme) | 1,0 (aralık 10^{-6}–10^{6}, 6 ondalık) | Ceza katsayısı; amaç \text{RSS}+\alpha\lVert\boldsymbol\beta\rVert^2. | α büyüdükçe katsayılar küçülür, df(\alpha) düşer, eğitim R^2'si azalır. |
| Otomatik α (çapraz-doğrulama) | kapalı | α'yı aşağıdaki ölçütle seçer; elle girilen α yok sayılır. | Model seçilen α ile kurulur; uyarı satırında yazılır. |
| α seçim ölçütü | LOO (varsayılan) | LOO, k-kat λ_min, k-kat λ_1SE, GCV, HKB, L-W. | Seçilen α'yı belirler. |
| CV kat sayısı | 5 (3–20) | Ardışık (karıştırılmamış) kat sayısı. | Yalnız k-kat ölçütleri ve "CV performansı" için kullanılır. |
| Hedef türü | Sürekli (doğrusal) | İkili: cezalı lojistik; sayım: cezalı Poisson. | Amaç fonksiyonu ve çıktı (D², sapma) değişir. |
| Kategorik öngörücüler | boş | Sayısal kodlu sütunları kukla kodlatır. | Tasarım matrisi. |
| Ek çıktı: Ridge izi + CV eğrisi | kapalı | Izgara boyunca katsayı yolu, LOO (ya da seçilen k-kat) eğrisi, df(\alpha). | Ek bölüm ve iki ek grafik paneli. |
| Ek çıktı: CV performansı | kapalı | Seçilen α'da dışarıda bırakılmış tahmin hatası. | Ek bölüm. |
| Ek çıktı: VIF / koşul sayısı | kapalı | EKK ve ridge VIF'leri, koşul sayısı. | Ek bölüm. |
| Ek çıktı: HKB/L-W/GCV | kapalı | Üç klasik ölçütün önerdiği α. | Ek satır; model değişmez. |
| Grafik | Katsayı grafiği (varsayılan) | Standart katsayı çubukları; ya da 3B yüzey. | Yalnız Grafik sekmesi. |
Otomatik α kapalıyken ölçüt seçmek ne işe yarar?
Seçilen ölçüt sessizce yok sayılmaz. Otomatik α kapalıyken ölçüt LOO dışında bir şeyse MerQur o ölçütün önereceği α'yı hesaplar ve "α SEÇİM ÖLÇÜTÜNÜN ÖNERİSİ" bölümünde yazar; model yine elle girilen α ile kurulur (regularized_extras.py:411–450). Örneğin GCV seçili, otomatik α kapalı ve α = 1 iken çıktı "GCV ölçütünün önerdiği α = 76.5533. Model elle girilen α = 1 ile kuruldu" der. Böylece kullanıcı önerilen değeri görüp kendisi girebilir. Cezalı lojistik/Poisson modelde GCV, HKB ve L-W tanımsızdır; bunlar seçilirse ayar bloğuna "desteklenmiyor" kaydı düşülür (ridge_regression.py:184–205).
52.4 Tıp örneği
Dosya: english/datasets/Tip/49_ridge_biomarker_progression.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/49_ridge_belirtec_progresyon.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #49'daki gibidir.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
progression |
Bağımlı | sürekli (puan) | ort. 51,53; SS 11,80; 16,70–93,61 |
biomarker_p01 … biomarker_p15 |
Açıklayıcı (15) | sürekli | ortalamalar 0,014–0,160; SS 0,66–0,82 |
patient_id |
— | kimlik | kullanılmaz |
n ve eksik değer: 200 hasta, hiçbir sütunda eksik değer yok. Açıklayıcılar arası korelasyonlar 0,632 ile 0,778 arasındadır: her çift güçlü biçimde ilişkilidir. EKK VIF'leri 3,06–4,24'tür.
Klinik soru: 15 biyobelirteç birlikte hastalık ilerlemesini ne kadar iyi tahmin ediyor? Biyobelirteçler bu kadar ilişkiliyken hangilerinin katkısı kararlı biçimde pozitiftir?
Seçilen ayarlar: Önce arayüz varsayılanları (α = 1, otomatik α kapalı). Sonra otomatik α (LOO) açılarak ikinci çalıştırma. Hesap yürüyüşü için dört "Ek çıktı" kutusu da açıldı. Cezalı lojistik yolunu göstermek için türetilmiş ikili hedef kullanıldı: ilerleme_yuksek = 1{progression > medyan 52,15} (100 olay, 100 olay yok; yalnız bu doğrulama için).
52.5 Formüller ve hesap adımları
MerQur'un hesap sırası şöyledir: (1) hedef ve açıklayıcılar sayısala çevrilir, eksikler liste bazında atılır, sabit sütunlar düşer; (2) açıklayıcılar 1/n-SS ile standartlaştırılır; (3) otomatik α açıksa ızgara kurulur ve seçilen ölçütle α bulunur; (4) scikit-learn Ridge(alpha=α) standart ölçekte uydurulur; (5) katsayılar özgün ölçeğe çevrilir; (6) R^2 ve düzeltilmiş R^2 eğitim verisinde hesaplanır; (7) istenen ek çıktılar eklenir (regression.py:1479–1675).
52.5.1 Standartlaştırma
- x_{ij}: j. açıklayıcının ham değeri.
- \bar x_j: sütun ortalaması.
- s_j: n'ye bölünen standart sapma (scikit-learn
StandardScaler,regression.py:1515–1517). - Sonuç: her z_j sütununun ortalaması 0, \frac1n\sum z_{ij}^2=1; dolayısıyla \mathbf Z^{\top}\mathbf Z=n\mathbf R (\mathbf R: açıklayıcıların korelasyon matrisi).
Neden standartlaştırma şart?
Ceza \alpha\sum\beta_j^2 her katsayıya aynı ağırlığı verir. Açıklayıcılar farklı birimlerdeyse (mg/dL ile yıl) birim değiştirmek katsayının büyüklüğünü, dolayısıyla cezasını değiştirir; sonuç ölçeğe bağımlı olur. Standartlaştırma bütün açıklayıcıları aynı ölçeğe getirir. n'ye bölünen SS, R MASS::lm.ridge ve glmnet(standardize = TRUE) ile aynı tanımdır; bu yüzden MerQur'un α'sı lm.ridge'in λ'sıyla birebir aynıdır.
52.5.2 Amaç fonksiyonu ve kapalı çözüm
- \alpha\ge0: ceza katsayısı; formdaki "α (Düzenlileştirme)".
- \mathbf Z: n\times p standart tasarım matrisi (sabit sütunu yok).
- \mathbf I_p: p\times p birim matris; ceza yalnız eğim katsayılarına uygulanır.
- \hat\beta_0=\bar y: \mathbf Z'nin sütunları ortalanmış olduğundan sabit terim ceza almadan y'nin ortalamasına eşit çıkar.
- \alpha=0 iken EKK çözümü elde edilir.
Neden \alpha\mathbf I eklemek işe yarar?
Çoklu bağıntıda \mathbf Z^{\top}\mathbf Z'nin bazı özdeğerleri sıfıra yakındır; tersi alınırken bu özdeğerler büyük sayılara dönüşür ve EKK katsayılarının varyansı patlar (\operatorname{Var}(\hat{\boldsymbol\beta}_{\text{EKK}})=\sigma^2(\mathbf Z^{\top}\mathbf Z)^{-1}). Köşegene \alpha eklemek bütün özdeğerleri \alpha kadar büyütür; matris her zaman tersinir olur ve varyans azalır. Bedeli sıfıra doğru bir yanlılıktır. Hoerl ve Kennard (1970), MSE'yi EKK'dan küçük yapan bir \alpha>0'ın her zaman var olduğunu göstermiştir.
Koddaki tercih: α birimi
Amaç fonksiyonunda 1/n ya da 1/2 çarpanı yoktur (scikit-learn Ridge, regression.py:1553). Bu nedenle aynı α farklı yazılımlarda farklı ceza demektir:
- R
MASS::lm.ridge(lambda = α): aynı ceza (doğrulamada birebir eşleşir). - R
glmnet(alpha = 0): amaç \frac{1}{2n}\text{RSS}+\frac{\lambda}{2}\lVert\boldsymbol\beta\rVert^2 ve y'yi de içeride ölçekler; \lambda=\alpha/n yalnız y'nin SS'si 1 iken eşdeğerdir. - Korelasyon ölçeği (Marquardt 1970): (\mathbf R+k\mathbf I); k=\alpha/n.
MerQur Bölüm 107'deki ElasticNet'te "L1 oranı = 0" ile kurulan saf ridge ise glmnet birimini kullanır: orada α = 1, burada α = n demektir (bkz. 107.5).
52.5.3 Tekil değer ayrışımı ve büzülme
\mathbf Z_c=\mathbf U\mathbf D\mathbf V^{\top} (\mathbf D=\operatorname{diag}(d_1,\dots,d_p)) yazılırsa
- \mathbf u_k,\mathbf v_k: sol ve sağ tekil vektörler; \mathbf v_k açıklayıcı uzayında k. temel bileşen yönüdür.
- d_k^2=n\,\lambda_k(\mathbf R): k. bileşenin varyansının n katı.
- d_k^2/(d_k^2+\alpha): k. yöndeki büzülme çarpanı; büyük varyanslı yönler neredeyse hiç küçülmez, küçük varyanslılar güçlü küçülür.
- \mathbf y_c=\mathbf y-\bar y\mathbf 1.
- df(\alpha): etkili serbestlik derecesi (ESL denklem 3.50); \alpha=0'da p, \alpha\to\infty'da 0 (
regularized_extras.py:264–267).
52.5.4 Özgün ölçeğe dönüş
- B_j: ham birimde katsayı; tabloda "Katsayı (ham)".
- b_0: ham ölçekte sabit terim; tablonun "Sabit terim" satırının "ham" sütunu. Aynı satırın "std." sütunu \bar y'dir.
Bu dönüşüm regression.py:1598–1612'dedir ve model tahminlerini değiştirmez: b_0+\sum B_jx_{ij}=\bar y+\sum\hat\beta_jz_{ij}.
52.5.5 Uyum ölçüleri
- \hat y_i: eğitim verisindeki uydurulmuş değer; R^2 eğitim R^2'sidir.
- \mathrm{df}_H: şapka matrisinin izi, yani sabit dahil etkin serbestlik derecesi (Hastie, Tibshirani ve Friedman 2009, §3.4.1); d_j, ortalanmış standart \mathbf Z'nin tekil değerleridir. EKK'da (\alpha=0) p+1'e eşittir ve formül klasik düzeltilmiş R^2'ye indirgenir.
Düzeltilmiş R² ve gizlenen satırlar
Düzeltilmiş R^2 nominal p yerine etkin serbestlik derecesini kullanır (regression.py:50–69, 1646–1647); sonuç metni tanımı ve \mathrm{df}_H'yi "Düzeltilmiş R² etkin serbestlik derecesiyle: df = tr(H_λ) = …" satırında yazar. Değer yine eğitim verisine dayanır; genelleme için R^2_{\text{CV}} kullanılır. F, p, AIC ve BIC hesaplanmaz; sonuç metninde bu satırlar bilerek gizlenir (stats_panel.py:10326–10330). Katsayılar için SH ve GA verilmez.
52.5.6 α seçimi
Izgara. Otomatik α'da aday değerler veriden kurulur (regularized_extras.py:151–159):
Neden d^2'ye göre?
Büzülme çarpanı d_k^2/(d_k^2+\alpha) olduğundan, \alpha=10^3\max d^2'de bütün çarpanlar 0,001'in altındadır (df\approx p/1001, boş modele yakın); \alpha=10^{-3}\min d^2'de hepsi 0,999'un üstündedir (df\approx p, EKK'ya yakın). Böylece ızgara verinin ölçeğinden bağımsız olarak "boş modelden EKK'ya" uzanır. Sabit bir ızgara (ör. [10^{-3},10^{2}]) büyük ölçekli verilerde uç noktada takılırdı; ölçeğe bağlı ızgara bunu önler.
LOO (varsayılan ölçüt). Her i için i. gözlem dışarıda bırakılır; kalan n-1 gözlemde ortalama ve 1/n-SS yeniden hesaplanır, ridge uydurulur ve dışarıdaki gözlem tahmin edilir (regularized_extras.py:270–320):
- \hat y_{(-i)}(\alpha): i. gözlem hiç görülmeden kurulan modelin tahmini.
- e_{(-i)}^2: o gözlemin karesel tahmin hatası.
- SE: kat hatalarının (burada n tekil "kat") standart hatası.
Otomatik α LOO'da \lambda_{\min}'i kullanır. \lambda_{1\text{SE}} yalnız "Ridge izi + CV eğrisi" bölümünde raporlanır.
Koddaki tercih: LOO'da yeniden ölçekleme
LOO, her eğitim kümesinde standartlaştırmayı yeniden yapar; kapalı biçimli "hat matrisi" kısayolu (e_{(-i)}=e_i/(1-h_{ii})) ölçeği sabit tuttuğu için bundan çok az farklıdır. MerQur n\le3000'de kesin yolu izler; n>3000'de tam veri ölçeğinde kısayola geçer ve "ölçek sabit" uyarısı yazar (regularized_extras.py:39, 305–320). Eşitlikte en büyük α'nın seçilmesi glmnet getOptcv kuralıdır.
k-kat CV. Veri sırasıyla ardışık K bloğa bölünür (scikit-learn KFold(shuffle = False); ilk n\bmod K kat bir gözlem fazladır, regularized_extras.py:174–183). Her eğitim katında yeniden ölçekleme yapılır; kat MSE'leri kat büyüklüğüyle ağırlıklı ortalanır:
- \text{MSE}_k(\alpha): k. test katındaki ortalama karesel hata.
- n_k: k. katın gözlem sayısı.
- Eğitim katında glmnet λ'sı sabit tutulur (cv.glmnet tanımı; Friedman, Hastie ve Tibshirani 2010). α birimi \text{RSS}+\alpha\lVert\boldsymbol\beta\rVert^2 (\alpha=n\lambda) olduğundan eğitim katındaki amaç \text{RSS}_{\text{eğitim}}+\alpha\,(n_{\text{eğitim}}/n)\lVert\boldsymbol\beta\rVert^2'dir (
regularized_extras.py:289). LOO'da ceza \alpha(n-1)/n'dir (regularized_extras.py:315).
GCV, HKB ve L-W (regularized_extras.py:335–357; R MASS::select tanımı):
- \hat{\mathbf y}_c(\alpha): ortalanmış uydurulmuş değerler.
- \hat\sigma^2=\text{RSS}_{\text{EKK}}/(n-p-1): EKK artık varyansı.
- \hat{\boldsymbol\beta}_{\text{EKK}}: standart ölçekte EKK katsayıları.
- GCV ızgaradaki en küçük değerinde seçilir; HKB ve L-W kapalı formdur, ızgaraya bağlı değildir.
HKB ve L-W neden (p-2) içerir?
Hoerl, Kennard ve Baldwin (1975), James–Stein büzülme kestiriminden esinlenerek k=p\hat\sigma^2/\lVert\hat{\boldsymbol\beta}\rVert^2'yi önermiştir; MASS uygulaması James–Stein'daki (p-2) çarpanını kullanır. Lawless ve Wang (1976) paydada \lVert\hat{\boldsymbol\beta}\rVert^2 yerine uydurulmuş değerlerin kareler toplamını (\hat{\boldsymbol\beta}^{\top}\mathbf Z^{\top}\mathbf Z\hat{\boldsymbol\beta}) kullanır; korelasyon ölçeğinde yazıldığı için n çarpanı gelir. Her ikisi de CV'ye göre çok daha az ceza seçme eğilimindedir.
Seçilen α ızgaranın alt ya da üst ucundaysa uyarı yazılır: alt uçta "çözüm cezasız EKK'ya yakın", üst uçta "öngörücüler tahmine katkı sağlamıyor" (regularized_extras.py:162–171).
52.5.7 VIF ve koşul sayısı
- \mathbf R: açıklayıcıların korelasyon matrisi.
- k: korelasyon ölçeğindeki ridge sabiti (Marquardt 1970).
- Ridge VIF'i, ridge kestiricisinin varyansının (\sigma^2 birimi) köşegenidir; EKK'nın aksine 1'in altına inebilir.
- \kappa: koşul sayısı (özdeğer oranının karekökü); 30'un üstü ciddi çoklu bağıntı sayılır.
regularized_extras.py:453–478. Metinde VIF(EKK) > 5 olan satırlar "⚠" ile işaretlenir.
52.5.8 CV tahmin performansı
Seçilen α'da ardışık K katla dışarıda bırakılmış tahminler \tilde y_i toplanır (her katta yeniden ölçekleme ve CV eğrisindeki gibi \alpha\,n_{\text{eğitim}}/n cezası, regularized_extras.py:542–583):
- \tilde y_i: i. gözlemin, kendisini içermeyen katta kurulan modelden tahmini.
- R^2_{\text{CV}} kat R^2'lerinin kat büyüklüğüyle ağırlıklı ortalamasıdır (cv.glmnet
cvmmantığı); \bar y_k, k. test katının ortalamasıdır. Bölüm 107'deki "R² (CV)" ile aynı tanımdır. MSE ve MAE'nin kat ortalaması havuzlanmış değere eşittir.
52.5.9 Cezalı lojistik ve Poisson ridge
"Hedef türü" ikili ya da sayım seçildiğinde amaç (regularized_extras.py:654–712):
- \ell: Bernoulli (logit bağlantı) ya da Poisson (log bağlantı) log-olabilirliği; standart ölçekte.
- \alpha/2: buradaki \tfrac12 çarpanı Gauss ridge'inde yoktur; glmnet
alpha = 0amacıyla eşleşmesi içindir. Çıktı bu eşlemeyi "λ = α/n" satırıyla yazar.
Çözüm IRLS ile bulunur: her adımda w_i=\mu_i(1-\mu_i) (Poisson'da \mu_i), çalışma yanıtı z_i=\eta_i+(y_i-\mu_i)/w_i ve
- \tilde{\mathbf Z}=[\mathbf 1,\mathbf Z]: sabit sütunlu tasarım.
- \mathbf P: sabit terimi cezalandırmayan ceza matrisi.
- Amaç azalmazsa adım yarılanır; durma ölçütü amaçta göreli 10^{-12} ve katsayıda 10^{-9}.
Uyum için R^2 yerine açıklanan sapma D^2=1-D/D_0 verilir (D_0: yalnız sabitli model). Otomatik α'da ızgara ortalama IRLS ağırlığıyla (\bar y(1-\bar y) ya da \bar y) ölçeklenir; CV ölçütü test katındaki ortalama sapmadır ve ikili modelde olasılıklar [10^{-5},1-10^{-5}]'e kırpılır. Burada eğitim katında glmnet λ'sı sabit tutulur: amaçtaki ceza \alpha\,n_{\text{eğitim}}/n olur (regularized_extras.py:790). Seçim ızgaranın alt ucuna düşerse ızgara alt uçtan en çok 4 kez iki onluk uzatılır (regularized_extras.py:755–771). Cezalı GLM'de LOO, GCV, HKB ve L-W tanımlı değildir; otomatik α bu ölçütlerden biriyle istenirse k-kat λ_min kullanılır ve uyarılır.
Kat içi ceza ölçeği
Gauss ve GLM ridge'inde CV eğrisi, otomatik α ve "CV performansı" aynı kuralı kullanır: eğitim katında glmnet λ'sı sabittir, ceza \alpha\,n_{\text{eğitim}}/n'dir (regularized_extras.py:289, 315, 814–833). Böylece seçilen α'daki başarım, CV eğrisinin o α'daki değeriyle aynı ceza ölçeğinde hesaplanır.
52.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Bütün ara değerler dogrulama/ridge/elle_hesap.py ile (MerQur çağrılmadan, yalnız numpy) hesaplanmıştır.
Adım 1 — Standartlaştırma. \bar y=51{,}5275. Örnek açıklayıcı biomarker_p03: \bar x_3=0{,}105310, s_3=0{,}763602 (n'ye bölünen SS). Örneğin 1. hastada x_{1{,}3}=-1{,}262 için z_{1{,}3}=(-1{,}262-0{,}105310)/0{,}763602=-1{,}790605.
Adım 2 — Çapraz çarpım matrisi ve özdeğerler. \mathbf Z^{\top}\mathbf Z=n\mathbf R: köşegen öğeler 200, örneğin (\mathbf Z^{\top}\mathbf Z)_{1{,}2}=200\times0{,}703708=140{,}7415. \mathbf R'nin özdeğerleri 11,0041 (ortak "biyobelirteç düzeyi" bileşeni) ile 0,1443 arasındadır:
Bir bileşen toplam varyansın %73'ünü taşır; geri kalan 14 yön ise küçük ve birbirine yakın varyanslıdır.
Adım 3 — α = 1'de çözüm. (\mathbf Z^{\top}\mathbf Z+\mathbf I)\hat{\boldsymbol\beta}=\mathbf Z^{\top}\mathbf y_c çözülür; örneğin (\mathbf Z^{\top}\mathbf y_c)_3=1900{,}6219. Büzülme çarpanları 2200{,}81/2201{,}81=0{,}99955'ten 28{,}87/29{,}87=0{,}96652'ye uzanır:
| Açıklayıcı | EKK \beta | Ridge \beta (α = 1) | Ridge \beta (α = 76,55, LOO) |
|---|---|---|---|
| p01 | 1,1589 | 1,161636 | 1,039074 |
| p02 | −0,1845 | −0,165879 | 0,377403 |
| p03 | 2,1334 | 2,112376 | 1,377534 |
| p05 | 2,0440 | 2,016461 | 1,255287 |
| p07 | 1,5933 | 1,576575 | 1,087017 |
| p09 | −0,7862 | −0,753273 | 0,149544 |
| p15 | −0,0652 | −0,055231 | 0,343393 |
α = 1 neredeyse EKK'dır: d^2'lerin en küçüğü bile 28,9 olduğundan ceza görece küçüktür. EKK'da negatif çıkan p02, p09, p15 katsayıları, bu belirteçlerin her biri ilerlemeyle tek başına güçlü pozitif ilişkili olduğu hâlde (r=0{,}71–0{,}74), çoklu bağıntının ürünüdür; LOO'nun seçtiği α'da üçü de pozitife döner.
Adım 4 — Özgün ölçek. B_3=2{,}112376/0{,}763602=2{,}766331. Bütün B_j'ler hesaplandıktan sonra b_0=51{,}5275-\sum_jB_j\bar x_j=50{,}198877.
Adım 5 — Uyum. R^2=0{,}797988 (EKK: 0,797995); \mathrm{df}_H=1+14{,}734977=15{,}734977, R^2_{\text{düz}}=1-(1-0{,}797988)\times199/(200-15{,}734977)=0{,}781833. Ceza eğitim R^2'sini yalnız 7\times10^{-6} düşürmüştür.
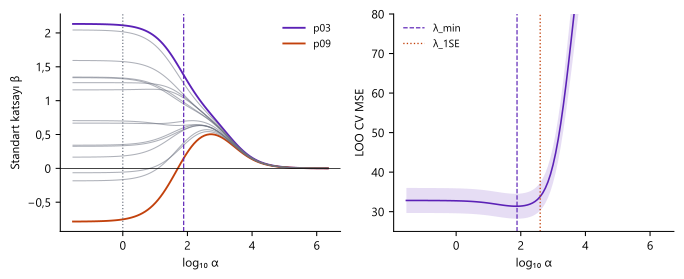
Adım 6 — Ridge izi. α büyüdükçe:
| α | df(\alpha) | R^2 | \beta_{03} | \beta_{09} | \beta_{02} | \lVert\boldsymbol\beta\rVert |
|---|---|---|---|---|---|---|
| 0 (EKK) | 15,000 | 0,797995 | 2,1334 | −0,7862 | −0,1845 | 4,4356 |
| 1 | 14,735 | 0,797988 | 2,1124 | −0,7533 | −0,1659 | 4,3921 |
| 10 | 12,763 | 0,797504 | 1,9471 | −0,5134 | −0,0272 | 4,0836 |
| 76,55 | 6,818 | 0,790635 | 1,3775 | 0,1495 | 0,3774 | 3,3014 |
| 1000 | 1,440 | 0,704271 | 0,6438 | 0,4713 | 0,5103 | 2,1591 |
| 100000 | 0,030 | 0,033171 | 0,0186 | 0,0163 | 0,0171 | 0,0674 |
Çok büyük α'da bütün katsayılar aynı küçük değere yaklaşır: büzülme çarpanı ilk bileşende (bütün belirteçlerin ortak düzeyi) en yavaş düştüğü için çözüm bu yöne, yani eşit ağırlıklara doğru daralır.
Şekil 52.1. Sol: ridge izi (standart katsayılar; mor p03, turuncu p09, nokta çizgi α = 1, kesikli çizgi LOO λ_min). Sağ: LOO CV hatası ± SE; kesikli λ_min, noktalı λ_1SE.
Adım 7 — LOO ile α. Izgara 10^3\times2200{,}81=2200811{,}44'ten 10^{-3}\times28{,}866=0{,}028866'ya 100 değerdir. 200 LOO uydurması (her biri kendi ölçeklemesiyle) sonucunda:
Her LOO katında ceza \alpha\times199/200'dür. \lambda_{1\text{SE}}, CV hatası 31{,}3729+3{,}1545=34{,}5274'ün altında kalan en büyük α'dır. Seçilen modelde df=6{,}8175 (\mathrm{df}_H=7{,}8175), R^2=0{,}790635, R^2_{\text{düz}}=0{,}783208; büzülme çarpanları 0,9664 (ilk bileşen) ile 0,2738 arasındadır. Aynı ızgarada 5 kat CV bir ızgara noktası yukarıda, \lambda_{\min}=91{,}9564'te en küçüğe ulaşır (\lambda_{1\text{SE}}=276{,}2430); 10 kat CV LOO ile aynı noktayı, 76,5533'ü verir.
Adım 8 — HKB, L-W, GCV. EKK'dan \hat\sigma^2=30{,}429457, \lVert\hat{\boldsymbol\beta}_{\text{EKK}}\rVert^2=19{,}674390, \lVert\mathbf Z_c\hat{\boldsymbol\beta}_{\text{EKK}}\rVert^2=22118{,}1482:
GCV ızgarada 76,5533'te en küçüktür (\text{GCV}=0{,}155495); burada LOO ile aynı ızgara noktasına düşer.
Adım 9 — VIF. EKK VIF'leri 3,060 (p12) ile 4,243 (p11) arasındadır; p03 için 4,007468. α = 1'de k=1/200=0{,}005 ve ridge VIF'i 3,830770, \kappa_{\text{ridge}}=8{,}5863. α = 50'de k=0{,}25: bütün ridge VIF'leri 0,899–0,928 arasına iner (p03 0,920927) ve \kappa_{\text{ridge}}=\sqrt{11{,}2541/0{,}3943}=5{,}3423.
Adım 10 — CV performansı. α = 1, ardışık 5 kat (her biri 40 hasta): \text{MSE}_{\text{CV}}=33{,}7119, RMSE 5,8062, MAE 4,6546, R^2_{\text{CV}}=0{,}755088 (beş kat R^2'sinin ortalaması). α = 50'de RMSE 5,6069 ve R^2_{\text{CV}}=0{,}771403: eğitim R^2'si 0,797988'den 0,793264'e düşerken dışarıda bırakılmış R^2 0,755'ten 0,771'e çıkar. Ridge'in kazancı tam olarak budur.
Adım 11 — Cezalı lojistik ridge. ilerleme_yuksek hedefinde α = 1 (\lambda_{\text{glmnet}}=0{,}005): Newton yinelemesi 8 adımda yakınsar; D=111{,}3256, D_0=277{,}2589, D^2=0{,}598478; p03 için \beta=0{,}883874. Otomatik α (5 kat λ_min, sapma ölçütü): ızgara \bar y(1-\bar y)=0{,}25 ağırlığıyla 550202{,}86'dan 0{,}0072164'e uzanır; \lambda_{\min}=15{,}9326, \lambda_{1\text{SE}}=82{,}9563 ve seçilen modelde D^2=0{,}554289. α = 1'de CV performansı (katta ceza \alpha\times160/200): ortalama sapma 0,769121, sınıflama hatası 0,155.
52.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucunun coefficients tablosundan ve extras sözlüğünden alınmıştır; R^2 ve düzeltilmiş R^2'deki 6 ondalık yuvarlaması (regression.py:1652–1653) doğrulamada bellekte devre dışı bırakılmıştır. R: 4.5.3; MASS::lm.ridge (katsayılar, kHKB, kLW, GCV), LOO ve k-kat eğrileri ile CV performansı cv.glmnet tanımıyla R'de elle (her eğitim katında 1/n-SS ile yeniden ölçekleme, ceza \alpha\,n_{\text{eğitim}}/n; R^2_{\text{CV}} kat ortalaması), VIF matris cebiriyle, cezalı lojistik ridge glmnet(family = "binomial", alpha = 0, lambda = α/n, thresh = 1e-14) ve cv.glmnet(foldid = ardışık, lambda = ızgara/n) ile.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| α = 1: standart katsayılar β (15 + sabit) | 2,112376 | 2,112376 | 2,112376 | 9,3e−15 | ✓ |
| α = 1: özgün ölçek katsayıları B (15 + sabit) | 2,766331 | 2,766331 | 2,766331 | 3,6e−14 | ✓ |
| α = 1: sabit terim b₀ (özgün ölçek) | 50,198877 | 50,198877 | 50,198877 | 3,6e−14 | ✓ |
| α = 1: R² | 0,797988 | 0,797988 | 0,797988 | 3,3e−16 | ✓ |
| α = 1: düzeltilmiş R² | 0,781833 | 0,781833 | 0,781833 | 2,2e−16 | ✓ |
| α = 1: etkili sd df(α) | 14,734977 | 14,734977 | 14,734977 | 3,0e−14 | ✓ |
| α = 50: B (15 + sabit) | 1,998326 | 1,998326 | 1,998326 | 2,1e−14 | ✓ |
| α = 50: R² | 0,793264 | 0,793264 | 0,793264 | 4,4e−16 | ✓ |
| Ridge izi ızgarası: üst uç | 2200811,441295 | 2200811,441295 | 2200811,441295 | 4,7e−10 | ✓ |
| Ridge izi ızgarası: alt uç | 0,028866 | 0,028866 | 0,028866 | 1,4e−17 | ✓ |
| LOO: λ_min | 76,553309 | 76,553309 | 76,553309 | 2,8e−14 | ✓ |
| LOO: λ_1SE | 398,591208 | 398,591208 | 398,591208 | 2,3e−13 | ✓ |
| LOO: CV MSE (λ_min) | 31,372939 | 31,372939 | 31,372939 | 2,1e−14 | ✓ |
| LOO: SE (λ_min) | 3,154547 | 3,154547 | 3,154547 | 8,9e−16 | ✓ |
| Otomatik α (LOO): seçilen α | 76,553309 | 76,553309 | 76,553309 | 2,8e−14 | ✓ |
| Otomatik α (LOO): B (15 + sabit) | 1,803995 | 1,803995 | 1,803995 | 1,4e−14 | ✓ |
| 5 kat: λ_min | 91,956443 | 91,956443 | 91,956443 | 2,8e−14 | ✓ |
| 5 kat: λ_1SE | 276,243029 | 276,243029 | 276,243029 | 3,4e−13 | ✓ |
| 5 kat λ_1SE modeli: B (15 + sabit) | 1,271112 | 1,271112 | 1,271112 | 7,1e−15 | ✓ |
| 10 kat: λ_min | 76,553309 | 76,553309 | 76,553309 | 2,8e−14 | ✓ |
| HKB | 20,106491 | 20,106491 | 20,106491 | 4,3e−14 | ✓ |
| L-W | 3,576999 | 3,576999 | 3,576999 | 5,8e−15 | ✓ |
| GCV en küçüğü: λ | 76,553309 | 76,553309 | 76,553309 | 2,8e−14 | ✓ |
| GCV en küçük değeri | 0,155495 | 0,155495 | 0,155495 | 3,6e−16 | ✓ |
| Otomatik α (HKB): B (15 + sabit) | 2,361051 | 2,361051 | 2,361051 | 3,6e−14 | ✓ |
| Otomatik α (L-W): B (15 + sabit) | 2,698709 | 2,698709 | 2,698709 | 4,3e−14 | ✓ |
| VIF (OLS), 15 değişken | 4,007468 | 4,007468 | 4,007468 | 9,8e−15 | ✓ |
| VIF (ridge, α = 1) | 3,830770 | 3,830770 | 3,830770 | 1,6e−14 | ✓ |
| VIF (ridge, α = 50) | 0,920927 | 0,920927 | 0,920927 | 1,7e−15 | ✓ |
| Koşul sayısı κ | 8,731736 | 8,731736 | 8,731736 | 3,6e−15 | ✓ |
| Koşul sayısı κ (ridge, α = 50) | 5,342267 | 5,342267 | 5,342267 | 7,1e−15 | ✓ |
| CV performansı α = 1: MSE | 33,711947 | 33,711947 | 33,711947 | 0,0e+00 | ✓ |
| CV performansı α = 1: MAE | 4,654618 | 4,654618 | 4,654618 | 8,0e−15 | ✓ |
| CV performansı α = 1: R²_CV | 0,755088 | 0,755088 | 0,755088 | 1,1e−16 | ✓ |
| CV performansı α = 50: RMSE | 5,606920 | 5,606920 | 5,606920 | 8,9e−16 | ✓ |
| Lojistik ridge α = 1: β (15 + sabit) | 0,883874 | 0,883874 | 0,883873 | 2,0e−07 | ✓ |
| Lojistik ridge α = 1: B (15 + sabit) | 1,157505 | 1,157505 | 1,157505 | 2,9e−07 | ✓ |
| Lojistik ridge α = 1: sapma | 111,325645 | 111,325645 | 111,325645 | 1,9e−07 | ✓ |
| Lojistik ridge α = 1: D² | 0,598478 | 0,598478 | 0,598478 | 6,9e−10 | ✓ |
| Lojistik ridge CV: λ_min (α birimi) | 15,932568 | 15,932568 | 15,932568 | 4,3e−14 | ✓ |
| Lojistik ridge CV: λ_1SE (α birimi) | 82,956330 | 82,956330 | 82,956330 | 1,4e−14 | ✓ |
| Lojistik ridge CV performansı: ortalama sapma | 0,769121 | 0,769121 | 0,769121 | 9,8e−10 | ✓ |
| Lojistik ridge CV performansı: sınıflama hatası | 0,155000 | 0,155000 | 0,155000 | 0,0e+00 | ✓ |
Bütün Gauss satırları göreli olarak 10^{-13} düzeyinde eşleşir. Cezalı lojistik ridge'de R ile fark 3\times10^{-7}'ye çıkar: glmnet'in durma ölçütü sapmanın göreli değişimine dayanır ve katsayıyı yaklaşık 7 basamakta bırakır; MerQur ile bağımsız Newton çözümü arasındaki fark 10^{-10}'un altındadır. λ_min ve λ_1SE üç kaynakta aynı ızgara noktasıdır.
52.7 Çıktıyı okuma
Sonuç metni (α = 1, dört ek çıktı açık; kısaltılmış):
MODEL: Ridge Regresyon (α=1)
──────────────────────────────────────────────────
n = 200  |  Hedef: progression
R² = 0.797988  Düzeltilmiş R² = 0.781833
Düzeltilmiş R² etkin serbestlik derecesiyle: df = tr(H_λ) = 15.73 (sabit dahil; Düz.R² = 1 − (1 − R²)(n − 1)/(n − df)).

── RIDGE İZİ VE CV EĞRİSİ ──
    CV türü: birini dışarıda bırak (LOO, kesin)
    λ_min = 76.553  (CV MSE = 31.373 ± 3.155)
    λ_1SE = 398.59  (CV MSE = 33.812 ± 3.518)
    İz ızgarası: α ∈ [0.0288657, 2.20081e+06]; etkili sd aralığı 0.001 – 14.992
    Etkili serbestlik derecesi df(α) = 14.735

── α SEÇİM ÖLÇÜTLERİ ──
    HKB = 20.106   L-W = 3.577   GCV en küçüğü (ızgara) = 76.553

── ÇOKLU DOĞRUSALLIK (VIF / KOŞUL SAYISI) ──
    Koşul sayısı κ = 8.732 (ridge sonrası 8.586; korelasyon ölçeğinde k = 0.005)
    biomarker_p01             VIF(OLS) = 3.671   VIF(ridge) = 3.513
    ...
── ÇAPRAZ DOĞRULAMA TAHMİN PERFORMANSI ──
    5-katlı CV (seçilen α): MSE = 33.712, RMSE = 5.8062, MAE = 4.6546, R²_CV = 0.7551
    Etkili serbestlik derecesi df(α) = 14.735
Otomatik α (LOO) açıldığında başlık MODEL: Ridge Regresyon (α=76.5533) olur, R^2 satırı R² = 0.790635 Düzeltilmiş R² = 0.783208 yazar ve uyarılar bölümünde ⚠ Çapraz-doğrulama ile seçilen α = 76.5533 (200-katlı CV). görünür (LOO, n katlı CV olarak adlandırılır).
Tablo sekmesi: Değişken · Katsayı (ham) · Katsayı (std.) · Sıfırlandı. Ridge'de "Sıfırlandı" sütunu her satırda "—"dir. Sayılar 6 anlamlı basamakla yazılır.
| Öğe | Nasıl yorumlanır |
|---|---|
| Başlıktaki α | Modelin gerçekten kurulduğu ceza. Otomatik α açıksa elle girilen değerden farklıdır. |
| R^2 | Eğitim verisindeki açıklanan varyans; α arttıkça her zaman düşer. Genelleme için "CV performansı"ndaki R^2_{\text{CV}}'ye bakın. |
| Düzeltilmiş R^2 | Etkin serbestlik derecesiyle (\mathrm{df}_H=\operatorname{tr}(\mathbf H), sabit dahil; değer altındaki satırda). Eğitim verisine dayanır. |
| Katsayı (std.) | 1 SS'lik artışın etkisi; açıklayıcılar arasında karşılaştırılabilir. Ceza nedeniyle yanlıdır. |
| Katsayı (ham) | Özgün birimde etki; tahmin denklemi için. |
| λ_min / λ_1SE | CV hatasının en küçüğü / bir SE kuralı; λ_1SE daha çok büzülmüş, daha sade bir model verir. |
| HKB, L-W, GCV | Klasik ölçütlerin önerdiği α; model bunlarla kurulmaz, yalnız bilgi verir. |
| VIF(ridge) | α'nın varyans şişmesini ne kadar giderdiği; 1'e yakın ya da altı çoklu bağıntının etkisinin kalktığını gösterir. |
| R^2_{\text{CV}} | Yeni hastalarda beklenen açıklama oranı; eğitim R^2'sinden küçüktür. |
| "Sıfırlandı" | Ridge'de anlamı yoktur; Lasso ile ortak tablodan gelir. |
Uyarı iletileri: "Çapraz-doğrulama ile seçilen α …" otomatik α'da her zaman; "… ızgaranın alt/üst ucunda" seçim uçtaysa (regularized_extras.py:162–171); "… özellik modelden çıkarıldı" sabit sütunda; "Olay kategorisi: 1 (referans: 0)" ikili hedefte.
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Hastalık ilerleme puanı 15 biyobelirteçten (r=0{,}63–0{,}78) ridge regresyonla modellendi (n = 200). Açıklayıcılar 1/n-standart sapmayla standartlaştırıldı ve ceza katsayısı birini-dışarıda-bırak çapraz doğrulamayla seçildi (\alpha = 76{,}55; etkili serbestlik derecesi 6,82). Model eğitim verisinde varyansın %79,1'ini açıkladı (R^2 = 0{,}791); α = 1'deki modelde beş katlı çapraz doğrulama R^2'si 0,755'ten α = 50'de 0,771'e yükseldi. En büyük standart katsayılar p03 (\beta = 1{,}38), p05 (\beta = 1{,}26) ve p07 (\beta = 1{,}09) için elde edildi; çoklu doğrusal bağıntı nedeniyle EKK'da negatif çıkan p02, p09 ve p15 katsayıları ridge çözümünde pozitifti.
52.8 Uzman soruları
S1. α hangi birimde? R'deki glmnet ile aynı mı?
Hayır. MerQur scikit-learn Ridge amacını kullanır: \text{RSS}+\alpha\lVert\boldsymbol\beta\rVert^2, 1/n-SS ile standart açıklayıcılarda. Bu, MASS::lm.ridge(lambda = α) ile birebir aynıdır (doğrulamada 10^{-14}). glmnet alpha = 0 ise \frac{1}{2n}\text{RSS}+\frac{\lambda}{2}\lVert\boldsymbol\beta\rVert^2'yi en küçükler ve Gauss ailesinde y'yi de içeride ölçekler; eşdeğerlik \lambda=\alpha/n ve y'nin 1/n-SS'si 1 iken kurulur. Korelasyon ölçeğindeki k ise \alpha/n'dir. Raporda α'nın hangi tanımla verildiği yazılmalıdır.
S2. LOO neden kapalı form "hat matrisi" kısayoluyla hesaplanmıyor?
Kısayol e_{(-i)}=e_i/(1-h_{ii}) standartlaştırmanın tam veriden yapıldığını varsayar. MerQur, glmnet ve ESL 7.10.2'deki ilke gereği (ön işleme de doğrulama içinde yapılmalı) her n-1'lik kümede ortalamayı ve SS'yi yeniden hesaplar. Bu kesin LOO'dur. Fark küçüktür ama sıfır değildir; n>3000'de MerQur hız için kısayola geçer ve bunu uyarıyla bildirir.
S3. CV hatası düz bir vadideyse λ_min neden en büyük α'yı seçiyor?
_curve_table eşitlikte en büyük λ'yı alır (glmnet getOptcv kuralı): aynı hatayı veren modeller arasında daha çok büzülmüş, dolayısıyla daha kararlı olanı tercih edilir. λ_1SE bu ilkeyi bir adım öteye taşır: en küçük hatanın bir SE'si içindeki en büyük α. Bu veride LOO'da λ_1SE = 398,6, df = 2,58'e karşılık gelir; CV hatası yalnız 2,4 birim (%8) artar.
S4. HKB ve L-W neden CV'den bu kadar farklı?
Üç ölçüt farklı soruları yanıtlar. HKB (20,1) ve L-W (3,6) EKK \hat\sigma^2 ve EKK katsayı büyüklüğünden kapalı formla türetilir ve ortalama karesel kestirim hatasını (katsayıların MSE'si) hedefler; CV ise tahmin hatasını en küçükler. Bu veride biyobelirteçlerin ortak bileşeni çok güçlü olduğundan tahmin için güçlü büzülme (α ≈ 77) karlıdır. HKB ve L-W yalnız Gauss modelde tanımlıdır.
S5. Ridge VIF'inin 1'in altına inmesi hata mı?
Değil. EKK'da \text{VIF}_j\ge1'dir çünkü [\mathbf R^{-1}]_{jj}\ge1. Ridge VIF'i (\mathbf R+k\mathbf I)^{-1}\mathbf R(\mathbf R+k\mathbf I)^{-1}'in köşegenidir; büzülme varyansı bağımsız açıklayıcılı EKK'nın da altına indirir. Marquardt (1970) VIF'leri 1–10 aralığına çeken k'yı önerir. Bu veride α = 50 (k=0{,}25) bütün VIF'leri 0,90–0,93'e indirir.
S6. Katsayılar için neden SH ve p değeri yok?
Ridge kestiricisinin varyansı \sigma^2(\mathbf Z^{\top}\mathbf Z+\alpha\mathbf I)^{-1}\mathbf Z^{\top}\mathbf Z(\mathbf Z^{\top}\mathbf Z+\alpha\mathbf I)^{-1} ile yazılabilir, ama kestirici yanlıdır ve yanlılık bilinmeyen \boldsymbol\beta'ya bağlıdır; bu varyansla kurulan Wald GA'sı doğru kapsama vermez. Üstelik α veriden seçildiğinde seçim belirsizliği de eklenir. MerQur bu yüzden yalnız nokta kestirimi verir; çıkarım isteniyorsa EKK (çoklu bağıntı ılımlıysa) ya da bootstrap kullanılmalıdır.
S7. Sabit hedef ya da tek açıklayıcı verilirse ne olur?
Hedef sabitse \text{TSS}=0 olur ve R^2 tanımsızdır; MerQur R^2=0 yazmak yerine açık bir hata iletisi verir. Tek açıklayıcıda ridge geçerlidir; df(\alpha)=d^2/(d^2+\alpha) tek terimdir ve ridge yalnız EKK eğimini n/(n+\alpha) katına küçültür. Sabit açıklayıcı modelden çıkarılır ve uyarılır. En az p+2 gözlem gerekir.
S8. Lojistik ridge'de α'nın anlamı Gauss'takiyle aynı mı?
Hayır. Cezalı GLM'de amaç -\ell+\frac{\alpha}{2}\lVert\boldsymbol\beta\rVert^2'dir; Gauss'ta \frac12 yoktur ve kayıp kareler toplamıdır. Bu nedenle iki ailede aynı sayısal α farklı büzülme demektir. Ayrıca CV eğrisi glmnet gibi kat içinde \alpha\,n_{\text{eğitim}}/n kullanır; Gauss ridge'inde de aynı kural geçerlidir. glmnet'le karşılaştırmada \lambda=\alpha/n eşlemesi doğrudur (doğrulamada 3\times10^{-7}).
S9. Kategorik açıklayıcıların kuklaları da standartlaştırılıyor mu?
Evet. Kuklalar sayısal sütun gibi 1/n-SS'leriyle bölünür ve cezalandırılır; glmnet'in varsayılanıyla aynıdır. Sonuç, referans düzeyin seçimine ve düzey sıklığına bağlıdır: seyrek düzeyin kuklası küçük SS'li olduğundan ham ölçekte daha az büzülür. Bunu istemeyen kullanıcı için grup cezası (group lasso) MerQur'da yoktur.
52.9 Sık hatalar ve tuzaklar
- Eğitim R^2'siyle α seçmek. R^2 α = 0'da en büyüktür; ceza her zaman eğitim uyumunu bozar. α ancak dışarıda bırakılmış hata ile seçilir.
- Varsayılan α = 1'i "önerilen" sanmak. α'nın birimi veriye bağlıdır; bu veride α = 1 neredeyse EKK'dır (df = 14,7). Otomatik α açılmalı ya da ridge izi incelenmelidir.
- Standart katsayıyı ham etki gibi okumak. "Katsayı (std.)" 1 SS'lik artışın etkisidir; klinik birimle yorum için "Katsayı (ham)" kullanılmalıdır.
- Ridge'den değişken seçimi beklemek. Hiçbir katsayı sıfırlanmaz; küçük katsayılı belirteç "önemsiz" ilan edilemez.
- İşaret değişimlerini yorumlamamak. Bu veride
p09EKK'da −0,79, ridge'de +0,15'tir. İlişkili açıklayıcılarda tek bir katsayının işareti kararsızdır; yorum ortak bileşen üzerinden yapılmalıdır. - Aynı α'yı iki menüde aynı sanmak. Ridge Regresyon menüsü ve Düzenlileştirilmiş Regresyon "Ridge (L2)" yöntemi aynı birimi kullanır; ama orada ElasticNet + L1 oranı 0 seçmek glmnet birimine geçer (α = 1 orada α = n demektir).
- Satır sırasına bağlı kat. k-kat CV katları karıştırılmamış ardışık bloklardır; veri tarih ya da merkez sırasına göre diziliyse CV iyimser ya da kötümser olabilir. Bu panelde karıştırma seçeneği yoktur (Bölüm 107'de vardır).
- LOO uyarısındaki "200-katlı" ifadesi. LOO, n katlı CV'dir; ayrı bir CV ayarı yapılmamıştır.
52.10 Kaynaklar
- Friedman, J., Hastie, T., & Tibshirani, R. (2010). Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software, 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
- Golub, G. H., Heath, M., & Wahba, G. (1979). Generalized cross-validation as a method for choosing a good ridge parameter. Technometrics, 21(2), 215–223. https://doi.org/10.1080/00401706.1979.10489751
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2. baskı). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Hoerl, A. E., & Kennard, R. W. (1970a). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- Hoerl, A. E., & Kennard, R. W. (1970b). Ridge regression: Applications to nonorthogonal problems. Technometrics, 12(1), 69–82. https://doi.org/10.1080/00401706.1970.10488635
- Hoerl, A. E., Kennard, R. W., & Baldwin, K. F. (1975). Ridge regression: Some simulations. Communications in Statistics, 4(2), 105–123. https://doi.org/10.1080/03610927508827232
- Lawless, J. F., & Wang, P. (1976). A simulation study of ridge and other regression estimators. Communications in Statistics – Theory and Methods, 5(4), 307–323. https://doi.org/10.1080/03610927608827353
- le Cessie, S., & van Houwelingen, J. C. (1992). Ridge estimators in logistic regression. Applied Statistics, 41(1), 191–201. https://doi.org/10.2307/2347628
- Marquardt, D. W. (1970). Generalized inverses, ridge regression, biased linear estimation, and nonlinear estimation. Technometrics, 12(3), 591–612. https://doi.org/10.1080/00401706.1970.10488699
- Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4. baskı). Springer. https://doi.org/10.1007/978-0-387-21706-2