80. Temel Bileşenler Analizi (PCA)
Analiz kimliği: pca · Menü adı: PCA · Panel: gui/panels/analyses/pca.py · Motor: ml/dimensionality.py, DimensionalityReduction.pca (satır 161–354); stats/sampling_adequacy.py (KMO, Bartlett); stats/rotation.py (varimax, promax)
80.1 Ne işe yarar
Temel bileşenler analizi (PCA), birbiriyle ilişkili p sayısal değişkeni, birbiriyle ilişkisiz ve varyansları azalan sırada olan p yeni değişkene, temel bileşenlere, dönüştürür. Cevapladığı soru şudur: "Bu değişkenlerdeki bilginin büyük kısmını kaç tane bileşik değişken taşıyor ve bu bileşenler hangi değişkenlerden oluşuyor?"
Model bir olasılık modeli değil, bir döndürmedir. Standartlaştırılmış veri matrisi \mathbf Z için
- \mathbf Z: n\times p matris; her sütun z_{ij}=(x_{ij}-\bar x_j)/s_j, s_j örneklem SS'si (n-1 bölenli).
- \mathbf R: p\times p korelasyon matrisi.
- \mathbf V=[\mathbf v_1,\dots,\mathbf v_p]: birim uzunluklu, birbirine dik özvektörler (bileşen katsayıları).
- \boldsymbol\Lambda=\operatorname{diag}(\lambda_1\ge\lambda_2\ge\dots\ge\lambda_p\ge0): özdeğerler; \lambda_k, k. bileşenin varyansıdır.
- \mathbf C: ham bileşen skorları; sütunları ilişkisizdir.
Neden özvektörler?
Birinci bileşen, \|\mathbf a\|=1 kısıtı altında \operatorname{Var}(\mathbf Z\mathbf a)=\mathbf a^{\top}\mathbf R\mathbf a'yı en büyükleyen doğrusal birleşimdir (Hotelling 1933). Lagrange çarpanıyla \mathbf R\mathbf a=\lambda\mathbf a bulunur; çözüm en büyük özdeğerin özvektörüdür ve en büyük varyans \lambda_1'dir. İkinci bileşen birinciye dik olma koşuluyla aynı problemi çözer ve ikinci özvektörü verir. Aynı çözüm, noktalara en küçük kareler anlamında en yakın k boyutlu alt uzaydır (Pearson 1901). İki tanım aynı yere varır.
Ne zaman kullanılır?
- Çok sayıda ilişkili sayısal değişkeni az sayıda bileşik puana indirmek (ör. bir risk indeksi kurmak).
- Regresyonda çoklu doğrusal bağıntıyı gidermek için ilişkisiz açıklayıcılar üretmek (bileşen regresyonu).
- Çok boyutlu veriyi iki ya da üç eksende görmek (skor grafiği, biplot).
Ne zaman kullanılmaz?
- Amaç gözlenen değişkenlerin ortak varyansını açıklayan gizil yapıları kestirmekse ve ölçme hatası modellenecekse: Açımlayıcı Faktör Analizi (EFA). PCA toplam varyansı ayrıştırır, hatayı ayrı tutmaz.
- Değişkenler kategorikse: Uyum Analizi (Correspondence) ya da çoklu uyum analizi.
- Önceden belirlenmiş bir faktör yapısı sınanacaksa: Doğrulayıcı Faktör Analizi (DFA).
- İki değişken kümesi arasındaki ilişki aranıyorsa: Kanonik Korelasyon (CCA).
- Doğrusal olmayan yapılar ve görselleştirme amaçlanıyorsa: t-SNE ya da UMAP (bunlar mesafe korur, bileşen yorumu vermez).
Sık karıştırılan analizler. PCA ile faktör analizi en sık karıştırılan ikilidir: PCA'da bileşen değişkenlerin tam doğrusal birleşimidir ve köşegende 1 bulunan \mathbf R ayrıştırılır; faktör analizinde köşegene ortak varyans kestirimleri konur ve faktörler ölçme hatasından arındırılmış gizil değişkenlerdir. Döndürme her ikisinde de uygulanabilir, ama döndürülmüş PCA bileşenleri artık "en büyük varyans" sıralamasına sahip değildir. MDS ve uyum analizi de boyut indirir; MDS uzaklık matrisinden, uyum analizi çapraz tablodan başlar.
80.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Sayısal değişkenler | Her sütun aralık/oran ölçeğinde. | Sayıya çevrilemeyen sütunlar ve Veri sekmesinde 3+ düzeyli "kategorik" işaretli sütunlar çıkarılır ve bildirilir (_preprocessing.py:216–246). |
| Doğrusal ilişki | Bileşenler doğrusal birleşimdir; korelasyon matrisi bilgiyi taşır. | Denetlenmez. |
| Yeterli ilişki | Değişkenler arasında anlamlı korelasyon yoksa indirgeme kazanç sağlamaz. | Bartlett küresellik testi ve KMO; n>p ise her çalıştırmada (dimensionality.py:269–280). |
| Ölçek | Korelasyon PCA'sı ölçekten bağımsızdır; kovaryans PCA'sında büyük varyanslı değişken baskın çıkar. | "Kovaryans matrisi PCA'sı" kutusu (varsayılan kapalı). |
| Uç değerler | Korelasyonlar uç değerlere duyarlıdır. | Denetlenmez. |
Normallik gerekmez: PCA betimsel bir dönüşümdür. Bartlett testi ise çok değişkenli normallik altında türetilmiştir.
Eksik değer. Panelin "Eksik Veri" seçicisi (stats_panel.py:1721–1731): Sil (listwise, varsayılan), ortalama, medyan ya da KNN ile doldurma. Seçim prepare_numeric_data içinde uygulanır; tamamen boş, sabit ya da sayıya çevrilemeyen sütunlar önce çıkarılır ve sonuç metninin başında "Analizden çıkarılan sütun(lar)" uyarısıyla yazılır (pca.py:227–230).
Uç durumlar.
- En az 2 değişken ve en az 3 satır gerekir (
dimensionality.py:201–202,stats_panel.py:7801–7803). - Bileşen sayısı \min(p,\,n-1) ile sınırlanır ve en az 2 tutulur (
dimensionality.py:213, 240). Bir ölçüt 1 bileşen önerse bile tablo ve grafik için 2 bileşen hesaplanır; sonuç metni bunu "önerilen k = 1 (tutulan: 2; grafik/tablo için en az 2)" diye yazar. - n\le p ise korelasyon matrisi tekildir; PCA yine çalışır ama KMO ve Bartlett atlanır (
dimensionality.py:271). - Korelasyon matrisi pozitif tanımlı değilse KMO tanımsızdır ve "—" basılır (
sampling_adequacy.py:32–35).
80.3 Parametreler
Varsayılanlar pca.py:56–159 ve motorun imzasından (dimensionality.py:161–177) alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Değişkenler | en az 2 sayısal | PCA'ya girecek sütunlar. | p, \mathbf R ve tüm sonuçlar. |
| Bileşen sayısı | \min(5,\ \text{seçilebilir sayısal sütun sayısı}) | "Elle" kuralında tutulacak bileşen sayısı; 2 ile seçili değişken sayısı arasında. | Tablo sütunları, skorlar, döndürme. Özdeğerler değişmez. |
| Eksik Veri | Sil (listwise) | Eksik değer işleme. | n ve korelasyonlar. |
| Bileşen sayısı ölçütü | Elle (yukarıdaki sayı) | Kaiser (özdeğer > 1), kümülatif varyans hedefi, paralel analiz (Horn). | Tutulan bileşen sayısı; "Tüm özdeğerler" bloğu basılır. |
| Paralel analiz ölçütü | %95 nicelik (Glorfeld) | Rastgele veri eşiği: %95 nicelik ya da ortalama (Horn). | Yalnız paralel analizde önerilen k. |
| Varyans hedefi (%) | 80 | Kümülatif açıklanan varyansın ulaşması gereken oran. | Yalnız varyans hedefi kuralında. |
| Bileşen skorlarını veri setine kaydet | kapalı | Standart skorlar (ort. 0, SS 1) PCA_PC1… sütunları. |
Veri setine yeni sütunlar. |
| Döndürme | Yok | Varimax ya da Promax (m=4), Kaiser normalleştirmeli. | Yükler, skorlar, grafik; özdeğerler değişmez. |
| Kovaryans matrisi PCA'sı | kapalı | Standartlaştırmadan, yalnız merkezleyerek. | Özdeğerler, yükler, Kaiser eşiği; KMO/Bartlett değişmez. |
| Ortak varyans (h²) + değişken MSA | kapalı | Tutulan bileşenlerle açıklanan değişken varyansı ve değişken bazlı MSA. | Ek blok. |
| Grafik | Scree (varsayılan) | Biplot, yük düzlemi, skorlar, 3B skor/yük/biplot. | Yalnız Grafik sekmesi. |
Döndürme açıkken tutulan bileşen sayısı neden önemli?
Varimax ve promax yalnız tutulan bileşenleri döndürür. Bu veride Kaiser ve paralel analiz 1 bileşen önerir, MerQur ise en az 2 tutar; döndürme bu iki bileşen arasında varyansı yeniden dağıtır. İkinci bileşenin özdeğeri 0,155 iken varimax sonrası ikinci döndürülmüş bileşen 2,21 birim varyans taşır (80.6). Döndürme, "gürültü" bileşenini anlamlı görünen bir boyuta dönüştürebilir; MerQur bu durumda döndürme bloğunda "seçilen ölçüt tek bileşen öneriyor; döndürülmüş çözümü yorumlamayın" uyarısını yazar. Döndürmeden önce bileşen sayısı ayrıca gerekçelendirilmelidir.
Koddaki tercih: tohum
Paralel analiz np.random.default_rng(seed) ile 100 benzetim yapar (dimensionality.py:227–234). Panel execute() çağrısına tohum geçirmez (stats_panel.py:7806–7812); motor varsayılanı 42 kullanılır. Bu yüzden arayüzde tohum (seed) kutusu yoktur ve ipucu metni "100 tekrar, tohum 42" der. Aynı veri her zaman aynı paralel analiz eşiklerini verir.
80.4 Tıp örneği
Dosya: english/datasets/Tip/69_pca_clinical_6ozellik.xlsx (Türkçe kopya: samples/Tum_Analiz_Tip/69_pca_klinik_6ozellik.xlsx). Değişkenler VIDEO_SCRIPT_TR.txt #69 bölümünden alınmıştır.
| Değişken | Rol | Tür | Ortalama | SS |
|---|---|---|---|---|
age |
gösterge | sürekli (yıl) | 59,044 | 12,556 |
BMI |
gösterge | sürekli (kg/m²) | 27,947 | 4,006 |
systolic_bp |
gösterge | sürekli (mmHg) | 134,606 | 18,320 |
glucose |
gösterge | sürekli (mg/dL) | 110,256 | 31,145 |
cholesterol |
gösterge | sürekli (mg/dL) | 209,617 | 35,223 |
HbA1c |
gösterge | sürekli (%) | 6,953 | 1,011 |
n ve eksik değer: 180 hasta, hiçbir sütunda eksik değer yok; patient_id analize alınmaz.
Klinik soru: Altı kardiyometabolik gösterge tek bir "genel risk" boyutunda mı toplanıyor, yoksa ayrı boyutlar var mı?
Seçilen ayarlar: Arayüz varsayılanları (elle 5 bileşen, döndürme yok). Hesap yürüyüşü için ayrıca Kaiser, varyans hedefi, paralel analiz (iki ölçüt), 2 bileşenle varimax ve promax, kovaryans PCA'sı çalıştırılmıştır.
80.5 Formüller ve hesap adımları
MerQur'un hesap sırası: (1) veri hazırlama ve eksik değer işleme; (2) korelasyon (ya da kovaryans) matrisinin tüm özdeğerleri; (3) seçilmişse bileşen sayısı ölçütü; (4) scikit-learn PCA ile tutulan bileşenlerin katsayıları ve varyans oranları; (5) özdeğer, yük ve standart skor; (6) KMO, MSA ve Bartlett; (7) seçilmişse döndürme ve ortak varyanslar.
80.5.1 Standartlaştırma ve korelasyon matrisi
- \bar x_j, s_j: j. değişkenin ortalaması ve n-1 bölenli SS'si.
- r_{jl}: Pearson korelasyonu; r_{jj}=1 olduğundan \operatorname{iz}(\mathbf R)=p.
Koddaki tercih: iki ayrı standartlaştırma
Motor StandardScaler ile n bölenli standartlaştırma yapar (dimensionality.py:205–206) ve bunu scikit-learn PCA'ya verir. Korelasyon matrisi ölçek çarpanından etkilenmediği için özvektörler ve varyans oranları n ya da n-1 seçiminden bağımsızdır. Özdeğerler ise scikit-learn'ün explained_variance_ değerinden değil, \lambda_k=p\cdot(\text{varyans oranı})_k ilişkisinden alınır (dimensionality.py:252–253); explained_variance_ n bölenli veride n/(n-1) kadar şişkin olurdu. Standart skorlar ise n-1 bölenli z ile ayrıca hesaplanır (dimensionality.py:281–284). Sonuç R prcomp(scale. = TRUE) ile aynıdır.
80.5.2 Özayrışım, varyans oranı ve bileşen sayısı ölçütleri
- \mathbf v_k: k. özvektör, \mathbf v_k^{\top}\mathbf v_k=1, \mathbf v_k^{\top}\mathbf v_l=0 (k\ne l).
- Tüm özdeğerler
numpy.linalg.eigvalsh(np.corrcoef(...))ile bulunur (dimensionality.py:216–217); tutulan bileşenlerin katsayıları scikit-learnPCA(tam SVD) ile gelir (dimensionality.py:242–261).
Üç otomatik ölçüt (dimensionality.py:220–237):
- h: varyans hedefi (varsayılan 0,80); kod \text{kümülatif}\ge h-10^{-12} eşitsizliğini arar.
- e_k: paralel analiz eşiği. B=100 kez n\times p boyutlu bağımsız standart normal veri üretilir, her birinin korelasyon matrisinin sıralı özdeğerleri alınır; e_k bu 100 değerin %95 niceliği (varsayılan,
np.quantiledoğrusal ara değer, R tür 7) ya da ortalamasıdır. - k_{\text{PA}}: gözlenen özdeğerin eşiği ardışık olarak aştığı bileşen sayısıdır; ilk aşamayan bileşende sayım durur (
np.argmin(above)). - Kovaryans PCA'sında Kaiser eşiği 1 değil, ortalama özdeğerdir (Jolliffe 2002).
Neden paralel analiz ve neden %95 nicelik?
Tamamen ilişkisiz değişkenlerde bile örneklem korelasyonları sıfır olmadığından ilk özdeğerler 1'in üstüne çıkar; Kaiser ölçütü bu yüzden fazla bileşen tutma eğilimindedir (Zwick ve Velicer 1986). Horn (1965) gözlenen özdeğeri, aynı boyuttaki rastgele verinin özdeğeriyle karşılaştırır. Ortalama eşik yine biraz fazla bileşen tutar; Glorfeld (1995) %95 niceliği önermiştir. psych::fa.parallel(quant = .95) aynı ölçütü kullanır.
80.5.3 Yükler ve katsayılar
- \ell_{jk}: yük (loading); korelasyon PCA'sında j. değişken ile k. bileşenin korelasyonudur.
- v_{jk}: katsayı (birim özvektör öğesi); tabloda "PCk (katsayı)" sütunları.
- Satır kareler toplamı (tüm bileşenlerde) 1, sütun kareler toplamı özdeğerdir.
Koddaki tercih: işaret
Bir özvektör -\mathbf v_k de özvektördür; işaret keyfidir. MerQur scikit-learn'ün svd_flip kuralını devralır: her bileşende mutlak değerce en büyük katsayı pozitif olur. R prcomp farklı işaret verebilir; bu durumda o bileşenin tüm yük ve skorlarının işareti birlikte değişir, yorum değişmez. Doğrulamada işaretler aynı kuralla hizalanmıştır.
80.5.4 Standart bileşen skorları
- \mathbf z_i: i. kişinin n-1 bölenli z puanları vektörü.
- f_{ik}: kaydedilen ve biplot/skor grafiğinde çizilen standart skor (
psych::principalskorları). - Kovaryans PCA'sında \mathbf z_i yerine merkezlenmiş \mathbf x_i-\bar{\mathbf x} kullanılır (
dimensionality.py:287–290); skorların SS'si yine 1'dir.
80.5.5 Örneklem yeterliliği: KMO, MSA ve Bartlett
- q_{jl}: diğer tüm değişkenler sabitken j ile l arasındaki kısmi korelasyon (anti-imaj korelasyonunun eksi işaretlisi).
- KMO (Kaiser 1974): kısmi korelasyonlar sıradan korelasyonlara göre küçükse 1'e yaklaşır; ortak yapı güçlüdür.
- \text{MSA}_j: aynı oranın tek değişken için hesabı.
- |\mathbf R|: korelasyon matrisinin determinantı, =\prod_k\lambda_k. Değişkenler ilişkisizse \mathbf R=\mathbf I ve |\mathbf R|=1.
- H_0: anakütle korelasyon matrisi birim matristir (Bartlett 1950).
Neden iki ölçü?
Bartlett testi "ilişki hiç yok mu?" sorusunu sınar ve n büyüdükçe neredeyse her zaman reddedilir; KMO ise ilişkinin ortak bir yapıdan mı, yoksa değişken çiftlerine özgü bağlardan mı geldiğini ölçer (Dziuban ve Shirkey 1974). PCA için Bartlett'in reddedilmesi gerekli, KMO'nun yüksek olması ise yararlıdır. MerQur KMO'yu Kaiser'in ölçeğiyle etiketler (≥ 0,90 mükemmel, ≥ 0,80 çok iyi, ≥ 0,70 iyi, ≥ 0,60 orta, ≥ 0,50 zayıf; sampling_adequacy.py:75–87) ve KMO < 0,60 ya da Bartlett p\ge0{,}05 ise uyarır.
Koddaki tercih: KMO ve Bartlett her zaman korelasyon matrisinden
Kovaryans PCA'sı seçilse de KMO ve Bartlett standartlaştırılmış veriden hesaplanır (dimensionality.py:276–278). İkisi de ölçekten bağımsız olduğundan doğru tercihtir. Bartlett p değeri sağ kuyruk fonksiyonuyla (chi2.sf) hesaplanır (sampling_adequacy.py:71); \chi^2 çok büyükse değer çift duyarlıklı sayının en küçük değerinin altında kalır ve 0 saklanır (bu veride gerçek değer e^{-860{,}8}). Metin "p < .001" yazdığı için görünen sonuç etkilenmez.
80.5.6 Ortak varyans
m tutulan bileşen sayısıdır. h_j^2, j. değişkenin varyansının tutulan bileşenlerce açıklanan payıdır; dik döndürmede değişmez (dimensionality.py:350–353).
80.5.7 Döndürme: varimax ve promax
Varimax (Kaiser 1958), Kaiser normalleştirmeli yükler a_{jk}=\ell_{jk}/h_j üzerinde dik bir \mathbf T arar:
- Ölçüt, her sütundaki kare yüklerin varyansıdır; yükleri 0'a ya da \pm1'e iterek "basit yapı" üretir.
- Kaiser normalleştirmesi, ortak varyansı büyük değişkenlerin döndürmeye baskın çıkmasını önler; döndürmeden sonra satırlar h_j ile geri ölçeklenir.
Koddaki tercih: SVD yinelemesi ve durma ölçütü
Algoritma stats/rotation.py:31–53: her adımda \mathbf G=\mathbf A^{\top}\big(\mathbf B^{\circ3}-\mathbf B\operatorname{diag}(\mathbf 1^{\top}\mathbf B^{\circ2})/p\big)'nin SVD'si \mathbf U\mathbf D\mathbf W^{\top} alınır ve \mathbf T=\mathbf U\mathbf W^{\top} olur; tekil değerler toplamı d göreli olarak 10^{-14}'ten az artınca durulur (en çok 100000 yineleme; rotation.py:26–27). R stats::varimax aynı algoritmadır ama en çok 1000 yineleme yapar; ölçütün düz olduğu verilerde yakınsamadan durabilir (80.8, S7). Promax rotation.py:56–75: hedef Q_{jk}=\tilde b_{jk}\,|\tilde b_{jk}|^{3} (işaretli dördüncü kuvvet), burada \tilde b_{jk} varimax yüklerinin satır normalleştirilmiş hâlidir; \mathbf U en küçük karelerle \mathbf L_v\mathbf U\approx\mathbf Q çözümüdür, sütunları \operatorname{diag}\big((\mathbf U^{\top}\mathbf U)^{-1}\big)^{1/2} ile ölçeklenir. Bileşen korelasyonları \boldsymbol\Phi=(\mathbf T_m^{\top}\mathbf T_m)^{-1}, \mathbf T_m=\mathbf T_v\mathbf U. Yaygın istatistik yazılımlarının promax tanımı budur; R stats::promax hedefi normalleştirmez ve farklı sonuç verir.
Döndürme seçiliyse kaydedilen ve çizilen skorlar da döndürülür: \mathbf F_{\text{rot}}=\mathbf F(\mathbf T^{\top})^{-1}; dik döndürmede bu \mathbf F\mathbf T'dir (dimensionality.py:346–348).
80.5.8 Kovaryans PCA'sı
- \ell_{jk}: değişkenin biriminde değişken–bileşen kovaryansı.
- \ell^{*}_{jk}: standartlaştırılmış yük, yani değişken–bileşen korelasyonu; sonuç metnindeki |\ell|\ge0{,}30 ve 0{,}50 eşikleri buna uygulanır (
dimensionality.py:325–328,pca.py:313–315). - Varyans oranı \lambda_k/\sum_l\lambda_l'dir.
80.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/pca/elle_hesap.py ile, MerQur ve scikit-learn çağrılmadan numpy ile hesaplanmıştır.
Adım 1 — Korelasyon matrisi.
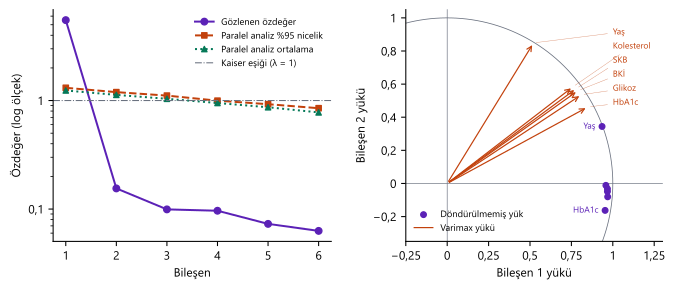
Sıra: yaş, BKİ, SKB, glikoz, kolesterol, HbA1c. Köşegen dışı korelasyonların ortalaması 0,9025'tir: altı gösterge neredeyse tek bir boyutta toplanır.
Adım 2 — Özdeğerler. \lambda=(5{,}513391;\ 0{,}154943;\ 0{,}099286;\ 0{,}096479;\ 0{,}072995;\ 0{,}062907), toplamları \operatorname{iz}(\mathbf R)=6. Varyans oranları %91,89; %2,58; %1,65; %1,61; %1,22; %1,05.
Adım 3 — Birinci özvektör ve yükler.
Denetim: \mathbf R\mathbf v_1=(2{,}195592;\ 2{,}271877;\ \dots)^{\top}=5{,}513391\,\mathbf v_1. Yükler \ell_{j1}=v_{j1}\sqrt{5{,}513391}=2{,}348061\,v_{j1}:
| Değişken | v_{j1} | \ell_{j1} | v_{j2} | \ell_{j2} |
|---|---|---|---|---|
| yaş | 0,398229 | 0,935066 | 0,874557 | 0,344250 |
| BKİ | 0,412065 | 0,967555 | −0,123052 | −0,048437 |
| SKB | 0,412071 | 0,967569 | −0,081498 | −0,032080 |
| glikoz | 0,412687 | 0,969014 | −0,204586 | −0,080531 |
| kolesterol | 0,408147 | 0,958355 | −0,028866 | −0,011363 |
| HbA1c | 0,406101 | 0,953551 | −0,413132 | −0,162620 |
Birinci bileşen altı göstergenin neredeyse eşit ağırlıklı ortalamasıdır (genel risk boyutu). İkinci bileşen, yaşı (pozitif) HbA1c ve glikozdan (negatif) ayırır; ama yalnız 0,155 birim varyans taşır.
Adım 4 — Bir hastanın skoru. 1 numaralı hasta: yaş 84, BKİ 36,07, SKB 179, glikoz 174, kolesterol 272, HbA1c 8,71. z puanları (1{,}9875;\ 2{,}0278;\ 2{,}4233;\ 2{,}0467;\ 1{,}7711;\ 1{,}7376).
Hasta her göstergede ortalamanın yaklaşık 2 SS üstündedir; birinci bileşen skoru da +2,09'dur.
Adım 5 — KMO ve Bartlett. Köşegen dışı \sum r_{jl}^2=24{,}449934, \sum q_{jl}^2=1{,}267423:
Değişken MSA'ları 0,9358 (glikoz) ile 0,9678 (yaş) arasındadır. |\mathbf R|=\prod\lambda_k=3{,}757523\times10^{-5}, \ln|\mathbf R|=-10{,}189166:
\ln p=-860{,}83; p pratikte sıfırdır.
Adım 6 — Bileşen sayısı ölçütleri. Kaiser: yalnız \lambda_1>1, k=1. Varyans hedefi: kümülatif oran ilk bileşende 0,9189 ≥ 0,80, k=1. Paralel analiz (100 benzetim, tohum 42):
| Bileşen | \lambda_k | Ortalama eşik | %95 eşik | \lambda_k>e_k? |
|---|---|---|---|---|
| 1 | 5,5134 | 1,2388 | 1,3109 | evet |
| 2 | 0,1549 | 1,1280 | 1,1958 | hayır |
| 3 | 0,0993 | 1,0382 | 1,1110 | hayır |
| 4 | 0,0965 | 0,9496 | 0,9978 | hayır |
| 5 | 0,0730 | 0,8679 | 0,9261 | hayır |
| 6 | 0,0629 | 0,7776 | 0,8502 | hayır |
Üç ölçüt de k=1 önerir; MerQur tablo ve grafik için 2 bileşen tutar.
Şekil 80.1. Sol: gözlenen özdeğerler (log ölçek), Kaiser eşiği ve paralel analiz eşikleri; yalnız ilk bileşen eşiklerin üstündedir. Sağ: PC1–PC2 yük düzlemi; noktalar döndürülmemiş yükler, oklar varimax yükleri.
Adım 7 — Varimax (2 bileşen). Satır normları h_j=\sqrt{\ell_{j1}^2+\ell_{j2}^2} (yaş için 0,996422). İki bileşende varimax açısının kapalı çözümü vardır (Kaiser 1958): \tan4\varphi=(D-2AB/p)/(C-(A^2-B^2)/p), u_j=a_{j1}^2-a_{j2}^2, v_j=2a_{j1}a_{j2}, A=\sum u, B=\sum v, C=\sum(u^2-v^2), D=2\sum uv. Bu veride \varphi=38{,}2289°:
Döndürülmüş yükler: yaş (0,5215; 0,8490), BKİ (0,7900; 0,5607), SKB (0,7799; 0,5735), glikoz (0,8110; 0,5364), kolesterol (0,7599; 0,5841), HbA1c (0,8497; 0,4623). Yük kareleri toplamları 3,4615 ve 2,2068; toplamları 5{,}5134+0{,}1549=5{,}6683 değişmez. Ortak varyanslar h_j^2 0,9186 (kolesterol) ile 0,9929 (yaş) arasındadır.
Adım 8 — Promax(4). Desen yükleri: yaş (0,1055; 0,9071), HbA1c (0,9534; 0,0166) ve diğerleri birinci bileşende 0,71–0,83. Bileşen korelasyonu \Phi_{12}=0{,}8308: iki "boyut" neredeyse aynı şeyi ölçer. Bu, tek boyutlu bir yapının zorla ikiye bölündüğünün işaretidir.
Adım 9 — Kovaryans PCA'sı. Özdeğerler (2562{,}76;\ 98{,}30;\ 34{,}94;\ 23{,}35;\ 1{,}50;\ 0{,}13), ortalama özdeğer 453,50; birinci bileşen varyansın %94,19'unu taşır. Yüklerde kolesterol (34,50) ve glikoz (30,32) baskındır, çünkü varyansları en büyüktür; HbA1c'nin yükü yalnız 0,94'tür. Standartlaştırılmış yükler (0,91–0,98) ise korelasyon PCA'sına yakındır.
80.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan alınmıştır; ml.dimensionality içindeki yerleşik round yalnız bellekte etkisizleştirilmiştir (özdeğer, oran, KMO). Yük, katsayı ve döndürülmüş yükler motor içinde DataFrame.round(6) ile saklandığı için 6 ondalıkta karşılaştırılmıştır. R: prcomp, psych::principal, psych::KMO, psych::cortest.bartlett, varimax için GPArotation::Varimax (eps 10^{-14}), promax normalleştirilmiş hedef tanımıyla elle; paralel analiz için psych::fa.parallel (kendi benzetimi; yalnız önerilen k karşılaştırılır). Python sütunundaki paralel analiz eşikleri aynı numpy üreteci ve tohumla bağımsız olarak üretilmiştir. Varimax için Python başvurusu iki bileşenli kapalı çözümdür.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Özdeğerler (korelasyon matrisi, 6) | 5,513391 | 5,513391 | 5,513391 | 2,7e−15 | ✓ |
| Tutulan özdeğerler λ = p·varyans oranı (5) | 5,513391 | 5,513391 | 5,513391 | 2,7e−15 | ✓ |
| Açıklanan varyans oranı (5) | 0,918898 | 0,918898 | 0,918898 | 3,3e−16 | ✓ |
| Kümülatif varyans oranı (5) | 0,918898 | 0,918898 | 0,918898 | 3,3e−16 | ✓ |
| Birim özvektörler / katsayı (6 × 5) | 0,398229 | 0,398229 | 0,398229 | 5,0e−07 | ✓ (6 ondalık) |
| Yükler = özvektör·√λ (6 × 5) | 0,935066 | 0,935066 | 0,935066 | 4,9e−07 | ✓ (6 ondalık) |
| Yükler, R: psych::principal (6 × 2) | 0,935066 | 0,935066 | 0,935066 | 4,9e−07 | ✓ (6 ondalık) |
| Standart bileşen skorları (180 × 5) | 2,086331 | 2,086331 | 2,086331 | 7,3e−13 | ✓ |
| KMO (genel) | 0,950717 | 0,950717 | 0,950717 | 3,3e−16 | ✓ |
| Değişken MSA (6) | 0,967786 | 0,967786 | 0,967786 | 7,8e−16 | ✓ |
| Bartlett χ² | 1794,991330 | 1794,991330 | 1794,991330 | 6,8e−12 | ✓ |
| Bartlett sd | 15 | 15 | 15 | 0,0e+00 | ✓ |
| Kaiser ölçütü: önerilen k | 1 | 1 | 1 | 0,0e+00 | ✓ |
| Varyans hedefi %80: önerilen k | 1 | 1 | 1 | 0,0e+00 | ✓ |
| Paralel analiz (q95): önerilen k | 1 | 1 | 1 | 0,0e+00 | ✓ (R: psych, kendi benzetimi) |
| Paralel analiz (ortalama): önerilen k | 1 | 1 | — | 0,0e+00 | ✓ |
| Paralel analiz: benzetim ortalaması (6) | 1,238779 | 1,238779 | — | 0,0e+00 | ✓ (Python: aynı üreteç ve tohum) |
| Paralel analiz: %95 nicelik (6) | 1,310937 | 1,310937 | — | 0,0e+00 | ✓ (Python: aynı üreteç ve tohum) |
| Varimax yükleri (6 × 2) | 0,521513 | 0,521513 | 0,521513 | 6,2e−07 | ✓ (6 ondalık) |
| Varimax döndürme matrisi T (2 × 2) | 0,785545 | 0,785545 | 0,785545 | 2,0e−07 | ✓ |
| Varimax sonrası yük kareleri toplamı (2) | 3,461541 | 3,461539 | 3,461539 | 1,7e−06 | ✓ (6 ondalık) |
| Ortak varyans h², 2 bileşen (6) | 0,992856 | 0,992856 | 0,992856 | 1,7e−14 | ✓ |
| Varimax standart skorları (180 × 2) | 1,476218 | 1,476217 | — | 7,2e−07 | ✓ |
| Promax(4) desen yükleri (6 × 2) | 0,105459 | 0,105459 | 0,105459 | 6,2e−07 | ✓ (6 ondalık) |
| Promax bileşen korelasyonu Φ₁₂ | 0,830840 | 0,830840 | 0,830840 | 1,6e−09 | ✓ |
| Promax standart skorları (180 × 2) | 2,006507 | 2,006507 | — | 2,9e−07 | ✓ |
| Kovaryans PCA: özdeğerler (6) | 2562,755600 | 2562,755600 | 2562,755600 | 4,1e−12 | ✓ |
| Kovaryans PCA: varyans oranı (5) | 0,941851 | 0,941851 | 0,941851 | 1,0e−15 | ✓ |
| Kovaryans PCA: yükler (6 × 5) | 11,462854 | 11,462854 | 11,462854 | 4,7e−07 | ✓ (6 ondalık) |
| Kovaryans PCA: standartlaştırılmış yükler (6 × 5) | 0,912943 | 0,912943 | 0,912943 | 4,2e−07 | ✓ (6 ondalık) |
| Kovaryans PCA: standart skorlar (180 × 5) | 2,021574 | 2,021574 | — | 5,4e−14 | ✓ |
| Kovaryans PCA: Kaiser (ortalama özdeğer) k | 1 | 1 | 1 | 0,0e+00 | ✓ |
Toplam 32 satır; eşleşmeyen: 0.
Varimax yük kareleri toplamında MerQur ile kapalı çözüm arasındaki 1{,}7\times10^{-6} fark, SVD yinelemesinin durma ölçütünden gelir (80.8, S7); göreli olarak 5\times10^{-7}'dir.
80.7 Çıktıyı okuma
Sonuç metni (varsayılan ayarlar, kısaltılmış):
── ÖRNEKLEM YETERLİLİĞİ (PCA ön şartları) ──
  KMO (Kaiser-Meyer-Olkin) = 0.951  (mükemmel)
  Bartlett küresellik testi: χ² = 1794.99, df = 15, p < .001  (PCA için uygun)

Açıklanan varyans (%): PC1: 91.9, PC2: 2.6, PC3: 1.7, PC4: 1.6, PC5: 1.2
Özdeğerler (korelasyon matrisi): PC1: 5.513, PC2: 0.155, PC3: 0.099, PC4: 0.096, PC5: 0.073
Yük (loading) = özvektör × √özdeğer = değişken–bileşen korelasyonu. ...

DEĞİŞKEN-BİLEŞEN EŞLEŞTİRMESİ (|yük| ≥ 0.30; * = |yük| ≥ 0.50 güçlü; önemli PC'ler):
  PC1 (varyans %91.9) — 6 değişken:
    (+) glucose (+0.97)*, systolic_bp (+0.97)*, BMI (+0.97)*, cholesterol (+0.96)*, HbA1c (+0.95)*, age (+0.94)*
Paralel analiz kuralı seçildiğinde araya şu blok girer:
Bileşen sayısı ölçütü: Paralel analiz (Horn) → önerilen k = 1 (tutulan: 2; grafik/tablo için en az 2)
  Tüm özdeğerler (korelasyon matrisi):
    PC1: λ = 5.5134   %91.9  kümülatif  %91.9   PA ort. = 1.2388, q95 = 1.3109  ✓
    PC2: λ = 0.1549    %2.6  kümülatif  %94.5   PA ort. = 1.1280, q95 = 1.1958
Aynı ölçütle varimax seçilirse döndürme bloğu uyarıyla başlar (yükler ve yük kareleri toplamı 2 bileşenli elle çözümle aynıdır):
── Döndürülmüş bileşen yükleri (varimax, Kaiser normalleştirmeli) ──
  ⚠ Seçilen ölçüt tek bileşen öneriyor; döndürme için en az 2 bileşen tutuldu. Döndürme ikinci
    bileşene varyans dağıtır ve tek boyutlu yapıyı iki bileşenli gösterir; döndürülmüş çözümü
    yorumlamayın.
                  PC1     PC2
  age          0.5215  0.8490
  ...
  Döndürme sonrası yük kareleri toplamı: PC1 = 3.4615, PC2 = 2.2068
Tablo sekmesi: satırlar değişkenler + "Özdeğer" + "Açıklanan varyans (%)"; sütunlar PCk (yük) ve PCk (katsayı), 4 ondalık.
| Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| KMO | 0,951 (mükemmel) | Ortak yapı çok güçlü; < 0,60 ise uyarı basılır (pca.py:265–266). |
| Bartlett | \chi^2(15)=1794{,}99, p<0{,}001 | Korelasyon matrisi birim matris değil; p\ge0{,}05 ise uyarı (pca.py:267–268). |
| Açıklanan varyans | PC1 %91,9 | Tek bileşen bilginin büyük kısmını taşır. |
| Özdeğerler | 5,513; 0,155; … | Yalnız tutulan bileşenler; tümü için bir ölçüt kuralı seçin. |
| Değişken-bileşen eşleştirmesi | |\ell|\ge0{,}30 olanlar, \ge0{,}50 "*" | Yalnız "önemli" bileşenler listelenir: varyans payı ≥ %5 ya da kümülatif ≤ %90 (pca.py:319–327). Bu veride PC2 (%2,6, kümülatif %94,5) listelenmez. |
| "(+) … (−) …" ve "Kontrast" | Aynı bileşende zıt işaretli değişkenler | Bileşen bir grubun yüksek, diğerinin düşük olduğu bir karşıtlığı temsil eder. |
| Döndürülmüş yükler | Kaiser normalleştirmeli | Döndürmede bileşen varyansları yük kareleri toplamıyla okunur; özdeğer satırı döndürülmemiş çözüme aittir. |
| Bileşen korelasyonları (promax) | \Phi | 0,8'in üstü bileşenlerin ayrışmadığını gösterir. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Altı kardiyometabolik gösterge (yaş, BKİ, sistolik kan basıncı, glikoz, kolesterol, HbA1c) korelasyon matrisi üzerinden temel bileşenler analizine alındı (n=180). Örneklem yeterliliği mükemmeldi, KMO =0{,}95; Bartlett küresellik testi anlamlıydı, \chi^2(15)=1794{,}99, p<0{,}001. Kaiser ölçütü ve paralel analiz (%95 nicelik) tek bileşen önerdi; birinci bileşen toplam varyansın %91,9'unu açıkladı (özdeğer =5{,}51) ve tüm göstergeler bu bileşene güçlü yük verdi (0,94–0,97).
80.8 Uzman soruları
S1. Özdeğerler neden scikit-learn'ün `explained_variance_` değeri değil?
StandardScaler n bölenli SS kullanır; standartlaştırılmış sütunların n-1 bölenli varyansı n/(n-1) olur ve scikit-learn'ün explained_variance_ özdeğerleri bu kadar şişirir. MerQur özdeğeri \lambda_k=p\times\text{varyans oranı}_k ile hesaplar (dimensionality.py:252–253); oran ölçekten bağımsız olduğu için sonuç korelasyon matrisinin tam özdeğeridir ve R prcomp ile aynıdır. Kovaryans PCA'sında explained_variance_ zaten n-1 bölenlidir ve doğrudan kullanılır.
S2. Yük ile katsayı arasındaki fark nedir? Hangisi raporlanır?
Katsayı birim özvektör öğesidir (prcomp $rotation, scikit-learn components_); yük katsayının \sqrt{\lambda_k} katıdır ve korelasyon PCA'sında değişken–bileşen korelasyonudur (psych::principal). Yorum ve |\ell|\ge0{,}30 gibi eşikler yük üzerinden yapılır. Skor hesabında ise katsayı kullanılır: f=\mathbf z^{\top}\mathbf v/\sqrt\lambda.
S3. Kaiser 1 bileşen önerdiği hâlde neden iki bileşen görüyorum?
Kod n_{\text{comp}}=\max\big(2,\min(k,\ \min(p,n-1))\big) uygular (dimensionality.py:240); grafik ve biplot iki eksen istediği için en az 2 tutulur. Sonuç metni önerilen ve tutulan sayıyı ayrı yazar. Raporda önerilen sayı (burada 1) kullanılmalı, ikinci bileşen yorumlanmamalıdır.
S4. Paralel analizin sonucu tohuma bağlı mı?
Eşikler 100 benzetimden gelir; tohum değişse eşikler üçüncü ondalıkta oynar. MerQur tohumu 42'ye sabitler ve arayüzde değiştirilemez; aynı veri her zaman aynı eşikleri verir. Bu veride birinci özdeğer (5,51) eşiğin (1,31) çok üstünde, ikincisi (0,15) çok altında olduğu için karar tohuma duyarlı değildir. R psych::fa.parallel kendi benzetimiyle de 1 bileşen bulur.
S5. Bartlett p değeri neden tam olarak 0 saklanıyor?
sampling_adequacy.py:71 p'yi sağ kuyruk fonksiyonuyla (chi2.sf, AFA ile ortak) hesaplar; 1-F farkı kullanılmadığı için küçük p'ler basamak kaybetmez. \chi^2=1795'te ise gerçek değer e^{-860{,}8}'dir (chi2.logsf ile) ve çift duyarlıklı sayının en küçük değerinin altında kaldığı için 0 saklanır. Metin "p < .001" yazar; tam büyüklük gerekiyorsa log ölçeği kullanılmalıdır.
S6. Promax'ta MerQur ile R `stats::promax` neden farklı?
MerQur hedef matrisi satır normalleştirilmiş varimax yüklerinin 4. kuvvetinden kurar (yaygın istatistik yazılımlarındaki tanım); stats::promax normalleştirmez. Bu veride MerQur \Phi_{12}=0{,}830840, stats::promax 0,833592 verir. R'de aynı sonuç için hedef elle kurulmalıdır (doğrulama betiği r_dogrulama.R).
S7. Varimax yükleri altıncı ondalıkta neden yazılımlar arasında farklı?
İki bileşende varimax ölçütü dönme açısına göre bu veride çok düzdür: açı 10^{-6} radyan değişince ölçüt yalnız 2\times10^{-13} değişir. SVD yinelemesi tekil değer toplamının göreli artışı 10^{-14}'ün altına inince durur; bu nokta optimuma yükler açısından ~10^{-6} uzaklıktadır. MerQur'un yükleri kapalı çözümden en çok 6\times10^{-7} sapar (6 ondalık gösterim yuvarlaması dahil). R stats::varimax aynı algoritmadır ama en çok 1000 yineleme yapar; bu veride bu sınıra takılır ve yük kareleri toplamı kapalı çözümden yine 1{,}3\times10^{-6} uzakta kalır. GPArotation::Varimax (gradyan izdüşümü) kapalı çözüme 10^{-10} düzeyinde yaklaşır. Raporlanan 2–3 ondalıkta fark görünmez.
S8. Kovaryans PCA'sı ne zaman doğru seçimdir?
Tüm değişkenler aynı birimde ve varyans farkları anlamlıysa (ör. aynı ölçekteki maddeler, aynı birimde ölçülmüş morfometrik uzunluklar). Bu veride birimler farklıdır; kolesterol ve glikoz yalnız varyansları büyük olduğu için birinci bileşene baskın yük verir. MerQur kovaryans PCA'sında Kaiser eşiğini ortalama özdeğer (453,50) alır ve eşleştirme eşiklerini standartlaştırılmış yüklere uygular.
S9. KMO n\le p iken neden hesaplanmıyor?
\mathbf R tekildir ve \mathbf R^{-1} yoktur; kısmi korelasyonlar tanımsızdır. Kod KMO ve Bartlett'i yalnız n>p iken hesaplar (dimensionality.py:265). Ayrıca \mathbf R pozitif tanımlı değilse (ör. ikili silme sonrası) ters matrisin köşegeninde sıfır ya da negatif değer çıkar; KMO "—" basılır (psych::KMO ile aynı).
80.9 Sık hatalar ve tuzaklar
- Döndürülmüş bileşenleri "en büyük varyans" sırasıyla yorumlamak. Döndürmeden sonra bileşenler artık özdeğer sırasında değildir; varyansları yük kareleri toplamıdır. Tablodaki "Özdeğer" satırı döndürülmemiş çözüme aittir.
- Gürültü bileşenini döndürüp anlamlandırmak. Bu veride ikinci bileşen 0,155 varyans taşır; varimax onu 2,21 birimlik bir "boyut" gibi gösterir, promax ise iki boyutun 0,83 korelasyonlu olduğunu ortaya koyar.
- Kaiser ölçütüne tek başına güvenmek. Rastgele veride bile ilk özdeğerler 1'i aşar; paralel analizi birlikte kullanın.
- Kovaryans PCA'sını farklı birimli değişkenlerde kullanmak. Büyük varyanslı değişken bileşeni belirler.
- Bartlett'in anlamlılığını yeterlilik sanmak. n büyükse küçük korelasyonlar da Bartlett'i anlamlı yapar; KMO'ya ve MSA'lara bakın.
- İşareti yorumlamak. Özvektörün işareti keyfidir; bir bileşenin bütün yükleri ve skorları birlikte ters dönebilir.
- "Önemli PC" listesini tam liste sanmak. Eşleştirme bloğu yalnız varyans payı ≥ %5 ya da kümülatif ≤ %90 olan bileşenleri listeler; tablo sekmesi tüm tutulan bileşenleri verir.
- Skorları ham bileşen skoru sanmak. Kaydedilen skorlar standarttır (SS 1); ham skor c_{ik}=\sqrt{\lambda_k}f_{ik}'dir.
80.10 Kaynaklar
- Bartlett, M. S. (1950). Tests of significance in factor analysis. British Journal of Statistical Psychology, 3(2), 77–85. https://doi.org/10.1111/j.2044-8317.1950.tb00285.x
- Dziuban, C. D., & Shirkey, E. C. (1974). When is a correlation matrix appropriate for factor analysis? Some decision rules. Psychological Bulletin, 81(6), 358–361. https://doi.org/10.1037/h0036316
- Gabriel, K. R. (1971). The biplot graphic display of matrices with application to principal component analysis. Biometrika, 58(3), 453–467. https://doi.org/10.1093/biomet/58.3.453
- Glorfeld, L. W. (1995). An improvement on Horn's parallel analysis methodology for selecting the correct number of factors to retain. Educational and Psychological Measurement, 55(3), 377–393. https://doi.org/10.1177/0013164495055003002
- Hendrickson, A. E., & White, P. O. (1964). Promax: A quick method for rotation to oblique simple structure. British Journal of Statistical Psychology, 17(1), 65–70. https://doi.org/10.1111/j.2044-8317.1964.tb00244.x
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30(2), 179–185. https://doi.org/10.1007/BF02289447
- Hotelling, H. (1933). Analysis of a complex of statistical variables into principal components. Journal of Educational Psychology, 24(6), 417–441. https://doi.org/10.1037/h0071325
- Jolliffe, I. T. (2002). Principal component analysis (2. baskı). Springer. https://doi.org/10.1007/b98835
- Jolliffe, I. T., & Cadima, J. (2016). Principal component analysis: A review and recent developments. Philosophical Transactions of the Royal Society A, 374(2065), 20150202. https://doi.org/10.1098/rsta.2015.0202
- Kaiser, H. F. (1958). The varimax criterion for analytic rotation in factor analysis. Psychometrika, 23(3), 187–200. https://doi.org/10.1007/BF02289233
- Kaiser, H. F. (1960). The application of electronic computers to factor analysis. Educational and Psychological Measurement, 20(1), 141–151. https://doi.org/10.1177/001316446002000116
- Kaiser, H. F. (1974). An index of factorial simplicity. Psychometrika, 39(1), 31–36. https://doi.org/10.1007/BF02291575
- Pearson, K. (1901). On lines and planes of closest fit to systems of points in space. The London, Edinburgh, and Dublin Philosophical Magazine and Journal of Science, 2(11), 559–572. https://doi.org/10.1080/14786440109462720
- Zwick, W. R., & Velicer, W. F. (1986). Comparison of five rules for determining the number of components to retain. Psychological Bulletin, 99(3), 432–442. https://doi.org/10.1037/0033-2909.99.3.432