50. Multinomial Lojistik Regresyon
Analiz kimliği: multinomial_logistic · Menü adı: Multinomial Lojistik Regresyon · Panel: gui/panels/analyses/multinomial_logistic.py · Motor: stats/glm_advanced.py, run_multinomial_logistic (satır 751–1057); ek çıktılar stats/glm_extras.py, stats/glm_count_ordinal_extras.py, stats/glm_scale.py, stats/multinom_stepwise.py
50.1 Ne işe yarar
Multinomial lojistik regresyon, üç ya da daha çok sırasız kategorisi olan bir sonucun (kanser evresi kodlaması sırasız kabul edildiğinde, tanı türü, tedavi tercihi) olasılıklarını açıklayıcı değişkenlerle modeller. İkili lojistik regresyonun (Bölüm 46) doğrudan genellemesidir: bir kategori referans seçilir ve geri kalan her kategori için referansa karşı ayrı bir logit denklemi kurulur. Bu yüzden "genelleştirilmiş logit" ya da "taban kategori logit" modeli de denir.
K kategori ve referans kategori r için model:
- \pi_{ik}=P(Y_i=k\mid\mathbf x_i): i. kişinin k kategorisinde olma olasılığı; her kişi için \sum_k\pi_{ik}=1.
- \mathbf x_i=(1,x_{i1},\dots,x_{ip})^{\top}: başına 1 eklenmiş açıklayıcı vektörü.
- \boldsymbol\beta_k: k. denklemin katsayı vektörü; referans kategoride \boldsymbol\beta_r=\mathbf 0 alınır (tanımlanabilirlik koşulu).
- \eta_{ik}: k kategorisinin referansa göre log-odds'u.
- Toplam parametre sayısı (K-1)(p+1); Tıp örneğinde 2\times3=6.
Neden bir kategorinin katsayıları sıfıra sabitlenir?
Tüm \eta_{ik}'lere aynı sabiti eklemek olasılıkları değiştirmez: pay ve payda aynı e^{c} çarpanını alır. Bu yüzden K katsayı vektörünün yalnız K-1 tanesi veriden kestirilebilir. Birini sıfıra sabitlemek, ikili lojistikteki "olay olmayan" kategorinin rolünü bu kategoriye verir. Hangi kategorinin seçildiği yalnız katsayıların gösterimini değiştirir; olasılıklar, log-olabilirlik ve tüm model testleri aynı kalır (50.5.6).
e^{\beta_{kj}}, x_j bir birim arttığında \pi_k/\pi_r oranının çarpıldığı katsayıdır. Bazı kaynaklar bu büyüklüğe "göreli risk oranı" (RRR) der; MerQur "OR" yazar. Her iki ad da aynı sayıyı gösterir: referans kategoriye karşı koşullu odds, yani yalnız k ile r arasından seçim yapılırken k'nin odds'u.
Ne zaman kullanılır? Sonuç üç ya da daha çok kategorili ve kategoriler arasında doğal bir sıra yok (ya da sıranın varsayımlarına güvenilmiyor); açıklayıcılar sayısal ya da kategorik; amaç her kategorinin referansa göre ilişkisini ayrı ayrı görmek.
Ne zaman kullanılmaz?
- Sonuç iki kategorili ise: İkili Lojistik Regresyon (MerQur bu modülde 3'ten az sınıfta hata verir).
- Kategoriler doğal bir sıra izliyor ve tek bir "daha yüksek kategoriye kayma" etkisi aranıyorsa: Sıralı Lojistik Regresyon (Bölüm 51). Daha az parametreyle daha güçlüdür.
- Seçeneklerin kendi özellikleri (fiyat, süre) modele girecekse: Koşullu Lojit (Seçim Modeli).
- Karmaşık örneklem ağırlıkları varsa: Karmaşık Örneklem Çok Terimli Lojistik Regresyon.
- Gözlemler kümeli ya da tekrarlıysa: GLMM ya da GEE (bu modülde küme-sağlam SH yoktur).
Sık karıştırılan analizler. Ayrı ayrı ikili lojistik regresyonlar (her kategori referansa karşı, yalnız o iki kategorinin gözlemleriyle) yaklaşık aynı katsayıları verir ama SH'leri büyüktür ve olasılıklar toplamı 1'e kısıtlanmaz (Begg ve Gray 1984). Diskriminant analizi (LDA) aynı soruyu açıklayıcıların çok değişkenli normalliği altında yanıtlar. Sıralı lojistik, sıra bilgisini kullanan ve her açıklayıcı için tek katsayı veren kısıtlı bir modeldir.
50.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| En az üç sınıf | Bağımlı değişkende en az üç farklı değer. | Üçten azsa hata (glm_advanced.py:790–792). |
| Bağımsız gözlemler | Her satır ayrı kişi. | Tasarım; denetlenmez. |
| Logitte doğrusallık | Sürekli x ile her denklemin log-odds'u arasında doğrusal ilişki. | Denetlenmez; etkileşim ya da dönüştürülmüş terimle sınanabilir. |
| IIA (ilgisiz seçeneklerden bağımsızlık) | İki kategori arasındaki odds, başka bir kategorinin varlığından etkilenmez. | İsteğe bağlı IIA testi (Hausman–McFadden). |
| Ayrışma yok | Hiçbir açıklayıcı birleşimi kategorileri kusursuz ayırmamalı. | Her çalıştırmada doğrusal programlama ile otomatik (glm_advanced.py:691–748, 871–888). |
| Yeterli gözlem | Her kategoride, parametre başına yeterli olay. | Denetlenmez. |
Normallik ve varyans eşitliği varsayımı yoktur: \mathbf y_i (kategori göstergeleri vektörü) multinom dağılıma uyar; varyansı \operatorname{diag}(\boldsymbol\pi_i)-\boldsymbol\pi_i\boldsymbol\pi_i^{\top}'dir ve ortalamadan belirlenir.
Eksik değer. Bağımlı değişkende ya da seçilen açıklayıcılardan herhangi birinde eksik olan satır tümüyle çıkarılır (liste bazında silme, _drop_na, glm_advanced.py:118–127, çağrı 745). Frekans ağırlığı seçilmişse satırlar önce ağırlık kadar çoğaltılır (multinomial_logistic.py:134–137).
Uç durumlar.
- Kategori sayısı 3'ten azsa: "Multinomial Lojistik en az 3 sınıf gerektirir" hatası.
- Yazılan referans adı veride yoksa: önce büyük/küçük harf duyarsız, sonra sayısal değerce (
'1'↔'1.0') tek eşleşme aranır; eşleşme bulunursa kullanılır ve uyarı yazılır, yoksa açık hata verilir (_match_reference,glm_advanced.py:178–195). - Tam ya da yarı ayrışmada kestirim sonsuza gider; sonuç metninin en başına büyük harfli uyarı eklenir ve sonlu olmayan değerler "—" olarak basılır (
glm_advanced.py:880–888).
50.3 Parametreler
Varsayılanlar multinomial_logistic.py:48–112 (form) ve 325–341 (read_options) satırlarından alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken (sırasız çoklu) | ilk kategorik sütun | 3+ sınıflı hedef. | Sınıflar metin olarak alınır. |
| Referans sınıf | boş | Katsayıların karşılaştırıldığı kategori. | Boşsa aşağıdaki sıra kuralının ilk sınıfı. Yalnız katsayı satırları değişir. |
| Bağımsız değişkenler | en az 1 | Sayısal ya da kategorik açıklayıcılar. | Metin sütunları kukla kodlanır (ilk düzey referans). |
| Kategorik (faktör) değişkenler | boş | Sayısal kodlu sütunları kukla kodlatır. | Tasarım matrisi. |
| Güven Düzeyi | %95 | Katsayı ve OR GA'ları; \alpha=1-\text{düzey}. | Yalnız GA sınırları. |
| Etkileşimler | boş | a*b biçiminde iki yönlü çarpım terimleri. |
Tasarım matrisi; etki testleri Tip II olur. |
| Ek çıktı: Etki başına olabilirlik oranı testleri | kapalı | Her açıklayıcı çıkarılınca LR χ². | Ek tablo. |
| Ek çıktı: Pearson / sapma uyum iyiliği | kapalı | Kovaryat örüntüleri üzerinden χ². | Ek tablo. |
| Ek çıktı: Sınıflama tablosu | kapalı | Gözlenen × en olası kategori. | Ek tablo. |
| Ek çıktı: IIA testi (Hausman-McFadden) | kapalı | Her referans dışı kategori çıkarılarak katsayı kararlılığı. | Ek tablo. |
| Aşırı yayılım ölçeği | Yok (ölçek = 1) | Pearson ya da sapma \varphi ile SH'ler \sqrt\varphi katı. | SH, z, p, GA. |
| Değişken seçim yöntemi | Enter (tümü) | İleri, geri, ileri adımsal, geri adımsal. | Modele giren değişkenler. |
| Giriş testi / Çıkarma testi | LR / LR | Giriş: LR ya da skor; çıkış: LR ya da Wald. | Yalnız adımsal yöntemde. |
| PIN / POUT | 0,05 / 0,10 | Giriş ve çıkış eşikleri. | Yalnız adımsal yöntemde. |
| Her zaman modelde | boş | Adımsal seçimde dışarı çıkarılmayan terimler. | Yalnız adımsal yöntemde. |
| Frekans ağırlığı | Yok (ağırlıksız) | Satırlar ağırlık kadar çoğaltılır. | n ve tüm kestirimler. |
| Grafik | Katsayı orman grafiği | Orman grafiği ya da kategori başına 3B olasılık yüzeyi. | Yalnız Grafik sekmesi. |
Varsayılan referans: ilk görünen sınıf, alfabetik değil
Referans alanı boşsa sınıflar core.cat_order kuralıyla sıralanır (glm_advanced.py:786–789, core/cat_order.py:58–124): (1) sütun pandas kategorik ise onun sırası; (2) tüm etiketler sayıysa sayısal sıra; (3) <55, 55-70 gibi aralık etiketleri; (4) Evre 1, T3 gibi tek sayılı etiketler sayıya göre; (5) aksi hâlde verideki ilk görünme sırası. Alfabetik sıra kullanılmaz: Türkçe ve İngilizce veri kopyalarında farklı referans verirdi. Tıp verisinde ilk satır medium olduğu için varsayılan referans medium olur, early değil. Satırların sırası değişirse referans da değişebilir. Sonuç metni hangi referansın kullanıldığını ve otomatik seçildiğini yazar.
Bazı yazılımlar varsayılan olarak son kategoriyi, R nnet::multinom ve VGAM::vglm(multinomial(refLevel = 1)) ise faktörün ilk düzeyini referans alır. Yazılımlar arasında karşılaştırma yaparken referans açıkça belirtilmelidir.
Adımsal seçimde neden "etki" bütün denklemlere birlikte girer?
Bir açıklayıcının K-1 denklemdeki katsayıları ayrı terimler değildir: değişken ya modeldedir ya değildir. MerQur bu yüzden giriş ve çıkış testlerini (K-1)\times(\text{kukla sayısı}) sd'li ortak LR, skor ya da Wald testiyle yapar. Tüm adımlar, tüm aday değişkenlerde tam olan aynı gözlemlerle yürütülür; seçilen terimlerle olağan model sonra yeniden kestirilir (glm_advanced.py:809–832).
50.4 Tıp örneği
Dosya: english/datasets/Tip/42_multinomial_cancer_stage.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/42_multinomial_kanser_evre.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #42'den alınmıştır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
cancer_stage |
Bağımlı | metin, 3 düzey | early 71, medium 110, advanced 69 |
age |
Açıklayıcı | sürekli (yıl) | ort. 62,27; SS 12,14; 40–84 |
biomarker |
Açıklayıcı | sürekli | ort. 48,77; SS 29,24; 0,1–99,3 |
Grup ortalamaları: biomarker early 29,4, medium 48,9, advanced 68,4; age early 59,9, medium 61,5, advanced 65,9. Biyobelirteç evreyle belirgin, yaş zayıf biçimde artıyor.
n ve eksik değer: 250 hasta, eksik değer yok. Her kategoride en az 69 hasta vardır; 6 parametre için yeterlidir.
Klinik soru: Yaş ve biyobelirteç düzeyi, erken evreye göre orta ve ileri evrede bulunma odds'uyla ilişkili mi?
Seçilen ayarlar: Evre aslında sıralıdır; burada multinomial model, sıralı modelin "orantılı odds" kısıtını kaldıran esnek karşılaştırma modeli olarak kullanılır (sıralı model için Bölüm 51). Klinik yorum için Referans sınıf = early yazılmıştır. Varsayılan (boş) referansla medium referans alınır; bu çalıştırma 50.5.6'da karşılaştırılır. Hesap yürüyüşü için dört ek çıktı kutusu açık ikinci bir çalıştırma, Pearson ölçekli bir çalıştırma ve İleri seçimli bir çalıştırma da yapılmıştır.
50.5 Formüller ve hesap adımları
MerQur'un hesap sırası şudur: liste bazında silme → sınıf sırası ve referans → (isteğe bağlı) adımsal seçim → tasarım matrisi ve kuklalar → açıklayıcıların z-standartlaştırılması → statsmodels MNLogit ile Newton–Raphson → ayrışma denetimi → katsayıların özgün ölçeğe geri dönüşümü (sabit için delta yöntemi) → model LR testi, sözde R^2'ler → isteğe bağlı ek çıktılar → isteğe bağlı ölçek düzeltmesi.
50.5.1 Olabilirlik
y_{ik}=1 kişi i k kategorisindeyse, değilse 0 olsun. Log-olabilirlik:
- \mathbf B=[\boldsymbol\beta_k]_{k\ne r}: (p+1)\times(K-1) katsayı matrisi.
- İkinci biçim, \pi_{ik} tanımı yerine konarak bulunur; K=2 olduğunda ikili lojistik log-olabilirliğine indirgenir.
- Çıktıdaki "Sapma" satırı -2\ell'dir; tek gözlemli veride doymuş modelin log-olabilirliği 0 olduğu için sapmayla aynı sayıdır.
Türevler, k,m\ne r için:
- \delta_{km}: Kronecker deltası (k=m ise 1, değilse 0).
- Bilgi matrisi (K-1)(p+1) boyutludur ve denklem blokları hâlinde dizilir; köşegen dışı bloklar (k\ne m) negatiftir: bir kategorinin olasılığı artınca diğerlerininki azalır.
- Logit kanonik bağlantı olduğu için gözlenen ve beklenen bilgi aynıdır; Newton–Raphson ve Fisher skorlaması aynı yinelemeleri üretir.
50.5.2 Kestirim: standartlaştırılmış ölçekte Newton–Raphson
- \mathbf U: denklem blokları alt alta dizilmiş skor vektörü; \mathbf I: yukarıdaki bilgi matrisi.
- Log-olabilirlik içbükeydir; ayrışma yoksa tek en büyük noktası vardır ve Newton karesel hızla yakınsar.
Koddaki tercih: z-standartlaştırma ve geri dönüşüm
MerQur sabit dışındaki her tasarım sütununu \tilde x_j=(x_j-m_j)/s_j ile standartlaştırır (s_j ddof = 0 ile; glm_advanced.py:847–863), sonra MNLogit(y, X_fit).fit(method="newton", maxiter=200) çağırır (832–833). statsmodels 0.14.6'da başlangıç değeri sıfır vektörüdür, durma ölçütü parametre değişiminin 10^{-8}'in altına inmesidir. Amaç, ölçekleri çok farklı açıklayıcılarda e^{\mathbf X\boldsymbol\beta} taşmasını önlemektir. Kestirim sonrası özgün ölçeğe dönülür (864–917):
Burada \mathbf C_k, standartlaştırılmış modelde k. denklemin kovaryans bloğudur. Dönüşüm doğrusal olduğu için ML kestirimi değişmezdir: özgün ölçekte doğrudan kestirilen modelle aynı sayıları verir (doğrulama tablosunda farklar 10^{-10} ve altında). Eğimlerin z ve p değerleri dönüşümden etkilenmez; sabitin z, p ve GA'sı delta yöntemiyle yeniden hesaplanır.
Başlangıç \mathbf B=\mathbf 0'da ilk adım. Her kişide \pi_{ik}=1/K olur. Bu durumda bilgi matrisinin blokları sabittir:
ve skor \mathbf U_k=\mathbf X^{\top}(\mathbf y_{\cdot k}-\tfrac13\mathbf 1)'dir. İlk adım bu yüzden kapalı biçimde hesaplanabilir.
50.5.3 Standart hata, Wald testi ve OR
- z standart normal dağılıma göre değerlendirilir; ayrı bir ölçek parametresi yoktur.
- OR, referansa karşı koşullu odds'un çarpanıdır. Sabit satırında OR yazılmaz ("—";
glm_advanced.py:1693–1698): tüm açıklayıcılar sıfırken anlamı yoktur. - GA önce log ölçekte kurulur, sonra üstel alınır; OR çevresinde simetrik değildir.
50.5.4 Model testi, sözde R² ve bilgi ölçütleri
- \ell_0: yalnız sabitli modelin log-olabilirliği; her kişiye örneklemdeki kategori oranları verilir. n_k: k kategorisindeki gözlem sayısı.
- Sd =p(K-1): sabit dışındaki tüm katsayılar; Tıp örneğinde 2\times2=4.
- q: toplam parametre sayısı. "df (artık)" satırı n-q'dur.
Koddaki tercih: \ell_0 yeniden kestirilir
LR testi ve McFadden R^2, statsmodels'in llnull değeriyle hesaplanır; bu değer yalnız sabitli model yinelemeli kestirilerek bulunur (glm_advanced.py:971, glm_extras.py:94–102). Kapalı biçimle farkı bu veride -2\ell_0'da 8\times10^{-8}'dir. Cox–Snell ve Nagelkerke her zaman verilir (glm_count_ordinal_extras.py:27–33). Sonuç nesnesindeki McFadden alanı dört ondalığa yuvarlanır (glm_advanced.py:1042).
50.5.5 Etki başına LR testleri ve adımsal seçim
- \ell_{(-j)}: j. açıklayıcı (bütün kuklalarıyla) çıkarılmış modelin log-olabilirliği; model yeniden kestirilir (
glm_extras.py:103–113). - d_j: açıklayıcının kukla sayısı (sürekli için 1). Test, değişkenin tüm denklemlerdeki etkisini birlikte sınar.
- Etkileşimli modelde bu tablo Tip II testlerine geçer (
glm_count_ordinal_extras.py:772–790): bir terim, onu içeren üst düzey terimler çıkarılmış modele göre sınanır (Rcar::Anovaile aynı mantık).
İleri seçimde ilk adım, her aday için yalnız o değişkenli modeli kurar ve en küçük p'li LR testini veren değişkeni ekler.
50.5.6 Referans değiştirmenin cebiri
Referans r'den s'ye taşındığında yeni katsayılar eski katsayıların farkıdır:
- \boldsymbol\beta_{k|r}: k kategorisinin r referansına göre katsayıları.
- SH'ler bu farkın varyansından gelir: \operatorname{Var}(\mathbf a-\mathbf b)=\operatorname{Var}\mathbf a+\operatorname{Var}\mathbf b-2\operatorname{Cov}(\mathbf a,\mathbf b). Bu yüzden yeni SH'leri yalnız tablodan hesaplamak mümkün değildir; denklemler arası kovaryans gerekir. MerQur modeli yeniden kestirir.
50.5.7 Uyum iyiliği, sınıflama ve ölçek
Kovaryat örüntüsü, açıklayıcıların aynı değer birleşimine sahip gözlemler kümesidir. g örüntü ve her örüntüde gözlenen (O_{hk}) ve beklenen (E_{hk}=\sum_{i\in h}\hat\pi_{ik}) sayılarla (glm_count_ordinal_extras.py:45–67):
- Sürekli açıklayıcılarda neredeyse her gözlem kendi örüntüsüdür (g\approx n); o zaman D=-2\ell olur ve χ² yaklaşımı geçersizdir. MerQur g>n/5 olduğunda uyarı yazar.
Sınıflama tablosu her kişiyi en yüksek kestirilen olasılıklı kategoriye atar (argmax, glm_count_ordinal_extras.py:81–93); kesme değeri yoktur.
Ölçek. "Aşırı yayılım ölçeği" seçilirse \varphi=X^2/\{n(K-1)-q\} (Pearson; gözlem bazında, n\times K hücre üzerinden) ya da \varphi=-2\ell/\{n(K-1)-q\} (sapma) hesaplanır ve tüm SH'ler \sqrt\varphi ile çarpılır (glm_scale.py:38–82). Katsayılar değişmez.
Tek gözlemli veride ölçeğin bilgi değeri sınırlıdır
Her satır bir kişi olduğunda X^2/\text{sd} aşırı yayılımı ölçmez; değeri büyük ölçüde açıklayıcıların dağılımına bağlıdır. Bu veride \varphi=0{,}9327<1 çıkar ve ölçekleme SH'leri küçültür. Aşırı yayılım düzeltmesi yalnız gruplanmış (aynı açıklayıcı değerinde çok sayıda gözlem olan) veride anlamlıdır. Arayüz ipucu metni bunu belirtir.
50.5.8 IIA testi (Hausman–McFadden)
Bir referans dışı kategori c veriden çıkarılır, model kalan kategorilerle yeniden kestirilir (\hat{\boldsymbol\beta}_R); tam modelin aynı denklemlerindeki katsayılarla (\hat{\boldsymbol\beta}_F) karşılaştırılır (Hausman ve McFadden 1984; glm_count_ordinal_extras.py:793–843):
- d: karşılaştırılan katsayı sayısı; MerQur sabit terimleri de dahil eder (Tıp örneğinde d=3).
- IIA geçerliyse iki kestirici de tutarlıdır; \hat{\boldsymbol\beta}_F etkindir, bu yüzden \mathbf V_R-\mathbf V_F pozitif yarı tanımlı beklenir.
- Sonlu örneklemde \mathbf V_R-\mathbf V_F pozitif tanımlı olmayabilir; H negatif çıkabilir. MerQur negatif H'yi p vermeden yazar, en küçük özdeğer pozitif değilse ayrıca uyarır.
Neden bu testin sonuçları dikkatle okunmalı?
Cheng ve Long (2007), Hausman–McFadden ve Small–Hsiao testlerinin benzetimlerde çok kötü boyut özellikleri gösterdiğini, sıklıkla negatif istatistik ürettiğini ve aynı veride çıkarılan kategoriye göre çelişen kararlar verdiğini bulmuştur. Test, IIA'yı "kanıtlamaz" ya da güvenilir biçimde reddetmez; seçeneklerin birbirinin yakın ikamesi olup olmadığına kuramsal olarak karar verilmelidir. Klinik evre gibi seçilmeyen, kişinin durumunu yansıtan sonuçlarda IIA'nın "seçim" yorumu zaten zayıftır.
50.5.9 Ayrışma denetimi
İkili lojistikteki Konis doğrusal programı (Bölüm 46.5.9) çok sınıfa genelleştirilir: referans sütunu 0 olan bir \mathbf B\in[-1{,}1] aranır öyle ki her gözlem için \mathbf x_i^{\top}(\boldsymbol\beta_{y_i}-\boldsymbol\beta_j)\ge0 (j\ne y_i) olsun ve en az biri kesin pozitif olsun (glm_advanced.py:691–748). Önce tam ayrışma (tüm kısıtlar \ge\tau>0), sonra yarı ayrışma sınanır; ayrışma varsa ayrıştıran değişkenler sabit + tek değişkenli programlarla belirlenir. Problem n(K-1)p(K-1)>2\cdot10^7 ise denetim atlanır; Newton'un sonlu olmayan katsayı üretmesi yine uyarılır.
50.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/multinomial_logistic/elle_hesap.py ile, MerQur çağrılmadan, özgün ölçekte numpy Newton–Raphson ile hesaplanmıştır. Referans early, denklem sırası medium, advanced.
Adım 1 — Başlangıç (\mathbf B=\mathbf 0). Her hastada \pi_{ik}=1/3; -2\ell=2\cdot250\ln3=549{,}306144. Skor:
İlk bileşen 110-250/3=26{,}67'dir: medium beklenenden sık olduğu için sabiti yukarı çekilecektir. Bilgi matrisi \mathbf X^{\top}\mathbf X'in sabit katlarından oluşur:
Adım 2 — Yakınsama.
| Yineleme | b_0^{\,m} | b_{\text{age}}^{\,m} | b_{\text{bio}}^{\,m} | b_0^{\,a} | b_{\text{age}}^{\,a} | b_{\text{bio}}^{\,a} | -2\ell |
|---|---|---|---|---|---|---|---|
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 549,306144 |
| 1 | −0,846346 | 0,005809 | 0,019533 | −3,911416 | 0,032485 | 0,038232 | 465,460185 |
| 2 | −1,551721 | 0,015134 | 0,026989 | −5,802172 | 0,048924 | 0,055172 | 456,384450 |
| 3 | −1,715992 | 0,017080 | 0,028824 | −6,304577 | 0,053248 | 0,059549 | 456,025090 |
| 4 | −1,723511 | 0,017170 | 0,028906 | −6,330760 | 0,053466 | 0,059774 | 456,024231 |
| 5 | −1,723526 | 0,017170 | 0,028906 | −6,330828 | 0,053466 | 0,059774 | 456,024231 |
(m: medium/early, a: advanced/early.) İlk adım -2\ell'yi 83,8 puan düşürür. Dördüncü yinelemede -2\ell son değerinden yalnız 6\times10^{-9} uzaktadır; katsayılardaki değişim her adımda kabaca karesini alarak küçülür (karesel yakınsama).
Adım 3 — Katsayı tablosu (referans early).
| Denklem | Terim | b | SH | z | p | OR | %95 GA |
|---|---|---|---|---|---|---|---|
| medium / early | Sabit | −1,723526 | 0,910635 | −1,893 | 0,0584 | — | — |
| age | 0,017170 | 0,013831 | 1,241 | 0,2144 | 1,017319 | [0,990111; 1,045274] | |
| biomarker | 0,028906 | 0,006421 | 4,502 | 6,74·10⁻⁶ | 1,029328 | [1,016455; 1,042364] | |
| advanced / early | Sabit | −6,330828 | 1,238023 | −5,114 | 3,16·10⁻⁷ | — | — |
| age | 0,053466 | 0,017071 | 3,132 | 0,00174 | 1,054921 | [1,020208; 1,090815] | |
| biomarker | 0,059774 | 0,008380 | 7,133 | 9,81·10⁻¹³ | 1,061597 | [1,044304; 1,079176] |
Örnek, advanced/early biomarker: z=0{,}059774/0{,}008380=7{,}1332; OR =e^{0{,}059774}=1{,}061597; GA e^{0{,}059774\pm1{,}959964\times0{,}008380}=e^{[0{,}043350;\ 0{,}076198]}=[1{,}044304;\ 1{,}079176].
Adım 4 — Tek bir hastanın olasılıkları. 1 numaralı hasta: yaş 45, biyobelirteç 1,2.
Üç olasılığın toplamı 1'dir. En olası kategori early; hastanın gerçek evresi medium olduğundan sınıflama tablosunda yanlış sınıflanan bir gözlemdir.
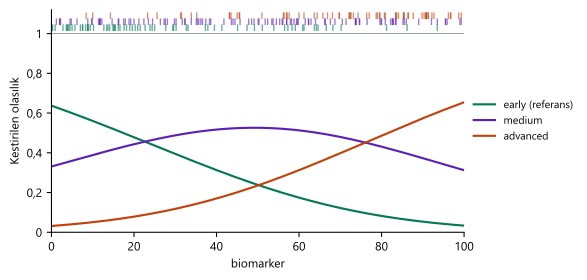
Şekil 50.1. Yaş ortalamada (62,3) sabitken biyobelirtece göre kestirilen kategori olasılıkları. Üstteki çizgiler her kategorideki hastaların biyobelirteç değerleridir.
Adım 5 — Model testi ve sözde R². Kategori sayıları 71, 110, 69:
Adım 6 — Etki başına LR testleri. age çıkarıldığında -2\ell=467{,}264818, biomarker çıkarıldığında 527{,}406566:
İleri seçimin ilk adımında biomarker girer (-2\ell: 537,0175 → 467,2648, χ² = 69,75), ikinci adımda age girer (χ² = 11,24); son model tam modelle aynıdır.
Adım 7 — Referans medium (varsayılan) ile. 50.5.6'daki farkla:
MerQur'un varsayılan çalıştırması tam bu sayıları verir; early vs medium satırları ise medium vs early satırlarının işaret tersidir. Log-olabilirlik, LR χ², AIC, BIC ve sözde R^2'ler iki çalıştırmada aynıdır.
Adım 8 — Ek çıktılar.
- Uyum iyiliği: 250 hastanın 250'si ayrı örüntü; X^2=460{,}7456, D=456{,}0242 (=-2\ell), sd =250\cdot2-6=494; p değerleri 0,856 ve 0,889. MerQur seyrek örüntü uyarısını yazar; bu p'ler yorumlanmaz.
- Sınıflama tablosu: early 36/71 (%50,7), medium 62/110 (%56,4), advanced 35/69 (%50,7); genel %53,2. En sık kategoriyi herkese atamak %44 doğruluk verir.
- Ölçek (Pearson): \varphi=460{,}7456/494=0{,}932683; SH'ler \sqrt{0{,}932683}=0{,}9658 ile çarpılır.
- IIA:
mediumçıkarıldığında H=10{,}8537 (sd 3, p=0{,}0125);advancedçıkarıldığında H=-0{,}0278 (negatif; p verilmez, uyarı yazılır). Aynı veride iki karar çelişir; 50.5.8'deki uyarının tipik örneği.
50.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundaki satırlardan ve extras sözlüğünden tam hassasiyetle alınmıştır (McFadden alanındaki dört ondalık yuvarlama doğrulama sırasında bellekte devre dışı bırakılmıştır). Python: özgün ölçekte, standartlaştırmasız Newton–Raphson. R 4.5.3: VGAM::vglm(multinomial(refLevel = 1)) (epsilon = 1e-14; VGAM bu sıkılıkta "yarım adım" uyarısı verir, kestirimler 10^{-15} düzeyinde etkilenmez); Hausman–McFadden tanımı R'de elle yazılmıştır. nnet::multinom (BFGS) aynı log-olabilirliğe ulaşır, katsayılarda 10^{-7} düzeyinde sapar.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| b medium / early: Sabit | −1,723526 | −1,723526 | −1,723526 | 7,1e−15 | ✓ |
| SH medium / early: Sabit | 0,910635 | 0,910635 | 0,910635 | 3,3e−12 | ✓ |
| p medium / early: Sabit | 0,058403 | 0,058403 | 0,058403 | 9,1e−13 | ✓ |
| b medium / early: age | 0,017170 | 0,017170 | 0,017170 | 1,5e−16 | ✓ |
| SH medium / early: age | 0,013831 | 0,013831 | 0,013831 | 2,1e−14 | ✓ |
| p medium / early: age | 0,214448 | 0,214448 | 0,214448 | 7,0e−13 | ✓ |
| OR %95 GA alt medium / early: age | 0,990111 | 0,990111 | 0,990111 | 4,1e−14 | ✓ |
| OR %95 GA üst medium / early: age | 1,045274 | 1,045274 | 1,045274 | 4,4e−14 | ✓ |
| b medium / early: biomarker | 0,028906 | 0,028906 | 0,028906 | 7,6e−17 | ✓ |
| SH medium / early: biomarker | 0,006421 | 0,006421 | 0,006421 | 6,2e−14 | ✓ |
| p medium / early: biomarker | 6,7439·10−6 | 6,7439·10−6 | 6,7439·10−6 | 1,4e−15 | ✓ |
| OR %95 GA alt medium / early: biomarker | 1,016455 | 1,016455 | 1,016455 | 1,3e−13 | ✓ |
| OR %95 GA üst medium / early: biomarker | 1,042364 | 1,042364 | 1,042364 | 1,3e−13 | ✓ |
| b advanced / early: Sabit | −6,330828 | −6,330828 | −6,330828 | 8,9e−15 | ✓ |
| SH advanced / early: Sabit | 1,238023 | 1,238023 | 1,238023 | 4,1e−11 | ✓ |
| p advanced / early: Sabit | 3,1597·10−7 | 3,1597·10−7 | 3,1597·10−7 | 2,8e−16 | ✓ |
| b advanced / early: age | 0,053466 | 0,053466 | 0,053466 | 9,0e−17 | ✓ |
| SH advanced / early: age | 0,017071 | 0,017071 | 0,017071 | 3,5e−13 | ✓ |
| p advanced / early: age | 0,001737 | 0,001737 | 0,001737 | 3,8e−13 | ✓ |
| OR %95 GA alt advanced / early: age | 1,020208 | 1,020208 | 1,020208 | 7,0e−13 | ✓ |
| OR %95 GA üst advanced / early: age | 1,090815 | 1,090815 | 1,090815 | 7,5e−13 | ✓ |
| b advanced / early: biomarker | 0,059774 | 0,059774 | 0,059774 | 2,1e−17 | ✓ |
| SH advanced / early: biomarker | 0,008380 | 0,008380 | 0,008380 | 3,4e−13 | ✓ |
| p advanced / early: biomarker | 9,8058·10−13 | 9,8058·10−13 | 9,8058·10−13 | 2,0e−21 | ✓ |
| OR %95 GA alt advanced / early: biomarker | 1,044304 | 1,044304 | 1,044304 | 6,8e−13 | ✓ |
| OR %95 GA üst advanced / early: biomarker | 1,079176 | 1,079176 | 1,079176 | 7,1e−13 | ✓ |
| Log-olabilirlik ℓ | −228,012115 | −228,012115 | −228,012115 | 1,4e−13 | ✓ |
| −2ℓ0 (yalnız sabit) | 537,017538 | 537,017538 | 537,017538 | 8,1e−08 | ✓ |
| LR χ²(4) | 80,993308 | 80,993307 | 80,993307 | 8,1e−08 | ✓ |
| AIC | 468,024231 | 468,024231 | 468,024231 | 2,8e−13 | ✓ |
| BIC | 489,152996 | 489,152996 | 489,152996 | 3,4e−13 | ✓ |
| McFadden R^2 | 0,150821 | 0,150821 | 0,150821 | 1,3e−10 | ✓ |
| Cox–Snell R^2 | 0,276730 | 0,276730 | 0,276730 | 2,3e−10 | ✓ |
| Nagelkerke R^2 | 0,313295 | 0,313295 | 0,313295 | 2,5e−10 | ✓ |
Ek çıktılar:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| LR χ² age (etki çıkarılınca) | 11,240587 | 11,240587 | 11,240587 | 2,1e−13 | ✓ |
| LR χ² biomarker | 71,382335 | 71,382335 | 71,382335 | 1,8e−13 | ✓ |
| İleri seçim adım 1: −2ℓ (yalnız biomarker) | 467,264818 | 467,264818 | 467,264818 | 1,7e−13 | ✓ |
| Pearson X^2 (250 örüntü) | 460,745625 | 460,745625 | 460,745625 | 3,4e−13 | ✓ |
| Pearson ölçeği \varphi | 0,932683 | 0,932683 | 0,932683 | 2,2e−16 | ✓ |
| Ölçekli SH medium / early: age | 0,013357 | 0,013357 | 0,013357 | 2,0e−14 | ✓ |
| Ölçekli SH advanced / early: biomarker | 0,008093 | 0,008093 | 0,008093 | 3,2e−13 | ✓ |
| OR %99 GA alt medium / early: age | 0,981713 | 0,981713 | 0,981713 | 5,3e−14 | ✓ |
| OR %99 GA üst medium / early: age | 1,054215 | 1,054215 | 1,054215 | 5,8e−14 | ✓ |
| OR %99 GA alt medium / early: biomarker | 1,012443 | 1,012443 | 1,012443 | 1,7e−13 | ✓ |
| OR %99 GA üst medium / early: biomarker | 1,046495 | 1,046495 | 1,046495 | 1,7e−13 | ✓ |
| OR %99 GA alt advanced / early: age | 1,009538 | 1,009538 | 1,009538 | 9,1e−13 | ✓ |
| OR %99 GA üst advanced / early: age | 1,102344 | 1,102344 | 1,102344 | 9,8e−13 | ✓ |
| OR %99 GA alt advanced / early: biomarker | 1,038928 | 1,038928 | 1,038928 | 9,0e−13 | ✓ |
| OR %99 GA üst advanced / early: biomarker | 1,084760 | 1,084760 | 1,084760 | 9,3e−13 | ✓ |
| Sınıflama: genel % doğru | 53,200000 | 53,200000 | 53,200000 | 0,0e+00 | ✓ |
| Hausman–McFadden χ² (medium çıkarıldı) | 10,853705 | 10,853705 | 10,853711 | 6,9e−06 | ✓ |
| Hausman–McFadden χ² (advanced çıkarıldı) | −0,027811 | −0,027811 | −0,027811 | 2,9e−09 | ✓ |
| Referans medium: b advanced / medium: Sabit | −4,607301 | −4,607301 | −4,607301 | 4,4e−15 | ✓ |
| Referans medium: b advanced / medium: age | 0,036296 | 0,036296 | 0,036296 | 6,2e−17 | ✓ |
| Referans medium: b advanced / medium: biomarker | 0,030868 | 0,030868 | 0,030868 | 4,9e−17 | ✓ |
| Referans medium: SH advanced / medium: Sabit | 1,046676 | 1,046676 | 1,046676 | 3,6e−11 | ✓ |
56 büyüklüğün tamamı ölçütü karşılar. En büyük farklar \ell_0'dadır (8\times10^{-8}; 50.5.4'teki yeniden kestirim) ve Hausman–McFadden χ²'sinde R ile 7\times10^{-6}'dır (göreli 6\times10^{-7}): medium çıkarıldığında \mathbf V_R-\mathbf V_F neredeyse tekildir ve ters alma küçük farkları büyütür.
50.7 Çıktıyı okuma
Sonuç metni (referans early, kısaltılmış):
Multinomial Lojistik Regresyon
  N (gözlem)         = 250
  Yordayıcı sayısı   = 2
  Log-olabilirlik    = -228.0121
  AIC                = 468.0242
  BIC                = 489.1530
  Sapma              = 456.0242
  df (artık)         = 244
  McFadden pseudo R² = 0.1508
  Sınıf sayısı       = 3
  Sınıflar           = early, medium, advanced

  Denklem            Değişken     Katsayı      SE      z       p     OR        OR %95 GA
  medium vs early    Sabit        -1.7235  0.9106  -1.89  0.0584      —                —
  medium vs early    age           0.0172  0.0138   1.24  0.2144  1.017   [0.990, 1.045]
  medium vs early    biomarker     0.0289  0.0064   4.50  < .001  1.029   [1.016, 1.042]
  advanced vs early  Sabit        -6.3308  1.2380  -5.11  < .001      —                —
  advanced vs early  age           0.0535  0.0171   3.13  0.0017  1.055   [1.020, 1.091]
  advanced vs early  biomarker     0.0598  0.0084   7.13  < .001  1.062   [1.044, 1.079]

── MODEL UYUM BİLGİSİ ──
  Yalnız sabit           −2LL = 537.0175
  Son model              −2LL = 456.0242   LR χ²(4) = 80.9933, p = 1.073e-16
  Pseudo R²: Cox-Snell = 0.2767, Nagelkerke = 0.3133, McFadden = 0.1508
Tablo sekmesi: Denklem, Değişken, Katsayı, SH, z, p, GA alt/üst (log-odds), OR ve OR GA'sı. Grafik sekmesi: sabit dışındaki katsayıların log-odds ölçeğinde orman grafiği; etiketler değişken [sınıf vs referans].
| Öğe | Nasıl yorumlanır |
|---|---|
| Sınıflar satırı | İlk sınıf referanstır. Notlar bölümü referansın kullanıcı tarafından mı yoksa otomatik mi seçildiğini yazar; önce buna bakın. |
| LR χ² | Tüm açıklayıcıların bütün denklemlerdeki birlikte katkısı (sd =p(K-1)). |
| Denklem başına OR | advanced vs early, biomarker 1,062: yaş sabitken biyobelirteçteki her birim artış, ileri evrenin erken evreye göre odds'unu %6,2 artırır. 10 birim için e^{10\times0{,}059774}=1{,}818. |
| Bir değişkenin anlamlılığı | Satırlardaki Wald p'leri denklem başınadır. Değişkenin genel katkısı için "Etki başına olabilirlik oranı testleri" kullanılmalıdır (age: χ²(2) = 11,24, p=0{,}004). |
p sütununda <0.0001 |
p<0{,}0001 demektir; raporda "p<0{,}001" yazılır. |
| Sınıflama tablosu | Yalnız en olası kategoriye bakar; olasılıkların kalitesini ölçmez. |
| Büyük harfli AYRIŞMA uyarısı | Katsayılar ve SH'ler geçersizdir; ayrıştıran değişken çıkarılmalı ya da kategoriler birleştirilmelidir. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Kanser evresini (erken, orta, ileri; referans: erken) yordamak için yaş ve biyobelirteç düzeyini içeren multinomial lojistik regresyon modeli kuruldu (n = 250). Model, yalnız sabitli modelden anlamlı biçimde daha iyi uyum gösterdi, \chi^2(4, N = 250) = 80{,}99, p < 0{,}001, McFadden R^2 = 0{,}15, Nagelkerke R^2 = 0{,}31. Biyobelirteç her iki denklemde anlamlıydı: her birim artış, orta evrenin (OR = 1,029; %95 GA [1,016; 1,042]; p < 0{,}001) ve ileri evrenin (OR = 1,062; %95 GA [1,044; 1,079]; p < 0{,}001) erken evreye göre odds'unu artırdı. Yaş yalnız ileri evre denkleminde anlamlıydı (OR = 1,055; %95 GA [1,020; 1,091]; p = 0{,}002); yaşın genel katkısı olabilirlik oranı testiyle de anlamlıydı, \chi^2(2) = 11{,}24, p = 0{,}004.
50.8 Uzman soruları
S1. MerQur katsayıları standartlaştırılmış ölçekte kestiriyor. Sonuçlar ders kitabı modelinden farklı mı?
Hayır. Doğrusal bir yeniden parametreleme ML kestirimini değiştirmez (ML değişmezliği). MerQur eğimleri s_j'ye bölerek, sabiti b_0=\tilde b_0-\sum b_jm_j ile ve sabitin SH'sini kovaryans bloğu üzerinden delta yöntemiyle geri çevirir (glm_advanced.py:900–953). Özgün ölçekte doğrudan Newton (bağımsız Python) ve R vglm ile katsayılar ve SH'ler 10^{-10} düzeyinde ya da daha yakın aynıdır. Tek fark sayısal kararlılıktır.
S2. Referans kategoriyi değiştirince neden yalnız katsayılar değişiyor?
Model, olasılıklar düzeyinde aynıdır; referans yalnızca hangi K-1 log-odds'un yazıldığını belirler. Yeni katsayılar eski katsayıların farkıdır (\boldsymbol\beta_{k|s}=\boldsymbol\beta_{k|r}-\boldsymbol\beta_{s|r}), log-olabilirlik, LR testleri, sınıflama ve olasılık tahminleri değişmez. Ancak satırlardaki Wald testleri farklı karşılaştırmaları sınar: referans medium iken age'in advanced/medium testi p=0{,}0087, referans early iken advanced/early testi p=0{,}0017'dir.
S3. Varsayılan referans neden "medium"? Başka yazılımda farklı çıkabilir mi?
MerQur referansı dilden bağımsız bir sıra kuralıyla seçer; metin etiketlerinde bu, verideki ilk görünme sırasıdır. Tıp dosyasının ilk satırı medium olduğu için referans medium'dur. Son kategoriyi referans alan yazılımlarda referans, sıralanmış değerlerin son kategorisidir (burada alfabetik son da medium'dur; eşleşme rastlantıdır). R nnet::multinom faktörün ilk düzeyini, yani alfabetik advanced'ı alır. Türkçe veri kopyasında etiketler değiştiği için alfabetik kurallar başka referans verir. Yazılım karşılaştırmalarında referans her zaman açıkça yazılmalıdır.
S4. Hausman–McFadden testi negatif çıktı. Ne anlama geliyor?
H, \mathbf V_R-\mathbf V_F farkının tersiyle kurulan karesel biçimdir. Bu fark yalnız asimptotik olarak pozitif yarı tanımlıdır; sonlu örneklemde bazı özdeğerleri negatif olabilir ve H<0 çıkar. Hausman ve McFadden (1984) bunu IIA lehine kanıt olarak yorumlamıştır; MerQur p vermez ve uyarı yazar. Cheng ve Long (2007) bu testlerin boyut özelliklerinin kötü olduğunu gösterdiği için IIA kararı test sonucuna dayandırılmamalıdır.
S5. Ayrışma olursa MerQur ne yapar?
Önce tam, sonra yarı ayrışma için doğrusal program çözer (Albert ve Anderson 1984 koşulunun çok sınıflı biçimi). Ayrışma varsa sonuç metninin başına büyük harfli uyarı, ayrıştıran değişkenlerin adları ve öneriler eklenir; Newton sonlu olmayan değer üretmişse tablo "—" gösterir. İkili lojistikteki Firth düzeltmesi bu modülde yoktur; uyarı metni ayrıştıran değişkeni çıkarmayı ya da sınıfları birleştirmeyi önerir ve Firth kestiriminin bu modülde olmadığını yazar.
S6. Uyum iyiliği p=0{,}86 çıktı. Model iyi uyuyor diyebilir miyiz?
Hayır. 250 gözlemin 250'si ayrı örüntü olduğunda her hücrenin beklenen sayısı 1'in altındadır ve X^2, D χ² dağılımına uymaz; D zaten -2\ell'ye eşittir. MerQur bu durumda uyarı yazar. Sürekli açıklayıcılarla uyum için çok sınıflı Hosmer–Lemeshow türü testler ya da kalibrasyon grafikleri gerekir; MerQur bunları bu modülde sunmaz.
S7. OR'ler R ile aynı mı? p değerleri?
Kestirim, SH (Fisher bilgisi = gözlenen bilgi, kanonik bağlantı), Wald z, p ve Wald GA'ları R ile aynı referansta aynıdır. Bazı yazılımlar Wald istatistiğini z^2 (χ², sd 1) olarak yazar; p aynıdır. R nnet::multinom BFGS ile ve varsayılan 10^{-8} göreli toleransla durduğu için katsayılarda 10^{-7} düzeyinde farklar görülebilir; nnet doğrudan p vermez.
S8. "Aşırı yayılım ölçeği" seçeneğini ne zaman kullanmalı?
Yalnız aynı kovaryat örüntüsünde çok sayıda gözlem olduğunda (gruplanmış veri) ve Pearson X^2/\text{sd} belirgin biçimde 1'den büyükse. Tek gözlemli veride \varphi yorumlanamaz; bu veride 0,93 çıkar ve SH'leri küçültür. MerQur \varphi<1'i de uygular.
50.9 Sık hatalar ve tuzaklar
- Referansı denetlememek. Referans alanı boşsa ilk görünen sınıf alınır; veri sıralaması değişince referans ve tüm katsayı satırları değişir. Klinik yorum için referans her zaman yazılmalıdır.
- OR'yi "olasılık kaç kat" diye okumak. e^{\beta}, \pi_k/\pi_r oranının çarpanıdır; \pi_k'nin kendisinin değil. Bir değişken k kategorisinin olasılığını, referansa göre odds'u artırırken bile azaltabilir (başka bir kategori daha hızlı büyüyorsa). Olasılık ölçeğindeki etkiyi görmek için Şekil 50.1 gibi tahmin eğrileri ya da 3B yüzey grafiği kullanılmalıdır. Panel künyesindeki (
CONFIG) "o sınıfta olma olasılığı referans sınıfa göre kaç kat" ifadesi bu yüzden kesin değildir. - Sıralı sonucu multinomial ile çözüp sırayı yok saymak. Evre gibi sıralı sonuçlarda sıralı model daha az parametreyle daha güçlüdür; multinomial model, orantılı odds varsayımı çiğnendiğinde ya da karşılaştırma için kullanılmalıdır.
- Satır başına Wald testini değişken testi sanmak. Bir değişken bir denklemde anlamsız, diğerinde anlamlı olabilir; değişkenin modeldeki yerine LR testiyle karar verilir.
- Az gözlemli kategori. Küçük bir kategori ayrışmaya ve çok büyük SH'lere yol açar; ayrışma uyarısı görülürse kategoriler birleştirilmelidir.
- IIA testine dayanarak modeli "doğrulamak". Test düşük güçlü ve kararsızdır; bu veride iki çıkarma iki ayrı karar verir.
- Uyum iyiliği p'sini sürekli açıklayıcılarla yorumlamak. Seyrek örüntü uyarısı görülüyorsa bu p'ler anlamsızdır.
- Adımsal seçimden sonra p'leri olduğu gibi raporlamak. Seçim süreci hesaba katılmaz; p'ler iyimserdir.
50.10 Kaynaklar
- Agresti, A. (2013). Categorical data analysis (3. baskı). Wiley.
- Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1–10. https://doi.org/10.1093/biomet/71.1.1
- Begg, C. B., & Gray, R. (1984). Calculation of polychotomous logistic regression parameters using individualized regressions. Biometrika, 71(1), 11–18. https://doi.org/10.1093/biomet/71.1.11
- Cheng, S., & Long, J. S. (2007). Testing for IIA in the multinomial logit model. Sociological Methods & Research, 35(4), 583–600. https://doi.org/10.1177/0049124106292361
- Hauck, W. W., & Donner, A. (1977). Wald's test as applied to hypotheses in logit analysis. Journal of the American Statistical Association, 72(360a), 851–853. https://doi.org/10.1080/01621459.1977.10479969
- Hausman, J., & McFadden, D. (1984). Specification tests for the multinomial logit model. Econometrica, 52(5), 1219–1240. https://doi.org/10.2307/1910997
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3. baskı). Wiley. https://doi.org/10.1002/9781118548387
- McFadden, D. (1974). Conditional logit analysis of qualitative choice behavior. P. Zarembka (Ed.), Frontiers in econometrics içinde (ss. 105–142). Academic Press.
- Nagelkerke, N. J. D. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691–692. https://doi.org/10.1093/biomet/78.3.691
- Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society. Series A (General), 135(3), 370–384. https://doi.org/10.2307/2344614