74. Diskriminant Analizi (LDA / QDA)
Analiz kimliği: discriminant · Menü adı: Diskriminant Analizi (LDA / QDA) · Panel: gui/panels/analyses/discriminant_panel.py · Motor: stats/discriminant_analysis.py, run_discriminant (satır 231–466), _canonical_discriminant (113–177), _box_m (180–226), npar_posteriors (489–539); ek çıktılar panelde _disc_extras (614–725)
74.1 Ne işe yarar
Diskriminant analizi iki soruyu birlikte yanıtlar. Sınıflama: sayısal ölçümleri bilinen yeni bir gözlem, önceden tanımlı sınıflardan hangisine atanmalıdır? Betimleme: sınıfları en iyi ayıran ölçüm birleşimleri hangileridir ve kaç boyut yeterlidir? Örnekte, beş laboratuvar ölçümünden (lökosit, CRP, kreatinin, AST, hemoglobin) hastanın sağlıklı, hafif ya da ağır sınıfında olduğu kestirilir.
Sınıflama Bayes kuralıyla yapılır:
- \mathbf x: p sayısal açıklayıcıdan oluşan gözlem vektörü.
- \pi_k: k. sınıfın önsel olasılığı; K sınıf sayısı.
- f_k: k. sınıfta çok değişkenli normal yoğunluk; \boldsymbol\mu_k sınıf ortalaması, \boldsymbol\Sigma_k sınıf kovaryans matrisi.
- LDA (doğrusal): tüm sınıflarda \boldsymbol\Sigma_k=\boldsymbol\Sigma; karar sınırları doğrusaldır. QDA (karesel): \boldsymbol\Sigma_k sınıfa göre farklı; sınırlar ikinci derecedendir.
MerQur ayrıca parametrik olmayan iki sınıflayıcı sunar: kNN ve çekirdek yoğunluğu. Sınıflayıcıdan bağımsız kanonik diskriminant fonksiyonlarını (Fisher 1936) da her çalıştırmada hesaplar.
Ne zaman kullanılır? Hedef kategorik, açıklayıcılar sayısal ve sınıf içinde yaklaşık çok değişkenli normalse; sınıfları ayıran boyutları (kanonik fonksiyonlar) yorumlamak isteniyorsa.
Ne zaman kullanılmaz?
- Açıklayıcılar kategorik ya da karışıksa: Naive Bayes ya da Multinomial Lojistik Regresyon (MerQur LDA'da yalnız sayısal sütunları kabul eder).
- Amaç açıklayıcıların etkisini OR ile kestirmek ve test etmekse: Multinomial Lojistik Regresyon; iki sınıfta İkili Lojistik Regresyon.
- Sınıfların ortalama vektörlerinin eşitliği test edilecekse (sınıf açıklayıcı, ölçümler bağımlı): MANOVA; matematik aynıdır ama soru yönü terstir.
- Açıklayıcı sayısı sınıf büyüklüğüne yaklaşıyorsa: QDA kestirilemez; LDA, Ridge ya da LASSO lojistik.
Sık karıştırılan analizler. MANOVA aynı \mathbf W ve \mathbf B matrislerinden Wilks Λ'yı hesaplar; diskriminant analizi bunların özvektörlerini (ayırıcı fonksiyonlar) ve sınıflama kuralını ekler. Lojistik regresyon sınıf olasılığını doğrudan modeller ve normallik varsaymaz; normallik ve ortak kovaryans doğruysa LDA daha verimlidir, değilse lojistik daha sağlamdır. Kümeleme (k-ortalamalar) sınıfları veriden bulur; diskriminant analizinde sınıflar bilinir.
74.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Kategorik hedef, sayısal X | En az 2 sınıf, en az 2 sayısal açıklayıcı. | 2'den az X ya da sınıf hata (discriminant_analysis.py:278–279, 307–312). |
| Çok değişkenli normallik (sınıf içinde) | LDA/QDA sınıflama kuralı ve testler buna dayanır. | Denetlenmez; parametrik olmayan yöntem seçilebilir. |
| Kovaryans matrislerinin eşitliği (LDA) | \boldsymbol\Sigma_1=\dots=\boldsymbol\Sigma_K. | Her çalıştırmada Box M testi (_box_m). |
| Yeterli örneklem | En az 20 tam satır; QDA'da her sınıfta n_k\ge p+1. | Hata (discriminant_analysis.py:303–305, 320–324). |
| Tam doğrusal bağımlılık yok | \mathbf W tekil olmamalı. | Tümü sabit X hata; kanonik çözüm ya da Box M tekilse uyarı (423–433). |
Eksik değer. Hedef ve seçilen açıklayıcılardan herhangi biri eksik olan satır çıkarılır (liste bazında; sayıya çevrilemeyen değer de eksik sayılır, discriminant_analysis.py:297–302). Tüm ek çıktılar aynı satırlarla hesaplanır.
Uç durumlar. QDA'da bir CV katının eğitim kısmında sınıf başına n\le p kalırsa CV doğruluğu "—" yazılır ve kat sayısı düşürülmez (discriminant_analysis.py:382–393). En küçük sınıf CV kat sayısından küçükse kat sayısı otomatik olarak \max(2,\min_k n_k)'ya indirilir (369). Çekirdek yönteminde yarıçap içinde hiç eğitim gözlemi olmayan gözlem sınıflanamaz ve yanlış sınıflanmış sayılır (_npar_pred, uyarı disc_npar_warn_unclassified).
74.3 Parametreler
Varsayılanlar discriminant_panel.py:43–325 ve stats_panel.py:8975–9002'ten alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Hedef sınıf | veriye bağlı | Sınıf değişkeni (metin ya da sayı kodlu). | Sınıflar MerQur düzey sırasıyla dizilir (Veri sekmesinde tanımlı sıra; yoksa sayısal ya da doğal sıra; o da yoksa verideki ilk görülme sırası). |
| Yöntem | LDA (doğrusal) | LDA, QDA (karesel), kNN, Çekirdek yoğunluk. | Sınıflama kuralı; kanonik çözüm ve Box M her yöntemde aynıdır. |
| kNN: komşu sayısı k | 5 | Yalnız kNN'de etkin. | Komşuluk büyüklüğü. |
| Çekirdek: yarıçap r | 1,0 | Yalnız çekirdekte etkin. | Yoğunluk bant genişliği. |
| Çekirdek | Uniform | Uniform, Normal, Epanechnikov, Biweight, Triweight. | Çekirdek biçimi. |
| Uzaklık metriği | Mahalanobis (havuzlanmış kovaryans) | Mahalanobis, Köşegen, Öklid. | kNN ve çekirdekte uzaklık. |
| CV kat sayısı | 5 | Karıştırmasız tabakalı k-kat CV (LDA/QDA). | Yalnız CV satırı. |
| Önsel olasılıklar | Eşit (1/K; varsayılan) | Eşit, Sınıf oranları, Kullanıcı tanımlı. | Sonsallar, sınıflama, LD yüzdeleri, Fisher sabitleri. Kanonik çözümü değiştirmez. |
| Önsel değerleri | boş (pasif) | "0.5, 0.3, 0.2" ya da "0,5; 0,3; 0,2" (çıktıdaki sınıf sırası). | Toplamı 1'e ölçeklenir. |
| Bağımsız değişkenler | en az 2 sayısal | Açıklayıcılar. | — |
| Ek çıktılar: Fisher sınıflama fonksiyonu katsayıları | kapalı | Sınıf başına doğrusal fonksiyon. | Ek tablo. |
| Ek çıktılar: Grup ortalamalarının eşitliği | kapalı | Değişken başına Wilks Λ ve F. | Ek tablo. |
| Ek çıktılar: Birini-dışarıda-bırak (LOO) | kapalı | Her gözlem kendisi olmadan sınıflanır. | Ek tablo. |
| Ek çıktılar: Adımsal değişken seçimi | kapalı | Wilks Λ ile adım tablosu. | Ek tablo; isteğe bağlı yeniden kurma. |
| Ek çıktılar: Kovaryans matrisleri | kapalı | Havuzlanmış, grup ve toplam. | Ek tablolar. |
| Ek çıktılar: Kanonik skor grafiği | kapalı | F1 × F2 saçılım + merkezler. | Grafik. |
| Ek çıktılar: Kaydet | kapalı | Dis_class, Dis1_score…, Dis_P_ |
Veri setine sütun. |
| Adımsal seçim: F-giriş / F-çıkış | 3,84 / 2,71 | Giriş ve çıkış için kısmi F eşikleri. | Seçilen değişkenler. |
| Modeli seçilen değişkenlerle yeniden kur | kapalı | Adım sonundaki kümeyle yeniden kestirim. | Tüm model. |
| Adımsal seçim yöntemi: Yön / Ölçüt | Adımsal / F | Adımsal, İleri, Geri; F ya da p. | Seçim yolu. |
| p-giriş / p-kalma | 0,15 / 0,15 | Giriş ve modelde kalma için p eşikleri. | Yalnız ölçüt p iken. |
| Grafik | Karışıklık matrisi / kanonik skorlar | 3B ayırma skorları seçilebilir. | Yalnız Grafik sekmesi. |
Önsel neden "eşit" varsayılan?
R MASS::lda ve scikit-learn sınıf oranlarını kullanır; MerQur varsayılan olarak eşit önsel kullanır (discriminant_analysis.py:238–239), çünkü eşit önsel seyrek sınıfın duyarlılığını korur (S2). Sınıflar dengeliyse iki tanım aynıdır (bu örnekte her sınıfta 35 hasta); dengesizse "Sınıf oranları" seçilmeden R ile karşılaştırma yapılmamalıdır.
74.4 Tıp örneği
Dosya: english/datasets/Tip/84_diskriminant_3sinif_5lab.xlsx (Türkçe kopya samples/Tum_Analiz_Tip/84_diskriminant_3sinif_5lab.xlsx). Değişken seçimi VIDEO_SCRIPT_TR.txt #84'ten.
| Değişken | Rol | Tür | Sınıf ortalamaları (healthy / mild / severe) |
|---|---|---|---|
class |
Hedef | 3 sınıf | 35 / 35 / 35 |
WBC_K_uL |
Açıklayıcı | sürekli (10³/µL) | 7,79 / 15,05 / 22,27 |
CRP_mg_L |
Açıklayıcı | sürekli (mg/L) | 5,29 / 78,83 / 193,21 |
creatinine |
Açıklayıcı | sürekli (mg/dL) | 0,92 / 1,51 / 3,05 |
AST_U_L |
Açıklayıcı | sürekli (U/L) | 24,66 / 59,17 / 112,40 |
Hb_g_dL |
Açıklayıcı | sürekli (g/dL) | 14,07 / 11,05 / 8,06 |
n ve eksik değer: 105 hasta, eksik değer yok.
Klinik soru: Beş laboratuvar ölçümü hastalık şiddet sınıfını ne doğrulukla ayırır ve ayrımı hangi ölçüm birleşimi taşır?
Bu veri kusursuz ayrışır
Bu sentetik veride her açıklayıcının sınıf aralıkları tek başına çakışmaz (ör. kreatinin: healthy 0,71–1,09; mild 1,17–1,84; severe 2,45–3,60). Bu nedenle LDA, QDA, kNN ve çekirdek yöntemlerinin hepsi %100 doğruluk verir ve sonsallar 1'e çok yakındır. Formüller ve doğrulama için veri yeterlidir; ama yöntemler arası doğruluk farkı bu veride gösterilemez. Box M testi ise kovaryans farkını açıkça gösterir (74.6, Adım 4).
Seçilen ayarlar: LDA, eşit önsel, 5 kat; tüm ek çıktılar açık. Ayrıca sınıf oranı önseli, kullanıcı önseli (0,2 / 0,3 / 0,5), QDA, kNN (k = 5, Mahalanobis) ve normal çekirdek (r = 1, Mahalanobis) ile ayrı çalıştırmalar ve p ölçütlü adımsal/ileri seçim.
74.5 Formüller ve hesap adımları
MerQur'un hesap sırası: (1) tam satırlar alınır, sınıflar MerQur düzey sırasıyla dizilir, önsel vektörü kurulur; (2) seçilen yöntemle sınıflayıcı uydurulur (LDA/QDA: scikit-learn; kNN/çekirdek: MerQur kodu), tüm veride yeniden yerine koyma doğruluğu ve CV doğruluğu hesaplanır; (3) yöntemden bağımsız olarak kanonik diskriminant çözümü ve Box M testi hesaplanır; (4) istenen ek çıktılar (Fisher fonksiyonları, tek değişkenli testler, LOO, adımsal seçim, kovaryanslar, skorlar) panelde aynı satırlardan üretilir.
74.5.1 Temel matrisler
- \mathbf W: grup içi kareler ve çarpımlar toplamı (SSCP) matrisi; \mathbf B: gruplar arası SSCP; \mathbf T: toplam SSCP.
- \bar{\mathbf x}: genel ortalama (gözlem ağırlıklı); n_k sınıf büyüklüğü, N=\sum n_k.
- \mathbf S_p: havuzlanmış grup içi kovaryans (\boldsymbol\Sigma'nın yansız kestirimi); \mathbf S_k: k. sınıfın kovaryansı.
Neden N-K?
Her sınıfta ortalama kestirildiği için K serbestlik derecesi harcanır; \mathbf W/(N-K) ortak kovaryansın yansız kestirimidir. Aynı bölen MANOVA'daki hata kareler ortalaması matrisidir.
74.5.2 LDA sınıflama kuralı ve Fisher sınıflama fonksiyonları
Ortak kovaryansta \ln\{\pi_kf_k(\mathbf x)\}'in k'ye bağlı kısmı doğrusaldır:
- \delta_k: k. sınıfın Fisher sınıflama fonksiyonu; \mathbf a_k katsayılar, b_k sabit.
- b_k önseli içerir: önsel değişince yalnız sabitler kayar.
- Eşdeğer biçim: \delta_k(\mathbf x)=-\tfrac12D_k^2(\mathbf x)+\ln\pi_k+c(\mathbf x); D_k^2=(\mathbf x-\bar{\mathbf x}_k)^{\top}\mathbf S_p^{-1}(\mathbf x-\bar{\mathbf x}_k) Mahalanobis uzaklığının karesi, c(\mathbf x)=-\tfrac12\mathbf x^{\top}\mathbf S_p^{-1}\mathbf x tüm sınıflarda aynı.
Neden doğrusal?
İki normal yoğunluğun log oranında -\tfrac12\mathbf x^{\top}\boldsymbol\Sigma^{-1}\mathbf x terimi ortak kovaryans sayesinde sadeleşir; geriye \mathbf x'te doğrusal bir fonksiyon kalır. Gözlem, önselle düzeltilmiş Mahalanobis uzaklığı en küçük olan sınıfa atanır.
Koddaki tercih: scikit-learn LDA (svd çözücü)
Sınıflayıcı LinearDiscriminantAnalysis(priors=…) ile uydurulur (discriminant_analysis.py:344–351); varsayılan çözücü svd'dir ve sınıflama kuralı yukarıdaki Fisher fonksiyonlarıyla cebirsel olarak aynıdır. "Sınıf oranları" seçilince priors=None geçilir; scikit-learn önseli eğitim oranlarından kendisi alır. Fisher katsayı tablosu ise panelde doğrudan \mathbf S_p^{-1}\bar{\mathbf x}_k formülüyle hesaplanır (discriminant_panel.py:626–630). Doğrulamada iki yolun sonsalları 10^{-24} düzeyinde aynıdır.
74.5.3 QDA
- \mathbf S_k: n_k-1 bölenli sınıf kovaryansı (scikit-learn
QuadraticDiscriminantAnalysis,reg_param = 0; RMASS::qdamethod = "moment"ile aynı). - \ln|\mathbf S_k| terimi sınıfa göre değişir; bu yüzden ikinci derece terim sadeleşmez ve sınır karesel olur.
QDA neden daha çok veri ister?
Her sınıf için p(p+1)/2 kovaryans parametresi ayrı kestirilir; \mathbf S_k'nin terslenebilmesi için n_k\ge p+1 gerekir. Bu örnekte p=5: sınıf başına 15 kovaryans parametresi, toplam 45 (LDA'da 15). MerQur bu koşulu çalıştırmadan önce denetler.
74.5.4 Kanonik diskriminant fonksiyonları
Fisher'ın sorusu şudur: hangi doğrusal birleşim z=\mathbf v^{\top}\mathbf x gruplar arası değişimin grup içi değişime oranını en büyük yapar?
- \lambda_m: m. özdeğer, yani m. fonksiyonda gruplar arası / grup içi kareler toplamı oranı; büyükten küçüğe sıralanır.
- \mathbf v_m: ham (standartlaştırılmamış) kanonik katsayılar.
- En çok \min(p,K-1) anlamlı fonksiyon vardır; burada \min(5{,}2)=2.
Koddaki tercih: Cholesky ile simetrik çözüm ve ölçekleme
\mathbf W^{-1}\mathbf B simetrik değildir. MerQur \mathbf W=\mathbf L\mathbf L^{\top} Cholesky ayrışımıyla simetrik \mathbf L^{-1}\mathbf B\mathbf L^{-\top} matrisinin özdeğerlerini bulur (discriminant_analysis.py:136–146) ve özvektörleri \mathbf v^{\top}\mathbf S_p\mathbf v=1 olacak biçimde ölçekler (147): her fonksiyonun grup içi varyansı 1'dir (R candisc coeffs.raw ile aynı). Özvektörün işareti keyfî olduğundan MerQur, standartlaştırılmış katsayıların toplamı ≥ 0 olacak biçimde yönlendirir (152–154); R candisc farklı işaret verebilir.
Fonksiyona ait türetilmiş büyüklükler:
- Sabit: skorların genel ortalamada 0 olmasını sağlar; skor =\mathbf v_m^{\top}\mathbf x+\text{sabit}_m.
- Standartlaştırılmış katsayı: değişken grup içi SS birimine çevrildiğinde katsayı; değişkenin diğerleri sabitken katkısı.
- Yapı katsayısı: değişkenle fonksiyon skoru arasındaki havuzlanmış grup içi korelasyon; tek başına ilişki. R
candiscstructureise toplam korelasyonu (cor(Y, scores)) verir. - Merkez: sınıfın ortalama skoru.
- r_{c,m}: kanonik korelasyon, fonksiyon skoru ile sınıf kuklaları arasındaki en büyük korelasyon.
74.5.5 Wilks Λ ve Bartlett testi
- \Lambda_1=|\mathbf W|/|\mathbf T|: tüm fonksiyonlar birlikte; MANOVA'daki Wilks Λ'nın aynısıdır.
- \Lambda_m (m\ge2): ilk m-1 fonksiyon çıkarıldıktan sonra kalan ayrım; "m'den sona kadar fonksiyonlar" satırı.
- \chi^2_m: Bartlett'in (1938) ki-kare yaklaşımı; sd'de m birden başlar.
Neden ardışık test?
İlk satır "hiç ayrım yok" sıfır hipotezini sınar. Reddedilirse ikinci satır "birinci fonksiyon dışında ayrım yok" hipotezini sınar; böylece kaç fonksiyonun anlamlı olduğuna karar verilir. Bu ardışık yorum, testin kendisi değil yorum kuralıdır; Bartlett yaklaşımı büyük örneklemde iyidir.
74.5.6 Önselle ağırlıklı LD yüzdeleri
Sonuç metnindeki "LDA Bileşen Açıklamaları" scikit-learn explained_variance_ratio_'dur. Gruplar arası matris önsellerle ağırlıklandırılır:
- \pi_k=n_k/N ise \mathbf B_\pi=\mathbf B ve LD yüzdeleri kanonik yüzdelere eşittir. R
MASS::ldasvd^2/sum(svd^2)aynı tanımdır. - Eşit ya da kullanıcı önselinde dengesiz sınıflarda iki yüzde farklıdır; MerQur bunu bir notla belirtir.
74.5.7 Box M testi
- M\ge0: kovaryanslar eşitken küçüktür.
- \chi^2 yaklaşımı R
heplots::boxMvebiotools::boxMile aynıdır; F yaklaşımı da Box'a (1949) dayanır. c_2<c_1^2 ise kodda Box'ın ikinci F biçimi kullanılır (discriminant_analysis.py:219–222).
Box M'yi yorumlarken
Test normallikten sapmaya ve büyük örnekleme çok duyarlıdır; anlamlı sonuç çoğu kez önemsiz farkları yansıtır. MerQur sonuç metninde \alpha=0{,}001 önerisini yazar. Anlamlı Box M, LDA'yı geçersiz kılmaz; sınıflama doğruluğu QDA ile karşılaştırılarak karar verilmelidir.
74.5.8 Tek değişkenli testler, CV ve LOO
Her açıklayıcı için \Lambda_j=W_{jj}/T_{jj} ve tek yönlü ANOVA F_j=\dfrac{(T_{jj}-W_{jj})/(K-1)}{W_{jj}/(N-K)}, sd (K-1,\,N-K) (discriminant_panel.py:635–643).
Koddaki tercih: CV katları ve SS
LDA/QDA'da CV cross_val_score(model, X, y, cv=k) ile yapılır (discriminant_analysis.py:373–381). Tam sayı cv scikit-learn'de karıştırmasız tabakalı katlar demektir: tohum yoktur, katlar sınıf içindeki satır sırasıyla oluşur. "±" değeri kat doğruluklarının n-1 bölenli SS'sidir (discriminant_analysis.py:380), MerQur'un makine öğrenmesi sınıflayıcılarıyla aynı tanım; o sınıflayıcılar (Naive Bayes, ağaçlar) ise karıştırmalı tohumlu katlar kullanır. LOO (birini dışarıda bırak) her gözlem için modeli yeniden uydurur (651–664; R lda(CV = TRUE)).
74.5.9 Adımsal değişken seçimi (Wilks Λ)
q değişkenli modelden q+1'e geçişte aday j için kısmi F:
- \Lambda_q=|\mathbf W_q|/|\mathbf T_q|: modeldeki q değişkenle Wilks Λ.
- Her adımda F'si en büyük aday girer (Λ'yı en çok düşüren). Çıkış testi aynı formülle, modelden bir değişken atılınca Λ'daki artışla yapılır.
Koddaki tercih: iki seçim yolu
Ölçüt F ve yön "Adımsal" ise sabit F eşikli yol (stepwise_wilks, discriminant_panel.py:631–713) çalışır: önce giriş, sonra çıkış; F-giriş 3,84, F-çıkış 2,71 (varsayılanlar). Ölçüt p ya da yön ileri/geri ise p eşikli yol (stepwise_wilks_sas, 509–604) çalışır: adımsal yöntemde her adımda önce çıkarma denenir; grup içi toleransı 10^{-8}'in altındaki aday girmez; az önce çıkan değişken yeniden girecekse seçim durur. Tabloya kısmi R^2, Rao F yaklaşımıyla p(\Lambda) (_wilks_p) ve ortalama karesel kanonik korelasyon ASCC =\sum\rho^2/(K-1) eklenir. Seçim varsayılanda yalnız tabloyu üretir; model tüm değişkenlerle kalır.
74.5.10 Parametrik olmayan yöntemler (kNN ve çekirdek)
- k_k: en yakın k komşudan k. sınıfta olanların sayısı; eşit uzaklıkta veri sırası (kararlı sıralama) kullanılır.
- K(u): uniform 1\{u\le1\}, normal e^{-u/2}, Epanechnikov (1-u), biweight (1-u)^2, triweight (1-u)^3 (u\le1).
- Havuzlanmış metrikte çekirdeğin normalleştirme sabiti tüm sınıflarda aynı olduğundan sadeleşir.
- LOO'da gözlem kendi komşu/çekirdek kümesinden çıkarılır ve n_k bir azalır.
74.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/discriminant/elle_hesap.py ile, MerQur ve scikit-learn LDA/QDA çağrılmadan numpy/scipy ile hesaplanmıştır.
Adım 1 — Havuzlanmış kovaryans. N-K=102. Köşegen (grup içi varyanslar):
Adım 2 — Tek değişkenli testler. Kreatinin için \Lambda=0{,}043427, F(2,\,102)=1123{,}39; diğerleri: WBC 625,61; CRP 765,59; AST 429,70; Hb 343,37 (hepsi p<0{,}001). Her değişken tek başına sınıfları güçlü ayırır.
Adım 3 — Kanonik çözüm. \mathbf W^{-1}\mathbf B'nin özdeğerleri \lambda_1=86{,}9701, \lambda_2=0{,}5942:
İki fonksiyon da anlamlıdır (p<0{,}001), ama ayrımın %99,3'ü birinci fonksiyondadır.
| Değişken | Ham F1 | Ham F2 | Std. F1 | Std. F2 | Yapı F1 | Yapı F2 |
|---|---|---|---|---|---|---|
WBC_K_uL |
0,206086 | −0,348278 | 0,3529 | −0,5964 | 0,3720 | −0,6226 |
CRP_mg_L |
0,029213 | −0,002997 | 0,5915 | −0,0607 | 0,4154 | −0,0543 |
creatinine |
3,500978 | 3,363742 | 0,6793 | 0,6527 | 0,4999 | 0,6982 |
AST_U_L |
0,042411 | 0,006147 | 0,5350 | 0,0775 | 0,3112 | −0,0494 |
Hb_g_dL |
−0,441798 | 0,390839 | −0,4240 | 0,3751 | −0,2756 | 0,4625 |
| Sabit | −10,0889 | −5,3611 |
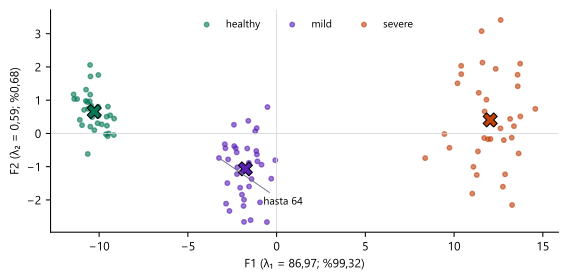
Örnek: kreatininin standart katsayısı 3{,}500978\times\sqrt{0{,}0377}=0{,}6793. Birinci fonksiyon bir "genel şiddet" eksenidir (inflamasyon ve böbrek belirteçleri artı, hemoglobin eksi). Merkezler F1'de healthy −10,275, mild −1,758, severe 12,033; F2'de mild sınıfı (−1,065) diğer ikisinden (0,658 ve 0,407) ayrılır.
Şekil 74.1. Kanonik skorlar (F1 × F2) ve sınıf merkezleri (X). Sınıflar F1 boyunca tamamen ayrışır; F2 hafif sınıfı uçlardan ayırır. İşaretli nokta 74.6, Adım 6'daki hastadır.
Adım 4 — Box M. Log-determinantlar: \ln|\mathbf S_{\text{healthy}}|=-2{,}8406, \ln|\mathbf S_{\text{mild}}|=6{,}3543, \ln|\mathbf S_{\text{severe}}|=11{,}6949, \ln|\mathbf S_p|=8{,}6837.
Kovaryanslar açıkça farklıdır (p<0{,}001): ağır sınıfta değişkenlik çok büyüktür (ör. CRP varyansı healthy 0,92, severe 1003,50). LDA varsayımı bozuktur; ancak ayrım o kadar güçlüdür ki sınıflamaya etkisi olmaz.
Adım 5 — Fisher sınıflama fonksiyonları (eşit önsel).
| healthy | mild | severe | |
|---|---|---|---|
WBC_K_uL |
3,02603 | 5,38130 | 7,71102 |
CRP_mg_L |
−0,01090 | 0,24308 | 0,64153 |
creatinine |
18,84834 | 42,87221 | 96,10122 |
AST_U_L |
0,03648 | 0,38711 | 0,98103 |
Hb_g_dL |
15,10181 | 10,66560 | 5,14788 |
| Sabit (b_k, \ln\tfrac13 dahil) | −128,21249 | −154,01333 | −371,39790 |
Adım 6 — En belirsiz hasta. LDA sonsalının en düşük olduğu gözlem 64 numaralı hastadır (mild): WBC 15,1; CRP 48,4; kreatinin 1,45; AST 62; Hb 12,2.
\delta=(130{,}7868;\ 155{,}2953;\ 39{,}0634). Mahalanobis uzaklık kareleri D^2=(53{,}372;\ 4{,}355;\ 236{,}819); nitekim \delta_{\text{healthy}}-\delta_{\text{mild}}=-\tfrac12(53{,}372-4{,}355)=-24{,}5085. Sonsal:
Sınıflama "mild"dir, olasılık 1-2{,}3\times10^{-11}. Kanonik skorları (-3{,}247;\ -0{,}738): mild merkezine (−1,758; −1,065) yakın, healthy'ye doğru kaymış. CRP'si (48,4) mild aralığının alt sınırındadır.
Adım 7 — Sınıflama ve CV. LDA, QDA, kNN ve çekirdek yöntemlerinin hepsinde yeniden yerine koyma, LOO ve 5 kat CV doğruluğu 1,0000'dır (kat SS'si 0). Önsel değişince (sınıf oranları ya da 0,2 / 0,3 / 0,5) sonsallar değişir ama sınıflama değişmez. Kullanıcı önselinde LD yüzdeleri (0,994254; 0,005746) kanonik yüzdelerden (0,993214; 0,006786) ayrılır.
Adım 8 — Adımsal seçim. Adımsal (p ölçütü) ve ileri seçim aynı yolu izler:
| Adım | Giren | Kısmi F | sd | Wilks Λ | Kısmi R^2 |
|---|---|---|---|---|---|
| 1 | creatinine | 1123,391 | 2; 102 | 0,043427 | 0,9566 |
| 2 | WBC_K_uL | 66,443 | 2; 101 | 0,018753 | 0,5682 |
| 3 | CRP_mg_L | 26,982 | 2; 100 | 0,012180 | 0,3505 |
| 4 | AST_U_L | 16,303 | 2; 99 | 0,009162 | 0,2478 |
| 5 | Hb_g_dL | 13,964 | 2; 98 | 0,007130 | 0,2218 |
İkinci adımın F'si: \dfrac{105-3-1}{2}\left(\dfrac{0{,}043427}{0{,}018753}-1\right)=50{,}5\times1{,}315723=66{,}443. Son adımda Λ, kanonik çözümdeki \Lambda_1'e eşittir.
74.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundaki canonical, box_m ve disc2 alanlarından tam hassasiyetle alınmıştır. Python hesabı genelleştirilmiş simetrik özdeğer problemini doğrudan scipy.linalg.eigh(B, W) ile çözer ve ölçeklemeyi, işaret kuralını ve türetilmiş büyüklükleri ayrıca yazar. R: 4.5.3, MASS::lda/qda (önsel, CV = TRUE), candisc::candisc (ham ve standart katsayılar; işaret MerQur kuralına göre yönlendirildi; yapı katsayısı grup içi korelasyon olarak elle), heplots::boxM (χ² ve log-determinantlar), anova(lm()); Fisher fonksiyonları ve adımsal Wilks R'de matris işlemleriyle. Box M'nin F yaklaşımı ve parametrik olmayan yöntemler için R'de hazır karşılık yoktur; bu satırlar MerQur ile bağımsız Python arasında karşılaştırılmıştır (R sütunu "—").
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Özdeğer λ1 | 86,970052 | 86,970052 | 86,970052 | 1,6e−11 | ✓ |
| Özdeğer λ2 | 0,594218 | 0,594218 | 0,594218 | 9,6e−14 | ✓ |
| Kanonik korelasyon r1 | 0,994300 | 0,994300 | 0,994300 | 1,4e−15 | ✓ |
| Kanonik korelasyon r2 | 0,610519 | 0,610519 | 0,610519 | 3,1e−14 | ✓ |
| F1 varyans yüzdesi (%) | 99,321392 | 99,321392 | 99,321392 | 2,8e−14 | ✓ |
| Wilks Λ (fonksiyon 1–2) | 0,007130 | 0,007130 | 0,007130 | 1,7e−15 | ✓ |
| Bartlett χ² (fonksiyon 1–2) | 494,337990 | 494,337990 | 494,337990 | 2,4e−11 | ✓ |
| Wilks Λ (fonksiyon 2–2) | 0,627267 | 0,627267 | 0,627267 | 3,8e−14 | ✓ |
| Bartlett χ² (fonksiyon 2–2) | 46,638347 | 46,638347 | 46,638347 | 6,0e−12 | ✓ |
| Bartlett p (fonksiyon 2) | 1,8137·10−9 | 1,8137·10−9 | 1,8137·10−9 | 5,3e−21 | ✓ |
| Ham katsayı F1: WBC_K_uL | 0,206086 | 0,206086 | 0,206086 | 1,7e−14 | ✓ |
| Ham katsayı F1: CRP_mg_L | 0,029213 | 0,029213 | 0,029213 | 8,6e−16 | ✓ |
| Ham katsayı F1: creatinine | 3,500978 | 3,500978 | 3,500978 | 1,1e−12 | ✓ |
| Ham katsayı F1: AST_U_L | 0,042411 | 0,042411 | 0,042411 | 8,7e−16 | ✓ |
| Ham katsayı F1: Hb_g_dL | −0,441798 | −0,441798 | −0,441798 | 7,2e−15 | ✓ |
| Ham sabit F1 | −10,088908 | −10,088908 | −10,088908 | 1,8e−12 | ✓ |
| Standart katsayı F2: WBC_K_uL | −0,596414 | −0,596414 | −0,596414 | 3,3e−14 | ✓ |
| Standart katsayı F2: CRP_mg_L | −0,060685 | −0,060685 | −0,060685 | 7,5e−14 | ✓ |
| Standart katsayı F2: creatinine | 0,652710 | 0,652710 | 0,652710 | 1,0e−13 | ✓ |
| Standart katsayı F2: AST_U_L | 0,077547 | 0,077547 | 0,077547 | 6,3e−14 | ✓ |
| Standart katsayı F2: Hb_g_dL | 0,375056 | 0,375056 | 0,375056 | 4,9e−14 | ✓ |
| Yapı katsayısı F1: WBC_K_uL | 0,372019 | 0,372019 | 0,372019 | 3,4e−14 | ✓ |
| Yapı katsayısı F1: CRP_mg_L | 0,415434 | 0,415434 | 0,415434 | 2,9e−14 | ✓ |
| Yapı katsayısı F1: creatinine | 0,499943 | 0,499943 | 0,499943 | 2,2e−13 | ✓ |
| Yapı katsayısı F1: AST_U_L | 0,311224 | 0,311224 | 0,311224 | 2,6e−14 | ✓ |
| Yapı katsayısı F1: Hb_g_dL | −0,275597 | −0,275597 | −0,275597 | 2,8e−14 | ✓ |
| Merkez healthy F1 | −10,275042 | −10,275042 | −10,275042 | 8,6e−13 | ✓ |
| Merkez healthy F2 | 0,658130 | 0,658130 | 0,658130 | 6,6e−14 | ✓ |
| Merkez mild F1 | −1,757799 | −1,757799 | −1,757799 | 3,4e−13 | ✓ |
| Merkez mild F2 | −1,064598 | −1,064598 | −1,064598 | 7,8e−14 | ✓ |
| Merkez severe F1 | 12,032840 | 12,032840 | 12,032840 | 1,2e−12 | ✓ |
| Merkez severe F2 | 0,406468 | 0,406468 | 0,406468 | 1,4e−14 | ✓ |
Box M, tek değişkenli testler ve Fisher fonksiyonları:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Box M | 368,645683 | 368,645683 | — | 0,0e+00 | ✓ |
| Box χ²(30) | 342,944895 | 342,944895 | 342,944895 | 4,0e−13 | ✓ |
| ln | Shealthy | −2,840636 | −2,840636 | −2,840636 | |
| ln | Smild | 6,354337 | 6,354337 | 6,354337 | |
| ln | Ssevere | 11,694909 | 11,694909 | 11,694909 | |
| ln | Shavuz | 8,683710 | 8,683710 | 8,683710 | |
| Box F | 11,420314 | 11,420314 | — | 0,0e+00 | ✓ |
| Box F sd2 | 32967,198044 | 32967,198044 | — | 0,0e+00 | ✓ |
| Tek değişkenli F: WBC_K_uL | 625,610211 | 625,610211 | 625,610211 | 6,8e−13 | ✓ |
| Tek değişkenli F: CRP_mg_L | 765,585223 | 765,585223 | 765,585223 | 1,1e−13 | ✓ |
| Tek değişkenli F: creatinine | 1123,390936 | 1123,390936 | 1123,390936 | 1,8e−12 | ✓ |
| Tek değişkenli F: AST_U_L | 429,696809 | 429,696809 | 429,696809 | 1,1e−12 | ✓ |
| Tek değişkenli F: Hb_g_dL | 343,374455 | 343,374455 | 343,374455 | 3,4e−13 | ✓ |
| Tek değişkenli Wilks Λ: creatinine | 0,043427 | 0,043427 | 0,043427 | 7,6e−17 | ✓ |
| Fisher katsayısı severe: WBC_K_uL | 7,711015 | 7,711015 | 7,711015 | 7,1e−15 | ✓ |
| Fisher katsayısı severe: CRP_mg_L | 0,641529 | 0,641529 | 0,641529 | 1,1e−16 | ✓ |
| Fisher katsayısı severe: creatinine | 96,101218 | 96,101218 | 96,101218 | 9,9e−14 | ✓ |
| Fisher katsayısı severe: AST_U_L | 0,981033 | 0,981033 | 0,981033 | 1,1e−16 | ✓ |
| Fisher katsayısı severe: Hb_g_dL | 5,147883 | 5,147883 | 5,147883 | 3,4e−14 | ✓ |
| Fisher sabiti healthy (eşit önsel) | −128,212495 | −128,212495 | −128,212495 | 0,0e+00 | ✓ |
| Fisher sabiti mild (eşit önsel) | −154,013329 | −154,013329 | −154,013329 | 1,1e−13 | ✓ |
| Fisher sabiti severe (eşit önsel) | −371,397903 | −371,397903 | −371,397903 | 6,3e−13 | ✓ |
| Havuzlanmış varyans: WBC_K_uL | 2,932532 | 2,932532 | 2,932532 | 4,4e−15 | ✓ |
| Havuzlanmış varyans: CRP_mg_L | 409,953350 | 409,953350 | 409,953350 | 0,0e+00 | ✓ |
| Havuzlanmış varyans: creatinine | 0,037653 | 0,037653 | 0,037653 | 1,4e−17 | ✓ |
| Havuzlanmış varyans: AST_U_L | 159,149580 | 159,149580 | 159,149580 | 2,8e−13 | ✓ |
| Havuzlanmış varyans: Hb_g_dL | 0,920868 | 0,920868 | 0,920868 | 6,7e−16 | ✓ |
Sınıflama, adımsal seçim ve parametrik olmayan yöntemler:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| LDA sonsalları (önsel eşit) | (105 × 3) | (105 × 3) | (105 × 3) | 4,4e−16 | ✓ |
| LDA sonsalları (önsel oran) | (105 × 3) | (105 × 3) | (105 × 3) | 4,4e−16 | ✓ |
| LDA sonsalları (önsel 0,2/0,3/0,5) | (105 × 3) | (105 × 3) | (105 × 3) | 4,4e−16 | ✓ |
| LDA doğruluğu (eğitim) | 1 | 1 | 1 | 0,0e+00 | ✓ |
| LDA LOO doğruluğu | 1 | 1 | 1 | 0,0e+00 | ✓ |
| LDA 5-kat CV ortalaması | 1 | 1 | 1 | 0,0e+00 | ✓ |
| LD1 oranı (önsel ağırlıklı, eşit) | 0,993214 | 0,993214 | 0,993214 | 1,1e−16 | ✓ |
| LD1 oranı (önsel ağırlıklı, 0,2/0,3/0,5) | 0,994254 | 0,994254 | 0,994254 | 4,4e−16 | ✓ |
| QDA sonsalları (eşit önsel) | (105 × 3) | (105 × 3) | (105 × 3) | 1,4e−31 | ✓ |
| QDA LOO doğruluğu | 1 | 1 | 1 | 0,0e+00 | ✓ |
| Adım 1 (creatinine): kısmi F | 1123,390936 | 1123,390936 | 1123,390936 | 1,8e−12 | ✓ |
| Adım 1: Wilks Λ | 0,043427 | 0,043427 | 0,043427 | 3,5e−17 | ✓ |
| Adım 2 (WBC_K_uL): kısmi F | 66,443498 | 66,443498 | 66,443498 | 2,0e−13 | ✓ |
| Adım 2: Wilks Λ | 0,018753 | 0,018753 | 0,018753 | 3,5e−17 | ✓ |
| Adım 3 (CRP_mg_L): kısmi F | 26,982160 | 26,982160 | 26,982160 | 7,2e−13 | ✓ |
| Adım 3: Wilks Λ | 0,012180 | 0,012180 | 0,012180 | 1,7e−16 | ✓ |
| Adım 4 (AST_U_L): kısmi F | 16,303050 | 16,303050 | 16,303050 | 5,0e−13 | ✓ |
| Adım 4: Wilks Λ | 0,009162 | 0,009162 | 0,009162 | 3,3e−17 | ✓ |
| Adım 5 (Hb_g_dL): kısmi F | 13,963747 | 13,963747 | 13,963747 | 2,2e−13 | ✓ |
| Adım 5: Wilks Λ | 0,007130 | 0,007130 | 0,007130 | 5,0e−17 | ✓ |
| kNN (k = 5): sonsallar | (105 × 3) | (105 × 3) | — | 0,0e+00 | ✓ |
| kNN (k = 5): LOO sonsalları | (105 × 3) | (105 × 3) | — | 0,0e+00 | ✓ |
| kNN (k = 5): LOO doğruluğu | 1 | 1 | — | 0,0e+00 | ✓ |
| Normal çekirdek (r = 1): sonsallar | (105 × 3) | (105 × 3) | — | 1,7e−24 | ✓ |
| Normal çekirdek (r = 1): LOO sonsalları | (105 × 3) | (105 × 3) | — | 2,5e−24 | ✓ |
| Normal çekirdek (r = 1): LOO doğruluğu | 1 | 1 | — | 0,0e+00 | ✓ |
85 büyüklüğün tamamı eşleşmiştir. R candisc ile ham katsayılar arasındaki en büyük fark 1{,}1\times10^{-12}'dir.
74.7 Çıktıyı okuma
Sonuç metni (LDA, eşit önsel, kısaltılmış):
Doğrusal Diskriminant Analizi (LDA)
  N (gözlem)     : 105
  Önsel olasılıklar (Eşit (1/K; varsayılan)): healthy = 0.3333, mild = 0.3333, severe = 0.3333
Model Performansı (eğitim):
  Doğruluk = 1.0000
CV doğruluk (5 katlı) = 1.0000 ± 0.0000
LDA Bileşen Açıklamaları (önsel olasılıklarla ağırlıklı):
  LD1: %99.32
  LD2: %0.68
Box's M Testi (kovaryans matrislerinin eşitliği):
  Box's M = 368.6457
  χ²(30) = 342.9449, p < .001
  F(30, 32967.20) = 11.4203, p < .001
Kanonik Diskriminant Fonksiyonları — Özdeğerler:
           Özdeğer        %   Kümülatif %     Kanonik r
  F1       86.9701    99.32         99.32        0.9943
  F2        0.5942     0.68        100.00        0.6105
Wilks' Lambda (Bartlett χ²) — fonksiyonların anlamlılığı:
  Fonksiyon 1–2        Λ = 0.0071, χ²(10) = 494.3380, p < .001
  Fonksiyon 2          Λ = 0.6273, χ²(4) = 46.6383, p < .001
Standartlaştırılmış Kanonik Diskriminant Katsayıları (grup-içi SD):
  creatinine                  0.6793      0.6527
Grup Merkezlerinde Fonksiyon Değerleri (centroids):
  healthy                   -10.2750      0.6581
  mild                       -1.7578     -1.0646
  severe                     12.0328      0.4065
── APA 7 ÖZET ──
LDA: Doğruluk = 1.00, CV-5 = 1.00 (SD = 0.00), N = 105, k = 3
F1: Özdeğer = 86.97, Rc = .99, Λ = .007, χ²(10, N = 105) = 494.34, p < .001; Box's M = 368.65, F(30, 32967) = 11.42, p < .001
| Öğe | Nasıl yorumlanır |
|---|---|
| Doğruluk / CV / LOO | Eğitim doğruluğu iyimserdir; LOO ve CV genelleme doğruluğudur. Aralarındaki büyük fark aşırı uyumu gösterir. |
| Özdeğer, %, kanonik r | Fonksiyonun ayırma gücü. r_c^2=0{,}9887: birinci fonksiyon skorlarındaki varyansın %98,9'u sınıf farkıdır. |
| Wilks Λ satırları | "1–2" satırı genel ayrımın testi (MANOVA'yla aynı); "2" satırı birinci fonksiyon dışında ayrım kalıp kalmadığını sınar. |
| Standart katsayılar | Diğer değişkenler sabitken katkı; eşdoğrusal değişkenlerde işaret ve büyüklük kararsızdır. |
| Yapı matrisi | Değişkenin fonksiyonla tek başına ilişkisi; fonksiyonu adlandırmak için bunu kullanın. MerQur değişken sırasıyla yazar. |
| Merkezler | Sınıfların fonksiyon üzerindeki konumu; işaret keyfîdir. |
| Box M | p<0{,}001 ise kovaryanslar farklı; QDA ile karşılaştırın. |
| Fisher fonksiyonları | Yeni hastayı elle sınıflamak için; sabitler önseli içerir. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Hastalık şiddet sınıfını (sağlıklı, hafif, ağır; her biri n = 35) lökosit, CRP, kreatinin, AST ve hemoglobin düzeylerinden ayırmak için eşit önsel olasılıklı doğrusal diskriminant analizi yapıldı. İki kanonik fonksiyonun ikisi de anlamlıydı; birinci fonksiyon ayrımın %99,3'ünü açıkladı (özdeğer = 86,97, kanonik r = 0{,}99), Wilks \Lambda = 0{,}007, \chi^2(10, N = 105) = 494{,}34, p < 0{,}001; ikinci fonksiyon için \Lambda = 0{,}63, \chi^2(4) = 46{,}64, p < 0{,}001. Birinci fonksiyonda en yüksek yapı katsayıları kreatinin (0,50) ve CRP'ye (0,42) aitti. Box M testi kovaryans matrislerinin eşit olmadığını gösterdi, F(30;\ 32967) = 11{,}42, p < 0{,}001; buna karşın hem doğrusal hem karesel sınıflamada birini dışarıda bırakma doğruluğu %100 idi.
74.8 Uzman soruları
S1. Önsel olasılık kanonik fonksiyonları değiştirir mi?
Hayır. Kanonik çözüm \mathbf W ve gözlem ağırlıklı \mathbf B'den hesaplanır, önsele bağlı değildir. Önsel yalnız sınıflama kuralının sabitlerini (\ln\pi_k), sonsalları ve scikit-learn/MASS tanımındaki "LD yüzdelerini" değiştirir. Bu örnekte kullanıcı önseli (0,2 / 0,3 / 0,5) LD1 yüzdesini 99,321'den 99,425'e taşır, kanonik % aynı kalır.
S2. Eşit önsel mi, sınıf oranı mı? MerQur hangisini kullanıyor?
R MASS::lda varsayılanı prior = proportions'tır. MerQur eşit önseli varsayılan yapar. Dengesiz sınıflarda iki tanım farklı sınıflama verir: oran önseli sık sınıfı kayırır, toplam doğruluğu artırır; eşit önsel seyrek sınıfın duyarlılığını korur. Raporda hangisinin kullanıldığı yazılmalıdır.
S3. Box M anlamlıyken LDA kullanılabilir mi?
Kullanılabilir. Box M normallikten sapmaya çok duyarlıdır ve büyük örneklemde önemsiz farkları da anlamlı bulur. Karar kuralı, LOO ya da CV doğruluğunu LDA ve QDA arasında karşılaştırmaktır. QDA çok daha fazla parametre kestirir; küçük sınıflarda varyansı yüksektir ve çoğu kez LDA'dan kötü sınıflar. Bu örnekte iki yöntem de %100 doğruluk verir.
S4. Ham katsayıların işareti başka bir programdakinden ters çıktı. Hangisi doğru?
İkisi de. Özvektörün işareti keyfîdir; MerQur standart katsayıların toplamı negatif olmayacak biçimde yönlendirir. Başka programlar (ör. R candisc) kendi kurallarıyla farklı işaret verebilir; o zaman ham ve standart katsayılar, yapı katsayıları, merkezler ve skorlar birlikte işaret değiştirir. Yorum değişmez.
S5. Yapı matrisi neden R candisc'in `structure` çıktısından farklı?
MerQur yapı katsayısını havuzlanmış grup içi korelasyon olarak hesaplar. R candisc structure ise toplam korelasyonu verir (sınıflar birleştirilmiş). Ayrım güçlü olduğunda toplam korelasyon büyük ölçüde sınıf ortalamaları arasındaki farkı yansıtır; grup içi tanım, sınıf içindeki ortak değişimi gösterir. Doğrulamada R tarafında grup içi tanım elle hesaplanmıştır.
S6. CV doğruluğu neden tohuma bağlı değil?
LDA/QDA'da MerQur cross_val_score(cv=k) kullanır; scikit-learn bunu karıştırmasız StratifiedKFold'a çevirir. Katlar her sınıf içinde satır sırasıyla oluşur; tohum yoktur ve sonuç deterministiktir. Ancak veri sınıfa ya da zamana göre sıralıysa katlar sıra bloklarıdır; bu, Naive Bayes ve ağaçlardaki karıştırmalı, tohumlu CV'den farklıdır. Sıra bağımsızlığı istenirse LOO tercih edilmelidir.
S7. Kategorik bir değişkeni (ör. cinsiyet 0/1) eklemek doğru mu?
Teknik olarak eklenebilir (sayısal sütun kabul edilir), ama 0/1 değişken çok değişkenli normal olamaz; Box M ve Bartlett testleri anlamını yitirir, sınıflama kuralı yaklaşık kalır. Karma veride Naive Bayes ya da multinomial lojistik regresyon daha uygundur. LDA'nın sınıflama kuralı normallik bozulsa da çoğu kez makul çalışır, testler çalışmaz.
S8. kNN'de neden sınıf büyüklüğüne bölünüyor?
MerQur'un kNN tanımında (74.5.10) sınıf yoğunluğu \hat f_k(\mathbf x)\propto k_k/n_k'dir: komşuların içindeki sınıf payı, o sınıfın örneklemdeki büyüklüğüne göre düzeltilir. Sonra önselle çarpılır. Böylece büyük sınıf yalnız büyük olduğu için kayırılmaz; sınıf ağırlığını önsel belirler. Basit çoğunluk oyu (scikit-learn KNeighborsClassifier) bu düzeltmeyi yapmaz; ikisi dengesiz sınıflarda farklı sonuç verir.
S9. Adımsal seçimde F eşikli ve p eşikli yollar neden farklı değişken kümeleri verebilir?
F eşikli yol sabit F-giriş/F-çıkış eşikleri (3,84 / 2,71) kullanır; p eşikli yol p eşikleri (0,15 / 0,15) kullanır ve her adımda önce çıkarmayı dener. F eşiği serbestlik derecesinden bağımsızdır, p eşiği değildir. MerQur ikisini de sunar. Bu örnekte iki yol da beş değişkeni aynı sırayla seçer.
74.9 Sık hatalar ve tuzaklar
- Eğitim doğruluğunu raporlamak. Yeniden yerine koyma doğruluğu iyimserdir; LOO ya da CV verilmelidir. Bu veri kusursuz ayrıştığı için ikisi de 1'dir; gerçek veride fark büyüyebilir.
- "LD yüzdesi" ile kanonik yüzdeyi karıştırmak. İlki önselle, ikincisi gözlem sayısıyla ağırlıklıdır; dengesiz sınıflarda ve eşit olmayan önselde farklıdır.
- Standart katsayıyla değişken önemini sıralamak. Eşdoğrusal değişkenlerde standart katsayılar kararsızdır, işaret değiştirebilir; yorum yapı katsayılarıyla yapılmalıdır.
- Kullanıcı önselinin sırası. Değerler çıktıdaki sınıf sırasıyla eşlenir; sayı adedi sınıf sayısına eşit değilse analiz durur.
- Sıralı veride CV. CV karıştırmasızdır; satırlar sınıf içinde zamana göre sıralıysa katlar zaman bloklarıdır.
- Grafiği sınıflama sanmak. Varsayılan grafik karışıklık matrisidir; kanonik skor grafiği "Kanonik skor grafiği" ek çıktısıyla gelir. 3B grafik en az üç fonksiyon (dört sınıf ve üç değişken) ister.
- QDA'yı küçük sınıfta zorlamak. n_k\le p ise QDA kurulmaz; CV katlarında da bu koşul aranır, sağlanmazsa CV "—" olur.
74.10 Kaynaklar
- Bartlett, M. S. (1938). Further aspects of the theory of multiple regression. Mathematical Proceedings of the Cambridge Philosophical Society, 34(1), 33–40. https://doi.org/10.1017/S0305004100019897
- Box, G. E. P. (1949). A general distribution theory for a class of likelihood criteria. Biometrika, 36(3–4), 317–346. https://doi.org/10.1093/biomet/36.3-4.317
- Fisher, R. A. (1936). The use of multiple measurements in taxonomic problems. Annals of Eugenics, 7(2), 179–188. https://doi.org/10.1111/j.1469-1809.1936.tb02137.x
- Lachenbruch, P. A., & Mickey, M. R. (1968). Estimation of error rates in discriminant analysis. Technometrics, 10(1), 1–11. https://doi.org/10.1080/00401706.1968.10490530
- Rencher, A. C., & Christensen, W. F. (2012). Methods of multivariate analysis (3. baskı). Wiley. https://doi.org/10.1002/9781118391686
- Venables, W. N., & Ripley, B. D. (2002). Modern applied statistics with S (4. baskı). Springer. https://doi.org/10.1007/978-0-387-21706-2