65. Gerçek Beceri İstatistiği (TSS)
Analiz kimliği: tss · Menü adı: TSS · Panel: gui/panels/analyses/tss.py (form 39–135, read_options 138–152, execute 157–164, ek metin 167–233) · Motor: stats/classification_eval.py, ClassificationEval.tss (satır 357–397), _tss_main (399–497), _tss_independent (499–641); eşik ölçütleri _select_threshold (846–880), ekler _tss_extras (910–955), Kappa _kappa_stats (883–907)
65.1 Ne işe yarar
Gerçek beceri istatistiği (True Skill Statistic, TSS), ikili bir sınıflayıcının tek bir eşikte duyarlılık ve özgüllüğünü tek sayıda toplar. Cevapladığı soru şudur: "Bu eşikte model, rastgele bir tahminden ne kadar daha iyi ayırıyor?"
- Se (duyarlılık): pozitiflerin doğru sınıflanan oranı; Sp (özgüllük): negatiflerin doğru sınıflanan oranı.
- DP, YP, DN, YN: doğru pozitif, yanlış pozitif, doğru negatif, yanlış negatif sayıları.
- TSS = 1 kusursuz, 0 rastgele, < 0 rastgeleden kötü (sınıflar ters). Değer aralığı [-1;\ 1].
TSS, meteorolojide Peirce (1884) beceri skoru ve Hanssen–Kuipers ayırıcısı olarak, tanı testlerinde Youden J olarak bilinir. Allouche, Tsoar ve Kadmon (2006) tür dağılım modellerinde (SDM) Kappa'nın yerine önermiştir; çünkü TSS, Kappa'nın aksine prevalanstan doğrudan etkilenmez. MerQur TSS'i varsayılan olarak seçilen yordayıcılarla uydurduğu lojistik modelin olasılıklarından, Youden eşiğinde hesaplar; isteğe bağlı olarak hazır bir olasılık sütunu, bağımsız test seti ya da k-kat çapraz doğrulama kullanır.
Ne zaman kullanılır?
- Tür varlık/yokluk modellerinde (MaxEnt, RF, GLM) tek eşikte başarım raporu için.
- Sınıflar dengesizken (prevalans 0,1 ya da 0,8) Kappa ya da doğruluk yerine.
- Bir modelin bağımsız test setindeki ya da çapraz doğrulamadaki başarımını eşikle birlikte raporlamak için.
Ne zaman kullanılmaz?
- Eşikten bağımsız bir ayırma özeti isteniyorsa: ROC Curve (Bölüm 64), AUC.
- Tahmin sütunu zaten hazırsa ve on metrik birlikte isteniyorsa: Confusion Matrix Metrics (Bölüm 66); orada Youden J = TSS'tir.
- Sonuç ikiden çok sınıfa sahipse: hedef tam iki değer içermelidir (
classification_eval.py:665–666). - Amaç model katsayılarını yorumlamaksa: Logistic Regression (Bölüm 46).
Sık karıştırılan analizler. TSS, ROC panelindeki Youden J ile aynı formüldür; fark, ROC'un tek değişkende ham değişkeni skor alması, TSS'in ise her zaman lojistik olasılık (ya da hazır olasılık) kullanmasıdır. Cohen Kappa da bir eşikte uyumu ölçer, ama beklenen uyumu marjinallerden hesapladığı için prevalansa duyarlıdır. TSS'in "prevalanstan bağımsız" olması, Se ve Sp'nin sınıf içi oranlar olmasından gelir; eşik seçimi ise prevalansa bağlı olabilir.
65.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| İkili hedef | Tam iki farklı değer. | Değilse hata (classification_eval.py:665–666). |
| Sayısal yordayıcılar | Lojistik model için. | Sayısal olmayan ve sabit sütunlar düşer (ml/_preprocessing.py). |
| Lojistik model uygun | Logit doğrusal, ayrışma yok. | Ayrışma Konis LP ile denetlenir, uyarı (classification_eval.py:491). |
| Bağımsız birimler | Satırlar arası bağımlılık yok. | Denetlenmez; mekânsal özilişkide CV iyimser kalır. |
| Hazır olasılıkta yön | Sütun, otomatik pozitif sınıfın (ortak olay kuralı; 0/1'de 1) olasılığıdır. | Pozitif diğer sınıfsa 1 − p alınır ve not yazılır (:515–521); TSS negatif çıkarsa skor yönü uyarısı verilir. |
Eksik değer. Hedefi eksik satırlar atılır, sonra yordayıcılarda (ya da olasılık sütununda) eksik olan satırlar liste bazında silinir (_prepare, classification_eval.py:659, :688–693).
Uç durumlar.
- Olasılık sütunu hedefle aynıysa hata (
classification_eval.py:431–432). - Silme sonrası 10'dan az satır kalırsa hata (
min_rows=10). - Bölünmüş eğitim kümesinde bir sınıf yoksa sklearn tabakalı bölme hata verir; k, küçük sınıftaki gözlem sayısını aşamaz.
- Duyarlılık ya da özgüllüğün paydası 0 olursa (test katında bir sınıf yoksa) oran 0 sayılır (
:463–464,:545–548); karmaşıklık matrisi panelindeki gibi "tanımsız" yazılmaz.
65.3 Parametreler
Varsayılanlar tss.py:39–152 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Hedef (İkili) | ilk kategorik sütun | Gerçek durum. | |
| Bağımsız değişkenler | — | Lojistik modelin yordayıcıları. | Hazır olasılık seçilirse kullanılmaz. |
| Değerlendirme | Tüm veride (örneklem içi) | Bağımsız test seti ya da k-katlı CV. | Eşik eğitimde, TSS testte; genellikle daha küçük. |
| Test oranı | 0,30 | Tabakalı bölmede test payı. | Yalnız test setinde etkin. |
| CV kat sayısı (k) | 5 | Tabakalı, karıştırmalı k-kat. | Yalnız CV'de etkin. |
| Rastgele tohum | 42 | Bölme, CV ve bootstrap tohumu. | Örneklem içinde (bootstrap kapalıysa) devre dışı. |
| Hazır olasılık sütunu | (yok — lojistik model uydur) | Kendi modelinizin olasılığı. | Lojistik uydurulmaz. |
| Pozitif sınıf | Otomatik (ortak olay kuralı: 0/1'de 1, 1/2'de 2; iki düzeyden yalnız biri tanınan olumlu etiketse (evet, yes, var, present, pozitif …) o düzey; aksi hâlde düzey sırasındaki ikinci değer ve uyarı) | Hangi değerin "var" sayılacağı. | Se ve Sp yer değiştirir; TSS aynı kalır, eşik değişir. |
| Eşik ölçütü | Maks. duyarlılık+özgüllük (Youden) | Se = Sp, tahmini = gözlenen prevalans, maks. Kappa, Se ≥ 0,90. | Eşik ve TSS değişir. |
| Elle eşik | Otomatik | Skor ≥ eşik → pozitif. | Ölçütü geçersiz kılar. |
| TSS GA + Kappa + AUC | kapalı | TSS GA'sı, Cohen κ (ASE, z), AUC (DeLong). | Ek blok. |
| TSS GA yöntemi | Wald (bağımsız binom) | Ya da bootstrap. | Yalnız ek blok açıkken. |
Bootstrap tekrar sayısı formda yoktur: B=1000 (classification_eval.py:374). Bootstrap seçildiğinde tohum (seed) alanı etkinleşir.
Eşik ölçütü neden TSS'i bu kadar değiştiriyor?
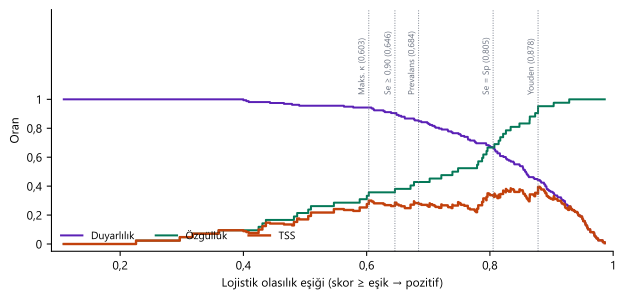
TSS bir eşiğe bağlıdır. "Maks. duyarlılık+özgüllük" tanımı gereği TSS'i en büyük yapan eşiği seçer; öteki ölçütler başka bir amaca (Se = Sp dengesi, prevalansı koruma, Kappa'yı büyütme, en az %90 duyarlılık) hizmet eder ve TSS'i her zaman küçültür. Tıp #61'de TSS, ölçüte göre 0,277 ile 0,395 arasında değişir. Bu yüzden TSS her zaman eşik ölçütüyle birlikte raporlanmalıdır; farklı ölçütlerle elde edilmiş TSS'ler karşılaştırılmaz (Liu ve ark. 2005).
65.4 Tıp örneği
Dosya: english/datasets/Tip/61_tss_disease_prediction.xlsx (Türkçe kopya: samples/Tum_Analiz_Tip/61_tss_hastalik_tahmin.xlsx).
| Değişken | Rol | Tür | Açıklama/özet |
|---|---|---|---|
disease_present |
Hedef | ikili (0/1) | 158 hasta (1), 42 sağlam (0); prevalans 0,79 |
risk_factor1 |
Yordayıcı | sürekli | 0–1 ölçekli risk puanı |
risk_factor2 |
Yordayıcı | sürekli | 0–1 ölçekli risk puanı |
prediction_score |
Hazır olasılık (isteğe bağlı) | sürekli | Dış modelin tahmin olasılığı |
patient_id |
kullanılmaz | 1–200 |
n ve eksik değer: 200 hasta, eksik değer yok.
Klinik soru: İki risk faktörüne dayalı tanı modeli hastalığı ne kadar iyi ayırıyor? Sınıflar dengesiz olduğundan doğruluk yerine TSS. (VIDEO_SCRIPT_TR.txt, #61.)
Seçilen ayarlar: Arayüz varsayılanı (örneklem içi, Youden, otomatik pozitif sınıf). Sayısal yürüyüş için ayrıca beş eşik ölçütü, elle eşik 0,5, Wald ve bootstrap GA ile ek blok, bağımsız test seti (oran 0,3, tohum 42), 5-kat CV (tohum 42) ve hazır olasılık sütunu (prediction_score; pozitif = 1 ve pozitif = 0) çalıştırılmıştır.
Şekil 65.1. Lojistik olasılık eşiğine göre duyarlılık, özgüllük ve TSS. Dikey çizgiler beş eşik ölçütünün seçtiği eşiklerdir; TSS'in tepe noktası Youden eşiğidir (0,878).
65.5 Formüller ve hesap adımları
MerQur'un sırası şudur: (1) hedefi 0/1'e çevir, eksikleri sil, (2) skoru kur: hazır olasılık yoksa cezasız ML lojistik regresyonun tahmin olasılığı, (3) eşiği seç (elle, Youden ya da başka ölçüt), (4) "skor ≥ eşik → pozitif" kuralıyla karmaşıklık matrisi, (5) Se, Sp, TSS, etiket, (6) bağımsız değerlendirmede bu adımları eğitim/test ayrımıyla tekrarla, (7) istenirse GA, Kappa ve AUC.
65.5.1 Skor: lojistik olasılık
- \hat\beta: cezasız ML katsayıları; IRLS, R
glm.fitile aynı başlangıç ve sapma ölçütü (classification_eval.py:1077–1109; ayrıntı Bölüm 64.5.1). - \hat\pi_i: 12 ondalığa yuvarlanmış olasılık (
:1117). - Hazır olasılık sütunu seçilirse \hat\pi_i yerine o sütun; pozitif sınıf olarak öteki değer seçilmişse 1-p_i (
:515–521).
Koddaki tercih
Skor, ROC ile aynı cezasız ML lojistik regresyonundan gelir; sklearn'ün L2 cezalı lojistiği kullanılmaz (:442–444). TSS her zaman olasılık ölçeğinde çalışır; tek yordayıcıda bile lojistik dönüşüm yapılır. Lojistik dönüşüm sıralamayı korur, dolayısıyla tek yordayıcıda Se, Sp ve TSS ham değişkenle aynıdır, yalnız eşiğin birimi olasılıktır.
65.5.2 Eşik ölçütleri
Aday eşikler gözlenen skorlardır, büyükten küçüğe taranır; eşitlikte ilk, yani en yüksek eşik seçilir (classification_eval.py:857–880). Her aday c için \text{DP}(c), \text{YP}(c) "skor ≥ c" ile sayılır:
- m: pozitif sayısı, n: negatif sayısı, N=m+n.
- "Duyarlılık ≥ 0,90": \text{Se}\ge0{,}90 olan en yüksek eşik (%10 ihmal oranı).
- Tanımlar
PresenceAbsence::optimal.thresholdsölçütleridir ("MaxSens+Spec", "Sens=Spec", "PredPrev=Obs", "MaxKappa", "ReqSens"). PresenceAbsence varsayılan olarak 101 noktalı bir ızgara kullanır; MerQur gözlenen skorların tamamını tarar.
PresenceAbsence ile eşik kuralı farkı
PresenceAbsence "olasılık > eşik" kuralını, MerQur "olasılık ≥ eşik" kuralını kullanır (classification_eval.py:457). Aynı sınıflama, PresenceAbsence'ta bir alttaki gözlenen olasılıkla, MerQur'da sınıflamaya giren en küçük olasılıkla yazılır. Tıp #61'de Youden noktası için PresenceAbsence 0,878116, MerQur 0,878138 yazar; Se, Sp ve TSS aynıdır.
65.5.3 TSS ve etiket
Etiket (classification_eval.py:1187–1194): < 0 rastgeleden kötü, < 0,2 zayıf, < 0,4 kabul edilebilir, < 0,6 iyi, < 0,8 çok iyi, üstü mükemmel.
TSS neden prevalanstan bağımsız sayılıyor?
Se yalnız pozitiflerin, Sp yalnız negatiflerin içinde hesaplanır. Prevalans değişip her sınıfın içindeki skor dağılımı aynı kalırsa, sabit eşikte Se ve Sp, dolayısıyla TSS değişmez. Kappa'da ise beklenen uyum p_e marjinallere bağlıdır; aynı Se ve Sp'de prevalans 0,5'ten uzaklaştıkça Kappa düşer (Allouche ve ark. 2006). Bu bağımsızlık eşik sabitken geçerlidir; "maks. Kappa" ya da "tahmini = gözlenen prevalans" ölçütüyle seçilen eşik prevalansa bağlıdır.
65.5.4 Bağımsız değerlendirme: test seti ve çapraz doğrulama
Test seti (classification_eval.py:558–568): train_test_split(test_size, random_state=seed, stratify=y) ile tabakalı bölünür; model ve eşik eğitim kümesinde bulunur, karmaşıklık matrisi ve TSS test kümesinde hesaplanır.
k-kat CV (:569–587): StratifiedKFold(k, shuffle=True, random_state=seed); her katta model ve eşik kalan k-1 katta, TSS dışarıda bırakılan katta hesaplanır:
- Ana satırdaki TSS, Se ve Sp kat ortalamalarıdır; karışıklık matrisi katların toplamıdır.
- \text{TSS}_{\text{havuz}} ek blokta (GA, Kappa, AUC ile) yazılır; kat ortalamasından biraz farklı olabilir.
- Gösterilen eşik, tüm veride uydurulan son modelin eşiğidir; katlarda kullanılan eşikler farklıdır.
- Örneklem içi TSS, "Karşılaştırma: örneklem içi (iyimser) TSS" satırında yazılır.
65.5.5 Ek blok: TSS GA'sı, Kappa ve AUC
Wald GA (classification_eval.py:923–926):
- Se ve Sp iki bağımsız binom orandır (farklı birimler); kovaryans terimi yoktur.
- GA, TSS'in tanım aralığı olan [-1;\ 1]'e kırpılır (Kappa GA'sı gibi); eşiğin aynı veride seçildiğini hesaba katmaz.
Bootstrap GA (:928–946): eşik ve sınıflama sabit tutulur, satırlar tabakasız yerine koyarak çekilir (B=1000), tek sınıflı örnekler atlanır; yüzdelik GA ve bootstrap SS. CV'de uygulanmaz, Wald'a döner.
Cohen κ (:883–907), tablo \begin{pmatrix}\text{DP}&\text{YN}\\\text{YP}&\text{DN}\end{pmatrix} üzerinde:
- ASE: Fleiss, Cohen ve Everitt (1969) H₁ varyansı; GA \hat\kappa\pm z\,\text{ASE}, [-1;\ 1]'e kırpılır.
- SE₀: H₀: κ = 0 altındaki varyans, yalnız z testinde. Ayrıntı ve gerekçe: Bölüm 29.5.3.
AUC: aynı skorların DeLong AUC'si ve GA'sı (Bölüm 64.5.4). CV'de kat-dışı (out-of-fold) skorlardan hesaplanır.
65.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/tss/elle_hesap.py ile, MerQur kodu çağrılmadan (lojistik model Newton–Raphson, eşikler doğrudan tarama) hesaplanmıştır.
Adım 1 — Lojistik model. \hat\beta_0=-4{,}2500, \hat\beta_1=5{,}1361 (risk_factor1), \hat\beta_2=4{,}2608 (risk_factor2). 200 olasılık 199 farklı değer alır (bir bağ).
Adım 2 — Youden eşiği. Taranan 199 aday eşik içinde Se + Sp en büyük değerine 0,878138'de ulaşır:
| Tahmin + | Tahmin − | Toplam | |
|---|---|---|---|
| Gerçek + | DP = 70 | YN = 88 | 158 |
| Gerçek − | YP = 2 | DN = 40 | 42 |
Bir alt olasılık (0,878116) bir sağlam bireye aittir; onu da pozitif saymak YP'yi 3'e çıkarır ve TSS'i 0,3716'ya düşürür.
Adım 3 — Öteki ölçütler.
| Ölçüt | Eşik | DP | YP | DN | YN | Se | Sp | TSS |
|---|---|---|---|---|---|---|---|---|
| Youden (maks. Se+Sp) | 0,878138 | 70 | 2 | 40 | 88 | 0,4430 | 0,9524 | 0,3954 |
| Se = Sp | 0,805193 | 105 | 14 | 28 | 53 | 0,6646 | 0,6667 | 0,3312 |
| Tahmini = gözlenen prevalans | 0,684308 | 134 | 24 | 18 | 24 | 0,8481 | 0,4286 | 0,2767 |
| Maks. Kappa | 0,603452 | 149 | 27 | 15 | 9 | 0,9430 | 0,3571 | 0,3002 |
| Se ≥ 0,90 | 0,645877 | 143 | 26 | 16 | 15 | 0,9051 | 0,3810 | 0,2860 |
| Elle eşik 0,5 | 0,5 | 151 | 32 | 10 | 7 | 0,9557 | 0,2381 | 0,1938 |
Prevalans 0,79 olduğundan "tahmini = gözlenen prevalans" ölçütü 158 pozitif tahmin ister (DP + YP = 158). Klasik 0,5 eşiği, prevalans yüksek olduğundan hemen herkesi pozitif sayar ve en düşük TSS'i verir.
Adım 4 — Wald GA.
Bootstrap (B = 1000, tohum 42, tabakasız): SE = 0,051105, GA [0{,}2957;\ 0{,}4913].
Adım 5 — Kappa. p_o=(70+40)/200=0{,}55; p_e=(72\cdot158+128\cdot42)/200^2=0{,}4188:
p=2{,}08\times10^{-6}; GA [0{,}1446;\ 0{,}3069]. TSS 0,40 "kabul edilebilir"ken κ 0,23'tür: prevalans 0,79 olduğu için p_e yüksek, κ bastırılmıştır.
Adım 6 — AUC. Aynı olasılıkların DeLong AUC'si 0,752637 (SE 0,038696).
Adım 7 — Bağımsız test seti. Tabakalı bölme: eğitim 140, test 60 (47 pozitif, 13 negatif). Eğitimde Youden eşiği 0,737464. Testte DP = 38, YP = 8, DN = 5, YN = 9; Se = 0,8085, Sp = 0,3846, TSS = 0,1931. Örneklem içi TSS (0,3954) ile fark, eşik ve modelin aynı veride seçilmesinin getirdiği iyimserliği gösterir; 13 negatifle Sp çok oynaktır.
Adım 8 — 5-kat CV. Kat TSS'leri 0,3125; 0,21875; 0,3750; 0,3871; 0,2939. Ortalama 0,3175, SS 0,0680; kat ortalaması Se 0,4869, Sp 0,8306. Havuzlanmış matris DP = 77, YP = 7, DN = 35, YN = 81 → TSS 0,3207; havuzlanmış κ 0,1947 (ASE 0,0486), kat-dışı AUC 0,7458.
Adım 9 — Hazır olasılık sütunu. prediction_score ile Youden eşiği 0,539: Se 0,8544, Sp 0,4286, TSS 0,2830. Pozitif sınıf 0 seçilirse skor 1-p alınır, eşik 0,463 olur; Se ve Sp yer değiştirir, TSS aynıdır.
65.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundan, stats.classification_eval modülünde round() bellekte etkisizleştirilerek alınmıştır (dogrulama/tss/merqur_calistir.py). R: 4.5.3; stats::glm, PresenceAbsence::optimal.thresholds (aday eşikler gözlenen olasılıklar) ve presence.absence.accuracy, irr::kappa2 (z, p), vcd::Kappa (ASE, GA), pROC (DeLong). PresenceAbsence eşiği "> eşik" kuralıyla verdiğinden R sütununa bir üstteki gözlenen olasılık yazılmıştır (Bölüm 65.5.2). Test seti ve CV için bölme indisleri MerQur'un çağırdığı sklearn fonksiyonlarıyla aynı tohumla üretilmiş (bolme_indisleri.json) ve hem Python hem R hesabına girdi olarak verilmiştir; modeller her iki tarafta bağımsız uydurulmuştur. Bootstrap satırları aynı tohumla yeniden üretimdir.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| \beta_0 (lojistik) | — | −4,250015 | −4,250015 | 4,1e−12 | ✓ |
| \beta_1 (lojistik) | — | 5,136051 | 5,136051 | 3,7e−12 | ✓ |
| \beta_2 (lojistik) | — | 4,260838 | 4,260838 | 4,6e−12 | ✓ |
| Youden (maks. Se+Sp): eşik | 0,878138 | 0,878138 | 0,878138 | 2,6e−13 | ✓ |
| Youden (maks. Se+Sp): duyarlılık | 0,443038 | 0,443038 | 0,443038 | 2,8e−16 | ✓ |
| Youden (maks. Se+Sp): özgüllük | 0,952381 | 0,952381 | 0,952381 | 3,3e−16 | ✓ |
| Youden (maks. Se+Sp): TSS | 0,395419 | 0,395419 | 0,395419 | 4,4e−16 | ✓ |
| Se = Sp: eşik | 0,805193 | 0,805193 | 0,805193 | 3,5e−13 | ✓ |
| Se = Sp: duyarlılık | 0,664557 | 0,664557 | 0,664557 | 4,4e−16 | ✓ |
| Se = Sp: özgüllük | 0,666667 | 0,666667 | 0,666667 | 3,3e−16 | ✓ |
| Se = Sp: TSS | 0,331224 | 0,331224 | 0,331224 | 5,6e−17 | ✓ |
| Tahmini = gözlenen prevalans: eşik | 0,684308 | 0,684308 | 0,684308 | 4,5e−13 | ✓ |
| Tahmini = gözlenen prevalans: duyarlılık | 0,848101 | 0,848101 | 0,848101 | 2,2e−16 | ✓ |
| Tahmini = gözlenen prevalans: özgüllük | 0,428571 | 0,428571 | 0,428571 | 4,4e−16 | ✓ |
| Tahmini = gözlenen prevalans: TSS | 0,276673 | 0,276673 | 0,276673 | 2,8e−16 | ✓ |
| Maks. Kappa: eşik | 0,603452 | 0,603452 | 0,603452 | 3,3e−13 | ✓ |
| Maks. Kappa: duyarlılık | 0,943038 | 0,943038 | 0,943038 | 3,3e−16 | ✓ |
| Maks. Kappa: özgüllük | 0,357143 | 0,357143 | 0,357143 | 1,7e−16 | ✓ |
| Maks. Kappa: TSS | 0,300181 | 0,300181 | 0,300181 | 4,4e−16 | ✓ |
| Duyarlılık ≥ 0,90: eşik | 0,645877 | 0,645877 | 0,645877 | 3,2e−13 | ✓ |
| Duyarlılık ≥ 0,90: duyarlılık | 0,905063 | 0,905063 | 0,905063 | 4,4e−16 | ✓ |
| Duyarlılık ≥ 0,90: özgüllük | 0,380952 | 0,380952 | 0,380952 | 5,6e−17 | ✓ |
| Duyarlılık ≥ 0,90: TSS | 0,286016 | 0,286016 | 0,286016 | 3,9e−16 | ✓ |
| Elle eşik 0,5: duyarlılık | 0,955696 | 0,955696 | 0,955696 | 4,4e−16 | ✓ |
| Elle eşik 0,5: özgüllük | 0,238095 | 0,238095 | 0,238095 | 8,3e−17 | ✓ |
| TSS Wald SE | 0,051396 | 0,051396 | 0,051396 | 6,9e−18 | ✓ |
| TSS Wald %95 GA alt | 0,294685 | 0,294685 | 0,294685 | 5,6e−17 | ✓ |
| TSS Wald %95 GA üst | 0,496153 | 0,496153 | 0,496153 | 5,6e−17 | ✓ |
| Kappa | 0,225740 | 0,225740 | 0,225740 | 5,6e−17 | ✓ |
| Kappa ASE (H₁) | 0,041407 | 0,041407 | 0,041407 | 0,0e+00 | ✓ |
| Kappa SE₀ (H₀) | 0,047572 | 0,047572 | — | 6,9e−18 | ✓ |
| Kappa z | 4,745199 | 4,745199 | 4,745199 | 1,8e−15 | ✓ |
| Kappa p | 2,0830·10−6 | 2,0830·10−6 | 2,0830·10−6 | 9,7e−17 | ✓ |
| Kappa %95 GA alt | 0,144584 | 0,144584 | 0,144584 | 3,3e−16 | ✓ |
| Kappa %95 GA üst | 0,306896 | 0,306896 | 0,306896 | 2,2e−16 | ✓ |
| AUC | 0,752637 | 0,752637 | 0,752637 | 3,3e−16 | ✓ |
| AUC SE (DeLong) | 0,038696 | 0,038696 | 0,038696 | 6,9e−18 | ✓ |
| AUC %95 GA alt | 0,676794 | 0,676794 | 0,676794 | 3,3e−16 | ✓ |
| Bootstrap TSS GA alt (tohum 42, B = 1000) | 0,295687 | 0,295687 | — | 5,6e−17 | ✓ |
| Bootstrap TSS GA üst | 0,491333 | 0,491333 | — | 0,0e+00 | ✓ |
| Bootstrap TSS SE | 0,051105 | 0,051105 | — | 0,0e+00 | ✓ |
| Test seti: eğitim eşiği | 0,737464 | 0,737464 | 0,737464 | 1,7e−13 | ✓ |
| Test seti: TP | 38 | 38 | 38 | 0,0e+00 | ✓ |
| Test seti: FP | 8 | 8 | 8 | 0,0e+00 | ✓ |
| Test seti: TSS | 0,193126 | 0,193126 | 0,193126 | 2,8e−17 | ✓ |
| CV kat 1 TSS | 0,312500 | 0,312500 | 0,312500 | 0,0e+00 | ✓ |
| CV kat 2 TSS | 0,218750 | 0,218750 | 0,218750 | 0,0e+00 | ✓ |
| CV kat 3 TSS | 0,375000 | 0,375000 | 0,375000 | 0,0e+00 | ✓ |
| CV kat 4 TSS | 0,387097 | 0,387097 | 0,387097 | 5,0e−16 | ✓ |
| CV kat 5 TSS | 0,293907 | 0,293907 | 0,293907 | 1,7e−16 | ✓ |
| CV TSS ortalaması | 0,317451 | 0,317451 | 0,317451 | 1,1e−16 | ✓ |
| CV TSS SS | 0,067976 | 0,067976 | 0,067976 | 2,8e−17 | ✓ |
| CV duyarlılık (kat ort.) | 0,486895 | 0,486895 | 0,486895 | 3,9e−16 | ✓ |
| CV özgüllük (kat ort.) | 0,830556 | 0,830556 | 0,830556 | 5,6e−16 | ✓ |
| CV havuzlanmış TSS | 0,320675 | 0,320675 | 0,320675 | 1,7e−16 | ✓ |
| CV havuzlanmış Kappa | 0,194729 | 0,194729 | 0,194729 | 5,8e−16 | ✓ |
| CV havuzlanmış Kappa ASE | 0,048623 | 0,048623 | 0,048623 | 2,1e−17 | ✓ |
| CV kat-dışı AUC | 0,745781 | 0,745781 | 0,745781 | 4,4e−16 | ✓ |
| CV kat-dışı AUC SE | 0,039362 | 0,039362 | 0,039362 | 3,5e−17 | ✓ |
| Hazır olasılık: eşik | 0,539000 | 0,539000 | 0,539000 | 0,0e+00 | ✓ |
| Hazır olasılık: TSS | 0,283002 | 0,283002 | 0,283002 | 5,6e−17 | ✓ |
| Hazır, pozitif = 0: eşik (1 − p) | 0,463000 | 0,463000 | 0,463000 | 5,6e−17 | ✓ |
| Hazır, pozitif = 0: duyarlılık | 0,428571 | 0,428571 | 0,428571 | 4,4e−16 | ✓ |
Sonuç: 63 büyüklüğün tamamı ölçütü karşılar.
65.7 Çıktıyı okuma
Varsayılan ayarlarla sonuç metni (APA başlığı kısaltılmıştır):
GERÇEK BECERİ İSTATİSTİĞİ (TSS)
──────────────────────────────────────────────────
TSS               : 0.3954
Eşik              : 0.8781
Duyarlılık        : 0.443
Özgüllük          : 0.9524

Karmaşıklık Matrisi:
  TP = 70   FP = 2
  FN = 88   TN = 40

Gözlem            : n = 200

TSS = 0.3954  (kabul edilebilir)
Eşik = 0.8781   |   Duyarlılık = 0.4430,  Özgüllük = 0.9524
Karmaşıklık matrisi: TP=70, FP=2, TN=40, FN=88
TSS = .40, Duyarlılık = .44, Özgüllük = .95, N = 200
"TSS GA + Kappa + AUC" açıkken eklenen blok:
── Eşik ve ek metrikler ──
  Eşik ölçütü: Maks. duyarlılık+özgüllük (Youden)  →  eşik = 0.8781   (pozitif durum: 1)
  TSS = 0.3954, SE = 0.0514, %95 GA [0.2947, 0.4962] (Wald (bağımsız binom))
  Cohen Kappa = 0.2257, ASE = 0.0414, %95 GA [0.1446, 0.3069];  H0: κ = 0 → z = 4.745, p < .001
  AUC = 0.7526, SE (DeLong) = 0.0387, %95 GA [0.6768, 0.8285]
| Satır | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| TSS ve etiket | Se + Sp − 1, eşikte | Etiket eşikleri Bölüm 65.5.3; SDM yazınında TSS > 0,5 çoğu zaman "iyi" sayılır. |
| Eşik | Olasılık ölçeğinde | "Skor ≥ eşik → pozitif". Hazır olasılıkta pozitif sınıf çevrildiyse 1-p ölçeğinde. |
| Karmaşıklık matrisi | DP, YP, YN, DN | Gövde ve grafikte satır gerçek, sütun tahmin. |
| [Bağımsız test seti] / [k-katlı CV] | Değerlendirme türü | Ek blokta eğitim/test n, kat TSS'leri ve örneklem içi karşılaştırma. |
| TSS GA | Wald ya da bootstrap | Eşiği sabit sayar; iyimser. |
| Cohen Kappa | κ, ASE, GA, z (SE₀ ile) | Prevalans yüksek/düşükse TSS'ten belirgin düşük çıkar. |
| AUC | Eşikten bağımsız ayırma | CV'de kat-dışı skorlardan. |
| Ayrışma uyarısı | Lojistik modelde tam/yarı ayrışma | Olasılıklar 0/1'e yığılır; TSS iyimser. |
| Grafik | 2×2 karmaşıklık matrisi ısı haritası | Başlıkta TSS ve eşik. |
APA biçiminde rapor cümlesi:
İki risk faktörüyle kurulan lojistik modelin ayırma başarısı gerçek beceri istatistiğiyle (TSS) değerlendirildi (n = 200; 158 hasta, 42 sağlam). Youden ölçütüyle seçilen olasılık eşiğinde (0,878) duyarlılık 0,44, özgüllük 0,95 ve TSS = 0,40 (Wald %95 GA [0,29; 0,50]) bulundu; Cohen κ = 0,23 (%95 GA [0,14; 0,31]), AUC = 0,75 idi. Beş katlı tabakalı çapraz doğrulamada TSS 0,32 ± 0,07'ye düştü.
65.8 Uzman soruları
S1. TSS ile Youden J arasında fark var mı?
Formül aynıdır: \text{Se}+\text{Sp}-1. Fark kullanım alanı ve eşiktir: Youden J çoğunlukla "eşiği seçen" ölçüt olarak, TSS ise "seçilmiş eşikteki başarım" olarak raporlanır. MerQur'da varsayılan eşik Youden olduğundan örneklem içi TSS, ROC eğrisindeki en büyük J'dir. Tıp #61'de ROC panelinin lojistik modundaki Youden noktası (Se 0,4430, 1 − Sp 0,0476) ile buradaki TSS (0,3954) aynı noktadır.
S2. Wald GA neden bağımsız binom varsayıyor; eşik seçimi varyansa girmiyor mu?
Se pozitiflerden, Sp negatiflerden hesaplandığı için bu iki oran farklı birimlere dayanır ve bağımsızdır (classification_eval.py:923). Ama eşik aynı veride TSS'i büyütmek için seçildiğinden gerçek değişkenlik daha büyüktür ve nokta kestirimi yukarı yanlıdır. Bağımsız test seti ya da CV bu yanlılığı giderir; GA'yı test kümesinin karmaşıklık matrisinden hesaplamak (ek blok test setinde zaten bunu yapar) en dürüst yoldur.
S3. Bootstrap GA'sı neden tabakasız ve neden eşik sabit?
_tss_extras satırları yerine koyarak çeker ve eşiği, dolayısıyla tahmin edilen sınıfı sabit tutar (classification_eval.py:931–942); yalnız örnekleme belirsizliği ölçülür, model ve eşik seçimi değil. Tabakasız çekiliş prevalansın da değişmesine izin verir. Çıktı satırı yöntemi "Bootstrap (yüzdelik, tabakasız, B = 1000)" diye adıyla yazar; ROC panelinin tabakalı bootstrap'ı (B=2000) ayrı bir yöntemdir.
S4. Prevalans 0,79 iken κ 0,23, TSS 0,40. Hangisi doğru?
İkisi de doğru, farklı soruları yanıtlar. κ şansla beklenen uyumu marjinallerden hesaplar: model 72 kişiyi pozitif, 128 kişiyi negatif tahmin ederken gerçekte 158 pozitif vardır; p_e=0{,}42 yüksektir. TSS ise her sınıfın içindeki doğru oranlarına bakar. Allouche ve ark. (2006) bu nedenle SDM'de TSS'i önerir. Tanı testinde PPV/NPV gibi prevalansa bağlı ölçüler de ayrıca raporlanmalıdır.
S5. CV'de neden iki farklı TSS var?
Ana satır kat TSS'lerinin ortalamasıdır (0,3175); her kat kendi eşiğiyle değerlendirilir. Ek blok, katların karmaşıklık matrislerini toplayıp tek bir TSS (0,3207) ve onun GA'sını verir (classification_eval.py:583–585, :920). biomod2 ve ENMeval kat ortalamasını raporlar; havuzlanmış değer küçük katlarda daha kararlıdır. Hangisinin raporlandığı yazılmalıdır.
S6. Bir katta hiç negatif yoksa ne olur?
Tabakalı bölme bunu büyük ölçüde önler; ama negatif sayısı k'dan küçükse sklearn hata verir. Bir test kümesinde bir sınıf yine de boş kalırsa Se ya da Sp'nin paydası 0 olur ve MerQur bu oranı 0 sayar (classification_eval.py:545–548); TSS yapay olarak düşer. Karmaşıklık matrisi paneli aynı durumda "tanımsız" yazar. Küçük sınıfta en az 2·k gözlem önerilir.
S7. Hazır olasılık sütunu neden otomatik pozitif sınıfın olasılığı sayılıyor?
Çoğu yazılım (sklearn predict_proba[:, 1], R predict(type = "response")) 0/1 hedefte 1'in olasılığını verir; MerQur bu sözleşmeyi varsayar. Pozitif sınıf olarak öteki değer seçilirse skor 1-p alınır ve not yazılır (classification_eval.py:515–521). Sütun bir olasılık değil de "küçük değer = riskli" bir skor ise TSS negatif çıkar; MerQur bu durumda skor yönünün ters olabileceğini uyarır. Sütun önceden ters çevrilmelidir.
S8. PresenceAbsence ile neden eşik farklı, TSS aynı?
PresenceAbsence "> eşik", MerQur "≥ eşik" kuralını kullanır; aynı sınıflama iki farklı sayıyla yazılır (Bölüm 65.5.2). Ayrıca PresenceAbsence varsayılanı 0,00–1,00 arası 101 noktalı ızgaradır; MerQur bütün gözlenen olasılıkları tarar. Izgara kullanılırsa bu veride Youden TSS'i biraz farklı çıkabilir. MerQur'un taraması kesin en büyüğü bulur.
65.9 Sık hatalar ve tuzaklar
- Örneklem içi TSS'i model başarımı diye raporlamak. Eşik ve model aynı veride seçilir; test seti ya da CV değerini verin.
- Eşik ölçütünü yazmamak. Aynı veride TSS 0,28 ile 0,40 arasında değişebilir.
- ROC'un bootstrap GA'sıyla TSS'inkini aynı sanmak. TSS bootstrap'ı tabakasız ve B = 1000'dir; ROC'unki tabakalı ve B = 2000'dir.
- Test setinde tüm veri n'sini raporlamak. Test setinde TSS 60 gözlemden hesaplanır; APA ve gövde test n'sini yazar.
- 0,5 eşiğini varsayılan sanmak. MerQur'da varsayılan Youden'dır; 0,5 ancak "Elle eşik" alanına yazılırsa kullanılır ve dengesiz sınıflarda kötü sonuç verir.
- Hazır olasılık sütununda yönü denetlememek. Pozitif sınıfı değiştirince not satırını okuyun.
- κ ile TSS'i aynı ölçekte yorumlamak. Etiket sınırları farklıdır; prevalans uçtayken κ düşer.
- Kat sayısını küçük sınıfa göre seçmemek. Az negatifli verilerde k = 5 ile her katta 8–9 negatif kalır; Sp ve TSS katlar arasında çok oynar (SS 0,07).
65.10 Kaynaklar
- Allouche, O., Tsoar, A., & Kadmon, R. (2006). Assessing the accuracy of species distribution models: Prevalence, kappa and the true skill statistic (TSS). Journal of Applied Ecology, 43(6), 1223–1232. https://doi.org/10.1111/j.1365-2664.2006.01214.x
- Cohen, J. (1960). A coefficient of agreement for nominal scales. Educational and Psychological Measurement, 20(1), 37–46. https://doi.org/10.1177/001316446002000104
- Fleiss, J. L., Cohen, J., & Everitt, B. S. (1969). Large sample standard errors of kappa and weighted kappa. Psychological Bulletin, 72(5), 323–327. https://doi.org/10.1037/h0028106
- Freeman, E. A., & Moisen, G. G. (2008). PresenceAbsence: An R package for presence absence analysis. Journal of Statistical Software, 23(11), 1–31. https://doi.org/10.18637/jss.v023.i11
- Liu, C., Berry, P. M., Dawson, T. P., & Pearson, R. G. (2005). Selecting thresholds of occurrence in the prediction of species distributions. Ecography, 28(3), 385–393. https://doi.org/10.1111/j.0906-7590.2005.03957.x
- Peirce, C. S. (1884). The numerical measure of the success of predictions. Science, 4(93), 453–454. https://doi.org/10.1126/science.ns-4.93.453-a