55. İç İçe Karma Model (Nested LMM)
Analiz kimliği: nested_lmm · Menü adı: Nested LMM (Multi-Level Hierarchical Mixed Model) · Panel ve EMS motoru: gui/panels/analyses/nested_lmm.py, execute (satır 428–720), _nested_anova (338–425), _reml_extras (742–831), _resid_diag (723–739) · REML motoru: stats/mixed_reml.py (Bölüm 54.5) · Çoklu karşılaştırma: stats/emm_tools.py, pairwise_ems (267–288)
55.1 Ne işe yarar
İç içe karma model, gözlemlerin iki düzeyli bir hiyerarşi içinde toplandığı ve bu hiyerarşinin bir de tekrar (blok) faktörüyle çaprazlandığı desenleri çözümler. MerQur'daki adlandırma orman genetiği döl denemelerinden gelir: bloklar (replikasyon, R) içinde populasyonlar (üst grup, P), populasyonların içinde aileler (alt grup, F). Aynı iskelet tıpta "vizit dalgası × klinik × klinikteki doktor", eğitimde "dönem × okul × okuldaki sınıf" desenine uyar.
Panelin kestirdiği doğrusal model (dengeli tasarım; P sabit, varsayılan):
- y_{ijkl}: i. replikasyon, j. üst grup, j içindeki k. alt grupta l. gözlem; i=1,\dots,r; j=1,\dots,p; k=1,\dots,f; l=1,\dots,n.
- R_i: replikasyon (blok) etkisi, sabit.
- P_j: üst grup etkisi, varsayılan sabit; isteğe bağlı rastgele.
- (RP)_{ij}: R × P etkileşimi; P sabitken sabit, P rastgeleyken rastgele.
- F_{k(j)}\sim N(0,\sigma^2_F): j. üst grup içindeki k. alt grubun rastgele etkisi. "k(j)" yazımı, k=1 etiketinin her üst grupta başka bir birimi gösterdiğini anlatır.
- (RF)_{ik(j)}\sim N(0,\sigma^2_{RF}): alt grubun replikasyondan replikasyona değişen rastgele sapması.
- \varepsilon_{ijkl}\sim N(0,\sigma^2_e): hücre içi (parsel içi) hata. Bütün rastgele terimler birbirinden bağımsızdır.
Panel üç soruyu birlikte cevaplar: (1) Üst gruplar (klinikler) ortalama olarak farklı mı? (2) Üst grubun içindeki alt gruplar (aynı klinikteki doktorlar) arasında ne kadar değişkenlik var? (3) Alt grup farkları replikasyonlar boyunca tutarlı mı (\sigma^2_{RF})? Birinci soru H_0^P:P_1=\dots=P_p hipotezidir; ikinci ve üçüncü soru varyans bileşenleriyle (\sigma^2_F, \sigma^2_{RF}) cevaplanır.
Ne zaman kullanılır
- Her alt grup yalnız bir üst grupta bulunuyorsa (her doktor tek klinikte çalışıyor) ve tasarımda bir de sabit blok/dönem faktörü varsa.
- Alt grup düzeyindeki değişkenlik başlı başına ilgi konusuysa (doktorlar arası değişkenlik, aile varyansı, kalıtım derecesi).
- Dengeli ya da hafif dengesiz desenlerde EMS F testleriyle REML varyans bileşenlerini aynı çıktıda görmek isteniyorsa.
Ne zaman kullanılmaz
- Replikasyon (blok) faktörü yoksa, yalnız "hasta → doktor → klinik" iç içeliği varsa: LMM panelinde ikinci gruplama değişkenini "iç içe" seçin (Bölüm 54.3).
- İki gruplama faktörü iç içe değil çaprazsa (her ilaç her klinikte denenmiş): Crossed LMM (Bölüm 56).
- Aynı birim zaman içinde tekrar tekrar ölçülüyorsa ve zamana bağlı hata korelasyonu önemliyse: LMM paneli (R yapısı: AR(1), UN …; Bölüm 54.5.9).
- Bağımlı değişken sayım ya da ikili ise: GLMM (Bölüm 58).
- Ana amaç yalnız varyans bileşenleri ve kalıtım derecesi ise ve tasarım bir tek iç içe hiyerarşiden oluşuyorsa: Varyans bileşenleri paneli (Bölüm 100).
Sık karıştırılan analizler. Hiyerarşik (iç içe) ANOVA yalnız EMS tablosunu verir; bu panel aynı tabloya REML varyans bileşenlerini, Satterthwaite F testlerini ve EMM'leri ekler. Karma desen (split-plot) ANOVA (Bölüm 11) bir denekler-arası ve bir denek-içi faktörle çalışır; burada "denek" yerine alt grup (doktor) vardır ve alt grubun içinde birden çok gözlem bulunur. LMM paneli (Bölüm 54) aynı REML motorunu kullanır; fark, iç içe panelin model formülünü kendisinin kurması ve EMS tablosunu da vermesidir.
55.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Sürekli bağımlı değişken | HbA1c gibi aralık/oran ölçeği | Sayısala çevrilir (nested_lmm.py:474); çevrilemeyen değer eksik sayılır |
| İç içelik | Her alt grup tek üst grupta | Denetlenmez; alt grup kimliği (P, F) çiftinden kurulur (nested_lmm.py:514–518), bu yüzden D01 etiketi her klinikte ayrı doktor sayılır |
| Rastgele etkilerin normalliği | F_{k(j)}, (RF)_{ik(j)} normal | Denetlenmez |
| Hata normalliği | \varepsilon normal | "Artık normalliği ve varyans homojenliği" kutusu: tam modelin artıklarına Shapiro–Wilk (nested_lmm.py:730–732) |
| Varyans homojenliği | Üst gruplarda eşit hata varyansı | Aynı kutu: Levene (ortalama merkezli) ve Brown–Forsythe (medyan merkezli) (nested_lmm.py:733–738) |
| Dengeli tasarım | Her hücrede eşit n, her üst grupta eşit sayıda alt grup | EMS F'leri için gerekir; dengesizlikte uyarı (nested_lmm.py:600–607, 686–691); REML tablosu dengesiz veride geçerlidir |
Eksik değer. Dört seçili sütunun (ve kovaryatların) herhangi birinde eksik olan satır liste bazında çıkarılır (stats/missing_rows.drop_missing_rows, nested_lmm.py:475–477); çıkarılan satır sayısı künyede yazılır.
Uç durumlar (kod satırlarıyla):
- n<30 ise analiz durur: "Yetersiz n" (
nested_lmm.py:478–479). Bu eşik REML motorunun değil panelin sert alt sınırıdır. - Bağımlı değişken sabitse hata (
nested_lmm.py:491–492). - Replikasyon ya da üst grup tek düzeyliyse hata (
nested_lmm.py:502–505). - Toplam alt grup sayısı üst grup sayısının iki katından azsa hata (
nested_lmm.py:506–509). - Dört rolden ikisine aynı sütun seçilirse hata (
nested_lmm.py:466–469). - Herhangi bir kaynağın sd'si 1'den küçükse hata (
nested_lmm.py:527–530); hücre başına tek gözlemde hata sd'si 0 olur, R×F(P)'nin kendi testi hesaplanamaz ama öteki testler yürür (nested_lmm.py:531–537). - Payda KO'su sıfır ya da negatifse F ve p tanımsızdır; "—" yazılır ve uyarı verilir (
nested_lmm.py:569–575,704–705). - REML adımı hata verirse EMS tablosu yine basılır, REML bölümleri yerine uyarı çıkar (
nested_lmm.py:696–701).
55.3 Parametreler
Varsayılanlar nested_lmm.py:145–311 (form ve read_options) ile stats_panel.py:6636–6649 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Bağımlı değişken | ilk sayısal sütun | Sürekli yanıt. | |
| Replikasyon (R) | ilk kategorik sütun | Sabit blok/dönem faktörü. | R, P ve F kombinasyonları tablonun bütün satırlarını belirler. |
| Üst seviye grup (P) | ilk kategorik sütun | Üst grup (klinik, populasyon). | |
| Alt seviye grup (F, P içinde) | ilk kategorik sütun | Alt grup (doktor, aile). Kimlik (P, F) çiftidir. | |
| SS yöntemi | I. tür (sıralı) | I. tür: sıralı KT; III. tür: toplam-sıfır kodlu kısmi KT. | Dengeli veride ikisi aynıdır (55.6.1); dengesizde I. tür sıraya bağlıdır. |
| Üst grup (P) tipi | Sabit (varsayılan) | Rastgele seçilirse R×P de rastgele olur. | P'nin paydası sentetik olur; R'nin paydası MS_R×P'ye geçer; REML modeline (1\mid P) ve (1\mid R{:}P) eklenir (55.5.4). |
| Kovaryat / ek sabit faktör | boş | Yalnız REML modeline eklenir (nested_lmm.py:763–768). |
EMS tablosu kovaryatsız kalır. |
| Üst grup karşılaştırmaları | (yok) | Tukey HSD, Bonferroni, Šidák ya da LSD; hata terimi MS_F(P). | P rastgeleyse uyarı verir, hesaplamaz (nested_lmm.py:704–705). |
| Artık normalliği ve varyans homojenliği | kapalı | Shapiro–Wilk, Levene, Brown–Forsythe. | Ek bölüm. |
| Kestirilen marjinal ortalama (EMM) faktörü | (yok) | REML modelinden P ya da R düzeylerinin EMM'si + ikili karşılaştırma (Satterthwaite sd). | Ek bölüm. |
| EMM p düzeltmesi | Bonferroni | Bonferroni, Šidák, Holm, Tukey, yok. | Yalnız EMM ikili p'leri. |
| Düzey sırası | boş | EMM listelerinin sırası. | Kestirim değişmez. |
| Güven Düzeyi | %95 | Grup ortalaması t-GA'sı, varyans bileşeni log-Wald GA'sı ve EMM GA'sı. | Yıldızlar ve "anlamlı" işareti de seçilen düzeyin \alpha'sına göredir. |
Neden P'nin tipi testleri değiştirir?
Bir faktörün F testinde payda, beklenen değeri paydaki terimin sıfır hipotezi altındaki beklenen değerine eşit olan kareler ortalamasıdır. P sabitken E[\mathrm{MS}_P] yalnız \sigma^2_e, \sigma^2_{RF} ve \sigma^2_F içerir; bunların hepsi E[\mathrm{MS}_{F(P)}]'de vardır. P rastgele seçildiğinde R×P de rastgele olur ve E[\mathrm{MS}_P]'ye fn\sigma^2_{RP} terimi girer. Bu terimi de içeren tek bir KO yoktur; payda üç KO'nun doğrusal birleşimi olarak kurulur (55.5.4).
55.4 Tıp örneği
- Dosya:
english/datasets/Tip/108_nested_lmm_clinical_doctor_visit_HbA1c.xlsx(Türkçe kopya:samples/Tum_Analiz_Tip/108_nested_lmm_klinik_doktor_vizit_HbA1c.xlsx). - Değişken seçimi:
VIDEO_SCRIPT_TR.txt#108: bağımlı HbA1c; faktörler visit, clinical, doctor_no.
| Değişken | Rol | Tür | Açıklama/özet |
|---|---|---|---|
| HbA1c | Bağımlı | Sürekli (%) | Ortalama 7,4606 |
| visit | Replikasyon (R) | Kategorik, 4 düzey | V1–V4; vizit ortalamaları 7,7738; 7,5288; 7,3694; 7,1703 |
| clinical | Üst grup (P) | Kategorik, 4 düzey | K_Ankara 6,8560; K_Bursa 7,1086; K_Istanbul 7,6825; K_Izmir 8,1951 |
| doctor_no | Alt grup (F) | Kategorik, her klinikte D01–D06 | 24 doktor; etiketler klinikler arasında tekrar eder |
| patient_id | — | Kimlik | 288 farklı hasta, her biri bir kez ölçülmüş |
n ve eksik değer. 288 satır, eksik yok. Desen tam dengeli: r=4 vizit × p=4 klinik × f=6 doktor × n=3 hasta.
Bu veride "visit" tekrarlı ölçüm değildir
Her hasta yalnız bir kez görünür (patient_id 288 farklı değer). "Vizit" burada hastaların hangi dalgada alındığını gösteren sabit bir bloktur; aynı hastanın zaman içindeki ölçümleri yoktur. Aynı hasta dört vizitte ölçülseydi doğru model hasta düzeyinde bir rastgele etki daha içerirdi ve bu panel yeterli olmazdı (LMM paneli, Bölüm 54).
Klinik soru. Klinikler arasında HbA1c ortalaması farklı mı? Aynı klinikteki doktorlar arasında HbA1c'nin ne kadarı doktora bağlı? Doktor farkları vizit dalgaları boyunca kalıcı mı?
Seçilen ayarlar. Varsayılanlar (I. tür KT, P sabit, %95) ve hesap yürüyüşü için: EMM faktörü = Üst grup (P) (Bonferroni), üst grup karşılaştırmaları = Tukey HSD, artık tanıları açık. Ek senaryolar: III. tür KT; P rastgele; dengesiz alt örnek (her klinikte D06 × V4 hücresinin ilk hastası çıkarılmış, 284 gözlem; III. tür).
55.5 Formüller ve hesap adımları
MerQur iki ayrı çözümleme yapar ve ikisini aynı çıktıda verir. (A) EMS tablosu: R, P, R×P, F(P), R×F(P) ve hata için KT'ler en küçük kareler ile hesaplanır; her terimin F'si beklenen kareler ortalamalarına (EMS) göre seçilen paydaya bölünerek bulunur (nested_lmm.py:338–425, 553–595). (B) REML karma modeli: aynı yapı bir doğrusal karma model olarak kestirilir; varyans bileşenleri, SH'leri, log-Wald GA'ları, Satterthwaite sd'li III. tür F testleri, EMM'ler ve kalıtım derecesi bu modelden gelir (nested_lmm.py:742–831). Dengeli veride iki yol aynı F'leri verir (55.6); dengesiz veride REML yolu esas alınmalıdır.
55.5.1 Kareler toplamları
Dengeli desende KT'ler ortalamalar arasındaki farklardan yazılabilir. \bar y_{i\cdot\cdot\cdot} replikasyon, \bar y_{\cdot j\cdot\cdot} üst grup, \bar y_{ij\cdot\cdot} R×P hücresi, \bar y_{\cdot jk\cdot} alt grup, \bar y_{ijk\cdot} R×F(P) hücresi ortalaması, \bar y genel ortalama olsun:
- r,p,f,n: replikasyon, üst grup, üst grup başına alt grup ve hücre başına gözlem sayısı.
- sd'ler: r-1, p-1, (r-1)(p-1), p(f-1), (r-1)p(f-1) ve rpf(n-1).
- KO = KT / sd.
MerQur bu kapalı biçimleri kullanmaz; KT'yi genel doğrusal model üzerinden, sütun pivotlu QR ile hesaplar. Bu yol dengesiz ve eksik hücreli veride de çalışır.
Koddaki tercih: I. ve III. tür KT
I. tür (nested_lmm.py:392–405): sabit terim, sonra R (toplam-sıfır kontrastları), P, R×P, F(P) hücre göstergeleri ve R×F(P) hücre göstergeleri sırayla eklenir; her bloğun KT'si artık KT'deki azalma, sd'si model rankındaki artıştır. Göstergeler aliaslı olsa da pivotlu QR fazla sütunları düşürür (_fit, satır 371–380).
III. tür (nested_lmm.py:406–421): tam rank toplam-sıfır parametrelemesi kurulur. R ve P için c_a=\mathbf 1[\text{düzey}=a]-\mathbf 1[\text{düzey}=\text{son}]; R×P bunların çarpımları; F(P) için her üst grubun içinde alt grup toplam-sıfır kontrastları; R×F(P) için R kontrastı × F(P)-içi kontrast. Bir terimin KT'si, o blok çıkarılınca artık KT'deki artıştır. Bu, R car::Anova(type = 3) + contr.sum ile aynı hipotezdir.
F(P) kimliği (P, F) çiftinden kurulur (nested_lmm.py:393–394, 408–412). Böylece "D01" etiketi dört klinikte dört ayrı doktordur; R'de A/B = A + A:B gösterimiyle aynıdır.
55.5.2 Beklenen kareler ortalamaları ve hata terimi seçimi (P sabit)
R ve P sabit, F(P) ve R×F(P) rastgele; dengeli desende kısıtlanmamış karma model altında beklenen KO'lar:
- Q_R, Q_P, Q_{RP}: sabit etkilerin karesel biçimleri; sıfır hipotezi altında 0'dır.
- Her satırın paydası, sıfır hipotezi altında paya eşit beklenen değerli KO'dur.
Buradan MerQur'un paydaları (nested_lmm.py:567–572):
p=1-F_{\nu_1,\nu_2}(F); \nu_1 payın, \nu_2 paydanın sd'sidir.
Neden klinikler doktorlara karşı sınanır?
Klinik ortalaması, o klinikteki altı doktorun ortalamasıdır. Doktorlar rastgele bir örneklem olduğundan, klinik ortalamaları arasındaki fark yalnız gerçek klinik farkından değil, kliniklere düşen doktorların rastgele farkından da beslenir (rn\sigma^2_F terimi). Hasta düzeyindeki hata (\mathrm{MS}_e) bu kaynağı içermez; payda olarak kullanılırsa klinik testi çok liberal olur (sahte yineleme, pseudoreplication). Bu yüzden klinik testinin sd'si 192 değil 20'dir: bilgi, 288 hastadan değil 24 doktordan gelir.
Koddaki tercih: kısıtlanmamış model
F(P)'nin paydası \mathrm{MS}_{RF(P)}'dir (nested_lmm.py:570). Bu, kısıtlanmamış (unrestricted) karma modelin EMS'sidir: E[\mathrm{MS}_{F(P)}] n\sigma^2_{RF} terimini içerir. Kısıtlı modelde (sabit R üzerinden toplamı sıfır olan RF etkileri) bu terim düşer ve F(P) \mathrm{MS}_e'ye karşı sınanır. MerQur kısıtlanmamış modeli seçer; REML modeli de bu parametrelemeye karşılık gelir. İki modelin farkı Bölüm 56.5.3'te ayrıntılı anlatılır.
55.5.3 Varyans bileşenlerinin ANOVA kestirimi
EMS denklemleri gözlenen KO'lara eşitlenip çözülürse varyans bileşenleri elde edilir:
- n: hücre başına gözlem; rn: bir alt grubun toplam gözlem sayısı.
Dengeli desende ve bütün kestirimler pozitifken bu çözüm REML kestirimiyle birebir aynıdır. MerQur ANOVA kestirimini basmaz; varyans bileşenleri tablosu REML'den gelir (55.5.5). ANOVA kestirimleri burada elle hesabı izlenebilir kılmak için verilmiştir.
55.5.4 P rastgele: sentetik payda ve Satterthwaite sd'si
P rastgele seçildiğinde R×P de rastgele olur. Dengeli desende EMS'ler değişir:
R artık \mathrm{MS}_{RP}'ye karşı sınanır (nested_lmm.py:579–580). P için tek bir KO yoktur; payda üç KO'dan kurulur (nested_lmm.py:581–591):
- \mathrm{MS}_{\text{payda}}: beklenen değeri \sigma^2_e+n\sigma^2_{RF}+rn\sigma^2_F+fn\sigma^2_{RP} olan sentetik KO.
- \nu_{\text{payda}}: Satterthwaite (1946) yaklaşık sd'si; KO'lar bağımsız ölçekli ki-kareler olduğu için \sum c_k\mathrm{MS}_k'nın varyansı 2\sum c_k^2E[\mathrm{MS}_k]^2/\nu_k ile yaklaşılır ve ki-kare momentleri eşlenir.
- F_P=\mathrm{MS}_P/\mathrm{MS}_{\text{payda}}, p: F(\nu_P,\ \nu_{\text{payda}})'dan.
Neden çıkarma işareti olan formülde de mutlak değer alınmaz?
Satterthwaite formülünün paydasındaki her terim c_k^2 ile çarpıldığından katsayının işareti kaybolur. Bu yüzden payda \mathrm{MS}^2/\nu terimlerinin toplamıdır. Sentetik KO negatif çıkarsa (\mathrm{MS}_{RP}<\mathrm{MS}_{RF(P)}-\mathrm{MS}_{F(P)}) F tanımsızdır; MerQur bu durumda F ve p'yi boş bırakır (nested_lmm.py:584–588).
Sentetik payda yalnız dengeli desende kesindir
Hücre sayıları ya da üst grup başına alt grup sayısı eşit değilse MerQur synthetic["unbalanced"] bayrağını kaldırır ve uyarı yazar (nested_lmm.py:592–595, 686–687). P sabitken de dengesizlik denetlenir; uyarı metni REML tablosunu esas almayı önerir (nested_lmm.py:586–593). MerQur'un EMS tablosu dengesiz desende de EMS katsayılarını hücre sayılarından hesaplamaz; hep dengeli katsayıları (doğrudan KO oranlarını) kullanır.
55.5.5 REML karma modeli
REML yolu (nested_lmm.py:747–769) şu modeli kurar:
- R*P: R ve P ana etkileri ile R×P etkileşimi, patsy gösterge (treatment) kodlamasıyla.
- (1\mid P{:}F): (klinik, doktor) çifti başına rastgele kesişim, varyansı \sigma^2_F.
- (1\mid R{:}P{:}F): (vizit, klinik, doktor) üçlüsü başına rastgele kesişim, varyansı \sigma^2_{RF}.
- Kovaryatlar sağ tarafa eklenir; kategorik kovaryat III. tür testlere de girer (
nested_lmm.py:763–778).
Kestirim, profillenmiş REML sapması, kovaryans parametresi SH'leri, Satterthwaite sd'si ve III. tür testler LMM bölümündeki motorla aynıdır (Bölüm 54.5.2–54.5.7); burada tekrar edilmez. Panel term_tests(fit, "satterthwaite", ["_R", "_P"] + kategorik kovaryatlar) çağırır (nested_lmm.py:777); sd yöntemi seçilemez, her zaman Satterthwaite'tir.
Varyans bileşeni tablosu, kovaryans parametresi satırlarından üretilir (nested_lmm.py:771–775). Her satırda kestirim, SH (gözlenen bilgi + delta yöntemi), Wald Z=\hat\sigma^2/\mathrm{SH}, toplam varyanstaki pay ve log-Wald GA vardır:
- \sum_m\hat\sigma^2_m: hata dahil bütün varyans bileşenlerinin toplamı.
- z_{1-\alpha/2}: standart normal yüzdeliği (%95 için 1,959964).
Neden log ölçekte GA?
Varyans pozitif bir parametredir ve kestiricisinin dağılımı sağa çarpıktır. \log\hat\sigma^2 için Wald aralığı kurulup geri dönüştürülürse (delta yöntemiyle \mathrm{SH}(\log\hat\sigma^2)\approx\mathrm{SH}/\hat\sigma^2) alt uç hiçbir zaman negatif olmaz ve aralık çarpıklığı yansıtır. Bileşen sıfır sınırındaysa (\hat\sigma^2\approx0) oran tanımsızlaşır; MerQur bu satırın GA'sını "—" bırakır (mixed_reml.py:846–863).
55.5.6 Kalıtım derecesi
"Kalıtım derecesi (h²; genetik yarım-kardeş deseni)" kutusu işaretlendiğinde (varsayılan kapalı) REML bileşenlerinden iki kalıtım derecesi hesaplanır (nested_lmm.py:816–831):
- h^2_i: bireysel dar anlamda kalıtım derecesi; 4\sigma^2_F, açık tozlanmış (yarım-kardeş) ailelerde eklemeli genetik varyansa eşittir.
- h^2_f: aile ortalaması kalıtım derecesi; paydası aile ortalamasının fenotipik varyansıdır.
- n_h: R×P×F hücre sayılarının harmonik ortalaması; m dolu hücre sayısı (
nested_lmm.py:820–821). - h^2_i>1 ise uyarı verilir (
nested_lmm.py:830–831).
Kalıtım derecesi yalnız genetik desende istenmeli
h^2 yalnız yarım-kardeş aile desenlerinde anlamlıdır; bu yüzden kutu varsayılan olarak kapalıdır. Tıp örneğinde "aile" doktordur; kutu işaretlenirse h^2_i=1{,}752 çıkar, hiçbir genetik anlam taşımaz ve "h^2>1" uyarısı da verilir. Aşağıdaki el hesabı ve çıktıda bu bölüm yalnız hesabı göstermek için açılmıştır.
55.5.7 Üst grup karşılaştırmaları ve EMM
EMS hata terimiyle karşılaştırma (nested_lmm.py:703–716, emm_tools.py:267–288): her klinik çifti için gözlenen ortalama farkı, \mathrm{MS}_{F(P)} hata terimiyle sınanır:
Tukey p'si P(q_{p,\nu}>\sqrt2\,|t|) ile (studentized range), Bonferroni \min(1,\ m\,p), Šidák 1-(1-p)^m ile düzeltilir; m=p(p-1)/2. Harf grupları Piepho (2004) ekle-çıkar algoritmasıyla kurulur.
EMM (nested_lmm.py:784–812): REML modelinden, R düzeyleri üzerinden eşit ağırlıklı klinik ortalamaları; SH ve sd Satterthwaite yöntemiyle (Bölüm 54.5.6). Dengeli desende EMM, gözlenen klinik ortalamasına; SH'si \sqrt{\mathrm{MS}_{F(P)}/(rfn)}'e, sd'si \nu_{F(P)}'ye eşittir (55.6).
55.5.8 Artık tanıları
Tanılar EMS modelinin (tam sabit etkili en küçük kareler modeli) artıklarıyla yapılır, yani e_{ijkl}=y_{ijkl}-\bar y_{ijk\cdot} (nested_lmm.py:424, 723–739). Shapiro–Wilk (3–5000 gözlem), üst gruplar arasında Levene (ortalama merkezli) ve Brown–Forsythe (medyan merkezli) F'leri verilir. REML modelinin koşullu artıkları burada kullanılmaz.
55.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/nested_lmm/elle_hesap.py ile, MerQur çağrılmadan numpy ile hesaplanmıştır. REML adımı için tam \mathbf V matrisiyle çalışan bağımsız kestirici (dogrulama/lmm/reml_bagimsiz.py) kullanılmıştır.
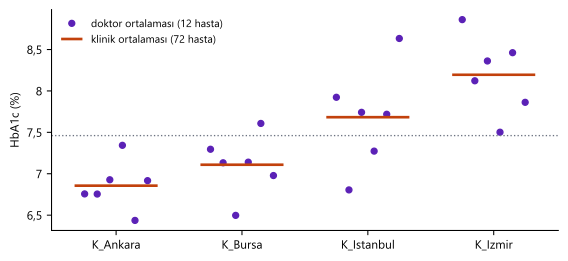
Adım 1 — Ortalamalar. Genel ortalama \bar y=7{,}460556. Klinik ortalamaları: Ankara 6,855972; Bursa 7,108611; İstanbul 7,682500; İzmir 8,195139. Her klinikte rfn=72 hasta vardır:
Ankara'daki altı doktorun ortalamaları 6,7567; 6,7550; 6,9275; 7,3433; 6,4367; 6,9167'dir; her doktorun rn=12 hastası vardır. Ankara'nın \mathrm{KT}_{F(P)}'ye katkısı 12\sum_k(\bar y_{\cdot 1k\cdot}-6{,}855972)^2=5{,}306340; dört kliniğin toplamı 49{,}933942'dir.
Şekil 55.1. Klinik içinde doktor ortalamaları (mor noktalar) ve klinik ortalamaları (turuncu çizgiler). Aynı klinikteki doktorların yayılımı \sigma^2_F'yi, turuncu çizgilerin genel ortalama (gri) çevresindeki yayılımı klinik etkisini gösterir; klinik testinin paydası mor noktaların yayılımıdır.
Adım 2 — KT, sd ve KO tablosu. Altı kaynağın tamamı aynı yoldan:
| Kaynak | KT | sd | KO | Payda | F | p |
|---|---|---|---|---|---|---|
| visit (R) | 14,061864 | 3 | 4,687288 | MS_R×F(P) | 14,2026 | 4,21·10⁻⁷ |
| clinical (P) | 77,634569 | 3 | 25,878190 | MS_F(P) | 10,3650 | 0,000251 |
| R×P | 2,346122 | 9 | 0,260680 | MS_R×F(P) | 0,7899 | 0,6266 |
| F(P) | 49,933942 | 20 | 2,496697 | MS_R×F(P) | 7,5651 | 4,68·10⁻¹⁰ |
| R×F(P) | 19,801814 | 60 | 0,330030 | MS_e | 1,8097 | 0,00134 |
| Hata | 35,014400 | 192 | 0,182367 |
Örnek, klinik satırı: F=25{,}878190/2{,}496697=10{,}3650; p=P(F_{3,\,20}>10{,}3650)=0{,}000251. Dengeli desende I. tür ve III. tür KT'ler aynıdır (55.6.1, Tablo 1).
Adım 3 — Varyans bileşenleri (ANOVA = REML).
Bağımsız REML kestiricisi aynı değerlere yakınsar (fark <10^{-11}). Toplam 0{,}412144; paylar %43,8 (doktor), %11,9 (vizit × doktor), %44,2 (hata). HbA1c değişkenliğinin yaklaşık %44'ü aynı klinikteki doktorlar arasındaki farktan gelir.
Adım 4 — Varyans bileşeni SH'leri. Dengeli desende REML'in gözlenen bilgi matrisi KO'ların ki-kare dağılımından kapalı biçimde elde edilir: \mathrm{Var}(\mathrm{MS}_k)=2E[\mathrm{MS}_k]^2/\nu_k ve kestiriciler KO'ların doğrusal birleşimidir.
Aynı yoldan \mathrm{SH}(\hat\sigma^2_{RF})=0{,}021021, \mathrm{SH}(\hat\sigma^2_e)=\sqrt{2\cdot0{,}182367^2/192}=0{,}018613. MerQur bu değerleri gözlenen Hessian'dan bulur (Bölüm 54.5.4) ve 55.6.1'deki tabloda 10^{-9} düzeyinde aynıdır. Doktor bileşeni için Wald Z=0{,}180556/0{,}065985=2{,}736; log-Wald %95 GA: 0{,}180556\,e^{\pm1{,}959964\cdot0{,}065985/0{,}180556}=[0{,}0882;\ 0{,}3696].
Adım 5 — REML Satterthwaite testleri. Dengeli desende REML III. tür F'leri EMS F'lerine, Satterthwaite payda sd'leri EMS paydalarının sd'lerine eşittir: visit F(3,\,60)=14{,}2026, clinical F(3,\,20)=10{,}3650, R×P F(9,\,60)=0{,}7899. Satterthwaite formülü her kontrastın varyansını oluşturan KO'ları kendisi "bulur"; klinik kontrastının varyansı yalnız \mathrm{MS}_{F(P)}'ye dayandığından sd 20 çıkar.
Adım 6 — EMM ve karşılaştırmalar. Ankara EMM'si 6,855972, \mathrm{SH}=\sqrt{2{,}496697/72}=0{,}186216, sd =20. Ankara − İzmir farkı -1{,}339167, \mathrm{SH}=\sqrt{2\cdot2{,}496697/72}=0{,}263349, t=-5{,}085. Bonferroni p=6\cdot P(|t_{20}|>5{,}085)=0{,}000339; Tukey p=P(q_{4,\,20}>\sqrt2\cdot5{,}085)=0{,}000306.
Adım 7 — Kalıtım derecesi (yalnız hesap gösterimi). h^2_i=4(0{,}180556)/0{,}412144=1{,}752357; h^2_f=0{,}180556/(0{,}180556+0{,}049221/4+0{,}182367/12)=0{,}867813 (n_h=3). Tıp verisinde yorumlanmaz (55.5.6).
Adım 8 — P rastgele. Sentetik payda 2{,}496697+0{,}260680-0{,}330030=2{,}427347; sd
F_P=25{,}878190/2{,}427347=10{,}6611, p=0{,}000278. R'nin yeni paydası \mathrm{MS}_{RP}: F_R=4{,}687288/0{,}260680=17{,}9810, p=0{,}000384. ANOVA kestirimi \hat\sigma^2_{RP}=(0{,}260680-0{,}330030)/(6\cdot3)=-0{,}003853 negatiftir; REML bu bileşeni sıfır sınırında kestirir (\hat\sigma^2_{RP}=0) ve öteki bileşenler bu yüzden ANOVA değerlerinden biraz ayrılır: \hat\sigma^2_P=0{,}324743 (SH 0,293669), \hat\sigma^2_F=0{,}181309, \hat\sigma^2_{RF}=0{,}046206, \hat\sigma^2_e=0{,}182367. R×P bileşeni sıfıra düşünce R×P ile R×F(P) kaynakları birleşir ve visit testinin Satterthwaite sd'si 9+60=69 olur (F=14{,}6028).
Adım 9 — Artık tanıları. Tam modelin 288 artığı: Shapiro–Wilk W=0{,}99221, p=0{,}1354; Levene F(3,\,284)=0{,}3730, p=0{,}7725; Brown–Forsythe F=0{,}3466, p=0{,}7916. Normallik ve homojenlik varsayımları için kanıt sorunu yoktur.
55.6.1 Doğrulama: MerQur, Python ve R
Betikler dogrulama/nested_lmm/ klasöründedir: merqur_calistir.py (MerQur execute()), elle_hesap.py + elle_kodlama.py (bağımsız Python), r_dogrulama.R (R 4.5.3: lm/anova, car::Anova(type = 3), lme4::lmer + lmerTest, emmeans, ptukey). R tarafında varyans bileşeni SH'leri lmerTest'in (\theta,\sigma) asimptotik kovaryansından (sayısal Hessian) delta yöntemiyle alınmıştır; bu yüzden R sütunundaki SH'ler 10^{-7} düzeyinde ayrılabilir.
Tablo 1. EMS tablosu ve III. tür KT (dengeli), P rastgele sentetik test.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| KT visit (R) | 14,061864 | 14,061864 | 14,061864 | 5,7e−14 | ✓ |
| F visit (R) | 14,202602 | 14,202602 | 14,202602 | 8,0e−14 | ✓ |
| p visit (R) | 4,2094·10−7 | 4,2094·10−7 | 4,2094·10−7 | 3,5e−20 | ✓ |
| KT clinical (P) | 77,634569 | 77,634569 | 77,634569 | 2,6e−13 | ✓ |
| F clinical (P) | 10,364970 | 10,364970 | 10,364970 | 3,4e−14 | ✓ |
| p clinical (P) | 0,000251 | 0,000251 | 0,000251 | 5,7e−18 | ✓ |
| KT R×P | 2,346122 | 2,346122 | 2,346122 | 9,8e−15 | ✓ |
| F R×P | 0,789868 | 0,789868 | 0,789868 | 1,8e−15 | ✓ |
| p R×P | 0,626623 | 0,626623 | 0,626623 | 3,7e−15 | ✓ |
| KT F(P) | 49,933942 | 49,933942 | 49,933942 | 2,8e−14 | ✓ |
| F F(P) | 7,565056 | 7,565056 | 7,565056 | 3,2e−14 | ✓ |
| p F(P) | 4,6801·10−10 | 4,6801·10−10 | 4,6801·10−10 | 3,5e−23 | ✓ |
| KT R×F(P) | 19,801814 | 19,801814 | 19,801814 | 1,3e−13 | ✓ |
| F R×F(P) | 1,809707 | 1,809707 | 1,809707 | 8,2e−15 | ✓ |
| p R×F(P) | 0,001340 | 0,001340 | 0,001340 | 1,9e−16 | ✓ |
| KT hata | 35,014400 | 35,014400 | 35,014400 | 1,1e−13 | ✓ |
| III. tür KT visit (R) | 14,061864 | 14,061864 | 14,061864 | 3,6e−14 | ✓ |
| III. tür KT clinical (P) | 77,634569 | 77,634569 | 77,634569 | 1,1e−13 | ✓ |
| III. tür KT R×P | 2,346122 | 2,346122 | 2,346122 | 1,7e−14 | ✓ |
| III. tür KT F(P) | 49,933942 | 49,933942 | 49,933942 | 2,1e−14 | ✓ |
| III. tür KT R×F(P) | 19,801814 | 19,801814 | 19,801814 | 2,8e−14 | ✓ |
| Sentetik payda MS (P rastgele) | 2,427347 | 2,427347 | 2,427347 | 3,6e−15 | ✓ |
| Sentetik payda sd | 18,352862 | 18,352862 | 18,352862 | 3,9e−14 | ✓ |
| F clinical (P rastgele) | 10,661100 | 10,661100 | 10,661100 | 7,5e−14 | ✓ |
| p clinical (P rastgele) | 0,000278 | 0,000278 | 0,000278 | 5,9e−18 | ✓ |
| F visit (P rastgele, payda MS_R×P) | 17,980986 | 17,980986 | 17,980986 | 4,3e−14 | ✓ |
Tablo 2. REML (P sabit): varyans bileşenleri, Satterthwaite testleri, bilgi ölçütleri, EMM, Tukey, kalıtım ve artık tanıları.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| \sigma^2_F kestirimi | 0,180556 | 0,180556 | 0,180556 | 1,9e−08 | ✓ |
| \sigma^2_F SH | 0,065985 | 0,065985 | 0,065985 | 8,6e−09 | ✓ |
| \sigma^2_{RF} kestirimi | 0,049221 | 0,049221 | 0,049221 | 1,4e−08 | ✓ |
| \sigma^2_{RF} SH | 0,021021 | 0,021021 | 0,021021 | 3,1e−09 | ✓ |
| \sigma^2_e kestirimi | 0,182367 | 0,182367 | 0,182367 | 5,0e−09 | ✓ |
| \sigma^2_e SH | 0,018613 | 0,018613 | 0,018613 | 8,3e−10 | ✓ |
| REML F visit (R) | 14,202602 | 14,202602 | 14,202603 | 1,6e−06 | ✓ |
| REML payda sd visit (R) | 60,000000 | 60,000000 | 60,000006 | 6,3e−06 | ✓ |
| REML F clinical (P) | 10,364970 | 10,364970 | 10,364969 | 8,0e−07 | ✓ |
| REML payda sd clinical (P) | 20,000000 | 20,000000 | 19,999998 | 2,2e−06 | ✓ |
| REML F R×P | 0,789868 | 0,789868 | 0,789868 | 9,0e−08 | ✓ |
| REML payda sd R×P | 60,000000 | 60,000000 | 60,000006 | 6,3e−06 | ✓ |
| −2LL (REML, gösterge kodlu X) | 443,200317 | 443,200317 | 443,200317 | 3,5e−11 | ✓ |
| AIC | 481,200317 | 481,200317 | 481,200317 | 3,5e−11 | ✓ |
| BIC | 550,796566 | 550,796566 | 550,796566 | 3,5e−11 | ✓ |
| EMM K_Ankara | 6,855972 | 6,855972 | 6,855972 | 5,2e−13 | ✓ |
| EMM K_Izmir | 8,195139 | 8,195139 | 8,195139 | 8,0e−14 | ✓ |
| EMM SH | 0,186216 | 0,186216 | 0,186216 | 7,2e−09 | ✓ |
| EMM sd | 20,000000 | 20,000000 | 19,999998 | 2,2e−06 | ✓ |
| Bonferroni p K_Ankara - K_Istanbul | 0,031032 | 0,031032 | 0,031032 | 1,1e−08 | ✓ |
| Bonferroni p K_Izmir - K_Bursa | 0,003145 | 0,003145 | 0,003145 | 1,8e−09 | ✓ |
| h^2_i | 1,752357 | 1,752357 | — | 1,9e−13 | ✓ |
| h^2_f | 0,867813 | 0,867813 | — | 9,2e−15 | ✓ |
| Tukey p K_Ankara - K_Istanbul | 0,024526 | 0,024526 | 0,024526 | 3,9e−13 | ✓ |
| Tukey p K_Ankara - K_Izmir | 0,000306 | 0,000306 | 0,000306 | 6,4e−13 | ✓ |
| Tukey p K_Bursa - K_Izmir | 0,002716 | 0,002716 | 0,002716 | 1,1e−13 | ✓ |
| Shapiro–Wilk W | 0,992214 | 0,992214 | — | 1,4e−15 | ✓ |
| Levene F | 0,373046 | 0,373046 | — | 3,1e−15 | ✓ |
| Brown–Forsythe F | 0,346625 | 0,346625 | — | 6,1e−15 | ✓ |
Tablo 3. P rastgele REML ve dengesiz alt örnek.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| \sigma^2_P (P rastgele) | 0,324743 | 0,324743 | 0,324743 | 2,3e−07 | ✓ |
| \sigma^2_P SH (P rastgele) | 0,293669 | 0,293669 | 0,293670 | 3,2e−07 | ✓ |
| \sigma^2_F (P rastgele) | 0,181309 | 0,181309 | 0,181309 | 1,4e−08 | ✓ |
| \sigma^2_F SH (P rastgele) | 0,065951 | 0,065951 | 0,065951 | 6,6e−09 | ✓ |
| \sigma^2_{RP} (sınır) (P rastgele) | 7,1492·10−25 | 0,000000 | 0,000000 | 7,1e−25 | ✓ |
| \sigma^2_{RF} (P rastgele) | 0,046206 | 0,046206 | 0,046206 | 8,0e−09 | ✓ |
| \sigma^2_{RF} SH (P rastgele) | 0,019244 | 0,019244 | 0,019244 | 1,4e−09 | ✓ |
| \sigma^2_e (P rastgele) | 0,182367 | 0,182367 | 0,182367 | 4,7e−09 | ✓ |
| \sigma^2_e SH (P rastgele) | 0,018613 | 0,018613 | 0,018613 | 7,3e−10 | ✓ |
| REML payda sd visit (P rastgele) | 69,000000 | 69,000000 | 68,999996 | 3,7e−06 | ✓ |
| III. tür KT visit (R) (dengesiz) | 13,152533 | 13,152533 | 13,152533 | 4,1e−14 | ✓ |
| III. tür KT clinical (P) (dengesiz) | 73,791938 | 73,791938 | 73,791938 | 8,5e−14 | ✓ |
| III. tür KT R×P (dengesiz) | 2,206810 | 2,206810 | 2,206810 | 2,1e−14 | ✓ |
| III. tür KT F(P) (dengesiz) | 49,269189 | 49,269189 | 49,269189 | 5,0e−14 | ✓ |
| III. tür KT R×F(P) (dengesiz) | 19,760072 | 19,760072 | 19,760072 | 3,6e−14 | ✓ |
| F clinical (dengesiz, EMS) | 9,984866 | 9,984866 | 9,984866 | 7,1e−15 | ✓ |
| \sigma^2_F (dengesiz) | 0,182172 | 0,182172 | 0,182172 | 2,7e−09 | ✓ |
| \sigma^2_F SH (dengesiz) | 0,066659 | 0,066659 | 0,066659 | 8,6e−10 | ✓ |
| \sigma^2_{RF} (dengesiz) | 0,051237 | 0,051237 | 0,051237 | 4,9e−09 | ✓ |
| \sigma^2_{RF} SH (dengesiz) | 0,021150 | 0,021150 | 0,021150 | 1,0e−09 | ✓ |
| \sigma^2_e (dengesiz) | 0,178088 | 0,178088 | 0,178088 | 2,0e−09 | ✓ |
| \sigma^2_e SH (dengesiz) | 0,018340 | 0,018340 | 0,018340 | 3,2e−10 | ✓ |
| REML F visit (R) (dengesiz) | 13,407835 | 13,407835 | 13,407835 | 5,0e−07 | ✓ |
| REML payda sd visit (R) (dengesiz) | 60,578539 | 60,578539 | — | 2,5e−11 | ✓ |
| lmerTest payda sd visit (R) (dengesiz; başka L tabanı) | — | — | 60,581972 | 0,0e+00 | ✓ |
| REML F clinical (P) (dengesiz) | 10,004376 | 10,004376 | 10,004376 | 7,5e−08 | ✓ |
| REML payda sd clinical (P) (dengesiz) | 19,973296 | 19,973296 | 19,973296 | 2,2e−07 | ✓ |
| REML F R×P (dengesiz) | 0,724607 | 0,724607 | 0,724607 | 2,7e−08 | ✓ |
| REML payda sd R×P (dengesiz) | 60,581975 | 60,581975 | 60,581972 | 2,2e−06 | ✓ |
İki ayrıntı açıklama ister:
- −2LL kodlamaya bağlıdır. Bağımsız Python kestiricisi REML modelini toplam-sıfır kodlu \mathbf X ile kurmuştur; −2ℓ değeri 465,381 çıkar. MerQur ve lme4 gösterge kodlu \mathbf X kullanır: 443,200. Fark \log|\mathbf X^\top\mathbf V^{-1}\mathbf X| teriminden gelir ve tam olarak \log|\mathbf X_t^\top\mathbf X_t|-\log|\mathbf X_s^\top\mathbf X_s|=-22{,}180710'dur (
elle_kodlama.py). Varyans bileşenleri, F ve sd'ler kodlamadan bağımsızdır; yalnız −2ℓ, AIC ve BIC kayar. Tabloda Python değeri gösterge kodlamasına çevrilmiştir. - Dengesiz veride çok sd'li Satterthwaite paydası. Fai–Cornelius paydası, hipotez matrisinin satır tabanına ve parametrelemenin koordinatına duyarlıdır. MerQur en yüksek dereceli terimi (R×P) gösterge kodlu, içerilen terimleri (visit, clinical) toplam-sıfır kodlu koordinatta ortonormal tabanla sınar (
mixed_reml.py:1081–1102). Bağımsız Python aynı koordinatlarda MerQur'la 10^{-6} düzeyinde eşleşir. lmerTest R×P'de aynı değeri (60,58197) verir; visit'te ise başka bir taban kullanır ve 60,58197 bulur, MerQur 60,57854 (göreli fark 6\cdot10^{-5}). F istatistiği ve p'nin üçüncü anlamlı basamağı etkilenmez. Bu bir hata değil, tanım farkıdır.
55.7 Çıktıyı okuma
MerQur'un sonuç metni (varsayılan ayarlar + EMM + Tukey + tanılar; kalıtım derecesi kutusu işaretli, kısaltılmış):
══ İÇ İÇE LMM — ÇOKLU HİYERARŞİK KARMA MODEL ══
Bağımlı değişken : HbA1c
Replikasyon (R)  : visit (4 seviye)
Üst seviye (P)   : clinical (4 seviye)
Alt seviye (F)   : doctor_no (24 alt grup, P içinde)
Toplam gözlem    : 288
Genel ortalama   : 7.4606

── VARYANS ANALİZİ TABLOSU ──
Kaynak                              df            SS          MS        F          p
visit (R)                            3        14.062      4.6873   14.203  <0.0001 ***
clinical (P)                         3        77.635     25.8782   10.365   0.0003 ***
visit × clinical (R×P)               9         2.346      0.2607    0.790   0.6266 ns
doctor_no [clinical içinde] (F      20        49.934      2.4967    7.565  <0.0001 ***
visit × doctor_no (R×F)             60        19.802      0.3300    1.810   0.0013 **
Hata (e)                           192        35.014      0.1824        —        — —

── VARYANS BİLEŞENLERİ (REML; dengesiz veride geçerli) ──
Kaynak                                         σ²        SE   Wald Z       %         %95 GA (log-Wald)
doctor_no [clinical içinde] (F)            0.1806    0.0660    2.736   %43.8          (0.0882, 0.3696)
visit × doctor_no (R×F)                    0.0492    0.0210    2.341   %11.9          (0.0213, 0.1137)
Hata (e)                                   0.1824    0.0186    9.798   %44.2          (0.1493, 0.2228)

── REML KARMA MODEL — SABİT ETKİ TESTLERİ (Tip III, Satterthwaite) ──
visit                                 3     60.00    14.203   <0.0001
clinical                              3     20.00    10.365    0.0003
visit:clinical                        9     60.00     0.790    0.6266
  -2LL (REML) = 443.200 · AIC = 481.200 · BIC = 550.797

── KALITIM DERECESİ (REML bileşenlerinden) ──
  Bireysel dar anlamda kalıtım derecesi h²_i = 4σ²F / (σ²F + σ²RF + σ²e) = 1.752
...
── ÇOKLU KARŞILAŞTIRMA (hata terimi MS_F(P), sd = 20; düzeltme: tukey) ──
K_Ankara - K_Izmir               -1.3392    0.2633   -5.085   <0.0001    0.0003
Harf grupları (aynı harf = fark yok):  K_Izmir (8.195) a  K_Istanbul (7.683) ab  K_Bursa (7.109) bc  K_Ankara (6.856) c
| Satır/Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
| Künye | R, P, F düzey sayıları, n, genel ortalama | "24 alt grup" (P, F) çiftlerinin sayısıdır; etiket sayısı (6) değil. |
| Varyans analizi tablosu | sd, KT, KO, F, p, yıldız | Önce R×P'ye bakın: anlamsızsa klinik farkı vizitlere göre değişmiyor demektir. Klinik satırının sd'si 3 ve 20'dir (tabloda yalnız pay sd'si yazar). |
| F testi hata terimi | Her satırın paydası | P'nin tipine göre değişir (55.5.2, 55.5.4). |
| Üst seviye grup ortalamaları | n, ortalama, SS, SH, t-GA | Basit betimsel GA; hata terimi hasta içi SS'dir, doktor değişkenliğini içermez. Çıkarım için EMM ya da çoklu karşılaştırma kullanın. |
| P için sentetik payda | MS, sd, F, p | Yalnız P rastgeleyken. |
| Varyans bileşenleri | σ², SH, Wald Z, %, log-Wald GA | % sütunu toplam varyanstaki paydır; ICC değildir. Wald Z küçük örneklemde güvenilmez (55.8, S4). |
| REML sabit etki testleri | Pay/payda sd, F, p | Dengesiz veride esas alınacak testler. |
| −2LL, AIC, BIC | REML bilgi ölçütleri | Yalnız aynı sabit etkili REML modellerini karşılaştırır. |
| Kalıtım derecesi | h^2_i, h^2_f, r, n_h | Yalnız genetik (yarım-kardeş aile) tasarımlarında. |
| EMM | Klinik EMM'leri ve Bonferroni'li ikili farklar | Satterthwaite sd'li, REML modelinden. |
| Çoklu karşılaştırma | Δ, SH, t, ham ve Tukey p, harf grupları | Hata terimi MS_F(P), sd 20. |
| Uyarılar | Dengesizlik, h^2>1, düşük gözlem/terim oranı | Koşullar: nested_lmm.py:659–667, 686–695, 830–831. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
HbA1c, vizit (4 dalga, sabit) × klinik (4, sabit) × klinik içinde doktor (6, rastgele) iç içe karma modelle incelendi (N=288; her hücrede 3 hasta). Klinikler arasında anlamlı fark vardı, F(3,\ 20)=10{,}37, p<0{,}001 (payda: klinik içinde doktor). Vizit etkisi anlamlı, F(3,\ 60)=14{,}20, p<0{,}001; vizit × klinik etkileşimi anlamsızdı, F(9,\ 60)=0{,}79, p=0{,}63. REML varyans bileşenleri: doktor \hat\sigma^2=0{,}181 (SH =0{,}066; %95 GA [0,088; 0,370]; toplam varyansın %43,8'i), vizit × doktor \hat\sigma^2=0{,}049 (%11,9), hata \hat\sigma^2=0{,}182 (%44,2). Tukey karşılaştırmalarında (hata terimi klinik içinde doktor, sd=20) İzmir, Ankara ve Bursa'dan; İstanbul Ankara'dan yüksek bulundu (tümü p<0{,}03).
55.8 Uzman soruları
S1. Dengeli veride EMS F'leri ile REML Satterthwaite F'leri neden birebir aynı?
Dengeli desende REML varyans bileşenleri ANOVA kestirimlerine eşittir (bütün kestirimler pozitifken), ve GLS sabit etki kestiricisi OLS'ye indirgenir. Bir sabit etki kontrastının varyansı tek bir KO'nun katıdır (klinik kontrastı için \mathrm{MS}_{F(P)}/(rfn)); bu yüzden Wald F, EMS F'sine, Satterthwaite sd'si de o KO'nun sd'sine eşit çıkar. Dengesiz veride bu eşitlik bozulur: EMS paydası yaklaşık, REML testi tutarlıdır.
S2. Klinik testinin sd'si neden 192 değil de 20?
Klinik ortalamaları doktorların rastgele örneklemine dayanır; payda \mathrm{MS}_{F(P)}'dir ve sd'si p(f-1)=4\cdot5=20'dir. 192 sd'li hata terimi kullanılsaydı her hasta bağımsız bir "klinik tekrarı" sayılırdı (sahte yineleme). Pratik sonuç: klinik karşılaştırmasının gücü doktor sayısıyla sınırlıdır; daha çok hasta toplamak klinik testine sınırlı katkı yapar.
S3. Kod hangi EMS modelini kullanıyor; R ile aynı mı?
Kısıtlanmamış modeli: F(P) \mathrm{MS}_{R\times F(P)}'ye karşı sınanır (nested_lmm.py:570). REML modeli ((1\mid P{:}F)+(1\mid R{:}P{:}F)) de kısıtlanmamış parametrelemeye karşılık gelir; lme4/lmerTest ile aynı varyans bileşenlerini verir (55.6.1).
S4. Wald Z ile bir varyans bileşenini sınamak doğru mu?
Hayır, yalnız kaba bir göstergedir. \sigma^2=0 parametre uzayının sınırındadır ve \hat\sigma^2'nin dağılımı küçük örneklemde çarpıktır; Wald Z'nin normal yaklaşımı bozulur. Doktor bileşeni 24 doktordan kestirilir; Wald Z=2{,}74 (p=0{,}006) ile EMS F_{F(P)}=7{,}57 (p<10^{-9}) çok farklı kanıt düzeyleri gösterir. Bir bileşenin varlığı EMS F'siyle ya da olabilirlik oranı testiyle (LMM panelinde "LRT", ½χ² karışımı) sınanmalıdır.
S5. P rastgele seçildiğinde \hat\sigma^2_{RP}=0 çıktı. Bu ne demek, ne yapmalı?
ANOVA kestirimi negatiftir (-0{,}0039): R×P KO'su kendi beklenen alt sınırı olan R×F(P) KO'sundan küçüktür. REML negatif varyansa izin vermez, bileşeni sıfıra çeker; tablo GA'yı "—" yazar. Bu durumda R×P teriminin modelden çıkarılması (indirgenmiş model) ile sonuçlar pratikte aynıdır: visit testi R×P ve R×F(P)'yi havuzlar (sd 69). Sentetik payda ise ANOVA KO'larıyla çalıştığından bu sınırdan etkilenmez; iki yolun P testi farklı payda kullanır.
S6. Sentetik paydanın Satterthwaite sd'si 18,35; R'nin `lmerTest` sonucu bundan farklı olur mu?
Olabilir. Sentetik payda yaklaşımı KO'ların doğrusal birleşimine dayanır (Satterthwaite 1946); lmerTest ise REML kestirimine Satterthwaite'i doğrudan uygular (Giesbrecht & Burns 1985; Kuznetsova vd. 2017). Bileşenler pozitif ve desen dengeliyse iki yol aynı sd'yi verir. Bu veride \hat\sigma^2_{RP} sınırda olduğu için REML'de P'nin sabit etki testi yoktur (P rastgele); sentetik test yalnız EMS tablosundadır.
S7. Dengesiz veride hangi tabloya güvenmeliyim?
REML tablosuna. EMS tablosu dengesizlikte KO oranlarını dengeli katsayılarla kurar ve uyarı yazar (nested_lmm.py:600–607). Dengesiz alt örnekte (284 gözlem) iki yolun klinik F'leri 9,985 (EMS) ve 10,004 (REML) çıkar; daha ağır dengesizlikte fark büyür. III. tür KT'ler doğru hesaplanır (R car::Anova ile eşleşir); yalnız EMS paydaları yaklaşıktır.
S8. Neden alt grup kimliği (P, F) çiftinden kuruluyor; "doctor_no" tek başına yetmez mi?
"D01" etiketi dört klinikte dört farklı doktordur. Etiket tek başına kullanılsaydı dört doktor tek birim sayılır, F(P) bileşeni çapraz bir "doktor etiketi" etkisine dönüşürdü. MerQur bu hatayı önlemek için kimliği çiftten kurar (nested_lmm.py:514–518); R'de (1 | clinical:doctor_no) yazımı aynı işi görür. Veride her doktora benzersiz kimlik vermek en güvenli yoldur.
55.9 Sık hatalar ve tuzaklar
- Tekrarlı ölçümü replikasyon sanmak. Aynı hasta her vizitte ölçülmüşse, hastanın kendi rastgele etkisi modele girmelidir; bu panel bunu kurmaz. LMM panelinde hasta ve doktor iç içe gruplama olarak verilmelidir.
- Üst grup ortalamalarının GA'sını çıkarım için kullanmak. "Üst seviye grup ortalamaları" tablosundaki GA, klinikteki 72 hastanın SS'sinden hesaplanır (
nested_lmm.py:638–653) ve doktor değişkenliğini içermez; çok dardır. Klinik karşılaştırması için EMM ya da MS_F(P) hata terimli karşılaştırmayı kullanın. - Kalıtım derecesini genetik olmayan veride istemek. h^2 kutusu yalnız yarım-kardeş aile tasarımlarında işaretlenmelidir.
- Kovaryatın EMS tablosunu düzelteceğini sanmak. Kovaryatlar yalnız REML modeline girer; EMS tablosu kovaryatsızdır.
- Kesik kaynak etiketi. Varyans analizi tablosunda "doctor_no [clinical içinde] (F" etiketi sütun genişliğinde kesilir; R×F(P) satırının etiketi de "visit × doctor_no (R×F)" diye kısaltılmıştır. İç içelik etiketlerde tam görünmez.
- I. tür KT'nin sırası. Dengesiz veride I. tür KT sıraya bağlıdır (R → P → R×P → F(P) → R×F(P)); dengesiz desende III. türü seçin.
- n<30 sınırı. Küçük pilot desenlerde analiz durur; REML motoru küçük örneklemde çalışabildiği hâlde panel engeller (
nested_lmm.py:478–479).
55.10 Kaynaklar
- Cornfield, J., & Tukey, J. W. (1956). Average values of mean squares in factorials. The Annals of Mathematical Statistics, 27(4), 907–949. https://doi.org/10.1214/aoms/1177728067
- Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin, 2(6), 110–114. https://doi.org/10.2307/3002019
- Hocking, R. R. (1973). A discussion of the two-way mixed model. The American Statistician, 27(4), 148–152. https://doi.org/10.1080/00031305.1973.10479018
- Giesbrecht, F. G., & Burns, J. C. (1985). Two-stage analysis based on a mixed model: Large-sample asymptotic theory and small-sample simulation results. Biometrics, 41(2), 477–486. https://doi.org/10.2307/2530872
- Searle, S. R., Casella, G., & McCulloch, C. E. (1992). Variance components. Wiley. https://doi.org/10.1002/9780470316856
- Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
- Kuznetsova, A., Brockhoff, P. B., & Christensen, R. H. B. (2017). lmerTest package: Tests in linear mixed effects models. Journal of Statistical Software, 82(13), 1–26. https://doi.org/10.18637/jss.v082.i13
- Fai, A. H.-T., & Cornelius, P. L. (1996). Approximate F-tests of multiple degree of freedom hypotheses in generalized least squares analyses of unbalanced split-plot experiments. Journal of Statistical Computation and Simulation, 54(4), 363–378. https://doi.org/10.1080/00949659608811740
- Falconer, D. S., & Mackay, T. F. C. (1996). Introduction to quantitative genetics (4. baskı). Longman.