7. Tek Yönlü Varyans Analizi (ANOVA)
Analiz kimliği: anova · Menü adı: Tek Yönlü ANOVA · Panel: gui/panels/analyses/one_way_anova.py · Motor: stats/hypothesis.py, HypothesisTests.one_way_anova (satır 3748–4115), post_hoc_test ve yardımcıları (satır 4119–4550)
7.1 Ne işe yarar
Tek yönlü varyans analizi (ANOVA), birbirinden bağımsız iki ya da daha çok grubun sürekli bir değişkendeki ortalamalarının eşit olup olmadığını tek bir testle sınar. Cevapladığı soru şudur: "Grup ortalamaları arasındaki farklar, yalnız grup içi rastlantısal değişkenlikle açıklanabilir mi?"
- \mu_i: i. grubun evren ortalaması; k: grup sayısı.
- H_1 "hangi grubun" farklı olduğunu söylemez. Bunu çoklu karşılaştırma (post hoc) testleri ya da planlı kontrastlar söyler (7.5.7–7.5.9).
Aynı soru doğrusal model olarak da yazılabilir: y_{ij}=\mu+\tau_i+\varepsilon_{ij}, \varepsilon_{ij}\sim N(0,\sigma^2), H_0:\tau_1=\dots=\tau_k=0. MerQur modeli kurmaz; kareler toplamlarını doğrudan grup özetlerinden hesaplar. Sonuç, R aov(y ~ g) ile aynıdır (7.6.1).
Ne zaman kullanılır? Gruplar farklı kişilerden oluşuyorsa (dört ilaç kolu, üç hastane), bağımlı değişken aralık ya da oran ölçeğindeyse ve grup içi dağılımlar kabaca normal ve benzer yayılımlıysa. Grup sayısı 2 olduğunda da çalışır; o zaman F=t^2 olur ve sonuç Student t testiyle aynıdır.
Ne zaman kullanılmaz?
- Aynı kişiler her koşulda ölçüldüyse: Tekrarlı Ölçümler ANOVA.
- İki ya da daha çok faktör varsa (ilaç × cinsiyet): İki Yönlü ANOVA.
- Bir ortak değişkene göre düzeltme gerekiyorsa: ANCOVA.
- Dağılımlar belirgin biçimde normal dışı ve gruplar küçükse: Kruskal–Wallis.
- Her grubun genel ortalamadan sapıp sapmadığı soruluyorsa ve sonuç tek grafikle sunulacaksa: Ortalamalar Analizi (ANOM) (Bölüm 8).
- Elde yalnız p değerleri varsa ve düzeltilmeleri gerekiyorsa: Çoklu Karşılaştırma Düzeltme (Bölüm 17).
Sık karıştırılan analizler. Welch ANOVA ayrı bir analiz değildir; bu modülün "ANOVA varyantı" seçeneğidir. Post hoc testler ANOVA'nın yerine geçmez: ANOVA bütünsel H_0'ı, post hoc testler çift çift farkları sınar ve kendi hata denetimlerini yapar. ANOM ise her grubu öteki gruplarla değil, ağırlıklı genel ortalamayla karşılaştırır.
7.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Bağımsızlık | Her gözlem tek kişiden gelir; gruplar arası ve grup içi gözlemler birbirini etkilemez. | Tasarımla sağlanır; istatistiksel denetimi yoktur. |
| Normallik | Her grupta değişken yaklaşık normal dağılır. | İsteğe bağlı Shapiro–Wilk (grup başına, 3\le n\le 5000); varsayılan kapalı. |
| Varyans eşitliği | \sigma_1^2=\dots=\sigma_k^2. Klasik F, Tukey, Bonferroni, Scheffé, LSD, Šidák, GT2, Gabriel, SNK, REGWQ, Duncan ve Dunnett bunu varsayar. | Varsayılan açık Levene (ortalama merkezli) ve ek bilgi olarak Brown–Forsythe (medyan merkezli); isteğe bağlı Bartlett. Varsayım bozuksa: Welch varyantı, Brown–Forsythe F^*, Games–Howell, Tamhane T2, Dunnett T3. |
| Ölçek | Bağımlı değişken sayısal; grup değişkeni kategorik ya da az düzeyli tamsayı kodlu. | Sayıya çevrilemeyen değer pd.to_numeric(..., errors="coerce") ile eksik sayılır (hypothesis.py:3770–3773). Grup listesine 20 ya da daha az düzeyli tamsayı sütunlar da eklenir (one_way_anova.py:50–52). |
Eksik değer. Grup değeri eksik satır hiçbir gruba girmez; bağımlı değişkeni eksik satır kendi grubundan çıkarılır (hypothesis.py:3770–3773). Bağımlı değişkeni tümüyle eksik bir grup analizden çıkarılır ve uyarı yazılır: "Bağımlı değişkeni tümüyle eksik olan düzey(ler) analizden çıkarıldı" (hypothesis.py:3777–3780). Künyedeki n, df[[grup, değer]].dropna() satır sayısıdır (stats_panel.py:5679).
Uç durumlar.
- Geçerli grup sayısı 2'den azsa hata: "ANOVA için en az 2 grup gereklidir." (
hypothesis.py:3782–3783). - Her grupta tek gözlem varsa (N-k=0) ya da tüm değerler sabitse F tanımsızdır; tabloya "—" ve dipnot yazılır (
hypothesis.py:3910–3911). - Welch varyantı seçildi ve bir grupta n<2 ya da s^2=0 ise Welch ağırlığı n_i/s_i^2 tanımsızdır. Ana sonuç "—" olur; klasik F yalnız ayrı etiketle bilgi için verilir (
hypothesis.py:3794–3824, 3683–3689). Roneway.testbu durumdaNaNverir. - Brown–Forsythe F^* istenip bir grupta n<2 ise F^* tanımsız bırakılır (
hypothesis.py:3957–3963). - Games–Howell, Tamhane T2 ve Dunnett T3'te n=1 grubu içeren çiftler NaN işaretlenir; program çökmez (
hypothesis.py:4259–4262, 4203–4210). - Kontrast katsayı sayısı grup sayısına eşit değilse hata; katsayı toplamı 0 değilse uyarı satırı yazılır (
hypothesis.py:4023–4026).
7.3 Parametreler
Varsayılanlar one_way_anova.py:44–132 ve _hypothesis_forms.py:331–371 içinden okunmuştur.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Grup Sütunu | veriye bağlı | Gruplama değişkeni. | Grup sırası post hoc fark yönünü ve kontrast katsayılarının hangi gruba uygulandığını belirler (7.5.1). |
| Değer Sütunu | veriye bağlı | Bağımlı değişken; çoklu seçilebilir. | Birden çok sütunda her biri için ayrı ANOVA yapılır; sütunlar arası düzeltme yapılmaz (stats_panel.py:5639–5669). |
| Post-hoc testi | Yok | 14 yöntemden biri: Tukey HSD, Duncan MRT, Bonferroni, Scheffé, Games-Howell, LSD, Šidák, Hochberg GT2, Gabriel, Student-Newman-Keuls, Ryan-Einot-Gabriel-Welsch Q, Dunnett (kontrole karşı), Tamhane T2, Dunnett T3. | Ek çift tablosu. ANOVA anlamsız olsa da seçilen yöntem çalıştırılır (koruma yoktur). |
| Güven Düzeyi | %95 | %90, %95, %99 ya da "Diğer (özel)…" (80–99,9); \alpha=1-\text{düzey}. | H_0 kararı, post hoc kararları, GA'lar ve varsayım satırlarındaki "İHLAL" etiketi bu \alpha ile verilir. |
| ANOVA varyantı | Klasik (Fisher) | Klasik ya da Welch (eşit olmayan varyans). | Welch'te ana F, sd₂ ve p Welch'tir; ANOVA tablosu her zaman klasik kalır ve altına "Welch" satırı eklenir. |
| Etki büyüklükleri: ω², ε² | kapalı | Yanlılığı azaltılmış açıklanan varyans oranları. | Ek satır; \eta^2 her zaman verilir. |
| Etki büyüklükleri: Etki GA'ları | kapalı | \eta^2, \varepsilon^2, \omega^2 için merkezî olmayan F'ye dayalı iki yönlü GA. | Ek bölüm. |
| Ek çıktı: Brown-Forsythe F* | kapalı | Brown–Forsythe (1974) ortalama eşitliği testi; ayrıca Welch satırı. | Ek bölüm ("Sağlam (robust) eşit ortalama testleri"). |
| Ek çıktı: Harf gösterimi (homojen alt kümeler) | kapalı | Seçili post hoc testin anlamlı çiftlerinden harf atar. | Ek bölüm; post hoc "Yok" ya da Dunnett ise uygulanmaz ve ayar bloğuna not düşülür. |
| Grafik | Kutu grafiği | Kutu, ortalama ± GA ya da grup başına Q–Q. | Yalnız Grafik sekmesi. |
| Varsayım kontrolleri: Levene | açık | Ortalama merkezli Levene + Brown–Forsythe satırı. | Yalnız bilgi; testi değiştirmez. |
| Varsayım kontrolleri: Bartlett, Shapiro | kapalı | Bartlett varyans eşitliği; grup başına Shapiro–Wilk. | Ek satır. |
| Betimsel | açık | Grup başına n, ortalama, SS, SH, medyan, uçlar, çarpıklık, basıklık. | Ek bölüm. |
| Dunnett kontrol grubu | İlk (sıralı ilk düzey) | Dunnett'te kontrol grubu: düzey sırasındaki (7.5.1) ilk ya da son düzey. | Yalnız Dunnett'i etkiler; başka yöntemle değiştirilirse ayar bloğuna "uygulanmadı" notu düşülür (one_way_anova.py:171–186). |
| Planlı kontrastlar | boş | Grup başına bir katsayı, virgülle; birden çok kontrast ; ile. |
Ek bölüm: havuzlanmış ve Welch t. |
| Polinom trend | Yok | Doğrusal…5. derece ortogonal polinom kontrastları. | Ek bölüm; düzeylerin eşit aralıklı ve doğal sırada olduğu varsayılır. |
Motor varsayılanı arayüzden farklı
Motorda do_levene ve show_desc seçeneklerinin varsayılanı False'tur (hypothesis.py:3761, 3558); arayüz ikisini de açık getirir (one_way_anova.py:127, 130). Betik ya da başka modülden execute() çağrısında options verilmezse Levene ve betimsel satırlar çıkmaz. Bu kılavuzdaki "varsayılan" çalıştırma arayüz varsayılanlarıyla yapılmıştır.
"İlk" ve "Son" hangi gruptur?
"İlk" ve "Son", MerQur'un ortak düzey sırasına göredir (7.5.1). Bu veride etiketler sayı içermediği ve Veri sekmesinde sıra tanımlanmadığı için verideki ilk görülme sırası geçerlidir: placebo, drug-A, drug-B, drug-C. "İlk" seçilirse kontrol placebo olur. Kontrol grubunu veride ilk sıraya koymak ya da Veri sekmesinde düzey sırasını tanımlamak, "İlk" seçimini güvenli kılar.
7.4 Tıp örneği
Dosya: english/datasets/Tip/06_anova_drug_LDL.xlsx (Türkçe kopyası samples/Tum_Analiz_Tip/06_anova_ilac_LDL.xlsx).
| Değişken | Rol | Tür | Açıklama |
|---|---|---|---|
drug_group |
Grup Sütunu | metin, 4 düzey | placebo, drug-A, drug-B, drug-C (verideki görülme sırası) |
LDL_change |
Değer Sütunu | sürekli | Çalışma sonu − başlangıç LDL kolesterol (mg/dL); negatif değer düşüş demektir. |
patient_id, age |
kullanılmaz |
n ve eksik değer: 140 hasta, her grupta 35 (dengeli tasarım). Hiçbir sütunda eksik değer yoktur.
Klinik soru: Dört kol arasında ortalama LDL düşüşü farklı mı? Farklıysa hangi ilaçlar plasebodan ve birbirinden ayrışıyor?
Seçilen ayarlar: Arayüz varsayılanları (Klasik varyant, %95, Levene ve Betimsel açık) ve Post-hoc = Tukey HSD. Sayısal yürüyüş için ikinci bir çalıştırmada ω², ε², Etki GA'ları, Brown–Forsythe F*, Harf gösterimi, Bartlett, Shapiro açıldı; kontrastlar -3, 1, 1, 1; 0, 1, -1, 0 (düzey sırası placebo, drug-A, drug-B, drug-C) ve Polinom trend = Doğrusal girildi. 14 post hoc yöntemin her biri ayrıca çalıştırıldı.
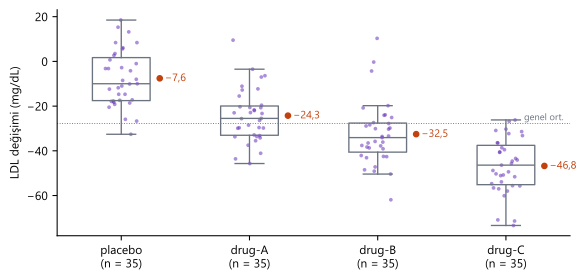
Şekil 7.1. Dört kolda LDL değişimi. Noktalar hastalar, kutular çeyrekler arası aralık, turuncu nokta grup ortalaması; kesikli çizgi genel ortalama (−27,79).
7.5 Formüller ve hesap adımları
MerQur'un sırası: (1) grupları ayır, boş grupları at; (2) scipy f_oneway ile F ve p'yi al; (3) istenirse Welch F'yi hesapla; (4) kareler toplamı tablosunu, kaymaya karşı merkezlenmiş veriyle yeniden kur; (5) \eta^2 ve istenen öteki etki büyüklüklerini, GA'larını, sağlam testleri, varsayım satırlarını ekle; (6) post hoc testi, kontrastları ve harf gösterimini ekle.
7.5.1 Grupların sırası
Gruplar MerQur'un ortak düzey sırası kuralıyla alınır (_natural_cat_order, core.cat_order): (1) kullanıcının Veri sekmesinde tanımladığı sıra ya da sıralı kategorik; (2) etiketler sayıysa ya da sayı içeriyorsa sayısal/doğal sıra ("doz 5" < "doz 10"); (3) hiçbiri yoksa verideki ilk görülme sırası. Alfabetik sıra kendiliğinden kullanılmaz. Bu sıra ANOVA'nın F'sini etkilemez; post hoc tablolarında fark yönünü (I-J, Grup 1 sıradaki önceki düzeydir), Dunnett'in "İlk/Son" kontrolünü ve kontrast katsayılarının hangi gruba uygulandığını belirler. On dört post hoc yöntemin hepsi ve kontrastlar aynı sırayı kullanır; kullanılan sıra ve kural sonuç notunda, kontrastlarda ayrıca "Katsayı sırası (grup düzeyleri)" satırında yazılır.
Neden alfabetik sıra kullanılmaz?
Alfabetik sıra etiketin dilinden ve yazımından gelen keyfi bir sıradır: Türkçe ve İngilizce aynı veride farklı sıra verir ("Hasta/Sağlıklı" ile "Patient/Healthy" ters düşer) ve fark yönü arayüz diline göre değişir. Kullanıcının verisini girdiği sıra, sıra bilgisinin en iyi vekilidir. Bu veride sıra placebo, drug-A, drug-B, drug-C'dir; ilk çift bütün yöntemlerde placebo − drug-A = +16,69 olarak yazılır. R factor()ın alfabetik varsayılanı bilinen bir tuzaktır; R ile karşılaştırırken factor(…, levels = …) ile sıra verilmelidir.
7.5.2 Kareler toplamları ve F
- y_{ij}: i. gruptaki j. hastanın değeri; n_i: grup büyüklüğü; N=\sum n_i.
- \bar y_i: grup ortalaması; \bar y: ağırlıklı genel ortalama (tüm gözlemlerin ortalaması).
- SS_B: gruplar arası kareler toplamı (grup ortalamalarının genel ortalamadan sapması); SS_W: grup içi kareler toplamı (hata).
- MS_W: hata kareler ortalaması; ortak \sigma^2'nin yansız kestiricisi. Post hoc testlerin çoğu bu değeri kullanır.
- F: H_0 doğruysa F_{k-1,N-k} dağılımına uyar; büyük F ortalamaların ayrıştığını gösterir.
Neden iki varyans kestiriminin oranı?
MS_W, H_0 doğru olsun olmasın \sigma^2'yi kestirir; çünkü yalnız grup içi sapmalardan hesaplanır. MS_B ise E(MS_B)=\sigma^2+\sum n_i\tau_i^2/(k-1) beklenen değerine sahiptir: H_0 altında o da \sigma^2'yi kestirir, H_1 altında büyür. İki bağımsız ki-kare bileşeninin serbestlik derecelerine bölünmüş oranı F dağılımına uyar (Cochran teoremi). Serbestlik dereceleri: k grup ortalaması bir genel ortalama etrafında k-1 serbest sapma verir; N gözlem k grup ortalaması etrafında N-k serbest sapma verir.
Koddaki tercih
F ve p scipy.stats.f_oneway ile alınır (hypothesis.py:3787). Tablodaki kareler toplamları ise ayrıca hesaplanır: veriler ilk gözlem kadar kaydırılır (y-y_{11}) ve SS'ler kaydırılmış veriden bulunur (hypothesis.py:3836–3847). SS'ler kaymaya göre değişmez; kaydırma, büyük sabit ofsetli verilerde (NIST StRD SmLs07–09) ortalama ve kare alma sırasındaki yuvarlama kaybını önler. Tabloda F ve p her zaman klasik değerdir; Welch varyantında bile tablo satırları SS/MS ile tutarlı kalır, Welch ayrı bir satırdadır (hypothesis.py:3855–3864).
7.5.3 Etki büyüklükleri
- \eta^2: örneklemde grup üyeliğinin açıkladığı varyans oranı; her zaman verilir.
- \varepsilon^2 (Kelley 1935) ve \omega^2 (Hays): evren oranının yanlılığı azaltılmış kestiricileri; \varepsilon^2\ge\omega^2.
- Negatif çıkarsa 0'a kırpılır (
hypothesis.py:3926, 3718).
Neden \eta^2 yukarı yanlı?
H_0 doğru olsa bile SS_B sıfır olmaz; E(SS_B)=(k-1)\sigma^2'dir. \eta^2 bu rastlantısal payı da "açıklanan" sayar. \varepsilon^2 ve \omega^2 paydan (k-1)MS_W yani rastlantısal SS_B'nin beklenen değerini düşer. \omega^2 paydaya ayrıca MS_W ekler: evren toplam varyansı \sigma^2_\tau+\sigma^2'nin daha iyi bir kestirimidir. Küçük örneklemde fark belirgindir; bu veride N=140 olduğundan üçü yakındır.
Etki büyüklüğü GA'ları (_pve_ci, hypothesis.py:1933–1941; _ncp_f_bounds, 1771–1791). Her etki büyüklüğü önce bir F değerine çevrilir, F'nin merkezî olmama parametresi \lambda için iki yönlü sınırlar bulunur, sınırlar orana geri çevrilir:
- es: GA'sı istenen oran (\eta^2, \varepsilon^2 ya da \omega^2); \eta^2 için f gözlenen F'nin kendisidir.
- F'(\cdot;\lambda): merkezî olmayan F dağılımının birikimli fonksiyonu.
- Merkezî F'de bile birikimli değer hedefin altında kalırsa sınır 0 alınır (MBESS ve effectsize kuralı).
Koddaki tercih
Bu, R effectsize::F_to_eta2 ailesinin (Steiger 2004) tanımıdır ve \varepsilon^2, \omega^2 için de aynı "es\to f\to\lambda\to oran" dönüşümü uygulanır. MerQur GA'yı iki yönlü verir. effectsize'ın varsayılanı alternative = "greater" (tek yönlü, üst sınır 1) olduğundan R ile karşılaştırırken alternative = "two.sided" verilmelidir.
7.5.4 Welch F ve Brown–Forsythe F*
Welch (1951) varyans eşitliği istemez (pingouin.welch_anova, hypothesis.py:3807–3814):
- s_i^2: i. grubun varyansı (n_i-1 paydalı); w_i: ortalamanın kesinliği (SH²'nin tersi).
- \bar y_w: kesinlik ağırlıklı genel ortalama.
- \Lambda: grupların ağırlık paylarındaki dengesizliği ve küçük n'yi özetleyen terim; payda düzeltmesi ve \nu_2 bundan gelir.
Neden ağırlıklı ortalama ve Satterthwaite benzeri sd?
Varyanslar farklıysa her grup ortalamasının kesinliği farklıdır; en iyi doğrusal birleşim kesinlik ağırlıklıdır. Pay, ağırlıklı sapma kareler toplamıdır ve H_0 altında yaklaşık \chi^2_{k-1}/(k-1) gibi davranır. Ağırlıklar veriden kestirildiği için oluşan ek değişkenlik paydadaki 1+2(k-2)\Lambda/(k^2-1) çarpanıyla ve \nu_2 ile karşılanır; bu, Welch'in iki grup için yaptığı moment eşlemesinin k gruba genellemesidir.
Brown–Forsythe (1974) F^* (hypothesis.py:3952–3976) payı klasik SS_B olarak tutar, paydayı grup varyanslarının ağırlıklı toplamıyla değiştirir:
- Payda, H_0 altında E(SS_B)'nin varyanslar eşit olmasa da doğru kestirimidir: E(SS_B)=\sum(1-n_i/N)\sigma_i^2.
- \nu_2^*: Satterthwaite yaklaşık serbestlik derecesi; pay sd'si k-1'dir.
Neden dengeli tasarımda F^*=F?
n_i=n ise payda \frac{k-1}{k}\sum s_i^2 olur; klasik F'nin paydası (k-1)MS_W=(k-1)\frac{1}{k}\sum s_i^2'dir. İkisi aynıdır, yalnız serbestlik derecesi farklıdır. Bu veride F^*=57{,}670093=F, ama \nu_2^*=133{,}43 (N-k=136 yerine).
Koddaki tercih
"Brown-Forsythe F" kutusu açıldığında aynı bölüme Welch satırı da yazılır (hypothesis.py:3977–3985). Dikkat: bu bölümdeki "Brown-Forsythe F" ortalamaların eşitliği testidir; Levene satırının altındaki "Brown-Forsythe (medyan merkezli Levene)" ise varyansların eşitliği testidir. Adları aynı yazarlardan gelir, sınadıkları şey farklıdır.
7.5.5 Varsayım testleri
Levene ortalama merkezli (_levene_lines, hypothesis.py:393–405): z_{ij}=|y_{ij}-\bar y_i| üzerinde tek yönlü ANOVA F'si,
Aynı satır bloğunda medyan merkezli biçim (Brown–Forsythe 1974b) ek bilgi olarak verilir. Ayrıntı ve "neden ortalama merkezli" tartışması için Bölüm 5.5.3'e bakın. Bartlett (hypothesis.py:3989–3992): Bölüm 5.5.9'daki formül, k grupla. Shapiro–Wilk: grup başına, sabit seride "—" (_shapiro_line, hypothesis.py:631–645).
Etiket kuralı: p\ge\alpha → "karşılanıyor", p<\alpha → "İHLAL" (_assump_word, hypothesis.py:382–385). Etiket yalnız bilgidir; varyant ya da post hoc seçimi otomatik değişmez.
7.5.6 Planlı kontrastlar ve polinom trend
Katsayılar c=(c_1,\dots,c_k) düzey sırasına (7.5.1) uygulanır; sıra çıktıda yazılır:
Welch sürümü yalnız c_i\ne 0 grupların kendi varyanslarını kullanır:
- \hat\psi: kontrast değeri (ör. c=(-3{,}1{,}1{,}1): üç ilacın ortalamaları toplamı eksi üç kat plasebo).
- \sum c_i=0 değilse ifade bir kontrast değil, doğrusal birleşimdir; MerQur hesaplar ama uyarı satırı yazar.
- p değerleri iki yönlüdür ve çoklu karşılaştırma düzeltmesi uygulanmaz; planlı (önceden belirlenmiş) kontrastlar için doğru olan budur.
Ortogonal polinom katsayıları, eşit aralıklı x=1,\dots,k değerlerinin merkezlenmiş Vandermonde matrisinin QR ayrışımından alınır ve son katsayı pozitif olacak biçimde işaretlenir (hypothesis.py:4028–4041). Sonuç R contr.poly(k) ile aynıdır; k=4'te doğrusal katsayılar (-0{,}6708,\ -0{,}2236,\ 0{,}2236,\ 0{,}6708)'dir.
Nominal grupta trend anlamsız
Polinom trend, düzeyler sıralı ve eşit aralıklı olduğunda (ör. 0, 10, 20, 40 mg doz değilse bile 1., 2., 3., 4. doz basamağı) yorumlanır. Bu veride düzeyler nominal olduğundan (placebo, drug-A, drug-B, drug-C) "doğrusal trend" klinik anlam taşımaz; burada yalnız hesabı göstermek için çalıştırılmıştır. Sıra kullanıcı tarafından ya da etiketlerdeki sayılarla tanımlanmamışsa (verideki ilk görülme sırası) MerQur polinom trend satırının altına "sıra tanımlanmadı" uyarısı yazar.
7.5.7 Eşit varyanslı ikili karşılaştırmalar
Tüm bu yöntemlerde ortak öğeler: \Delta_{ij}=\bar y_i-\bar y_j, SH_{ij}=\sqrt{MS_W\left(1/n_i+1/n_j\right)}, t_{ij}=\Delta_{ij}/SH_{ij}, sd =N-k, çift sayısı m=k(k-1)/2. Yöntemler yalnız kritik değer ve düzeltilmiş p tanımıyla ayrılır:
| Yöntem | Düzeltilmiş p | Eşzamanlı GA yarı genişliği | Kod |
|---|---|---|---|
| LSD (Fisher) | 2P(T_{N-k}\ge\lvert t\rvert) (düzeltmesiz) | t_{1-\alpha/2;\,N-k}\,SH | 4059–4062 |
| Bonferroni | \min(1,\ m\,p_{\text{LSD}}) | t_{1-\alpha/(2m);\,N-k}\,SH | 4133–4159 |
| Šidák | 1-(1-p_{\text{LSD}})^m | t_{1-[1-(1-\alpha)^{1/m}]/2;\,N-k}\,SH | 4063–4067 |
| Tukey HSD (Tukey–Kramer) | P\!\left(Q_{k,\,N-k}\ge \lvert\Delta\rvert/\sqrt{\tfrac{MS_W}{2}(\tfrac1{n_i}+\tfrac1{n_j})}\right) | q_{1-\alpha;\,k,\,N-k}\sqrt{\tfrac{MS_W}{2}(\tfrac1{n_i}+\tfrac1{n_j})} | 4104–4131 |
| Scheffé | P\!\left(F_{k-1,\,N-k}\ge t^2/(k-1)\right) | \sqrt{(k-1)F_{1-\alpha;\,k-1,\,N-k}}\,SH | 4161–4190 |
| Hochberg GT2 | 1-M_{m,\,N-k}(\lvert t\rvert) | m_{1-\alpha;\,m,\,N-k}\,SH | 4068–4070 |
| Gabriel | 1-M_{m,\,N-k}\!\left(\lvert\Delta\rvert/SH_G\right) | m_{1-\alpha;\,m,\,N-k}\,SH_G | 4071–4074 |
- Q_{k,\nu}: studentize aralık dağılımı (k ortalamanın aralığı / SH); q_{1-\alpha;k,\nu} kantili.
- M_{m,\nu}: studentize maksimum modül (SMM) dağılımının birikimli fonksiyonu; m_{1-\alpha;m,\nu} kantili (aşağıda).
- SH_G=\sqrt{MS_W}\left(1/\sqrt{2n_i}+1/\sqrt{2n_j}\right): Gabriel'in SH'si; dengeli tasarımda SH_G=SH olduğundan Gabriel ve GT2 aynı sonucu verir (bu veride de öyle).
SMM dağılımı (_smm_cdf, hypothesis.py:962–986): m bağımsız standart normalin ortak paydalı en büyük mutlak değeri.
- f_S: S'nin yoğunluğu; kodda logaritmik sabitle \exp\{\log c_\nu+(\nu-1)\log s-\nu s^2/2\} biçiminde yazılır.
- İntegral, S'nin tepe noktasında ikiye bölünüp uyarlamalı quad ile alınır (\epsilon_{\text{abs}}=10^{-13}); kantil Brent kökü ile bulunur, üst sınır gerekirse 10'ar kat büyütülür (
_smm_ppf,hypothesis.py:1026–1038).
Neden bu kadar çok yöntem ve hangisi ne zaman?
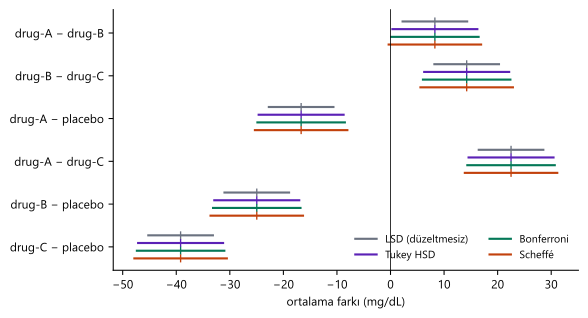
Hepsi aile bazında birinci tür hata oranını (FWER) korumaya çalışır ama farklı "aile" tanımlarıyla. Tukey tüm m ikili farkı birlikte ele alır ve studentize aralığın kesin dağılımını kullandığı için dengeli tasarımda ikili karşılaştırmalar için en dar eşzamanlı aralığı verir. Bonferroni ve Šidák yalnız eşitsizliğe dayanır, bu yüzden biraz geniştir; Šidák bağımsızlık altında tam, Bonferroni her koşulda geçerlidir. GT2 Šidák eşitsizliğinin SMM ile keskinleştirilmiş biçimidir. Scheffé tüm olası kontrastları (sonsuz aile) korur; bu yüzden ikili farklar için en geniş aralığı verir. LSD hiçbir düzeltme yapmaz; yalnız k=3'te ve ANOVA anlamlıysa FWER'i korur (Fisher'ın korumalı LSD'si). Şekil 7.2 bu sıralamayı bu veride gösterir.
Koddaki tercih
Tukey HSD, statsmodels pairwise_tukeyhsd ile hesaplanır; değerler sonuç nesnesinin tam hassasiyetli dizilerinden (meandiffs, pvalues, confint) okunur. Çok küçük p'ler üst kuyruktan (sf) alındığı için 0'a inmez. statsmodels çiftleri sözlük sırasıyla kurar; MerQur her çifti düzey sırasına (7.5.1) yeniden yönlendirir ve farkı "Grup 1 − Grup 2" olarak yazar (\lvert\Delta\rvert, p ve GA genişliği değişmez).
7.5.8 Eşit olmayan varyanslı ikili karşılaştırmalar
| Yöntem | Düzeltilmiş p | GA yarı genişliği | Kod |
|---|---|---|---|
| Games–Howell | P\!\left(Q_{k,\,\nu_{ij}}\ge\sqrt2\,\lvert t^W\rvert\right) | \dfrac{q_{1-\alpha;\,k,\,\nu_{ij}}}{\sqrt2}\,SH^W | 4192–4238 |
| Tamhane T2 | 1-\left(1-2P(T_{\nu_{ij}}\ge\lvert t^W\rvert)\right)^m | t_{1-[1-(1-\alpha)^{1/m}]/2;\,\nu_{ij}}\,SH^W | 4036–4045 |
| Dunnett T3 | 1-M_{m,\,\nu_{ij}}(\lvert t^W\rvert) | m_{1-\alpha;\,m,\,\nu_{ij}}\,SH^W | 4046–4055 |
- \nu_{ij}: çifte özgü Welch–Satterthwaite sd'si; her çiftin kendi kritik değeri vardır.
- \sqrt2: studentize aralık, iki ortalamanın farkını \sqrt{MS/n} ile böler; t ise \sqrt{2MS/n} ile. q=\sqrt2\,t dönüşümü bundan gelir.
Koddaki tercih
Dunnett T3'te \nu_{ij} yuvarlanmadan kullanılır (hypothesis.py:4273–4276); R PMCMRplus::dunnettT3Test sd'yi tam sayıya yuvarlar; bu veride drug-A − drug-B için PMCMRplus p=0{,}057694, MerQur 0{,}057718 verir. Fark yalnız sd tanımındandır; R'de yuvarlamasız SMM integraliyle hesaplanan değer MerQur ile 10^{-13} düzeyinde eşleşir (7.6.1).
7.5.9 Kontrole karşı Dunnett
Kontrol grubu 0 ile her öteki grup karşılaştırılır (hypothesis.py:4210–4237). T_i=\Delta_{i0}/SH_{i0}'lar, ortak \bar y_0 nedeniyle ilişkilidir:
- Tek faktörlü korelasyon yapısı (Z_i=\lambda_iW+\sqrt{1-\lambda_i^2}\,E_i) çok boyutlu integrali iki katlı integrale indirir.
- İç integral 256 düğümlü Gauss–Legendre ile [-8{,}5;\ 8{,}5] aralığında, dış integral uyarlamalı quad ile alınır (
_dunnett_cdf,hypothesis.py:1041–1075). - Düzeltilmiş p=1-P(\max\lvert T\rvert\le\lvert t_i\rvert); GA \Delta_{i0}\pm c_{1-\alpha}SH_{i0} (iki yönlü, tek adım).
Neden kesin integral, neden scipy.stats.dunnett değil?
scipy'nin dunnett fonksiyonu yarı Monte Carlo kullanır ve 10^{-3} düzeyinde göreli sapma gösterebilir; aynı veriyi iki kez çalıştırmak farklı son basamaklar verebilir. Tek faktörlü yapı sayesinde olasılık deterministik olarak 10^{-9} doğrulukla hesaplanabilir; R multcomp::glht da Genz–Bretz yarı Monte Carlo kullanır: bu veride drug-B − drug-A için glht p=0{,}0203730, kesin değer 0{,}0203731'dir.
7.5.10 Adımlı yöntemler: SNK, REGWQ, Duncan
Ortalamalar büyükten küçüğe sıralanır; iki ortalama arasındaki adım r, kapsadıkları ortalama sayısıdır (r=2,\dots,k). Harmonik grup büyüklüğü kullanılır:
| Yöntem | Bildirilen p | Kod |
|---|---|---|
| Student–Newman–Keuls | \max_{\text{kapsayan aralıklar}}p_r | _step_down_close |
| Duncan MRT | \max_{\text{kapsayan aralıklar}}\tilde p; \tilde p=1-(1-p_r)^{1/(r-1)} (r=2'de p_r) | _step_down_close |
| REGWQ | \max_{\text{kapsayan aralıklar}}\tilde p; \tilde p=1-(1-p_r)^{k/r} (r<k-1), \tilde p=p_r (r\ge k-1) | 4013–4024, 4075–4076 |
- Duncan'ın kuralı: r adımlı aralık \alpha_r=1-(1-\alpha)^{r-1} düzeyinde sınanır. Bildirilen p bu kurala denk gelecek biçimde dönüştürülmüştür: \tilde p<\alpha\iff p_r<\alpha_r.
- REGWQ'da \alpha_r=1-(1-\alpha)^{r/k} (r<k-1), \alpha_r=\alpha (r\ge k-1); bildirilen p aynı denklikle dönüştürülür ve kapsayan aralıkların en büyüğü alınır (adım-aşağı kapanış).
- Bu yöntemler GA vermez.
Neden SNK ve Duncan'da adım-aşağı kapanış uygulanır?
Newman (1939), Keuls (1952) ve Duncan (1955) yöntemleri tanım gereği adım adım aşağı iner: bir aralık anlamsızsa içindeki hiçbir alt aralık sınanmaz ve anlamsız sayılır. Kapanış olmazsa ailedeki birinci tür hata denetimi yöntemin tanımının da altına düşer. MerQur bu yüzden SNK, Duncan ve REGWQ'da aynı mantığı kullanır (_step_down_close): bir çiftin raporlanan p'si, sıralı ortalamalarda o çifti kapsayan bütün aralıkların (kendisi dahil) \alpha ile kıyaslanabilir p'lerinin en büyüğüdür. Yapay bir örnekte (üç grup, n=6, ortalamalar 0; 0,2; 1,47) A–C aralığı anlamsızdır (p=0{,}0551); içindeki B–C çiftinin kendi adım p'si 0,0439 olsa da kapanışla p=0{,}0551 raporlanır ve çift anlamsız sayılır. R DescTools::PostHocTest(method = "newmankeuls" | "duncan") ise her çifti kendi adım p'siyle sınar ve bu tür veride ayrışır. Bu veride bütün çiftler anlamlı olduğundan kapanış sonucu değiştirmez.
7.5.11 Harf gösterimi
Anlamlı çiftlerden "ekle–emdir" algoritmasıyla harfler üretilir (Piepho 2004; _cld_letters, hypothesis.py:2889–2915): başta tüm gruplar tek sütundadır; her anlamlı (a,b) çifti için ikisini birlikte içeren sütun ikiye bölünür (biri a'sız, biri b'siz), başka sütunun alt kümesi olan sütunlar atılır. "a" harfi en yüksek ortalamalı grubu içeren sütuna verilir. Aynı harfi paylaşan gruplar seçili yöntemle anlamlı farklı değildir. Dunnett'te harf verilmez (yalnız kontrole karşı karşılaştırma vardır).
7.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Aşağıdaki ara değerler dogrulama/anova/elle_hesap.py ile, MerQur kodu çağrılmadan numpy ile hesaplanmıştır. Metinde 6 ondalık gösterilir.
Adım 1 — Grup özetleri.
| placebo | drug-A | drug-B | drug-C | |
|---|---|---|---|---|
| n_i | 35 | 35 | 35 | 35 |
| \sum y | −265,2 | −849,2 | −1139,1 | −1636,8 |
| \bar y_i | −7,577143 | −24,262857 | −32,545714 | −46,765714 |
| \sum(y-\bar y_i)^2 | 5350,741714 | 4786,541714 | 6810,186857 | 5164,438857 |
| s_i^2 | 157,374756 | 140,780639 | 200,299613 | 151,895261 |
| s_i | 12,544910 | 11,865102 | 14,152725 | 12,324580 |
Genel ortalama \bar y=(-265{,}2-849{,}2-1139{,}1-1636{,}8)/140=-3890{,}3/140=-27{,}787857.
Adım 2 — Kareler toplamları.
Adım 3 — F ve p.
Adım 4 — Etki büyüklükleri ve GA'ları.
\eta^2 için f=57{,}670093 (gözlenen F). Merkezî olmayan F_{3{,}136}'da \lambda_{\text{alt}}=111{,}169816, \lambda_{\text{üst}}=242{,}631886; oran sınırları 111{,}169816/(111{,}169816+136)=0{,}449771 ve 242{,}631886/378{,}631886=0{,}640812. Aynı yolla \varepsilon^2: [0,438452; 0,632540], \omega^2: [0,436389; 0,631025].
Adım 5 — Welch ve Brown–Forsythe. Ağırlıklar w_i=35/s_i^2: placebo 0,222399; drug-A 0,248614; drug-B 0,174738; drug-C 0,230422; W=0{,}876173; \bar y_w=-27{,}597354; \Lambda=0{,}066291.
Brown–Forsythe paydası \sum(1-35/140)s_i^2=0{,}75\times650{,}350269=487{,}762702; F^*=28129{,}320214/487{,}762702=57{,}670093 (=F, dengeli tasarım), \nu_2^*=133{,}426782, p=5{,}69\times10^{-24}.
Adım 6 — Varsayım testleri.
| Test | İstatistik | p | MerQur etiketi |
|---|---|---|---|
| Levene (ortalama merkezli) | W=(32{,}588011/3)/(8370{,}024747/136)=0{,}176502 | 0,912161 | karşılanıyor |
| Brown–Forsythe (medyan merkezli) | W=0{,}138998 | 0,936525 | karşılanıyor |
| Bartlett | T=1{,}210140 (C=1{,}012255) | 0,750573 | karşılanıyor |
| Shapiro–Wilk, placebo / drug-A / drug-C | W=0{,}9773\ /\ 0{,}9698\ /\ 0{,}9675 | 0,670 / 0,439 / 0,379 | karşılanıyor |
| Shapiro–Wilk, drug-B | W=0{,}9266 | 0,0223 | İHLAL |
drug-B'de sağa çarpıklık (1,02) ve ağır kuyruk (basıklık 2,16) vardır; bir uç değer (+10,3) bunu sürükler. n=35 ve dengeli tasarımda F testi bu düzeyde sapmaya dayanıklıdır; Welch ve F^* aynı kararı verir.
Adım 7 — Kontrastlar (düzey sırası verideki ilk görülme sırasıdır: placebo, drug-A, drug-B, drug-C). C1 =(-3{,}1{,}1{,}1):
Welch: SH_W=7{,}385987, \nu=59{,}33, t=-10{,}945437. C2 =(0{,}1,-1{,}0) (drug-A − drug-B): \hat\psi=8{,}282857, SH=3{,}048068, t=2{,}717412, p=0{,}007436; bu, LSD'nin aynı çift için verdiği değerdir.
Doğrusal polinom katsayıları (-0{,}6708;\ -0{,}2236;\ 0{,}2236;\ 0{,}6708) aynı sıraya uygulanır: \hat\psi=-0{,}670820\times(-7{,}577143)-0{,}223607\times(-24{,}262857)+0{,}223607\times(-32{,}545714)+0{,}670820\times(-46{,}765714)=-28{,}140596, SH=\sqrt{162{,}587567\times1/35}=2{,}155310, t_{136}=-13{,}056406, p=9{,}24\times10^{-26} (Welch t=-13{,}319604, \nu=84{,}35). Sıra tanımlanmadığı için MerQur bu satırın üstüne "Düzey sırası tanımlanmadı" uyarısını yazar; düzeyler nominal olduğundan bu sayı yalnız hesabı gösterir.
Adım 8 — Bir çiftte yöntemlerin karşılaştırılması: drug-A − drug-B. \Delta=8{,}282857, SH=\sqrt{162{,}587567\times2/35}=3{,}048068, t=2{,}717412; Tukey için \sqrt{MS_W/35}=2{,}155310 ve q=8{,}282857/2{,}155310=3{,}843001.
| Yöntem | Kritik değer | Yarı genişlik | Düzeltilmiş p | %95 eşzamanlı GA |
|---|---|---|---|---|
| LSD | t=1{,}977561 | 6,027740 | 0,007436 | [2,255118; 14,310597] |
| Tukey HSD | q=3{,}678483 | 7,928269 | 0,036912 | [0,354588; 16,211126] |
| Hochberg GT2 / Gabriel | m=2{,}668105 | 8,132566 | 0,043593 | [0,150291; 16,415424] |
| Šidák | t=2{,}669884 | 8,137987 | 0,043794 | [0,144870; 16,420844] |
| Bonferroni | t=2{,}677399 | 8,160893 | 0,044615 | [0,121964; 16,443750] |
| Scheffé | \sqrt{3\times2{,}671178}=2{,}830819 | 8,628527 | 0,065292 | [−0,345670; 16,911384] |
| Games–Howell | \nu=66{,}0 | 8,227998 | 0,047887 | [0,054859; 16,510856] |
| Tamhane T2 | 0,058384 | [−0,184118; 16,749832] | ||
| Dunnett T3 | 0,057718 | [−0,171439; 16,737153] | ||
| SNK / Duncan (r=2) | 0,007436 | — |
| REGWQ (r=2<k-1) | | | 0,014816 | — |
Bu tek çift, yöntemlerin farkını açıkça gösterir: LSD, Tukey, GT2, Šidák, Bonferroni ve Games–Howell farkı anlamlı bulur; Scheffé, Tamhane T2 ve Dunnett T3 bulmaz. SNK ve Duncan bu çiftte LSD ile aynı p'yi verir; çünkü sıralı ortalamalarda drug-A ile drug-B komşudur (r=2) ve n_h=35'te q=\sqrt2\,t'dir. Adım-aşağı kapanışta raporlanan p, çifti kapsayan aralıkların (kendisi dahil) en büyük p'sidir; kapsayan aralıklar (placebo…drug-B, drug-A…drug-C, placebo…drug-C) p<10^{-10} verdiğinden kapanış bu veride hiçbir p'yi değiştirmez. REGWQ'da komşu çift için \alpha_2=1-0{,}95^{2/4}=0{,}02532; denk p: 1-(1-0{,}007436)^{2}=0{,}014816.
Şekil 7.2. Altı çift için %95 aralıklar: düzeltmesiz LSD, Tukey HSD, Bonferroni ve Scheffé. Sıfırı kesen aralık o yöntemde anlamsız demektir; drug-A − drug-B çiftinde yalnız Scheffé sıfırı keser.
Adım 9 — Dunnett, kontrol placebo ("İlk" seçimi). \lambda_i=\sqrt{35/70}=0{,}707107 (eşit korelasyon 0,5), c_{0{,}95}=2{,}375535, SH=3{,}048068, yarı genişlik 7,240792. drug-A − placebo: \Delta=-16{,}685714, p=6{,}13\times10^{-7}, GA [−23,926506; −9,444923]. Üç ilacın tamamı plasebodan anlamlı biçimde daha fazla düşüş sağlar.
Adım 10 — Harf gösterimi (Tukey). Altı çiftin altısı da anlamlı olduğundan her grup kendi harfini alır: placebo a, drug-A b, drug-B c, drug-C d.
7.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() çağrısının sonuç nesnesinden alınmıştır (dogrulama/anova/merqur_calistir.py); stats/hypothesis.py modülündeki gösterim yuvarlamaları yalnız bellekte etkisizleştirilmiş, hesap mantığı değiştirilmemiştir. Yalnız sonuç metninde yuvarlanmış yazılan değerlerde (Levene, Bartlett, Shapiro–Wilk) gösterilen ondalıkta eşleşme aranmıştır; Tukey dahil bütün post hoc değerleri tam hassasiyetle karşılaştırılmıştır. Kontrastlar Python ve R'de de aynı düzey sırasıyla (placebo, drug-A, drug-B, drug-C) kurulmuş, SNK ve Duncan'a aynı adım-aşağı kapanış uygulanmıştır. R 4.5.3: aov, oneway.test, onewaytests::bf.test, car::leveneTest, bartlett.test, shapiro.test, effectsize::eta_squared/epsilon_squared/omega_squared(alternative = "two.sided"), emmeans::contrast, TukeyHSD, DescTools::PostHocTest (LSD, Bonferroni, Scheffé, SNK, Duncan), emmeans Šidák. R'de hazır karşılığı olmayan ya da tanımı farklı olan yöntemler (GT2, Gabriel, Games–Howell GA'sı, Tamhane T2 GA'sı, yuvarlamasız Dunnett T3, REGWQ, kesin Dunnett) R'de formülden integrate, ptukey, qtukey ile yazılmıştır; bağımsız Python hesabı ise SMM ve Dunnett olasılıklarını MerQur'dan farklı bir integral düzeniyle (ki-kare değişkeni üzerinde quad, iç integral Gauss–Hermite) hesaplar. Ölçüt: en büyük mutlak fark \le 10^{-6} (değer 1'den büyükse göreli).
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| SS_B (gruplar arası) | 28129,320214 | 28129,320214 | 28129,320214 | 1,1e−11 | ✓ |
| SS_W (grup içi) | 22111,909143 | 22111,909143 | 22111,909143 | 4,7e−11 | ✓ |
| MS_B | 9376,440071 | 9376,440071 | 9376,440071 | 1,5e−11 | ✓ |
| MS_W | 162,587567 | 162,587567 | 162,587567 | 2,3e−13 | ✓ |
| F | 57,670093 | 57,670093 | 57,670093 | 9,2e−14 | ✓ |
| p | 4,0746·10−24 | 4,0746·10−24 | 4,0746·10−24 | 1,4e−37 | ✓ |
| \eta^2 | 0,559885 | 0,559885 | 0,559885 | 8,9e−16 | ✓ |
| \varepsilon^2 | 0,550177 | 0,550177 | 0,550177 | 6,7e−16 | ✓ |
| \omega^2 | 0,548402 | 0,548402 | 0,548402 | 6,7e−16 | ✓ |
| \eta^2 %95 GA alt | 0,449771 | 0,449771 | 0,449771 | 1,3e−09 | ✓ |
| \eta^2 %95 GA üst | 0,640812 | 0,640812 | 0,640812 | 8,9e−10 | ✓ |
| \varepsilon^2 %95 GA alt | 0,438452 | 0,438452 | 0,438452 | 1,2e−08 | ✓ |
| \varepsilon^2 %95 GA üst | 0,632540 | 0,632540 | 0,632540 | 1,4e−09 | ✓ |
| \omega^2 %95 GA alt | 0,436389 | 0,436389 | 0,436389 | 2,5e−08 | ✓ |
| \omega^2 %95 GA üst | 0,631025 | 0,631025 | 0,631025 | 1,1e−09 | ✓ |
| Welch F | 59,234722 | 59,234722 | 59,234722 | 7,1e−14 | ✓ |
| Welch sd₂ | 75,425511 | 75,425511 | 75,425511 | 4,3e−14 | ✓ |
| Welch p | 8,7140·10−20 | 8,7140·10−20 | 8,7140·10−20 | 1,9e−33 | ✓ |
| Brown–Forsythe F^* | 57,670093 | 57,670093 | 57,670093 | 7,8e−14 | ✓ |
| Brown–Forsythe sd₂ | 133,426782 | 133,426782 | 133,426782 | 2,3e−13 | ✓ |
| Brown–Forsythe p | 5,6914·10−24 | 5,6914·10−24 | 5,6914·10−24 | 2,1e−37 | ✓ |
| Levene W (ortalama) | 0,1765 | 0,176502 | 0,176502 | 3,6e−16 | ✓ (4 ondalık) |
| Levene p | 0,9122 | 0,912161 | 0,912161 | 1,6e−15 | ✓ (4 ondalık) |
| Brown–Forsythe (medyan) W | 0,139 | 0,138998 | 0,138998 | 8,9e−16 | ✓ (3 ondalık) |
| Bartlett T | 1,2101 | 1,210140 | 1,210140 | 2,0e−15 | ✓ (4 ondalık) |
| Bartlett p | 0,7506 | 0,750573 | 0,750573 | 2,2e−16 | ✓ (4 ondalık) |
| Shapiro–Wilk W (drug-B) | 0,9266 | 0,926646 | 0,926646 | 2,4e−11 | ✓ (4 ondalık) |
| Shapiro–Wilk p (drug-B) | 0,0223 | 0,022262 | 0,022262 | 3,7e−11 | ✓ (4 ondalık) |
| Kontrast C1: \hat\psi | −80,842857 | −80,842857 | −80,842857 | 2,8e−14 | ✓ |
| Kontrast C1: SH | 7,466211 | 7,466211 | 7,466211 | 8,9e−16 | ✓ |
| Kontrast C1: t | −10,827829 | −10,827829 | −10,827829 | 1,4e−14 | ✓ |
| Kontrast C1: p | 4,3480·10−20 | 4,3476·10−20 | 4,3476·10−20 | 3,9e−24 | ✓ |
| Kontrast C1: Welch t | −10,945437 | −10,945437 | −10,945437 | 3,0e−14 | ✓ |
| Kontrast C1: Welch sd | 59,331481 | 59,331481 | 59,331481 | 7,1e−15 | ✓ |
| Kontrast C1: Welch p | 7,2610·10−16 | 7,2611·10−16 | 7,2611·10−16 | 8,3e−21 | ✓ |
| Kontrast C2: \hat\psi | 8,282857 | 8,282857 | 8,282857 | 4,1e−14 | ✓ |
| Kontrast C2: SH | 3,048068 | 3,048068 | 3,048068 | 1,3e−15 | ✓ |
| Kontrast C2: t | 2,717412 | 2,717412 | 2,717412 | 1,5e−14 | ✓ |
| Kontrast C2: p | 0,007436 | 0,007436 | 0,007436 | 2,9e−16 | ✓ |
| Kontrast C2: Welch t | 2,653297 | 2,653297 | 2,653297 | 4,4e−15 | ✓ |
| Kontrast C2: Welch sd | 65,990540 | 65,990540 | 65,990540 | 8,5e−14 | ✓ |
| Kontrast C2: Welch p | 0,009976 | 0,009976 | 0,009976 | 1,2e−17 | ✓ |
| Kontrast doğrusal: \hat\psi | −28,140596 | −28,140596 | −28,140596 | 4,6e−14 | ✓ |
| Kontrast doğrusal: SH | 2,155310 | 2,155310 | 2,155310 | 4,4e−16 | ✓ |
| Kontrast doğrusal: t | −13,056406 | −13,056406 | −13,056406 | 1,8e−15 | ✓ |
| Kontrast doğrusal: p | 9,2380·10−26 | 9,2375·10−26 | 9,2375·10−26 | 4,8e−30 | ✓ |
| Kontrast doğrusal: Welch t | −13,319604 | −13,319604 | −13,319604 | 1,1e−14 | ✓ |
| Kontrast doğrusal: Welch sd | 84,354745 | 84,354745 | 84,354745 | 1,4e−14 | ✓ |
| Kontrast doğrusal: Welch p | 1,8910·10−22 | 1,8909·10−22 | 1,8909·10−22 | 8,1e−27 | ✓ |
Post hoc yöntemlerinde her satır altı çiftin (Dunnett'te üç çiftin) tamamını karşılaştırır; tabloda örnek çift yazılır.
| Yöntem: büyüklük (örnek çift) | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark (tüm çiftler) | Durum |
|---|---|---|---|---|---|
| Tukey HSD: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 7,8e−14 | ✓ |
| Tukey HSD: p (drug-A − drug-B) | 0,036912 | 0,036912 | 0,036912 | 5,3e−13 | ✓ |
| Tukey HSD: GA alt (drug-A − drug-B) | 0,354588 | 0,354588 | 0,354588 | 3,2e−09 | ✓ |
| Tukey HSD: GA üst (drug-A − drug-B) | 16,211126 | 16,211126 | 16,211126 | 3,2e−09 | ✓ |
| LSD: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 7,8e−14 | ✓ |
| LSD: p (drug-A − drug-B) | 0,007436 | 0,007436 | 0,007436 | 2,0e−16 | ✓ |
| LSD: GA alt (drug-A − drug-B) | 2,255118 | 2,255118 | 2,255118 | 4,8e−11 | ✓ |
| LSD: GA üst (drug-A − drug-B) | 14,310597 | 14,310597 | 14,310597 | 4,8e−11 | ✓ |
| Bonferroni: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 7,8e−14 | ✓ |
| Bonferroni: p (drug-A − drug-B) | 0,044615 | 0,044615 | 0,044615 | 1,1e−15 | ✓ |
| Bonferroni: GA alt (drug-A − drug-B) | 0,121964 | 0,121964 | 0,121964 | 8,9e−14 | ✓ |
| Bonferroni: GA üst (drug-A − drug-B) | 16,443750 | 16,443750 | 16,443750 | 9,9e−14 | ✓ |
| Šidák: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 7,8e−14 | ✓ |
| Šidák: p (drug-A − drug-B) | 0,043794 | 0,043794 | 0,043794 | 1,2e−15 | ✓ |
| Šidák: GA alt (drug-A − drug-B) | 0,144870 | 0,144870 | 0,144870 | 9,2e−14 | ✓ |
| Šidák: GA üst (drug-A − drug-B) | 16,420844 | 16,420844 | 16,420844 | 6,8e−14 | ✓ |
| Scheffé: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 7,8e−14 | ✓ |
| Scheffé: p (drug-A − drug-B) | 0,065292 | 0,065292 | 0,065292 | 2,9e−15 | ✓ |
| Scheffé: GA alt (drug-A − drug-B) | −0,345670 | −0,345670 | −0,345670 | 1,1e−13 | ✓ |
| Scheffé: GA üst (drug-A − drug-B) | 16,911384 | 16,911384 | 16,911384 | 6,4e−14 | ✓ |
| Hochberg GT2: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 3,2e−14 | ✓ |
| Hochberg GT2: p (drug-A − drug-B) | 0,043593 | 0,043593 | 0,043593 | 1,3e−14 | ✓ |
| Hochberg GT2: GA alt (drug-A − drug-B) | 0,150291 | 0,150291 | 0,150291 | 4,4e−12 | ✓ |
| Hochberg GT2: GA üst (drug-A − drug-B) | 16,415424 | 16,415424 | 16,415424 | 4,4e−12 | ✓ |
| Gabriel: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 3,2e−14 | ✓ |
| Gabriel: p (drug-A − drug-B) | 0,043593 | 0,043593 | 0,043593 | 1,3e−14 | ✓ |
| Gabriel: GA alt (drug-A − drug-B) | 0,150291 | 0,150291 | 0,150291 | 4,4e−12 | ✓ |
| Gabriel: GA üst (drug-A − drug-B) | 16,415424 | 16,415424 | 16,415424 | 4,4e−12 | ✓ |
| Games–Howell: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 3,2e−14 | ✓ |
| Games–Howell: p (drug-A − drug-B) | 0,047887 | 0,047887 | 0,047887 | 3,2e−11 | ✓ |
| Games–Howell: GA alt (drug-A − drug-B) | 0,054859 | 0,054859 | 0,054859 | 1,2e−09 | ✓ |
| Games–Howell: GA üst (drug-A − drug-B) | 16,510856 | 16,510856 | 16,510856 | 1,2e−09 | ✓ |
| Tamhane T2: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 3,2e−14 | ✓ |
| Tamhane T2: p (drug-A − drug-B) | 0,058384 | 0,058384 | 0,058384 | 3,4e−16 | ✓ |
| Tamhane T2: GA alt (drug-A − drug-B) | −0,184118 | −0,184118 | −0,184118 | 4,3e−14 | ✓ |
| Tamhane T2: GA üst (drug-A − drug-B) | 16,749832 | 16,749832 | 16,749832 | 4,6e−14 | ✓ |
| Dunnett T3: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 3,2e−14 | ✓ |
| Dunnett T3: p (drug-A − drug-B) | 0,057718 | 0,057718 | 0,057718 | 2,5e−14 | ✓ |
| Dunnett T3: GA alt (drug-A − drug-B) | −0,171439 | −0,171439 | −0,171439 | 4,9e−13 | ✓ |
| Dunnett T3: GA üst (drug-A − drug-B) | 16,737153 | 16,737153 | 16,737153 | 5,2e−13 | ✓ |
| SNK: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 7,8e−14 | ✓ |
| SNK: p (drug-A − drug-B) | 0,007436 | 0,007436 | 0,007436 | 2,1e−14 | ✓ |
| Duncan: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 7,8e−14 | ✓ |
| Duncan: p (drug-A − drug-B) | 0,007436 | 0,007436 | 0,007436 | 2,1e−14 | ✓ |
| REGWQ: fark (drug-A − drug-B) | 8,282857 | 8,282857 | 8,282857 | 3,2e−14 | ✓ |
| REGWQ: p (drug-A − drug-B) | 0,014816 | 0,014816 | 0,014816 | 4,2e−14 | ✓ |
| Dunnett (kontrol placebo): fark (drug-A − placebo) | −16,685714 | −16,685714 | −16,685714 | 2,5e−14 | ✓ |
| Dunnett (kontrol placebo): p (drug-A − placebo) | 6,1308·10−7 | 6,1308·10−7 | 6,1308·10−7 | 1,5e−14 | ✓ |
| Dunnett (kontrol placebo): GA alt (drug-A − placebo) | −23,926506 | −23,926506 | −23,926506 | 9,7e−13 | ✓ |
| Dunnett (kontrol placebo): GA üst (drug-A − placebo) | −9,444923 | −9,444923 | −9,444923 | 9,7e−13 | ✓ |
| Dunnett (kontrol drug-A): fark (placebo − drug-A) | 16,685714 | 16,685714 | 16,685714 | 3,2e−14 | ✓ |
| Dunnett (kontrol drug-A): p (placebo − drug-A) | 6,1308·10−7 | 6,1308·10−7 | 6,1308·10−7 | 1,5e−14 | ✓ |
| Dunnett (kontrol drug-A): GA alt (placebo − drug-A) | 9,444923 | 9,444923 | 9,444923 | 9,7e−13 | ✓ |
| Dunnett (kontrol drug-A): GA üst (placebo − drug-A) | 23,926506 | 23,926506 | 23,926506 | 9,6e−13 | ✓ |
Sonuç: 49 ana büyüklük ve 54 post hoc satırının tamamı ölçütü karşılar. En büyük farklar etki büyüklüğü GA'larındadır (2{,}5\times10^{-8}; merkezî olmayan F kök bulma toleransı). Tukey HSD tam hassasiyetle eşleşir. Ek denetimler: multcomp::glht Dunnett p'leri yarı Monte Carlo hatası içinde (\le 2\times10^{-8}) eşleşir; PMCMRplus::dunnettT3Test sd'yi yuvarladığı için 2\times10^{-5} düzeyinde ayrılır.
7.7 Çıktıyı okuma
MerQur'un sonuç metni varsayılan ayarlar ve Tukey HSD ile şöyledir (kısaltılmış):
F(3,136) = 57.6701, p < .001 ***, η² = 0.5599. H₀ REDDEDİLİR.
Post-hoc (Tukey HSD): 6/6 ikilide anlamlı fark bulundu.

── VARSAYIM KONTROLLERİ ──
Levene (varyans homojenliği, ortalama merkezli): W = 0.1765, p = 0.9122 → karşılanıyor
Brown-Forsythe (medyan merkezli Levene): W = 0.139, p = 0.9365 → karşılanıyor

── BETİMSEL İSTATİSTİKLER ──
    placebo: n=35, M=-7.5771, SD=12.5449, SE=2.1205, medyan=-10.0000, ...
    drug-A: n=35, M=-24.2629, SD=11.8651, SE=2.0056, medyan=-25.5000, ...
    Grup 1  Grup 2  Ort. Fark   |Fark|   p (düzelt.) Anlamlılık   Karar  %95 GA alt  %95 GA üst
0  placebo  drug-C    39.1886  39.1886  3.109000e-14        ***  Farklı     31.2603     47.1168
...
5   drug-A  drug-B     8.2829   8.2829  3.691200e-02          *  Farklı      0.3546     16.2111
Tüm seçenekler açıkken ek bölümler:
── Etki büyüklüğü %95 GA (merkezî olmayan F) ──
    η² = 0.5599 [0.4498, 0.6408]   ε² = 0.5502 [0.4385, 0.6325]   ω² = 0.5484 [0.4364, 0.6310]
── Sağlam (robust) eşit ortalama testleri ──
    Brown-Forsythe F*(3, 133.43) = 57.6701, p < .001 ***
    Welch F(3, 75.43) = 59.2347, p < .001
── Planlı kontrastlar / polinom trend ──
    Katsayı sırası (grup düzeyleri): placebo, drug-A, drug-B, drug-C
    ⚠ Düzey sırası tanımlanmadı (drug_group): eğilim testi verideki ilk görülme sırasını (placebo, drug-A, drug-B, drug-C) skor olarak kullandı. ...
    C1: ψ = -80.8429, SE = 7.4662, t(136) = -10.828, p < .001  |  Welch: t(59.33) = -10.945, p < .001
    C2: ψ = 8.2829, SE = 3.0481, t(136) = 2.717, p = 0.0074  |  Welch: t(65.99) = 2.653, p = 0.0100
    Doğrusal: ψ = -28.1406, SE = 2.1553, t(136) = -13.056, p < .001  |  Welch: t(84.35) = -13.320, p < .001
── Harf gösterimi (Tukey HSD; aynı harf = fark yok) ──
    placebo              M = -7.5771   a
| Satır / Öğe | Ne yazar | Nasıl yorumlanır |
|---|---|---|
F(3,136) = 57.6701 |
Uygulanan testin F'si ve sd'leri; Welch varyantında sd₂ iki ondalıklı (ör. 75.43) | Welch seçildiyse ilk satır Welch'tir; ANOVA tablosu yine klasiktir. |
p < .001 *** |
APA biçimli p ve yıldız | Yıldız seçilen \alpha'ya bağlıdır: p\ge\alpha ise "ns", p<\alpha ise 0,001 / 0,01 / 0,05 eşikleri (Bölüm 4.5.2). |
η² = 0.5599 |
Örneklem etki büyüklüğü | LDL değişimindeki değişkenliğin yaklaşık %56'sı ilaç kolundan gelir. |
| ANOVA tablosu (Tablo sekmesi) | Kaynak, SS, df, MS, F, p; Welch'te ek "Welch" satırı | SS ve MS 4 ondalık, p 6 ondalık (çok küçükse 4 anlamlı basamak). |
| Post hoc tablosu | Grup 1, Grup 2, fark, | fark |
Post-hoc (...): 6/6 |
Anlamlı çift sayısı | Kararlar seçilen \alpha ile verilir. |
| Harf gösterimi | Ortalamaya göre azalan sıralı gruplar ve harfler | Aynı harf = seçili yöntemle fark yok. |
| Uyarı satırları | Boş grup, Welch ya da F^* tanımsız, kontrast toplamı ≠ 0 | 7.2'deki uç durum satırlarıyla çıkar. |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Dört kolda LDL değişimi (mg/dL) anlamlı biçimde farklıydı; F(3, 136) = 57{,}67, p < 0{,}001, \eta^2 = 0{,}56 (%95 GA [0,45; 0,64]), \omega^2 = 0{,}55. Varyansların eşitliği Levene testiyle desteklendi (F(3, 136) = 0{,}18, p = 0{,}91); Welch düzeltmesi aynı sonucu verdi (F(3; 75{,}43) = 59{,}23, p < 0{,}001). Tukey HSD ile tüm ikili farklar anlamlıydı; en küçük fark drug-A ile drug-B arasındaydı (8,28 mg/dL, %95 eşzamanlı GA [0,35; 16,21], p = 0{,}037). Plaseboya karşı Dunnett karşılaştırmasında üç ilaç da anlamlı düzeyde daha fazla düşüş sağladı (drug-A: −16,69 mg/dL, %95 GA [−23,93; −9,44], p < 0{,}001).
7.8 Uzman soruları
S1. ANOVA anlamsızken post hoc neden yine de çalışıyor?
MerQur "korumalı" yaklaşım uygulamaz: post hoc seçildiyse F'nin sonucundan bağımsız olarak çalıştırılır (hypothesis.py:3882–3887). Tukey, Bonferroni, Scheffé, Games–Howell ve Dunnett FWER'i kendi başlarına korur; bu yöntemler için ön F testi gerekmez ve onu şart koşmak testi gereksiz yere tutucu yapar. Koruma yalnız LSD için anlamlıdır; LSD kullanılacaksa yorum F anlamlı olduğunda yapılmalıdır.
S2. Tukey değerleri neden yazdırma tablosundan değil, dizilerden okunur?
statsmodels pairwise_tukeyhsd'nin yazdırma tablosu fark, p ve GA'yı 4 ondalığa yuvarlar; bu tablodan okunan p, bu veride beş çiftte 0 görünürdü, oysa R TukeyHSD 3{,}1\times10^{-14} gibi değerler verir. MerQur bu yüzden meandiffs, pvalues ve confint dizilerini tam hassasiyetle okur; çok küçük p'ler üst kuyruktan alınır. Böylece Tukey de öteki yöntemler gibi tam değer saklar; post hoc tablosu p'yi 6 ondalıkla, 10^{-6}'nın altında 4 anlamlı basamakla gösterir (ör. placebo − drug-C için 3.109e-14).
S3. Welch varyantında neden ANOVA tablosu hâlâ klasik?
Tablo SS ve MS sütunları taşır; Welch F bu kareler toplamlarından türetilmez. Welch F'yi tabloya klasik SS'lerin yanına yazmak tutarsız bir tablo üretirdi. MerQur ana sonuç satırında Welch'i, tabloda klasik değerleri ve altına ayrı bir "Welch" satırını verir (hypothesis.py:3855–3864).
S4. Etki büyüklüğü GA'sı R effectsize ile neden farklı çıkıyor?
effectsize 1.0'ın eta_squared() varsayılanı alternative = "greater"dır: alt sınır tek yönlü %95'lik sınırdır, üst sınır 1 yazılır. MerQur iki yönlü %95 GA verir. alternative = "two.sided" ile iki program 10^{-8} içinde eşleşir (7.6.1).
S5. Dengeli tasarımda Gabriel ve Hochberg GT2 neden aynı?
Gabriel'in SH'si \sqrt{MS_W}(1/\sqrt{2n_i}+1/\sqrt{2n_j}), GT2'ninki \sqrt{MS_W(1/n_i+1/n_j)}'dir. n_i=n_j=n ise ikisi de \sqrt{2MS_W/n} olur ve kritik değer (SMM, k^*=m) ortaktır. Grup büyüklükleri ayrıştıkça Gabriel daha liberal olur.
S6. Bir grupta tek gözlem var. Hangi çıktılar etkilenir?
Klasik F hesaplanır (o grup SS_W'ye katkı vermez). Welch F, Brown–Forsythe F^* ve Welch kontrastı tanımsızdır; MerQur bunları "—" ile verir ve nedenini yazar. Games–Howell, Tamhane T2 ve Dunnett T3'te o grubu içeren çiftler NaN işaretlenir ve not düşülür (hypothesis.py:4259–4262, 4203–4210). Shapiro–Wilk o grup için satır vermez (n<3). Eşit varyanslı post hoc testler çalışır, ama tek gözlemli grubun ortalaması kendi varyansı olmadan değerlendirilir.
S7. SNK bir çifti anlamlı, onu kapsayan geniş aralığı anlamsız bulabilir mi?
Hayır. Newman–Keuls tanım gereği adım adım aşağı iner; MerQur SNK, Duncan ve REGWQ'da adım-aşağı kapanışı uygular (7.5.10): kapsayan aralık anlamsızsa içindeki dar aralıklar da anlamsız sayılır ve raporlanan p kapsayan aralıkların en büyük p'sidir. R DescTools::PostHocTest çifti kendi adım p'siyle sınadığı için böyle veride farklı karar verebilir.
S8. Duncan'ın raporlanan p'si neden ham studentize aralık p'si değil?
Duncan'da r adımlı aralığın kritik düzeyi \alpha_r=1-(1-\alpha)^{r-1}'dir; ham p'yi \alpha ile karşılaştırmak yanlış karar verir. MerQur \tilde p=1-(1-p_r)^{1/(r-1)} dönüşümüyle p'yi doğrudan \alpha ile karşılaştırılabilir yapar (hypothesis.py:4284–4290). R DescTools::PostHocTest(method = "duncan") aynı dönüşümü kullanır ve 7.6.1'de 10^{-14} düzeyinde eşleşir. Duncan'ın aile bazında hata oranı \alpha'nın çok üstüne çıkabilir; ziraatte yaygın olsa da FWER denetimi istenen çalışmalarda önerilmez.
S9. Dunnett'i neden Tukey yerine seçeyim?
Yalnız kontrole karşı k-1 karşılaştırma ilgilenilen soruysa Dunnett'in ailesi daha küçüktür (k-1 çift, m yerine); kritik değeri daha düşüktür (bu veride 2,3755, Tukey'nin t ölçeğindeki karşılığı 3{,}6785/\sqrt2=2{,}6011). Aynı veride drug-A − placebo farkı Dunnett'te \pm7{,}24, Tukey'de \pm7{,}93 yarı genişlikle verilir. Kontrol grubunun düzey sırasındaki yeri (7.3, 7.5.1) çıktıda denetlenmelidir.
S10. Kontrast p'leri çoklu karşılaştırma için düzeltiliyor mu?
Hayır. Planlı kontrastlar önceden belirlenmiş az sayıda hipotez için tasarlanır ve MerQur her birini t_{N-k} ile düzeltmesiz sınar (hypothesis.py:4046). Kontrastlar veriye bakıldıktan sonra seçildiyse Scheffé ölçütü uygundur: \lvert t\rvert, \sqrt{(k-1)F_{1-\alpha;k-1,N-k}} ile karşılaştırılır. Elde birden çok kontrastın p'si varsa "Çoklu Karşılaştırma Düzeltme" modülüyle Holm uygulanabilir.
7.9 Sık hatalar ve tuzaklar
- Dunnett'te kontrolü denetlememek. "İlk" ve "Son" düzey sırasına göredir; sıra tanımlanmamış metin etiketlerinde verideki ilk görülme sırası geçerlidir. Çıktıdaki kontrol grubu adı okunmalıdır.
- Post hoc tablolarında fark yönünü karıştırmak. Fark her zaman Grup 1 − Grup 2'dir; Grup 1 ve Grup 2 sütunlarını okuyun.
- Levene anlamsızlığını "varyanslar eşit" diye okumak. Anlamsız sonuç eşitliği kanıtlamaz; varyanslar ve n'ler farklıysa Welch ve Games–Howell daha güvenlidir.
- Çoklu bağımlı değişkende düzeltmesizlik. Birden çok Değer Sütunu seçildiğinde her biri ayrı ANOVA'dır ve aile düzeltmesi yapılmaz.
- Polinom trendi nominal gruplarda yorumlamak. Katsayılar düzey sırasına uygulanır; sıra tanımlanmamışsa bu verideki ilk görülme sırasıdır ve doz basamağı anlamı taşımaz.
- APA satırını olduğu gibi Türkçe metne almak. APA satırı ondalık noktayla yazılır.
7.10 Kaynaklar
- Bartlett, M. S. (1937). Properties of sufficiency and statistical tests. Proceedings of the Royal Society of London. Series A, 160(901), 268–282. https://doi.org/10.1098/rspa.1937.0109
- Brown, M. B., & Forsythe, A. B. (1974a). The small sample behavior of some statistics which test the equality of several means. Technometrics, 16(1), 129–132. https://doi.org/10.1080/00401706.1974.10489158
- Brown, M. B., & Forsythe, A. B. (1974b). Robust tests for the equality of variances. Journal of the American Statistical Association, 69(346), 364–367. https://doi.org/10.1080/01621459.1974.10482955
- Duncan, D. B. (1955). Multiple range and multiple F tests. Biometrics, 11(1), 1–42. https://doi.org/10.2307/3001478
- Dunnett, C. W. (1955). A multiple comparison procedure for comparing several treatments with a control. Journal of the American Statistical Association, 50(272), 1096–1121. https://doi.org/10.1080/01621459.1955.10501294
- Dunnett, C. W. (1980). Pairwise multiple comparisons in the unequal variance case. Journal of the American Statistical Association, 75(372), 796–800. https://doi.org/10.1080/01621459.1980.10477552
- Einot, I., & Gabriel, K. R. (1975). A study of the powers of several methods of multiple comparisons. Journal of the American Statistical Association, 70(351), 574–583. https://doi.org/10.1080/01621459.1975.10482474
- Gabriel, K. R. (1978). A simple method of multiple comparisons of means. Journal of the American Statistical Association, 73(364), 724–729. https://doi.org/10.1080/01621459.1978.10480084
- Games, P. A., & Howell, J. F. (1976). Pairwise multiple comparison procedures with unequal N's and/or variances: A Monte Carlo study. Journal of Educational Statistics, 1(2), 113–125. https://doi.org/10.3102/10769986001002113
- Hochberg, Y. (1974). Some generalizations of the T-method in simultaneous inference. Journal of Multivariate Analysis, 4(2), 224–234. https://doi.org/10.1016/0047-259X(74)90015-3
- Kelley, T. L. (1935). An unbiased correlation ratio measure. Proceedings of the National Academy of Sciences, 21(9), 554–559. https://doi.org/10.1073/pnas.21.9.554
- Keuls, M. (1952). The use of the "studentized range" in connection with an analysis of variance. Euphytica, 1(2), 112–122. https://doi.org/10.1007/BF01908269
- Kramer, C. Y. (1956). Extension of multiple range tests to group means with unequal numbers of replications. Biometrics, 12(3), 307–310. https://doi.org/10.2307/3001469
- Levene, H. (1960). Robust tests for equality of variances. I. Olkin (Ed.), Contributions to probability and statistics içinde (ss. 278–292). Stanford University Press.
- Newman, D. (1939). The distribution of range in samples from a normal population, expressed in terms of an independent estimate of standard deviation. Biometrika, 31(1–2), 20–30. https://doi.org/10.1093/biomet/31.1-2.20
- Piepho, H.-P. (2004). An algorithm for a letter-based representation of all-pairwise comparisons. Journal of Computational and Graphical Statistics, 13(2), 456–466. https://doi.org/10.1198/1061860043515
- Scheffé, H. (1953). A method for judging all contrasts in the analysis of variance. Biometrika, 40(1–2), 87–110. https://doi.org/10.1093/biomet/40.1-2.87
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3–4), 591–611. https://doi.org/10.1093/biomet/52.3-4.591
- Šidák, Z. (1967). Rectangular confidence regions for the means of multivariate normal distributions. Journal of the American Statistical Association, 62(318), 626–633. https://doi.org/10.1080/01621459.1967.10482935
- Steiger, J. H. (2004). Beyond the F test: Effect size confidence intervals and tests of close fit in the analysis of variance and contrast analysis. Psychological Methods, 9(2), 164–182. https://doi.org/10.1037/1082-989X.9.2.164
- Tamhane, A. C. (1979). A comparison of procedures for multiple comparisons of means with unequal variances. Journal of the American Statistical Association, 74(366), 471–480. https://doi.org/10.1080/01621459.1979.10482541
- Welch, B. L. (1951). On the comparison of several mean values: An alternative approach. Biometrika, 38(3–4), 330–336. https://doi.org/10.1093/biomet/38.3-4.330