73. Naive Bayes
Analiz kimliği: naive_bayes · Menü adı: Naive Bayes · Panel: gui/panels/analyses/naive_bayes.py · Motor: ml/naive_bayes.py, NaiveBayesNB (satır 182–314) ve ml/classification.py, Classification.naive_bayes (satır 913–1021) ile ortak sınıflama altyapısı _run_sklearn_model (satır 1089–1687)
73.1 Ne işe yarar
Naive Bayes, bir gözlemin hangi sınıfa ait olduğunu, sınıfın önsel olasılığını ve özelliklerin o sınıftaki dağılımını Bayes kuralıyla birleştirerek kestirir. Cevapladığı soru şudur: "HbA1c'si 6,3, BMI'si 30,1, ailede diyabet öyküsü olan 52 yaşındaki bu kadın hangi glisemik sınıfa girer ve bu atama ne kadar kesin?"
Model, sınıf k verildiğinde p özelliğin birbirinden bağımsız olduğunu varsayar ("naive", yani saf varsayım budur):
- Y: sınıf değişkeni; K sınıf, k=1,\dots,K.
- \mathbf x=(x_1,\dots,x_p): bir gözlemin özellik vektörü (sayısal ve kategorik karışık olabilir).
- \pi_k=P(Y=k): sınıfın önsel olasılığı.
- f_{jk}(x_j): j. özelliğin k. sınıftaki koşullu yoğunluğu (sayısal özellik) ya da koşullu olasılığı (kategorik özellik).
- Pay: \pi_k\,f(\mathbf x\mid k), yani bileşik olasılık; payda aynı terimin tüm sınıflar üzerinden toplamıdır ve sonsalları 1'e tamamlar.
Neden "saf" bağımsızlık?
p boyutlu bir sınıf koşullu dağılımı kestirmek, özellikle kategorik ve sayısal değişkenler karıştığında, çok parametre ister. Bağımsızlık varsayımıyla f(\mathbf x\mid k) tek boyutlu p dağılımın çarpımına iner: her özellik için yalnız sınıf içi ortalama ve SS (ya da bir sıklık tablosu) kestirilir. Varsayım çoğu veride yanlıştır; buna karşın sınıflama doğruluğu çoğu kez iyidir, çünkü atama için olasılıkların değil sıralarının doğru olması yeter (Domingos ve Pazzani 1997; Hand ve Yu 2001). Bağımlı özelliklerde sonsallar 0 ya da 1'e doğru abartılır.
Ne zaman kullanılır? Hedef kategorik (iki ya da daha çok sınıf) ve özellikler sayısal, kategorik ya da ikisinin karışımıysa; özellik sayısı gözlem sayısına göre büyükse; hızlı, şeffaf (her parametresi bir tablo) bir başlangıç sınıflayıcısı gerekiyorsa; eksik değerli satırların silinmesi istenmiyorsa (MerQur eksik özelliği o satırda atlar).
Ne zaman kullanılmaz?
- Amaç bir özelliğin etkisini kestirmek ve test etmekse (OR, GA, p): Multinomial Lojistik Regresyon ya da iki sınıfta İkili Lojistik Regresyon.
- Özellikler sayısal, sınıf içinde güçlü ilişkili ve yaklaşık çok değişkenli normalse: Diskriminant Analizi (LDA / QDA); LDA aynı Bayes kuralını ortak kovaryans matrisiyle, yani ilişkileri hesaba katarak uygular.
- Hedef sayısal ise: MerQur'da Naive Bayes regresyon yapmaz (
classification.py:938–939hata verir); Karar Ağacı, Rastgele Orman ya da regresyon modelleri. - İyi kalibre olasılık gerekiyorsa (risk puanı): Naive Bayes sonsalları bağımlı özelliklerde aşırı keskindir; lojistik model tercih edilir.
Sık karıştırılan analizler. Diskriminant analizi (LDA) da Bayes kuralıyla sınıflar ve sayısal özellikleri normal kabul eder; fark, LDA'nın sınıflar arasında ortak bir tam kovaryans matrisi kullanması, Naive Bayes'in ise her sınıfta köşegen (ilişkisiz) yapı varsaymasıdır. Normal yoğunluklu Naive Bayes, sınıf içi kovaryansları köşegen ve sınıfa göre farklı olan bir QDA'dır. kNN ve çekirdek diskriminant de yoğunluk temellidir ama değişkenleri birlikte (çok boyutlu uzaklıkla) ele alır.
73.2 Varsayımlar ve veri türü
| Varsayım | Ne demek | MerQur'da nasıl denetlenir |
|---|---|---|
| Kategorik hedef | Y en az 2 sınıflı. | Tek sınıfta hata (classification.py:1237–1238); "Regresyon" görevi hata (classification.py:938–939). |
| Sınıf içi koşullu bağımsızlık | Sınıf bilindiğinde özellikler birbirinden bağımsız. | Denetlenmez. |
| Sayısal X sınıf içinde normal | "Normal (Gauss)" yoğunlukta her sınıfta N(\mu_{jk},\sigma_{jk}^2). | Denetlenmez; "Çekirdek yoğunluğu" seçeneği dağılım varsayımını kaldırır. |
| Yeterli sınıf içi gözlem | Sayısal X'te sınıf başına en az 2 geçerli değer (SS için). | Normalde uyarı ve tanımsız sonsal (naive_bayes.py:257–265); çekirdekte hata. |
| Bölme için yeterli sınıf büyüklüğü | Tabakalı bölmede her sınıfta en az 2 gözlem; CV kat sayısı en büyük sınıfı aşmamalı. | Hata (classification.py:1239–1253, 1337–1342). |
Eksik değer. Arayüz varsayılanı "Atla (satır silinmez)"dir; bu, R e1071::naiveBayes formül arayüzünün na.action = na.pass davranışıdır. Kestirimde her özellik kendi eksiklerini çıkararak ortalama/SS/tablo hesaplar; tahminde eksik özellik o satırın çarpımına hiç girmez (çarpana 1 konur, naive_bayes.py:279–283). Hedefi eksik satır her durumda atılır (classification.py:1204). "Liste bazında sil" seçilirse herhangi bir X'i eksik satır analizden çıkar.
Uç durumlar (koddan).
- Bir sınıfta sayısal X'in eksik olmayan değeri 2'den azsa SS tanımsızdır (R'de
sd()= NA); MerQur analizi durdurmaz, o değişkeni dolu olan satırların sonsalını tanımsız (—) yapar, sınıf tahminini Rwhich.maxgibi tanımsız sınıfları atlayarak üretir ve sonuç metnine uyarı yazar (naive_bayes.py:257–265,310–314; uyarı metninb_warn_na_params). ROC-AUC bu satırlar çıkarılarak hesaplanır (classification.py:1409–1415). - Kategorik X'in bir sınıfta hiç gözlemi yoksa ve Laplace = 0 ise olasılıklar 0/0 = NaN olur; aynı uyarı yolu işler (
naive_bayes.py:247–251). - Çekirdek yoğunluğunda sınıf içi geçerli gözlem 2'den azsa analiz hata verir; R
density()da bant genişliği hesaplayamaz (naive_bayes.py:258–260). - Önsel değerleri sıfır, negatif ya da sonsuz olamaz (
naive_bayes.py:228–229,classification.py:443–444).
73.3 Parametreler
Varsayılanlar naive_bayes.py:51–109 ve ortak sınıflama satırlarından (_ml_options.py:179–271) alınmıştır.
| Arayüz adı | Varsayılan | Ne yapar | Sonucu nasıl değiştirir |
|---|---|---|---|
| Hedef sınıf (Y) | veriye bağlı | Sınıf değişkeni. | Sınıflar MerQur düzey sırasıyla dizilir (önsel girişinde bu sıra kullanılır). |
| Özellikler (X) | en az 1 | Sayısal ve kategorik özellikler. | Metin sütunu ve Veri sekmesinde "kategorik" işaretli sütun kategorik (sıklık tablosu); diğerleri sayısal (yoğunluk). |
| Sayısal X yoğunluğu | Normal (Gauss) | Normal: sınıf içi ortalama ve SS ile normal yoğunluk. Çekirdek: sınıf içi Gauss çekirdek yoğunluğu. | Yalnız sayısal X'lerin f_{jk}'sı değişir. |
| Laplace düzeltmesi | 0 | Kategorik olasılıklara eklenen sayı l. | Yalnız kategorik X tabloları; sayısal X'e etkisi yok. |
| Önsel olasılıklar | Eğitim verisindeki oranlar | Eğitim oranları, Eşit (1/K) ya da Kullanıcı tanımlı. | Tüm sonsallar ve sınıf atamaları. |
| Önsel değerleri | boş (pasif) | "0.5, 0.3, 0.2" ya da "A=0.5; B=0.3; C=0.2". | Toplamı 1'e ölçeklenir; sıra çıktıdaki sınıf sırasıdır. |
| Olasılık alt sınırı (threshold) | 0,001 | eps'ten büyük olmayan yoğunluk/olasılık bu değerle değiştirilir; SS ≤ eps ise SS yerine de kullanılır. | Sıfır olasılıklı hücrelerin log-olabilirliği. |
| eps | 0 | "Sıfır" sayılacak sınır. | Varsayılanda yalnız tam sıfırlar değişir. |
| Eksik değerler | Atla (satır silinmez) | Atla ya da liste bazında sil. | n ve parametreler. |
| Test oranı | 0,20 | Tabakalı eğitim/test bölmesi; 0 = "Yok (tüm veri)". | Parametreler eğitim kümesinden; başarım test kümesinde. |
| CV kat sayısı (k) | 5 | Eğitim kümesinde tabakalı, karıştırmalı k-kat CV. | Yalnız CV satırı. |
| CV tekrar sayısı | 1 | Tekrarlı tabakalı CV. | Yalnız CV satırı. |
| Rastgele tohum | 42 | Bölme ve kat dizinleri için tohum (seed). | Bölme ve CV; model kuralı değişmez. |
| Hazır bölme / kat sütunu, ayrı test dosyası | (yok) | Bölmeyi veriden ya da dosyadan alır. | Bölme. |
| Permütasyon önemi (test kümesi) | kapalı | Özelliği karıştırınca doğruluk kaybı. | Ek tablo. |
| Tahmin ve olasılıkları veri setine kaydet | kapalı | NB_PRED ve NB_P_ |
Veri setine yeni sütunlar. |
| Olasılık eşiği (ikili) | Varsayılan (en olası sınıf) | İki sınıfta P(\text{ikinci sınıf})\ge c kuralı. | Yalnız ikili hedefte; çok sınıfta ayar bloğuna "uygulanmadı" yazılır. |
| Ek çıktılar: Dengesiz veri metrikleri, PDP | kapalı | Kappa, MCC, dengeli doğruluk; kısmi bağımlılık. | Ek bölüm. |
| Grafik | Sınıf koşullu dağılımlar | Yoğunluk eğrileri ve olasılık çubukları; ROC; PDP; 3B. | Yalnız Grafik sekmesi. |
"Sınıf dengesi" ve "hiperparametre ayarı" kutuları bu panelde yoktur; ortak çağrıdan gelirse ayar bloğuna nedeniyle yazılır: Naive Bayes'te sınıf dengesi önsel olasılıklarla verilir ("Eşit" önsel), ayarlanacak ızgara parametresi yoktur (classification.py:947–950).
Kategorik mi sayısal mı? (koddan)
Özellik türü encode_categoricals_codes ile belirlenir (classification.py:261–287): sayısal sütun sayısal kalır; metin sütunu ya da Veri sekmesinde "kategorik" işaretli sütun düzey koduna (0, 1, …) çevrilir ve kategorik sayılır. Düzeyler MerQur düzey sırasıyla dizilir: sıralı (ordered) pandas kategorisinde ya da Veri sekmesinde tanımlı sıra; yoksa sayısal ya da doğal sıra; o da yoksa verideki ilk görülme sırası. 0/1 kodlu bir cinsiyet sütunu işaretlenmezse sayısal kabul edilir ve normal yoğunlukla modellenir; ipucu ve ön işleme notu bunu hatırlatır. Kategorik değişkenin düzey sayısı (Laplace paydasındaki L_j) eğitimde gözlenmeyen düzeyleri de içerir (classification.py:1263–1267), R factor düzeyleriyle aynı.
73.4 Tıp örneği
Dosya: english/datasets/Tip/121_decision_tree_glycaemic_status.xlsx. Tıp setinde Naive Bayes için ayrı bir dosya yoktur; karma (sayısal + kategorik) özellikli, üç sınıflı bu Tıp dosyası Karar Ağacı bölümüyle ortaktır.
| Değişken | Rol | Tür | Özet |
|---|---|---|---|
glycaemic_status |
Hedef | 3 sınıf | diabetes 115 (%20,9), normoglycaemic 281 (%51,1), prediabetes 154 (%28,0) |
hba1c_pct |
Özellik | sayısal (%) | ort. 6,04; SS 0,94; 4,4–9,6 |
bmi |
Özellik | sayısal (kg/m²) | ort. 28,49; SS 4,88; 18,0–44,1 |
age |
Özellik | sayısal (yıl) | ort. 51,82; SS 11,91; 25–85 |
systolic_bp |
Özellik | sayısal (mmHg) | ort. 127,99; SS 14,78; 95–172 |
family_history |
Özellik | metin: no / unknown / yes | 276 / 63 / 211 |
sex |
Özellik | metin: F / M | 288 / 262 |
n ve eksik değer: 550 hasta; hiçbir sütunda eksik değer yok.
Klinik soru: HbA1c, BMI, yaş, sistolik kan basıncı, aile öyküsü ve cinsiyet birlikte bir hastanın glisemik sınıfını ne doğrulukla öngörür?
Seçilen ayarlar: Arayüz varsayılanları (normal yoğunluk, Laplace 0, eğitim oranı önseli, %20 test, 5 kat, tohum 42). Elle hesap için ayrıca test oranı "Yok (tüm veri)" ile çalıştırılmıştır: parametreler 550 hastanın tümünden kestirilir, böylece tablolar tam sayılarla izlenebilir. Laplace 1 + eşit önsel, kullanıcı önseli (0,5 / 0,3 / 0,2) ve çekirdek yoğunluğu ayrı çalıştırmalardır.
73.5 Formüller ve hesap adımları
MerQur'un hesap sırası şudur: (1) hedefi eksik satırlar atılır, kategorik X'ler düzey koduna çevrilir; (2) tabakalı eğitim/test bölmesi yapılır; (3) yalnız eğitim kümesinde önseller, sayısal X için sınıf içi ortalama ve SS (ya da çekirdek yoğunluğu), kategorik X için koşullu olasılık tabloları kestirilir; (4) her satır için log bileşik olasılık L_k toplanır, sonsal olasılıklar normalleştirilir; (5) test kümesi en büyük sonsala göre sınıflanır, CV eğitim kümesinde yinelenir. Tanım R e1071::naiveBayes 1.7-17 ile birebirdir; çekirdek seçeneği klaR::NaiveBayes(usekernel = TRUE) tanımını izler (naive_bayes.py:1–40).
73.5.1 Önsel olasılıklar
- n_k: eğitim kümesinde k. sınıfın gözlem sayısı.
- q_k: kullanıcının girdiği pozitif sayı (toplamı 1 olmak zorunda değildir; q_k/\sum q_l alınır,
klaRprior/sum(prior)kuralı).
Önsel neden sonucu bu kadar değiştirir?
Sonsalın logaritması \ln\pi_k ile özellik terimlerinin toplamıdır. Özellikler sınıfları zayıf ayırıyorsa (bu veride normoglycaemic ile prediabetes HbA1c ortalamaları 5,75 ve 5,80'dir) karar \ln\pi_k farkına yaslanır. Eğitim oranları kullanılırsa sık sınıf (normoglycaemic, %51) kazanır; eşit önsel seyrek sınıfları (diabetes) öne çıkarır, genel doğruluk düşer ama seyrek sınıfın duyarlılığı artar (73.6, Adım 6).
Koddaki tercih: önsel sırası ve ayrıştırma
Kullanıcı önseli parse_prior ile okunur (classification.py:409–447): ";" ya da satır sonu varsa ayırıcı odur ve ondalık virgül serbesttir ("0,5; 0,3; 0,2"); yoksa virgül ayırıcıdır ("0.5, 0.3, 0.2"); "sınıf=değer" biçimi de kabul edilir. Sıra çıktıdaki sınıf sırasıdır (MerQur düzey sırası: sayısal etiketlerde sayısal, aksi hâlde verideki sıra; classification.py:952–956), ipucu metni de bunu söyler. Değerler pozitif olmalı; toplamları 1'e ölçeklenir.
73.5.2 Sayısal özellik: normal yoğunluk
- n_{jk}: k. sınıfta x_j'si eksik olmayan eğitim gözlemi sayısı (eksikler değişken başına atılır).
- \hat\sigma_{jk}: n-1 bölenli sınıf içi SS (R
sd). - f_{jk}(x): bir olasılık değil yoğunluktur; 1'den büyük olabilir. Birimi x'in biriminin tersidir; bu nedenle farklı ölçekli özelliklerin yoğunluklarını karşılaştırmak anlamsızdır, yalnız aynı özelliğin sınıflar arası oranı anlamlıdır.
Neden n-1?
n-1 bölenli varyans yansızdır ve R e1071 aynı tanımı kullanır. scikit-learn GaussianNB ise n bölenli varyans ve buna ek olarak tüm varyansların en büyüğünün 10^{-9} katı kadar bir düzeltme ekler; bu yüzden MerQur GaussianNB kullanmaz, ayrı bir kestirici (NaiveBayesNB) yazar. Küçük sınıflarda iki tanımın sonsalları belirgin biçimde ayrılabilir.
Koddaki tercih: SS sıfırsa ve yoğunluk sıfırsa
Tahminde önce \hat\sigma_{jk}\le\varepsilon olan sınıfların SS'si threshold değeriyle değiştirilir, sonra (sayısal ve kategorik) f\le\varepsilon olan değerler threshold olur (naive_bayes.py:295–298). Varsayılan \varepsilon=0, threshold = 0,001: yalnız tam sıfır SS ve tam sıfır yoğunluk/olasılık değişir. Bu, e1071::predict.naiveBayes kodunun aynısıdır. Normal yoğunluk, R dnorm C kodunun (|z|\ge5 için iki parçalı üstel ve alt taşma sınırı dahil) birebir kopyasıyla hesaplanır (naive_bayes.py:64–85), böylece çok uzak değerlerde yoğunluğun 0'a düştüğü nokta R ile aynıdır.
73.5.3 Kategorik özellik: koşullu olasılık tablosu ve Laplace düzeltmesi
- c_{jkv}: eğitim kümesinde sınıfı k ve x_j düzeyi v olan gözlem sayısı (eksik x_j sayılmaz).
- L_j: x_j'nin düzey sayısı (eğitimde gözlenmeyen düzey dahil).
- l\ge0: Laplace düzeltmesi; l=0 ham oran, l=1 "artı bir" düzeltmesidir.
Neden Laplace düzeltmesi?
Bir düzey bir sınıfta hiç görülmemişse ham oran 0'dır; çarpımda tek bir 0, diğer tüm kanıtlardan bağımsız olarak o sınıfın sonsalını sıfırlar. l>0 her hücreye "sanal" l gözlem ekler; bu, düzeylere eşit ağırlıklı simetrik bir Dirichlet(l) önselinin sonsal ortalamasıdır. MerQur'da varsayılan l=0'dır (e1071 gibi); sıfır hücre ortaya çıkarsa 73.5.2'deki threshold kuralı (0,001) devreye girer, yani sıfır olasılık yine tam sıfır olarak kalmaz.
73.5.4 Bileşik log-olasılık ve sonsal olasılık
- L_k: sınıf k için önsel ve tüm özellik katkılarının log toplamı; f_{jk} kategorik X'te tablo olasılığıdır.
- Toplam yalnız gözlenen özellikler üzerindendir: eksik özellik çarpana 1 olarak girer.
- Sonsal formülü
e1071type = "raw"biçimidir; üstel alınmadan önce farklar alındığı için çok küçük olasılıklarda taşma olmaz.
Neden log ölçeğinde toplam?
Altı özelliğin yoğunluklarının çarpımı bu veride 10^{-7} düzeyindedir; yüz özellikte bilgisayarın en küçük sayısının altına iner. Logaritma çarpımı toplama çevirir; sonsal yalnız L_l-L_k farklarına bağlı olduğundan ortak sabitler sadeleşir.
73.5.5 Çekirdek yoğunluğu seçeneği
"Çekirdek yoğunluğu" seçilince her sayısal X'in her sınıftaki yoğunluğu R density() (Gauss çekirdeği, bw = "nrd0", n=512, cut = 3) ile kestirilir (naive_bayes.py:112–168):
- h_{jk}: Silverman'ın başparmak kuralıyla bant genişliği (R
bw.nrd0); IQR, Rquantiletür 7 ile hesaplanan çeyrekler açıklığıdır. - \phi: standart normal yoğunluk.
- Kestirim 512 noktalı bir ızgarada yapılır: ızgara [\min x-3h,\ \max x+3h] aralığını kaplar.
Koddaki tercih: ızgara, FFT ve en yakın nokta
R density() toplamı doğrudan hesaplamaz: gözlemleri [\,\min x-7h,\ \max x+7h\,] aralığındaki 1024 noktalı bir ızgaraya doğrusal ağırlıkla dağıtır (BinDist), çekirdekle FFT üzerinden döngüsel evrişim yapar ve 512 noktalı çıktı ızgarasına doğrusal ara değerle taşır. MerQur bu algoritmayı bit düzeyinde aynı ızgarayla yeniden yazar (r_density, _bindist, r_seq). Tahminde klaR::dkernel(interpolate = FALSE) kuralı uygulanır: yeni değerin yoğunluğu en yakın ızgara noktasındaki değerdir (naive_bayes.py:171–175). Izgara dışındaki bir değer de en yakın uçtaki (çok küçük) yoğunluğu alır; tam 0 ise threshold (0,001) kuralı işler. klaR'dan tek fark: MerQur yoğunluğu eksik değerleri çıkararak kestirir, klaR eksik değerde durur.
Doğrudan çekirdek toplamıyla fark
Izgara ve ikili dağıtım, ızgara noktalarındaki yoğunluğu \hat f_{jk}(x)'in doğrudan toplamından ayırır: bu veride HbA1c için en büyük mutlak fark normoglycaemic ve prediabetes sınıflarında 1{,}1\times10^{-4}, bant genişliği küçük olan diabetes sınıfında 9{,}9\times10^{-4}'tür (tepe yoğunluğunun yaklaşık binde biri). MerQur R ile aynı sayıyı verir; elle doğrudan toplam yapan biri üçüncü ya da dördüncü ondalıkta farklı sonuç bulur. Doğrulamada (73.6.1) bağımsız Python hesabı aynı ızgara algoritmasını ayrıca yazarak yapılmıştır.
73.5.6 Bölme, başarım ölçüleri ve çapraz doğrulama
Test oranı >0 ise satırlar tabakalı olarak bölünür (train_test_split(..., stratify=…, random_state=tohum), classification.py:1302–1306). Tabaka kodu sınıfların veride ilk görülme sırasıdır (first_seen_codes, classification.py:219–229); böylece aynı veri Türkçe ve İngilizce etiketlerle aynı satırları seçer. Doğruluk, kesinlik, duyarlılık ve F1 test kümesinde hesaplanır (iki sınıfta "binary", çok sınıfta destekle ağırlıklı ortalama). ROC-AUC çok sınıfta bire-karşı-diğerleri (OvR) AUC'lerin ağırlıksız ortalamasıdır:
- \hat P_k(a): a gözleminin k sınıfı için sonsal olasılığı.
- Her terim, k sınıfına karşı diğerleri için Mann–Whitney AUC'sidir; ortalama sınıf büyüklüğüyle ağırlıklandırılmaz (scikit-learn
average="macro").
CV, yalnız eğitim kümesinde tabakalı ve karıştırmalı k katla yapılır (StratifiedKFold(k, shuffle=True, random_state=tohum), classification.py:1482–1505); her katta model o katın eğitim kısmından yeniden kestirilir. "±" değeri kat doğruluklarının n-1 bölenli SS'sidir (_classification_format.py:21–27). Test kümesi varken eğitim kümesinin kendi doğruluğu da ayrıca yazılır (aşırı uyum karşılaştırması için).
73.6 Elle hesap: Tıp verisinde sayısal yürüyüş
Ara değerler dogrulama/naive_bayes/elle_hesap.py ile, MerQur çağrılmadan numpy ile hesaplanmıştır. Adım 1–5 "Yok (tüm veri)" çalıştırmasıdır (550 hasta). Sınıf sırası MerQur düzey sırasıdır (verideki ilk görülme): prediabetes, diabetes, normoglycaemic; aile öyküsü düzeyleri yes, no, unknown.
Adım 1 — Önseller. n_k=(154;\ 115;\ 281), \pi_k=(0{,}280000;\ 0{,}209091;\ 0{,}510909); \ln\pi_k=(-1{,}272966;\ -1{,}564986;\ -0{,}671564).
Adım 2 — Sayısal X tabloları (sınıf içi ortalama / n-1 bölenli SS).
| Özellik | prediabetes | diabetes | normoglycaemic |
|---|---|---|---|
hba1c_pct |
5,797403 / 0,785901 | 7,097391 / 0,773856 | 5,745196 / 0,764236 |
bmi |
32,672078 / 4,031275 | 28,813913 / 4,524551 | 26,068683 / 3,740571 |
age |
51,928571 / 11,323587 | 50,617391 / 12,393110 | 52,249110 / 12,037525 |
systolic_bp |
127,207792 / 15,821585 | 127,956522 / 16,768491 | 128,437722 / 13,291399 |
Adım 3 — Kategorik X tabloları (Laplace 0). family_history sıklıkları diabetes sınıfında yes 38, no 59, unknown 18 (toplam 115):
| P(\cdot\mid k) | yes | no | unknown | P(\text{sex}=F) | P(\text{sex}=M) |
|---|---|---|---|---|---|
| prediabetes | 0,597403 | 0,337662 | 0,064935 | 0,512987 | 0,487013 |
| diabetes | 0,330435 | 0,513043 | 0,156522 | 0,486957 | 0,513043 |
| normoglycaemic | 0,288256 | 0,587189 | 0,124555 | 0,544484 | 0,455516 |
Örnek: P(\text{yes}\mid\text{prediabetes})=92/154=0{,}597403. Aile öyküsü prediyabet sınıfında belirgin biçimde sıktır.
Adım 4 — 1 numaralı hasta. HbA1c 6,3; BMI 30,1; yaş 52; SKB 142; aile öyküsü yes; kadın. HbA1c için diabetes sınıfında z=(6{,}3-7{,}097391)/0{,}773856=-1{,}030413 ve
Tüm terimler (log ölçeğinde):
| Terim | prediabetes | diabetes | normoglycaemic |
|---|---|---|---|
| \ln\pi_k | −1,272966 | −1,564986 | −0,671564 |
hba1c_pct = 6,3 |
−0,882505 | −1,193445 | −0,913569 |
bmi = 30,1 |
−2,516563 | −2,468855 | −2,818925 |
age = 52 |
−3,345846 | −3,442302 | −3,407182 |
systolic_bp = 142 |
−4,117369 | −4,089137 | −4,026643 |
family_history = yes |
−0,515164 | −1,107346 | −1,243906 |
sex = F |
−0,667505 | −0,719580 | −0,607917 |
| L_k | −13,317918 | −14,585651 | −13,689705 |
Adım 5 — Sonsal. Prediabetes için 1/\{e^{-14{,}585651+13{,}317918}+e^{-13{,}689705+13{,}317918}+1\}:
En büyük sonsal prediabetes'tedir; hastanın gerçek sınıfı da prediabetes'tir. Kararı aile öyküsü terimi verir: prediabetes ile normoglycaemic arasındaki L farkının (0{,}371787) neredeyse iki katı (0{,}728742) yalnız family_history satırından gelir; önsel farkı ise ters yöndedir (-0{,}601402).
Tüm veride sınıflama tablosu (yeniden yerine koyma):
| Gerçek \ Tahmin | prediabetes | diabetes | normoglycaemic |
|---|---|---|---|
| prediabetes (154) | 125 | 5 | 24 |
| diabetes (115) | 12 | 79 | 24 |
| normoglycaemic (281) | 8 | 14 | 259 |
Doğruluk 463/550=0{,}841818; OvR AUC'ler (prediabetes / diabetes / normoglycaemic) 0,918782 / 0,908446 / 0,921139, ortalama 0,916122.
Adım 6 — Laplace ve önselin etkisi. l=1 ile P(\text{unknown}\mid\text{diabetes})=(18+1)/(115+3)=0{,}161017 olur (ham 0,156522). Bu veride sıfır hücre olmadığından Laplace'ın etkisi küçüktür. Eşit önsel (1/3) ise belirleyicidir: Laplace 1 + eşit önselde 1 numaralı hastanın sonsalı (0{,}567490;\ 0{,}215940;\ 0{,}216570) olur; tüm veride doğruluk 0,803636'ya iner, ama diabetes duyarlılığı 79/115'ten 97/115'e çıkar. Kullanıcı önseli "diabetes=0,5; normoglycaemic=0,3; prediabetes=0,2" (sınıf=değer biçimi) 1 numaralı hastada sonsalı (0{,}398546;\ 0{,}375553;\ 0{,}225901) yapar; doğruluk 0,74'tür.
Adım 7 — Çekirdek yoğunluğu. HbA1c için bant genişlikleri:
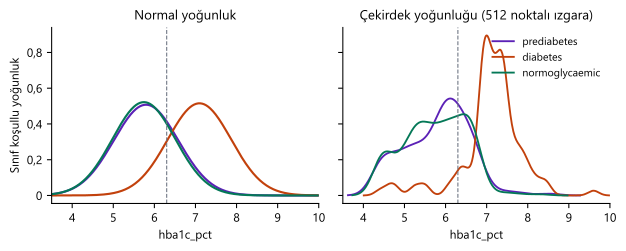
Diyabetiklerde HbA1c değerleri dar bir aralıkta yoğunlaştığı için (IQR = 0,5) kural SS yerine IQR/1,34'ü seçer. Diabetes ızgarası [4{,}009978;\ 9{,}990022] aralığındaki 512 noktadır; 6,3'e en yakın nokta 197. nokta (6,303693), yoğunluk 0,142536'dır (normal yoğunlukta 0,303175). En yakın noktaların yoğunlukları normoglycaemic'te 0,446402, prediabetes'te 0,511468'dir. Çekirdekli modelde 1 numaralı hastanın sonsalı (0{,}508011;\ 0{,}054760;\ 0{,}437229), tüm veride doğruluk 0,86, AUC 0,938374'tür.
Şekil 73.1. `hba1c_pct`'nin sınıf koşullu yoğunlukları. Sol: normal yoğunluk (sınıf içi ortalama ve SS). Sağ: Gauss çekirdek yoğunluğu (Silverman bant genişliği). Kesikli çizgi 1 numaralı hastanın değeri (6,3).
Adım 8 — Varsayılan bölme ve CV. Tohum 42 ile 440 eğitim, 110 test hastası. Eğitim önselleri (123;\ 92;\ 225)/440. Test doğruluğu 89/110=0{,}809091, test AUC 0,916401; eğitim kümesi doğruluğu 0,834091. Eğitim kümesinde 5 kat doğruluğu: 0,772727; 0,806818; 0,795455; 0,875000; 0,806818; ortalama 0,811364, SS (n-1) 0,038199.
73.6.1 Doğrulama: MerQur, Python ve R
MerQur değerleri execute() sonucundaki nb_info tablolarından, predictions sütunlarından ve başarım alanlarından tam hassasiyetle alınmıştır (doğruluk ve CV puanlarındaki 4 ondalık yuvarlama bellekte devre dışı bırakıldı). R: 4.5.3, e1071::naiveBayes 1.7-17 (laplace =, önsel m$apriori ile değiştirilerek), predict(type = "raw"); çekirdek: klaR::NaiveBayes(usekernel = TRUE) 1.7-4 ve predict (threshold 0,001). Bölme ve kat dizinleri bağımsız Python'dan R'ye aktarılmıştır. AUC her üç kaynakta OvR makro tanımıyla hesaplanmıştır.
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Önsel πprediab. (eğitim oranı) | 0,280000 | 0,280000 | 0,280000 | 0,0e+00 | ✓ |
| Önsel πdiab. (eğitim oranı) | 0,209091 | 0,209091 | 0,209091 | 8,3e−17 | ✓ |
| Önsel πnormo. (eğitim oranı) | 0,510909 | 0,510909 | 0,510909 | 1,1e−16 | ✓ |
| hba1c_pct: ortalama (prediab.) | 5,797403 | 5,797403 | 5,797403 | 3,6e−15 | ✓ |
| hba1c_pct: SS (prediab.) | 0,785901 | 0,785901 | 0,785901 | 4,4e−16 | ✓ |
| hba1c_pct: ortalama (diab.) | 7,097391 | 7,097391 | 7,097391 | 3,6e−15 | ✓ |
| hba1c_pct: SS (diab.) | 0,773856 | 0,773856 | 0,773856 | 2,2e−16 | ✓ |
| hba1c_pct: ortalama (normo.) | 5,745196 | 5,745196 | 5,745196 | 2,7e−15 | ✓ |
| hba1c_pct: SS (normo.) | 0,764236 | 0,764236 | 0,764236 | 3,3e−16 | ✓ |
| bmi: ortalama (prediab.) | 32,672078 | 32,672078 | 32,672078 | 2,8e−14 | ✓ |
| bmi: SS (prediab.) | 4,031275 | 4,031275 | 4,031275 | 1,8e−15 | ✓ |
| bmi: ortalama (diab.) | 28,813913 | 28,813913 | 28,813913 | 4,6e−14 | ✓ |
| bmi: SS (diab.) | 4,524551 | 4,524551 | 4,524551 | 1,8e−15 | ✓ |
| bmi: ortalama (normo.) | 26,068683 | 26,068683 | 26,068683 | 5,0e−14 | ✓ |
| bmi: SS (normo.) | 3,740571 | 3,740571 | 3,740571 | 4,4e−15 | ✓ |
| P(family_history = yes ∣ prediab.) | 0,597403 | 0,597403 | 0,597403 | 3,3e−16 | ✓ |
| P(family_history = no ∣ prediab.) | 0,337662 | 0,337662 | 0,337662 | 3,3e−16 | ✓ |
| P(family_history = unknown ∣ prediab.) | 0,064935 | 0,064935 | 0,064935 | 2,8e−17 | ✓ |
| P(family_history = yes ∣ diab.) | 0,330435 | 0,330435 | 0,330435 | 3,9e−16 | ✓ |
| P(family_history = no ∣ diab.) | 0,513043 | 0,513043 | 0,513043 | 4,4e−16 | ✓ |
| P(family_history = unknown ∣ diab.) | 0,156522 | 0,156522 | 0,156522 | 1,9e−16 | ✓ |
| P(family_history = yes ∣ normo.) | 0,288256 | 0,288256 | 0,288256 | 1,1e−16 | ✓ |
| P(family_history = no ∣ normo.) | 0,587189 | 0,587189 | 0,587189 | 1,1e−16 | ✓ |
| P(family_history = unknown ∣ normo.) | 0,124555 | 0,124555 | 0,124555 | 2,5e−16 | ✓ |
| P(sex = F ∣ diab.) | 0,486957 | 0,486957 | 0,486957 | 4,4e−16 | ✓ |
| Hasta 1 sonsal (prediab.) | 0,507364 | 0,507364 | 0,507364 | 3,3e−16 | ✓ |
| Hasta 1 sonsal (diab.) | 0,142807 | 0,142807 | 0,142807 | 3,1e−16 | ✓ |
| Hasta 1 sonsal (normo.) | 0,349828 | 0,349828 | 0,349828 | 5,6e−17 | ✓ |
| Tüm sonsal olasılıklar | (550 × 3) | (550 × 3) | (550 × 3) | 2,0e−15 | ✓ |
| Doğruluk (yeniden yerine koyma) | 0,841818 | 0,841818 | 0,841818 | 2,2e−16 | ✓ |
| ROC-AUC (OvR makro) | 0,916122 | 0,916122 | 0,916122 | 2,2e−16 | ✓ |
Laplace, önsel ve çekirdek seçenekleri:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Laplace 1: P(family_history = unknown ∣ diab.) | 0,161017 | 0,161017 | 0,161017 | 3,6e−16 | ✓ |
| Laplace 1: P(family_history = unknown ∣ prediab.) | 0,070064 | 0,070064 | 0,070064 | 2,8e−17 | ✓ |
| Laplace 1 + eşit önsel: hasta 1 sonsal (diab.) | 0,215940 | 0,215940 | 0,215940 | 2,5e−16 | ✓ |
| Laplace 1 + eşit önsel: tüm sonsallar | (550 × 3) | (550 × 3) | (550 × 3) | 2,6e−15 | ✓ |
| Laplace 1 + eşit önsel: doğruluk | 0,803636 | 0,803636 | 0,803636 | 4,4e−16 | ✓ |
| Kullanıcı önseli 0,5/0,3/0,2: hasta 1 sonsal (prediab.) | 0,398546 | 0,398546 | 0,398546 | 1,1e−16 | ✓ |
| Kullanıcı önseli: tüm sonsallar | (550 × 3) | (550 × 3) | (550 × 3) | 2,7e−15 | ✓ |
| Kullanıcı önseli: doğruluk | 0,740000 | 0,740000 | 0,740000 | 0,0e+00 | ✓ |
| Çekirdek: hba1c_pct bant genişliği (prediab.) | 0,258289 | 0,258289 | 0,258289 | 3,9e−16 | ✓ |
| Çekirdek: hba1c_pct bant genişliği (diab.) | 0,130007 | 0,130007 | 0,130007 | 2,8e−17 | ✓ |
| Çekirdek: hba1c_pct bant genişliği (normo.) | 0,222704 | 0,222704 | 0,222704 | 3,3e−16 | ✓ |
| Çekirdek: systolic_bp bant genişliği (diab.) | 5,200297 | 5,200297 | 5,200297 | 1,8e−15 | ✓ |
| Çekirdek: hasta 1 sonsal (diab.) | 0,054760 | 0,054760 | 0,054760 | 2,7e−16 | ✓ |
| Çekirdek: tüm sonsallar | (550 × 3) | (550 × 3) | (550 × 3) | 9,8e−15 | ✓ |
| Çekirdek: doğruluk | 0,860000 | 0,860000 | 0,860000 | 0,0e+00 | ✓ |
| Çekirdek: ROC-AUC | 0,938374 | 0,938374 | 0,938374 | 2,2e−16 | ✓ |
Varsayılan bölme ve çapraz doğrulama:
| Büyüklük | MerQur | Python (bağımsız) | R 4.5.3 | En büyük fark | Durum |
|---|---|---|---|---|---|
| Önsel πdiab. (eğitim kümesi, n = 440) | 0,209091 | 0,209091 | 0,209091 | 8,3e−17 | ✓ |
| Test doğruluğu (n = 110) | 0,809091 | 0,809091 | 0,809091 | 1,1e−16 | ✓ |
| Test ROC-AUC | 0,916401 | 0,916401 | 0,916401 | 0,0e+00 | ✓ |
| Eğitim kümesi doğruluğu | 0,834091 | 0,834091 | 0,834091 | 1,1e−16 | ✓ |
| CV kat 1 doğruluğu | 0,772727 | 0,772727 | 0,772727 | 3,3e−16 | ✓ |
| CV kat 2 doğruluğu | 0,806818 | 0,806818 | 0,806818 | 2,2e−16 | ✓ |
| CV kat 3 doğruluğu | 0,795455 | 0,795455 | 0,795455 | 4,4e−16 | ✓ |
| CV kat 4 doğruluğu | 0,875000 | 0,875000 | 0,875000 | 0,0e+00 | ✓ |
| CV kat 5 doğruluğu | 0,806818 | 0,806818 | 0,806818 | 2,2e−16 | ✓ |
| CV ortalaması | 0,811364 | 0,811364 | 0,811364 | 3,3e−16 | ✓ |
| CV SS (n − 1) | 0,038199 | 0,038199 | 0,038199 | 4,2e−17 | ✓ |
| Çekirdek: test doğruluğu | 0,818182 | 0,818182 | 0,818182 | 2,2e−16 | ✓ |
59 büyüklüğün tamamı 10^{-6} ölçütü içinde eşleşmiştir; sonsal olasılıkların en büyük farkı 10^{-14} düzeyindedir. Çekirdekli model de R ile eşleşir: aynı ızgara ve aynı en yakın nokta kuralı kullanıldığı için fark yuvarlama düzeyindedir. Aynı tohumla ikinci çalıştırma tüm sayıları birebir yinelemiştir.
73.7 Çıktıyı okuma
Sonuç metni (varsayılan ayarlar, kısaltılmış):
Naive Bayes Sınıflandırma
  Hedef               = glycaemic_status
  Özellik sayısı      = 6
  Sınıflar            = prediabetes, diabetes, normoglycaemic
  Algoritma           = Naive Bayes (sayısal X: normal yoğunluk; kategorik X: koşullu olasılık tablosu)
  Kullanılan düzey sırası (family_history): yes, no, unknown
  Kullanılan düzey sırası (sex): F, M
  ── Test Performansı ──
  Doğruluk            = 0.8091
  ROC-AUC             = 0.9164
  5-katlı CV doğruluğu= 0.8114 (±0.0382)
── Karmaşıklık Matrisi ──
                  prediabetes  diabetes  normoglycaemic
  prediabetes              21         1               9
  diabetes                  2        15               6
  normoglycaemic            1         2              53
Naive Bayes modeli
  Yoğunluk = Normal (Gauss); sayısal X = 4, kategorik X = 2
  Laplace düzeltmesi = 0 (yalnız kategorik X)
  Olasılık alt sınırı (threshold) = 0.001; eps = 0 (SS ≤ eps ya da olasılık ≤ eps olduğunda threshold kullanılır)
Önsel olasılıklar (Eğitim verisindeki oranlar)
    prediabetes          123      0.279545
    diabetes              92      0.209091
    normoglycaemic       225      0.511364
  hba1c_pct (sayısal): sınıf içi ortalama ve SS
    diabetes               7.08804       0.79211
  family_history (kategorik): P(family_history = düzey | sınıf)
                           yes        no   unknown
    prediabetes       0.609756  0.341463  0.048780
Eğitim kümesi başarımı (n = 440)
  Doğruluk            = 0.8341
| Öğe | Nasıl yorumlanır |
|---|---|
| Test doğruluğu ve CV | 0,81 ve 0,81 ± 0,04: yeni hastalarda beklenen doğruluk. Eğitim kümesi doğruluğu (0,83) yakın olduğundan aşırı uyum belirtisi yok. |
| Karmaşıklık matrisi | Satır gerçek, sütun tahmin. Diabetes duyarlılığı 15/23=0{,}65; hataların çoğu diyabetiklerin normoglisemik sanılmasıdır. Klinik amaç diyabeti kaçırmamaksa eşit önsel denenmelidir. |
| ROC-AUC | OvR makro ortalama; sınıflamadan bağımsız olarak sonsalların sıralama gücünü ölçer. |
| Önsel tablosu | Eğitim kümesindeki sınıf sayıları ve önseller. |
| Sayısal tablolar | Sınıf içi ortalama ve SS; ortalamalar arasındaki fark SS'ye göre büyükse özellik ayırıcıdır (HbA1c diyabeti, BMI prediyabeti ayırır; yaş ve SKB hemen hiç ayırmaz). |
| Kategorik tablolar | P(\text{düzey}\mid\text{sınıf}); satırlar 1'e tamamlanır. |
| Tanımsız parametre uyarısı | Bir sınıfta 2'den az geçerli gözlem; ilgili sonsallar "—" (naive_bayes.py:205–209). |
APA biçiminde rapor cümlesi (Türkçe ondalıkla):
Glisemik durumu (diyabet, normoglisemi, prediyabet) sınıflamak için HbA1c, BMI, yaş ve sistolik kan basıncını normal yoğunlukla, aile öyküsü ve cinsiyeti koşullu olasılık tablolarıyla modelleyen Naive Bayes sınıflandırıcı kullanıldı (Laplace düzeltmesi 0; önsel olasılıklar eğitim kümesindeki sınıf oranları). Tabakalı %80/%20 bölmede (tohum 42; eğitim n = 440) modelin test kümesindeki doğruluğu 0,81, çok sınıflı ROC-AUC değeri 0,92 oldu; eğitim kümesinde 5 katlı çapraz doğrulama doğruluğu Ort = 0,81 (SS = 0,04) idi. Diyabet sınıfının duyarlılığı 0,65 ile en düşük düzeydeydi.
73.8 Uzman soruları
S1. MerQur neden scikit-learn GaussianNB ya da CategoricalNB kullanmıyor?
GaussianNB varyansı n bölenle hesaplar ve tüm varyanslara en büyük varyansın 10^{-9} katını ekler; CategoricalNB varsayılan Laplace \alpha=1 kullanır ve karma veriyi tek modelde desteklemez. MerQur R e1071::naiveBayes tanımını (n − 1 bölenli SS, varsayılan Laplace 0, eps/threshold kuralı, eksik değişkeni atlama) tek bir kestiricide uygular (NaiveBayesNB). Doğrulamada sonsallar e1071 ile 10^{-15} düzeyinde aynıdır.
S2. Laplace düzeltmesi sayısal özellikleri etkiler mi?
Hayır. Laplace yalnız kategorik tabloların pay ve paydasına girer (naive_bayes.py:247–251). Sayısal özellikte sıfır SS ya da sıfır yoğunluk için ayrı bir kural vardır: değer threshold (0,001) ile değiştirilir. Bu iki mekanizma birbirinden bağımsızdır; e1071 ile aynıdır.
S3. Bir sınıfta bir özelliğin yalnız bir geçerli değeri varsa ne olur?
SS tanımsızdır (R'de sd = NA). MerQur analizi durdurmaz: o değişkeni dolu olan her satırın sonsalını tanımsız (—) yapar, sınıf tahminini tanımsız sınıfları dışarıda bırakarak üretir (R which.max NA'ları atlar), ROC-AUC'yi bu satırlar olmadan hesaplar ve sonuç metnine değişken/sınıf çiftlerini yazar. Çekirdek seçeneğinde ise bant genişliği hesaplanamadığı için analiz hata verir.
S4. Eşit önsel doğruluğu düşürdü. Bu bir hata mı?
Hayır. Eşit önsel, sınıfların gerçek sıklığını yok sayarak seyrek sınıfı öne çıkarır; toplam doğruluk düşer (0,842 → 0,804, Laplace 1 ile birlikte), seyrek sınıfın duyarlılığı artar (diabetes 0,687 → 0,843). Hangi önselin doğru olduğu klinik maliyetlere bağlıdır. Bayes kuralı, hedef toplulukta sınıf sıklıkları biliniyorsa onları önsel olarak kullanmayı önerir; örneklem bilinçli olarak dengelendiyse eğitim oranları yanıltıcıdır.
S5. Bağımsızlık varsayımı bozuksa sonsal olasılıklar neden "aşırı emin"?
İlişkili iki özellik aynı bilgiyi iki kez taşır; model onları bağımsız sayarak log-olabilirlik katkısını iki kez ekler. Bu, L_k farklarını büyütür ve sonsalları 0 ya da 1'e iter. Sınıf ataması (argmax) çoğu kez yine doğrudur, ama olasılıkların kalibrasyonu bozulur. Risk iletişiminde Naive Bayes sonsalı yerine lojistik model ya da kalibrasyon sonrası olasılık kullanılmalıdır.
S6. Çekirdek yoğunluğu neden doğrudan hesaplanmıyor da ızgaradan okunuyor?
MerQur klaR::NaiveBayes(usekernel = TRUE) tanımını izler: yoğunluk R density() ile 512 noktalı ızgarada kestirilir, tahminde en yakın ızgara noktasının değeri alınır. Bu, sonuçları R ile birebir aynı tutar ve büyük veride hızlıdır; bedeli 10^{-4}–10^{-3} düzeyinde bir yaklaşıklıktır. Değer ızgara dışındaysa uçtaki yoğunluk kullanılır; bu yüzden eğitim aralığının çok dışındaki bir değer, normal yoğunluktaki kadar sert cezalandırılmaz.
S7. Çok sınıflı AUC neden R pROC'un çok sınıflı AUC'sinden farklı çıkabilir?
MerQur scikit-learn roc_auc_score(multi_class="ovr") kullanır: her sınıf için bire-karşı-diğerleri AUC'si, ağırlıksız ortalama. R pROC::multiclass.roc Hand ve Till (2001) tanımını (sınıf çiftleri üzerinden ortalama) kullanır; iki sayı genellikle yakındır ama aynı değildir. Doğrulamada R tarafında OvR tanımı elle yazılmıştır.
S8. Sayısal kodlu bir kategorik değişken (ör. 1/2/3 eğitim düzeyi) nasıl girer?
Veri sekmesinde "kategorik" işaretlenmezse sayısal sayılır ve sınıf içinde normal dağıldığı varsayılarak modellenir; üç düzeyli bir değişken için bu kaba bir yaklaşımdır. İşaretlenirse düzey koduna çevrilir ve koşullu olasılık tablosuyla girer (classification.py:261–287). Sonuç metnindeki "sayısal X = …, kategorik X = …" satırı ve "Kategorik X'ler koşullu olasılık tablosuyla kullanıldı" notu hangi yolun izlendiğini gösterir.
73.9 Sık hatalar ve tuzaklar
- 0/1 kodlu değişkeni işaretlememek. Sayısal kodlu ikili değişken normal yoğunlukla modellenir; SS'si küçük bir sınıfta yoğunluklar uç değerler alır. İkili ve az düzeyli sayısal sütunlar Veri sekmesinde "kategorik" işaretlenmelidir.
- Sonsalı risk olasılığı gibi okumak. Bağımsızlık bozuk olduğunda sonsallar aşırı keskindir; "%95 olasılıkla diyabet" ifadesi kalibrasyon denetlenmeden kullanılmamalıdır.
- Eğitim doğruluğunu raporlamak. "Yok (tüm veri)" seçeneğinde başlık "Eğitim (yeniden yerine koyma) Performansı" olur; bu iyimserdir. Raporda test kümesi ya da CV doğruluğu verilmelidir.
- Önsel sırasını karıştırmak. Kullanıcı önseli çıktıdaki sınıf sırasıyla eşlenir; "sınıf=değer" biçimi bu hatayı önler.
- Laplace'ı her zaman 1 yapmak. Küçük sınıflarda l=1 tablo olasılıklarını belirgin biçimde düzleştirir. Sıfır hücre yoksa Laplace gerekmez; varsa threshold kuralı zaten sonsalın tam sıfır olmasını önler.
- Yoğunluk değerlerini olasılık sanmak. Sınıf koşullu tablodaki normal yoğunluk 1'den büyük olabilir; yalnız sınıflar arasındaki oranı anlamlıdır.
- Model kurulumu satırındaki "ölçekleme/doldurma yalnız eğitime uyduruldu" ifadesi. Bu satır tüm sınıflayıcılarla ortaktır; Naive Bayes'te ölçekleme ve doldurma yapılmaz (aynı çıktının "Ön işleme" satırı bunu açıkça yazar).
73.10 Kaynaklar
- Domingos, P., & Pazzani, M. (1997). On the optimality of the simple Bayesian classifier under zero-one loss. Machine Learning, 29(2–3), 103–130. https://doi.org/10.1023/A:1007413511361
- Hand, D. J., & Yu, K. (2001). Idiot's Bayes—Not so stupid after all? International Statistical Review, 69(3), 385–398. https://doi.org/10.1111/j.1751-5823.2001.tb00465.x
- Hand, D. J., & Till, R. J. (2001). A simple generalisation of the area under the ROC curve for multiple class classification problems. Machine Learning, 45(2), 171–186. https://doi.org/10.1023/A:1010920819831
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning (2. baskı). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Meyer, D., Dimitriadou, E., Hornik, K., Weingessel, A., & Leisch, F. (2025). e1071: Misc functions of the Department of Statistics, Probability Theory Group (R paketi sürüm 1.7-17). CRAN.
- Silverman, B. W. (1986). Density estimation for statistics and data analysis. Chapman and Hall.
- Weihs, C., Ligges, U., Luebke, K., & Raabe, N. (2005). klaR analyzing German business cycles. D. Baier, R. Decker & L. Schmidt-Thieme (Ed.), Data analysis and decision support içinde (ss. 335–343). Springer. https://doi.org/10.1007/3-540-28397-8_36