7. Değerlendirme (④ Evaluation)
Sekme: ④ Evaluation · Kod: tabs/tab_evaluation.py (arayüz); sdm_core.py evaluate_all, boyce_ecospat, compute_calibration, cv_roc_curves, cv_omission_pr_calibration, cv_boyce_curves, cv_threshold_performance, compute_response_curves, evaluation_scores_table (hesap)
7.1 Bu sekme ne yapar
④ Evaluation, ③ Models'ta kurulan modellerin başarımını grafik ve tablolarla gösterir. Yeni bir model kurmaz, veriyi yeniden bölmez: bütün eğri ve skorlar ③ Models çalıştırması sırasında kaydedilen kat dışı (out-of-fold, CV hold-out) tahminlerden üretilir (sdm_core.py:5547-5556, 6826-7037). Yalnız iki şey tam veri (Full) modellerinden hesaplanır: tepki eğrileri (§7.7) ve Classification Thresholds tablosundaki harita eşikleri (§7.9).
- Girdi: ③ Models'ın modelleyici (
modeler) ve topluluk (ensemble) nesneleri, PA setleri, çıktı klasörü. - Çıktı: ekranda yedi alt sekme;
figures/klasörüne PNG şekiller (300 dpi),evaluation_scores.csv,evaluation_omission_pr_calibration.csv,classification_thresholds.csv(§7.11). - Kilit düzeni: ③ Models çalıştırması bitince açılır (
tabs/tab_models.py:1848). Sekme ilk gösterildiğinde tüm grafikler bir kez, ilerleme penceresi eşliğinde hesaplanır; aynı çalıştırma için sekme değiştirmek yeniden hesaplamaz (tabs/tab_evaluation.py:1344-1371).
7.2 Ekranın düzeni
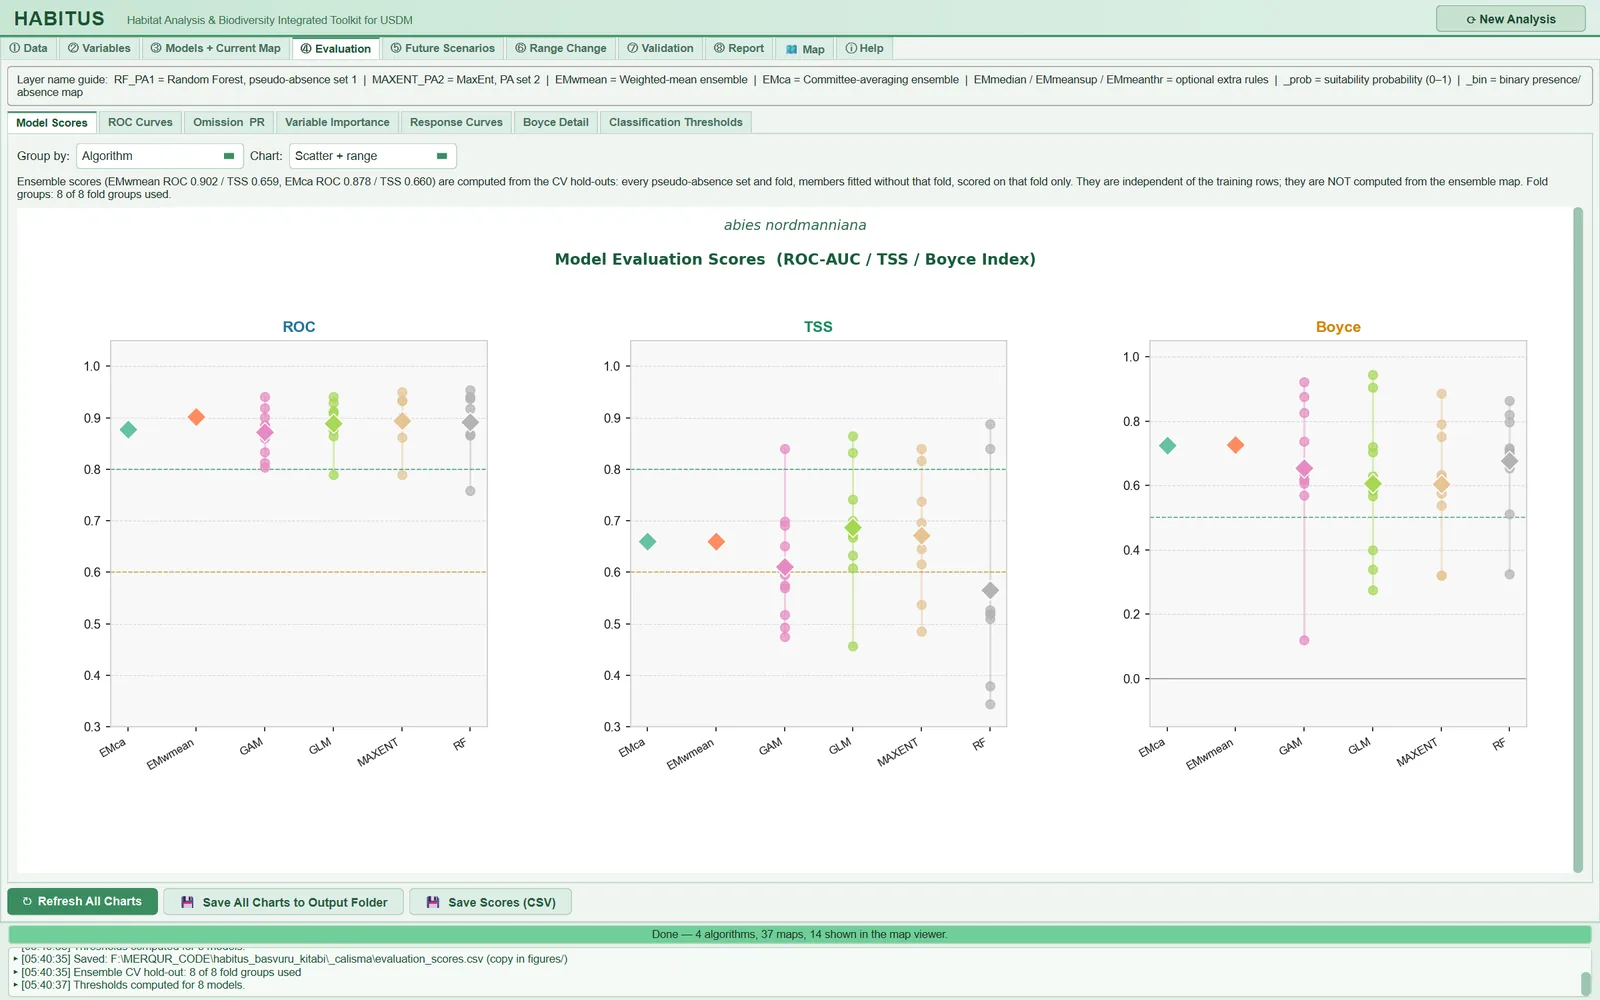
Şekil 7.1. ④ Evaluation sekmesi Model Scores alt sekmesi açıkken: üstte katman adı rehberi, ortada yedi alt sekme, Group by = Algorithm ve Chart = Scatter + range ile ROC, TSS, Boyce panelleri (EMca ve EMwmean topluluk satırları dâhil), altta Refresh All Charts, Save All Charts to Output Folder ve Save Scores (CSV) düğmeleri.
| Bölge | İçerik | Bu bölümde |
|---|---|---|
| Üst şerit | Layer name guide: katman adlarının anlamı (RF_PA1, EMwmean, _prob, _bin …) |
§7.2 |
Model Scores |
ROC, TSS, Boyce dağılımları | §7.3 |
ROC Curves |
Kat dışı ROC eğrileri | §7.4 |
Omission & PR |
Omisyon, kesinlik-duyarlılık, kalibrasyon | §7.5 |
Variable Importance |
Permütasyon önemi | §7.6 |
Response Curves |
Tepki eğrileri (marginal / partial / ice) | §7.7 |
Boyce Detail |
Kat başına Boyce P/E eğrileri | §7.8 |
Classification Thresholds |
On bir eşik kuralının eşikleri ve kat dışı başarımı | §7.9 |
| Alt düğmeler | ↻ Refresh All Charts, 💾 Save All Charts to Output Folder, 💾 Save Scores (CSV) |
§7.10 |
Alt sekme şeridinde üçüncü sekmenin adı ekranda Omission PR olarak görünür; kodda adı Omission & PR'dır (tabs/tab_evaluation.py:201). Bu bölümde koddaki ad kullanılır.
Çok satırlı şekiller (skorlar, ROC, omisyon, tepki, Boyce) kendi kaydırma alanındadır; şeklin altında devamı varsa ▼ Scroll down for more of this figure ipucu görünür (tabs/tab_evaluation.py:69-101).
7.3 Model skorları (Model Scores)
Bu alt sekme (Şekil 7.1) evaluation_scores.csv tablosundaki ROC, TSS ve Boyce sütunlarını üç panelde çizer (tabs/tab_evaluation.py:229-353). Tablonun kendisi her ölçütü içerir; ölçütlerin tanımı §7.3.2'dedir.
| Arayüzdeki ad | Ne yapar | Varsayılan | Seçenekler | Kod |
|---|---|---|---|---|
Group by: |
Noktaları gruplayan sütun | Algorithm |
Algorithm / PA Set / CV Run |
tabs/tab_evaluation.py:233-235 |
Chart: |
Grafik türü | Scatter + range |
Scatter + range / Box plot / Bar mean±SD |
tabs/tab_evaluation.py:237-239 |
| Topluluk notu | Topluluk satırlarının hold-out skorlarını ve kat gruplarını yazar | — | — | tabs/tab_evaluation.py:261-281 |
7.3.1 Grafik ve gruplama
Ne işe yarar. Scatter + range her satırı bir nokta, grubun en küçük–en büyük aralığını bir çizgi ve ortalamayı bir elmas olarak çizer; Box plot kutu grafiği; Bar mean±SD ortalama ve standart sapma çubuğu çizer (tabs/tab_evaluation.py:315-331). ROC ve TSS panellerinde 0,8 (yeşil) ve 0,6 (turuncu) kesikli çizgileri, Boyce panelinde 0,5 ve 0 çizgileri vardır. Grup sayısı altıyı geçerse etiketler dik yazılır.
Ne zaman, nasıl ayarlanır. Algorithm algoritmaları karşılaştırır; PA Set yalancı yokluk setleri arasındaki farkı (arka plan çekiminin etkisini); CV Run katlar arasındaki farkı (bazı katların sistematik olarak zor olup olmadığını) gösterir.
Sonuca etkisi. Yalnız görünümü değiştirir; tablo ve dosyalar değişmez.
Dikkat. Grafik tablodaki bütün satırları kullanır: CV koşuları, CV ortalamasını taşıyan Full satırları ve topluluk satırları (PA Set = Ensemble). Full satırları ortalamanın kopyası olduğundan Algorithm gruplamasında bir algoritmanın dağılımına PA seti başına bir ortalama noktası daha eklenmiş olur; yayılımı okurken evaluation_scores.csv'de Score_source = cv_fold satırlarını esas alın. Eksen alt sınırları ROC ve TSS için 0,3, Boyce için −0,15'tir (tabs/tab_evaluation.py:314); bunun altındaki değerler panelde görünmez.
7.3.2 Skor tablosundaki ölçütler
Her satır evaluate_all ile bir modelin tahminlerinden hesaplanır (sdm_core.py:1122-1257). Eşiğe bağlı ölçütler, ③ Models'ta seçilen eşik kuralı ve eşik kaynağıyla (train_cv varsayılan) bulunan eşikte hesaplanır (Bölüm 6, §6.5). TP, FN, FP, TN karışıklık matrisinin hücreleridir; bir payda sıfırsa ölçüt NaN olur, 0 olmaz (sdm_core.py:693-719).
| Sütun | Tanım | Eşiğe bağlı | Kod |
|---|---|---|---|
ROC |
ROC eğrisi altındaki alan (AUC) | hayır | sdm_core.py:951-959 |
TSS |
Duyarlılık + özgüllük − 1 (Allouche vd. 2006) | evet | sdm_core.py:671-679 |
Boyce |
Sürekli Boyce indeksi (ecospat ya da legacy tanımı) | hayır | sdm_core.py:475-664 |
Threshold |
Kullanılan ikili eşik | — | sdm_core.py:1242 |
Prevalence, N_pres, N_abs |
Değerlendirme kümesinde varlık oranı ve sayıları | hayır | sdm_core.py:1249-1252 |
PredPresFrac |
Eşiğin üstünde kalan satırların payı | evet | sdm_core.py:1235-1236 |
Brier |
\overline{(p-y)^2}; küçük daha iyi | hayır | sdm_core.py:998 |
CalSlope |
y'nin \mathrm{logit}(p) üzerine lojistik regresyonunun eğimi; 1 iyi kalibrasyon, <1 aşırı güvenli (Pearce ve Ferrier 2000) | hayır | sdm_core.py:1000-1013 |
Sensitivity, Specificity |
TP/(TP+FN), TN/(TN+FP) | evet | sdm_core.py:709-710 |
Kappa |
Cohen kappa'sı (Fielding ve Bell 1997) | evet | sdm_core.py:711-712 |
MCC |
Matthews korelasyon katsayısı | evet | sdm_core.py:713-714 |
Jaccard, Sorensen, FPB |
TP/(TP+FP+FN); 2TP/(2TP+FP+FN); 2 × Jaccard (Li ve Guo 2013) | evet | sdm_core.py:715-719 |
OR_MTP, OR_10p |
Test varlıklarının, eğitim varlıklarının en düşük / 10. yüzdelik tahmininin altında kalan payı | eşik referansa bağlı | sdm_core.py:1095-1099 |
AUC_train, dAUC |
Eğitim verisindeki AUC; AUC_train − ROC (aşırı uyum farkı) |
hayır | sdm_core.py:1074-1084 |
OR_MTP_degenerate, OR_10p_degenerate |
Omisyon eşiği tahminlerin en küçüğüne eşit ya da altındaysa 1 (omisyon yapı gereği 0) | — | sdm_core.py:1100-1114 |
Threshold_source, OR_reference, Boyce_formula |
Eşiğin, omisyon referansının ve Boyce tanımının kaynağı | — | sdm_core.py:5877-5879 |
Score_source |
cv_fold, cv_mean, random_split, cv_holdout |
— | sdm_core.py:1038-1053 |
Score_source değerleri: cv_fold bir CV koşusunun kendi tutulan katında skorudur; cv_mean tam veri modeline taşınan CV ortalamasıdır; random_split CV skoru oluşmamış bir tam veri modelinin rastgele bölme skorudur (iyimser); cv_holdout topluluk satırıdır (Bölüm 6, §6.6.7).
Not:
compute_calibrationayrıca kalibrasyon kesişimi (CalIntercept), en büyük ve beklenen kalibrasyon hatası (MCE,ECE) hesaplar (sdm_core.py:981-1033); bu üç değerevaluation_scores.csv'ye yazılmaz.
Örnek koşudan bir satır (GLM, PA1, RUN1): ROC 0,941, TSS 0,865, Boyce 0,399, eşik 0,177, yaygınlık 0,148 (43 varlık, 248 yokluk), duyarlılık 0,953, özgüllük 0,911, kalibrasyon eğimi 1,28, AUC_train 0,900 (dAUC = −0,041). Aynı algoritmanın RUN2 katında ROC 0,790, TSS 0,457'dir; katlar arası fark algoritmalar arası farktan büyüktür.
7.4 ROC eğrileri (ROC Curves)
Şekil 7.2. ROC Curves alt sekmesi: her algoritma ve topluluk kuralı için ayrı panel; ince çizgiler tek tek katlar, kalın çizgi ortalama eğri, gölge ±1 SD bandı.
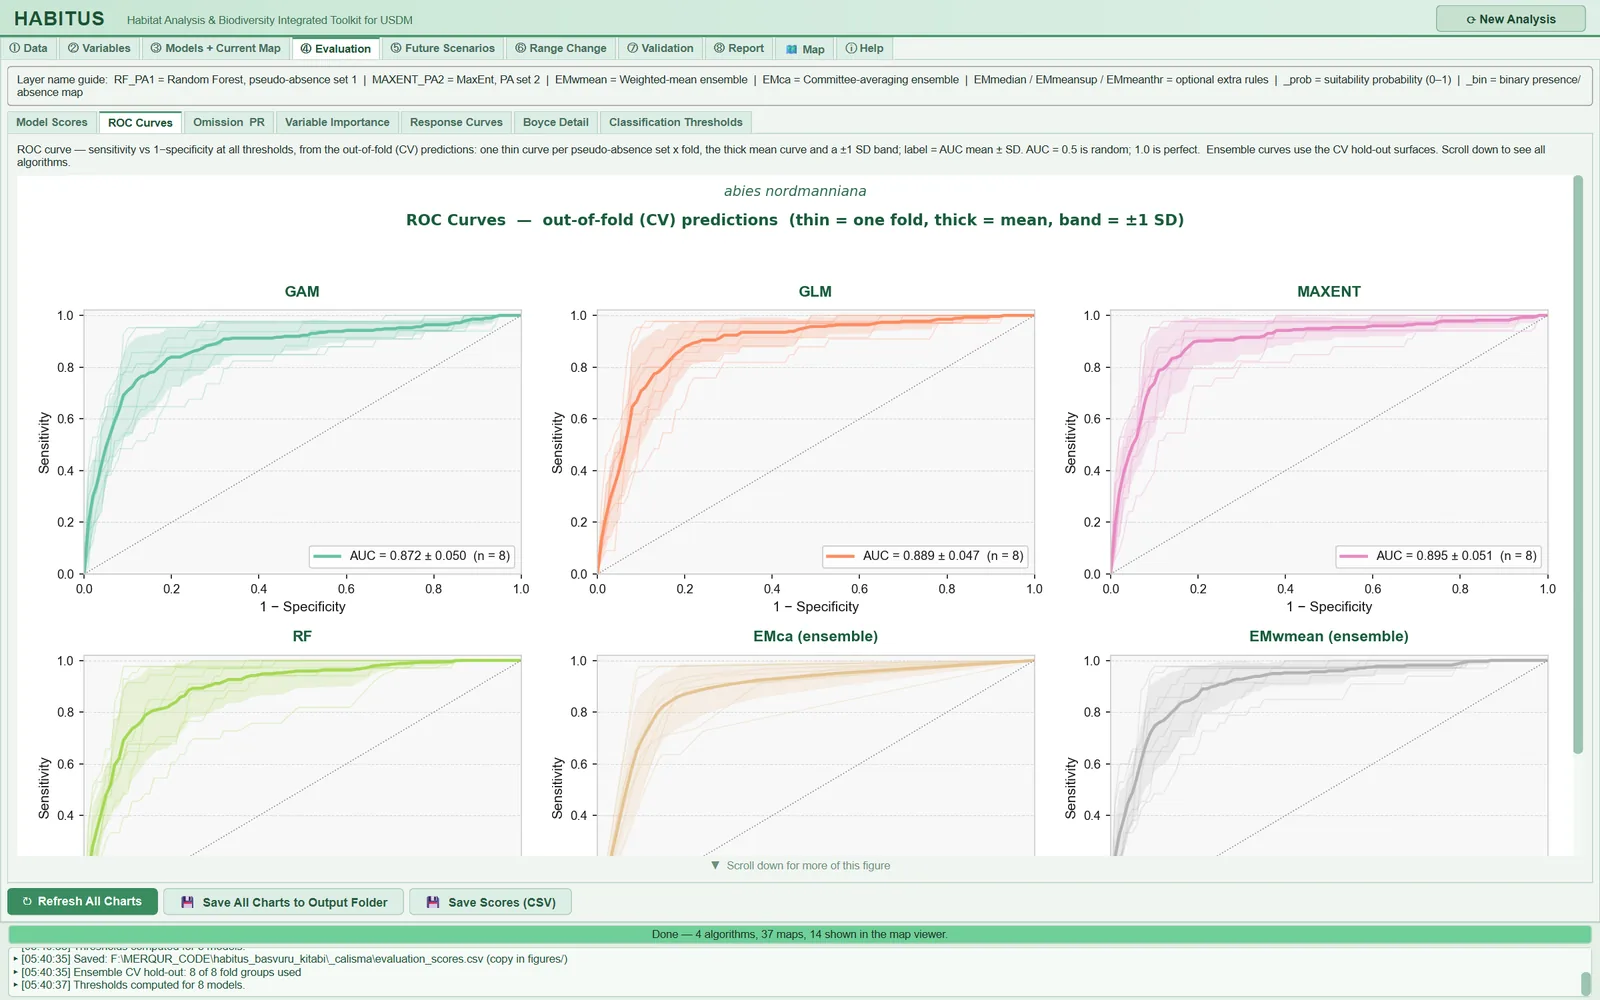
Ne işe yarar. Her algoritma için her PA seti × kat grubunun kat dışı tahminlerinden bir ROC eğrisi çizilir; eğriler 101 noktalı ortak bir yanlış pozitif oranı ızgarasına aradeğerlenir, ortalama eğri ve ±1 SD bandı hesaplanır; açıklama AUC = ortalama ± SD (n = kat grubu sayısı) biçimindedir (cv_roc_curves, sdm_core.py:6826-6891; tabs/tab_evaluation.py:372-435). Topluluk kuralları (EMwmean (ensemble) …) topluluğun hold-out yüzeylerinden çizilir (Bölüm 6, §6.6.7). Ayar yoktur.
Sonuca etkisi. Ekran ve evaluation_roc_curves.png; skorlar değişmez. Örnek koşuda sekiz kat grubu üzerinden AUC: GAM 0,872 ± 0,050, GLM 0,889 ± 0,047, MaxEnt 0,895 ± 0,051.
Dikkat. Tek sınıflı bir hold-out atlanır; hiç kat dışı tahmini olmayan algoritma şeklin altında Not shown: … notuyla listelenir (sdm_core.py:6872-6876; tabs/tab_evaluation.py:427-429). Yokluk sınıfı yalancı yokluk olduğundan AUC "varlık noktalarını arka plandan ayırma" başarısıdır; gerçek yokluklara karşı başarının ölçüsü değildir.
7.5 Omisyon, kesinlik-duyarlılık ve kalibrasyon (Omission & PR)
Şekil 7.3. Omission & PR alt sekmesi: her algoritma için bir satırda omisyon oranı, kesinlik-duyarlılık ve kalibrasyon panelleri, kat başına ince eğriler ve ortalama.
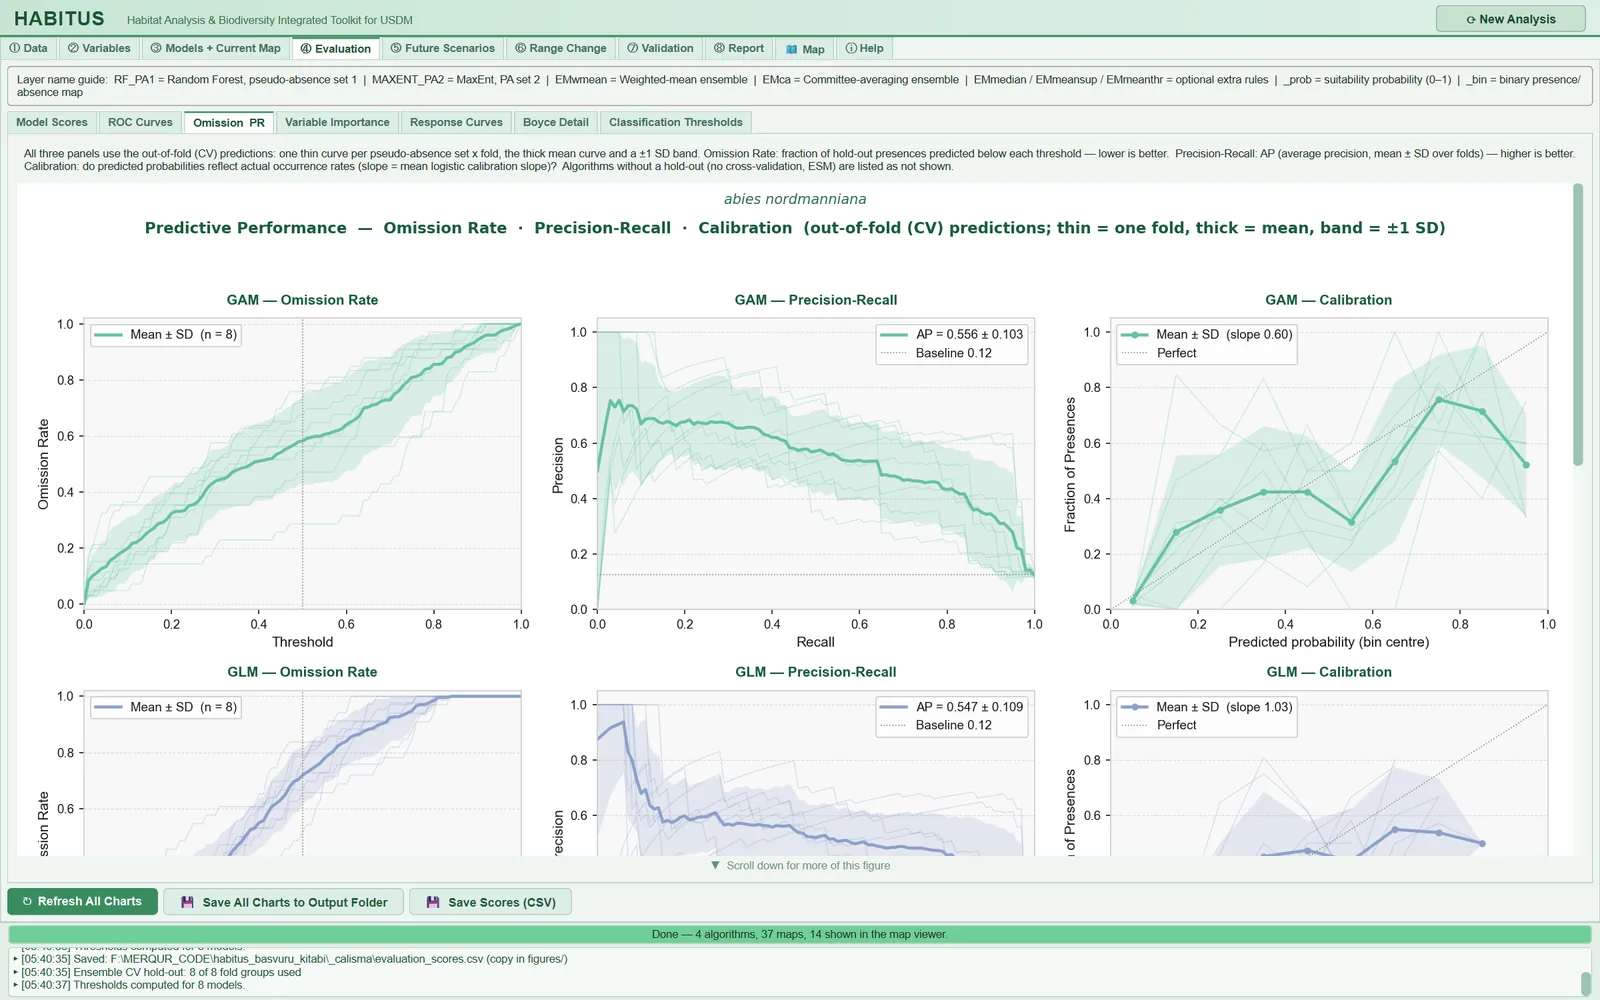
Ne işe yarar. Her algoritma için kat dışı tahminlerden üç panel çizilir (cv_omission_pr_calibration, sdm_core.py:6926-6995; tabs/tab_evaluation.py:459-571):
- Omission Rate: 0–1 arasında 101 eşikte, hold-out varlıklarından tahmini eşiğin altında kalanların payı. Düşük daha iyidir; 0,5'te kesikli dikey çizgi vardır.
- Precision-Recall: kesinlik-duyarlılık eğrisi, ortak duyarlılık ızgarasına aradeğerlenir; açıklama ortalama kesinlik (average precision, AP) ± SD'dir. Gri yatay çizgi taban kesinliktir (kat yaygınlıklarının ortalaması).
- Calibration: tahminler 10 eşit genişlikli kutuya ayrılır; her kutuda varlık payı hesaplanır (3'ten az satırlı kutular boş bırakılır); açıklama katların ortalama kalibrasyon eğimidir. Köşegen tam kalibrasyonu gösterir.
Sonuca etkisi. Ekran, evaluation_omission_pr_calibration.png ve her algoritma için 0,5 eşiğindeki ortalama omisyonu, AP'yi, taban kesinliği ve ortalama kalibrasyon eğimini içeren figures/evaluation_omission_pr_calibration.csv (tabs/tab_evaluation.py:573-597).
Örnek koşuda GAM için AP 0,556 ± 0,103 (taban 0,12) ve ortalama kalibrasyon eğimi 0,60, GLM için AP 0,547 ± 0,109 ve eğim 1,03'tür: iki model benzer biçimde ayırt eder, ama GAM'ın olasılıkları aşırı güvenlidir.
Dikkat. Yalancı yokluklu verilerde kesinlik ve kalibrasyon mutlak değer olarak yorumlanamaz: "yokluk" sınıfı arka plandır, olasılık ölçeği PA:varlık oranına bağlıdır (örnek koşuda 7:1, taban kesinlik yaklaşık 0,12). Bu paneller algoritmaları ve katları birbiriyle karşılaştırmak içindir. Hold-out kümeleri küçük olduğundan (örnek koşuda kat başına 32–43 varlık) ±1 SD bandı bir güven aralığı değildir.
7.6 Değişken önemi (Variable Importance)
Şekil 7.4. Variable Importance alt sekmesi: her değişken için algoritma başına ortalama permütasyon önemi çubukları; açıklama kutusu grafiğin sağında.
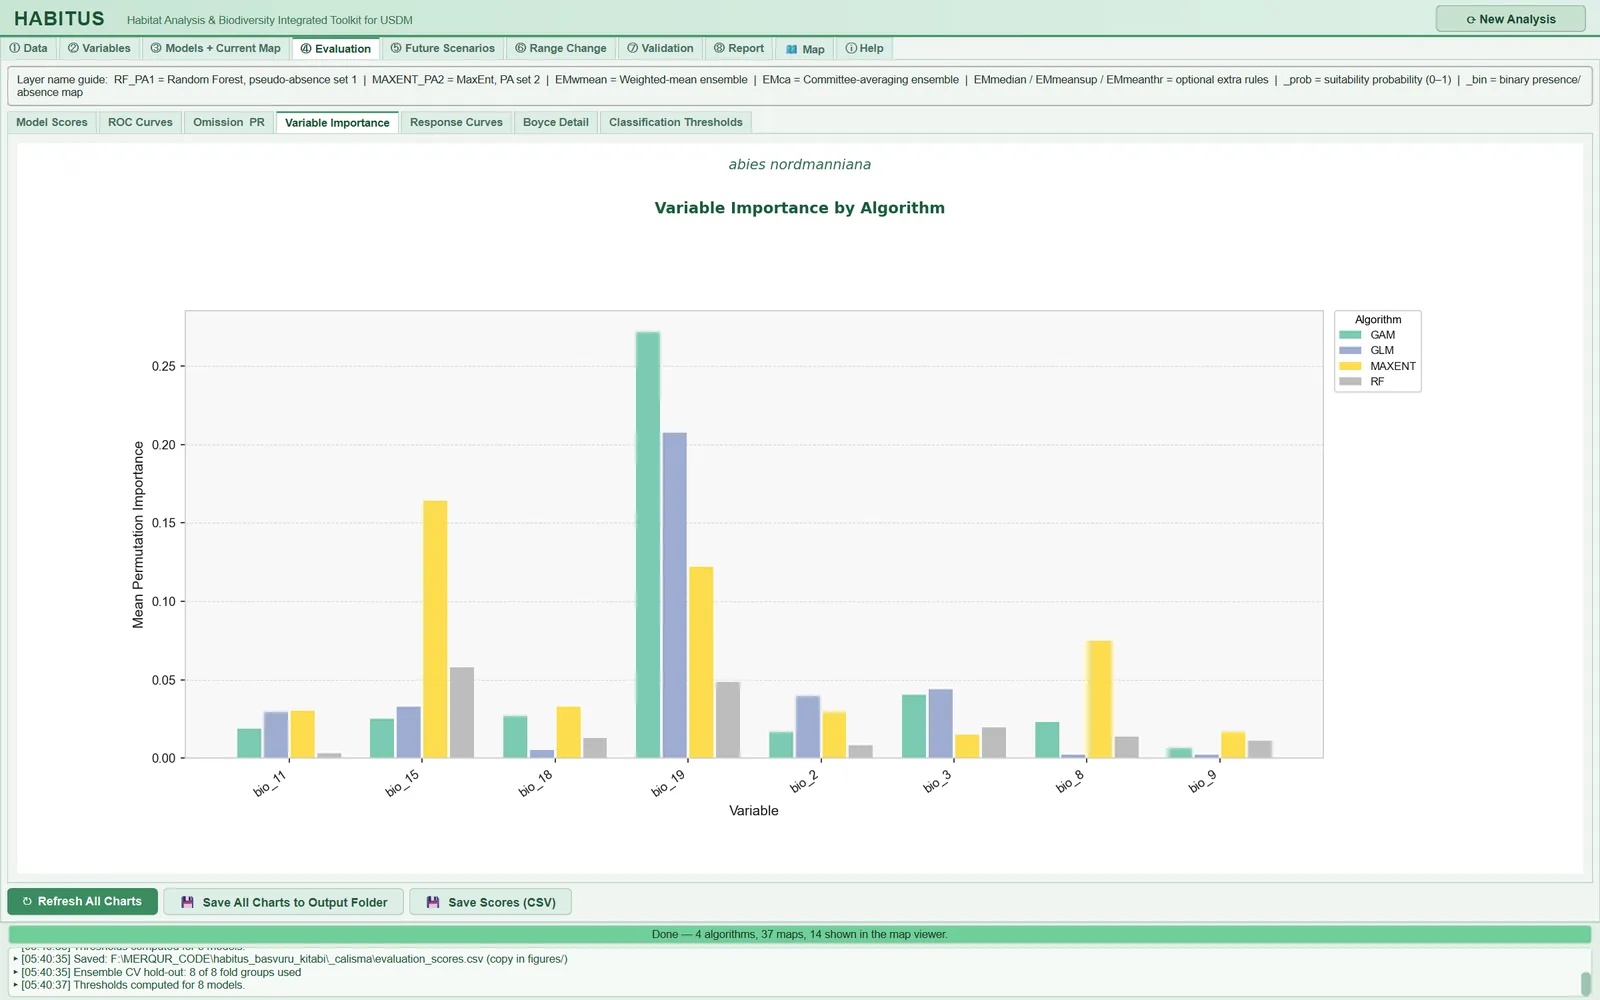
Ne işe yarar. ③ Models'ta her CV koşusunda, test katında hesaplanan permütasyon önemi (öngörücü karıştırıldığında AUC'deki düşüş) algoritma × değişken için tüm katlar ve PA setleri üzerinden ortalanır ve gruplu çubuk grafikte çizilir (tabs/tab_evaluation.py:607-647; hesap: sdm_core.py:5562-5636). Ayar yoktur; tekrar sayısı ③ Models'taki Variable importance reps: alanıdır (Bölüm 6, §6.4.7).
Ne zaman, nasıl ayarlanır. Önem değerleri algoritmalar arasında aynı ölçektedir (AUC düşüşü); yine de tree tabanlı ve doğrusal modellerin önem sıralamaları farklı olabilir, ortak sıralama için algoritmalar arası tutarlılığa bakın.
Sonuca etkisi. Ekran ve evaluation_variable_importance.png. Örnek koşuda GAM ve GLM'de en önemli değişken bio_19 (AUC düşüşü sırasıyla yaklaşık 0,27 ve 0,21), MaxEnt'te bio_15'tir (yaklaşık 0,16); RF'de hiçbir değişken 0,06'yı geçmez.
Dikkat. İlişkili öngörücüler önemi paylaşır: biri karıştırıldığında diğeri bilgiyi taşımaya devam eder ve ikisinin önemi de düşük görünebilir. Önem negatif çıkabilir (karıştırma AUC'yi rastlantıyla artırmıştır). Variable importance reps: = 0 ise grafik boş kalır. Tam veri modellerinin önemi hesaplanmaz; grafik yalnız CV koşularındandır.
7.7 Tepki eğrileri (Response Curves)
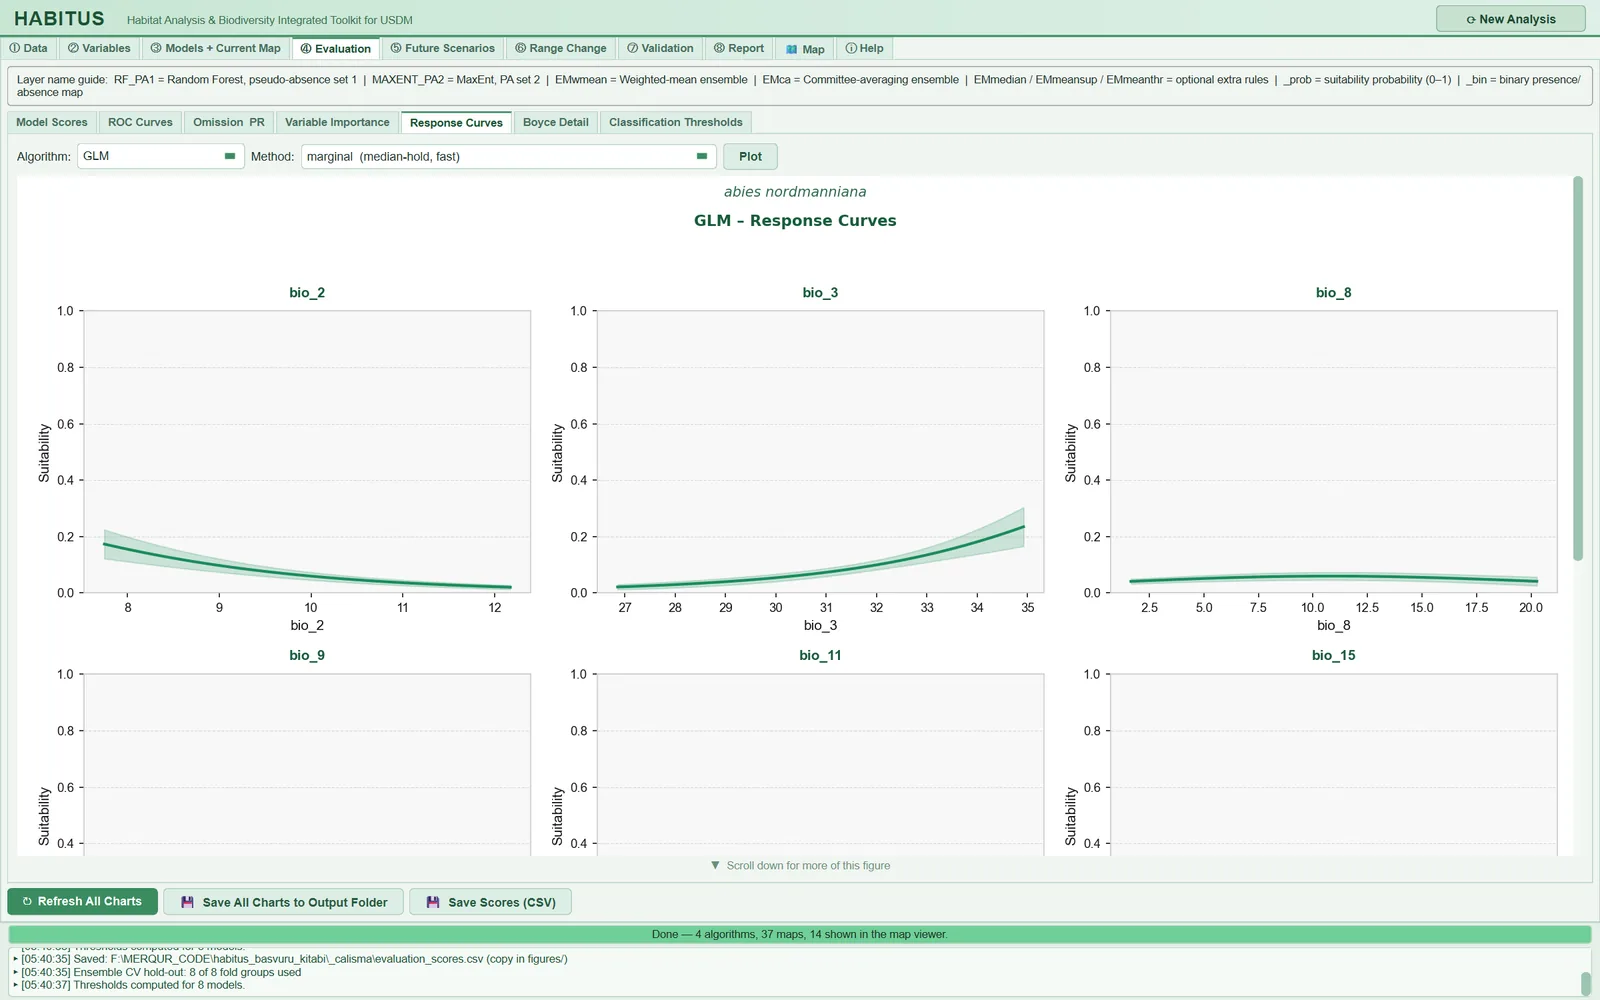
Şekil 7.5. Response Curves alt sekmesi: Algorithm, Method ve Plot denetimleri; seçilen algoritma için her sürekli öngörücüye bir panel, kalın çizgi ortalama tepki, gölge yinelemeler arası standart sapma; ikinci satır panellerin yalnız üst kısmı görünür, eğriler kaydırınca görünen 0,4'ün altındaki bölgededir.
| Arayüzdeki ad | Ne yapar | Varsayılan | Seçenekler | Kod |
|---|---|---|---|---|
Algorithm: |
Eğrileri çizilecek algoritma | ilk algoritma | çalıştırmadaki algoritmalar | tabs/tab_evaluation.py:654-655, 885-892 |
Method: |
Tepki eğrisi yöntemi | marginal (median-hold, fast) |
marginal / partial / ice |
tabs/tab_evaluation.py:656-671 |
Plot |
Eğrileri hesaplar ve çizer | — | — | tabs/tab_evaluation.py:672-673 |
7.7.1 Tepki eğrisi yöntemi (Method)
Ne işe yarar. Her sürekli öngörücü, tüm PA setlerinin birleşik verisinde (varlıklar ve yalancı yokluklar) 5. ile 95. yüzdeliği arasında 100 noktada değiştirilir (compute_response_curves, sdm_core.py:8354-8510):
marginal: diğer bütün öngörücüler birleşik verinin medyanında tutulur (biomod2'deki "medyan tutma" yaklaşımı).partial: kısmi bağımlılık (PDP; Friedman 2001): tohumlu seçilen en çok 500 gerçek satırda odak değişken her ızgara değerine eşitlenir ve tahminlerin ortalaması alınır.ice: bireysel koşullu beklenti (ICE; Goldstein vd. 2015): tohumlu seçilen 60 satırın her biri için ayrı bir eğri (ince çizgiler) çizilir; kalın çizgi bu eğrilerin ortalaması, yani o satırların PDP'sidir.
Her yöntemde algoritmanın tüm kurulan modelleri (her PA setinin CV koşuları ve tam veri modeli) ayrı ayrı tahmin edilir; kalın çizgi bunların ortalaması, gölge standart sapmasıdır (sdm_core.py:8461-8506). Kategorik öngörücüler için her sınıfa bir çubuk çizilir (diğer öngörücüler medyanda; 2–60 sınıflı değişkenler) (sdm_core.py:8512-8553).
Ne zaman, nasıl ayarlanır. marginal hızlıdır ve biomod2/maxnet çıktılarıyla karşılaştırılabilir. Öngörücüler arasında güçlü etkileşim ya da ilişki varsa medyan satırı gerçekçi olmayan bir öngörücü bileşimi olabilir; partial gerçek veri dağılımı üzerinden ortalar. Etkileşimi görmek için ice kullanılır: ince eğrilerin birbirinden farklı biçimde olması, odak değişkenin etkisinin diğer değişkenlere bağlı olduğunu gösterir.
Sonuca etkisi. Yalnız ekran ve evaluation_response_<ALGO>.png. partial yaklaşık 500 × 100 tahmin, ice 60 × 100 tahmin × model sayısı gerektirir; MaxEnt ve RF'de belirgin biçimde yavaştır. Sonuç aynı çalıştırma, yöntem ve algoritma için önbelleğe alınır; yeniden çizim tekrar hesaplamaz (tabs/tab_evaluation.py:690-712).
Dikkat. Eğriler ③ Models'taki Clamp predictors … ayarı uygulanmadan hesaplanır (tahmin işlevleri doğrudan çağrılır, sdm_core.py:8419-8437). Y ekseni 0–1 aralığına sabittir; yalancı yokluklu verilerde olasılık ölçeği düşük olduğundan eğriler sıkışık görünebilir (örnek koşuda GLM eğrileri 0,25'in altında kalır). Bir eğrinin gölgesi CV ve tam veri modellerinin farkını gösterir, bir güven aralığı değildir. Şekil 3 sütunludur; dokuzdan fazla öngörücüde alt satırlar için şekli kaydırın.
7.8 Boyce ayrıntısı (Boyce Detail)
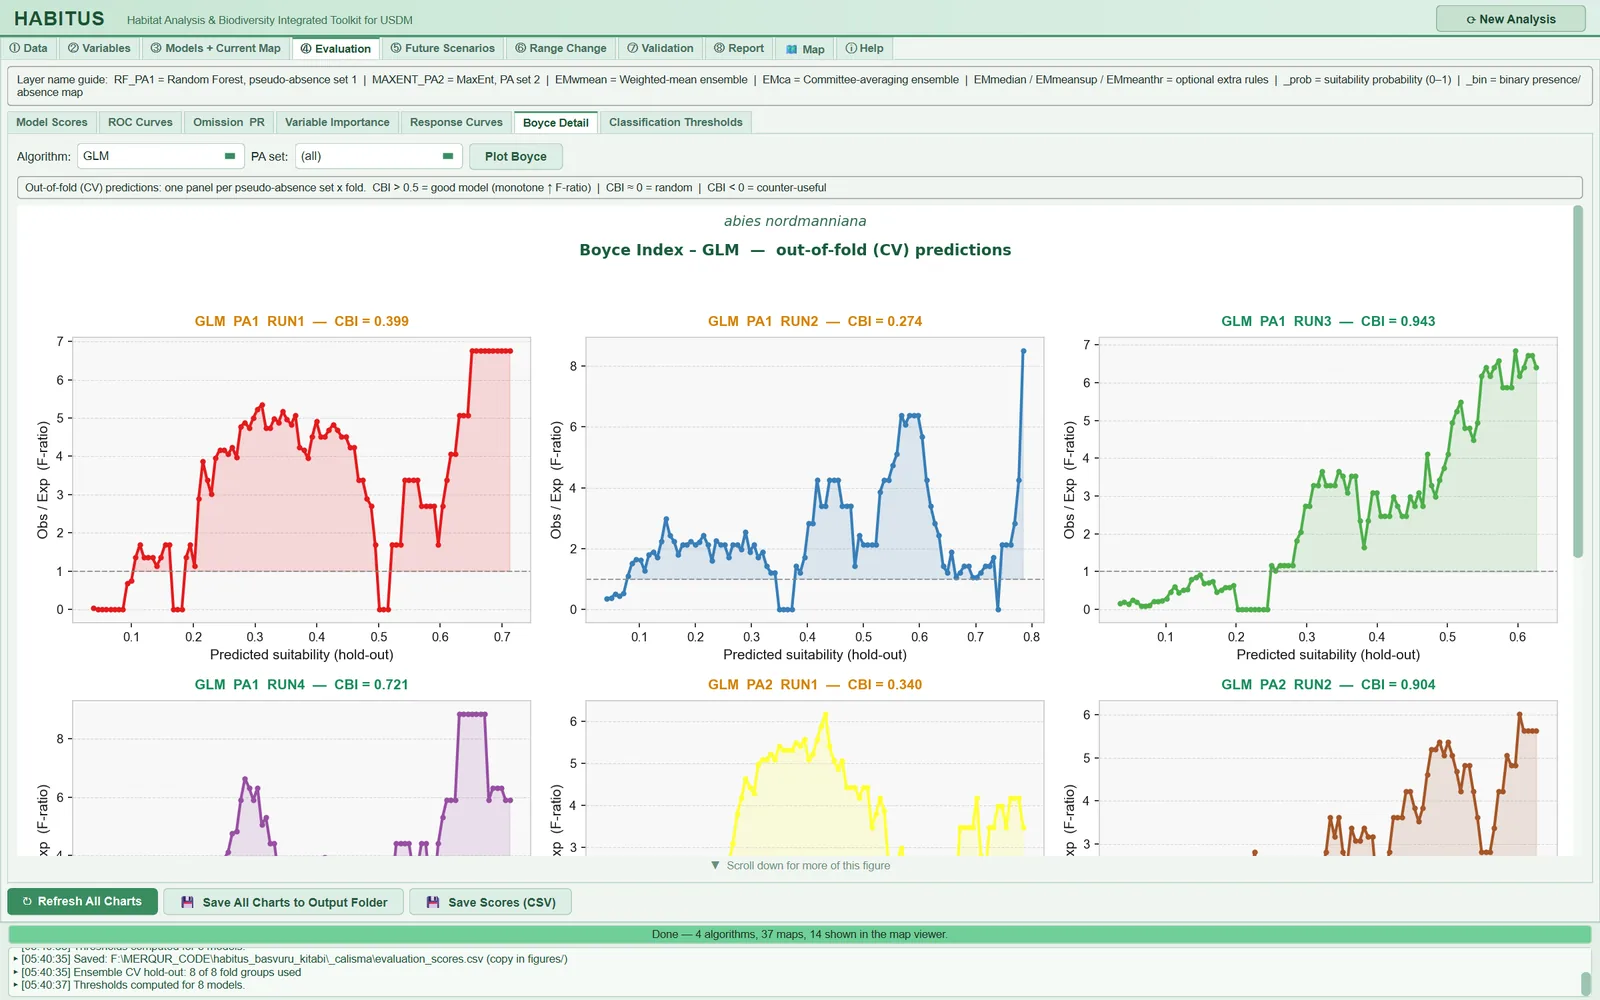
Şekil 7.6. Boyce Detail alt sekmesi: seçilen algoritma için her PA seti × kat grubuna bir panel; P/E (F-ratio) eğrisi, 1 düzeyinde kesikli çizgi ve başlıkta o katın CBI değeri.
| Arayüzdeki ad | Ne yapar | Varsayılan | Seçenekler | Kod |
|---|---|---|---|---|
Algorithm: |
Algoritma | ilk algoritma | çalıştırmadaki algoritmalar | tabs/tab_evaluation.py:774 |
PA set: |
Gösterilecek PA seti | (all) |
(all), PA1, PA2, … |
tabs/tab_evaluation.py:775, 893-897 |
Plot Boyce |
Panelleri çizer | — | — | tabs/tab_evaluation.py:776-777 |
Ne işe yarar. Her PA seti × kat için hold-out tahminlerinden Boyce eğrisi çizilir: x ekseni pencere orta noktası, y ekseni F=P_i/E_i oranıdır; 1'in üstündeki bölge gölgelenir; başlık rengi CBI ≥ 0,5 için yeşil, 0–0,5 için turuncu, 0'ın altı için kırmızıdır (cv_boyce_curves, sdm_core.py:6998-7015; tabs/tab_evaluation.py:791-847). Çağrılan işlev, skor tablosundaki Boyce değerini üreten çağrının aynısıdır; panel başlığındaki CBI tablodaki değerle örtüşür.
Ne zaman, nasıl ayarlanır. İyi bir modelde P/E eğrisi uygunluk arttıkça tekdüze yükselir ve düşük uygunlukta 1'in altında, yüksek uygunlukta 1'in üstündedir (Hirzel vd. 2006). Eğrinin tepeden sonra düşmesi, modelin en yüksek değerleri gereğinden geniş alana verdiğini; düz bir eğri ayırt etmenin zayıf olduğunu gösterir.
Sonuca etkisi. Ekran ve evaluation_boyce_<ALGO>.png. Örnek koşuda GLM'nin kat CBI değerleri 0,274 (PA1 RUN2) ile 0,943 (PA1 RUN3) arasında değişir; RUN1 ve RUN2 panellerinde P/E eğrisi orta uygunlukta tepe yapıp düşer.
Dikkat. Pencere genişliği tahmin aralığının onda biridir (ecospat tanımı); çok dar tahmin aralıklı modellerde (ör. BIOCLIM) pencereler birbirine çok yakın düşer. Kat başına varlık sayısı azsa eğri basamaklıdır; CBI'yi tek katta değil katların ortalamasında okuyun.
7.9 Sınıflandırma eşikleri (Classification Thresholds)
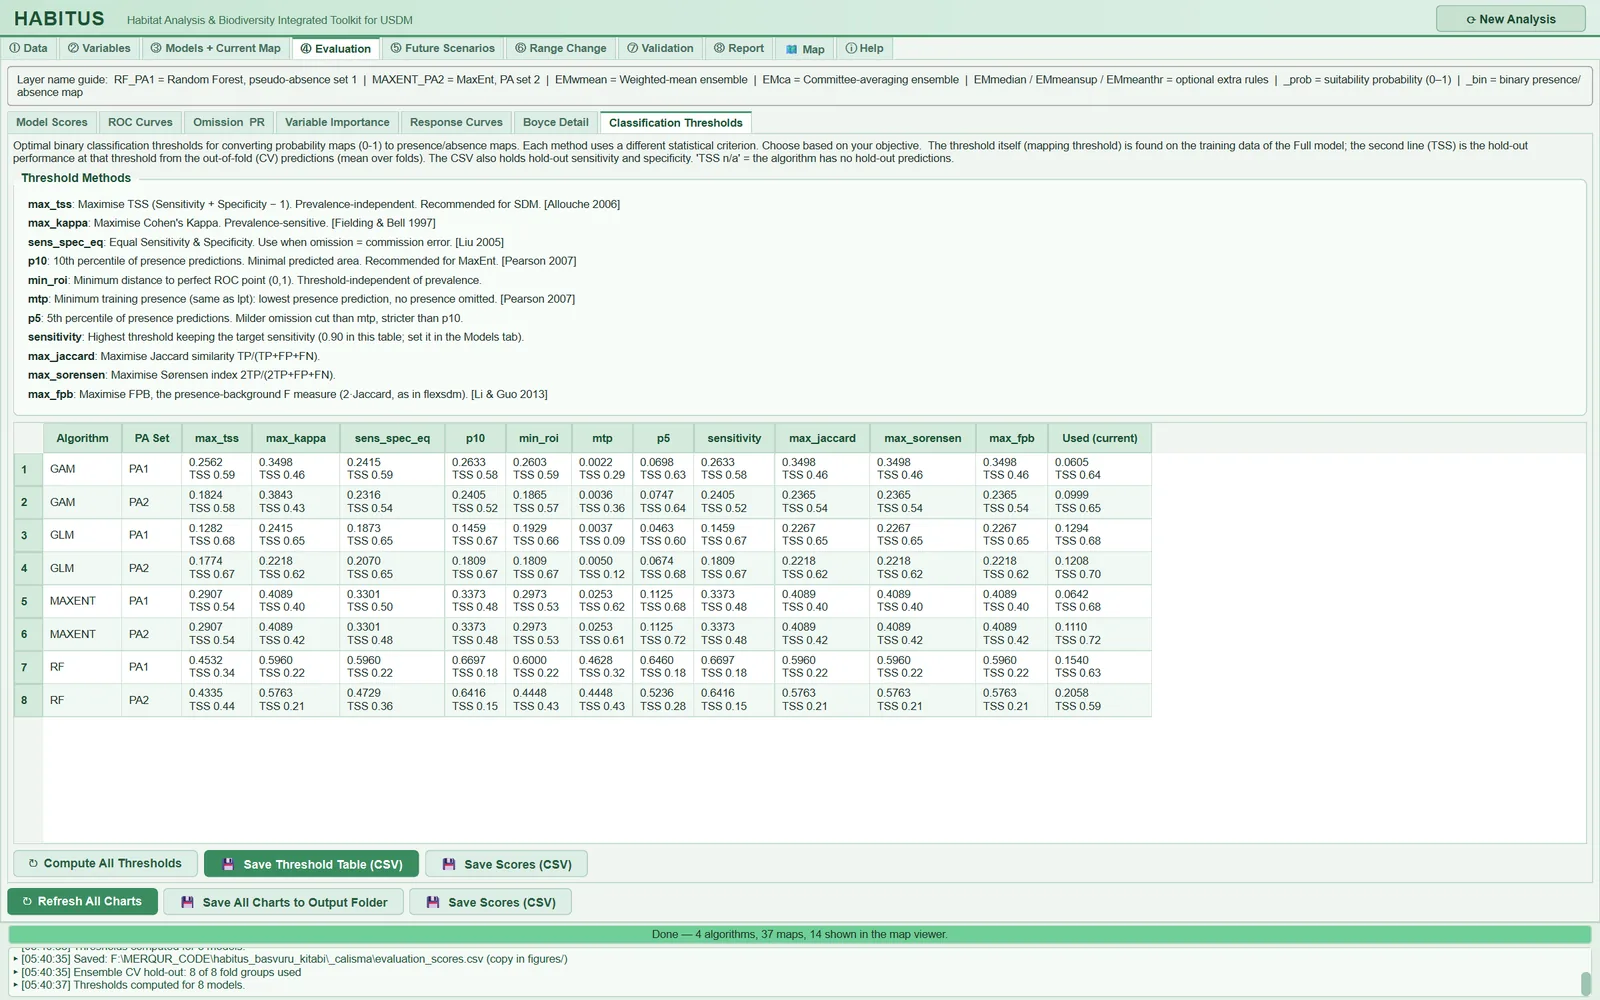
Şekil 7.7. Classification Thresholds alt sekmesi: eşik kurallarının açıklamaları ve her tam veri modeli için on bir kuralın eşiği (üst satır) ile o eşikteki kat dışı TSS (alt satır); son sütun haritada kullanılan eşik.
| Arayüzdeki ad | Ne yapar | Kod |
|---|---|---|
Threshold Methods kutusu |
On bir kuralın kısa tanımları | tabs/tab_evaluation.py:1132-1160 |
| Tablo | Satır: tam veri modeli (algoritma × PA seti); sütunlar: 11 kural ve Used (current) |
tabs/tab_evaluation.py:1162-1180 |
↻ Compute All Thresholds |
Tabloyu yeniden hesaplar | tabs/tab_evaluation.py:1183-1185 |
💾 Save Threshold Table (CSV) |
figures/classification_thresholds.csv yazar |
tabs/tab_evaluation.py:1316-1342 |
💾 Save Scores (CSV) |
evaluation_scores.csv yazar (§7.10) |
tabs/tab_evaluation.py:1188-1194 |
Ne işe yarar. Her tam veri modeli için on bir kuralın her biriyle (Bölüm 6, §6.5.1) bir harita eşiği bulunur ve hücrede iki satır yazılır: eşik ve bu eşiğin kat dışı tahminlerde verdiği TSS'nin katlar üzerinden ortalaması (tabs/tab_evaluation.py:1200-1314; sdm_core.py:7018-7037). İpucu ayrıca o eşikte kat dışı duyarlılık ve özgüllüğü, eğitim verisindeki ölçüt değerini ve "pixel >= t -> Present (1)" kuralını gösterir. Used (current) sütunu haritada fiilen kullanılan eşiktir. CSV her kural için eşik ile _holdout_Sens, _holdout_Spec, _holdout_TSS sütunlarını, kullanılan eşiği, kuralın adını ve kat sayısını içerir.
Ne zaman, nasıl ayarlanır. Eşik kuralı seçimini desteklemek için: hangi kuralın kat dışı TSS'yi koruyarak daha geniş ya da daha dar bir harita verdiğini görürsünüz. sensitivity sütunu her zaman 0,90 hedefiyle hesaplanır (yöntem açıklaması).
Sonuca etkisi. Bu tablo haritaları değiştirmez; kural ③ Models'ta değiştirilip modeller yeniden çalıştırılınca haritalar değişir.
Dikkat. Bu tablodaki eşikler ile haritada kullanılan eşik farklı yollarla bulunur:
- Tablodaki kural sütunları, tam veri modelinin tüm PA setlerinin birleşik verisindeki kendi (eğitimde görülmüş) tahminlerinden bulunur (
tabs/tab_evaluation.py:1217-1259). Used (current)ise ③ Models'ta CV katlarında, seçilen eşik kaynağıyla (varsayılantrain_cv) bulunan eşiklerin ortalamasıdır (sdm_core.py:5852-5853).
Bu nedenle max_tss sütunu ile Used (current) aynı kural için bile farklıdır. Örnek koşuda GAM PA1 için max_tss sütunu 0,2562 (kat dışı TSS 0,59), kullanılan eşik 0,0605'tir (kat dışı TSS 0,64). Eğitim verisini ezberleyen algoritmalarda fark büyür: RF PA1 için max_tss sütunu 0,4532 (kat dışı TSS 0,34), kullanılan eşik 0,1540'tır (kat dışı TSS 0,63). Kural karşılaştırması için alt satırdaki kat dışı TSS'ye bakın; eşik değerlerini haritanın eşiği olarak okumayın.
7.10 Alt düğmeler: yenileme, kaydetme
| Arayüzdeki ad | Ne yapar | Kod |
|---|---|---|
↻ Refresh All Charts |
Açılır listeleri günceller ve yedi alt sekmenin tamamını yeniden hesaplar | tabs/tab_evaluation.py:851-872 |
💾 Save All Charts to Output Folder |
Bütün şekilleri ve skor tablosunu figures/ klasörüne yazar; iptal edilebilir |
tabs/tab_evaluation.py:939-1058 |
💾 Save Scores (CSV) |
evaluation_scores.csv dosyasını çıktı kökene ve figures/ kopyasına yazar |
tabs/tab_evaluation.py:1064-1108 |
Ne işe yarar. Save All Charts … sırayla skor, ROC, omisyon/PR/kalibrasyon ve önem şekillerini; ardından CV modeli olan her algoritma için tepki eğrisi (o anda seçili Method: ile) ve Boyce şeklini; en sonda skor tablosunu yazar (tabs/tab_evaluation.py:993-1030). Her şekil 300 dpi PNG olarak bir kez kaydedilir (tabs/tab_evaluation.py:923-937). Ekranda bir şekil çizildiğinde de aynı adla kaydedilir; bu yüzden düğmeye basılmadan figures/ klasöründe yalnız görüntülenen algoritmanın tepki ve Boyce şekilleri bulunur (örnek koşuda yalnız evaluation_response_GLM.png ve evaluation_boyce_GLM.png).
Dikkat. evaluation_scores.csv ③ Models bitince, sekme ilk açıldığında ve topluluk yeniden kurulduğunda kendiliğinden yazılır (tabs/tab_evaluation.py:1071-1081; tabs/tab_models.py:1840-1845); Save Scores (CSV) yalnız elle yinelemek içindir. Çıktı klasörü yoksa şekil kaydedilemez ve günlüğe "Output directory not set — cannot save figure." yazılır. Kayıt sonrası bilgi penceresi figures/response_curves/ alt klasöründen söz eder; böyle bir klasör oluşturulmaz, algoritma başına tek birleşik şekil yazılır.
7.11 Çıktılar ve sonraki adıma geçenler
<çıktı>/figures/ klasöründe:
evaluation_model_scores.png,evaluation_roc_curves.png,evaluation_omission_pr_calibration.png,evaluation_variable_importance.pngevaluation_response_<ALGO>.png,evaluation_boyce_<ALGO>.pngevaluation_omission_pr_calibration.csv,classification_thresholds.csv,evaluation_scores.csv(kopya)
Çıktı kökünde evaluation_scores.csv. Bu sekme modelleri, eşikleri ve haritaları değiştirmez; ⑧ Report aynı skor tablosunu ve şekilleri kullanır (Bölüm 11).
7.12 Uzman soruları
S1. Bu sekmedeki ROC, omisyon ve Boyce eğrileri bağımsız veriden mi? Model eğitim verisinde mi sınanıyor?
Cevap: Eğriler yalnız ③ Models'ta kaydedilen CV hold-out tahminlerinden çizilir (modeler.cv_holdout; sdm_core.py:5547-5556); yeni bir bölme ya da eğitim satırlarında tahmin yapılmaz (sdm_core.py:6926-6932). Bağımsızlık derecesi ③ Models'taki CV tasarımına bağlıdır: mekânsal bloklarda testler eğitimden coğrafi olarak ayrıdır, random tasarımında değildir. İstisnalar tepki eğrileri ve Classification Thresholds tablosunun eşik sütunlarıdır.
S2. Topluluk (EMwmean) için verilen AUC topluluk haritasından mı hesaplanıyor?
Cevap: Hayır. Topluluk satırları ve ROC panelleri, her katta o katı görmemiş CV modellerinin topluluk kuralıyla birleştirilmesi ve yalnız o katta skorlanmasıyla üretilir; üye seçimi ve ağırlıklar diğer katların skorlarından gelir (sdm_core.py:6516-6696). Skorlar alt sekmesinin notu bunu açıkça yazar: "… they are NOT computed from the ensemble map." (tabs/tab_evaluation.py:269-274).
S3. TSS kaç eşikte ve hangi veride hesaplanıyor; ecospat ya da biomod2 ile karşılaştırılabilir mi?
Cevap: TSS, seçilen kuralın (varsayılan max_tss) eğitim satırlarının iç kat dışı tahminlerinde bulduğu eşikte, test katında hesaplanır (sdm_core.py:1193-1217). biomod2 ve ecospat.max.tss eşiği genellikle değerlendirme verisinin kendisinde en iyiler; bu "kâhin" eşik TSS'yi yükseltir. ③ Models'ta Test-fold threshold: = test seçilirse HABITUS da aynı yolu izler ve sayılar karşılaştırılabilir olur; ancak bu seçim iyimserdir (Bölüm 6, §6.5.2).
S4. Boyce indeksi ecospat ile birebir aynı mı?
Cevap: Varsayılan ecospat formülü ecospat.boyce (ecospat 4.1.4) işlevinin satır satır aktarımıdır: pencere genişliği tahmin aralığının 1/10'u, 101 konum, kapalı pencereler, ardışık yinelenen P/E değerlerinin atılması ve Spearman korelasyonu (sdm_core.py:475-543). Fark, fit kümesinin seçimindedir: HABITUS değerlendirme katının tüm satırlarını (test varlıkları ve test yalancı yoklukları) kullanır (sdm_core.py:605-610); ecospat'ta fit çoğu uygulamada tüm çalışma alanının raster tahminleridir. Bu nedenle değerler aynı tahminlerle birebir, tam harita ile yaklaşık örtüşür.
S5. Kalibrasyon eğimi nasıl hesaplanıyor ve yalancı yokluklu veride ne anlama geliyor?
Cevap: Gözlemin, tahminin logit'i üzerine (pratikte cezasız, C = 1e12) lojistik regresyonunun eğimidir; tahminler [10^{-6}, 1-10^{-6}] aralığına kırpılır, en az 10 satır ve iki sınıf gerekir (sdm_core.py:989-1013; Pearce ve Ferrier 2000). Yalancı yokluklu veride olasılığın ölçeği PA:varlık oranına bağlıdır; eğim, gerçek varlık olasılığının değil, modelin kat dışı verideki aşırı ya da eksik güveninin göstergesidir. Eğimin 1'den çok küçük olması (aşırı uyum) algoritmalar arası karşılaştırmada anlamlıdır.
S6. OR_10p neden bazen 0 çıkıyor ve bu iyi bir sonuç mu?
Cevap: Her zaman değil. Omisyon eşiği değerlendirme kümesinin en düşük tahminine eşit ya da altındaysa hiçbir varlık eşiğin altına düşemez; omisyon yapı gereği 0'dır. Bu durum OR_10p_degenerate = 1 ile işaretlenir; katların en az yarısında olursa algoritma için uyarı yazılır (sdm_core.py:1100-1114, 5787-5816). Bu genellikle BIOCLIM, sığ CART ve güçlü düzenlenmiş GLMNET'te görülür; bu algoritmaların omisyonu diğerleriyle karşılaştırılmamalıdır.
S7. Değişken önemi hangi yöntemle hesaplanıyor; MaxEnt'in yüzde katkısı gibi mi?
Cevap: Hayır, permütasyon önemidir: test katında bir öngörücü karıştırılır ve AUC'deki düşüş ölçülür (sdm_core.py:5564-5636). MaxEnt'in "percent contribution" ve "permutation importance" çıktıları yüzdeye normalleştirilir ve eğitim verisinde hesaplanır; HABITUS normalleştirmez ve test katında hesaplar. scikit-learn modellerinde sabit tohum nedeniyle Variable importance reps: tekrarları aynı sonucu verir; etkin tekrar n_repeats = 3'tür.
S8. Tepki eğrileri hangi modellerden ve hangi veriden üretiliyor?
Cevap: Algoritmanın tüm kurulan modellerinden (her PA setinin CV koşuları ve tam veri modeli); kalın çizgi bunların ortalaması, gölge standart sapmasıdır (sdm_core.py:8461-8506). Değişkenin aralığı ve medyan satır, tüm PA setlerinin varlık ve yalancı yokluk satırlarının birleşiminden alınır; aralık 5.–95. yüzdeliktir, uçlarda dışdeğerleme yoktur (sdm_core.py:8405-8457). biomod2'nin bm_PlotResponseCurves işlevindeki varsayılan yaklaşım da diğer değişkenleri sabit bir değerde (medyan) tutmaktır; değişken aralığı ve özetleme ayrıntıları iki programda aynı olmadığından eğriler biçimce benzer, sayıca birebir olmayabilir.
S9. Marginal, PDP ve ICE ne zaman farklı sonuç verir?
Cevap: Öngörücüler arasında etkileşim ya da güçlü ilişki varsa. Marginal yalnız medyan satırının çevresini gösterir; PDP gerçek veri satırları üzerinden ortalar (Friedman 2001); ICE her satırın eğrisini ayrı gösterir ve PDP'nin ortalamayla gizlediği heterojenliği ortaya çıkarır (Goldstein vd. 2015). Doğrusal toplamsal bir modelde (ör. etkileşimsiz GLM) üçü aynı biçimi verir, düzeyleri farklı olabilir; ağaç modellerinde ve interactions terimli GLM'de ayrışırlar.
S10. Classification Thresholds tablosundaki max_tss neden haritadaki eşikle aynı değil?
Cevap: Tablo eşiği, tam veri modelinin tüm PA setlerinin birleşik verisindeki (eğitimde görülmüş) tahminlerinden bulur (tabs/tab_evaluation.py:1217-1259); haritadaki eşik ise CV katlarında eşik kaynağına göre bulunan eşiklerin ortalamasıdır (sdm_core.py:5852-5853). Örnek koşuda RF PA1 için tablo 0,4532, harita 0,1540'tır; RF'nin eğitim tahminleri varlıklarda 1'e yakın olduğundan tablo eşiği yüksek çıkar ve kat dışı TSS 0,34'e düşer, haritanın eşiği 0,63 verir. Tablonun güvenilir kısmı alt satırdaki kat dışı TSS'dir.
S11. Algoritmalar arasındaki fark anlamlı mı? Bir test sunuluyor mu?
Cevap: Hayır, istatistiksel bir karşılaştırma testi yoktur. Program katlar ve PA setleri üzerinden ortalama, SD ve aralığı verir (sdm_core.py:5883-5919) ve grafikler dağılımı gösterir. Katlar aynı veriden türediği için bağımsız değildir; basit bir t testi de geçerli olmaz. Örnek koşuda aynı algoritmanın katları arasındaki fark (GLM PA1 ROC 0,790–0,941) algoritmalar arasındaki farktan büyüktür; bu durumda sıralama yapmak yerine birden çok algoritmayı topluluğa almak daha savunulabilir.
S12. ESM ya da CV olmadan çalıştırılan bir algoritma bu sekmede nasıl görünür?
Cevap: Kat dışı tahmini olmayan algoritmalar ROC, omisyon ve Boyce şekillerinde "Not shown" notuyla listelenir (sdm_core.py:6872-6876, 6974-6977); Classification Thresholds hücreleri TSS n/a gösterir. ESM'nin hold-out tahmini kaydedilir ve normal biçimde görünür; yalnız iç kat dışı eğitim tahmini üretmediği için eşik kaynağı farklı etiketlenebilir (Bölüm 6, §6.5.2).
7.13 Sık hatalar ve tuzaklar
Model Scoresgrafiğindeki dağılımı katlar arası yayılım sanmak: grafikFull(CV ortalaması) ve topluluk satırlarını da içerir.- TSS'si 0,3'ün altındaki modeli grafikte görememek: eksen 0,3'ten başlar; değeri tabloda ya da CSV'de okuyun.
Classification Thresholdstablosundaki eşik değerlerini haritanın eşiği sanmak; haritanın eşiğiUsed (current)sütunudur.- Kalibrasyon ve kesinlik değerlerini gerçek varlık olasılığı gibi yorumlamak; ölçek PA:varlık oranına bağlıdır.
- Tepki eğrisinin gölgesini güven aralığı olarak raporlamak; yinelemeler arası SD'dir.
Save All Charts …kullanmadanfigures/klasöründe her algoritmanın tepki ve Boyce şekillerini beklemek.Variable importance reps:= 0 ile çalıştırıp önem grafiğinin neden boş olduğunu aramak.- Tepki eğrilerinde kırpma (
Clamp) uygulandığını varsaymak.
7.14 Kaynaklar
Allouche, O., Tsoar, A., Kadmon, R., 2006. Assessing the accuracy of species distribution models: prevalence, kappa and the true skill statistic (TSS). Journal of Applied Ecology 43, 1223–1232. https://doi.org/10.1111/j.1365-2664.2006.01214.x
Fielding, A.H., Bell, J.F., 1997. A review of methods for the assessment of prediction errors in conservation presence/absence models. Environmental Conservation 24, 38–49. https://doi.org/10.1017/S0376892997000088
Friedman, J.H., 2001. Greedy function approximation: A gradient boosting machine. The Annals of Statistics 29, 1189–1232. https://doi.org/10.1214/aos/1013203451
Goldstein, A., Kapelner, A., Bleich, J., Pitkin, E., 2015. Peeking inside the black box: Visualizing statistical learning with plots of individual conditional expectation. Journal of Computational and Graphical Statistics 24, 44–65. https://doi.org/10.1080/10618600.2014.907095
Hirzel, A.H., Le Lay, G., Helfer, V., Randin, C., Guisan, A., 2006. Evaluating the ability of habitat suitability models to predict species presences. Ecological Modelling 199, 142–152. https://doi.org/10.1016/j.ecolmodel.2006.05.017
Li, W., Guo, Q., 2013. How to assess the prediction accuracy of species presence–absence models without absence data? Ecography 36, 788–799. https://doi.org/10.1111/j.1600-0587.2013.07585.x
Pearce, J., Ferrier, S., 2000. Evaluating the predictive performance of habitat models developed using logistic regression. Ecological Modelling 133, 225–245. https://doi.org/10.1016/S0304-3800(00)00322-7