6. Modeller II: çapraz doğrulama, eşik, topluluk ve sonuçlar (③ Models)
Sekme: ③ Models + Current Map · Kod: tabs/tab_models.py, tabs/tab_tuning.py (arayüz); sdm_core.py SDMModeler, EnsembleModeler, Projector, evaluate_all; sdm_spatial.py (bloklar, variogram, katlar, SSB); sdm_tuning.py (ızgara araması)
6.1 Bu sekme ne yapar
③ Models sekmesi, ② Variables adımında seçilen öngörücülerle seçilen algoritmaları kurar, her birini çapraz doğrulamayla (CV) sınar, tüm veriyle yeniden kurulan modelleri bugünkü iklim katmanlarına izdüşürür ve bunları bir topluluk (ensemble) haritasında birleştirir. Bölüm 5 algoritmaların kendi seçeneklerini (Algorithm Options) anlatır; bu bölüm aynı sekmedeki geri kalan her şeyi anlatır: hangi algoritmaların çalışacağı, verinin katlara nasıl bölündüğü, ikili (var/yok) eşiğin nasıl seçildiği, topluluğun nasıl kurulduğu, isteğe bağlı ayar araması ve sonuç alt sekmeleri.
- Girdi: ① Data'da üretilen yalancı yokluk (pseudo-absence, PA) setleri, ② Variables'ta onaylanan sürekli ve kategorik öngörücüler, eğitim raster'ları ve tohum (seed). Bunlar yoksa düğme
"Complete ① Data and ② Variables steps first."iletisini verir (tabs/tab_models.py:1394-1395). - Çıktı: her algoritma × PA seti × CV koşusu için değerlendirme skorları; tüm veriyle kurulan (
Full) modellerin olasılık ve ikili haritaları; algoritma başına ortalama ve yayılım haritaları;EM*topluluk haritaları;evaluation_scores.csv,habitus_run_config.json, eğitim/test nokta dosyaları (§6.10). - Kilit düzeni: Çalıştırma bitince ④ Evaluation, ⑤ Future Scenarios, ⑥ Range Change, ⑦ Validation ve ⑧ Report sekmeleri açılır (
tabs/tab_models.py:1848-1852).
Tek düğme, ▶ Run Models + Generate Current Distribution Map, dört işi sırayla yapar (tabs/tab_models.py:1559-1659): (1) SDMModeler.run() ile CV ve tam veri modelleri, (2) EnsembleModeler ile topluluk üyelerinin süzülmesi, (3) Projector.project() ile bugünkü iklime izdüşüm ve haritaların yazılması, (4) çalıştırma kaydının (habitus_run_config.json) yazılması.
6.2 Ekranın düzeni
Şekil 6.1. ③ Models + Current Map sekmesi çalıştırmadan önce: üstte dört alt sekme, solda Select Algorithms, sağda Algorithm Options, altta Training Settings ile Combining Results && Binary Threshold Method kutuları ve en altta çalıştırma düğmesi.
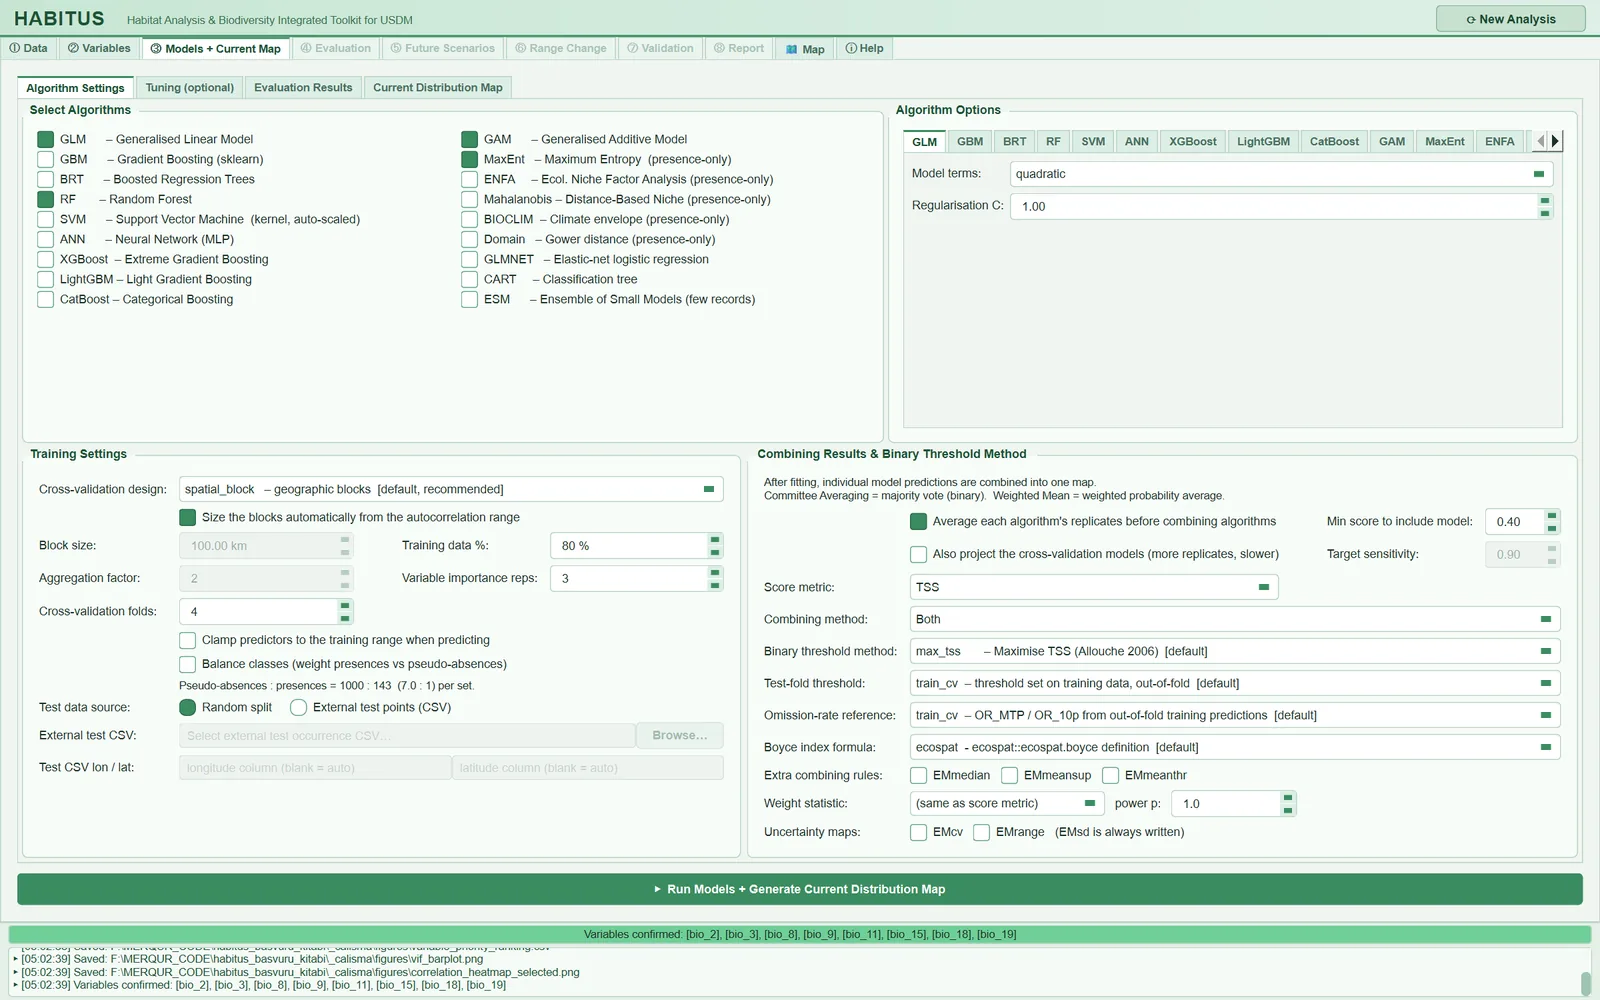
Sekmede dört alt sekme ve tüm alt sekmelerin altında duran tek çalıştırma düğmesi vardır (tabs/tab_models.py:91-110):
| Bölge | İçerik | Bu bölümde |
|---|---|---|
Algorithm Settings |
Select Algorithms, Algorithm Options, Training Settings, Combining Results && Binary Threshold Method |
§6.3–6.6 (algoritma seçenekleri: Bölüm 5) |
Tuning (optional) |
Tek algoritma için ızgara araması | §6.7 |
Evaluation Results |
Model başına ROC-AUC, TSS, Boyce tablosu | §6.8 |
Current Distribution Map |
Durum metni, üretilen haritalar tablosu, çıktı klasörü, harita görüntüleyici | §6.9 |
| Alt şerit | ▶ Run Models + Generate Current Distribution Map |
§6.1 |
Çalıştırma başlayınca program Evaluation Results alt sekmesine geçer, bitince Current Distribution Map alt sekmesini açar (tabs/tab_models.py:1491, 1835).
6.3 Algoritma seçimi (Select Algorithms)
Şekil 6.2. Select Algorithms kutusu: on sekiz algoritma iki sütunda; örnek koşuda GLM, RF, GAM ve MaxEnt işaretli.
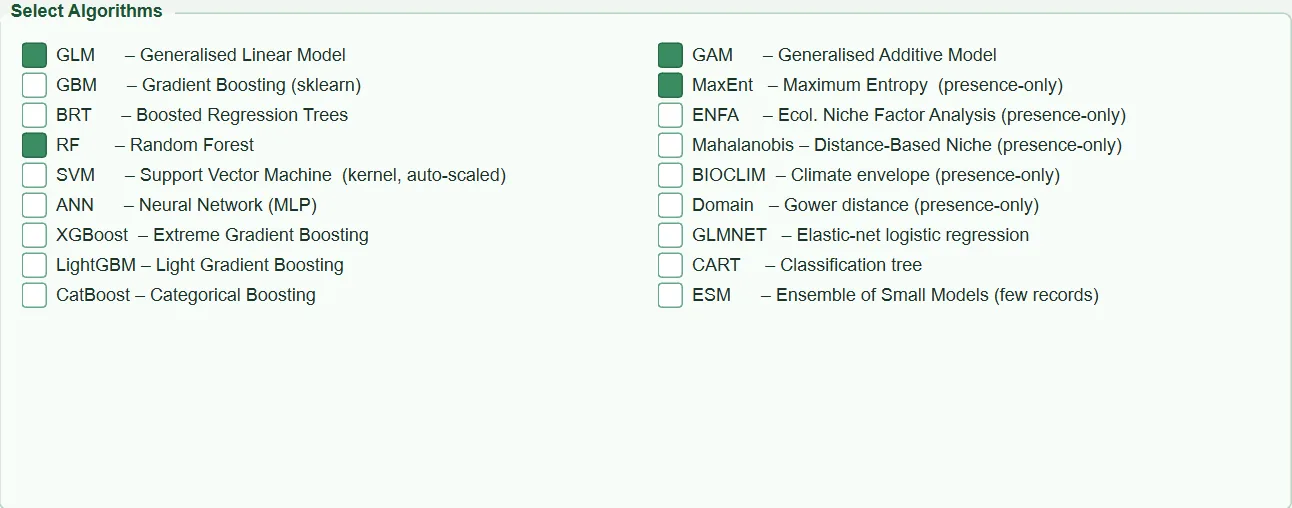
Kutuda on sekiz onay kutusu vardır; her biri bir algoritmayı çalıştırma listesine ekler (tabs/tab_models.py:125-150). İşaretli ve etkin olan her kutu çalışır (tabs/tab_models.py:1397-1398). Hiçbiri seçilmezse "Select at least one algorithm." iletisi çıkar.
| Arayüzdeki ad (kısa) | Ne yapar | Varsayılan | Kod |
|---|---|---|---|
GLM, RF |
Genelleştirilmiş doğrusal model; rastgele orman | açık | tabs/tab_models.py:129-132 |
GBM, BRT, SVM, ANN |
Gradyan artırma (sklearn), artırılmış regresyon ağaçları, destek vektör makinesi, çok katmanlı sinir ağı | kapalı | tabs/tab_models.py:130-134 |
XGBoost, LightGBM, CatBoost |
Üç artırma kütüphanesi; kurulu değilse kutu soluk ve [not installed] |
kapalı | tabs/tab_models.py:135-137, 152-168 |
GAM |
Genelleştirilmiş toplamsal model (pygam gerekir) | kapalı | tabs/tab_models.py:138 |
MaxEnt, ENFA, Mahalanobis, BIOCLIM, Domain |
Yalnız varlık kullanan (presence-only) yöntemler | kapalı | tabs/tab_models.py:139-143 |
GLMNET, CART, ESM |
Elastik ağ lojistik regresyon, sınıflandırma ağacı, küçük modeller topluluğu | kapalı | tabs/tab_models.py:144-146 |
Ne işe yarar. Seçilen her algoritma her PA setinde, her CV katında ve bir kez de tüm veriyle kurulur (sdm_core.py:5409-5643, 5654-5768). Topluluk haritası yalnız seçilen algoritmalardan oluşur (sdm_core.py:7844-7855).
Ne zaman, nasıl ayarlanır. Topluluk yaklaşımı farklı yanlılıkları olan algoritmaların birleşimini öngörür (Araújo ve New 2007); birbirine çok benzeyen algoritmaları (ör. GBM, BRT, XGBoost, LightGBM hepsi birden) eklemek topluluğu tek bir aileye ağırlaştırır. İki katmanlı birleştirme (§6.6.1) bu etkiyi yineleme sayısı bakımından giderir, aile sayısı bakımından gidermez. Az kayıtlı türlerde (yaklaşık 30'dan az varlık) ESM ve yalnız varlık kullanan yöntemler anlamlıdır (Bölüm 5).
Sonuca etkisi. Süre algoritma sayısıyla doğrusal artar: toplam kurulum sayısı yaklaşık algoritma × PA seti × (kat + 1) kadardır; Test-fold threshold = train_cv iken her CV kurulumuna üç iç kurulum daha eklenir (§6.5.2). Örnek koşuda MaxEnt tam modeli tek başına 25–28 s sürmüştür (oturum günlüğü).
Dikkat. Programın kendi yüklediği varsayılan yalnız GLM ve RF'dir; şekildeki dört algoritma örnek koşu için elle işaretlenmiştir.
6.4 Eğitim ayarları (Training Settings)
Şekil 6.3. Training Settings kutusu varsayılan değerlerle: spatial_block tasarımı, otomatik blok boyu (Block size ve Aggregation factor soluk), 4 kat, Random split ve kapalı Clamp/Balance kutuları.
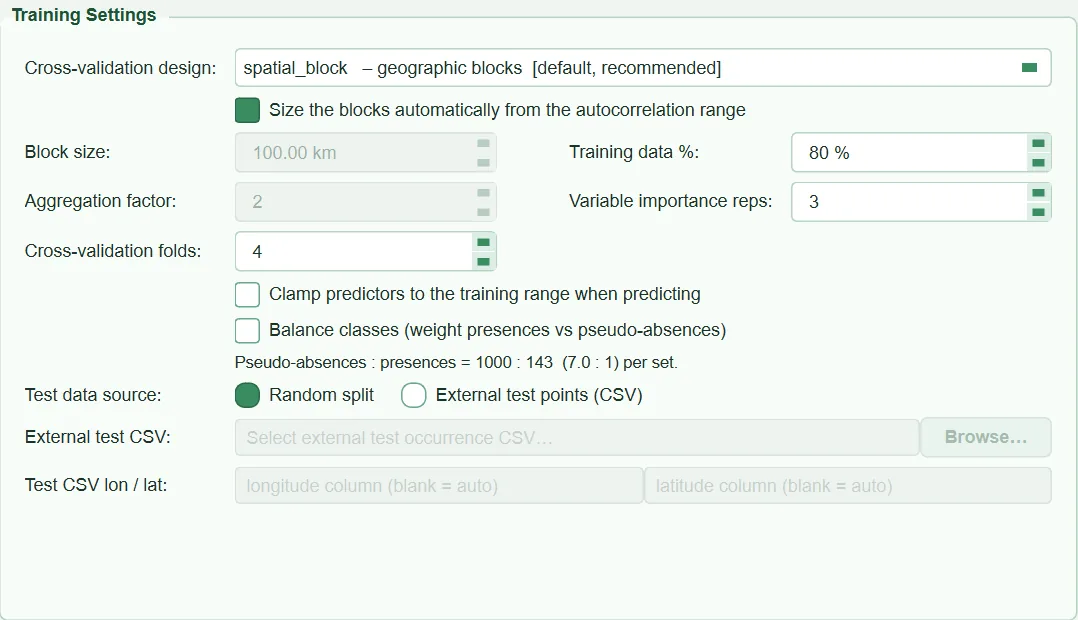
Bu kutu verinin eğitim ve test parçalarına nasıl bölüneceğini belirler. HABITUS skorlarını çapraz doğrulama katlarının tutulan (hold-out) parçasından üretir; tasarım seçimi bu nedenle raporlanan bütün skorları doğrudan etkiler.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Cross-validation design: |
Katlama tasarımı | spatial_block |
8 tasarım (§6.4.1) | tabs/tab_models.py:219-255 |
Size the blocks automatically from the autocorrelation range |
Blok boyunu variogram menzilinden alır | açık | açık / kapalı | tabs/tab_models.py:265-271 |
Block size: |
Elle blok kenarı | 100 km (yalnız otomatik kapalıyken) | 1–5000 km | tabs/tab_models.py:273-279 |
Aggregation factor: |
Dama tahtası hücre çarpanı | 2 | 1–20 (yalnız checkerboard*) |
tabs/tab_models.py:256-263 |
Cross-validation folds: |
Kat sayısı | 4 | 1–10 (jackknife'ta soluk) |
tabs/tab_models.py:211-216 |
Clamp predictors to the training range when predicting |
Öngörücüleri eğitim aralığına kırpar | kapalı | açık / kapalı | tabs/tab_models.py:354-364 |
Balance classes (weight presences vs pseudo-absences) |
Sınıfları ters orantılı ağırlıklar | kapalı | açık / kapalı | tabs/tab_models.py:333-352 |
Test data source: |
Test verisi kaynağı | Random split |
Random split / External test points (CSV) |
tabs/tab_models.py:294-299 |
Training data %: |
Yedek değerlendirme bölmesinde eğitim payı | 80 % | 50–95 % | tabs/tab_models.py:301-303 |
External test CSV: |
Dış test dosyası | boş | CSV dosyası | tabs/tab_models.py:305-311 |
Test CSV lon / lat: |
Dış test dosyasında koordinat sütunları | boş (otomatik) | sütun adı | tabs/tab_models.py:313-320 |
Variable importance reps: |
Permütasyon önemi tekrar sayısı | 3 | 0–10 | tabs/tab_models.py:290-291 |
Etkinlik kuralları _toggle_block işlevindedir (tabs/tab_models.py:281-289): blok kutuları yalnız spatial_block, checkerboard ve checkerboard2 için etkindir; Aggregation factor yalnız dama tahtası tasarımlarında; Cross-validation folds jackknife dışında her tasarımda.
6.4.1 Çapraz doğrulama tasarımı (Cross-validation design)
Ne işe yarar. Her PA seti için her satıra bir kat numarası verir (SDMModeler._build_folds, sdm_core.py:4997-5162). Kat k sırayla test kümesi olur, geri kalan katlar eğitim kümesidir (sdm_core.py:5429-5450). Sekiz tasarım vardır:
| Seçenek | Katlar nasıl oluşur | Kod |
|---|---|---|
spatial_block |
Çalışma alanına kare ızgara serilir; her blok bütün hâlinde bir kata verilir. Bloklar, her kattaki varlık ve yokluk sayıları dengeli olacak biçimde 50 tohumlu denemenin en iyisiyle dağıtılır | sdm_spatial.py:385-511, 305-357 |
environmental |
Öngörücüler standartlaştırılır, k-means ile folds kümeye ayrılır; her küme bir kat |
sdm_spatial.py:514-558 |
random |
Sınıflara göre tabakalı rastgele katlar | sdm_spatial.py:561-580 |
checkerboard |
Hücre kenarı = blok boyu × Aggregation factor olan dama tahtası; iki renk iki kat |
sdm_spatial.py:623-706 |
checkerboard2 |
İnce (blok boyu) ve kaba (blok boyu × çarpan) iki dama tahtası; kat = 2 × kaba renk + ince renk, dört kat | sdm_spatial.py:666-672 |
jackknife |
Her varlık kendi katıdır; yokluklar katlara eşit ve rastgele dağıtılır | sdm_spatial.py:709-755 |
lon_bands / lat_bands |
Boylam ya da enlem boyunca eşit varlık sayılı folds şerit |
sdm_spatial.py:758-790 |
Ayrıca Test data source: = External test points (CSV) seçilirse katlar test için kullanılmaz (§6.4.5).
Ne zaman, nasıl ayarlanır. Kümelenmiş kayıtlarda rastgele bölme, test noktasının yanı başında neredeyse aynı öngörücü değerleri taşıyan bir eğitim noktası bırakır ve skorları şişirir (Roberts vd. 2017). Bu nedenle varsayılan spatial_block'tur. Gelecek iklim izdüşümü yapılacaksa environmental, modelin görmediği koşullara aktarımı daha doğrudan sınar. checkerboard ve checkerboard2 ENMeval'deki aynı adlı bölmelerin karşılığıdır (Muscarella vd. 2014): test ve eğitim noktaları alanın her yerinde iç içe geçer. jackknife yaklaşık 25 varlığın altındaki türler içindir (sdm_spatial.py:594; Pearson vd. 2007). Şeritler bir enlem ya da boylam gradyanına aktarımı sınar. random yalnız eski bir sonucu yeniden üretmek ya da karşılaştırma için tutulmalıdır.
Sonuca etkisi. Tasarım, raporlanan her skoru (AUC, TSS, Boyce), topluluğa giren üyeleri (§6.6.4) ve üyelerin ağırlıklarını belirler; çünkü Full modellerin skoru CV katlarının ortalamasıdır (sdm_core.py:5818-5853). Bloklu tasarımlar rastgele bölmeden daha düşük, ama daha dürüst skor verir.
Dikkat.
- Tasarım uygulanamazsa (çok az blok, her iki sınıfı içermeyen katlar, koordinat yok) program rastgele katlara düşer ve bunu
"WARNING (design not applied): …"notuyla günlüğe ve rapora yazar; özet satırda[BLOCKING FAILED - scores are optimistic]görünür (sdm_core.py:5135-5140,5933-5934). - Varlık ya da yokluk içermeyen katlar başka katla birleştirilir; bu durumda istenenden az kat değerlendirilir ve
"WARNING: … requested folds held no presence or no absence and were merged into others …"iletisi verilir (sdm_core.py:5124-5134;sdm_spatial.py:360-382). randomtasarımında kat sayısı nadir sınıfın kayıt sayısını geçemez (sdm_spatial.py:572-574).- Dama tahtası tasarımlarında kat sayısı sabittir (2 ya da 4);
Cross-validation folds:bu tasarımlarda yalnız kaç katın koşulacağını sınırlar (sdm_core.py:5400-5401).checkerboard2ile 4'ten küçük bir değer bazı katların hiç test edilmemesine yol açar; bu tasarımda kat sayısını 4'te bırakın.
6.4.2 Blok boyu: otomatik ya da elle
Ne işe yarar. Size the blocks automatically from the autocorrelation range açıkken blok kenarı, ① Data aşamasında varlık noktalarındaki öngörücü değerlerinden hesaplanan ampirik variogram menzilidir (sdm_core.py:2433-2462, 5096-5106). Hesap şöyledir (sdm_spatial.py:166-281): en çok 1500 nokta alt örneklenir; en büyük çift uzaklığın yarısına kadar 15 uzaklık sınıfında yarı varyans \gamma(h)=\tfrac12\,\overline{(z_i-z_j)^2} hesaplanır; dış üçte bir sınıfın medyanı eşik (sill) sayılır; \gamma'nın eşiğin %95'ine ilk ulaştığı uzaklık o öngörücünün menzilidir; blok boyu bu menzillerin öngörücüler üzerinden medyanıdır. Nokta sayısı 20'nin altındaysa ya da variogram kurulamazsa çalışma alanının en büyük çift uzaklığının 1/10'u kullanılır (method = "fallback_extent"). Kutu kapalıyken Block size: değeri kullanılır.
Ne zaman, nasıl ayarlanır. Otomatik değer blockCV'deki mantığın sadeleştirilmiş bir karşılığıdır (Valavi vd. 2019). Menzil, makalede belirtilmiş bir ölçeğe (ör. bir dağ silsilesinin genişliği) ya da başka bir çalışmayla karşılaştırmaya göre sabitlenmek istenirse elle girilir.
Sonuca etkisi. Blok büyüdükçe katlar arası sızıntı azalır, skorlar düşer ve katlar arası fark büyür. Örnek koşuda variogram menzili 151,5 km, çalışma alanı genişliği 606 km'dir; 30 bloktan dört kat kurulmuş, katlardaki varlık sayıları 43/33/35/32 olmuştur (habitus_run_config.json).
Dikkat. Alan istenen kat sayısı kadar blok içermiyorsa blok altı kez yarıya indirilebilir; bu durumda not "Block reduced from … km so that the study area could hold … folds …" der (sdm_spatial.py:454-464, 503-507). Bu küçültme hem otomatik hem elle girilen boyuta uygulanır. Izgara, ortalama enlemde boylam aralığı \cos\varphi ile düzeltilerek derece cinsinden kurulur (sdm_spatial.py:439-446).
6.4.3 Toplama çarpanı (Aggregation factor)
Ne işe yarar. checkerboard için hücre kenarı = blok boyu × çarpan; checkerboard2 için ince ızgara = blok boyu, kaba ızgara = blok boyu × çarpan (en az 2) (sdm_spatial.py:651-672). Blok boyu otomatikse variogram menzilidir.
Ne zaman, nasıl ayarlanır. ENMeval'deki aggregation.factor ile aynı rolü oynar (Muscarella vd. 2014). Varsayılan 2 çoğu durumda yeterlidir; büyütmek dama hücrelerini büyütür ve test noktalarını eğitim noktalarından uzaklaştırır.
Sonuca etkisi. Büyük çarpan daha kötümser (daha bağımsız) test verir; çok büyük çarpanda bazı renkler tek sınıf içerebilir ve hücre küçültülür.
Dikkat. Her kat her iki sınıfı içermezse hücre altı kez yarıya indirilir, yine olmazsa rastgele katlara düşülür (sdm_spatial.py:685-698).
6.4.4 Kat sayısı (Cross-validation folds)
Ne işe yarar. spatial_block, environmental, random ve şerit tasarımlarında oluşturulacak kat sayısıdır; tüm tasarımlarda koşulacak CV koşusu (RUN1…RUNk) sayısının üst sınırıdır (sdm_core.py:5400-5407).
Ne zaman, nasıl ayarlanır. 4–5 kat yaygın kullanımdır. Kat sayısı arttıkça her test kümesi küçülür ve kat skorlarının oynaklığı artar; küçük örneklemde 3–4 kat, geniş ve çok kayıtlı alanlarda 5 kat makuldür.
Sonuca etkisi. Süre kat sayısıyla doğrusal artar. Skorların ortalaması ve standart sapması kat sayısından etkilenir.
Dikkat. 1 seçilirse katlar yine iki parça olarak kurulur ama yalnız biri test edilir (sdm_core.py:5018, 5400-5401); bu durumda kat skorlarının yayılımı hesaplanamaz ve topluluğun hold-out skoru üyelerin kendi kat skorlarına dayanır (§6.6.9). jackknife'ta koşu sayısı varlık sayısına eşittir ve bu alan dikkate alınmaz (sdm_core.py:5402-5406).
6.4.5 Test verisi kaynağı ve dış test CSV'si
Ne işe yarar. Random split seçiliyken (varsayılan) testler CV katlarının tutulan parçasında yapılır. External test points (CSV) seçilince her RUN tüm PA verisiyle eğitilir ve dosyadaki noktalarda sınanır (sdm_core.py:5417-5427). Koordinat sütunları Test CSV lon / lat: alanlarından alınır; boşsa longitude/long/lon/lng/decimallongitude/x ve latitude/lat/decimallatitude/y adları aranır, bulunamazsa 2. ve 3. sütun kullanılır (sdm_core.py:5165-5189). Dosyada presence, occurrence ya da pa adlı bir sütun varsa 0 değerli satırlar gerçek yokluk sayılır; yoksa test yoklukları çalışma alanından yeni çekilen, eğitimden bağımsız arka plan noktalarıdır; bu da olmazsa eğitim yalancı yokluklarından tohumlu bir alt örnek alınır ve bağımsız olmadığı not edilir (sdm_core.py:5191-5340).
Ne zaman, nasıl ayarlanır. Bağımsız bir saha çalışmasından, başka bir dönemden ya da başka bir bölgeden gelen kayıtlar varsa kullanılır.
Sonuca etkisi. Skorlar bağımsız veriye dayanır; ancak tüm koşular aynı veriyle eğitilip aynı noktalarda sınandığı için koşular arası fark yalnız algoritmanın kendi rastlantısallığını gösterir. Program bunu rapora "External test set: RUN1..RUNn all re-fit the same model on the SAME training data …" notuyla yazar (sdm_core.py:5341-5347).
Dikkat. Raster dışına ya da NoData'ya düşen test kayıtları sayılarak bildirilir; 10'dan az kullanılabilir varlık kalırsa "… the test statistics will be very unstable." uyarısı çıkar (sdm_core.py:5289-5301). Bu modda Training data %: soluktur ve 80 kullanılır (tabs/tab_models.py:1296-1301, 1578). Dosya seçilmeden çalıştırılırsa "External test points mode selected but no CSV provided." hatası verilir.
6.4.6 Eğitim payı (Training data %)
Ne işe yarar. Tüm veriyle kurulan (Full) her model için ayrıca rastgele bir değerlendirme bölmesi yapılır: verinin bu yüzdesiyle bir model kurulur, kalanında skorlanır (sdm_core.py:5675-5722). Aynı algoritma ve PA seti için en az bir geçerli CV skoru varsa bu bölme skoru CV katlarının ortalamasıyla değiştirilir ve Score_source = cv_mean olur (sdm_core.py:5818-5853). Bölme skoru yalnız CV skoru hiç oluşmamışsa kalır (Score_source = random_split).
Ne zaman, nasıl ayarlanır. Normal kullanımda değiştirmeye gerek yoktur.
Sonuca etkisi. CV başarılı olduğunda raporlanan skorlara, eşiklere ve haritalara etkisi yoktur.
Dikkat. Alanın ipucu metni ("% of occurrence data used for training; remainder used as test set") bu ayarın CV skorlarını belirlediği izlenimini verir; belirlemez.
6.4.7 Değişken önemi tekrarları (Variable importance reps)
Ne işe yarar. Her CV koşusunda, test katında her öngörücü karıştırılır ve AUC'deki düşüş önem sayılır. scikit-learn modellerinde permutation_importance (n_repeats=3, scoring="roc_auc", sabit tohum) çağrılır; MaxEnt, GAM, ENFA, Mahalanobis, BIOCLIM, Domain ve ESM'de her öngörücü kendi tohumlu üreteciyle karıştırılıp AUC farkı alınır (sdm_core.py:5562-5636). Tekrarların ortalaması saklanır; 0 önemi kapatır.
Ne zaman, nasıl ayarlanır. Önem grafiği gerekmiyorsa 0 süreyi kısaltır. Varsayılan 3'tür.
Sonuca etkisi. Haritaları ve skorları değiştirmez; yalnız ④ Evaluation'daki önem grafiğini besler (Bölüm 7).
Dikkat. scikit-learn modellerinde döngü her tekrarda aynı tohumu kullandığından değerler tekrarlar arasında değişmez; bu algoritmalarda etkin tekrar sayısı n_repeats = 3'tür ve alan pratikte açma/kapama işlevi görür. Tam veri (Full) modelleri için önem hesaplanmaz.
6.4.8 Kırpma ve sınıf dengeleme
Ne işe yarar. Clamp predictors … her tahminden önce öngörücüleri tüm PA setlerinin eğitim en küçük/en büyük değerlerine kırpar (sdm_core.py:4929-4962, 4979-4980). Balance classes … destekleyen algoritmalarda varlık ve yalancı yokluk sınıflarını boyutlarıyla ters orantılı ağırlıklar; altındaki satır mevcut PA:varlık oranını gösterir (örnek koşuda 1000 : 143 (7.0 : 1)) (tabs/tab_models.py:1316-1335). Algoritma bazındaki ayrıntı Bölüm 5'tedir.
Sonuca etkisi. Kırpma CV içinde neredeyse etkisizdir, gelecek izdüşümlerinde dışdeğerlemeyi sınırlar. Dengeleme olasılıkların ölçeğini değiştirir; eşikler yeniden türetilir, AUC sıralaması çoğunlukla değişmez (ipucu metni).
6.4.9 Mekânsal sıralama yanlılığı (SSB) raporu
Ayar değildir, her çalıştırmada kendiliğinden hesaplanır. Kullanılan kat tasarımı için (Hijmans 2012):
Uzaklıklar büyük daire km'sidir, katlar üzerinden havuzlanır ve kat başına da verilir (sdm_spatial.py:808-881). Yorum eşikleri koddadır: 0,7'nin altı "spatial sorting bias … scores optimistic", 0,7–1,3 "little or no spatial sorting bias", 1,3'ün üstü dışdeğerlemeci (kötümser) bölme (sdm_spatial.py:866-875). Sonuç günlüğe CV PA1: SSB = … satırıyla, çalıştırma kaydına per_pa_set.*.ssb altında ve özet satıra [SSB=…] olarak yazılır (sdm_core.py:5142-5153, 5942-5944).
Not: Örnek koşuda mekânsal bloklara karşın SSB = 0,36 bulunmuştur (test varlıkları en yakın eğitim varlığına ortalama 45,5 km, test yoklukları 127,9 km). Yalancı yokluklar alanın tamamına yayıldığı, varlıklar ise dar bir kuşakta toplandığı için bu oran bloklamadan bağımsız olarak düşük çıkabilir; SSB'yi tasarımlar arasında karşılaştırmak için kullanın, tek başına bir geçme/kalma ölçütü olarak değil.
6.5 Değerlendirme ayarları: eşik, omisyon referansı, Boyce
Şekil 6.4. Combining Results && Binary Threshold Method kutusu varsayılan değerlerle: iki katmanlı birleştirme açık, TSS skor ölçütü ve 0.40 en düşük skor, max_tss eşik kuralı, train_cv eşik kaynağı ve omisyon referansı, ecospat Boyce formülü.
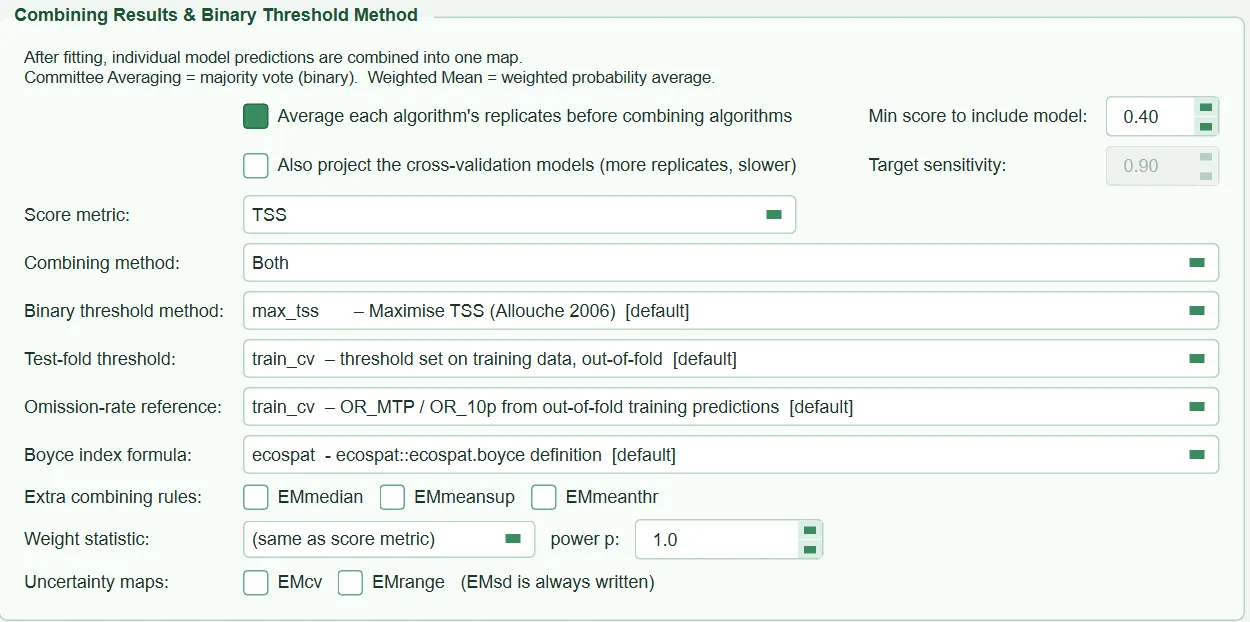
Bu kutu iki iş görür: ikili haritanın ve eşiğe bağlı skorların (TSS, Kappa, MCC, duyarlılık, özgüllük, Jaccard, Sørensen, FPB) eşiğini, ve topluluk ayarlarını (§6.6). Önce eşik ve skor ayarları:
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Binary threshold method: |
Olasılığı var/yok'a çeviren kural | max_tss |
11 kural (§6.5.1) | tabs/tab_models.py:435-455 |
Target sensitivity: |
sensitivity kuralının hedefi |
0.90 | 0.50–1.00 | tabs/tab_models.py:456-462 |
Test-fold threshold: |
Eşiğin seçildiği veri | train_cv |
train_cv / train / test |
tabs/tab_models.py:465-490 |
Omission-rate reference: |
OR_MTP ve OR_10p eşiklerinin kaynağı | train_cv |
train_cv / train |
tabs/tab_models.py:491-503 |
Boyce index formula: |
Sürekli Boyce indeksinin tanımı | ecospat |
ecospat / legacy |
tabs/tab_models.py:504-514 |
6.5.1 İkili eşik kuralı (Binary threshold method)
Ne işe yarar. Her model için bir eşik seçilir; olasılığı bu eşiğe eşit ya da büyük hücreler 1 olur (sdm_core.py:7907-7915). Kuralların hepsi find_optimal_threshold içindedir (sdm_core.py:795-948). Izgara taramalı kurallar 0,01–0,99 arasında 200 eşit aralıklı eşiği dener.
| Kural | Seçilen eşik | Kaynak | Kod |
|---|---|---|---|
max_tss |
TSS = duyarlılık + özgüllük − 1'i en büyük yapan eşik | Allouche vd. 2006 | sdm_core.py:891-897 |
max_kappa |
Cohen kappa'sını en büyük yapan eşik | Fielding ve Bell 1997 | sdm_core.py:899-915 |
sens_spec_eq |
|duyarlılık − özgüllük| en küçük | Liu vd. 2005 | sdm_core.py:917-931 |
p10 |
Varlık tahminlerinin 10. yüzdeliği | Pearson vd. 2007 | sdm_core.py:858-864 |
min_roi |
ROC eğrisinde (0,1) köşesine en yakın nokta: \min\sqrt{\mathrm{FPR}^2+(1-\mathrm{TPR})^2} | — | sdm_core.py:933-945 |
mtp |
En düşük varlık tahmini (hiç varlık dışarıda kalmaz; lpt ile aynı) |
Pearson vd. 2007 | sdm_core.py:734-735 |
p5 |
Varlık tahminlerinin 5. yüzdeliği | — | sdm_core.py:736-738 |
sensitivity |
Varlıkların en az hedef payını tutan en yüksek eşik: sıralı varlık tahminlerinde \lfloor(1-s)\,n\rfloor. değer | Allouche vd. 2006 | sdm_core.py:866-876 |
max_jaccard |
\mathrm{TP}/(\mathrm{TP}+\mathrm{FP}+\mathrm{FN}) en büyük | — | sdm_core.py:878-885 |
max_sorensen |
2\mathrm{TP}/(2\mathrm{TP}+\mathrm{FP}+\mathrm{FN}) en büyük | — | sdm_core.py:878-885 |
max_fpb |
FPB = 2 × Jaccard en büyük (flexsdm'in varlık-arka plan F ölçüsü) | Li ve Guo 2013 | sdm_core.py:701, 878-885 |
Ne zaman, nasıl ayarlanır. max_tss yalancı yokluklu verilerde yaygın ve yaygınlıktan (prevalence) görece bağımsızdır. Yanlış negatifin pahalı olduğu korunan alan çalışmalarında p10, p5, mtp ya da sensitivity (ör. 0,95) daha geniş alan verir. Omisyon ve komisyon hatası eşit önemliyse sens_spec_eq seçilir. Kappa ve Jaccard ailesi yaygınlıktan etkilenir; yalancı yokluk sayısı değiştikçe eşik kayar.
Sonuca etkisi. İkili haritalardaki alan, alan değişimi hesapları (⑥ Range Change) ve eşiğe bağlı tüm skorlar bu kurala bağlıdır. AUC, Boyce, Brier ve kalibrasyon eğimi eşikten bağımsızdır. Örnek koşuda max_tss ile seçilen eşikler 0,06–0,21 arasındadır (GLM_PA1 0,1294, RF_PA2 0,2058; oturum günlüğü): olasılık ölçeği düşük olduğundan 0,5 gibi sabit bir eşik bu verilerde çok dar bir harita verirdi.
Dikkat. Haritada kullanılan eşik, o modelin CV katlarında seçilen eşiklerin ortalamasıdır (sdm_core.py:5852-5853); tam veri modelinin kendi verisinde yeniden seçilmez. Eşik hesaplanamazsa 0,5 kullanılır ve Threshold_source sütununa FAILED, 0.5 used (…) yazılır (sdm_core.py:1221-1227). Target sensitivity: kutusu yalnız sensitivity seçiliyken etkindir; hedef anahtarın içinde taşınır (sensitivity:0.90) ve çalıştırma kaydına öyle yazılır (tabs/tab_models.py:1504-1507).
6.5.2 Eşiğin seçildiği veri (Test-fold threshold)
Ne işe yarar. Test katındaki eşiğe bağlı skorlar için eşiğin hangi tahminlerde seçileceğini belirler (evaluate_all, sdm_core.py:1122-1257):
train_cv(varsayılan): eğitim satırları üç iç kata bölünür (OOF_INNER_FOLDS = 3, katlar kullanıcının CV tasarımıyla kurulur); her satır kendisini görmemiş bir modelle tahmin edilir; eşik bu kat dışı (out-of-fold) tahminlerde seçilip test katına uygulanır (sdm_core.py:4876-4919,4296-4368).train: eşik, modelin kendi eğitim satırlarındaki tahminlerde seçilir.test: eşik doğrudan test katında, o katın skorunu en büyük yapacak biçimde seçilir (kâhin eşik).
Ne zaman, nasıl ayarlanır. train_cv önerilen ve dürüst seçenektir. train ucuzdur ama eğitim verisini ezberleyen algoritmalarda (Domain, RF, GBM, XGBoost) eşik anlamsızlaşır. test yalnız eski sonuçlarla karşılaştırma içindir.
Sonuca etkisi. test seçeneği TSS'yi tipik olarak 0,1–0,2 yüksek verir (ipucu metni, tabs/tab_models.py:480-482). train_cv her CV kurulumuna üç iç kurulum ekler; süre kabaca iki katına çıkar. Haritadaki eşik CV katlarındaki eşiklerin ortalaması olduğundan (§6.5.1) bu seçim haritaları da etkiler.
Dikkat. test seçilince kutunun altında turuncu uyarı belirir: "Warning: 'test' picks the threshold on the very data it is scored on …" (tabs/tab_models.py:1261-1272). İç kurulum başarısız olursa kaynak train (inner CV unavailable) olarak etiketlenir (sdm_core.py:1201-1207). ESM iç kat tahmini üretmez (sdm_core.py:4889-4890).
6.5.3 Omisyon oranı referansı (Omission-rate reference)
Ne işe yarar. OR_MTP ve OR_10p, test varlıklarının sırasıyla en düşük ve 10. yüzdelik eğitim varlık tahmininin altında kalan payıdır (sdm_core.py:1062-1115). train_cv bu referans değerleri iç kat dışı tahminlerden, train modelin kendi eğitim tahminlerinden alır.
Ne zaman, nasıl ayarlanır. Varsayılan train_cv önerilir; ENMeval'in omisyon tanımıyla aynı mantıktadır (Muscarella vd. 2014), referansın ezberden etkilenmemesi farkıyla.
Sonuca etkisi. Yalnız OR_MTP ve OR_10p sütunlarını ve Tuning'deki ENMeval seçim kuralını (§6.7) etkiler; haritaları etkilemez.
Dikkat. train seçilince uyarı: "Warning: with in-sample references OR_10p / OR_MTP are unreliable for over-fitting algorithms …". Eşik değeri değerlendirme kümesinin en düşük tahminine eşit ya da altındaysa omisyon yapı gereği 0 olur; HABITUS bunu OR_10p_degenerate sütunuyla işaretler ve katların en az yarısında olursa algoritma için not yazar (sdm_core.py:1100-1114, 5787-5816).
6.5.4 Boyce indeksi formülü (Boyce index formula)
Ne işe yarar. ecospat, ecospat::ecospat.boyce işlevinin satır satır aktarımıdır (sdm_core.py:475-543): değerlendirilen tüm satırların tahminleri beklenen dağılımı (E), varlıkların tahminleri gözlenen dağılımı (P) verir; genişliği tahmin aralığının 1/10'u olan pencere 101 konumda kaydırılır, her pencerede F=P_i/E_i hesaplanır, ardışık yinelenen F değerleri atılır ve indeks pencere alt sınırları ile F arasındaki Spearman korelasyonudur (Hirzel vd. 2006; Boyce vd. 2002). legacy, [0, 1] ekseninde sabit 0,1 genişlikli pencere ve 101 merkezle hesaplanan önceki HABITUS tanımıdır (sdm_core.py:612-664).
Ne zaman, nasıl ayarlanır. R'daki ecospat ile karşılaştırılabilir sonuç için ecospat (varsayılan). legacy yalnız önceki bir sonucu yeniden üretmek içindir.
Sonuca etkisi. Boyce skorlarını, Boyce'u skor ölçütü yapan topluluk seçimini ve ağırlıklarını değiştirir. Kod açıklaması aynı BIOCLIM tahminlerinde legacy için 0,007, ecospat için 0,334 verildiğini kaydeder (sdm_core.py:560-562).
Dikkat. Değerlendirme kümesinde varlık yoksa ya da 5'ten az satır varsa Boyce NaN olur (sdm_core.py:605-609).
6.6 Topluluk ayarları (Combining Results)
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Average each algorithm's replicates before combining algorithms |
İki katmanlı topluluk | açık | açık / kapalı | tabs/tab_models.py:516-530 |
Also project the cross-validation models (more replicates, slower) |
CV modellerini de izdüşürür | kapalı | açık / kapalı | tabs/tab_models.py:532-540 |
Combining method: |
Yazılan temel topluluk kuralları | Both |
Weighted Mean / Committee Averaging / Both |
tabs/tab_models.py:403-417 |
Score metric: |
Üye süzme ölçütü | TSS |
TSS / ROC / Boyce |
tabs/tab_models.py:418 |
Min score to include model: |
En düşük skor | ölçüte bağlı: TSS 0.40, ROC 0.70, Boyce 0.50 | 0–1 | tabs/tab_models.py:419-433, sdm_core.py:6093 |
Extra combining rules: |
Ek kurallar | hepsi kapalı | EMmedian, EMmeansup, EMmeanthr |
tabs/tab_models.py:543-558 |
Weight statistic: |
Ağırlık istatistiği | (same as score metric) |
+ AUC, TSS, Boyce |
tabs/tab_models.py:559-566 |
power p: |
Ağırlık kuvveti | 1.0 | 0.5–10.0 | tabs/tab_models.py:567-575 |
Uncertainty maps: |
Ek belirsizlik haritaları | kapalı (EMsd her zaman) | EMcv, EMrange |
tabs/tab_models.py:576-583 |
6.6.1 İki katmanlı topluluk
Ne işe yarar. Açıkken (varsayılan) önce aynı algoritmanın yinelemeleri (her PA seti için bir tam veri modeli; §6.6.2 açıksa CV modelleri de) ortalanır; algoritma başına ortalama, yinelemeler arası standart sapma ve yinelemelerin oy payı hesaplanır (EnsembleModeler.predict_by_algorithm, sdm_core.py:6234-6331). Topluluk bu algoritma ortalamalarından kurulur (sdm_core.py:6359-6376). Kapalıyken süzgeçten geçen her model tek düz bir ağırlıklı ortalamaya girer (sdm_core.py:6377-6407).
Ne zaman, nasıl ayarlanır. Açık bırakın: aksi hâlde yinelemesi çok olan bir algoritma topluluğa daha fazla oy verir.
Sonuca etkisi. Ayrıca her algoritma için <algo>_mean_prob, <algo>_mean_bin ve birden çok yineleme varsa <algo>_sd haritaları yazılır (sdm_core.py:7964-8021). Ağırlıklar algoritma düzeyinde hesaplanır; örnek koşuda TSS ağırlıkları GLM 0,271, MaxEnt 0,265, GAM 0,241, RF 0,223'tür.
Dikkat. Kapalıyken EMsd, ek belirsizlik haritası seçilmedikçe yazılmaz (sdm_core.py:6416-6419); arayüzdeki (EMsd is always written) ifadesi yalnız iki katmanlı mod için geçerlidir.
6.6.2 CV modellerini de izdüşürme
Ne işe yarar. Varsayılan olarak yalnız tam veri modelleri izdüşürülür (algoritma başına PA seti kadar yineleme). Kutu açıkken CV katlarının modelleri de izdüşürülür ve her biri ayrı dosya (<algo>_PA1_RUN1_prob.tif …) olarak yazılır (sdm_core.py:7850-7916). Seçim ⑤ Future Scenarios'a da aktarılır (tabs/tab_models.py:1538-1546).
Ne zaman, nasıl ayarlanır. Algoritma içi kararsızlık (yinelemeler arası SD) için daha fazla yineleme istendiğinde. PA seti sayısı 1 iken algoritma başına tek yineleme kalacağı için <algo>_sd haritası ancak bu kutuyla üretilebilir.
Sonuca etkisi. İzdüşüm süresi ve disk kullanımı yaklaşık (kat + 1) katına çıkar. Topluluk ortalaması CV modellerini de içerir.
Dikkat. Topluluk yalnız izdüşürülen modellerden kurulur (sdm_core.py:6343-6355, 8028-8035). Kutu kapalıyken en düşük skoru yalnız bazı CV modelleri geçip hiçbir tam veri modeli geçemezse topluluk yazılmaz ve program "No full-data model reached the minimum … Lower the minimum score, or tick 'Also project the cross-validation models' …" iletisini verir (sdm_core.py:8040-8054). Kutu açıkken her CV modeli kendi kat skoruyla ayrıca süzülür; zayıf bir katın modeli dışarıda kalabilir.
6.6.3 Birleştirme yöntemi ve ek kurallar
Ne işe yarar. Combining method: hangi temel kuralların hesaplanıp yazılacağını belirler: Weighted Mean → EMwmean, Committee Averaging → EMca, Both → ikisi (tabs/tab_models.py:1670-1694; sdm_core.py:6173-6183, 6409-6412). Seçilmeyen kural hesaplanmaz, yazılmaz, skorlanmaz. Tanımlar (iki katmanlı modda, \bar p_a algoritma ortalaması, w_a ağırlık, v_a algoritmanın yinelemelerinden kendi eşiğinde "var" diyenlerin payı):
Ek kurallar (sdm_core.py:6016-6040): EMmedian hücre başına üye olasılıklarının medyanı; EMmeansup ağırlık istatistiği üyelerin ortalamasına eşit ya da üstünde olan "üstün" üyelerin basit ortalaması (flexsdm meansup); EMmeanthr hücrede kendi eşiğine ulaşan üyelerin olasılık ortalaması, hiçbiri ulaşmıyorsa 0 (flexsdm meanthr; Velazco vd. 2022).
Ne zaman, nasıl ayarlanır. Ağırlıklı ortalama ve komite ortalaması, Marmion vd. (2009) karşılaştırmasında iyi sonuç veren uzlaşı yöntemleridir. Medyan uç bir üyeye karşı dayanıklıdır; meanthr "en az bir üye var diyor" türünden geniş bir harita verir.
Sonuca etkisi. Her kural ayrı _prob ve _bin haritası üretir, ayrı hold-out skoru alır (§6.6.6). EMca bir oy payıdır, olasılık değildir.
Dikkat. Komite ortalaması algoritmalar arasında ağırlıksızdır; ağırlık istatistiği yalnız EMwmean ve EMmeansup'ı etkiler.
6.6.4 Skor ölçütü ve en düşük skor
Ne işe yarar. Bir model, Score metric: değeri Min score to include model: değerine eşit ya da büyükse topluluğa girer (EnsembleModeler._filter_models, sdm_core.py:6185-6196). Tam veri modellerinin skoru CV katlarının ortalamasıdır (§6.4.6). En düşük skor varsayılanı ölçüte göre değişir: ROC 0,70, TSS 0,40, Boyce 0,50 (sdm_core.py:6086-6098); kullanıcı bir değer yazana kadar ölçütü izler, yazdıktan sonra değiştirilmez (tabs/tab_models.py:1696-1710).
Ne zaman, nasıl ayarlanır. Mekânsal bloklu CV ile dürüst TSS'ler genellikle 0,3–0,6 aralığındadır; TSS için 0,40 bu nedenle seçilmiştir (kod açıklaması, sdm_core.py:6086-6092). Zayıf modelleri dışarıda bırakmak isteniyorsa yükseltilir; topluluğun boş kalmaması için en iyi modelin skoruna bakılarak ayarlanır.
Sonuca etkisi. Topluluk üye sayısı ve dolayısıyla harita değişir. Örnek koşuda sekiz tam veri modelinin sekizi de TSS ≥ 0,40 koşulunu sağlamıştır (Models included in combined map: 8/8).
Dikkat. Hiçbir model eşiği geçmezse EM* haritaları yazılmaz, algoritma haritaları yazılır; durum metni WARNING - NO COMBINED MAP: ile başlar ve ileti en iyi modelin skorunu söyler (sdm_core.py:6198-6232; tabs/tab_models.py:1831-1833).
6.6.5 Ağırlık istatistiği, ağırlık kuvveti ve belirsizlik haritaları
Ne işe yarar. Üye ağırlığı
ile hesaplanır; s_i Weight statistic: ile seçilen istatistik (varsayılan: skor ölçütü), p power p: değeridir (sdm_core.py:5988-6005). Sonlu olmayan skorlar eşit pay alır; tüm ağırlıklar sıfırsa üyeler eşit ağırlıklanır. Süzme yine skor ölçütüyle yapılır. EMsd üyeler arası standart sapmadır (ddof = 1); EMcv = SD / ortalama (ortalama ≈ 0 olan hücrede 0); EMrange = en büyük − en küçük (sdm_core.py:6068-6083). Belirsizlik yüzeyleri normalleştirilmeden yazılır ve hiçbir zaman eşiklenmez (sdm_core.py:8057-8068).
Ne zaman, nasıl ayarlanır. p=1 skorla orantılı ağırlıktır (sdm paketindeki power ile aynı anlamda); en iyi üyeleri öne çıkarmak için 2–3 kullanılabilir. Ağırlık istatistiğini skor ölçütünden farklı seçmek, ör. TSS ile süzüp Boyce ile ağırlıklamak mümkündür.
Sonuca etkisi. p büyüdükçe EMwmean en iyi algoritmaya yaklaşır. Belirsizlik haritaları topluluk haritasını değiştirmez.
Dikkat. Belirsizlik yüzeyleri en az iki üye gerektirir; tek algoritmalı bir çalıştırmada (iki katmanlı modda) EMsd oluşmaz (sdm_core.py:6073-6074).
6.6.6 Topluluğun ikili eşiği
Program topluluk haritalarını şu eşiklerle ikiliye çevirir (EnsembleModeler.binary_threshold, sdm_core.py:6423-6461): EMca için 0,5 (çoğunluk oyu); EMwmean için üyelerin eşiklerinin, harita ağırlıklarıyla ağırlıklı ortalaması; EMmedian için üye eşiklerinin medyanı; EMmeansup için üstün üyelerin eşik ortalaması; EMmeanthr için en küçük üye eşiği (sdm_core.py:6043-6065). Örnek koşuda EMwmean eşiği 0,1166, EMca eşiği 0,5'tir. Topluluk haritaları kendi aralığına gerilmez; yalnız [0, 1]'e kırpılır (sdm_core.py:8074-8081).
6.6.7 Topluluğun hold-out skoru ve diğer katlardan üye seçimi
Topluluk haritası, tüm varlıkları görmüş modellerden kurulduğu için kendi haritasında skorlanmaz. Bunun yerine her PA seti × kat grubu için o katı görmemiş CV modelleri (algoritma başına bir tane) topluluğun kuralıyla birleştirilir ve yalnız o katın tutulan satırlarında skorlanır; raporlanan değer kat gruplarının ortalamasıdır (EnsembleModeler.evaluate_cv, sdm_core.py:6516-6696). Üyenin topluluğa girip girmediği ve ağırlığı, aynı algoritmanın diğer katlardaki skorlarının ortalamasından hesaplanır (bir katı dışarıda bırakma; aynı kat numarası diğer PA setlerinde de dışarıda kalır; sdm_core.py:6463-6496). Topluluğun eşiği, üyelerin iç kat dışı eğitim tahminlerinden kurulan eğitim yüzeyinde seçilir (sdm_core.py:6619-6657). Örnek koşuda sekiz kat grubunun sekizi kullanılmış; EMwmean için ROC 0,902, TSS 0,659, Boyce 0,726; EMca için ROC 0,878, TSS 0,660, Boyce 0,725 bulunmuştur. Bu satırlar PA_set = Ensemble, CV_run = CV_holdout, Score_source = cv_holdout ile evaluation_scores.csv'ye eklenir (sdm_core.py:6698-6729).
Not: Hold-out skoru her katta düz (tek katmanlı) bir birleşimle hesaplanır, çünkü her grupta her algoritmadan tek model vardır. Tek katlı bir tasarımda "diğer kat" bulunmadığından üye kendi kat skoruyla ağırlıklanır ve bu durum
cv_notemetninde sayılır (sdm_core.py:6511-6513).
6.7 Ayar araması (Tuning (optional))
Şekil 6.5. Tuning (optional) alt sekmesinin ayar paneli (sağdaki sonuç tablosu ve grafik arama yapılmadığı için boş): MaxEnt için rm 0.50–4.00 adım 0.50 ve L, LQ, H, LQH, LQHP öznitelik sınıfları; 40 ızgara noktası, yaklaşık 160 model kurulumu.
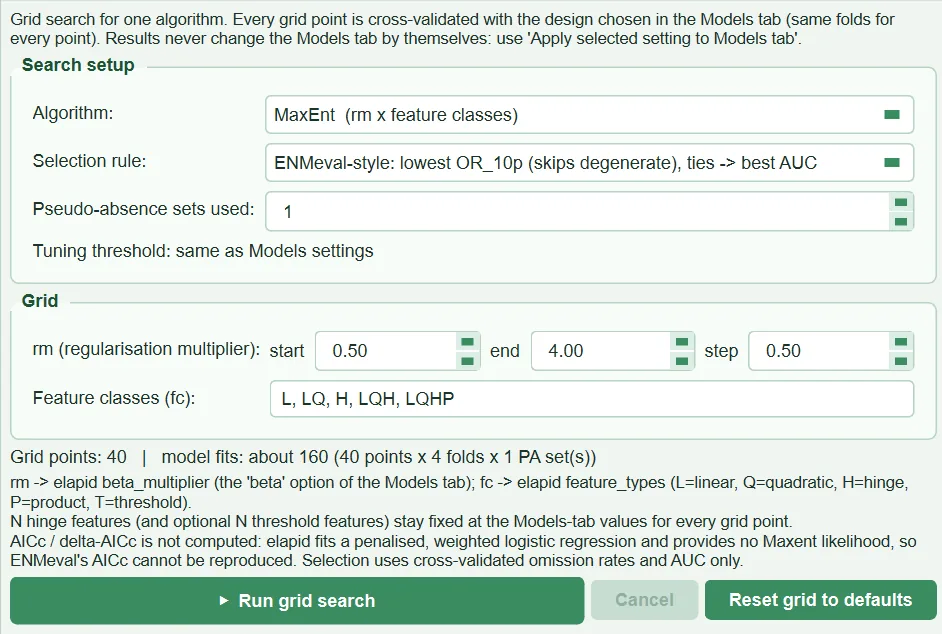
Bu alt sekme tek bir algoritmanın ayarlarını bir ızgara üzerinde arar. Her ızgara noktası, Algorithm Settings'teki CV tasarımı, eşik kuralı ve kaynağı, omisyon referansı, Boyce formülü ve kırpma ayarıyla, tüm noktalarda aynı katlarla sınanır (tabs/tab_models.py:1274-1294; sdm_tuning.py:394-494). Her nokta için yalnız CV koşulur (run(cv_only=True)); tam veri modeli ve değişken önemi hesaplanmaz.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Algorithm: |
Aranacak algoritma | MaxEnt (rm x feature classes) |
MaxEnt, GBM, RF, SVM, ANN, XGBoost, LightGBM, GLMNET, CART, GAM (kurulu olanlar) | tabs/tab_tuning.py:91-96 |
Selection rule: |
En iyi noktayı seçme kuralı | ENMeval-style | 3 kural | tabs/tab_tuning.py:97-110, sdm_tuning.py:84-88 |
Pseudo-absence sets used: |
Skorlamada kullanılan ilk n PA seti | 1 | 1–20 | tabs/tab_tuning.py:111-114 |
rm (regularisation multiplier): |
MaxEnt düzenleme çarpanı dizisi | start 0.50, end 4.00, step 0.50 | 0.05–50 | tabs/tab_tuning.py:211-226, sdm_tuning.py:506 |
Feature classes (fc): |
MaxEnt öznitelik sınıfı setleri | L, LQ, H, LQH, LQHP |
L, Q, H, P, T harfleri | tabs/tab_tuning.py:227-233, sdm_tuning.py:505 |
| Diğer algoritmaların ızgara satırları | Virgülle değer listesi ya da başla:bitir[:adım] |
algoritmaya göre (aşağıda) | — | tabs/tab_tuning.py:234-242 |
▶ Run grid search, Cancel, Reset grid to defaults |
Başlat; noktalar arasında durdur; varsayılana dön | — | — | tabs/tab_tuning.py:137-148 |
Apply selected setting to Models tab, Save table as CSV… |
Seçilen noktayı algoritma seçeneklerine yazar; tabloyu kaydeder | — | — | tabs/tab_tuning.py:170-178, 480-499 |
Varsayılan ızgaralar (sdm_tuning.py:626-643, 776-793, 837-843): GBM n_estimators 20, 50, 100, 200, 500 × learning_rate 0.01, 0.1, 0.3 × min_samples_leaf 1–10, 20, 30 (flexsdm tune_gbm, 180 nokta); RF max_features 2'den öngörücü sayısına kadar × n_estimators 200–1200 (flexsdm tune_raf); SVM C 1, 2, 4, 8, 16 × gamma 0.001, 0.01, 0.1, 0.2 (kernlab sigma = sklearn gamma); ANN hidden_layer_sizes 2, 4, 6, 8 × alpha = 2 × nnet decay; XGBoost ve LightGBM için 3 × 3 × 3; GLMNET C 0.01–10 × l1_ratio 0–1; CART max_depth × min_samples_leaf × ccp_alpha; GAM n_splines 5–20 × lam 0.1–10.
6.7.1 Seçim kuralı (Selection rule)
Ne işe yarar. enmeval: ortalama OR_10p'si en düşük nokta, eşitlikte en yüksek ortalama test AUC'si (Muscarella vd. 2014; Kass vd. 2021). enmeval_guard: önce en iyi AUC'nin bir kat-SD altından daha kötü noktaları atar, sonra aynı kural. max_auc: en yüksek ortalama test AUC'si. OR_10p'si yalnız alttaki eşit tahminler yüzünden 0 olan ("degenerate") noktalar ENMeval kurallarında seçilmez (sdm_tuning.py:238-298). Kural arama bittikten sonra yeniden kurulum yapmadan değiştirilebilir (tabs/tab_tuning.py:415-418).
Ne zaman, nasıl ayarlanır. MaxEnt için ENMeval-style yaygın kullanımla uyumludur; AUC'si belirgin düşük noktaların seçilmesini önlemek için enmeval_guard.
Sonuca etkisi. Seçilen nokta Apply selected setting to Models tab ile algoritma seçeneklerine yazılır; ana çalıştırma bunu kullanır. Arama sonucu, ızgara, kural ve seçilen noktanın çalıştırmada gerçekten kullanılıp kullanılmadığı habitus_run_config.json'a tuning_<algo> bölümü olarak yazılır (tabs/tab_models.py:2195-2208).
Dikkat. AICc hesaplanmaz; program bunu "AICc / delta-AICc is not computed: …" notuyla söyler (sdm_tuning.py:62-66). Seçim, raporlanan skorları üreten aynı katlarda yapıldığından ayarlanmış algoritmanın skorları iyimserdir; iç içe (nested) doğrulama yoktur (sdm_tuning.py:68-78). 60 noktayı ya da 600 kurulumu aşan aramalar onay ister (tabs/tab_tuning.py:36-38, 318-327). Sonuç tablosu otomatik olarak <çıktı>/tuning/tuning_<algo>.csv dosyasına yazılır (tabs/tab_tuning.py:397-413).
6.8 Değerlendirme sonuçları (Evaluation Results)
Şekil 6.6. Evaluation Results alt sekmesi örnek koşudan sonra: her algoritma, PA seti ve CV koşusu için ROC-AUC, TSS ve Boyce değerleri.
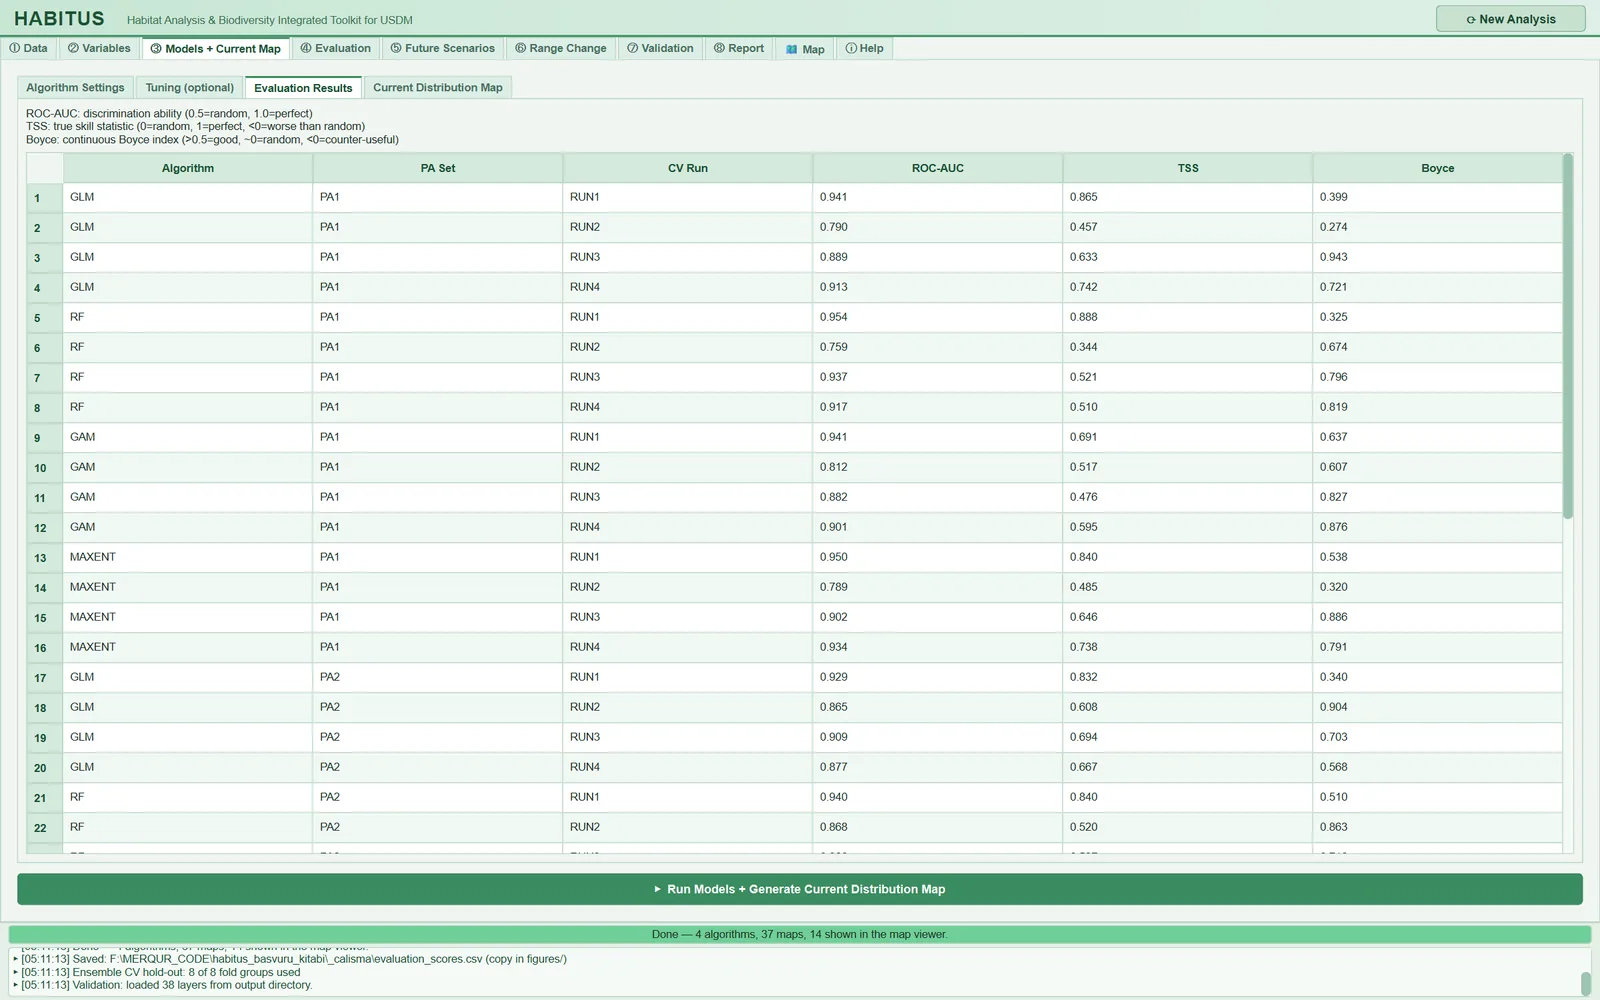
Tablo evaluation_scores_table çıktısının ilk altı sütununu gösterir: Algorithm, PA Set, CV Run, ROC-AUC, TSS, Boyce (tabs/tab_models.py:618-634, 1753-1782). Satırlar önce CV koşuları (RUN1…), sonra tam veri modelleri (Full, CV ortalamasını taşır), en sonda topluluğun hold-out satırları (EMwmean, EMca …, PA Set = Ensemble) gelir. Değerler 0,8 ve üstü yeşil, 0,6–0,8 turuncu, 0,6 altı kırmızı yazılır; sayısal olmayan değerler N/A görünür. Topluluk satırlarının ipucu, skorun haritadan değil CV hold-out'larından geldiğini söyler (tabs/tab_models.py:1769-1774).
Tablonun tamamı ve diğer sütunlar (eşik, yaygınlık, Brier, kalibrasyon eğimi, Kappa, MCC, duyarlılık, özgüllük, omisyon oranları, Threshold_source, Score_source …) evaluation_scores.csv dosyasındadır; anlamları Bölüm 7'de anlatılır.
İpucu: Renk eşikleri tüm ölçütler için aynıdır; Boyce'un 0,5'in üstü zaten iyi kabul edilir (sekme üstündeki açıklama). Renk bir yargı değil, tabloyu taramayı kolaylaştıran bir işarettir.
6.9 Bugünkü dağılım haritası (Current Distribution Map)
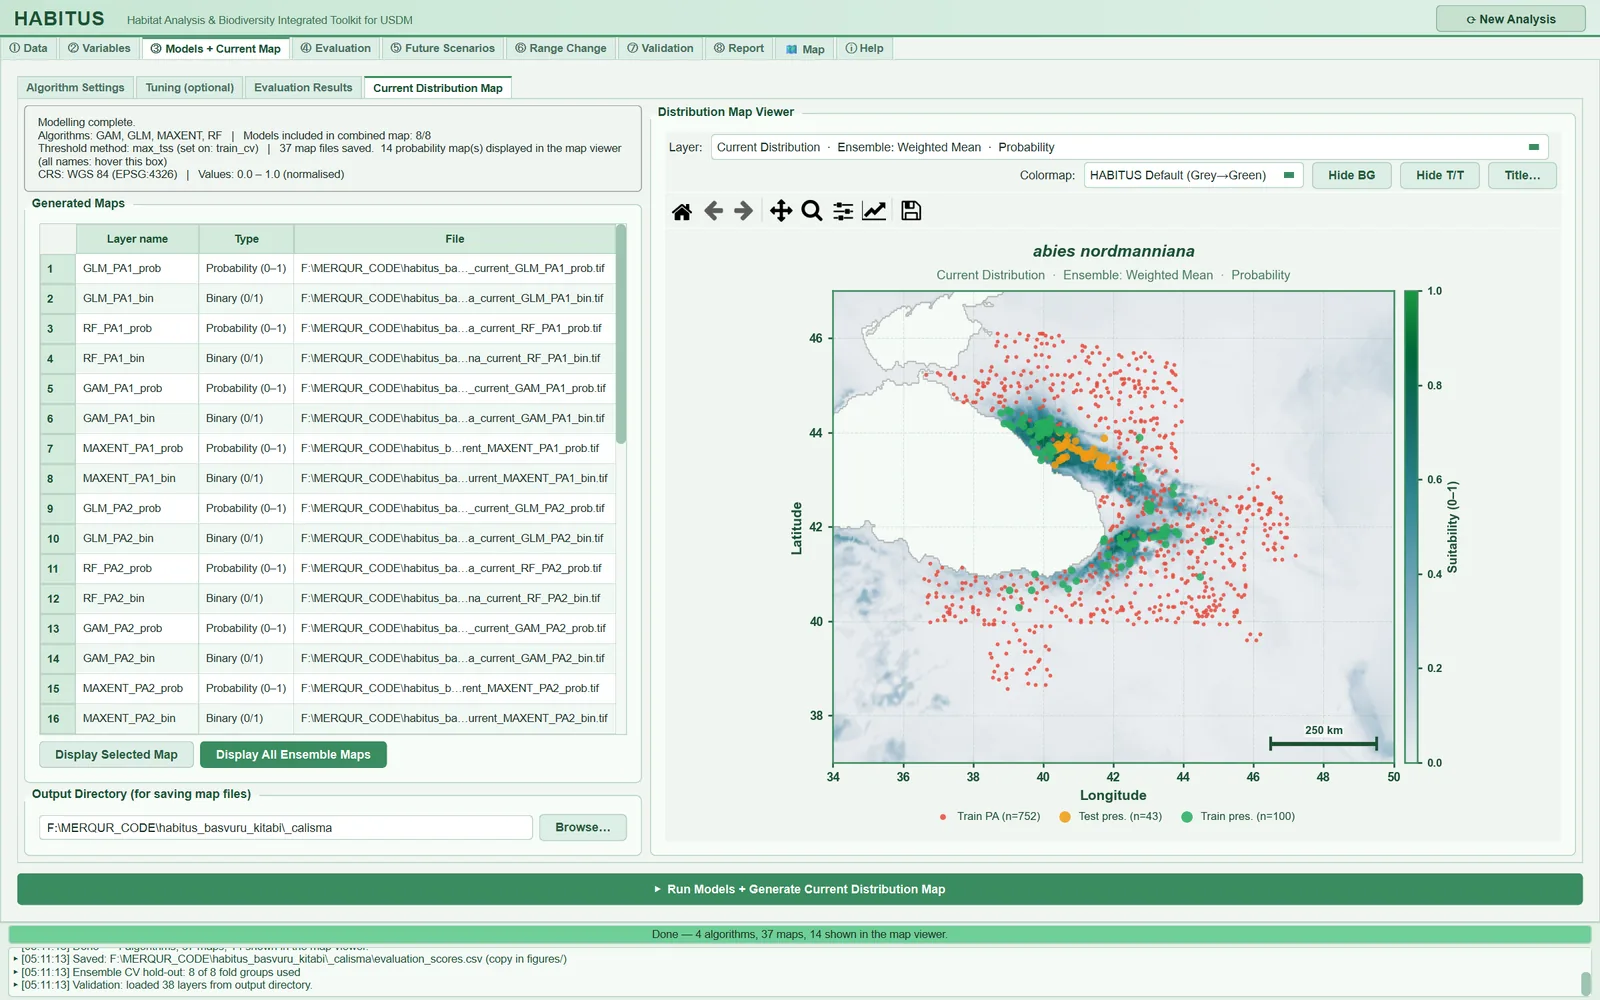
Şekil 6.7. Current Distribution Map alt sekmesi: solda durum metni, Generated Maps tablosu ve çıktı klasörü; sağda ağırlıklı ortalama topluluk haritası, üzerinde eğitim varlıkları (yeşil, n=100), test varlıkları (turuncu, n=43) ve eğitim yalancı yoklukları (kırmızı, n=752).
| Arayüzdeki ad | Ne yapar | Varsayılan | Kod |
|---|---|---|---|
| Durum metni | Algoritmalar, topluluğa giren model sayısı, eşik kuralı ve kaynağı, harita sayısı, CRS; uzun katman listesi ipucunda | — | tabs/tab_models.py:643-651, 1817-1834 |
Generated Maps tablosu |
Layer name, Type (Probability (0–1) / Binary (0/1)), File |
— | tabs/tab_models.py:654-666, 1798-1812 |
Display Selected Map |
Seçili satırların haritasını görüntüleyiciye yükler | — | tabs/tab_models.py:1963-1977 |
Display All Ensemble Maps |
EM ile başlayan tüm haritaları yükler |
— | tabs/tab_models.py:1979-1984 |
Output Directory (for saving map files) |
Haritaların yazılacağı klasör; boşsa ① Data'daki çıktı klasörü | ① Data'dan | tabs/tab_models.py:679-686, 1467-1477 |
Distribution Map Viewer |
Katman seçimi, renk ölçeği, Hide BG, Hide T/T, Title… |
— | tabs/tab_models.py:688-695; map_widget.py:346-401 |
Çalıştırma bitince tüm olasılık haritaları görüntüleyiciye otomatik yüklenir (tabs/tab_models.py:1808-1812); katman adları Current Distribution · <algoritma> · PA-<n> · Probability ya da … · Ensemble: Weighted Mean · Probability biçimindedir (tabs/tab_models.py:35-47). Haritanın üzerine ilk PA setinin ilk CV katındaki bölme çizilir: eğitim varlıkları yeşil, test varlıkları turuncu, eğitim yalancı yoklukları kırmızı (tabs/tab_models.py:1859-1907; sdm_core.py:5470-5513). Aynı noktalar occurrence_train.csv, occurrence_test.csv ve occurrence_all_splits.csv olarak çıktı klasörüne yazılır (tabs/tab_models.py:1914-1961). Hide BG yalancı yokluk noktalarını, Hide T/T eğitim/test noktalarını gizler; görüntüleyicinin diğer araçları Bölüm 12'de anlatılır.
Dikkat. Örnek koşuda durum metni 37 map files saved. 14 probability map(s) displayed der: 8 bireysel model × 2 (olasılık, ikili) + 4 algoritma × 3 (ortalama olasılık, ortalama ikili, SD) + 2 topluluk × 2 + EMsd + 4 yenilik katmanı (NT1, NT2, MIC_NT1, MIC_NT2) = 37 dosya; görüntüleyiciye yüklenen 14 harita, _prob ile biten 8 bireysel, 4 algoritma ortalaması ve 2 topluluk haritasıdır. Haritadaki "test" noktaları bir 80/20 bölmeden değil, ilk mekânsal kattan gelir; bu nedenle birbirine bitişik bir küme oluştururlar (Şekil 6.7'deki turuncu küme). Değerler [0, 1]'e kırpılmış ham olasılıklardır; durum metnindeki normalised sözcüğü haritanın kendi aralığına gerildiği anlamına gelmez (sdm_core.py:7884-7889).
6.10 Çıktılar ve sonraki adıma geçenler
<çıktı>/current/ klasörüne (tabs/tab_models.py:1615; sdm_core.py:7895-8103):
<tür>_current_<ALGO>_PA<n>_prob.tifve_bin.tif: her tam veri modeli (CV modelleri izdüşürülürse_PA<n>_RUN<k>_…).<tür>_current_<ALGO>_mean_prob.tif,_mean_bin.tif,<ALGO>_sd.tif: algoritma ortalamaları ve yayılımları (iki katmanlı modda).<tür>_current_EMwmean_prob.tif,EMca_…, ek kurallar veEMsd.tif/EMcv.tif/EMrange.tif.NT1,NT2,MIC_*yenilik (ExDet) katmanları veprojection_options.json(Bölüm 8).
Çıktı kökünde: evaluation_scores.csv (ve figures/ kopyası), habitus_run_config.json (CV tasarımı, kat başına blok boyu, SSB, kat boyutları, eşik ayarları, topluluk üyeleri ve ağırlıkları, hold-out topluluk skorları), occurrence_*.csv ve aramalar yapıldıysa tuning/tuning_<algo>.csv (tabs/tab_models.py:2056-2240).
Sonraki sekmelere geçenler: modeller ve topluluk nesnesi, topluluk kuralları ve ağırlıkları, iki katmanlı mod ve izdüşürülen yinelemeler (⑤ Future Scenarios aynı kuralları kullanır, tabs/tab_models.py:1539-1546), eşikler (⑥ Range Change), harita dosyaları (⑦ Validation katman listeleri otomatik doldurulur, tabs/tab_models.py:1853-1857).
6.11 Uzman soruları
S1. Mekânsal blok boyu nasıl belirleniyor; blockCV ile aynı mı?
Cevap: Hayır, aynı mantıkta ama sadeleştirilmiş. HABITUS varlık noktalarındaki her öngörücü için 15 sınıflı yönsüz ampirik variogram kurar, dış üçte bir sınıfların medyanını eşik alır, eşiğin %95'ine ilk ulaşılan uzaklığı menzil sayar ve öngörücüler üzerinden medyanı blok boyu yapar (sdm_spatial.py:166-281). blockCV ise raster hücrelerinden ya da noktalardan örnekleyip bir variogram modeli uydurarak menzili tahmin eder (Valavi vd. 2019). HABITUS'ta variogram modeli uydurulmaz ve değer yalnız varlık noktalarındaki öngörücü değerlerinden çıkar; sonuç blockCV'den farklı olabilir. Karşılaştırmalı bir değer isteniyorsa blockCV'de bulunan menzil Block size: alanına elle girilmelidir.
S2. Blok tasarımı yeterli bloğu kuramazsa ne oluyor; skorlar sessizce rastgele bölmeye mi dönüyor?
Cevap: Önce blok altı kez yarıya indirilir ve bu not edilir; yine de istenen kat kadar blok yoksa ya da ikiden az kat her iki sınıfı içeriyorsa rastgele katlara düşülür, degraded işaretlenir, not WARNING (design not applied): ile başlar ve çalıştırma özetine [BLOCKING FAILED - scores are optimistic] eklenir (sdm_spatial.py:454-495; sdm_core.py:5135-5140, 5933-5934). Sessiz bir geri dönüş yoktur; ancak kullanıcının günlüğü ya da raporu okuması gerekir.
S3. Haritayı çizen tam veri modelinin bağımsız bir skoru var mı?
Cevap: Yoktur ve olamaz; tüm veriyle kurulmuştur. Program Full satırına aynı algoritma ve PA setinin CV kat skorlarının ortalamasını (ve kat eşiklerinin ortalamasını) yazar, Score_source = cv_mean (sdm_core.py:5818-5853). Topluluk üyelerini seçen ve ağırlıklayan da bu ortalamadır. Bu, biomod2'deki "tam modelin skoru = CV skorlarının özeti" yaklaşımına benzer.
S4. İkili eşik test verisinde mi seçiliyor? Eşiğe bağlı skorlar iyimser mi?
Cevap: Varsayılan train_cv'de hayır: eşik, eğitim satırlarının üç iç katlı kat dışı tahminlerinde seçilip test katına uygulanır (sdm_core.py:4876-4927, 1193-1220). test seçeneği eşiği test katında en iyiler; kod ve ipucu bunun TSS'yi tipik olarak 0,1–0,2 şişirdiğini belirtir. Bu fark, R'da ecospat.max.tss ya da biomod2'nin değerlendirme verisinde eşik araması yapan akışlarıyla karşılaştırmada önemlidir: HABITUS'un varsayılan TSS'si bunlardan sistematik olarak düşük çıkabilir.
S5. Topluluk skoru topluluğun kendi haritasından mı hesaplanıyor?
Cevap: Hayır. Her PA × kat grubunda o katı görmemiş CV modelleri topluluk kuralıyla birleştirilir ve yalnız o katta skorlanır; üye seçimi ve ağırlıklar diğer katların skorlarından gelir (bir katı dışarıda bırakma) (sdm_core.py:6463-6696). Haritadan yeniden yerine koyma skoru (evaluate) bu tabloya hiç girmez (sdm_core.py:6698-6706). Bu tasarım, topluluğun seçim ve ağırlıklandırma adımını da doğrulamanın içine alır; biomod2'nin topluluk değerlendirmesinden daha temkinlidir.
S6. İki katmanlı topluluk neden var; biomod2'nin EMwmean'inden farkı ne?
Cevap: biomod2'de her bireysel model (PA × koşu) topluluğa ayrı üye olarak girer. HABITUS varsayılan olarak önce algoritmanın yinelemelerini ortalar, sonra algoritmaları ağırlıklar (sdm_core.py:6109-6132, 6359-6376). Böylece yinelemesi çok olan algoritma baskın olmaz ve algoritma içi kararsızlık ayrı bir SD haritasıyla görünür. Kutu kaldırılırsa düz birleşime dönülür; biomod2 ile karşılaştırma için bu seçenek kullanılabilir, ancak biomod2'nin ağırlık tanımı (sıralama tabanlı decay dâhil) birebir aynı değildir.
S7. Ağırlıklar nasıl hesaplanıyor; negatif bir skor ne oluyor?
Cevap: w_i=\max(s_i,0)^p/\sum_j\max(s_j,0)^p; negatif skorlar 0'a çekilir, sonlu olmayanlar eşit pay alır, tüm ağırlıklar sıfırsa eşit ağırlık verilir (sdm_core.py:5988-6005). Örnek koşuda TSS ortalamaları 0,687 (GLM), 0,566 (RF), 0,611 (GAM), 0,672 (MaxEnt) iken ağırlıklar 0,271/0,223/0,241/0,265'tir; yani p=1'de ağırlıklar birbirine yakındır. Ayrım isteniyorsa p artırılır.
S8. SSB nasıl hesaplanıyor ve dismo::ssb ile aynı mı?
Cevap: Kat başına test varlıklarının ve test yokluklarının en yakın eğitim varlığına uzaklığı alınır, havuzlanır ve oranlanır (sdm_spatial.py:808-881). dismo::ssb de test-varlık→eğitim-varlık uzaklığını test-arka plan→eğitim-varlık uzaklığına oranlar (Hijmans 2012); HABITUS arka plan olarak test katındaki yalancı yoklukları kullanır ve 3000'den fazla noktayı tohumlu alt örnekler. Yorum eşikleri (0,7 ve 1,3) HABITUS'a özgüdür, yayımlanmış bir kesme noktası değildir.
S9. Ayar araması (tuning) sonrası skorlar iyimser mi? İç içe doğrulama yapılıyor mu?
Cevap: Evet iyimserdir; iç içe doğrulama yapılmaz. En iyi nokta, raporlanan skorları üreten aynı katlarda seçilir; program bunu SELECTION_BIAS_NOTE ile günlüğe ve arayüze yazar ve iyimserliğin büyüklüğünün ölçülmediğini söyler (sdm_tuning.py:68-78; tabs/tab_tuning.py:396). Kullanıcı, ayarlanmış algoritmayı bağımsız bir test kümesiyle (External test points (CSV)) ya da ⑦ Validation'daki bağımsız haritayla sınayarak bu yanlılığı kısmen giderebilir.
S10. ENMeval'deki delta-AICc ölçütü neden yok?
Cevap: elapid MaxEnt'i cezalı, ağırlıklı lojistik regresyon olarak uydurur ve Maxent olabilirliğini vermez; HABITUS bu nedenle AICc'yi uydurmak yerine hiç hesaplamaz (sdm_tuning.py:38-46, 62-66). Seçim kat dışı omisyon ve AUC'ye dayanır (Warren ve Seifert 2011'in karmaşıklık uyarısı bu yolla yalnız dolaylı karşılanır).
S11. Dış test CSV'sinde RUN1…RUN4 arasındaki standart sapma bir belirsizlik ölçüsü mü?
Cevap: Hayır. Her koşu aynı tüm veriyle eğitilir ve aynı test noktalarında sınanır (sdm_core.py:5417-5427); fark yalnız algoritmanın kendi rastlantısallığından gelir. Program bunu rapora not olarak yazar (sdm_core.py:5341-5347). Belirsizlik için PA setleri arası fark ya da bloklu CV kullanılmalıdır.
S12. Hangi ayar haritayı en çok değiştirir?
Cevap: Olasılık haritası için algoritma seçimi ve topluluğa giriş eşiği (§6.3, §6.6.4); ikili harita ve alan için eşik kuralı ve eşik kaynağı (§6.5.1–6.5.2), çünkü haritadaki eşik CV katlarında seçilen eşiklerin ortalamasıdır. CV tasarımı haritayı doğrudan değiştirmez ama skorlar üzerinden hem üye seçimini hem ağırlıkları hem de eşiği değiştirir. Örnek koşuda eşikler 0,06–0,21 aralığında olduğundan eşik kuralındaki küçük farklar alanı belirgin biçimde değiştirebilir; bunun duyarlılığı ölçülmek isteniyorsa ④ Evaluation'daki Classification Thresholds tablosu kullanılabilir (Bölüm 7).
6.12 Sık hatalar ve tuzaklar
randomtasarımıyla elde edilen yüksek AUC'yi mekânsal bloklu sonuçlarla aynı tabloda karşılaştırmak. Tasarım her satırın_cv_strategyalanında ve çalıştırma kaydında yazılıdır.Min score to include model:değerini AUC alışkanlığıyla 0,7 gibi yüksek tutup ölçütü TSS'ye çevirmek: hiçbir model geçmez veWARNING - NO COMBINED MAP:görülür. Kullanıcı değer yazmamışsa varsayılan ölçütü izler; yazmışsa izlemez.checkerboard2ileCross-validation folds:değerini 4'ün altına indirmek: dört katın bir kısmı hiç test edilmez.Training data %:değerini değiştirerek skorların değişmesini beklemek; CV başarılıysa değişmez (§6.4.6).Test-fold threshold:=testile üretilen TSS'yi makalede bildirmek; arayüz bu seçimde turuncu uyarı gösterir.- Haritadaki turuncu "test" noktalarını bir rastgele test kümesi sanmak; bunlar ilk mekânsal katın noktalarıdır.
Also project the cross-validation modelskapalıyken yalnız CV modelleri eşiği geçtiğinde topluluğun neden yazılmadığını anlamamak; ileti bu kutuyu işaretlemeyi önerir.- Tek algoritmalı bir çalıştırmada
EMsdaramak: en az iki üye gerekir. - Ayar aramasında seçilen noktayı
Apply selected setting to Models tabile uygulamadan ana çalıştırmayı başlatmak; arama sonucu ayarları kendiliğinden değiştirmez. Çalıştırma kaydındakiselected_options_used_in_this_runalanı bunu gösterir.
6.13 Kaynaklar
Allouche, O., Tsoar, A., Kadmon, R., 2006. Assessing the accuracy of species distribution models: prevalence, kappa and the true skill statistic (TSS). Journal of Applied Ecology 43, 1223–1232. https://doi.org/10.1111/j.1365-2664.2006.01214.x
Araújo, M.B., New, M., 2007. Ensemble forecasting of species distributions. Trends in Ecology & Evolution 22, 42–47. https://doi.org/10.1016/j.tree.2006.09.010
Boyce, M.S., Vernier, P.R., Nielsen, S.E., Schmiegelow, F.K.A., 2002. Evaluating resource selection functions. Ecological Modelling 157, 281–300. https://doi.org/10.1016/S0304-3800(02)00200-4
Fielding, A.H., Bell, J.F., 1997. A review of methods for the assessment of prediction errors in conservation presence/absence models. Environmental Conservation 24, 38–49. https://doi.org/10.1017/S0376892997000088
Hijmans, R.J., 2012. Cross-validation of species distribution models: removing spatial sorting bias and calibration with a null model. Ecology 93, 679–688. https://doi.org/10.1890/11-0826.1
Hirzel, A.H., Le Lay, G., Helfer, V., Randin, C., Guisan, A., 2006. Evaluating the ability of habitat suitability models to predict species presences. Ecological Modelling 199, 142–152. https://doi.org/10.1016/j.ecolmodel.2006.05.017
Kass, J.M., Muscarella, R., Galante, P.J., Bohl, C.L., Pinilla-Buitrago, G.E., Boria, R.A., Soley-Guardia, M., Anderson, R.P., 2021. ENMeval 2.0: Redesigned for customizable and reproducible modeling of species' niches and distributions. Methods in Ecology and Evolution 12, 1602–1608. https://doi.org/10.1111/2041-210X.13628
Li, W., Guo, Q., 2013. How to assess the prediction accuracy of species presence–absence models without absence data? Ecography 36, 788–799. https://doi.org/10.1111/j.1600-0587.2013.07585.x
Liu, C., Berry, P.M., Dawson, T.P., Pearson, R.G., 2005. Selecting thresholds of occurrence in the prediction of species distributions. Ecography 28, 385–393. https://doi.org/10.1111/j.0906-7590.2005.03957.x
Marmion, M., Parviainen, M., Luoto, M., Heikkinen, R.K., Thuiller, W., 2009. Evaluation of consensus methods in predictive species distribution modelling. Diversity and Distributions 15, 59–69. https://doi.org/10.1111/j.1472-4642.2008.00491.x
Muscarella, R., Galante, P.J., Soley-Guardia, M., Boria, R.A., Kass, J.M., Uriarte, M., Anderson, R.P., 2014. ENMeval: An R package for conducting spatially independent evaluations and estimating optimal model complexity for Maxent ecological niche models. Methods in Ecology and Evolution 5, 1198–1205. https://doi.org/10.1111/2041-210X.12261
Pearson, R.G., Raxworthy, C.J., Nakamura, M., Peterson, A.T., 2007. Predicting species distributions from small numbers of occurrence records: a test case using cryptic geckos in Madagascar. Journal of Biogeography 34, 102–117. https://doi.org/10.1111/j.1365-2699.2006.01594.x
Roberts, D.R., Bahn, V., Ciuti, S., Boyce, M.S., Elith, J., Guillera-Arroita, G., Hauenstein, S., Lahoz-Monfort, J.J., Schröder, B., Thuiller, W., Warton, D.I., Wintle, B.A., Hartig, F., Dormann, C.F., 2017. Cross-validation strategies for data with temporal, spatial, hierarchical, or phylogenetic structure. Ecography 40, 913–929. https://doi.org/10.1111/ecog.02881
Valavi, R., Elith, J., Lahoz-Monfort, J.J., Guillera-Arroita, G., 2019. blockCV: An R package for generating spatially or environmentally separated folds for k-fold cross-validation of species distribution models. Methods in Ecology and Evolution 10, 225–232. https://doi.org/10.1111/2041-210X.13107
Velazco, S.J.E., Rose, M.B., de Andrade, A.F.A., Minoli, I., Franklin, J., 2022. flexsdm: An R package for supporting a comprehensive and flexible species distribution modelling workflow. Methods in Ecology and Evolution 13, 1661–1669. https://doi.org/10.1111/2041-210X.13874
Warren, D.L., Seifert, S.N., 2011. Ecological niche modeling in Maxent: the importance of model complexity and the performance of model selection criteria. Ecological Applications 21, 335–342. https://doi.org/10.1890/10-1171.1