3. Veri II: arka plan, yalancı yokluk, erişilebilir alan ve seyreltme (① Data)
Sekme: ① Data › Background & Pseudo-Absence Settings · Kod: tabs/tab_data.py (arayüz), sdm_core.py DataFormatter.generate_pa_datasets, _sample_background (hesap), sdm_sampling.py (stratejiler, yanlılık yüzeyi), sdm_spatial.py (erişilebilir alan, seyreltme, variogram)
3.1 Bu bölüm ne anlatır
Çoğu tür kaydı yalnız varlık bildirir: türün nerede görüldüğü bilinir, nerede bulunmadığı bilinmez. Bir modelin varlığı ayırt edebilmesi için ona "karşılaştırma" noktaları gerekir. HABITUS bu noktaları üç ayrı amaçla, üç ayrı küme olarak üretir:
- Yalancı yokluklar (pseudo-absences): GLM, GAM, RF, GBM, BRT, SVM, ANN, XGBoost, LightGBM, CatBoost, GLMNET, CART gibi iki sınıflı (varlık/yokluk) algoritmalara "yok" etiketiyle verilen noktalar. Birden çok bağımsız küme (tekrar) çekilebilir.
- MaxEnt arka planı (background): MaxEnt'in "kullanılabilir çevre"yi tanımlamak için kullandığı örnek. Yokluk sayılmaz; bir kez çekilir ve bütün MaxEnt uydurmalarında kullanılır.
- ENFA arka planı: ENFA'nın küresel çevre ortalamasını ve kovaryansını hesaplamak için kullandığı ayrı örnek.
Bu üç kümenin nereden çekildiğini erişilebilir alan, hangi ağırlıkla çekildiğini örnekleme yanlılığı yüzeyi, hangi kayıtlara göre çekildiğini seyreltme belirler. Hepsi ① Data'nın sağ üstündeki Background & Pseudo-Absence Settings grubunun altı alt sekmesindedir ve Load Data düğmesiyle birlikte uygulanır (Bölüm 2.8).
İşlem sırası (sdm_core.py:2955-3207): kayıt ayıklama → seyreltme → erişilebilir alan maskesi (seyreltilmiş kayıtlardan) → kullanıcının yokluk kayıtları → yanlılık yüzeyi → strateji kısıtları (zarf, k-ortalamalar) → yalancı yokluk kümeleri → MaxEnt arka planı → ENFA arka planı.
3.2 Ekranın düzeni
| Alt sekme | İpucu metni | Hangi küme | Bu kitapta |
|---|---|---|---|
ML Models |
ML Models (Pseudo-Absences) | yalancı yokluk | §3.3 |
Own Absences |
My Own Absence Data | yalancı yokluğun yerine/yanına gerçek yokluk | §3.4 |
MaxEnt |
MaxEnt (Background Points) | MaxEnt arka planı | §3.5 |
Sampling Bias |
Sampling Bias (Target Group) | üç kümenin ağırlıkları | §3.6 |
ENFA / Mahalanobis |
ENFA / Mahalanobis (Presence-Only) | ENFA arka planı | §3.7 |
Study Area & Thinning |
Study Area & Thinning | üç kümenin alanı; varlık kayıtları | §3.8, §3.9 |
Alt sekme ipuçları tabs/tab_data.py:214-219'da tanımlıdır. Bölümde kullanılan ekran görüntüleri örnek koşunun (Abies nordmanniana) ayarlarını gösterir.
3.3 Yalancı yokluklar: ML Models
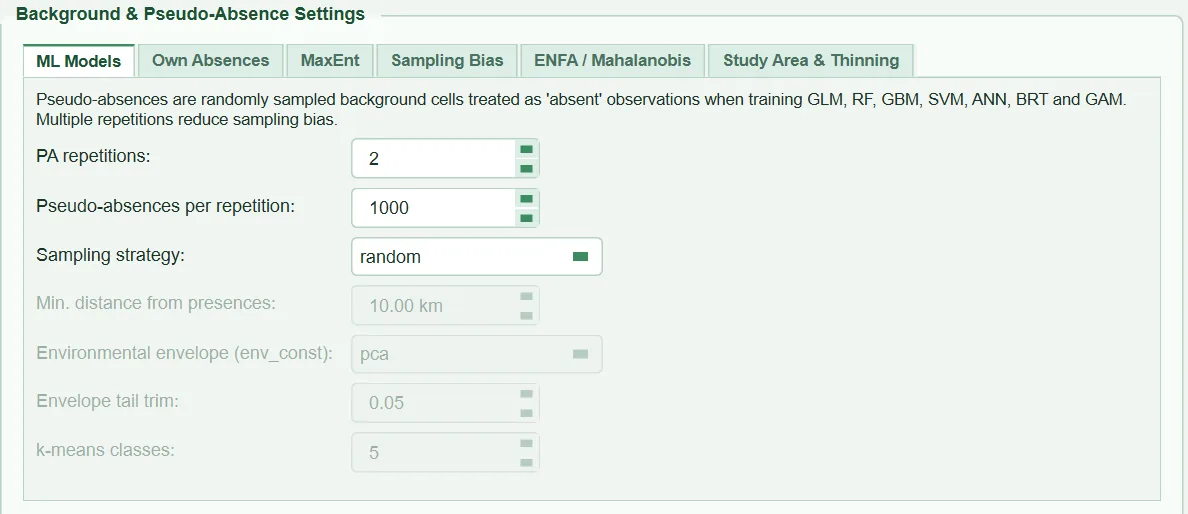
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
PA repetitions: |
Bağımsız yalancı yokluk kümesi sayısı | 2 | 1 – 10 | tabs/tab_data.py:293-297 |
Pseudo-absences per repetition: |
Her kümedeki yalancı yokluk sayısı | 1000 | 100 – 100 000 (adım 500) | tabs/tab_data.py:299-304 |
Sampling strategy: |
Yalancı yoklukların hangi hücrelerden çekileceği | random |
random, disk, sre, kmeans, env_const, geo_const, geo_env_const, geo_env_km_const |
tabs/tab_data.py:306-326, sdm_sampling.py:47-53 |
Min. distance from presences: |
Varlıklara en az uzaklık (km) | 10 km | 0 – 500 km | tabs/tab_data.py:328-333 |
Environmental envelope (env_const): |
Zarfın kuruluşu | pca |
pca, bioclim |
tabs/tab_data.py:335-342 |
Envelope tail trim: |
Zarfın her iki ucundan kırpılan pay | 0.05 | 0.00 – 0.45 | tabs/tab_data.py:343-348 |
k-means classes: |
Çevre uzayındaki küme sayısı | 5 | 2 – 30 | tabs/tab_data.py:349-353 |
Alanlar yalnız onları kullanan stratejide etkindir (tabs/tab_data.py:557-573): en az mesafe disk ve geo_*; zarf ve uç kırpma env_const, geo_env_const, geo_env_km_const; k-ortalamalar kmeans, geo_env_km_const. Own Absences'ta replace seçiliyse bütün alanlar gri olur (§3.4).
3.3.1 PA repetitions (tekrar sayısı)
- Ne işe yarar. Aynı varlıklarla, her biri ayrı çekilmiş
nyalancı yokluklaPA repetitionskadar eğitim kümesi kurulur (sdm_core.py:3035-3082). Kümelerin varlık tarafı aynıdır, yalnız yokluk tarafı değişir. ③ Models her küme için ayrı model kurar (günlüktePA1,PA2) ve topluluk her kümeden gelen modelleri birleştirir (Bölüm 5–6). - Ne zaman, nasıl ayarlanır. Arayüz ipucu 2–5'i önerir. Az yalancı yoklukla çalışılıyorsa (ör. varlık sayısı kadar) tekrar sayısı artırılmalıdır; Barbet-Massin vd. (2012) sınıflandırma ağaçlarında varlık sayısı kadar yalancı yoklukla 10 tekrarın ortalamasını önerir.
- Sonuca etkisi. Tekrar, tek bir çekilişin şansına bağlı sonucu ortalamaya dönüştürür; kümeler arasındaki fark yalancı yokluk seçiminden doğan belirsizliği gösterir. Süre kabaca tekrar sayısıyla doğru orantılı artar.
- Dikkat.
Own Absencesreplacekipinde tekrar sayısı 1'e indirilir, çünkü tekrarlanacak bir çekiliş kalmaz (sdm_core.py:3031-3033); rapor da 1 yazar.
3.3.2 Pseudo-absences per repetition (sayı) ve prevalans
- Ne işe yarar. Her kümede çekilecek yalancı yokluk sayısıdır. Hücreler yinelemesiz çekilir (
rng.choice(..., replace=False),sdm_core.py:2301-2302); aday hücre sayısı istenen sayıdan azsa hepsi alınır ve uyarı yazılır. - Ne zaman, nasıl ayarlanır. İpucu 1000–10 000 aralığını ve varlık sayısından az olmamasını önerir. Barbet-Massin vd. (2012) regresyon yöntemleri (GLM, GAM) için büyük sayıyı (ör. 10 000) ve varlık ile yokluğun eşit ağırlıklandırılmasını, ağaç yöntemleri için varlık sayısı kadar yalancı yoklukla çok tekrarı önermiştir. HABITUS'ta sınıf ağırlıklandırması ③ Models'ta ayrıca ayarlanır (Bölüm 5).
- Sonuca etkisi. Prevalans (eğitim kümesinde varlıkların payı) bu sayıyla belirlenir: p = n_{\text{varlık}} / (n_{\text{varlık}} + n_{\text{yokluk}}) (
sdm_core.py:3087-3089). Örnek koşuda 143/(143+1000) = 0{,}125'tir. Prevalans ağırlıklandırılmamış modellerin ham çıktısının düzeyini, dolayısıyla eşik değerlerini doğrudan değiştirir: yalancı yokluk sayısını artırmak ham olasılıkları düşürür. AUC eşikten bağımsızdır ama yalancı yoklukların nereden geldiğine duyarlıdır (§3.3.3, §3.8). - Dikkat. Yalancı yokluk sayısı erişilebilir alandaki geçerli hücre sayısını aşarsa alandaki bütün hücreler kullanılır ve "The accessible area holds N usable cells, fewer than the M points requested" uyarısı yazılır (
sdm_core.py:2190-2203). Örnekleme sonrası bir öngörücüde NoData'ya düşen nokta atılır ve sayılır ("PA1: N sampled point(s) fell on NoData…",sdm_core.py:2816-2841); kategorik katmanların NoData hücreleri örneklemeden baştan çıkarıldığı için bu durum seyrektir.
3.3.3 Sampling strategy (sekiz strateji)
Stratejilerin hepsi önce aynı aday kümesinden başlar: bütün sürekli ve kategorik katmanlarda değeri olan hücreler (_valid_cell_mask, sdm_core.py:2309-2330), erişilebilir alan tanımlıysa onun içinde kalanlar (sdm_core.py:2181-2203). Ardından stratejiye özgü kısıt uygulanır (sdm_core.py:2205-2297), varsa yanlılık ve sınıf ağırlıklarıyla çekiliş yapılır.
| Strateji | Ne yapar | Kullandığı alanlar | R'deki karşılığı | Kod |
|---|---|---|---|---|
random |
Aday hücrelerden eşit olasılıkla çekiliş | — | biomod2 random, flexsdm random |
sdm_core.py:2291-2305 |
disk |
Her varlığa Min. distance içindeki hücreleri dışlar, kalanlardan rastgele |
en az mesafe | biomod2 disk (yalnız en az mesafe) |
sdm_core.py:2243-2258 |
sre |
Varlıkların biyoiklim zarfının dışındaki hücrelerden çeker; zarf her değişkenin varlıklardaki %5–%95 aralığı | (sabit 0,05) | biomod2 sre |
sdm_core.py:2079-2119, 3005-3022 |
kmeans |
Ölçeklenmiş çevre uzayında k-ortalamalar; varlık içermeyen sınıflardan, her sınıfa eşit toplam ağırlıkla çeker | k | sdm eRandom, flexsdm kmeans |
sdm_sampling.py:245-288 |
env_const |
Varlıkların çevresel zarfının dışındaki hücrelerden çeker | zarf, uç kırpma | flexsdm env_const |
sdm_sampling.py:219-242 |
geo_const |
disk ile aynı kural |
en az mesafe | flexsdm geo_const |
sdm_sampling.py:26-27 |
geo_env_const |
En az mesafe ve zarf dışı | en az mesafe, zarf, uç kırpma | flexsdm geo_env_const |
sdm_core.py:2997-3003 |
geo_env_km_const |
En az mesafe, zarf dışı ve varlıksız k-ortalama sınıfları | hepsi | flexsdm geo_env_km_const |
sdm_core.py:2399-2429 |
- Ne işe yarar. Strateji, modelin varlıkları "neyle" karşılaştıracağını belirler.
randomerişilebilir alanın çevresel çeşitliliğini olduğu gibi temsil eder. Öteki stratejiler yalancı yoklukları varlıklardan coğrafi (disk,geo_const) ya da çevresel (sre,env_const,kmeans) olarak uzaklaştırır; amaç, aslında uygun olan ama kayıt bulunmayan hücrelerin "yok" etiketi almasını (yanlış yokluk) azaltmaktır. - Ne zaman, nasıl ayarlanır. Barbet-Massin vd. (2012) regresyon yöntemleri için rastgele seçimi, sınıflandırma ağaçları ve diskriminant yöntemleri için coğrafi ve çevresel olarak uzaktan seçimi önermiştir. Varsayılan
random, erişilebilir alanla birlikte kullanıldığında en az varsayım içeren seçenektir. Yoğun örneklenmiş bir türde kayıtların çevresinde yanlış yokluk riski yükseksedisk(ör. 10–50 km) makul bir ara yoldur. - Sonuca etkisi. Yalancı yoklukları varlıklardan uzaklaştıran her kısıt ayırmayı kolaylaştırır: AUC ve TSS yükselir, ama bu yükselişin bir kısmı modelin değil örnekleme tasarımının ürünüdür; tepki eğrileri varlık aralığının dışında kesilir, haritada uygun alan genişler (VanDerWal vd. 2009; Barbet-Massin vd. 2012). Zarf dışı stratejiler (
sre,env_const) bunu en güçlü biçimde yapar: model zarfın içini "uygun", dışını "uygun değil" diye öğrenmeye yönelir ve zarfı kendisi yeniden üretir. - Dikkat. Zarf ve k-ortalama stratejileri, ① Data'da yüklenen bütün sürekli katmanlarla hesaplanır; ② Variables'taki seçim daha sonra yapıldığı için seçilmeyen katmanlar da yalancı yoklukların yerini etkiler.
sre'de bir hücre zarfın içinde sayılmak için bütün değişkenlerde aralıkta olmalıdır; 19 katmanla neredeyse her hücre en az bir değişkende dışarıda kalır ve kısıt zayıflar. Zarf dışında hiç hücre kalmazsa strateji rastgele çekilişe döner ve uyarı yazılır ("no cells outside the envelope found. Falling back to random sampling.";sdm_core.py:2206-2212).random,diskvesredışındaki stratejilerde aday hücre istenen sayıdan azsa daha az nokta çekilir ("leaves only N candidate cells";sdm_core.py:2294-2297).
3.3.4 Min. distance from presences
- Ne işe yarar.
disk,geo_const,geo_env_constvegeo_env_km_const'ta her aday hücrenin merkezinin her varlığa büyük daire (haversine) uzaklığı hesaplanır; uzaklığı bu değerden büyük olmayan hücreler dışlanır (sdm_core.py:2243-2258). Projeksiyonlu ızgarada koordinatlar önce boylam/enleme çevrilir. - Ne zaman, nasıl ayarlanır. Kayıtların konum hatası ve türün yerel yayılımı kadar bir mesafe (birkaç km ile birkaç on km) tipik seçimdir. Barbet-Massin vd. (2012) sınıflandırma yöntemleri için yaklaşık 2° uzaklığı denemiştir; bu, küçük bir çalışma alanında adayların çoğunu siler.
- Sonuca etkisi. Mesafe büyüdükçe yalancı yokluklar varlıklardan ve onların çevresel koşullarından uzaklaşır; AUC/TSS yükselir, model daha "geniş" bir uygun alan çizer.
- Dikkat. Mesafe 0 iken
geo_*stratejileri hiçbir şeyi dışlamaz ve bunu uyarı olarak bildirir (sdm_core.py:2999-3003). Çok büyük mesafe "No background cells remain after min_dist=… km. Reduce the minimum distance." hatasıyla durur. Hesap her varlık için bütün aday hücreleri tarar; dünya ölçekli ızgarada ve binlerce kayıtta uzun sürebilir.
3.3.5 Environmental envelope ve Envelope tail trim
- Ne işe yarar.
env_constailesinde varlıkların çevresel zarfı iki yoldan biriyle kurulur (sdm_core.py:2407-2420):pca: bütün geçerli hücrelerdeki standartlaştırılmış sürekli değişkenler üzerinde temel bileşenler (SVD) hesaplanır; ilk iki bileşende varlıkların [q,\,1-q] nicelik aralığı zarfı oluşturur. Bir hücre, iki bileşenden en az birinde bu aralığın dışındaysa zarf dışıdır (sdm_sampling.py:219-242).bioclim: her değişken ayrı ayrı; hücre bütün değişkenlerde [q,\,1-q] aralığındaysa zarf içidir (sreile aynı hesap, fakat q ayarlanabilir;sdm_core.py:2410-2412).Envelope tail trimq'dur: 0 tam en küçük-en büyük aralığı, 0,05 ise %5–%95 aralığını verir.
- Ne zaman, nasıl ayarlanır. flexsdm'in
env_constyöntemine en yakın olanpca'dır. Kayıtlarda konum hatası ya da aykırı değer şüphesi varsa q büyütülür (zarf daralır). - Sonuca etkisi. q büyüdükçe zarf daralır, zarf dışı aday alan büyür ve yalancı yokluklar varlık koşullarına yaklaşır; q küçüldükçe zarf genişler ve yalancı yokluklar varlıklardan çevresel olarak uzaklaşır, ayırma kolaylaşır.
- Dikkat. Temel bileşenler erişilebilir alanla sınırlı değil, bütün geçerli hücrelerle kurulur; zarfın kendisi sonra erişilebilir alanla kesişir. Zarf dışı hücrelerin payı çalıştırma kaydına yazılır (
frac_cells_outside_envelope).srestratejisi bu iki alanı kullanmaz; payı her zaman 0,05'tir.
3.3.6 k-means classes
- Ne işe yarar. Geçerli hücreler standartlaştırılmış çevre uzayında
ksınıfa ayrılır (scikit-learnKMeans,n_init=3; 50 000'den çok hücre varsa model 50 000 hücrelik rastgele alt örnekle kurulur, bütün hücreler sonra sınıflanır). Varlıklar en yakın sınıf merkezine atanır. Varlık içermeyen sınıflar yalancı yokluk kaynağıdır ve her biri aynı toplam ağırlığı alır (katmanlı çekiliş). Bütün sınıflarda varlık varsa sınıf ağırlığı 1/(1+n_{\text{varlık}}) olur ve uyarı yazılır (sdm_sampling.py:245-288). - Ne zaman, nasıl ayarlanır. Varsayılan 5. Çok çeşitli bir çalışma alanında sınıf sayısını artırmak varlıksız sınıf bulmayı kolaylaştırır.
- Sonuca etkisi. Eşit sınıf ağırlığı, küçük ama çevresel olarak farklı sınıfların yalancı yokluklarda fazla temsil edilmesine yol açar; çevresel çeşitlilik dengelenir, ama coğrafi dağılım değişir.
- Dikkat. Sınıflar bütün geçerli hücrelerle kurulur; varlıksız sınıfların hepsi erişilebilir alanın dışında kalırsa çalıştırma "No candidate cell has a positive sampling weight" iletisiyle durur (
sdm_core.py:2281-2285). k-ortalamaların tohumu çalıştırma tohumundan türetilir.
3.4 Kendi yokluk kayıtlarınız: Own Absences
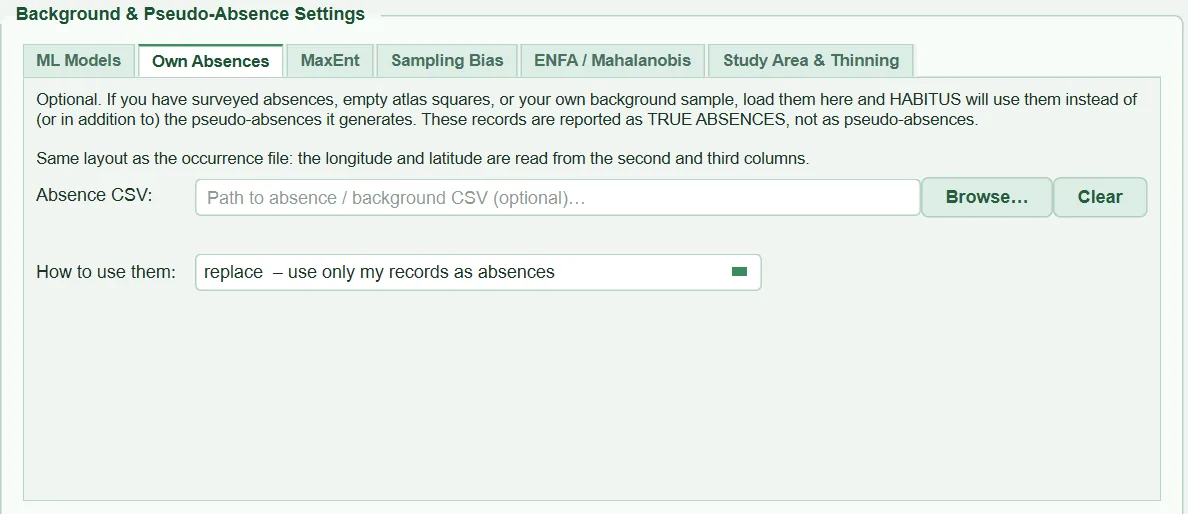
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Absence CSV: + Browse… / Clear |
Gözlenmiş yokluk (ya da kendi arka plan) kayıtları; seçilince kayıt sayısı ve okunacak sütunlar önizlenir | boş | CSV | tabs/tab_data.py:478-491, 1162-1181 |
How to use them: |
Kayıtların yalancı yoklukların yerine mi yanına mı konacağı | replace |
replace – use only my records as absences / augment – my records plus generated pseudo-absences |
tabs/tab_data.py:493-507 |
3.4.1 Absence CSV ve sütunlar
- Ne işe yarar. Dosya, kayıt dosyasıyla aynı okuyucuyla okunur (ayırıcı ve ondalık sezgisi dahil). Koordinat sütunları şu sırayla aranır (
sdm_core.py:2729-2754): kayıt dosyasındaki boylam/enlem sütun adları bu dosyada da varsa onlar; yoksa adla bulunanlongitude/lat…sütunları; yoksa 2. ve 3. sütun; yalnız iki sütun varsa 1. ve 2. sütun. Boş koordinatlı satırlar sayılarak atılır; raster dışı ya da NoData'ya düşenler "absence record outside extent or on NoData" gerekçesiyle atılır ve kayıp %20'yi aşarsa varlıklardaki gibi açıklayıcı uyarı verilir (sdm_core.py:2770-2797). - Ne zaman, nasıl ayarlanır. Alan taramasında türün bulunmadığı noktalar, boş atlas kareleri ya da aynı yöntemle derlenmiş bir hedef grup arka planı için. Bu kayıtlar raporda ve özette "TRUE absences" diye, yalancı yokluktan ayrı yazılır.
- Sonuca etkisi. Gerçek yoklukla eğitilen model, "türün bulunmadığı yer" bilgisini tahminle değil gözlemle alır; değerlendirme istatistiklerinin anlamı da değişir (yalancı yokluğa göre değil gerçek yokluğa göre ayırma).
- Dikkat. Yokluk kayıtları hücre başına bire indirilmez, seyreltilmez ve bir varlıkla aynı hücreye düşüp düşmedikleri denetlenmez. Dosya verilmiş ama kullanılamıyorsa program sessizce yalancı yokluğa dönmez, durur ("All N user-supplied absence records fall outside the raster extent…",
sdm_core.py:2791-2797).
3.4.2 replace ve augment kipleri
- Ne işe yarar.
replace: Yokluk tarafı yalnız sizin kayıtlarınızdır. Yalancı yokluk üretilmez;ML Models'taki bütün alanlar gri olur, tekrar sayısı 1'e iner, en az mesafe ve erişilebilir alan kayıtlarınıza uygulanmaz (tabs/tab_data.py:535-546,sdm_core.py:3031-3040).augment: Her kümede kayıtlarınız olduğu gibi yer alır, üstünePseudo-absences per repetitionkadar yalancı yokluk çekilir (sdm_core.py:3060-3062). Kümeler arasındaki fark yalnız üretilen kısımdan gelir.
- Ne zaman, nasıl ayarlanır. Kayıtlar gerçek ve kapsamlı bir yokluk taramasından geliyorsa
replace; az sayıdaysa ya da tam bir tarama değil kısmi bir arka plansaaugment. - Sonuca etkisi.
replace'te prevalans sizin varlık/yokluk oranınızdır.augment'te yokluk tarafı büyür, prevalans düşer. - Dikkat.
replacekipinde 20'den az yokluk kaydı varsa "Only N true absence records were supplied and pseudo-absences were switched off…" uyarısı verilir veaugmentönerilir (sdm_core.py:2807-2813). Yokluk kayıtları yalnız iki sınıflı algoritmaların eğitim kümesine girer: MaxEnt kendi arka planını, ENFA kendi arka planını kullanmaya devam eder (§3.5, §3.7).
3.5 MaxEnt arka planı: MaxEnt
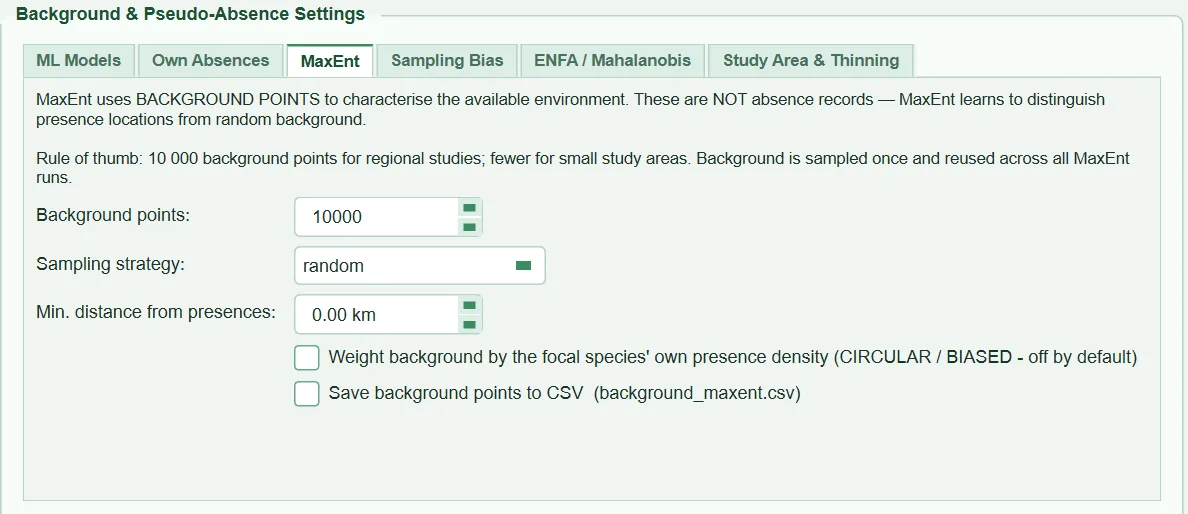
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Background points: |
MaxEnt arka plan noktası sayısı | 10000 | 100 – 200 000 (adım 1000) | tabs/tab_data.py:789-794 |
Sampling strategy: |
Çekiliş kuralı | random |
random, disk |
tabs/tab_data.py:796-801 |
Min. distance from presences: |
disk'te varlıklara en az uzaklık |
0 km | 0 – 500 km | tabs/tab_data.py:803-806 |
Weight background by the focal species' own presence density (CIRCULAR / BIASED - off by default) |
Arka planı odak türün kayıt yoğunluğuyla ağırlıklandırır | kapalı | açık / kapalı | tabs/tab_data.py:808-822, sdm_core.py:3102-3142 |
Save background points to CSV (background_maxent.csv) |
Arka plan koordinatlarını ve öngörücü değerlerini yazar | kapalı | açık / kapalı | tabs/tab_data.py:824-830, 1549-1563 |
3.5.1 Background points ve strateji
- Ne işe yarar. Arka plan, yalancı yokluklardan ayrı ve bir kez çekilir (
sdm_core.py:3144-3166); erişilebilir alan ve (seçildiyse) hedef grup yanlılığı uygulanır. MaxEnt her uydurmada, çapraz doğrulama katlarında da, bu arka planın tamamını kullanır (sdm_core.py:4595-4603).diskyalnızMin. distance0'dan büyükse etkilidir; 0 ikenrandomile aynıdır. - Ne zaman, nasıl ayarlanır. 10 000, Maxent'in yaygın varsayılanıdır (Phillips vd. 2006). Küçük bir erişilebilir alanda geçerli hücre sayısı bundan azsa bütün hücreler kullanılır; arka plan o zaman alanın tam bir sayımıdır (Phillips ve Dudík 2008).
- Sonuca etkisi. Arka planın büyüklüğü, alanın çevresel dağılımının ne kadar iyi temsil edildiğini belirler; 10 000'in üstünde kazanç genellikle küçüktür, süre artar. Arka planın yeri (erişilebilir alan) sayısından çok daha etkilidir (§3.8).
- Dikkat. Arka plan varlık hücrelerini dışlamaz; Maxent'in tanımındaki gibi varlıklar da kullanılabilir çevrenin bir parçasıdır. Özette "Background (MaxEnt): N points" satırı NoData nedeniyle atılanlar düşüldükten sonraki sayıyı verir.
3.5.2 Odak türün kendi yoğunluğuyla ağırlıklandırma (dairesel)
- Ne işe yarar. Açıkken her geçerli hücreye, bütün varlıklara olan uzaklıklarından hesaplanan Gauss çekirdek toplamı (bant genişliği 0,5 birim) ağırlık olarak verilir ve arka plan bu ağırlıkla çekilir (
sdm_core.py:3119-3136). Arka plan böylece varlıkların yoğun olduğu yerlere yığılır. - Ne zaman, nasıl ayarlanır. Önerilmez; kutunun adı ve ipucu bunu açıkça söyler. Odak türün kendi kayıtları hem yanlılığı hem türün gerçek dağılımını taşır; ağırlık bu ikisini ayıramaz ve model, en iyi örneklenmiş alanların çevresini yok saymayı öğrenir. Geçerli bir düzeltme bağımsız bir yanlılık yüzeyi ister (Phillips vd. 2009):
Sampling Biasalt sekmesi. - Sonuca etkisi. Varlık ile arka plan arasındaki karşıtlık azalır; AUC düşer, tepki eğrileri düzleşir.
- Dikkat. Açıldığında her çalıştırmada "MaxEnt background weighted by the focal species' own presence density: this is circular and biased…" uyarısı günlüğe yazılır.
Sampling Bias'ta bir yüzey verilmiş ve MaxEnt'e uygulanıyorsa bu kutu yok sayılır (sdm_core.py:3104-3107). Bant genişliği raster koordinat birimindedir (coğrafi ızgarada 0,5°, yaklaşık 55 km).
3.6 Örnekleme yanlılığı: Sampling Bias
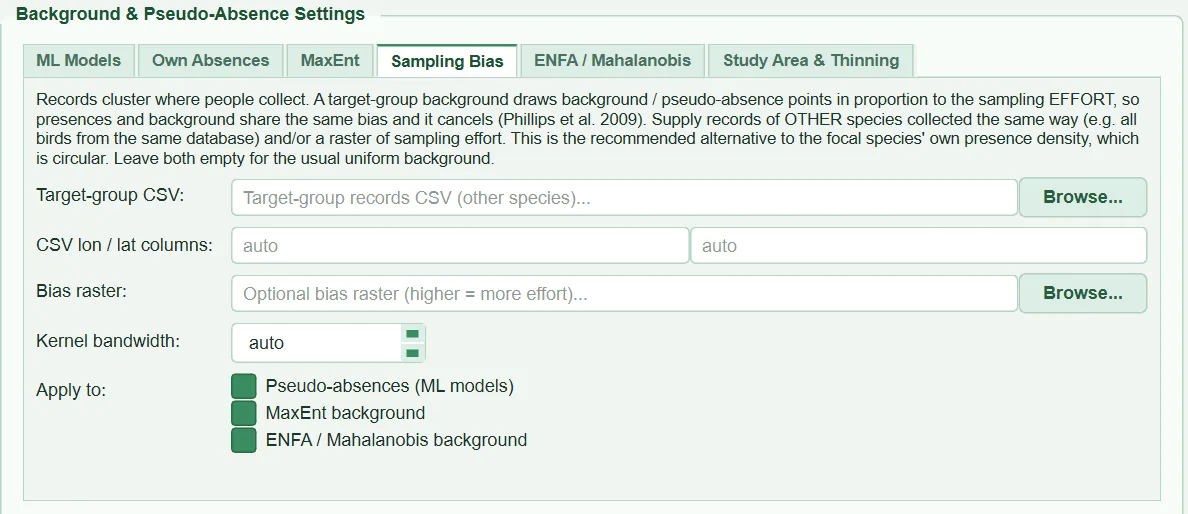
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Target-group CSV: |
Aynı yöntemle toplanmış başka türlerin kayıtları | boş (kapalı) | CSV | tabs/tab_data.py:402-405 |
CSV lon / lat columns: |
Hedef grup CSV'sindeki koordinat sütunları | auto |
sütun adı | tabs/tab_data.py:407-409, sdm_sampling.py:77-93 |
Bias raster: |
Örnekleme çabası rasteri (büyük değer = çok çaba) | boş (kapalı) | .tif .tiff .img .asc |
tabs/tab_data.py:411-416, sdm_sampling.py:161-198 |
Kernel bandwidth: |
Hedef grup yoğunluğunun Gauss düzleştirmesi (sigma) | auto (0) |
0 – 5000 km | tabs/tab_data.py:418-423, sdm_sampling.py:103-158 |
Apply to: |
Yüzeyin uygulanacağı kümeler | üçü de işaretli | Pseudo-absences (ML models), MaxEnt background, ENFA / Mahalanobis background |
tabs/tab_data.py:425-441, sdm_core.py:2991-2993 |
3.6.1 Hedef grup yüzeyi ve yanlılık rasteri
- Ne işe yarar. Kayıtlar insanların topladığı yerlerde (yol, köy, istasyon çevresi) yoğunlaşır. Hedef grup yaklaşımı (Phillips vd. 2009), arka plan ve yalancı yoklukları aynı çabanın izini taşıyan başka türlerin kayıt yoğunluğuyla orantılı çeker; varlık ile arka plan aynı yanlılığı taşıdığı için yanlılık birbirini götürür. HABITUS iki kaynaktan bir ağırlık ızgarası kurar (
sdm_core.py:2332-2397):- Hedef grup CSV'si: kayıtlar hücrelere sayılır ve Gauss filtresiyle düzleştirilir; ızgara en büyük değere bölünür, sıfır yoğunluklu hücrelere 10^{-6} taban ağırlık bırakılır (
sdm_sampling.py:103-158). - Yanlılık rasteri: aynı ızgaradaysa doğrudan okunur, değilse çift doğrusal (bilinear) yöntemle yeniden örneklenir; NaN, NoData ve negatif değerler 0 olur, en büyük değere bölünür (
sdm_sampling.py:161-198). - İkisi birlikte verilirse çarpımları kullanılır. Çekiliş olasılığı hücre ağırlığıyla orantılıdır; ağırlık erişilebilir alan ve strateji kısıtlarıyla birleşir (k-ortalama sınıf ağırlığıyla çarpılır;
sdm_core.py:2272-2289).
- Hedef grup CSV'si: kayıtlar hücrelere sayılır ve Gauss filtresiyle düzleştirilir; ızgara en büyük değere bölünür, sıfır yoğunluklu hücrelere 10^{-6} taban ağırlık bırakılır (
- Ne zaman, nasıl ayarlanır. Örnekleme çabası açıkça dengesizse. Hedef grup, odak türle aynı veri tabanından ve aynı yöntemle toplanmış türler olmalıdır (ör. aynı herbaryumun bütün odunsu bitki kayıtları). Odak türün kendi kayıtları hedef gruba konmamalıdır; bu dairesel olur.
- Sonuca etkisi. Arka plan erişilebilir yerlere kayar; model "kolay ulaşılan" ile "uygun"u daha az karıştırır. Tipik olarak AUC düşer (ayrım zorlaşır), ama harita yollar ve yerleşimler yerine çevresel koşulları izler (Kramer-Schadt vd. 2013).
- Dikkat. Hedef grup koordinatları rasterle aynı koordinat sisteminde olmalıdır; hiçbiri ızgaraya düşmezse çalıştırma durur. 20'den az hedef grup kaydında yoğunluğun çok kaba olacağı, yüzeyin hücrelerin %0,1'inden azında toplandığında arka planın çoğunun oradan geleceği uyarısı yazılır (
sdm_core.py:2352-2393). Hatalı dosya çalıştırmayı durdurur; program sessizce düzgün örneklemeye dönmez. Yanlılık rasteri koordinat sistemi bildirmiyorsa öngörücülerle aynı sistemde olduğu varsayılır ve uyarılır; ızgarası farklı ve CRS'si yoksa hizalanamaz ve hata verir. Hiçbir yüzey verilmediğinde rapora "Sampling bias: not corrected" notu düşülür (sdm_core.py:1358-1363,2988-2990).
3.6.2 Kernel bandwidth
- Ne işe yarar. Gauss düzleştirmesinin standart sapmasıdır (km). Coğrafi ızgarada km dereceye çevrilir; boylam yönünde kayıtların ortalama enleminin kosinüsüyle düzeltilir. Projeksiyonlu ızgarada km, harita biriminin metre karşılığıyla çevrilir.
auto(0) iken her eksen için normal başvuru kuralı kullanılır: h = 1{,}06\,\min(s,\ \mathrm{IQR}/1{,}34)\,n^{-1/5} (MASSbandwidth.nrd/4,kde2d'deki gibi). Sigma hiçbir zaman bir hücreden küçük olmaz (sdm_sampling.py:136-154). - Ne zaman, nasıl ayarlanır. Hedef grup kayıtları seyrekse genişletilir; çaba yolların hemen çevresinde toplanıyorsa birkaç hücre düzeyinde tutulur.
- Sonuca etkisi. Küçük bant genişliği yüzeyi kayıt noktalarına yapıştırır, arka plan neredeyse yalnız kayıtlı hücrelerden gelir; büyük bant genişliği yüzeyi düzleştirir ve düzgün örneklemeye yaklaştırır.
- Dikkat. Kullanılan bant genişliği çalıştırma kaydına yazılır (
auto (nrd)ya da km).
3.6.3 Apply to
Yüzey yalnız işaretli kümelere uygulanır (sdm_core.py:2991-2993). Üçünü birden işaretlemek, bütün algoritmaların aynı yanlılık düzeltmesini görmesini sağlar ve algoritmalar arası karşılaştırmayı tutarlı kılar. Yalnız birini işaretlemek, düzeltmenin etkisini tek bir algoritma ailesinde sınamak için yararlıdır.
3.7 ENFA arka planı: ENFA / Mahalanobis
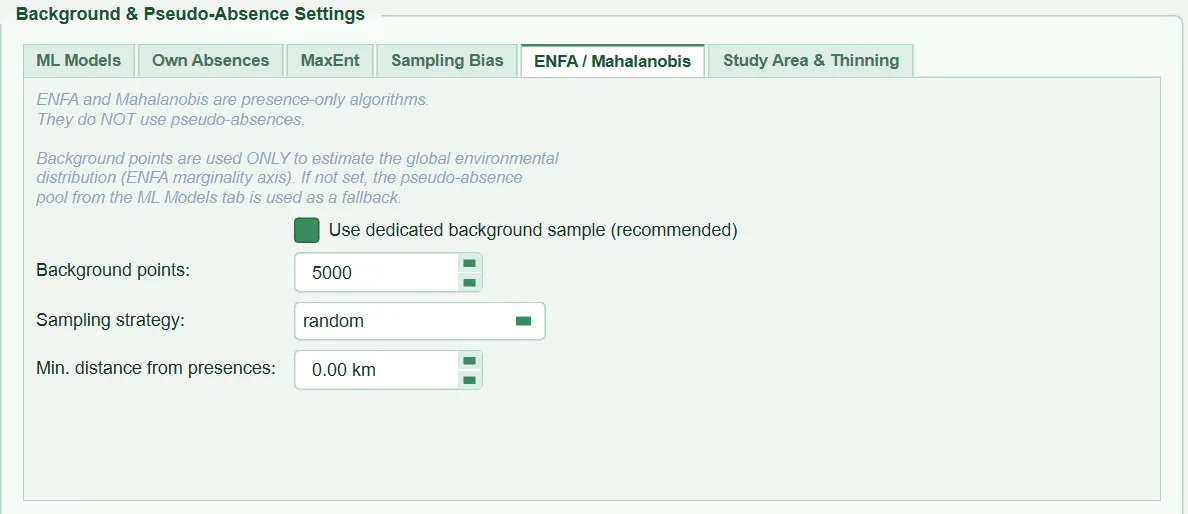
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Use dedicated background sample (recommended) |
ENFA için ayrı arka plan çeker | açık | açık / kapalı | tabs/tab_data.py:858-864 |
Background points: |
Arka plan nokta sayısı | 5000 | 100 – 100 000 (adım 1000) | tabs/tab_data.py:866-872 |
Sampling strategy: |
Çekiliş kuralı | random |
random, disk |
tabs/tab_data.py:874-879 |
Min. distance from presences: |
disk'te en az uzaklık |
0 km | 0 – 500 km | tabs/tab_data.py:881-885 |
- Ne işe yarar. ENFA, türün koşullarını çalışma alanının "küresel" koşullarıyla karşılaştırır: küresel ortalama ve kovaryans bu arka plandan hesaplanır (
sdm_core.py:4079-4092). Arka plan erişilebilir alan içinden ve (işaretliyse) yanlılık yüzeyiyle çekilir (sdm_core.py:3176-3199). Kutu kapalıysa ENFA küresel istatistikleri eğitim satırlarından (varlıklar + yalancı yokluklar) hesaplar. - Ne zaman, nasıl ayarlanır. Açık bırakılması önerilir: küresel çevre, yalancı yokluk stratejisinin (ör.
disk,sre) bozduğu bir örnekten değil, alanın düzgün bir örneğinden tahmin edilmelidir. İpucu 5000–10 000 noktayı yeterli bulur. - Sonuca etkisi. ENFA'nın marjinallik (türün ortalamasının küresel ortalamadan sapması) ve özelleşme eksenleri bu örneğe göre ölçülür; erişilebilir alanı daraltmak marjinalliği küçültür.
- Dikkat. Kodda bu arka planı yalnız ENFA kullanır; Mahalanobis uzaklığı yöntemi yalnız varlıkların ortalamasını ve kovaryansını kullanır (
sdm_core.py:4207-4230), bu sekmenin ayarları onu değiştirmez. Arka planın sütunları modeldeki değişkenlerle tam eşleşmezse ENFA eğitim satırlarına döner. Strateji kutusundadiskseçmek yalnız en az mesafeyi devreye sokar.
3.8 Erişilebilir alan: Study Area & Thinning (üst yarı)
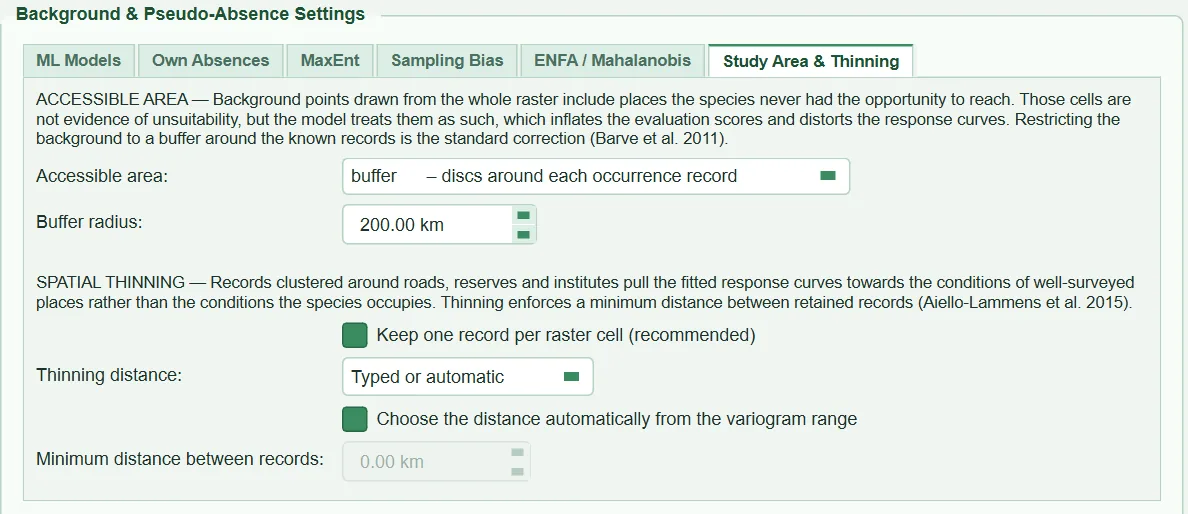
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Accessible area: |
Arka plan/yalancı yokluk alanının kuruluş yöntemi | buffer |
buffer – discs around each occurrence record, mcp_buffer – buffered minimum convex polygon, polygon – my own calibration area layer, none – sample the whole raster extent |
tabs/tab_data.py:644-666 |
Buffer radius: |
Tampon yarıçapı; polygon'da çokgenlerin çevresine eklenen tampon |
200 km | 0 – 5000 km (adım 50) | tabs/tab_data.py:668-674, 609-618 |
Calibration layer: + Browse… |
Kalibrasyon çokgen katmanı (yalnız polygon'da görünür) |
boş | .shp .gpkg .geojson .json .kml .gml |
tabs/tab_data.py:677-691 |
Keep only the polygons containing an occurrence record |
Yalnız kayıt içeren çokgenleri tutar (yalnız polygon'da) |
açık | açık / kapalı | tabs/tab_data.py:693-701 |
3.8.1 Neden erişilebilir alan
Bir tür, uygun olduğu halde hiç ulaşamadığı yerlerde bulunmaz. Bu hücreler "uygun değil" kanıtı değildir; ama arka plan ya da yalancı yokluk olarak modele girdiklerinde model onları öyle öğrenir (Barve vd. 2011). Erişilebilir alan (BAM çerçevesindeki M), arka planın çekileceği alanı türün ulaşabileceği bölgeyle sınırlar. Kapsamı geniş tutmak, varlıklardan çok farklı koşullar içeren hücreleri arka plana katar; ayrım kolaylaşır ve AUC yapay olarak yükselir (Lobo vd. 2008; VanDerWal vd. 2009). Maske üç kümeye de (yalancı yokluk, MaxEnt, ENFA) uygulanır; kullanıcının yokluk kayıtlarına uygulanmaz. Harita yine bütün kapsam (ya da çalışma sınırı) için üretilir.
3.8.2 Accessible area yöntemleri
- Ne işe yarar.
buffer: Her varlığın hücresindenBuffer radiusuzaklıktaki bütün hücreler (sdm_spatial.py:943-1062). Uzaklık, hücre boyunu km'ye çeviren anizotropik Öklid uzaklık dönüşümüyle (distance_transform_edt) hesaplanır; coğrafi ızgarada hücre genişliği kayıtların ortalama enleminin kosinüsüyle küçültülür.mcp_buffer: Varlık hücrelerinin dışbükey zarfı (en küçük dışbükey çokgen) doldurulur, sonra aynı tampon eklenir. Kayıtlar bir doğru üzerindeyse (nehir, kıyı) zarf, en uzak iki kayıt arasındaki doğru parçasıdır.polygon: Kullanıcının kalibrasyon katmanı (§3.8.4).none: Kısıt yok; bütün geçerli hücreler.
- Ne zaman, nasıl ayarlanır. Rojas-Soto vd. (2024) yedi kalibrasyon alanı yöntemini 31 tür üzerinde karşılaştırmış ve biyocoğrafik birimleri (ekolojik bölge, havza, biyocoğrafik il) kullanan yöntemi önermiştir; HABITUS'taki karşılığı
polygon+Keep only the polygons containing an occurrence record'dur. Tampon yöntemleri güvenli ve basittir ama engelleri (dağ sırası, deniz) temsil edemez.mcp_bufferkesintisiz yayılışlı türe uygundur; parçalı yayılışta zarf boşluğu da kapsar.noneyalnız rasterler zaten ilgi alanına göre kesilmişse seçilmelidir. - Sonuca etkisi. Alan daraldıkça arka plan varlık koşullarına benzer; AUC/TSS düşer ama daha dürüst olur, tepki eğrileri M içindeki gradyanı tanımlar. Örnek koşuda 200 km tampon raster kapsamının %40,0'ını tutmuştur.
- Dikkat. Tampon, seyreltilmiş kayıtlardan kurulur (
sdm_core.py:2971).buffervemcp_buffer'da yarıçap 0 ise kısıt uygulanmaz. Tampon kapsamın %97'sinden fazlasını kapsıyorsa "The accessible-area buffer covers almost the whole raster extent, so it is not constraining anything." uyarısı verilir (sdm_core.py:2694-2699). Alanda istenen nokta sayısından az hücre varsa bütün hücreler kullanılır, uyarı yazılır ve çekiliş kapsamın tamamına genişletilmez (sdm_core.py:2166-2203). Maske kurulamazsa program bütün kapsama dönmez, durur.
3.8.3 Buffer radius
- Ne işe yarar.
buffervemcp_buffer'da M'nin yarıçapı;polygon'da seçilen çokgenlerin çevresine eklenen tampon (sdm_spatial.py:1260-1299). - Ne zaman, nasıl ayarlanır. Arayüz ipucunun dediği gibi türün yayılma yeteneğinden ve yayılışın yaşından seçilmelidir, raster boyutundan değil. Yayılımı sınırlı türlerde onlarca km, uzun mesafe yayılan türlerde yüzlerce km.
- Sonuca etkisi. Yarıçap büyüdükçe arka plan çevresel olarak çeşitlenir, AUC yükselir, prevalans değişmez (nokta sayısı aynıdır) ama yalancı yokluklar varlıklardan uzaklaşır.
- Dikkat.
polygonkipine geçildiğinde alan varsayılan 200 km değerini korur; çokgenleri çizildiği gibi kullanmak için değeri 0'a indirmek gerekir (ipucu: "Leave it at zero to use the polygon boundaries exactly as drawn"). Örnek koşubuffer200 km ile çalıştırılmıştır.
3.8.4 Kalibrasyon katmanı ve "kayıt içerenler"
- Ne işe yarar. Katman pyogrio ile okunur; yalnız çokgenler kullanılır. Koordinat sistemi rasterlerden farklıysa yeniden projekte edilir; katman sistem bildirmiyorsa aynı olduğu varsayılır ve uyarılır (
sdm_spatial.py:1194-1225).Keep only the polygons containing an occurrence recordaçıksa yalnız en az bir varlığın düştüğü çokgenler tutulur (biyocoğrafik birim yöntemi); kapalıysa katmandaki bütün çokgenler kullanılır. İsteğe bağlı tampon eklenir ve çokgenler ızgarayaall_touched=Trueile (çokgene değen her hücre içeride) yakılır (sdm_spatial.py:1234-1321). Özette "Calibration area: K of N polygons… X% of the raster extent" yazılır. - Ne zaman, nasıl ayarlanır. Bütün bir ekolojik bölge katmanını kesmeden yükleyip kutuyu açık bırakmak en pratik yoldur. Katman yalnız çalışma alanınızı içeriyorsa kutu kapatılır.
- Sonuca etkisi. M, biyocoğrafik sınırları izler; tampon yöntemlerinin aşamadığı engeller hesaba girer.
- Dikkat. Hiçbir çokgen kayıt içermiyorsa çalıştırma durur. Kutu kapalıyken hiçbir varlık çokgenlerin içinde değilse "Calibration polygon: NONE of the N presence records lies inside the polygon(s)…", varlıkların %80'inden azı içerdeyse "only K of N presence records… lie inside" uyarısı verilir (
sdm_core.py:2644-2672).polygonseçilip katman verilmezse çalıştırma durur.
3.8.5 accessible_area.tif
Erişilebilir alan tanımlıysa maske türün çıktı klasörüne accessible_area.tif olarak yazılır (1 = içeride, 0 = dışarıda, sıkıştırılmış uint8; tabs/tab_data.py:1536-1548, sdm_spatial.py:1065-1075). ⑥ Range Change, değişimi bu alanın içinde ayrıca raporlamak için bu dosyayı kullanır (Bölüm 9). none seçiliyse dosya yazılmaz.
3.9 Kayıtların seyreltilmesi: Study Area & Thinning (alt yarı)
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Keep one record per raster cell (recommended) |
Her öngörücü hücresinde bir kayıt | açık | açık / kapalı | tabs/tab_data.py:722-731 (Bölüm 2.8.3) |
Thinning distance: |
Seyreltme mesafesinin kaynağı | Typed or automatic |
Typed or automatic, One cell, 10 km (Boria 2014) |
tabs/tab_data.py:733-743 |
Choose the distance automatically from the variogram range |
Mesafeyi variogram aralığından seçer (yalnız Typed or automatic'te) |
kapalı | açık / kapalı | tabs/tab_data.py:745-751 |
Minimum distance between records: |
Elle girilen mesafe (yalnız Typed or automatic ve otomatik kapalıyken) |
0 km (seyreltme yok) | 0 – 500 km | tabs/tab_data.py:753-765 |
3.9.1 Seyreltmenin işleyişi
- Ne işe yarar. Yollar, koruma alanları ve araştırma kurumları çevresinde kümelenmiş kayıtlar, tepki eğrilerini türün yaşadığı koşullardan çok iyi örneklenmiş yerlerin koşullarına çeker (Aiello-Lammens vd. 2015). Seyreltme, tutulan iki kayıt arasında en az bir mesafe zorunlu kılar. Algoritma açgözlüdür: kayıtlar tohumlu rastgele bir sırayla gezilir, tutulmuş bir kayda mesafeden daha yakın olan atılır; üç farklı sırayla denenir ve en çok kayıt tutan sonuç seçilir (
sdm_spatial.py:888-937,sdm_core.py:2536). Mesafeler büyük daire mesafesidir. - Ne zaman, nasıl ayarlanır. Seyreltme, hücre başına bir kuraldan sonra uygulanır (Bölüm 2.8.1). Örnekleme açıkça kümeliyse açılır; kayıtlar zaten seyrek ve düzenliyse kapalı kalabilir.
- Sonuca etkisi. Kayıt sayısı düşer, prevalans düşer, kalan kayıtlar coğrafi olarak daha düzgün dağılır. Boria vd. (2014) seyreltmenin aşırı uyumu azaltıp bağımsız değerlendirmede performansı artırdığını göstermiştir. Atılan kayıtlar "spatially thinned" gerekçesiyle listelenir; kullanılan mesafe ve nasıl seçildiği günlüğe, özete, rapora ve çalıştırma kaydına (
thinning.how_chosen) yazılır. - Dikkat. spThin varsayılan olarak çok sayıda rastgele tekrardan en büyük kümeyi seçer; HABITUS'un 3 tekrarı bu sonuca yaklaşır ama en büyük kümeyi garanti etmez. Seyreltme sonrası 10'dan az kayıt kalırsa uyarı verilir. Elle girilen mesafe bir hücreden küçükse bunun yalnız komşu hücrelerdeki kayıtları ayırdığı bildirilir (
sdm_core.py:2526-2534).
3.9.2 Ön ayarlar: One cell ve 10 km
- Ne işe yarar.
One cell, mesafeyi bir öngörücü hücresinin kenarına eşitler: coğrafi ızgarada hücre yüksekliği × 110,57 km ile hücre genişliği × 111,32 km × cos(ortalama enlem) değerlerinin ortalaması (sdm_core.py:2554-2569).10 km, Boria vd. (2014)'ün kullandığı ve çok kopyalanan sabit mesafedir (sdm_core.py:2478-2483). Ön ayar seçilince otomatik kutu ve elle girilen mesafe gri olur. - Ne zaman, nasıl ayarlanır.
One cell, komşu hücrelerdeki kayıtları ayırmak için öngörücü çözünürlüğüne bağlı en küçük anlamlı mesafedir; 2,5′ verisinde yaklaşık 4 km'dir.10 kmbir gelenektir, her tür ve çözünürlük için kural değildir. - Sonuca etkisi. İkisi de genellikle otomatik mesafeden küçüktür; daha az kayıt atar.
- Dikkat. Ön ayarlar en az %50 kayıt koruma kuralına tabi değildir.
3.9.3 Otomatik mesafe: variogram aralığının yarısı ve azaltma kuralı
- Ne işe yarar. Program her çalıştırmada, seyreltme kapalı olsa bile, öngörücülerin mekânsal özilişki aralığını kayıt noktalarından tahmin eder (
sdm_spatial.py:166-281): en çok 1500 kayıt alt örneklenir; her öngörücü için yönsüz deneysel yarı-variogram, en büyük çift uzaklığının yarısına kadar 15 aralıkta hesaplanır; eşik (sill) dış üçte bir aralıkların ortanca yarı-varyansı, aralık (range) bu eşiğin %95'ine ilk ulaşılan uzaklıktır; değişkenlerin ortancası alınır. 20'den az nokta ya da kullanılabilir variogram yoksa aralık, en büyük uzaklığın onda biri sayılır (fallback_extent). Otomatik seyreltme açıkken mesafe aralığın yarısıdır; bu mesafe kayıtların yarısından fazlasını (THIN_MIN_RETAIN = 0.5) atıyorsa mesafe en çok 8 kez yarıya indirilir, en az %50'yi koruyan ilk mesafe kullanılır (sdm_core.py:2484-2522,2571-2594). - Ne zaman, nasıl ayarlanır. Türe özgü bir mesafe gerekçesi yoksa savunulabilir bir başlangıçtır; aynı aralık ③ Models'ta mekânsal blok boyu olarak kullanıldığı için seyreltme ile blok boyu birbiriyle tutarlı olur (Roberts vd. 2017'nin ve blockCV'nin [Valavi vd. 2019] mantığı).
- Sonuca etkisi. Örnek koşuda aralık 151,5 km bulunmuş, yarısı 75,7 km kayıtların yarısından fazlasını atacağı için 37,9 → 18,9 → 9,5 → 4,7 km'ye inilmiş; 4,7 km'de 221 kaydın 143'ü (%65) korunmuştur (çalıştırma kaydı: "auto (half the variogram range, reduced to keep 65% of records)").
- Dikkat. Bölgesel bir eğilimin baskın olduğu iklim katmanlarında aralık çok büyük çıkar ve azaltma kuralı mesafeyi neredeyse hücre boyuna indirir; bu durumda mesafe artık özilişkiyi değil yalnız kümelenmeyi giderir. Her aday mesafe kayıtların yarısından fazlasını atıyorsa seyreltme yapılmaz ve uyarı verilir; aralık hiç hesaplanamazsa yine yapılmaz ve "Type a thinning distance in ① Data" denir (
sdm_core.py:2495-2522). Elle girilen mesafe için %50 koruma sınırı yoktur.
3.10 Çıktılar ve sonraki adıma geçenler
pa_datasets: her biri (öngörücü tablosu, 0/1 etiket, koordinatlar) olanPA repetitionskadar küme; ③ Models'a geçer.background_Xve koordinatları: MaxEnt arka planı; istenmişsebackground_maxent.csv(sütunlarlongitude, latitude, <değişkenler>).background_ponly: ENFA arka planı.accessible_area.tifve erişilebilir alan bilgisi; seyreltme bilgisi; özilişki aralığı (③'te blok boyu).- Çalıştırma kaydının
background,study_areavethinningbölümleri: yokluk kaynağı (pseudo,user,user+pseudo), strateji ve ayrıntıları (aday hücre sayısı, zarf dışı pay, k-ortalama sınıf sayımları), arka plan sayıları, hedef grup bilgisi, erişilebilir alan yöntemi ve payı, kalibrasyon çokgenleri, seyreltme mesafesi ve nasıl seçildiği. Örnek koşuda varsayılan bırakılan ayarlar ayrıcadefaults_left_unchangedaltında listelenir.
3.11 Uzman soruları
S1. HABITUS'taki random yalancı yokluk çekilişi biomod2'deki random ile aynı mı?
Cevap: Kural aynıdır: geçerli hücrelerden eşit olasılıklı, yinelemesiz çekiliş (sdm_core.py:2301-2302). İki fark vardır. Birincisi, HABITUS varsayılan olarak çekilişi 200 km'lik erişilebilir alanla sınırlar; biomod2'de böyle bir varsayılan yoktur, kapsamın tamamı kullanılır. İkincisi, yalancı yokluklar hücre merkezlerinden çekilir ve aynı küme içinde bir hücre bir kez seçilir. Varlık hücreleri random'da dışlanmaz; bir yalancı yokluk bir varlık hücresine düşebilir.
S2. Yalancı yoklukları varlıklardan uzaklaştıran stratejiler neden skorları şişirir?
Cevap: AUC ve TSS, modelin varlık ile yokluğu ayırma becerisini ölçer. Yalancı yokluklar varlıklardan coğrafi (disk) ya da çevresel (sre, env_const) olarak uzaklaştırıldığında ayrım, verinin kuruluşu gereği kolaylaşır; ölçülen beceri modelden çok örnekleme tasarımından gelir (VanDerWal vd. 2009; Barbet-Massin vd. 2012). Aynı veride stratejileri karşılaştırırken skorların değil, bağımsız bir doğrulama verisiyle (⑦ Validation) elde edilen performansın karşılaştırılması gerekir.
S3. Erişilebilir alan tamponu neden 200 km ve bu değer nereden geliyor?
Cevap: 200 km bir başlangıç değeridir (tabs/tab_data.py:669, sdm_core.py:1400); kodda türe özgü bir gerekçesi yoktur. Arayüz ipucu yarıçapın türün yayılma yeteneğinden ve yayılışın yaşından seçilmesini ister. Barve vd. (2011) M'nin tür ve soru özelinde tanımlanması gerektiğini vurgular; Rojas-Soto vd. (2024) biyocoğrafik birimlere dayalı kalibrasyon alanını önerir (HABITUS'ta polygon). Değer her çalıştırmada kayda yazılır ve raporlanmalıdır.
S4. Tampon uzaklığı jeodezik mi hesaplanıyor?
Cevap: Hayır, yaklaşık hesaplanır. buffer ve mcp_buffer, hücre yüksekliğini sabit, genişliğini kayıtların ortalama enleminin kosinüsüyle küçültülmüş kabul eden anizotropik Öklid uzaklık dönüşümü kullanır (sdm_spatial.py:1022-1062). Enlem açıklığı küçük alanlarda hata küçüktür; kuzey-güney yönünde binlerce km uzanan bir yayılışta tamponun doğu-batı genişliği uçlarda sapar. Seyreltme ve en az mesafe ise haversine ile hesaplanır.
S5. Kullanıcının yokluk kayıtları MaxEnt'e de giriyor mu?
Cevap: Hayır. Own Absences kayıtları yalnız pa_datasets'in yokluk tarafına girer (sdm_core.py:3035-3082). MaxEnt kendi arka planını kullanır (sdm_core.py:4595-4598); arka plan yokluk sayılmaz. ENFA da kendi arka planını kullanır. Gerçek yoklukları MaxEnt'e "arka plan" olarak vermek isteyen kullanıcı için kodda bir yol yoktur.
S6. Hedef grup yüzeyinin bant genişliği nasıl seçiliyor; R'deki karşılığı nedir?
Cevap: auto'da her eksen için 1{,}06\,\min(s,\ \mathrm{IQR}/1{,}34)\,n^{-1/5} kullanılır; bu, MASS bandwidth.nrd değerinin dörtte biridir ve kde2d'nin içte kullandığı sigma ile aynıdır (sdm_sampling.py:143-151). Yoğunluk hücre sayımlarının Gauss filtresiyle düzleştirilmesiyle elde edilir; sınırdan dışarı kütle kaybolur (mode="constant"). Yüzey en büyük değere ölçeklenir ve 10^{-6} ile tabanlanır, böylece hiç hedef kaydı olmayan hücreler çok düşük olasılıkla da olsa seçilebilir. Kramer-Schadt vd. (2013) ve Phillips vd. (2009) bu yaklaşımın gerekçesini verir.
S7. Otomatik seyreltme mesafesi neden variogram aralığının yarısı, ve neden azaltılıyor?
Cevap: Aralık, öngörücülerdeki özilişkinin kaybolduğu uzaklıktır; yarısı kayıtlar arasındaki tekrar eden çevre bilgisini azaltmak için yaygın bir başlangıçtır ve aynı aralık blok boyunu belirlediği için iki karar tutarlı olur (sdm_core.py:2433-2442). Bölgesel eğilimi güçlü iklim katmanlarında aralık yüzlerce km çıkar ve yarısı kayıtların çoğunu atar; seyreltmenin amacı veri kümesini değil yinelemeyi gidermek olduğu için mesafe, kayıtların en az %50'si kalana kadar yarıya indirilir (sdm_core.py:2571-2594). Örnek koşuda 75,7 km'den 4,7 km'ye inilmiştir.
S8. HABITUS'un seyreltmesi spThin ile aynı sonucu verir mi?
Cevap: Kural aynıdır (tutulan iki kayıt arasında en az mesafe, büyük daire uzaklığı), algoritma farklıdır. spThin thin() çok sayıda rastgele tekrar yapar ve en çok kayıt tutan kümeyi seçer (Aiello-Lammens vd. 2015); HABITUS 3 tekrarlı açgözlü seçim yapar (sdm_spatial.py:888-937), otomatik mesafe aramasında ise tek tekrar. Tutulan kayıt sayısı spThin'in en iyisinden biraz az olabilir; kesin eşitlik sınanmamıştır.
S9. sre ile env_const (bioclim) arasında ne fark var?
Cevap: İkisi aynı hesabı (_compute_sre_mask) kullanır: her değişkende varlıkların [q,\,1-q] aralığı, bütün değişkenlerde aralıkta olan hücre zarf içidir (sdm_core.py:2079-2119). sre'de q sabit 0,05'tir (sdm_core.py:3010-3011); env_const + bioclim'de Envelope tail trim ile ayarlanır. 4'ten az varlıkta değeri olan değişkenler zarfa katılmaz. env_const + pca ise iki temel bileşen üzerinde çalışır ve değişken sayısı arttıkça zarfın anlamsızlaşmasını önler.
S10. Arka plan ve yalancı yoklukların hepsi aynı tohumdan mı geliyor; tekrarlar birbirinden bağımsız mı?
Cevap: DataFormatter tek bir tohumlu üreteç kurar ve bütün çekilişler sırayla ondan yapılır (sdm_core.py:1505). Her yalancı yokluk kümesi üretecin sonraki durumundan çekildiği için kümeler birbirinden farklıdır ve aynı tohumla aynı sırada yeniden üretilir. Tekrar sayısını değiştirmek, sonra gelen MaxEnt ve ENFA arka planlarını da değiştirir, çünkü üreteç durumu ilerlemiş olur.
S11. Erişilebilir alan küçük ve hücre sayısı istenen arka plan sayısından az olursa ne olur?
Cevap: Alandaki bütün geçerli hücreler kullanılır, istenenden az nokta çekilir ve bir uyarı yazılır (sdm_core.py:2190-2203); hangi istekte kaç hücre bulunduğu çalıştırma kaydına (cells_short_of_request) eklenir. Arka plan bu durumda alanın tam sayımıdır (Phillips ve Dudík 2008). Çekiliş kapsamın tamamına genişletilmez; bu, kullanıcının tanımladığı M'yi korur.
S12. Bu sekmedeki ayarlardan sonucu en çok etkileyenler hangileri? Cevap: Örnek veriyle sistematik bir duyarlılık analizi yapılmamıştır. Kodun yapısından ve kaynaklardan şu sıra beklenir: (1) erişilebilir alan yöntemi ve yarıçapı (arka planın çevresel kapsamını belirler; Barve vd. 2011), (2) yalancı yokluk stratejisi (ayrımın zorluğunu belirler; Barbet-Massin vd. 2012), (3) yanlılık düzeltmesi (haritanın yanlılığı mı çevreyi mi izlediğini belirler; Phillips vd. 2009), (4) seyreltme ve hücre başına bir kural (kullanılan kayıt sayısını belirler; örnek koşuda 626'dan 143'e). Yalancı yokluk ve arka plan sayıları, makul aralıkta, daha az etkilidir.
3.12 Sık hatalar ve tuzaklar
polygonkipindeBuffer radius'u 200 km'de bırakmak: çokgenler 200 km genişletilir. Çokgenleri olduğu gibi kullanmak için 0 girin.- Rasterler zaten çalışma alanına kesilmişken tampon da kullanmak gereksiz değildir; ama tampon kapsamın %97'sinden fazlasını kaplıyorsa program bunu bildirir.
geo_constya dadiskstratejisini 0 km ile kullanmak: hiçbir şey dışlanmaz.- Odak türün kendi kayıtlarını
Target-group CSVolarak vermek ya da MaxEnt'teki dairesel kutuyu açmak: yanlılık düzeltilmez, pekiştirilir. - Hedef grup CSV'sini rasterlerden farklı koordinat sisteminde vermek: "None of the N target-group points falls inside the raster extent."
- Az sayıda gerçek yoklukla
replace: eşiğe bağlı bütün istatistikler kararsızlaşır;augmentkullanın. - Stratejiler arasında AUC/TSS karşılaştırıp en yükseği seçmek: skor farkı tasarımdan gelir (S2).
- Otomatik seyreltmenin her türde özilişkiyi gidereceğini sanmak: azaltma kuralı mesafeyi çok küçültebilir; kullanılan mesafeyi özetten okuyun.
- ENFA / Mahalanobis sekmesinin Mahalanobis'i de değiştirdiğini sanmak: arka planı yalnız ENFA kullanır.
3.13 Kaynaklar
Aiello-Lammens, M.E., Boria, R.A., Radosavljevic, A., Vilela, B., Anderson, R.P., 2015. spThin: an R package for spatial thinning of species occurrence records for use in ecological niche models. Ecography 38, 541–545. https://doi.org/10.1111/ecog.01132
Barbet-Massin, M., Jiguet, F., Albert, C.H., Thuiller, W., 2012. Selecting pseudo-absences for species distribution models: how, where and how many? Methods in Ecology and Evolution 3, 327–338. https://doi.org/10.1111/j.2041-210X.2011.00172.x
Barve, N., Barve, V., Jiménez-Valverde, A., Lira-Noriega, A., Maher, S.P., Peterson, A.T., Soberón, J., Villalobos, F., 2011. The crucial role of the accessible area in ecological niche modeling and species distribution modeling. Ecological Modelling 222, 1810–1819. https://doi.org/10.1016/j.ecolmodel.2011.02.011
Boria, R.A., Olson, L.E., Goodman, S.M., Anderson, R.P., 2014. Spatial filtering to reduce sampling bias can improve the performance of ecological niche models. Ecological Modelling 275, 73–77. https://doi.org/10.1016/j.ecolmodel.2013.12.012
Kramer-Schadt, S., Niedballa, J., Pilgrim, J.D., Schröder, B., Lindenborn, J., Reinfelder, V., Stillfried, M., Heckmann, I., Scharf, A.K., Augeri, D.M., Cheyne, S.M., Hearn, A.J., Ross, J., Macdonald, D.W., Mathai, J., Eaton, J., Marshall, A.J., Semiadi, G., Rustam, R., Bernard, H., Alfred, R., Samejima, H., Duckworth, J.W., Breitenmoser-Wuersten, C., Belant, J.L., Hofer, H., Wilting, A., 2013. The importance of correcting for sampling bias in MaxEnt species distribution models. Diversity and Distributions 19, 1366–1379. https://doi.org/10.1111/ddi.12096
Lobo, J.M., Jiménez-Valverde, A., Real, R., 2008. AUC: a misleading measure of the performance of predictive distribution models. Global Ecology and Biogeography 17, 145–151. https://doi.org/10.1111/j.1466-8238.2007.00358.x
Phillips, S.J., Anderson, R.P., Schapire, R.E., 2006. Maximum entropy modeling of species geographic distributions. Ecological Modelling 190, 231–259. https://doi.org/10.1016/j.ecolmodel.2005.03.026
Phillips, S.J., Dudík, M., 2008. Modeling of species distributions with Maxent: new extensions and a comprehensive evaluation. Ecography 31, 161–175. https://doi.org/10.1111/j.0906-7590.2008.5203.x
Phillips, S.J., Dudík, M., Elith, J., Graham, C.H., Lehmann, A., Leathwick, J., Ferrier, S., 2009. Sample selection bias and presence-only distribution models: implications for background and pseudo-absence data. Ecological Applications 19, 181–197. https://doi.org/10.1890/07-2153.1
Roberts, D.R., Bahn, V., Ciuti, S., Boyce, M.S., Elith, J., Guillera-Arroita, G., Hauenstein, S., Lahoz-Monfort, J.J., Schröder, B., Thuiller, W., Warton, D.I., Wintle, B.A., Hartig, F., Dormann, C.F., 2017. Cross-validation strategies for data with temporal, spatial, hierarchical, or phylogenetic structure. Ecography 40, 913–929. https://doi.org/10.1111/ecog.02881
Rojas-Soto, O., Forero-Rodríguez, J.S., Galindo-Cruz, A., Mota-Vargas, C., Parra-Henao, K.D., Peña-Peniche, A., Piña-Torres, J., Rojas-Herrera, K., Sánchez-Rodríguez, J.D., Toro-Cardona, F.A., Trinidad-Domínguez, C.D., 2024. Calibration areas in ecological niche and species distribution modelling: Unravelling approaches and concepts. Journal of Biogeography 51, 1416–1428. https://doi.org/10.1111/jbi.14834
Valavi, R., Elith, J., Lahoz-Monfort, J.J., Guillera-Arroita, G., 2019. blockCV: An R package for generating spatially or environmentally separated folds for k-fold cross-validation of species distribution models. Methods in Ecology and Evolution 10, 225–232. https://doi.org/10.1111/2041-210X.13107
VanDerWal, J., Shoo, L.P., Graham, C., Williams, S.E., 2009. Selecting pseudo-absence data for presence-only distribution modeling: How far should you stray from what you know? Ecological Modelling 220, 589–594. https://doi.org/10.1016/j.ecolmodel.2008.11.010