2. Veri I: kayıtlar, katmanlar ve çalışma sınırı (① Data)
Sekme: ① Data · Kod: tabs/tab_data.py (arayüz), sdm_inputs.py (CSV okuma), sdm_mask.py (klasör tarama, sınırla kırpma), sdm_core.py DataFormatter (yükleme ve kayıt ayıklama)
2.1 Bu sekme ne yapar
① Data, iş akışının ilk ve zorunlu adımıdır. Tür kayıtlarını (varlık noktalarını), öngörücü raster katmanlarını ve isteğe bağlı bir çalışma sınırını okur; kayıtları ayıklar; ardından makine öğrenmesi modelleri için yalancı yokluk (pseudo-absence) kümelerini, MaxEnt için arka plan noktalarını ve ENFA için ayrı bir arka plan örneğini üretir. Bu bölüm sekmenin "veri" yarısını anlatır: kayıt dosyası, katmanlar, sınır, tohum, çıktı klasörü ve Load Data düğmesinin kayıtlar üzerinde yaptığı her işlem. Arka plan, yalancı yokluk, erişilebilir alan ve seyreltme ayarları Bölüm 3'tedir.
- Girdi: bir kayıt CSV'si (tür adı, boylam, enlem), en az bir sürekli raster, isteğe bağlı kategorik rasterler ve bir sınır katmanı.
- Çıktı: bellekteki
DataFormatternesnesi (öngörücü dizileri, ayıklanmış varlıklar, yalancı yokluk kümeleri, arka planlar), günlüğe ve çalıştırma kaydına (habitus_run_config.json) yazılan sayılar; sınır verildiyse kırpılmış katmanlar (masked_inputs/current/), erişilebilir alan tanımlıysaaccessible_area.tif. - Kilit düzeni: adım başarıyla bitince ② Variables sekmesi açılır ve program o sekmeye geçer (
tabs/tab_data.py:1759-1760). ① yeniden çalıştırılırsa sonraki sekmelerin bütün sonuçları sıfırlanır (tabs/tab_data.py:1396-1397).
2.2 Ekranın düzeni
Sekme iki sütundan oluşur (tabs/tab_data.py:78-82). Sol sütunda kayıt dosyası, raster listeleri ve çalışma sınırı; sağ sütunda arka plan/yalancı yokluk ayarları, tekrarlanabilirlik ve çıktı klasörü bulunur. En altta bütün adımı başlatan yeşil düğme, onun altında ilerleme şeridi ve oturum günlüğü yer alır.
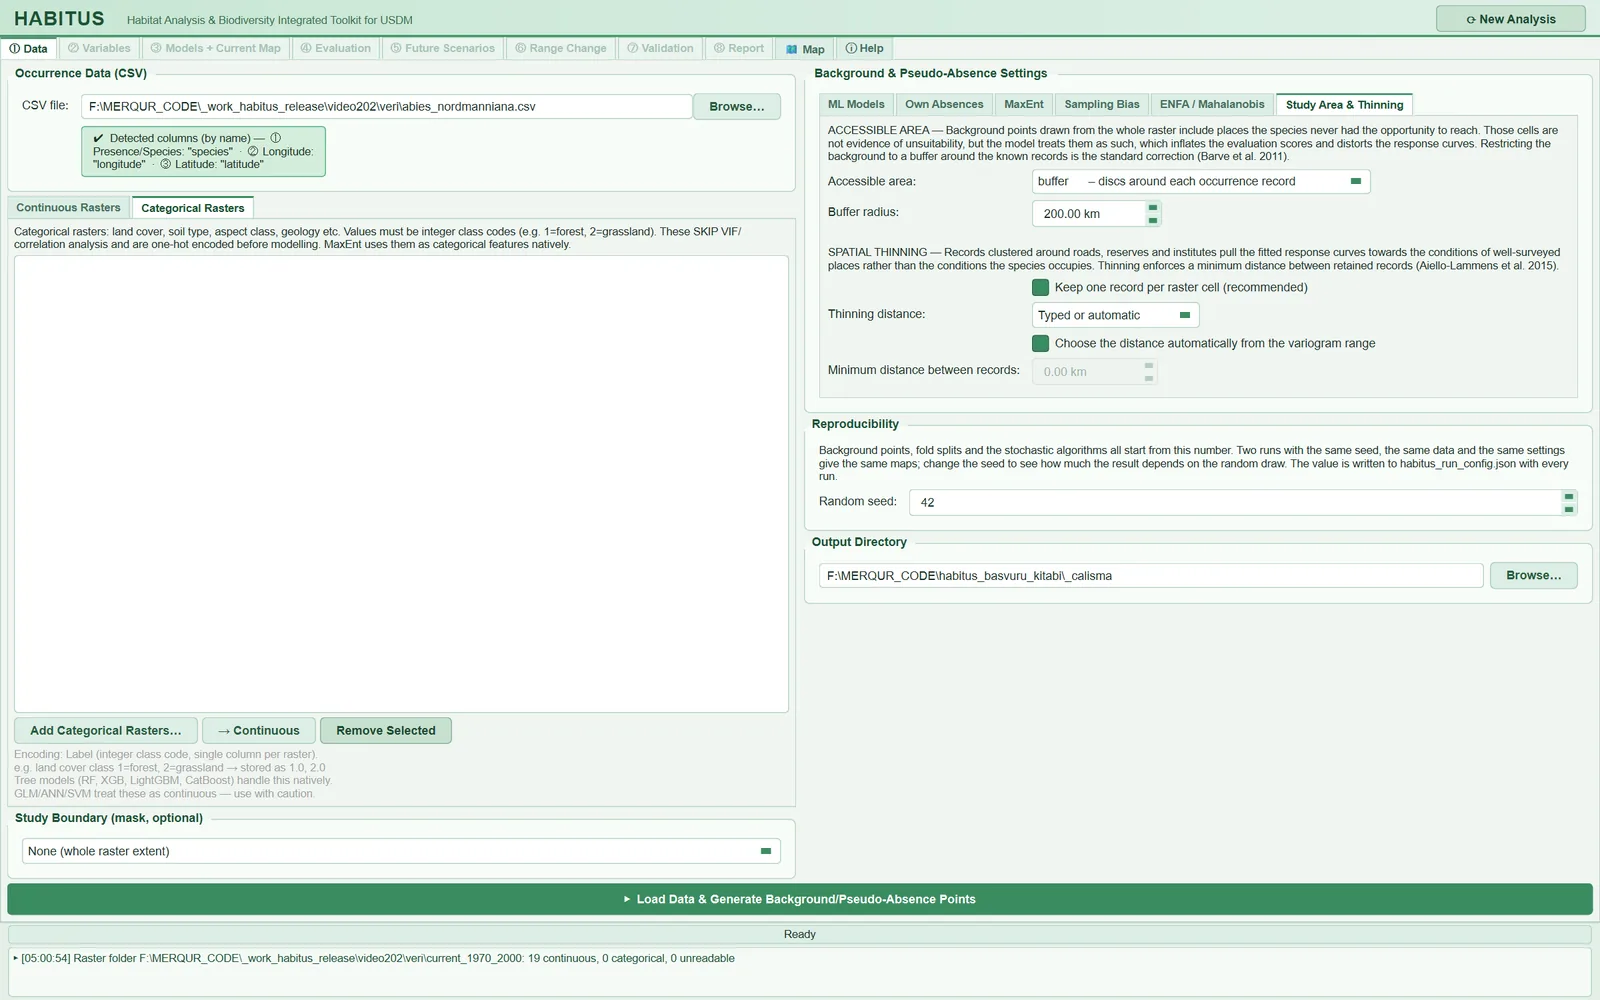
| Bölge | Arayüzdeki ad | Bu kitapta |
|---|---|---|
| Sol üst | Occurrence Data (CSV) |
§2.3 |
| Sol orta | Continuous Rasters, Categorical Rasters |
§2.4 |
| Sol alt | Study Boundary (mask, optional) |
§2.5 |
| Sağ üst | Background & Pseudo-Absence Settings (6 alt sekme) |
Bölüm 3 |
| Sağ orta | Reproducibility |
§2.6 |
| Sağ alt | Output Directory |
§2.7 |
| Alt şerit | Load Data & Generate Background/Pseudo-Absence Points |
§2.8, §2.9 |
2.3 Tür kayıtları: Occurrence Data (CSV)
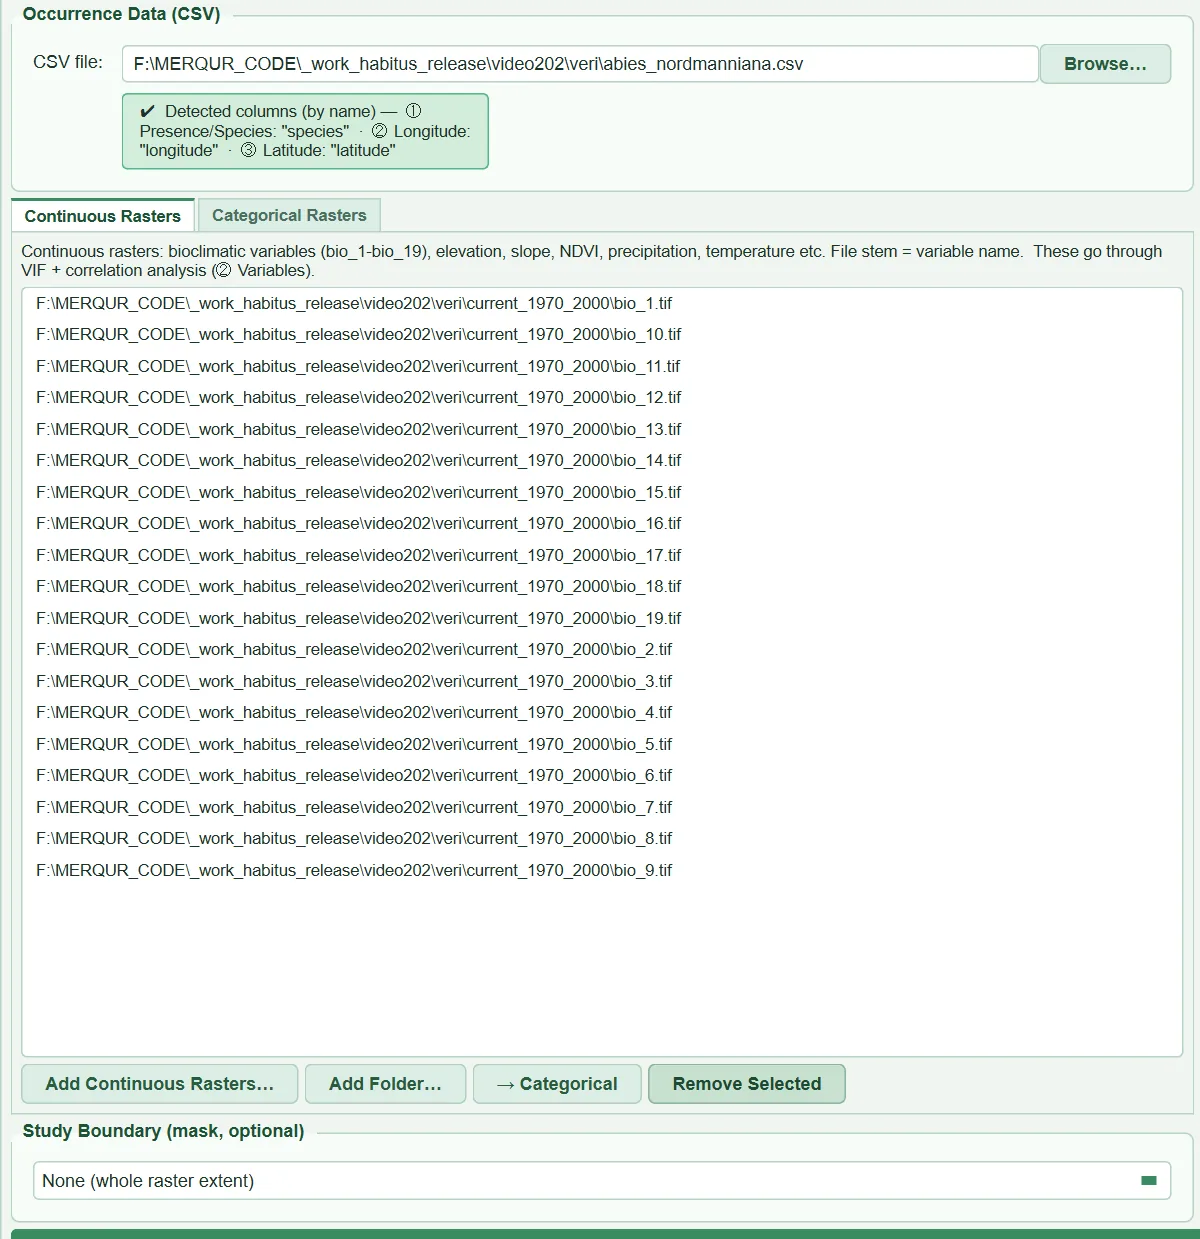
Bu grup, türün gözlendiği yerlerin koordinatlarını taşıyan tabloyu okur. Dosya seçilince program ilk satırlara bakar, sütunları bulur, yeşil bilgi kutusunda hangi sütunun ne olarak kullanılacağını yazar ve dosyada birden çok tür varsa bir tür listesi açar.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
CSV file: + Browse… |
Kayıt tablosunu seçer; seçince sütunları ve türleri tarar, çıktı klasörünü önerir | boş | .csv, .tsv, .txt |
tabs/tab_data.py:92-96, 972-979 |
| Bilgi kutusu | Bulunan tür, boylam, enlem sütunlarını ve yok sayılacak sütunları gösterir | — | — | tabs/tab_data.py:99-108, 1008-1023 |
Species: listesi |
Çok türlü dosyada her tür için bir onay kutusu (kayıt sayısıyla) | hepsi işaretli | All / None |
tabs/tab_data.py:112-149, 1045-1072 |
Analyse now: |
①–⑧ iş akışının şimdi hangi tür için çalışacağını seçer | ilk işaretli tür | işaretli türler | tabs/tab_data.py:132-140, 1085-1095 |
2.3.1 Dosya biçimi, ayırıcı ve ondalık işaret
- Ne işe yarar. Program her CSV'yi aynı yordamla okur (
sdm_inputs.py:20-65). Dosyanın ilk 64 KB'sinden boş olmayan ilk 50 satır alınır; virgül, noktalı virgül ve sekme için her satırdaki sayım çıkarılır ve satırların çoğunda aynı sayıda geçen işaret ayırıcı kabul edilir. Ayırıcı noktalı virgül ya da sekme ise ve gövdede36,52biçiminde sayılar varken noktalı ondalık hiç yoksa ondalık işaret virgül sayılır. Dosya UTF-8 olarak okunur; baştaki bayt sırası işareti (BOM) atılır. - Ne zaman, nasıl ayarlanır. Ayar yoktur; Türkçe, Almanca ya da İspanyolca bölge ayarlı bir hesap tablosunun kaydettiği
;ayırıcılı, virgül ondalıklı dosya olduğu gibi okunur. En güvenli biçim yine virgül ayırıcı ve nokta ondalıktır. - Sonuca etkisi. Yanlış sezilen ayırıcı bütün tabloyu tek sütuna indirir; o durumda program "CSV has only 1 column(s)" uyarısı verir ve hiçbir koordinat okunmaz.
- Dikkat. Virgül ayırıcılı bir dosyada koordinatlar
"36,52"gibi tırnak içinde virgüllü yazılmışsa ondalık virgül sezilmez (sezme yalnız;ve sekme için yapılır) ve koordinat sütunu metin olarak kalır. Sayıya çevrilemeyen her koordinat hücresi çalıştırmayı satır numarasıyla durdurur: "column '…' holds non-numeric coordinates in N row(s) (row 5: '36°31′'…)" (sdm_inputs.py:100-123). Boş koordinat hücreleri ise durdurmaz; o kayıtlar "missing coordinate" gerekçesiyle atılır ve bir uyarı yazılır (sdm_core.py:2944-2953). UTF-8 olmayan bir dosya "Re-save it as 'CSV UTF-8'" iletisiyle reddedilir (sdm_inputs.py:90-93).
2.3.2 Sütunların bulunması (adla, konumla, GBIF)
- Ne işe yarar.
occurrence_columnsönce adlara bakar (sdm_inputs.py:128-166). Büyük-küçük harf gözetmeden boylam içinlongitude, decimallongitude, lon, long, lng, x, enlem içinlatitude, decimallatitude, lat, yaranır. İkisi de bulunursa tür sütunuspecies, scientificname, acceptedscientificname, verbatimscientificname, taxonadlarından ilki olur; hiçbiri yoksa koordinat dışı ilk sütun alınır. Koordinat adları bulunamazsa ilk üç sütun konumla okunur: ① tür, ② boylam, ③ enlem. Bilgi kutusundaki "(by name)" eki adla bulunduğunu gösterir. Dosyada üçten fazla sütun varsa fazlası yok sayılır ve bir bilgi penceresi bunları tek tek sayar ("Extra Columns Detected",tabs/tab_data.py:1030-1041). - Ne zaman, nasıl ayarlanır. GBIF'ten indirilen Darwin Core tablosu (
gbifID, …, species, …, decimalLongitude, decimalLatitude) düzenlenmeden kullanılabilir. Kendi tablonuzda sütunlaraspecies, longitude, latitudeadlarını vermek en açık yoldur; arayüzde sütun seçen ayrı bir alan yoktur. - Sonuca etkisi. Boylam ile enlemin yer değiştirmesi kayıtların çoğunu raster dışına atar. Program bu durumu sezmeye çalışır (§2.8.6).
- Dikkat. Ad bulunamadığında sıra kesin olarak "tür, boylam, enlem"dir; "tür, enlem, boylam" sırasındaki bir dosya ters okunur. Yalnız
xveyadlı sütunlar varsa onlar da koordinat sayılır. Arayüzdeki ilk bilgi metni ("The first 3 columns will always be used") dosya seçilmeden önce görünür; dosya seçilince gerçekte kullanılan sütunlar yazılır, esas olan budur.
2.3.3 Çok türlü dosya ve Analyse now
- Ne işe yarar. Tür sütununda birden fazla ad varsa
Species:satırı açılır; her tür kayıt sayısıyla bir onay kutusu olarak listelenir (tabs/tab_data.py:1045-1072). Sütundaki bütün değerler sayıysa (ör. 0/1 varlık kodu) bunlar tür adı sayılmaz ve liste açılmaz.Analyse now:kutusu işaretli türlerden birini seçer.Load Data'ya basıldığında yalnız o türün kayıtları alınır, çıktı klasörünün içinde türün adını taşıyan alt klasöreoccurrences_used.csvolarak yazılır ve iş akışı bu dosyayla sürer (tabs/tab_data.py:1500-1506). - Ne zaman, nasıl ayarlanır. Birçok türü aynı ayarlarla modellemek için: önce bir tür için ①–⑧ tamamlanır, sonra ⑧ Report'taki
Run Selected Speciesaynı ayarları öteki işaretli türlere uygular (Bölüm 11). - Sonuca etkisi. Her tür kendi kayıtlarıyla, ayrı ayrı modellenir; türler arasında bilgi paylaşılmaz. Alt klasör adları dosya sistemine uygun hâle getirilir ve büyük-küçük harf farkı gözetilmeden tekilleştirilir ("Quercus robur" ile "quercus robur" ayrı klasöre gider;
tabs/tab_data.py:34-60). - Dikkat. Hiç tür işaretlenmezse çalıştırma "The occurrence file holds several species. Tick at least one and choose it under 'Analyse now'." iletisiyle durur (
tabs/tab_data.py:1373-1378). Tür adlarındaki baş ve sondaki boşluklar kırpılır; "Abies nordmanniana" ile "Abies nordmanniana" (iki boşluk) yine iki ayrı tür sayılır.
2.3.4 Tür adı ve önerilen çıktı klasörü
Raporlarda ve dosya adlarında kullanılan tür adı şöyle belirlenir (sdm_core.py:1566-1593): ilk sütun koordinat ya da tür sütunu değilse ve sayı değilse oradaki en sık metin; değilse tür sütunundaki en sık metin; o da yoksa CSV dosyasının adı (alt çizgi ve tireler boşluğa çevrilir). Örnek koşuda ad "abies nordmanniana"dır. Output Directory boşsa dosya seçildiği anda Belgeler/HABITUS/<tür>_YYYYMMDD_HHMMSS klasörü oluşturulur ve alana yazılır (tabs/tab_data.py:1125-1160, main_dialog.py:832-853); çok türlü dosyada klasör adı CSV'nin adından alınır.
2.4 Öngörücü katmanlar: Continuous Rasters ve Categorical Rasters
Öngörücüler iki ayrı listede tutulur. Sürekli (continuous) katmanlar ölçülen büyüklüklerdir: sıcaklık, yağış, yükseklik, eğim, NDVI. Kategorik (categorical) katmanlar ise sınıf kodlarıdır: arazi örtüsü, toprak tipi, jeoloji. Bu ayrım sonraki her adımı etkiler: sürekli katmanlar ② Variables'ta VIF ve korelasyon analizine girer, kategorik katmanlar bu analizin dışında kalır ve modellere sınıf olarak verilir.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Add Continuous Rasters… |
Seçilen dosyaları sürekli listeye ekler (aynı yol iki kez eklenmez) | — | .tif .tiff .asc .img .nc .vrt |
tabs/tab_data.py:911-912, 1183-1191 |
Add Folder… |
Klasördeki bütün rasterleri okur, her birini sürekli/kategorik diye sınıflar | — | klasör | tabs/tab_data.py:913-919, 1205-1290 |
→ Categorical / → Continuous |
Seçili dosyaları öteki listeye taşır | — | — | tabs/tab_data.py:920-922, 948-950, 1197-1203 |
Remove Selected |
Seçili dosyaları listeden çıkarır | — | — | tabs/tab_data.py:923-924, 1193-1195 |
Add Categorical Rasters… |
Seçilen dosyaları kategorik listeye ekler | — | aynı uzantılar | tabs/tab_data.py:946-947 |
| Encoding notu | Kategorik kodlamanın etiket (tamsayı sınıf kodu) olduğunu bildirir | label | yalnız label | tabs/tab_data.py:959-968, sdm_core.py:1428-1440 |
2.4.1 Tek tek ekleme ve değişken adları
- Ne işe yarar. Her dosyanın uzantısız adı değişken adı olur. Ad, boşluk, parantez, tire ve nokta alt çizgiye çevrilerek temizlenir:
bio_ (1)→bio_1,tr-elev→tr_elev(sdm_core.py:166-186). Katmanlar listeye hangi sırayla eklenmiş olursa olsun program değişkenleri "doğal" sıraya dizer (bio_2 < bio_3 < bio_12;sdm_core.py:189-200,1617-1620); bu sayede sonuçlar ekleme sırasına bağlı değildir. - Ne zaman, nasıl ayarlanır. Gelecek senaryolarında (⑤) katmanlar adla eşleştirildiği için güncel ve gelecek dosyalarının adları aynı olmalıdır (
bio_1.tif↔bio_1.tif). - Sonuca etkisi. Her katmanın yalnız ilk bandı okunur (
sdm_core.py:1608); çok bantlı bir GeoTIFF ya da NetCDF'in öteki bantları kullanılmaz. Sürekli katmanlar bellekte, kaynak türü kayıpsız taşıyabiliyorsa float32, taşıyamıyorsa float64 tutulur (sdm_core.py:1367-1379); değerler bit bit korunur, bütün hesaplar float64'te yapılır. - Dikkat. Katmanın NoData değeri dosyada tanımlı olmalıdır; tanımlı değilse deniz ya da boş alan hücreleri (ör. -3,4e38) gerçek değer sanılır. Temizlendikten sonra aynı adı veren iki dosya (
bio 1.tifvebio_1.tif) sınır kullanılmadığında denetlenmez; sonra okunan öncekinin yerine geçer. Sınır kullanıldığında aynı ada sahip iki dosya hata verir: "Two predictor rasters have the same name" (sdm_mask.py:337-345).
2.4.2 Add Folder…: sürekli/kategorik sınıflama ve gerekçesi
- Ne işe yarar.
scan_raster_folderklasördeki.tif .tiff .asc .img .nc .vrtdosyalarını ada göre sıralar ve her biriniclassify_rasterile sınıflar (sdm_mask.py:54-141). Kurallar sırasıyla şunlardır:- Adı biyoiklim katmanı gibi olan (
bio1,bio_12,wc2.1_30s_bio_5) ve renk tablosu taşımayan dosya, değerleri okunmadan sürekli sayılır (30 açı saniyelik bir dünya.asc'sinin gigabaytlarca metni böylece okunmaz). - Öteki dosyalar seyreltilerek okunur: uzun kenarı en çok yaklaşık 1000 hücre olacak biçimde en yakın komşuyla küçültülür.
- Geçerli hücre yoksa sürekli bırakılır ve şüpheli işaretlenir.
- Renk tablosu (palet) varsa kategorik.
- Ondalıklı değer varsa sürekli.
- Bütün değerler tamsayı ve farklı değer sayısı en çok 30 (
MAX_CATEGORICAL_CLASSES) ise kategorik; en az 12 farklı değer varken adda sınıf çağrıştıran bir sözcük yoksa ya da ad sürekli bir değişken çağrıştırıyorsa (elev,slope,ndvi,temp,prec…) şüpheli işaretlenir. - 30'dan fazla farklı tamsayı varsa sürekli; adda
landcover,soil,geolog,class,zone… geçiyorsa şüpheli.
- Adı biyoiklim katmanı gibi olan (
- Ne zaman, nasıl ayarlanır. Biyoiklim ve öteki katmanları tek klasörde tutan kullanıcı için en hızlı yoldur. Sonuç penceresi ("Rasters added") her dosyayı
N(sürekli) ya daC(kategorik) harfiyle ve gerekçesiyle listeler; ⚠ işaretli satırlar elle denetlenmeli, yanlış sınıflanan dosya→ Categorical/→ Continuousile taşınmalıdır. - Sonuca etkisi. Örnek veride 19 dosyanın hepsi addan sürekli sayılmıştır (günlükte "19 continuous, 0 categorical, 0 unreadable"). Yanlış listede kalan bir katman modelde yanlış temsil edilir: kategorik listede kalan bir sıcaklık katmanı VIF analizine girmez ve sınıf gibi işlenir.
- Dikkat. 1–5 arası verimlilik puanı gibi sıralı tamsayı ölçekler değerlerinden sınıf kodundan ayrılamaz ve işaretlenmeden kategorik sayılır (
sdm_mask.py:48-51). Açılamayan dosyalar "✖ … could not be opened" satırıyla raporlanır ve listeye eklenmez.
2.4.3 Kategorik katmanların modele girişi
- Ne işe yarar. Kategorik katmanlar tamsayıya (int32) çevrilerek okunur, NoData hücreleri
-9999ile işaretlenir ve her katmanın sınıf listesi çıkarılır (sdm_core.py:1653-1677). Örneklenen noktalarda her katman tek bir sütun olarak, sınıf kodunun kendisiyle yer alır (etiket kodlaması). Kod sayı gibi kullanılmaz: GLM, GLMNET, SVM ve ANN boru hattının ilk adımı her sınıfı ayrı bir 0/1 sütuna açar (_CatPrep,sdm_core.py:3364-3384); GAM faktör terimi, MaxEnt kategorik özellik sınıfı kullanır; ağaç yöntemleri (RF, GBM, BRT, XGBoost, LightGBM, CatBoost, CART) kod üzerinden böler; BIOCLIM, Domain, ENFA ve Mahalanobis kategorik katmanları dışarıda bırakır (sdm_core.py:1781-1787). - Ne zaman, nasıl ayarlanır. Arazi örtüsü gibi gerçek sınıf katmanları için. Az kayıtlı bir türde çok sınıflı bir katman, eğitim verisinde hiç ya da çok az kaydı olan sınıflar doğurur; program bunları "sparse classes" uyarısıyla bildirir (
sdm_core.py:3232-3246) ve ② Variables'ta katmanı dışarıda bırakma olanağı verir. - Sonuca etkisi. Kategorik bir katmanın NoData olduğu hücreler bütün örneklemeden çıkar (
_valid_cell_mask,sdm_core.py:2309-2330); kapsaması sürekli katmanlardan dar olan bir arazi örtüsü katmanı çalışma alanını daraltır. Yalnız bu nedenle kaybedilen kayıt ve hücre sayıları ② Variables'a bildirilir (sdm_core.py:3073-3078). - Dikkat. Ondalıklı değerler tamsayıya çevrilirken kesilir (2,7 → 2). Kategorik listedeki dosya da sürekli katmanlarla aynı ızgarada olmalıdır (§2.4.5). En az bir sürekli katman zorunludur; yalnız kategorik katmanla çalıştırma "Please add at least one environmental raster." iletisiyle durur (
tabs/tab_data.py:1368-1369).
2.4.4 Büyük ASCII ızgaralarının GeoTIFF'e çevrilmesi
- Ne işe yarar.
Add Folder…ile eklenen.ascdosyalarının toplam boyutu 200 MB'yi (_ASC_CONVERT_MB) aşarsa program bunları bir kez sıkıştırılmış, döşemeli (tiled, DEFLATE) GeoTIFF kopyalarına çevirmeyi önerir ("Convert ASCII grids to GeoTIFF?";tabs/tab_data.py:1292-1330,sdm_mask.py:144-178). Kopyalar klasörün içindekigeotiff/alt klasörüne aynı adla yazılır ve listedeki yollar bunlarla değiştirilir;.ascdosyalarına dokunulmaz. Kopya, kaynaktan yeniyse yeniden üretilmez. - Ne zaman, nasıl ayarlanır. Dünya ölçekli
.asckatmanlarında "Yes" önerilir: ASCII metin her okumada baştan ayrıştırıldığı için kırpma, örnekleme ve izdüşümün her biri dakikalar sürer; GeoTIFF pencere pencere okunur. - Sonuca etkisi. Değerler ve koordinat sistemi aynı kalır; yalnız süre kısalır.
- Dikkat. Öneri yalnız klasörle eklemede çıkar; tek tek eklenen
.ascdosyaları için sorulmaz.
2.4.5 Izgara uyumu ve koordinat sistemi
- Ne işe yarar. Program bütün katmanları hücre hücre tek bir tabloya okur; bu yüzden sınır kullanılmadığında her katman ilk katmanla (doğal sıradaki ilk ad) aynı satır-sütun sayısına, hücre boyuna, başlangıç noktasına ve koordinat sistemine sahip olmalıdır. Hücre boyu ve başlangıçta 1e-6 birimlik fark hoş görülür (
sdm_core.py:1683-1744). Uymayan her katman adıyla ve farkıyla listelenir: "Environmental rasters are not on the same grid. • bio_12: cell size …". - Ne zaman, nasıl ayarlanır. Farklı kaynaklardan gelen katmanlar önceden hizalanmalıdır (QGIS: Raster > Align Rasters). Alternatif olarak bir çalışma sınırı verilirse program katmanları kendisi ortak ızgaraya getirir (§2.5.2).
- Sonuca etkisi. Koordinat sistemi coğrafi (derece) ya da projeksiyonlu (metre) olabilir. Mesafeye dayanan her karar (seyreltme, tampon, en az mesafe, blok boyu) büyük daire (haversine) mesafesiyle kilometre cinsinden verilir; projeksiyonlu ızgarada koordinatlar önce boylam/enleme çevrilir (
sdm_spatial.py:113-141). Projeksiyonlu bir sistemin uzunluk birimi okunamıyorsa çalıştırma durur ("The length unit of the raster coordinate system could not be determined";sdm_spatial.py:93-110). - Dikkat. Kayıt CSV'sinin koordinatları rasterlerle aynı koordinat sisteminde olmalıdır. Program CSV'yi yeniden projekte etmez; koordinatları doğrudan rasterin dönüşüm matrisiyle hücreye çevirir (
sdm_core.py:1763-1765). UTM'deki rasterle derece cinsinden CSV kullanılırsa kayıtların hepsi raster dışında kalır. Rasterler coğrafi olduğunda enlemi ±90'ı, boylamı ±180'i aşan koordinatlar için uyarı verilir (sdm_inputs.py:179-196). Hücre boyu ekvatorda yaklaşık 4 km ya da daha büyükse bir çözünürlük uyarısı yazılır (sdm_core.py:1751-1761); örnek koşuda (2,5′, yaklaşık 4,6 km) bu uyarı çıkmıştır.
2.5 Çalışma sınırı: Study Boundary (mask, optional)
Bu grup bütün rasterleri bir çokgenle ya da derece cinsinden bir dikdörtgenle kırpar. Böylece dünya ölçekli katmanlar kesilmeden kullanılabilir ve sınırın dışındaki her hücre NoData olur.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
| Kip kutusu | Sınırın türünü seçer | None (whole raster extent) |
None (whole raster extent) / Polygon layer (SHP, GPKG, KML, GeoJSON) / Corner coordinates (degrees) |
tabs/tab_data.py:173-181 |
Dosya alanı + Browse… / Clear |
Çokgen katmanı (yalnız ikinci kipte görünür); dosya seçilince kip kendiliğinden çokgene geçer | boş | .shp .gpkg .geojson .json .kml .gml |
tabs/tab_data.py:161-172, 1332-1339 |
West / South / East / North |
Dikdörtgenin köşeleri, WGS84 derece (yalnız üçüncü kipte) | 25 / 35 / 45 / 43 | boylam −180…180, enlem −90…90; 4 ondalık | tabs/tab_data.py:186-197 |
2.5.1 Kipler ve kırpmanın kapsamı
- Ne işe yarar. Sınır verildiğinde
Load Dataher şeyden önce bütün sürekli ve kategorik katmanları kırpar (tabs/tab_data.py:1511-1524). Bundan sonraki her adım (kayıt ayıklama, yalancı yokluklar, arka plan, çapraz doğrulama katları, güncel harita, ⑤'teki gelecek katmanları ve ⑥ alan değişimi) yalnız sınırın içindeki hücreleri görür; çünkü bir katmanda NoData olan hücre her yerde dışlanır. Köşe koordinatları EPSG:4326 dikdörtgeni olarak alınır ve gerekirse rasterin sistemine çevrilir (sdm_mask.py:193-201). - Ne zaman, nasıl ayarlanır. Model ve haritaların bir ülke, havza ya da bölgeyle sınırlanması gerektiğinde. Sınır, Bölüm 3'te anlatılan erişilebilir alandan farklıdır: sınır bütün katmanları ve haritaları kırpar; erişilebilir alan yalnız arka plan ve yalancı yoklukların çekildiği alanı daraltır, harita yine sınırın tamamı için üretilir.
- Sonuca etkisi. Sınırın dışına düşen kayıtlar "outside raster extent" ya da "falls on NoData cell" gerekçesiyle atılır. Arka plan yalnız sınırın içinden çekildiği için sınırı daraltmak, erişilebilir alanı daraltmaya benzer biçimde değerlendirme skorlarını etkiler (Bölüm 3).
- Dikkat. "West must be smaller than East and South smaller than North" denetimi yapılır (
tabs/tab_data.py:1488-1491). Çokgen kipinde dosya yoksa "The study boundary layer was not found" iletisiyle durulur. Katmanda çokgen yoksa ("has no polygon features"), sınır rasterlerle hiç örtüşmüyorsa ya da bir katmanın sınır içinde hiç değeri yoksa çalıştırma adıyla birlikte durur (sdm_mask.py:213-216,369-383,399-403). Sınır katmanı ya da rasterler koordinat sistemi bildirmiyorsa ikisinin aynı olduğu varsayılır ve bu durum bir uyarıyla rapora yazılır (sdm_mask.py:228-236).
2.5.2 Kırpma nasıl yapılır: tek pencere, ortak ızgara, masked_inputs
- Ne işe yarar.
mask_rasters(sdm_mask.py:304-418) listenin ilk katmanı üzerinde sınırın sınırlayıcı kutusuna karşılık gelen tek bir pencere hesaplar; bütün katmanlar bu pencerenin ızgarasına yazılır. Hücre boyu ve hizası aynı olan katman pencereyle okunur (değerler değişmez); farklı çözünürlükte, kaymış başlangıçlı ya da başka koordinat sistemindeki katman en yakın komşu yöntemiyle bu ızgaraya yeniden örneklenir (sdm_mask.py:273-301). Ardından çokgenin dışındaki hücreler NoData yapılır. Kırpılmış kopyalar özgün adlarıyla<çıktı klasörü>/masked_inputs/current/altına GeoTIFF olarak yazılır; ilerleme şeridinde "Rasters clipped to the study boundary: R x C cells." görülür. - Ne zaman, nasıl ayarlanır. Farklı kapsamda kesilmiş ya da bir hücre geniş indirilmiş katmanları (GCM setlerinde sık görülür) birlikte kullanmak için sınır kipi pratik bir hizalama yoludur.
- Sonuca etkisi. En yakın komşu yöntemi yeni değer üretmez ve sınıf kodlarını korur; fakat ince çözünürlüklü sürekli bir katman kaba ızgaraya indirildiğinde ortalama değil tek bir hücrenin değeri alınır. ⑤'teki gelecek katmanları aynı ızgaraya kırpılır, böylece güncel ve gelecek haritaları hücre hücre örtüşür.
- Dikkat. Izgarayı belirleyen, listenin ilk katmanıdır (önce sürekli, sonra kategorik liste, eklenme sırasıyla). En ince çözünürlüklü katmanı ilk sıraya koymak, bilginin kaybolmasını önler.
masked_inputsklasörü çok türlü dosyada da ana çıktı klasöründedir; türler aynı kırpılmış kopyaları paylaşır.
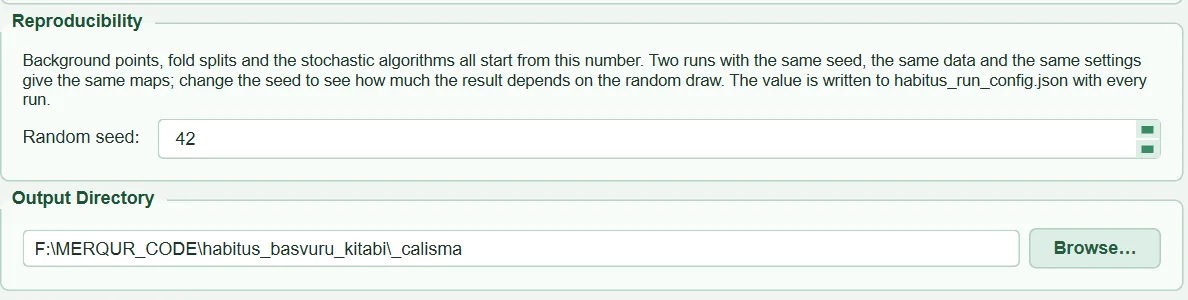
2.6 Tekrarlanabilirlik: Reproducibility
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Random seed: |
Bütün rastgele işlemlerin başlangıç sayısı | 42 | 0 – 2147483647 | tabs/tab_data.py:242-249, run_config.py:28 |
2.6.1 Random seed
- Ne işe yarar. Veri adımı başlarken
set_run_seedNumPy'nin genel üretecini, Python'unrandommodülünü vePYTHONHASHSEEDortam değişkenini bu sayıyla tohumlar (tabs/tab_data.py:1510,run_config.py:31-50).DataFormatterayrıca kendi üretecini (numpy.random.default_rng(seed)) bu sayıdan kurar; yalancı yokluk, arka plan çekilişi, seyreltme sırası, variogram alt örneği ve k-ortalamalar bundan türer (sdm_core.py:1503-1505,2301-2302,2536). Modellerinrandom_statedeğeri de aynı sayıdan verilir (Bölüm 5). - Ne zaman, nasıl ayarlanır. Yayımlanacak bir çalışmada değer raporlanır;
habitus_run_config.jsondosyasınınrandom_seedalanına her çalıştırmada yazılır. Sonucun rastgele çekilişe ne kadar bağlı olduğunu görmek için aynı ayarlarla birkaç farklı tohum denenir. - Sonuca etkisi. Aynı veri, aynı ayar ve aynı tohumla aynı haritalar beklenir. Tohum değişince yalancı yokluk ve arka plan noktaları, katlar ve stokastik algoritmalar değişir; skorlardaki ve haritalardaki oynama, verinin bu çekilişlere duyarlılığını gösterir.
- Dikkat.
PYTHONHASHSEEDyalnız tanımlı değilse atanır (setdefault) ve Python yorumlayıcısı başladıktan sonra atanması karma sıralamasını etkilemez. Çok iş parçacıklı kütüphanelerin (ör. bazı gradyan artırma uygulamaları) farklı makinelerde bit bit aynı sonucu verip vermediği kodda güvenceye alınmaz ve sınanmamıştır; aynı makinede aynı kurulumla tekrarlanabilirlik amaçlanmıştır.
2.7 Çıktı klasörü: Output Directory
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Klasör alanı + Browse… |
Bütün çıktıların yazılacağı klasör | CSV seçilince Belgeler/HABITUS/<tür>_<zaman> |
herhangi bir klasör | tabs/tab_data.py:253-260, 1125-1160 |
Sonucu etkilemez; boş bırakılırsa "Please specify an output directory." iletisiyle durulur. Çok türlü dosyada her tür <çıktı klasörü>/<tür> alt klasörüne yazılır (tabs/tab_data.py:1115-1123); oturum günlüğü de çalıştırma başında bu klasöre taşınır, böylece toplu çalıştırmada her türün günlüğü kendi klasöründe olur (tabs/tab_data.py:1398-1408).
2.8 Load Data düğmesi: işlem sırası ve kayıt ayıklama
▶ Load Data & Generate Background/Pseudo-Absence Points düğmesi bütün adımı arka planda, arayüzü dondurmadan çalıştırır (tabs/tab_data.py:1363-1574). İşlem sırası, hangi kaydın neden atıldığını anlamak için önemlidir:
- Ön denetim: CSV var mı, en az bir sürekli raster var mı, çıktı klasörü dolu mu, hedef grup CSV'si ve yanlılık rasteri (verildiyse) var mı, sınır geçerli mi.
- Önceki bir veri adımı varsa sonraki sekmelerin bütün sonuçları sıfırlanır.
- Çok türlü dosyada yalnız seçili türün kayıtları
occurrences_used.csv'ye ayrılır. - Tohum atanır (§2.6).
- Sınır verildiyse bütün katmanlar kırpılır (§2.5).
load_data: CSV ve katmanlar okunur, tür adı belirlenir, ızgara uyumu denetlenir (sdm_core.py:1549-1681).generate_pa_datasets: koordinatlar sayıya çevrilir, kayıtlar ayıklanır (bu bölüm), seyreltme ve erişilebilir alan uygulanır, yalancı yokluk kümeleri ve arka planlar çekilir (Bölüm 3), çoklu doğrusallık ön hesabı yapılır (sdm_core.py:2911-3249).- Erişilebilir alan
accessible_area.tifolarak yazılır; istenmişse MaxEnt arka planı CSV'ye kaydedilir.
2.8.1 Kayıt ayıklamanın adımları
Varlık kayıtları aşağıdaki sırayla süzülür (sdm_core.py:2931-2968, 1824-2037). Her atılan kayıt gerekçesiyle dropped_points listesine girer; liste uyarı penceresinde, günlükte, raporda ve habitus_run_config.json'da (points_dropped_by_reason) görünür.
| Sıra | Gerekçe (arayüzdeki metin) | Kural | Kapatılabilir mi | Kod |
|---|---|---|---|---|
| 1 | missing coordinate |
Boylam ya da enlem hücresi boş | hayır | sdm_core.py:2944-2953 |
| 2 | duplicate coordinate |
Koordinatlar 8 ondalığa yuvarlandığında daha önceki bir kayıtla aynı | hayır | sdm_core.py:1844-1856 |
| 3 | outside raster extent |
Hücre satırı/sütunu ızgaranın dışında | hayır | sdm_core.py:1864-1876 |
| 4 | falls on NoData cell |
Herhangi bir sürekli katmanda NaN ya da herhangi bir kategorik katmanda NoData | hayır | sdm_core.py:1878-1905 |
| 5 | same raster cell as another record |
Aynı öngörücü hücresinde dosya sırasında daha önce gelen bir kayıt var | evet: Keep one record per raster cell |
sdm_core.py:1913-1936 |
| 6 | spatially thinned |
Seyreltme mesafesi içinde tutulan bir kayıt var | evet (Bölüm 3) | sdm_core.py:2960-2968 |
2.8.2 Yinelenen koordinat, raster dışı ve NoData
- Ne işe yarar. Birebir aynı koordinat (yaklaşık 1 mm'lik yuvarlama farkıyla) yalnız ilk kez geçtiği yerde tutulur. Kalanlar arasından ızgaranın dışına düşenler ve bir katmanda değer taşımayan hücreye düşenler atılır. Kategorik bir katman yüzünden atılan kayıtlar ayrıca sayılır (
cat_nodata_loss_presence) ve ② Variables'a bildirilir. - Ne zaman, nasıl ayarlanır. Bu üç süzgeç her zaman çalışır; ayar yoktur.
- Sonuca etkisi. Kıyıdaki kayıtların bir kısmı kaba çözünürlükte deniz hücresine düşerek NoData'ya takılabilir. Atılan kayıtların payı, kullanılan varlık sayısını ve dolayısıyla Bölüm 3'teki prevalansı belirler.
- Dikkat. Yinelenmeyen kayıtların %20'sinden fazlası (
LOSS_WARN_FRACTION) raster dışında ya da NoData'da kalırsa program boylam ile enlemi yer değiştirip yeniden dener; değiştirilmiş hâlde kayıtların en az yarısı içeride kalıyorsa "The lon/lat columns are probably swapped" uyarısını, değilse koordinat sistemini ve sütunları denetlemenizi isteyen uyarıyı verir (sdm_inputs.py:199-221,sdm_core.py:1969-1990). Bütün kayıtlar düştüğünde ve bir katman içerideki her kayıtta NoData ise suçlu koordinatlar değil o katmandır; ileti katmanı adıyla gösterir (sdm_core.py:2014-2029).
2.8.3 Hücre başına bir kayıt
- Ne işe yarar. Aynı öngörücü hücresine düşen kayıtlar aynı öngörücü değerlerini taşır; her fazla kayıt o hücreye bilgi eklemeden ağırlık ekler. Seçenek açıkken her hücrede dosya sırasındaki ilk kayıt tutulur, ötekiler "same raster cell as another record" gerekçesiyle atılır (
sdm_core.py:1913-1936). Seçenek kapalıyken de bu kayıtlar sayılır ve bir uyarı yazılır (sdm_core.py:1962-1967). Kutunun kendisi Study Area & Thinning alt sekmesindedir (Bölüm 3,tabs/tab_data.py:722-731); varsayılanı açıktır. - Ne zaman, nasıl ayarlanır. Neredeyse her zaman açık kalmalıdır. Yalnız çok az kaydı olan ve kayıtları birkaç hücrede toplanan türlerde kapatmak gündeme gelir; o durumda da kayıtlar aynı hücre değerlerini tekrarlar.
- Sonuca etkisi. Örnek koşuda 626 kaydın 405'i daha önce kaydı olan bir hücreye düştüğü için atılmış, 221 kayıt kalmıştır (oturum günlüğü). Kapalı tutulsaydı yoğun gözlenen birkaç alan (ör. aynı vadide yüzlerce kayıt) hem model eğrilerini hem de çapraz doğrulama katlarını domine ederdi.
- Dikkat. Kural seyreltmeden önce uygulanır. Hangi kaydın tutulacağı dosya sırasına bağlıdır; aynı hücredeki kayıtların koordinatları farklı olsa da öngörücü değerleri aynı olduğu için model açısından fark yoktur, ancak seyreltme ve mekânsal bloklar kaydın tam konumunu kullanır. Dış test kümesi (⑦) bu kuraldan muaftır.
2.8.4 En az beş varlık
- Ne işe yarar. Süzgeçlerden sonra en az 5 kayıt (
MIN_PRESENCES,sdm_core.py:1269) kalmazsa çalıştırma durur. İleti nedene göre değişir (sdm_core.py:1997-2035): kayıp yalnız hücre başına bir kural yüzündense "The N presence record(s) fall in only K predictor cell(s)…", hiç kayıp yoksa "Only K usable presence record(s). At least 5 are required…", kayıplar raster dışı/NoData kaynaklıysa koordinat sistemi uyarısı. - Ne zaman, nasıl ayarlanır. Değiştirilemez. Eşik, SDM yöntemlerinin karşılaştırıldığı yayımlanmış çalışmalardaki en küçük örneklemlere dayanır (Hernandez vd. 2006; Pearson vd. 2007).
- Sonuca etkisi. 5–24 kayıtta çalıştırma sürer ama uyarılar çıkar (§2.8.5).
- Dikkat. Bu sınır seyreltmeden önce denetlenir. Seyreltme sonrası 10'dan az kayıt kalırsa yalnız uyarı verilir ("Thinning at … km leaves only N records";
sdm_core.py:2547-2552), çalıştırma durmaz.
2.8.5 Kayıt sayısı ve kayıt/öngörücü oranı uyarıları
- Ne işe yarar.
_check_sample_size(sdm_core.py:2843-2885) seyreltme sonrası kalan varlık sayısını (n) yüklenen öngörücü sayısıyla (k: sürekli + kategorik) karşılaştırır ve üç uyarı üretebilir:- n < 10: "Only N usable presence record(s). No species distribution method produces a trustworthy model at this sample size…"
- n < 25 (
JACKKNIFE_RECOMMENDED_MAX,sdm_spatial.py:594): ③ Models'ta jackknife (her seferinde bir varlığı dışarıda bırakan) doğrulamanın seçilmesi önerilir (Pearson vd. 2007). - n \geq 10 ve n/k < 10: "N presence records for the K predictors loaded (R per predictor)…". Metin, ② Variables'ta tutulacak öngörücü sayısının asıl önemli sayı olduğunu ve n kaydın yaklaşık \lfloor n/10 \rfloor öngörücüyü taşıyabileceğini söyler.
- Ne zaman, nasıl ayarlanır. Değişken başına 10 kayıt kuralı lojistik türü modeller için yaygın yönergedir; esnek öğreniciler (RF, artırma, menteşe özellikli MaxEnt) daha fazlasını ister (Wisz vd. 2008).
- Sonuca etkisi. Örnek koşuda 143 kayıt ve 19 katman için oran 7,5'tir; ileti "143 records allow about 14" der. ② Variables'ta 8 değişken tutulunca (oran 17,9) aynı denetim yeniden yapılır ve uyarı kalkar (
note_selected_predictors,sdm_core.py:2889-2909;tabs/tab_vif.py:1213). - Dikkat. Uyarılar sonucu değiştirmez; rapora "advisory" olarak yazılır. Bu bölümdeki k, ① Data'da yüklenen bütün katmanları sayar; seçimden sonraki sayı için ②'deki ileti esas alınır.
2.8.6 Veri adımı sonrası iletiler
Adım bitince sırasıyla şu pencereler çıkar (tabs/tab_data.py:1576-1761):
- "Invalid Occurrence Points Detected": en az bir kayıt atıldıysa; gerekçe başına bir başlık ve koordinat listesi (hücre ve seyreltme başlıklarında ilk 15 kayıt, kalanı "… and N more"), sonda "✔ N valid point(s) will be used for modelling." ve CRS hatırlatması. Aynı metin günlüğe yazılır.
- "Points worth knowing before you interpret this run": sonucu yorumlamayı etkileyen uyarılar (çözünürlük, kayıt/öngörücü oranı, erişilebilir alan, seyreltme, yokluk kayıtları…). Yalnız örnekleme yanlılığı hatırlatması varsa bu pencere açılmaz, uyarı yalnız günlüğe "ADVISORY:" önekiyle yazılır.
- "Data ready!" özeti: kullanılan/yüklenen varlık sayısı, atılanların gerekçelere göre dökümü, yalancı yokluk ya da gerçek yokluk satırı, MaxEnt arka plan sayısı, erişilebilir alan ve kapsadığı pay, seyreltme mesafesi ve nasıl seçildiği, özilişki aralığı, prevalans, örnekleme yanlılığının düzeltilmediği notu, tohum, sürekli ve kategorik değişken adları.
Örnek koşunun özeti, oturum günlüğünden derlendiğinde şöyledir: 626 kayıt yüklendi; 405'i aynı hücre, 78'i seyreltme nedeniyle atıldı; 143 varlık kullanıldı; 2 küme × 1000 yalancı yokluk; 10 000 MaxEnt arka planı; erişilebilir alan tampon, 200 km, raster kapsamının %40'ı; seyreltme 4,7 km (otomatik); özilişki aralığı 151,5 km; prevalans 0,125.

2.9 Çıktılar ve sonraki adıma geçenler
- Bellekte (② ve sonrası için): öngörücü dizileri, değişken adları (
var_names,cat_var_names), yalancı yokluk kümeleri (pa_datasets), MaxEnt ve ENFA arka planları, ayıklanmış varlıklar, özilişki aralığı (③'te mekânsal blok boyu olarak kullanılır), çoklu doğrusallık ön sıralaması (collinearity_df, ② Variables'ın başlangıç tablosu). - Diskte:
masked_inputs/current/*.tif(sınır verildiyse),occurrences_used.csv(çok türlü dosyada),accessible_area.tif(erişilebilir alan tanımlıysa; 1 = içeride, 0 = dışarıda),background_maxent.csv(istenmişse), oturum günlüğühabitus_<zaman>.log. - Çalıştırma kaydı:
habitus_run_config.json'undatabölümü kullanılan CSV'yi, tür adını, kullanılan varlık sayısını, atılanların gerekçe dökümünü, raster listelerini, ızgara bilgisini (raster_grid: başvuru katmanı, satır-sütun, hücre boyu, ekvatorda km, CRS) ve prevalansı içerir;study_boundarybölümü sınırı, çokgen sayısını ve kırpılmış ızgarayı. Bu kayıt ③ Models çalıştırıldığında yazılır.
2.10 Uzman soruları
S1. Koordinatlar rasterin koordinat sistemine çevriliyor mu, yoksa aynı sistemde olmaları mı bekleniyor?
Cevap: Aynı sistemde olmaları beklenir. Kayıtlar rasterin dönüşüm matrisiyle doğrudan satır-sütuna çevrilir (sdm_core.py:1763-1765, 1866); CSV için bir koordinat sistemi alanı ya da yeniden projeksiyon yoktur. Yeniden projeksiyon yalnız sınır ve kalibrasyon çokgenleri için yapılır (sdm_mask.py:219-227, sdm_spatial.py:1194-1225). Projeksiyonlu rasterlerde CSV de metre cinsinden olmalıdır; coğrafi rasterlerde ±90/±180 dışındaki değerler uyarı üretir.
S2. Hücre başına bir kayıt kuralı R'deki hangi işleme denk düşer ve neden seyreltmeden önce uygulanıyor?
Cevap: Öngörücü ızgarasında hücre kimliğine göre tekilleştirmedir; dismo'daki gridSample ile ızgara başına bir nokta seçmeye ya da hücre numarasına göre duplicated ile ayıklamaya benzer. HABITUS her hücrede dosya sırasındaki ilk kaydı tutar (sdm_core.py:1919-1936). Önce uygulanmasının nedeni, aynı hücredeki kayıtların öngörücü açısından birer kopya olması ve seyreltmenin bu kopyaları rastgele sırada eleyerek gereksiz zaman harcamasıdır; ayrıca mesafeye dayalı seyreltme hücre altı ölçekte anlamsızdır. Seyreltme mesafesi hücreden küçük girilirse program bunu bildirir (sdm_core.py:2526-2534).
S3. Yinelenen koordinat ne kadar hassas karşılaştırılıyor?
Cevap: Boylam ve enlem 8 ondalığa yuvarlanıp karşılaştırılır (sdm_core.py:1848); derecede bu yaklaşık 1 mm'dir. Yani yalnız gerçekten aynı nokta yinelenen sayılır; birkaç metre arayla girilmiş kayıtlar bu süzgeçten geçer ve hücre başına bir kural ile seyreltmeye kalır.
S4. Boylam ve enlemin yer değiştirdiği nasıl anlaşılıyor?
Cevap: Yinelenmeyen kayıtların %20'sinden fazlası raster dışı ya da NoData'ya düşerse kayıtlar enlem-boylam yer değiştirilmiş olarak bir kez daha ızgaraya yerleştirilir; bu hâlde içeride kalan pay en az 0,5 ve gerçek içeride kalma payından büyükse iletide sütunların büyük olasılıkla ters olduğu söylenir (sdm_core.py:1972-1990, sdm_inputs.py:207-216). Program sütunları kendiliğinden çevirmez; karar kullanıcıya bırakılır.
S5. En az kaç kayıt gerekiyor, bu sayı nereden geliyor ve az kayıtla ne öneriliyor?
Cevap: Süzgeç sonrası en az 5 kayıt zorunludur (sdm_core.py:1269, 1993-2013); gerekçe SDM yöntemlerinin küçük örneklemle sınandığı çalışmalardır (Hernandez vd. 2006; Pearson vd. 2007). 10'un altında güvenilir model üretilemeyeceği, 25'in altında jackknife doğrulamanın seçilmesi gerektiği uyarıları yazılır (sdm_core.py:2864-2875). Çok az kayıtlı türler için ③ Models'taki ESM (küçük modeller topluluğu) seçeneği ayrıca anlatılmaktadır (Bölüm 5).
S6. "10 kayıt / öngörücü" kuralı hangi öngörücü sayısıyla uygulanıyor?
Cevap: ① Data'da yüklenen bütün katmanların sayısıyla (sdm_core.py:2858); bu sayı genellikle nihai modeldeki sayıdan büyüktür. ② Variables'ta seçim onaylanınca aynı denetim seçilen sayıyla tekrarlanır ve önceki ileti yerine yenisi konur (sdm_core.py:2889-2909). Kural yönlendiricidir; çalıştırmayı durdurmaz. Kaynak: Wisz vd. (2008) ve lojistik regresyondaki olay/değişken oranı geleneği.
S7. Farklı çözünürlükte ya da kapsamda katmanlar birlikte kullanılabilir mi?
Cevap: Sınır verilmezse hayır: satır-sütun sayısı, hücre boyu, başlangıç ve CRS aynı olmalıdır, aksi hâlde çalıştırma uymayan katmanı adıyla gösterip durur (sdm_core.py:1698-1744). Sınır verilirse evet: bütün katmanlar listenin ilk katmanının hücreleriyle tanımlanan ortak ızgaraya en yakın komşu yöntemiyle getirilir (sdm_mask.py:283-301). Program ortalama alarak toplulaştırma (aggregate) yapmaz; ince bir katmanı kaba ızgaraya indirmek için önceden bir GIS aracıyla toplulaştırmak daha doğru olur.
S8. Kategorik bir katman neden doğrusal modellerde sayı gibi kullanılmıyor; hangi algoritmalar onu dışarıda bırakıyor?
Cevap: Katman tek sütunda sınıf koduyla taşınır, ancak GLM, GLMNET, SVM ve ANN boru hattının ilk adımı (_CatPrep) eğitimde görülen her sınıf için ayrı 0/1 sütun üretir; kod hiçbir zaman karesi alınan, ölçeklenen ya da çarpılan bir sayı olarak kullanılmaz (sdm_core.py:3364-3384). GAM faktör terimi, MaxEnt kategorik özellik kullanır; ağaç yöntemleri kod üzerinden böler; BIOCLIM, Domain, ENFA ve Mahalanobis katmanı dışarıda bırakır (sdm_core.py:1781-1787). Eğitimde görülmeyen bir sınıf izdüşüm alanında karşılaşılırsa o değişkenin bütün 0/1 sütunları sıfır olur.
S9. Aynı tohumla iki çalıştırma bit bit aynı sonucu verir mi?
Cevap: Amaç budur: tohum veri adımının başında bütün üreteçlere uygulanır (tabs/tab_data.py:1510, run_config.py:31-50) ve arka plan çekilişi, seyreltme, variogram alt örneği, k-ortalamalar ve katlar kendi tohumlu üreteçlerinden gelir. Katman ekleme sırası da sonucu değiştirmez, çünkü değişkenler doğal sıraya dizilir (sdm_core.py:1617-1620). Farklı işletim sistemleri ya da kütüphane sürümleri arasında bit bit eşitlik kodda güvenceye alınmamış ve sınanmamıştır; bu yüzden çalıştırma kaydı kütüphane sürümlerini de yazar (habitus_run_config.json, environment).
S10. Çalışma sınırı ile erişilebilir alan arasındaki fark nedir; biri ötekinin yerine kullanılabilir mi?
Cevap: Sınır, bütün katmanları kırpar: dışarıdaki hücreler NoData olur, harita da sınırla biter (sdm_mask.py:304-418). Erişilebilir alan yalnız arka plan ve yalancı yoklukların çekileceği hücreleri sınırlar; harita yine sınırın ya da raster kapsamının tamamı için üretilir (sdm_core.py:2181-2203). Barve vd. (2011) anlamındaki M alanını tanımlamak için erişilebilir alan kullanılmalıdır; sınırı M olarak kullanmak modelin izdüşüm alanını da M'ye indirir.
S11. Bellek gereksinimi nasıl hesaplanıyor?
Cevap: Her sürekli katman tam olarak belleğe okunur; float32'ye kayıpsız sığan kaynaklar (float32, 16 bitlik tamsayılar) float32, ötekiler float64 tutulur (sdm_core.py:1367-1379). Kod açıklamasına göre 2,5′ çözünürlükte 19 dünya katmanı 2,6 GB yer tutar. Belleği azaltmanın yolu bir çalışma sınırı vermektir; kırpılmış katmanlar yalnız sınırın kutusunu kapsar.
2.11 Sık hatalar ve tuzaklar
- Rasterler UTM'de, CSV derece cinsinden: kayıtların hepsi "outside raster extent" olur; ileti koordinat sistemini denetlemeyi söyler. CSV'yi raster sistemine çevirin.
- Sütun adları yok ve sıra "tür, enlem, boylam": konumla okumada ters gelir; "probably swapped" uyarısı çıkar. Sütunlara
longitudevelatitudeadlarını verin. - Koordinatlarda derece-dakika-saniye ya da tırnaklı ondalık virgül: "holds non-numeric coordinates" iletisiyle durur.
- Katmanlar farklı kapsamda kesilmiş: "Environmental rasters are not on the same grid." Hizalayın ya da bir çalışma sınırı verin.
- NoData değeri tanımlı olmayan katman: deniz hücreleri gerçek değer sanılır; kıyı kayıtları elenmez, arka plan denize düşer. Katmanın NoData değerini tanımlayın.
- Çok bantlı dosya: yalnız ilk bant okunur.
- Kategorik listede kalan bir sürekli katman (ör. tamsayı olarak saklanmış sıcaklık): ⚠ işaretine bakın ve
→ Continuousile taşıyın. - Sınırın ilk sıradaki katmanı kaba çözünürlükte: bütün katmanlar o ızgaraya indirilir.
- Çok türlü dosyada hiç tür işaretlenmemiş: çalıştırma durur.
2.12 Kaynaklar
Barve, N., Barve, V., Jiménez-Valverde, A., Lira-Noriega, A., Maher, S.P., Peterson, A.T., Soberón, J., Villalobos, F., 2011. The crucial role of the accessible area in ecological niche modeling and species distribution modeling. Ecological Modelling 222, 1810–1819. https://doi.org/10.1016/j.ecolmodel.2011.02.011
Hernandez, P.A., Graham, C.H., Master, L.L., Albert, D.L., 2006. The effect of sample size and species characteristics on performance of different species distribution modeling methods. Ecography 29, 773–785. https://doi.org/10.1111/j.0906-7590.2006.04700.x
Pearson, R.G., Raxworthy, C.J., Nakamura, M., Peterson, A.T., 2007. Predicting species distributions from small numbers of occurrence records: a test case using cryptic geckos in Madagascar. Journal of Biogeography 34, 102–117. https://doi.org/10.1111/j.1365-2699.2006.01594.x
Wisz, M.S., Hijmans, R.J., Li, J., Peterson, A.T., Graham, C.H., Guisan, A., NCEAS Predicting Species Distributions Working Group, 2008. Effects of sample size on the performance of species distribution models. Diversity and Distributions 14, 763–773. https://doi.org/10.1111/j.1472-4642.2008.00482.x