4. Değişkenler (② Variables)
Sekme: ② Variables · Kod: tabs/tab_vif.py (VIF + Correlation), tabs/tab_vif_advanced.py (Advanced Analysis), sdm_core.py compute_vif, compute_correlation_matrix, variable_priority_ranking (hesap)
4.1 Bu sekme ne yapar
② Variables, ① Data adımında yüklenen sürekli öngörücüler arasındaki çoklu doğrusallığı (collinearity: bir öngörücünün öteki öngörücülerin doğrusal bir bileşimine yakın olması) gösterir ve modele girecek değişkenleri seçtirir. Seçimi kullanıcı yapar. Program yalnız sıralar, işaretler ve bir başlangıç önerisi (Recommended) sunar; onaylanmadan hiçbir değişken modelden çıkmaz.
- Girdi: ① Data'nın ürettiği sözde yokluk (pseudo-absence, PA) setleri (
state["pa_datasets"]) ve sürekli değişken adları (formatter.var_names). Kategorik rasterlar ayrı bir bölümde listelenir; VIF'e ve korelasyona girmez. - Çıktı: seçilen sürekli değişkenler (
state["var_names"]), seçilen ve dışarıda bırakılan kategorik rasterlar (state["cat_selected"],state["cat_excluded"]),figures/altına yazılan dört dosya (§4.8). - Kilit düzeni: sekme ① Data tamamlanınca açılır.
Confirm Variable Selection → Proceed to ③ Modelsdüğmesi ③ Models sekmesini açar ve oraya geçer (tabs/tab_vif.py:1206-1208).
Sekmenin iki alt sekmesi vardır: VIF + Correlation (seçimin yapıldığı yer) ve Advanced Analysis (koşul sayısı, temel bileşenler, LASSO ve Ridge ile tamamlayıcı tanı). İkinci alt sekme seçim yapmaz; yalnız bilgi verir.
4.2 Ekranın düzeni
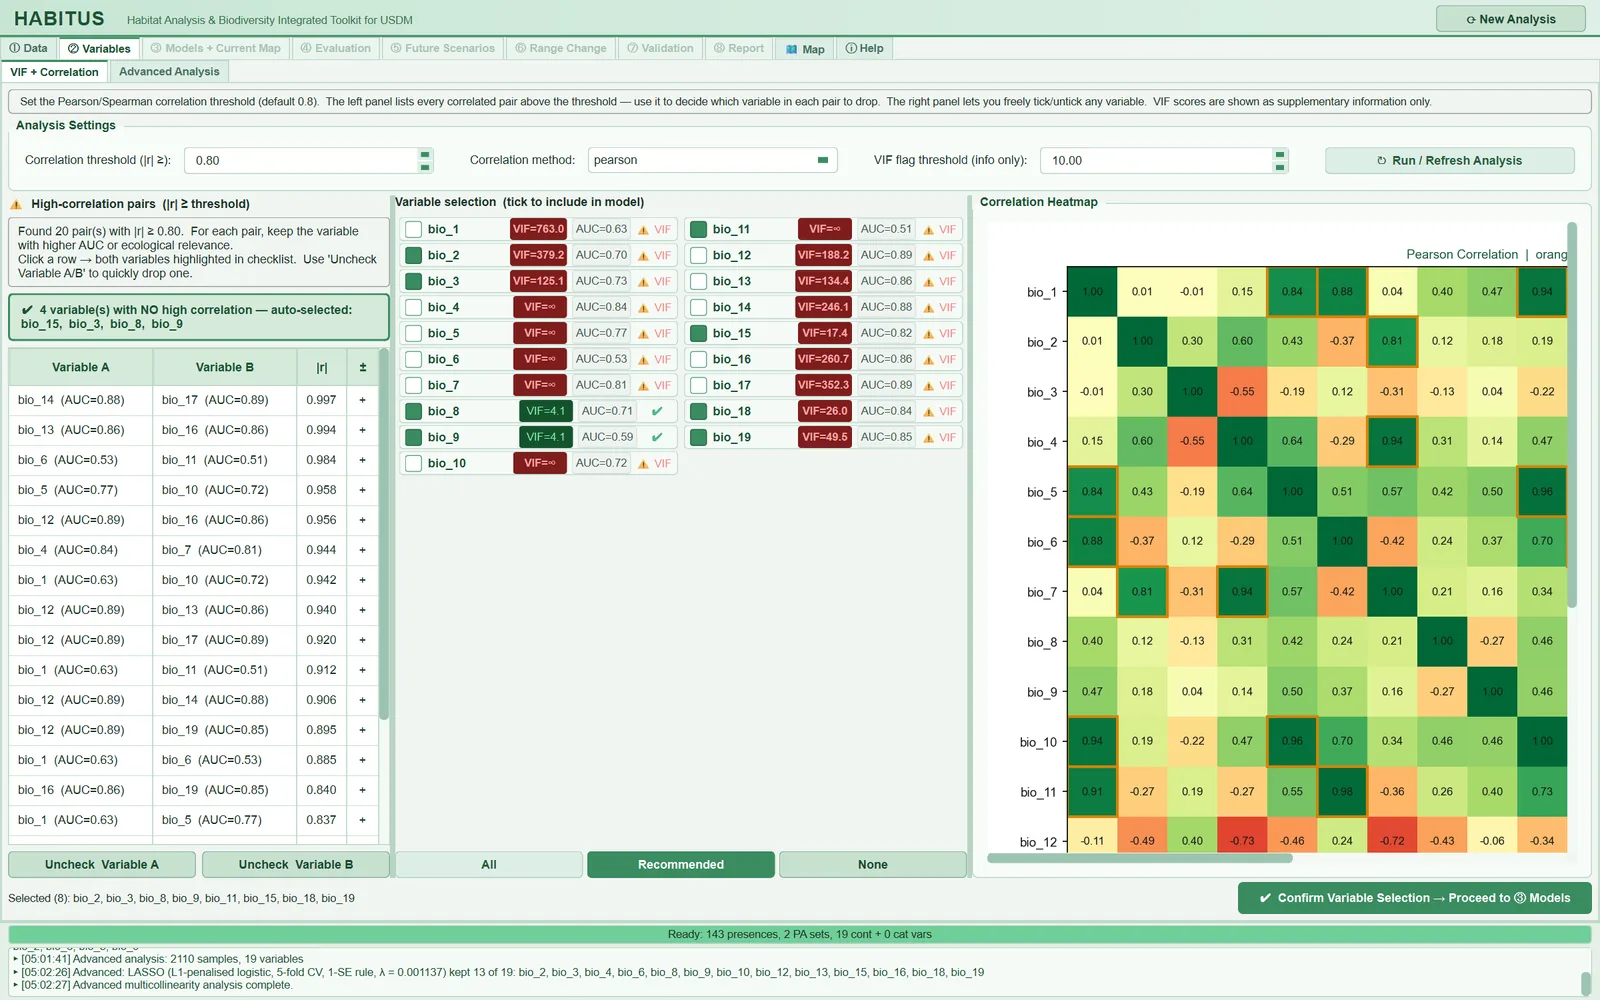
Şekil 4.1 örnek koşudan alınmıştır (Abies nordmanniana, 143 kullanılan varlık, 2 PA seti × 1000 nokta, 19 WorldClim biyoiklim değişkeni). Bölgeler:
| Bölge | Ne içerir | Alt bölüm |
|---|---|---|
Üst bilgi şeridi ve Analysis Settings |
Korelasyon eşiği, korelasyon yöntemi, VIF eşiği, Run / Refresh Analysis |
§4.4 |
Sol panel High-correlation pairs (|r| ≥ threshold) |
Eşiği aşan çiftler tablosu, "güvenli" değişken kutusu, Uncheck Variable A/B |
§4.5 |
Orta panel Variable selection (tick to include in model) |
Her sürekli değişken için onay kutusu, VIF rozeti, AUC rozeti, durum simgesi; altında kategorik bölüm; All, Recommended, None |
§4.6 |
Sağ panel Correlation Heatmap |
Kare hücreli korelasyon matrisi; eşiği aşan hücreler turuncu çerçeveli | §4.5.3 |
| Alt şerit | Seçim özeti ("Selected (n): …") ve Confirm Variable Selection → Proceed to ③ Models |
§4.7 |
Advanced Analysis alt sekmesi |
Condition Number, PCA, LASSO (L1), Ridge (L2) |
§4.9 |
4.3 Hesaplar hangi örnek üzerinde yapılır
Bu sekmedeki bütün sayılar bir örneklem üzerinde hesaplanır, rasterın bütün hücreleri üzerinde değil. Örneklem, ① Data'nın ürettiği PA setlerinin alt alta eklenmesidir: her set, kullanılan varlıkların tamamını ve o setin sözde yokluklarını içerir (tabs/tab_vif.py:349-353, sdm_core.py:3221-3226). Örnek koşuda bu 2 × (143 + 1000) = 2286 satırdır. MaxEnt'in arka plan noktaları (10 000) bu havuza girmez.
İki alt sekme havuzu farklı hazırlar:
VIF + Correlationhavuzu olduğu gibi kullanır; yalnız eksik değer içeren satırları atar (dropna). Her varlık, PA seti sayısı kadar (örnekte iki kez) yer alır.Advanced Analysisyinelenen satırları atar: her PA setinde aynı olan varlıklar bir kez sayılır, iki sette rastlantıyla aynı hücreye düşen sözde yokluklar da tekilleşir (tabs/tab_vif_advanced.py:356-363). Örnek koşuda kalan satır sayısı 2110'dur (Şekil 4.2'deki durum satırı: "2110 samples × 19 variables").
Not: VIF ve korelasyon, öngörücülerin kendi aralarındaki ilişkisidir; varlık/yokluk etiketine bakmaz. Ama hangi noktalarda ölçüldüğüne bağlıdır. Erişilebilir alan (① Data) geniş tutulursa sözde yokluklar daha geniş bir iklim aralığına yayılır ve korelasyonlar değişebilir. Aynı katmanların bütün çalışma alanındaki korelasyonu ile bu örneklemdeki korelasyon aynı olmak zorunda değildir.
Tek değişkenli AUC (aşağıda) ise etikete bakar: varlıklar 1, sözde yokluklar 0 alınır.
4.4 Analiz ayarları (Analysis Settings)
Bu şerit, çiftler tablosunun, ısı haritasının ve Recommended önerisinin hangi eşiklerle kurulacağını belirler.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Correlation threshold (|r| ≥): |
Bu değere eşit ya da büyük mutlak korelasyonlu çiftleri listeler, ısı haritasında çerçeveler; Recommended'ın ikinci adımında kullanılır |
0.80 | 0.30–0.99, adım 0.05 | tabs/tab_vif.py:123-130, sdm_core.py:435-445 |
Correlation method: |
Pearson (doğrusal) ya da Spearman (sıra) korelasyonu | pearson |
pearson, spearman |
tabs/tab_vif.py:132-136, sdm_core.py:300-302 |
VIF flag threshold (info only): |
Rozet renklendirmesi, VIF_OK bayrağı ve Recommended'ın adım adım VIF eşiği |
10.00 | 2–50, adım 1 | tabs/tab_vif.py:138-143, sdm_core.py:405, sdm_core.py:427-434 |
↻ Run / Refresh Analysis |
Sıralamayı, çiftleri, listeyi ve ısı haritasını yukarıdaki üç değerle yeniden hesaplar | — | düğme | tabs/tab_vif.py:339-376 |
4.4.1 Korelasyon eşiği (Correlation threshold)
- Ne işe yarar. Korelasyon matrisinin üst üçgeninde |r| \ge eşik olan her çifti sol tabloya yazar, |r|'ye göre büyükten küçüğe sıralar (
tabs/tab_vif.py:696-705) ve ısı haritasında bu hücreleri turuncu çerçeveyle işaretler (tabs/tab_vif.py:984-991). Hiçbir çiftte yer almayan değişkenleri "güvenli" sayar (§4.5.2).Run / Refresh Analysisile birlikteRecommended'ın korelasyon adımını da belirler (§4.6.2). - Ne zaman, nasıl ayarlanır. İpucu metni üç yaygın değeri verir: 0.70 (temkinli), 0.80 (varsayılan), 0.90 (gevşek). Dormann vd. (2013) benzetim çalışmalarında |r| > 0{,}7'nin, çoklu doğrusallığın model kestirimini ve öngörüyü ciddi biçimde bozmaya başladığı yaklaşık sınır olduğunu bildirir. Model başka bir bölgeye ya da iklime aktarılacaksa (gelecek senaryosu) 0,70 daha güvenlidir; yalnız bugünkü dağılımın betimlenmesi isteniyorsa 0,80 çoğu zaman yeterlidir.
- Sonuca etkisi. Eşik düştükçe çift sayısı artar, güvenli değişken sayısı azalır,
Recommendeddaha az değişken bırakır. Örnek koşuda 0,80 eşiğiyle 20 çift listelenmiştir (Şekil 4.1; en güçlü çift bio_14–bio_17, |r| = 0{,}997). - Dikkat. Kutudaki değeri değiştirmek çift tablosunu ve ısı haritasını hemen yeniler (
tabs/tab_vif.py:880-884), amaRecommendedönerisini veCorr_OKbayrağını yenilemez; bunlar içinRun / Refresh Analysis'e basılmalıdır. Sekme ilk açıldığında gösterilen öneri, ① Data adımının otomatik ön hesabından gelir ve bu ön hesap 0,70 eşiğini, Pearson yöntemini ve VIF eşiği 10'u kullanır (sdm_core.py:3225-3227,sdm_core.py:305-309); kutuda ise 0.80 yazar. Arayüzdeki değerlerle hesaplanmış bir öneri için önceRun / Refresh Analysis'e basın.
4.4.2 Korelasyon yöntemi (Correlation method)
- Ne işe yarar.
pandas.DataFrame.corr(method=…)ile Pearson ya da Spearman matrisini hesaplar (sdm_core.py:300-302). Çiftler tablosu, ısı haritası, ortalama mutlak korelasyon (Mean_Corr) veRecommended'ın korelasyon adımı bu matrisi kullanır. VIF bu seçimden etkilenmez; VIF her zaman doğrusal regresyonla hesaplanır. - Ne zaman, nasıl ayarlanır. İpucu: "pearson: linear correlation (assumes normality)", "spearman: rank-based, robust to non-normality and outliers". Yağış değişkenleri gibi çarpık dağılımlı ya da tekdüze ama doğrusal olmayan ilişkili öngörücülerde Spearman daha uygundur.
- Sonuca etkisi. Spearman, tekdüze doğrusal olmayan ilişkileri de yakaladığı için genellikle daha çok çift listeler. VIF adımı değişmediğinden
Recommended'ın ilk aşaması aynı kalır. - Dikkat. Yöntem kutusu değiştirilince hiçbir şey kendiliğinden yenilenmez (kutuya bağlı bir sinyal yoktur,
tabs/tab_vif.py:132-136);Run / Refresh Analysis'e basılmalıdır.
4.4.3 VIF eşiği (VIF flag threshold (info only))
- Ne işe yarar. Üç yerde kullanılır: (1) değişken listesindeki VIF rozeti eşikten büyükse kırmızı, değilse yeşil olur (
tabs/tab_vif.py:443-462); (2)VIF_OKbayrağı \text{VIF} \le eşik ve \text{VIF} < 999 olduğunda doğrudur (sdm_core.py:405); (3)Run / Refresh Analysis'ten sonraRecommended'ın adım adım VIF aşaması bu eşiğe kadar değişken çıkarır (sdm_core.py:427-434,tabs/tab_vif.py:357). - Ne zaman, nasıl ayarlanır. 10 yaygın kullanılan sınırdır; usdm::vifstep'in varsayılanı da
th = 10'dur. O'Brien (2007) bu tür eşiklerin kural olarak değil, örneklem büyüklüğü ve amaçla birlikte değerlendirilmesi gereken işaretler olarak okunması gerektiğini tartışır. Katsayıları yorumlanacak GLM ve GAM gibi modellerde 5 gibi daha sıkı bir eşik düşünülebilir. - Sonuca etkisi. Eşik düştükçe
Recommendeddaha az değişken bırakır. Değişkeni kendiliğinden çıkarmaz: listedeki işaretler değişmez, yalnızRecommendeddüğmesine basıldığında yeni öneri uygulanır. - Dikkat. Arayüzdeki "(info only)" ifadesi ve ipucundaki "does NOT force deselection" cümlesi, eşiğin hiçbir değişkeni zorla çıkarmadığı anlamındadır. Eşik yine de
Recommendedönerisini belirler. Kutudaki değeri değiştirmek tek başına bir şey yenilemez;Run / Refresh Analysisgerekir.
4.4.4 VIF nasıl hesaplanır
Her sürekli değişken x_i, öteki bütün sürekli değişkenlere kesişimli doğrusal regresyonla bağlanır (sklearn.linear_model.LinearRegression) ve
hesaplanır (sdm_core.py:221-297). Ayrıntılar:
- Yalnız x_i'nin ve öteki değişkenlerin hepsinin sonlu olduğu satırlar kullanılır; 10'dan az böyle satır varsa ya da değişken sabitse sonuç
NaN'dir ve rozetVIF=—gösterir (sdm_core.py:269-282). - R^2, kayan nokta taşmasına karşı [0, 1] aralığına kırpılır. R^2 > 0{,}9999 ise (gerçek VIF 10 000'in üstünde) değer 999'a sabitlenir ve rozet
VIF=∞gösterir (sdm_core.py:286-295,tabs/tab_vif.py:447-451). Bu, WorldClim'de birbirinden türetilmiş değişkenlerde olağandır (ör. bio_7 = bio_5 − bio_6). - En az iki değişken gerekir; tek değişkenle VIF tanımsızdır ve sıralama tablosu her değişkene VIF = 1 yazar (
sdm_core.py:356-368).
4.5 Yüksek korelasyonlu çiftler ve ısı haritası
Sol panel ve sağdaki ısı haritası aynı korelasyon matrisinden kurulur. Amaç, birbirinin yerine geçen değişken çiftlerini göstermek ve her çiftten hangisinin bırakılacağına kullanıcının karar vermesini kolaylaştırmaktır.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Çift tablosu (Variable A, Variable B, |r|, ±) |
Eşiği aşan her çift; ad yanında tek değişkenli AUC; mutlak r ve işaret | — | — | tabs/tab_vif.py:682-801 |
| Çift satırına tıklama | İki değişkenin listedeki çerçevesini turuncu vurgular ve görünür alana kaydırır | — | — | tabs/tab_vif.py:827-865 |
Uncheck Variable A / Uncheck Variable B |
Seçili çiftin ilk / ikinci değişkeninin işaretini kaldırır | — | düğme | tabs/tab_vif.py:209-221, 867-878 |
| Güvenli değişken kutusu | Hiçbir çiftte yer almayan değişkenler ("auto-selected") | — | — | tabs/tab_vif.py:707-729 |
Correlation Heatmap |
Kare hücreli matris; RdYlGn renk ölçeği, −1…+1 | — | — | tabs/tab_vif.py:937-1009 |
4.5.1 Çift tablosunun sütunları
Variable A,Variable B: çiftin iki değişkeni, matristeki doğal sıraya göre (bio_1 önce, bio_10 sonra). Adın yanında parantez içinde o değişkenin tek değişkenli AUC'si yazar ve iki değişkenden AUC'si düşük olan kırmızı, yüksek olan yeşil gösterilir (tabs/tab_vif.py:752-772).|r|: mutlak korelasyon, üç ondalık. Renk: \ge 0{,}95 kırmızı, \ge 0{,}85 turuncu, altı nötr (tabs/tab_vif.py:777-785).±: korelasyonun işareti (+ya da−).
Panelin üstündeki bilgi metni çift sayısını yazar ("Found 20 pair(s) with |r| ≥ 0.80"). Hiç çift yoksa "No variable pairs exceed |r| ≥ … All variables can be safely used together." yazar.
Dikkat: Çift tablosunun AUC renklendirmesi ve bilgi metnindeki "keep the variable with higher AUC or ecological relevance" önerisi,
Recommended'ın ölçütüyle aynı değildir:Recommendedbir çiftten VIF'i yüksek olanı çıkarır, AUC'ye bakmaz (§4.6.2). Tek değişkenli AUC yalnız bilgi içindir; bu örnekte iyi ayırt eden bir değişken, gerçek etkenle korelasyonu yüzünden iyi ayırt ediyor olabilir ve aktarımda başarısız olabilir (sdm_core.py:323-339). Bir çiftten hangisinin kalacağına öncelikle türün ekolojisi karar vermelidir.
4.5.2 Güvenli değişkenler
Eşiği aşan hiçbir çiftte yer almayan değişkenler yeşil bir kutuda "N variable(s) with NO high correlation — auto-selected" başlığıyla listelenir. Liste yeniden kurulduğunda bu değişkenler her zaman işaretli gelir (tabs/tab_vif.py:427-431). Örnek koşuda 0,80 eşiğiyle dört değişken güvenlidir: bio_15, bio_3, bio_8, bio_9 (Şekil 4.1).
Not: "Güvenli" yalnız ikili korelasyon anlamındadır. Bir değişken hiçbir tek değişkenle güçlü ilişkili olmadan birkaçının bileşimine yakın olabilir; bunu VIF gösterir. Örnekte bio_3 hiçbir çiftte değildir ama tam kümede VIF'i 125,1'dir.
Recommendedgüvenli değişkenleri otomatik eklemez; yalnız adım adım seçimin sonucunu uygular (tabs/tab_vif.py:900-915).
4.5.3 Korelasyon ısı haritası
Isı haritası seçilen yöntemle hesaplanan bütün sürekli değişkenlerin matrisini gösterir. Hücreler kare ve sabit boyutludur (25 değişkene kadar 0,5 inç, daha fazlasında 0,4 inç); matris büyükse sıkıştırılmaz, kaydırma çubuğuyla gezilir (tabs/tab_vif.py:953-963). 25 değişkene kadar hücre değerleri iki ondalıkla yazılır. Eşiği aşan köşegen dışı hücreler turuncu çerçevelidir; başlık "Pearson Correlation | orange border = |r| ≥ 0.80" biçimindedir. Her çizimde şekil figures/correlation_heatmap.png olarak 300 dpi kaydedilir (çıktı klasörü tanımlıysa; tabs/tab_vif.py:1006-1009).
4.6 Değişken listesi ve toplu seçim
Orta paneldeki liste, modele girecek sürekli değişkenlerin seçildiği yerdir. 12'den fazla değişken varsa iki sütuna bölünür (tabs/tab_vif.py:522-528).
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
| Değişken onay kutusu | İşaretli değişken modele girer | güvenli değişkenler ve Recommended önerisi işaretli |
açık / kapalı | tabs/tab_vif.py:423-438 |
| VIF rozeti | Tam kümedeki VIF; yeşil ≤ eşik, kırmızı > eşik, VIF=∞ sabitlenmiş, VIF=— hesaplanamadı |
— | — | tabs/tab_vif.py:441-469 |
| AUC rozeti | Tek değişkenli AUC; nötr renk, yalnız bilgi | — | 0,5–1 | tabs/tab_vif.py:471-499, sdm_core.py:380-393 |
| Durum simgesi | ⚠ VIF (VIF_OK yanlış), ⚠ Corr (Corr_OK yanlış), ✔ (önerilen), – |
— | — | tabs/tab_vif.py:501-517 |
All |
Bütün sürekli değişkenleri işaretler | — | düğme | tabs/tab_vif.py:890-893 |
Recommended |
Adım adım seçimin sonucunu uygular, çıkarmaları günlüğe yazar | — | düğme | tabs/tab_vif.py:900-915 |
None |
Bütün sürekli değişkenlerin işaretini kaldırır | — | düğme | tabs/tab_vif.py:895-898 |
4.6.1 Öncelik tablosu ve sütunları
variable_priority_ranking her değişken için bir satır üretir; liste rozetleri bu tablodan okunur ve tablo onayla birlikte figures/variable_priority_ranking.csv olarak yazılır (sdm_core.py:305-465, tabs/tab_vif.py:1083-1096). Satırlar Priority_Score'a göre büyükten küçüğe sıralıdır.
| Sütun | Anlamı |
|---|---|
Variable |
Değişken adı |
VIF |
Tam kümedeki VIF (iki ondalık; 999 = sabitlenmiş) |
Mean_Corr |
Öteki değişkenlerle ortalama mutlak korelasyon (köşegen 0 alınarak) |
Univariate_AUC |
Değişkenin tek başına varlık ile sözde yokluğu ayırma gücü; 0,5'in altındaysa 1 - \text{AUC} alınır |
Priority_Score |
0{,}5\,(1 - (\min(\text{VIF}, 50) - 1)/49) + 0{,}5\,(1 - \text{Mean\_Corr}), [0, 1]'e kırpılmış |
VIF_OK |
\text{VIF} \le eşik ve \text{VIF} < 999 |
Corr_OK |
Mean_Corr < korelasyon eşiği |
Recommended |
Adım adım seçimde kaldı mı |
VIF_in_selection |
Önerilen küme içindeki VIF (önerilmeyenlerde boş) |
Priority_Score yalnız çoklu doğrusallığa dayanır; tek değişkenli AUC tabloda bilgi olarak durur ama sıralamaya ağırlık olarak girmez (sdm_core.py:395-401). Gerekçe kodda açıktır: bu örneklemde iyi ayırt eden bir öngörücüyü öne çıkarmak, ekolojik anlamı ve başka bölgeye ya da iklime aktarılabilirliği gözetmeyen bir seçim olur.
Not:
Corr_OK, tek tek çiftlere değil değişkenin ortalama mutlak korelasyonuna bakar. Örnek koşuda 0,70 eşiğiyle 19 değişkenin hepsindeCorr_OKdoğrudur (en yüksekMean_Corrbio_12'de 0,533), oysa 20 çift 0,80'i aşar. Bu yüzden⚠ Corrsimgesi seyrek görülür; çiftleri sol tablo gösterir.
4.6.2 Önerilen seçim (Recommended): adım adım VIF ve korelasyon çifti
-
Ne işe yarar.
Recommendeddüğmesi,variable_priority_ranking'inRecommendedsütununu listeye uygular; başka hiçbir değişkeni işaretli bırakmaz (tabs/tab_vif.py:907-909). Bu sütun iki aşamalı bir süreçle bulunur (sdm_core.py:427-447):- Adım adım VIF. Bütün sürekli değişkenlerle başlanır. Kalan kümenin VIF'leri yeniden hesaplanır; en büyük VIF eşikten büyükse o değişken çıkarılır. En büyük VIF eşiğe eşit ya da altında kalınca ya da tek değişken kalınca durulur.
- Korelasyon çifti. Kalan değişkenler arasında |r| \ge korelasyon eşiği olan çiftlerden en güçlüsü bulunur; çiftin iki üyesinden kalan kümedeki VIF'i büyük olan çıkarılır (eşitse ilki). Hiç böyle çift kalmayana kadar sürer.
Çıkarılan her değişken, çıkarıldığı andaki VIF ya da |r| değeriyle sırasıyla günlüğe yazılır.
-
Ne zaman, nasıl ayarlanır. Bir başlangıç noktası olarak kullanılır. İpucu metni de bunu söyler: "A starting point: check it against what you know of the species." Önce eşikleri ayarlayın,
Run / Refresh Analysis'e basın, sonraRecommended'a basın ve sonucu türün ekolojisine göre elle düzeltin (bir çiftten ekolojik olarak daha anlamlı olanı tutmak gibi). - Sonuca etkisi. Örnek koşuda adım adım seçim 11 değişkeni şu sırayla çıkarmıştır: bio_4 (VIF 999), bio_5 (999), bio_1 (757,27), bio_7 (653,22), bio_17 (346,39), bio_16 (236,16), bio_6 (130,1), bio_12 (80,89), bio_10 (74,4), bio_14 (26,21), bio_13 (15,98). Kalan sekiz değişken bio_2, bio_3, bio_8, bio_9, bio_11, bio_15, bio_18, bio_19'dur; bu küme içindeki VIF'ler 1,65 (bio_15) ile 6,43 (bio_18) arasındadır ve aralarında korelasyon eşiğini aşan çift kalmadığından ikinci aşama bir şey çıkarmamıştır (
_calisma/figures/variable_priority_ranking.csv, oturum günlüğü). Tam kümede yalnız iki değişkenin (bio_8 ve bio_9) VIF'i 10'un altındadır; tam küme VIF'ine göre süzmek bu yüzden çok az değişken bırakırdı. Adım adım yöntem bu sorunu giderir. - Dikkat. Adım adım yöntem tam kümedeki VIF'e göre değil, her adımda yeniden hesaplanan VIF'e göre çalışır. Bu yüzden tam kümede
VIF=∞gösteren bir değişken (örnekte bio_11) önerilen kümede kalabilir; listedeki rozet tam kümeyi,VIF_in_selectionsütunu önerilen kümeyi anlatır. Sabitlenmiş değerler (999) eşit olduğunda değişkenlerin doğal sırasındaki ilki çıkarılır (v_now.idxmax(),sdm_core.py:430); bu durumda çıkarma sırası, VIF'i sabitlemeyen bir hesaptan farklı olabilir (§4.11, S2).
usdm::vifstep ile aynı sonuç
Adım adım VIF aşaması, R'deki usdm paketinin vifstep işlevinin (Naimi vd. 2014) yaptığı işi yapar. Bu kitap için ikisi aynı matriste karşılaştırılmıştır: çalışma sınırı (10° B–50° D, 30–46° K) içinden rastgele seçilmiş 5000 kara hücresinde 19 WorldClim 2.1 biyoiklim değişkeni; HABITUS'ta variable_priority_ranking(..., vif_threshold=10), R'de usdm::vifstep(d, th = 10) (betik: habitus_dogrulama\H3_yazilim_tanitim\betikler\Y10_vif_usdm.py). İki program 11 değişkeni aynı sırayla çıkarmıştır (bio_5, bio_10, bio_11, bio_16, bio_7, bio_17, bio_1, bio_12, bio_3, bio_13, bio_18) ve kalan sekiz değişkenin VIF'leri on dördüncü ondalığa kadar aynıdır:
| Değişken | usdm::vifstep VIF | HABITUS VIF |
|---|---|---|
| bio_2 | 2,375571 | 2,375571 |
| bio_4 | 2,524650 | 2,524650 |
| bio_6 | 6,864633 | 6,864633 |
| bio_8 | 2,787451 | 2,787451 |
| bio_9 | 6,130096 | 6,130096 |
| bio_14 | 3,548789 | 3,548789 |
| bio_15 | 3,131781 | 3,131781 |
| bio_19 | 2,161437 | 2,161437 |
(Kaynak: habitus_dogrulama\H3_yazilim_tanitim\yazim\dogrulama_vif_usdm.csv; tablo altı ondalığa yuvarlanmıştır.) Karşılaştırmada korelasyon eşiği 0,99 tutulmuş, yani ikinci aşama devre dışı bırakılmıştır; usdm'de bu aşamanın karşılığı yoktur (usdm::vifcor korelasyonu önce ve farklı bir kuralla uygular).
4.6.3 Tek değişkenli AUC
Her değişken için sklearn.metrics.roc_auc_score(y, x) hesaplanır; 0,5'in altındaysa ilişki ters yönlü sayılıp 1 - \text{AUC} yazılır (sdm_core.py:380-393). 10'dan az geçerli satır varsa ya da hesap başarısızsa 0,5 yazılır. Rozet bilerek nötr renklidir: düşük AUC bir değişkeni çıkarmak için gerekçe değildir (tabs/tab_vif.py:471-499). Örnek koşuda en yüksek değerler yağış değişkenlerindedir (bio_12 0,887; bio_17 0,886), en düşükler sıcaklık değişkenlerinde (bio_11 0,51; bio_6 0,533).
4.6.4 Kategorik değişken bölümü
Veride kategorik raster varsa listenin altında Categorical variables (not part of VIF) başlıklı sabit bir kutu açılır (tabs/tab_vif.py:557-671). Her kategorik raster bir satırdır:
| Öğe | Ne yapar | Varsayılan | Kod |
|---|---|---|---|
| Onay kutusu | İşaretli raster modele girer | işaretli (önceki onay varsa o) | tabs/tab_vif.py:602-616 |
Sınıf rozeti (N classes) |
Sınıf sayısı; ipucunda sınıf başına "varlık / kayıt" (ilk PA seti) | — | tabs/tab_vif.py:618-639 |
| Sınıf sayımı metni | İlk dört sınıfın "sınıf:varlık/kayıt" değerleri | — | tabs/tab_vif.py:641-651 |
| Seyrek sınıf uyarısı | 3'ten az varlık içeren sınıf sayısı ("⚠ k classes <3 presences") | — | tabs/tab_vif.py:653-664, sdm_core.py:1264 |
Kategorik rasterlar VIF'e ve korelasyona girmez; All, Recommended ve None bu kutuya dokunmaz. İpucu metni her algoritmanın kategorik değişkeni nasıl kullandığını söyler: GLM, GLMNET, SVM ve ANN kukla (one-hot) sütunlarla; GAM faktör terimiyle; MaxEnt kategorik özellik sınıfıyla; ağaç tabanlı yöntemler tamsayı bölmeleriyle; BIOCLIM, Domain, ENFA, Mahalanobis ve ESM yalnız sürekli değişkenleri kullanır (tabs/tab_vif.py:536-545). Yalnız bir rasterın NoData'sı yüzünden ① Data'da kayıt düşmüşse ipucu bunu sayılarıyla yazar ve rasterı dışarıda bırakmanın örneklemeyi yeniden yapmadığını belirtir. Örnek koşuda kategorik raster yoktur, bu yüzden kutu görünmez.
4.7 Onay (Confirm) ve kayıt/öngörücü denetimi
| Arayüzdeki ad | Ne yapar | Varsayılan | Kod |
|---|---|---|---|
✔ Confirm Variable Selection → Proceed to ③ Models |
Seçimi kaydeder, dosyaları yazar, ③ Models'i açar | — | tabs/tab_vif.py:1160-1225 |
4.7.1 Onay
- Ne işe yarar. İşaretli sürekli değişkenleri doğal sırayla
state["var_names"]'e, kategorik seçimistate["cat_selected"]'e ve dışarıda bırakılanlarıstate["cat_excluded"]'e yazar (tabs/tab_vif.py:1187-1191). Değişkenlerin işaretlenme sırası önemli değildir; seçim her zaman doğal ada göre sıralanır (sdm_core.canonical_order). Ardından §4.8'deki dosyaları yazar, ③ Models'i açar ve onunAlgorithm Settingsalt sekmesine geçer. - Ne zaman, nasıl ayarlanır. Seçim bittiğinde bir kez basılır. Seçim sonradan değiştirilirse yeniden basılmalıdır; aksi hâlde ③ Models eski seçimi kullanır.
- Sonuca etkisi. Bundan sonraki bütün adımlar (modeller, gelecek projeksiyonları, yenilik haritaları) yalnız onaylanan değişkenleri kullanır.
- Dikkat. En az iki sürekli değişken gerekir: hiç seçim yoksa "Please select at least one variable.", tek değişken varsa "At least 2 variables are needed for modelling. Please select more variables." iletisi çıkar (
tabs/tab_vif.py:1162-1167). Modeller daha önce çalıştırılmışsa "Re-confirm Variable Selection" penceresi, onaylamanın bütün modelleri, haritaları, projeksiyonları ve değerlendirme sonuçlarını sileceğini söyler;Yesdenirse bunlar silinir (tabs/tab_vif.py:1170-1185,main_dialog.py:528-542).
4.7.2 Kayıt/öngörücü denetimi
Onaydan sonra program, kullanılan varlık sayısını seçilen öngörücü sayısına (sürekli + kategorik) böler (sdm_core.py:2889-2909). Oran 10'un altındaysa bilgi penceresinin başına ve günlüğe ("ADVISORY: …") şu biçimde bir uyarı ekler: "… presence records for the k predictors selected (… per predictor). Below about 10 per predictor the model is prone to overfitting and the evaluation statistics become unstable; n records support about n/10 predictors." Bu, ① Data'daki aynı denetimin seçilmiş küme için yinelenmesidir; ① Data yalnız yüklenen katman sayısını görebilir. Örnek koşuda 143 varlık ve 19 katmanla ① Data uyarı vermişti (7,5 kayıt/öngörücü; "143 records allow about 14"); seçilen 8 değişkenle oran 17,9 olduğundan onayda uyarı çıkmamıştır. Yeni bir onay eski uyarının yerine geçer.
4.8 Dışa aktarma
VIF + Correlation alt sekmesi onayla birlikte çıktı klasörünün figures/ alt klasörüne şunları yazar (tabs/tab_vif.py:1193-1197):
| Dosya | İçerik |
|---|---|
high_correlation_pairs.csv |
Variable_A, Variable_B, Correlation_r, AUC_A, AUC_B, Direction, Recommend_drop (eşiği aşan çiftler) |
variable_priority_ranking.csv |
§4.6.1'deki tablo |
vif_barplot.png |
Tam küme VIF çubukları; eşik (kesikli) ve 10 (noktalı) çizgisi; çubuk 50'de kesilir, ∞ ve "(>50, capped)" etiketleri |
correlation_heatmap_selected.png |
Yalnız seçilen değişkenlerin korelasyon matrisi |
Bunlara ek olarak correlation_heatmap.png her ısı haritası çiziminde yazılır. Çıktı klasörü tanımlı değilse hiçbir dosya yazılmaz.
Dikkat:
high_correlation_pairs.csv'dekiRecommend_dropsütunu, çiftten tek değişkenli AUC'si düşük olanı yazar (tabs/tab_vif.py:1066-1070). Bu,Recommended'ın kuralından (VIF'i yüksek olanı çıkar) farklıdır ve bir öneri değil, AUC karşılaştırmasıdır.
Advanced Analysis'in Save All Results... düğmesi ayrıca advanced_analysis/ klasörüne yazar (§4.9.6). Raporun (⑧) değişken bölümü ve ODMAP dışa aktarımı, bu sekmedeki korelasyon eşiğini, yöntemini ve VIF eşiğini okur (tabs/tab_report.py:528-530, odmap.py:487-492).
4.9 Gelişmiş analiz (Advanced Analysis)
Bu alt sekme dört tamamlayıcı tanı sunar. Hiçbiri değişken listesindeki işaretleri değiştirmez; önerileri (PCA'daki RECOMMENDED, LASSO'daki SELECTED) yalnız bilgi içindir.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Run All Analyses |
Dört analizi sırayla çalıştırır | — | düğme | tabs/tab_vif_advanced.py:384-407 |
Save All Results... |
Grafikleri ve tabloları advanced_analysis/'e yazar |
ilk çalıştırmaya kadar devre dışı | düğme | tabs/tab_vif_advanced.py:760-891 |
Penalty λ: (LASSO) |
Cezanın nasıl seçileceği | 1-SE rule (CV) |
1-SE rule (CV), Minimum CV deviance, Typed value |
tabs/tab_vif_advanced.py:259-269 |
| λ değer kutusu (LASSO) | Typed value seçiliyken kullanılan λ |
0.0100 (devre dışı) | 0.0001–10, 4 ondalık | tabs/tab_vif_advanced.py:270-281 |
CV folds: |
LASSO ve Ridge için katmanlı çapraz doğrulama kat sayısı | 5 | 3–10 | tabs/tab_vif_advanced.py:282-284 |
Recompute |
Yalnız LASSO'yu yeniden hesaplar | — | düğme | tabs/tab_vif_advanced.py:285-287, 409-415 |
4.9.1 Kapsam ve örnek
Analiz, VIF + Correlation'da onaylanmış değişkenleri kullanır. Henüz onay yoksa ya da onaylanan küme bütün sürekli değişkenleri kapsıyorsa bütün sürekli değişkenler kullanılır ve durum satırı bunu yazar: "Analyses all 19 continuous variables (not a selected subset): no subset has been confirmed in the VIF + Correlation tab." (tabs/tab_vif_advanced.py:337-345, 375-380). Örneklem, §4.3'teki tekilleştirilmiş PA havuzudur; sabit (varyansı 10^{-10}'dan küçük) sütunlar atılır ve günlüğe yazılır (tabs/tab_vif_advanced.py:365-373). Bu sırayla çalışmak önerilir: önce bütün değişkenlerle tanı, sonra onaydan sonra seçilen kümeyle yeniden Run All Analyses.
4.9.2 Koşul sayısı (Condition Number)
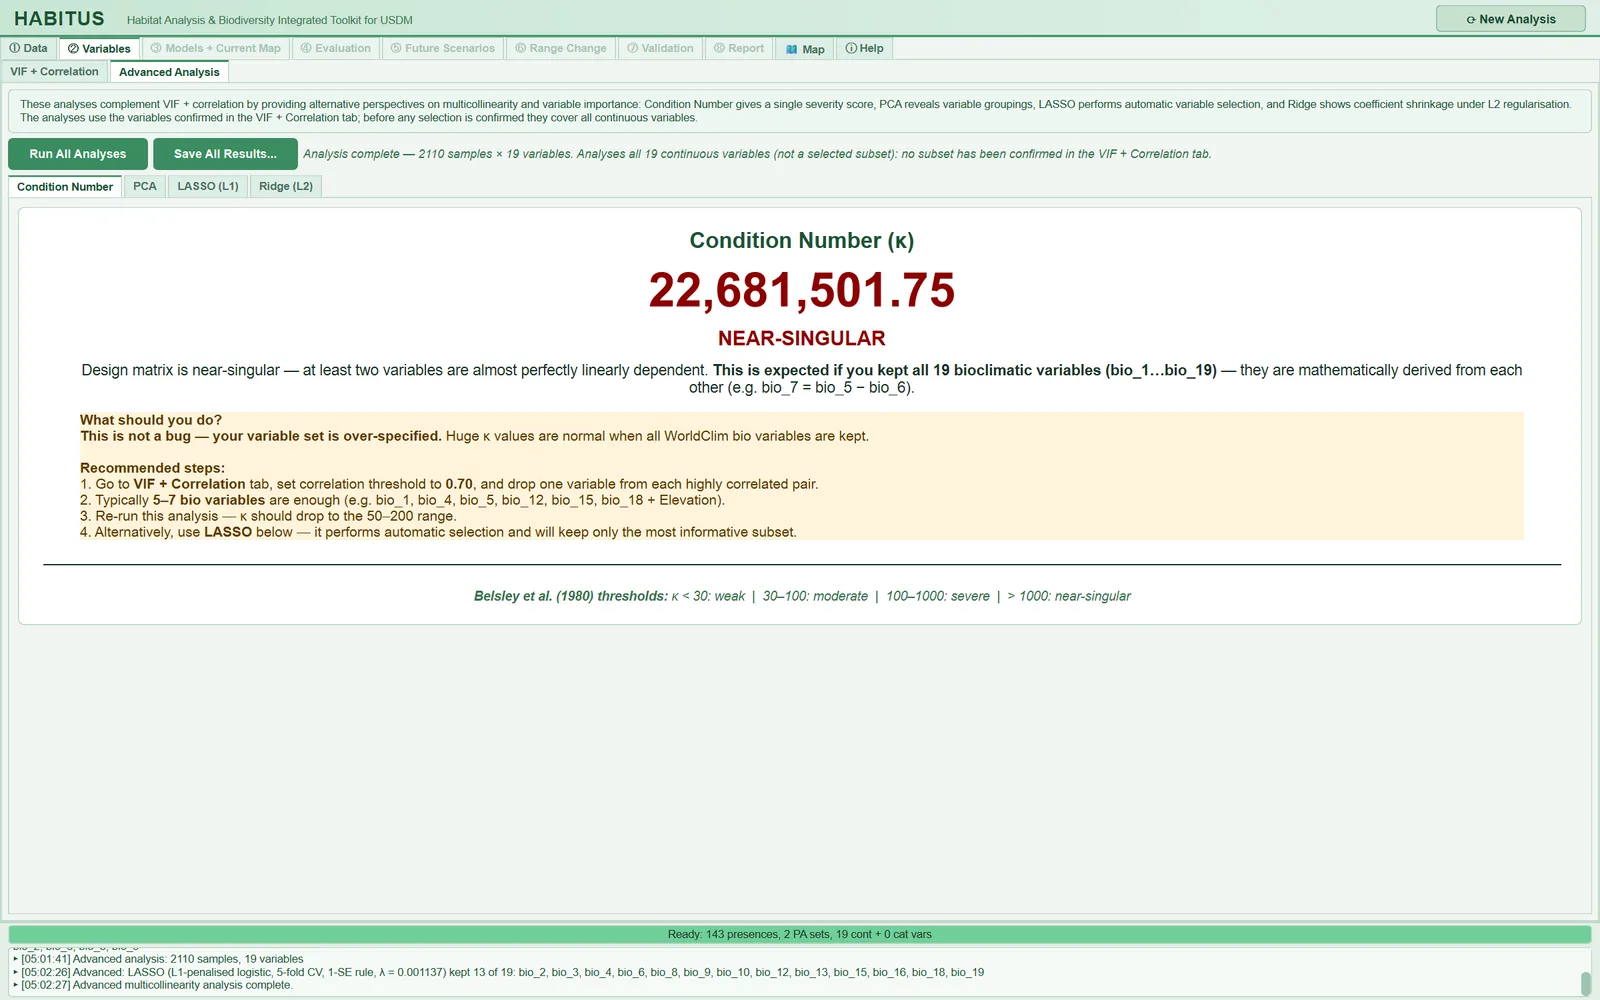
- Ne işe yarar. Değişkenler standartlaştırılır (ortalama 0, standart sapma 1), matrisin tekil değerleri hesaplanır ve \kappa = s_{\max}/s_{\min} yazılır (
tabs/tab_vif_advanced.py:419-431). 10^{-10}'dan küçük tekil değerler atılır; atılan varsa metne yakın doğrusal bağımlılık notu eklenir. Sınıflama: \kappa < 30LOW, 30 \le \kappa < 100MODERATE, 100 \le \kappa < 1000SEVERE, \kappa \ge 1000NEAR-SINGULAR; her sınıf için "What should you do?" kutusunda yapılacaklar yazar. - Ne zaman, nasıl ayarlanır. Ayarı yoktur. Bütün küme için bir kez, seçimden sonra bir kez bakmak yararlıdır: seçim sonrasında κ'nın düşmesi beklenir.
- Sonuca etkisi. Yalnız tanıdır. Örnek koşuda 19 değişkenle κ = 22 681 501,75'tir (Şekil 4.2); bu, birbirinden türetilmiş biyoiklim değişkenlerinin hepsi tutulduğunda beklenen bir değerdir.
- Dikkat. Ekrandaki eşikler Belsley vd. (1980)'e atfedilir. Belsley'nin ölçütü her tekil değer için koşul indeksleri ve varyans ayrıştırma oranlarıdır; tek bir κ ve dört sınıflık bu ölçek pratik bir özetlemedir. NEAR-SINGULAR sınıfının yapılacaklar kutusundaki öneriler ("Typically 5–7 bio variables are enough …", "κ should drop to the 50–200 range") genel yol göstericidir, bu veriye özgü bir hesap değildir.
4.9.3 Temel bileşenler (PCA)
- Ne işe yarar. Standartlaştırılmış değişkenlere
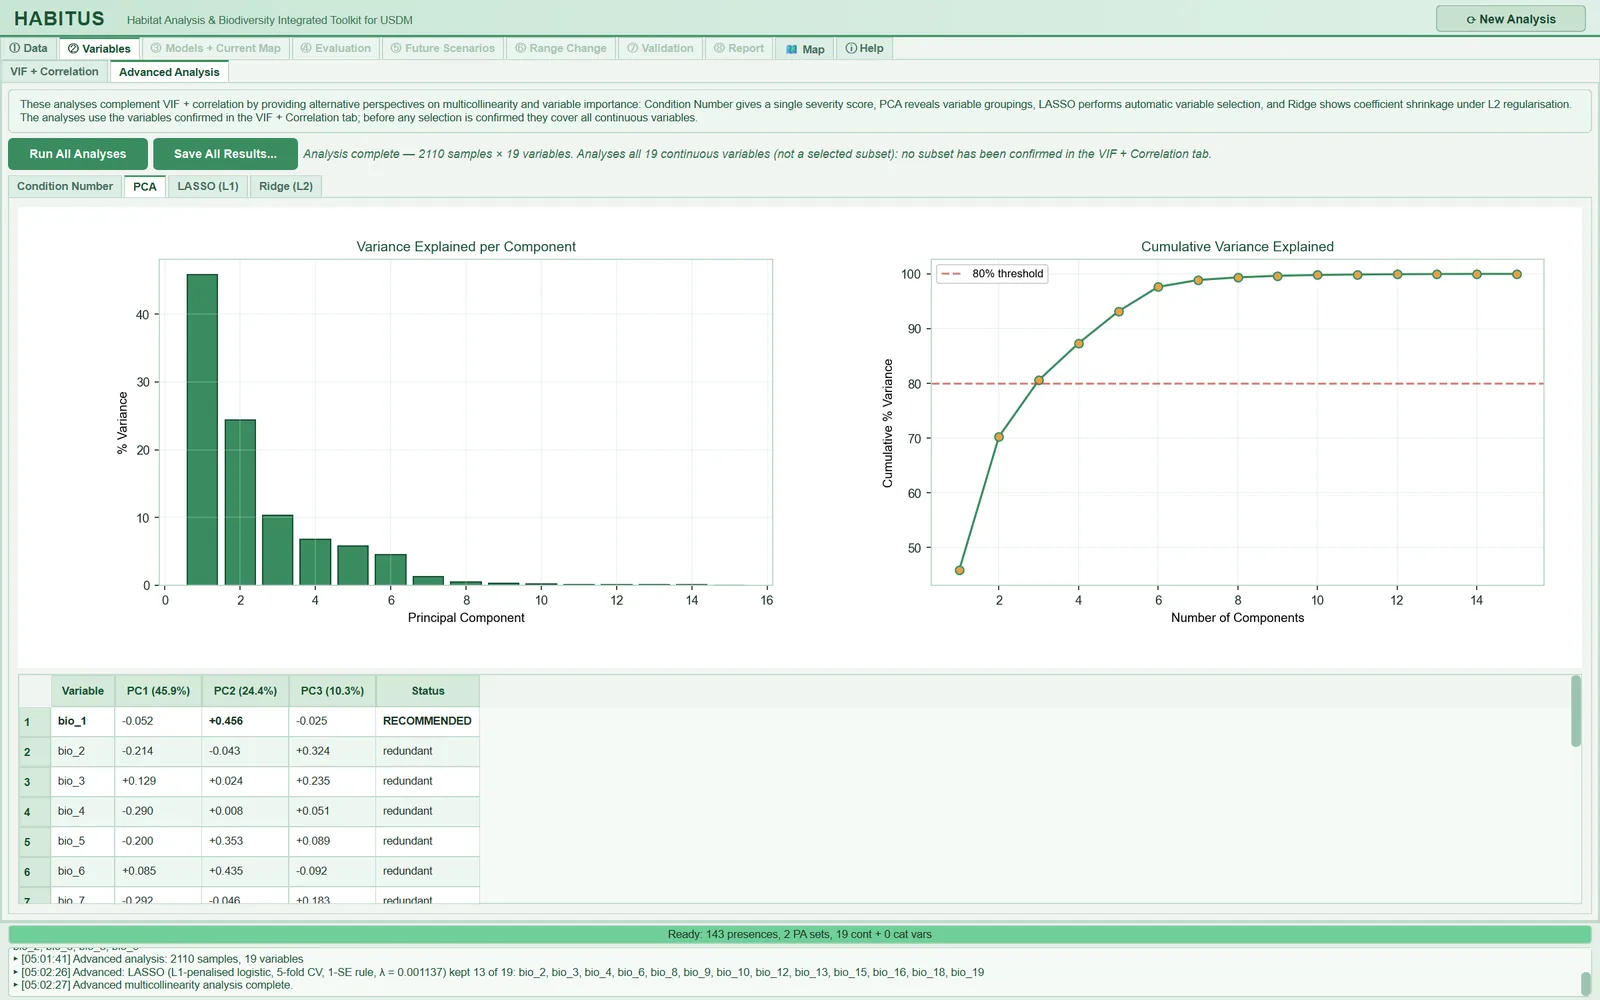
sklearn.decomposition.PCAuygulanır (tabs/tab_vif_advanced.py:499-596). Solda ilk 15 bileşenin açıkladığı varyans yüzdesi, sağda birikimli varyans ve %80 çizgisi çizilir. Tabloda birikimli varyansı %80'e ulaştıran k bileşenin yükleri (en az 2, en çok 8) gösterilir; sütun başlıkları bileşenin varyans payını yazar ("PC1 (45.9%)"). Her bileşende mutlak yükü en büyük değişken kalın ve yeşil vurgulanır veStatussütunundaRECOMMENDEDalır; öteki değişkenlerredundantyazar. |\text{yük}| > 0{,}4 olan öteki hücreler açık sarı boyanır. - Ne zaman, nasıl ayarlanır. Ayarı yoktur. Değişkenlerin hangi gruplarda toplandığını (örneğin sıcaklık ve yağış eksenleri) görmek için kullanılır.
- Sonuca etkisi. Yalnız bilgi. Örnek koşuda ilk üç bileşen varyansın %45,9, %24,4 ve %10,3'ünü açıklar; birikimli %80 üçüncü bileşende aşıldığı için tabloda üç bileşen vardır ve en çok üç değişken
RECOMMENDEDalır (Şekil 4.3'te görülen satırlarda bio_1, PC2'de +0,456 yükle). - Dikkat. Bileşen başına "en büyük yüklü değişken" kuralı bir sezgiseldir: iki bileşende aynı değişken en büyük yüke sahipse önerilen değişken sayısı k'dan az olur. %80 sınırı da gelenekseldir, koddan gelen sabit bir değerdir (
tabs/tab_vif_advanced.py:539-540).
4.9.4 LASSO (L1) — cezalı lojistik regresyon
-
Ne işe yarar. Varlık (1) / sözde yokluk (0) yanıtına, standartlaştırılmış öngörücülerle L1 cezalı lojistik regresyon (Tibshirani 1996) uyarlanır (
tabs/tab_vif_advanced.py:43-128,638-711). Ayrıntılar:- Varlıklar ve yokluklar eşit toplam ağırlık alır (
compute_sample_weight("balanced"); Barbet-Massin vd. 2012), böylece çok sayıdaki sözde yokluk sonucu belirlemez. - λ, glmnet ölçeğindedir: ortalama ağırlıklı binom sapması + λ × ceza; scikit-learn'ün
C'si 1/(n\lambda) alınır. 40 değerlik logaritmik ızgara, hiçbir değişkenin kalmadığı en küçük λ'dan (\lambda_{\max}) başlar ve \lambda_{\max}/1000'e iner. - Her λ için katmanlı k katlı çapraz doğrulamayla ağırlıklı binom sapması hesaplanır; her katta standartlaştırma yalnız eğitim kısmından yapılır. Kat sayısı
CV foldsile, ama az sınıfın gözlem sayısından büyük olmayacak biçimde ve en az 2 olarak belirlenir. 1-SE rule (CV): sapması en küçük sapmanın bir standart hatası içinde kalan en büyük λ (Hastie vd. 2009, §7.10).Minimum CV deviance: sapması en küçük λ.Typed value: kutuya yazılan λ ile bütün veriye tek bir uyum.- Mutlak katsayısı 10^{-8}'den büyük değişkenler
SELECTED, ötekilerdroppedyazar. Tablo mutlak katsayıya göre sıralıdır.
- Varlıklar ve yokluklar eşit toplam ağırlık alır (
-
Ne zaman, nasıl ayarlanır. Varsayılan
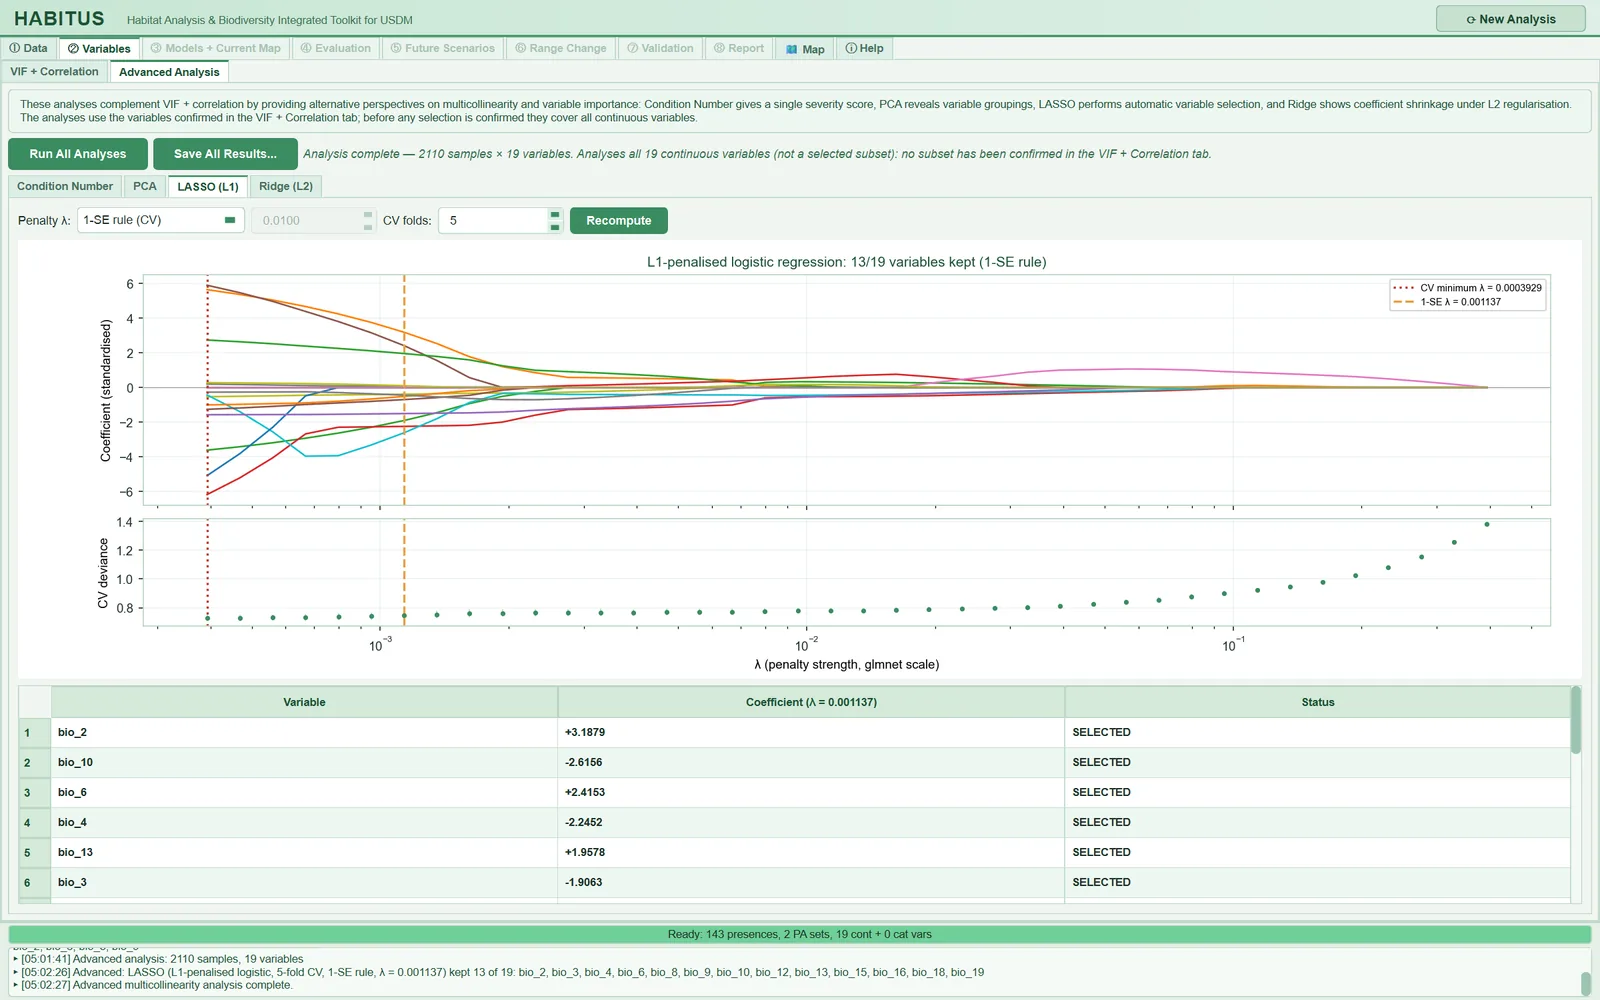
1-SE rule (CV)değişken seçimi için yaygın tercihtir: daha az ve daha kararlı değişken bırakır. Tahmin gücüne bakılıyorsaMinimum CV devianceseçilebilir. Çok az varlık varsa kat sayısını düşürmek (3) katların kararlılığını artırabilir. - Sonuca etkisi. Yalnız bilgi; model ayarlarına geçmez. Örnek koşuda (19 değişken, 2110 satır) 1-SE λ = 0,001137 ile 19 değişkenden 13'ü kalmıştır (bio_2, bio_3, bio_4, bio_6, bio_8, bio_9, bio_10, bio_12, bio_13, bio_15, bio_16, bio_18, bio_19); en küçük sapmanın λ'sı 0,0003929'dur (Şekil 4.4).
- Dikkat. LASSO, birbirine çok bağlı değişkenlerden birini neredeyse keyfî seçer; ilişkili değişkenler arasında seçim kararsızdır ve örneklemdeki küçük değişikliklerle değişebilir. Bu nedenle LASSO'nun tuttuğu küme ile
Recommended'ın kümesi farklıdır (örnekte bio_4, bio_6, bio_10, bio_12, bio_13, bio_16 LASSO'da kalmış, adım adım VIF'te çıkarılmıştır) ve bu beklenen bir durumdur: LASSO ayırt etme gücüne, adım adım VIF yalnız çoklu doğrusallığa bakar. Katsayılar havuzlanmış PA setleri üzerindedir; son modelin katsayıları değildir. Örnek koşuda en küçük sapma ızgaranın en küçük λ'sına denk gelmiştir; bu, ızgaranın daha küçük λ'lara uzatılması gerekebileceğini gösterir (bkz. S8).
4.9.5 Ridge (L2) — katsayı büzülmesi
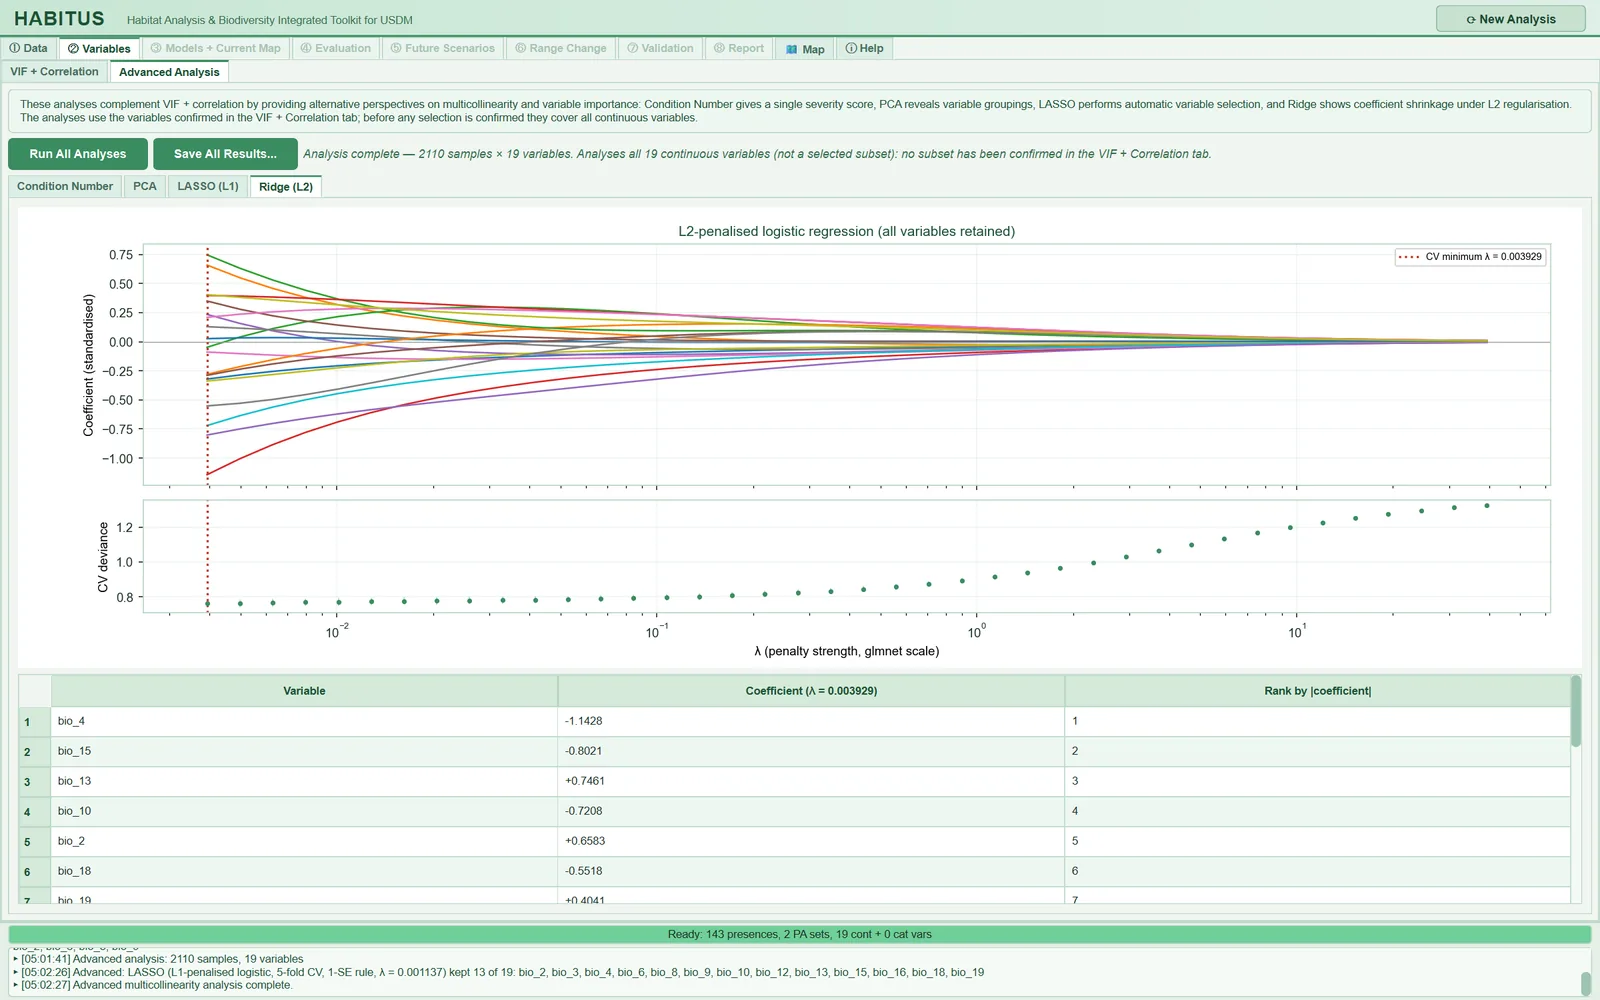
- Ne işe yarar. LASSO ile aynı kurulum, L2 cezasıyla (
tabs/tab_vif_advanced.py:715-748). Izgara 100 \times \lambda_{\max}'tan başlar ve dört büyüklük mertebesi iner. λ her zaman en küçük çapraz doğrulama sapmasıyla seçilir; ayarı yoktur, yalnızCV foldsLASSO ile ortaktır. Ridge hiçbir değişkeni sıfırlamaz; tablo değişkenleri mutlak standartlaştırılmış katsayıya göre sıralar veRank by |coefficient|sütununda sırayı yazar. Hiçbir değişken "önerilmez". - Ne zaman, nasıl ayarlanır. İlişkili değişkenler bir arada tutulduğunda katsayıların nasıl paylaşıldığını görmek için. Ridge katsayıları LASSO'nunkinden daha kararlıdır.
- Sonuca etkisi. Yalnız bilgi. Örnek koşuda λ = 0,003929; en büyük mutlak katsayılar bio_4 (−1,1428), bio_15 (−0,8021), bio_13 (+0,7461), bio_10 (−0,7208), bio_2 (+0,6583) (Şekil 4.5).
- Dikkat.
Recomputedüğmesi yalnız LASSO'yu yeniden hesaplar;CV foldsdeğiştirildikten sonra Ridge'in de yenilenmesi içinRun All Analyses'e basılmalıdır. Örnek koşuda Ridge'in en küçük sapması da ızgaranın en küçük λ'sına denk gelmiştir.
4.9.6 Gelişmiş analizin dışa aktarımı
Save All Results... çıktı klasöründe advanced_analysis/ alt klasörünü kurar ve şunları yazar (tabs/tab_vif_advanced.py:760-891): condition_number.txt (κ, değişken ve satır sayısı, ilk 10 tekil değer), pca_variance.png, pca_loadings.csv (ilk k bileşen), pca_variance.csv (bütün bileşenlerin varyans ve birikimli varyans yüzdesi), lasso_coefficient_paths.png, lasso_coefficients.csv, lasso_path.csv (λ ızgarası, CV sapması ve standart hatası, bütün katsayılar), lasso_info.txt (kayıt sayısı, kat sayısı, iki λ, kullanılan λ, seçilen değişkenler), ridge_coefficient_paths.png, ridge_coefficients.csv, ridge_path.csv. Çıktı klasörü tanımlı değilse "Set the output directory in the Data tab first." uyarısı çıkar.
4.10 Çıktılar ve sonraki adıma geçenler
state["var_names"]: onaylanan sürekli değişkenler, doğal ad sırasıyla. ③ Models, ⑤ Future Scenarios (projeksiyon ve yenilik haritaları) ve ⑧ Report bunu kullanır.state["cat_selected"]/state["cat_excluded"]: kategorik seçim; kategorik raster yoksaNoneve boş liste.figures/ve (istenirse)advanced_analysis/dosyaları (§4.8, §4.9.6).- Sekmedeki eşikler ve yöntem, rapora ve ODMAP'in "Multicollinearity" öğesine yazılır.
- Kayıt/öngörücü uyarısı (varsa)
sample_warningslistesine eklenir ve rapora geçer.
4.11 Uzman soruları
S1. Adım adım VIF seçimi usdm::vifstep ile aynı sonucu veriyor mu?
Evet, aynı girdide aynı sonucu verir. İki yöntem de kalan kümenin VIF'ini her adımda yeniden hesaplar, en büyüğü eşikten büyükse onu çıkarır ve en büyük VIF eşiğe eşit ya da altında kalınca durur (sdm_core.py:427-434; usdm'de th = 10). Bu kitapta 5000 hücrelik bir WorldClim matrisinde karşılaştırılmıştır: çıkarma sırası 11 değişkende aynı, kalan sekiz değişkenin VIF'leri on dördüncü ondalığa kadar aynıdır (§4.6.2). VIF de usdm'deki gibi kesişimli doğrusal regresyonun R^2'sinden hesaplanır (sdm_core.py:275-295).
S2. VIF'in 999'a sabitlenmesi çıkarma sırasını değiştirebilir mi?
Değiştirebilir. R^2 > 0{,}9999 olan her değişkenin VIF'i 999 olur (sdm_core.py:292-293); aynı adımda birden çok değişken bu durumdaysa idxmax() doğal sıradaki ilkini çıkarır (sdm_core.py:430). usdm gerçek VIF'i kullandığı için o adımda gerçekten en büyük olanı çıkarır. Örnek koşuda ilk iki adımda bio_4 ve bio_5 999 ile çıkarılmıştır. Doğrulama matrisinde bu durum sonucu değiştirmemiştir; ama sabitlenmiş eşitliklerin olduğu bir veride son küme usdm'den farklı olabilir. Fark, yalnız aşırı yüksek VIF'li değişkenlerin hangisinin önce gideceğiyle ilgilidir; kesin aynı sonuç gerekiyorsa en açık türetilmiş değişkenler (bio_7 gibi) önceden elle çıkarılabilir.
S3. VIF ve korelasyon neden raster hücrelerinde değil de varlık + sözde yokluk havuzunda hesaplanıyor?
Çünkü model bu noktalarla eğitilir; çoklu doğrusallık modelin gördüğü veride önemlidir (tabs/tab_vif.py:349-353). Bunun sonucu olarak sonuçlar erişilebilir alanın genişliğine ve PA sayısına bağlıdır (§4.3). VIF + Correlation havuzunda her varlık PA seti sayısı kadar yinelenir, Advanced Analysis ise yinelenenleri atar (tabs/tab_vif_advanced.py:356-363); bu yüzden iki alt sekmedeki örneklem tam aynı değildir. Bütün alan üzerinde bir korelasyon isteyen kullanıcı, R'de usdm::vifstep'i doğrudan rasterlara uygulayabilir.
S4. Recommended neden tek değişkenli AUC'yi hesaba katmıyor?
Kodun açıklaması: tek değişkenli ayırt etme gücü, bu örneklemde gerçek etkenle korelasyonu sayesinde iyi görünen bir değişkeni öne çıkarır; böyle bir değişken başka bölgeye ya da iklime aktarıldığında başarısız olabilir (sdm_core.py:323-339). Bu yüzden hem Priority_Score hem Recommended yalnız çoklu doğrusallığa dayanır ve AUC rozeti bilerek nötr renklidir (tabs/tab_vif.py:471-499). Çiftten hangisinin bırakılacağına türün ekolojisi karar vermelidir (Dormann vd. 2013).
S5. Korelasyon adımı neden çiftten VIF'i yüksek olanı çıkarıyor; usdm::vifcor ile fark nedir?
HABITUS önce VIF adımını uygular, sonra kalan kümede |r| \ge eşik olan en güçlü çiftten, o anki kümede VIF'i büyük olanı çıkarır (sdm_core.py:435-445). usdm::vifcor ise önce korelasyon eşiğiyle çift çift çıkarır (çiftten öteki değişkenlerle daha çok ilişkili olanı), sonra VIF'e bakmaz. İki yöntemin son kümesi farklı olabilir. Varsayılan eşiklerle (VIF 10, |r| 0,80) VIF adımından sonra yüksek korelasyonlu çift nadiren kalır; örnek koşuda hiç kalmamıştır.
S6. Eşikleri değiştirdim ama Recommended aynı öneriyi veriyor. Neden?
Öneri, variable_priority_ranking en son çalıştığında hesaplanır. Sekme ilk açıldığında ① Data'nın ön hesabı gösterilir (korelasyon 0,70, Pearson, VIF 10; sdm_core.py:3225-3227). Korelasyon eşiğini değiştirmek yalnız çift tablosunu ve ısı haritasını yeniler (tabs/tab_vif.py:880-884); yöntem ve VIF eşiği hiçbir şeyi kendiliğinden yenilemez. Yeni bir öneri için Run / Refresh Analysis'e, sonra Recommended'a basılmalıdır.
S7. LASSO ve Ridge, R'deki glmnet ile aynı sonucu veriyor mu?
Aynı tanımı kullanır (Friedman vd. 2010): binom aile, glmnet ölçeğinde λ, eşit sınıf ağırlıkları, standartlaştırılmış öngörücüler, katmanlı k katlı çapraz doğrulama, lambda.min ve lambda.1se (tabs/tab_vif_advanced.py:63-128). Programın test takımı, benzetilmiş bir veride iki ızgara noktasındaki katsayıları R glmnet ile karşılaştırır: Ridge için 2 \times 10^{-4}, LASSO için 3 \times 10^{-3} mutlak fark içinde ve LASSO'nun sıfırladığı değişkenler aynıdır (tests/test_202_small_samples_lasso.py:81-98). Çözücü liblinear'dır ve kesişim terimi çok küçük bir cezayla kestirilir (intercept_scaling=100); bu, glmnet'ten küçük farkların kaynağıdır. λ ızgarası glmnet'inkiyle (100 değer, lambda.min.ratio) aynı değildir: HABITUS 40 değer kullanır ve LASSO'da üç, Ridge'de dört büyüklük mertebesi iner.
S8. Çapraz doğrulama sapmasının en küçüğü ızgaranın ucuna düşerse ne olur?
Program bunu ayrıca bildirmez; lambda_min ızgaranın en küçük değeri olur (tabs/tab_vif_advanced.py:120). Örnek koşuda LASSO'da (\lambda_{\min} = 0{,}0003929 = \lambda_{\max}/1000) ve Ridge'de (0{,}003929) böyle olmuştur (Şekil 4.4 ve 4.5'te kırmızı çizgi sol uçtadır). Bu durumda gerçek en küçük daha küçük bir λ'da olabilir; 1-SE kuralı ise sapma eğrisi düz olduğu için daha güvenilirdir. Bu analizler yalnız bilgi verdiği için model sonuçlarını etkilemez; ayrıntılı bir ceza seçimi gerekiyorsa advanced_analysis/lasso_path.csv incelenebilir ya da glmnet daha geniş bir ızgarayla çalıştırılabilir.
S9. Koşul sayısı neden bu kadar büyük, ve VIF ile ne ilişkisi var?
κ, standartlaştırılmış matrisin en büyük ve en küçük tekil değerinin oranıdır (tabs/tab_vif_advanced.py:421-431). En küçük tekil değer sıfıra yaklaştıkça κ büyür; bu, en az bir değişkenin ötekilerin doğrusal bileşimine yaklaştığı anlamına gelir. VIF aynı durumu değişken başına gösterir. 19 biyoiklim değişkeninde bio_7 = bio_5 − bio_6 gibi tam türetmeler bulunduğundan κ milyonlar düzeyindedir (örnek koşuda 22 681 501,75). Seçilen kümeyle yeniden hesaplandığında κ'nın düşmesi seçimin işe yaradığını gösterir.
S10. Tek değişkenle model kurulabilir mi?
Hayır. Tek değişkenle sıralama tablosu kurulur (VIF = 1; sdm_core.py:356-368) ama Confirm en az iki sürekli değişken ister (tabs/tab_vif.py:1164-1167); Run / Refresh Analysis de tek değişken yüklüyse ① Data'ya katman eklenmesini ister (tabs/tab_vif.py:367-372).
S11. Kategorik değişkenler çoklu doğrusallık denetimine neden girmiyor?
VIF ve Pearson/Spearman korelasyonu sıralı sayısal değişken varsayar; kategorik kodların sayısal değeri anlamsızdır. Kategorik rasterlar bu yüzden ayrı listelenir ve seyrek sınıflar (3'ten az varlık) işaretlenir (tabs/tab_vif.py:583-664). Program kategorik ile sürekli değişkenler arasındaki ilişkiyi (örneğin bir arazi örtüsü sınıfının yükseltiyle örtüşmesi) ölçmez; bu kullanıcının denetlemesi gereken bir noktadır. Advanced Analysis kategorik rasterları kullanmaz; yalnız sürekli değişkenlerle çalışır (tabs/tab_vif_advanced.py:343-354).
S12. Bu sekmedeki seçim tekrarlanabilir mi?
VIF, korelasyon, PCA ve koşul sayısı rastgelelik içermez; aynı PA setleri aynı sonucu verir. PA setleri ① Data'daki tohuma bağlıdır. LASSO ve Ridge'in çapraz doğrulama katları koşu tohumuyla (formatter.random_seed) karıştırılır (tabs/tab_vif_advanced.py:600-604, 108). Seçilen değişkenler, eşikler ve yöntem rapora, ODMAP'e ve figures/variable_priority_ranking.csv'ye yazılır; Recommended ile yapılan çıkarmalar sırasıyla oturum günlüğündedir.
4.12 Sık hatalar ve tuzaklar
- Eşiği değiştirip
Run / Refresh Analysis'e basmamak. Öneri eski eşiklerle kalır (§4.4.1). Önce eşikleri ayarlayın, sonraRun / Refresh Analysis, sonraRecommended. Recommended'ı son karar saymak. İpucu açıkça "A starting point" der. Önerilen kümeyi türün ekolojisiyle karşılaştırın; örneğin örnek koşuda önerilen kümede yıllık ortalama sıcaklık (bio_1) yoktur, onun yerine bio_11 (en soğuk çeyreğin ortalama sıcaklığı) kalmıştır.- Tam küme VIF rozetine bakıp önerilen bir değişkeni çıkarmak. Rozet bütün değişkenlerin varlığındaki VIF'i gösterir; önerilen kümedeki VIF
variable_priority_ranking.csv'ninVIF_in_selectionsütunundadır (örnekte bio_11: tam kümede ∞, önerilen kümede 2,85). - Çift tablosundaki kırmızı AUC'yi "bunu at" diye okumak. AUC renklendirmesi yalnız iki AUC'yi karşılaştırır; düşük tek değişkenli AUC bir değişkeni gereksiz yapmaz (§4.5.1).
- Seçimi değiştirip onaylamamak. ③ Models son onaylanan kümeyi kullanır. Modeller çalıştırıldıktan sonra yeniden onay her şeyi siler ("Re-confirm Variable Selection").
Advanced Analysis'in önerilerini listeye uygulandı sanmak. PCA ve LASSO yalnız bilgi verir; değişken listesindeki işaretler değişmez.- Kayıt/öngörücü uyarısını görmezden gelmek. "Below about 10 per predictor …" uyarısı çıkıyorsa daha az değişken seçin ya da ③ Models'te daha basit algoritmalar (GLM, doğrusal/karesel özellikli MaxEnt) kullanın.
4.13 Kaynaklar
Barbet-Massin, M., Jiguet, F., Albert, C.H., Thuiller, W., 2012. Selecting pseudo-absences for species distribution models: how, where and how many? Methods in Ecology and Evolution 3, 327–338. https://doi.org/10.1111/j.2041-210X.2011.00172.x
Belsley, D.A., Kuh, E., Welsch, R.E., 1980. Regression Diagnostics: Identifying Influential Data and Sources of Collinearity. Wiley, New York. https://doi.org/10.1002/0471725153
Dormann, C.F., Elith, J., Bacher, S., Buchmann, C., Carl, G., Carré, G., vd., 2013. Collinearity: a review of methods to deal with it and a simulation study evaluating their performance. Ecography 36, 27–46. https://doi.org/10.1111/j.1600-0587.2012.07348.x
Friedman, J., Hastie, T., Tibshirani, R., 2010. Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
Hastie, T., Tibshirani, R., Friedman, J., 2009. The Elements of Statistical Learning, 2. baskı. Springer, New York. https://doi.org/10.1007/978-0-387-84858-7
Naimi, B., Hamm, N.A.S., Groen, T.A., Skidmore, A.K., Toxopeus, A.G., 2014. Where is positional uncertainty a problem for species distribution modelling? Ecography 37, 191–203. https://doi.org/10.1111/j.1600-0587.2013.00205.x
O'Brien, R.M., 2007. A caution regarding rules of thumb for variance inflation factors. Quality & Quantity 41, 673–690. https://doi.org/10.1007/s11135-006-9018-6
Tibshirani, R., 1996. Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society Series B 58, 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02080.x