5. Modeller I: algoritmalar ve ayarları (③ Models → Algorithm Settings)
Sekme: ③ Models + Current Map → Algorithm Settings · Kod: tabs/tab_models.py (arayüz), sdm_core.py build_model, SDMModeler (hesap), sdm_niche.py (BIOCLIM, Domain, ESM), sdm_tuning.py (ayarlanabilir parametreler)
5.1 Bu sekme ne yapar
Algorithm Settings (algoritma ayarları) alt sekmesi, modellemenin "hangi yöntemle" sorusunu yanıtlar. Burada 18 algoritmadan hangilerinin çalıştırılacağı işaretlenir ve her birinin ayarları (hiperparametreleri) girilir. Hiperparametre, modelin veriden öğrenmediği, kullanıcının önceden belirlediği ayardır: ağaç sayısı, ceza katsayısı, katman sayısı gibi.
İş akışındaki yeri şöyledir:
- Girdi: ① Data sekmesinin ürettiği sözde yokluk veri kümeleri (her tekrar için varlık + sözde yokluk satırları), MaxEnt arka planı, isteğe bağlı yalnız-varlık arka planı ve ② Variables sekmesinde seçilen öngörücüler (sürekli ve kategorik). Bu iki adım tamamlanmadan çalıştırma düğmesi "Complete ① Data and ② Variables steps first." iletisini verir (
tabs/tab_models.py:1394-1395). - İşlem:
▶ Run Models + Generate Current Distribution Mapdüğmesine basıldığında işaretli her algoritma, her sözde yokluk kümesinde, çapraz doğrulama katlarında ve tam veriyle eğitilir (sdm_core.py:5352SDMModeler.run). Bu sayfadaki ayarlar_collect_algo_optsile toplanıpSDMModeler'ealgo_optionsolarak geçer (tabs/tab_models.py:1142-1209,1569-1573). - Çıktı: eğitilmiş modeller, değerlendirme skorları, değişken önemleri ve güncel dağılım haritası. Bunlar
Evaluation ResultsveCurrent Distribution Mapalt sekmelerinde ve ④ Evaluation sekmesinde görülür. Kullanılan bütün ayarlarhabitus_run_config.jsondosyasınınsettings.models.algorithm_optionsalanına yazılır.
Çapraz doğrulama tasarımı, eşik ve topluluk (ensemble) ayarları aynı sayfanın alt yarısındadır; onlar Bölüm 6'da anlatılır. Bu bölüm yalnız algoritma seçimini ve algoritma ayarlarını kapsar.
5.2 Ekranın düzeni
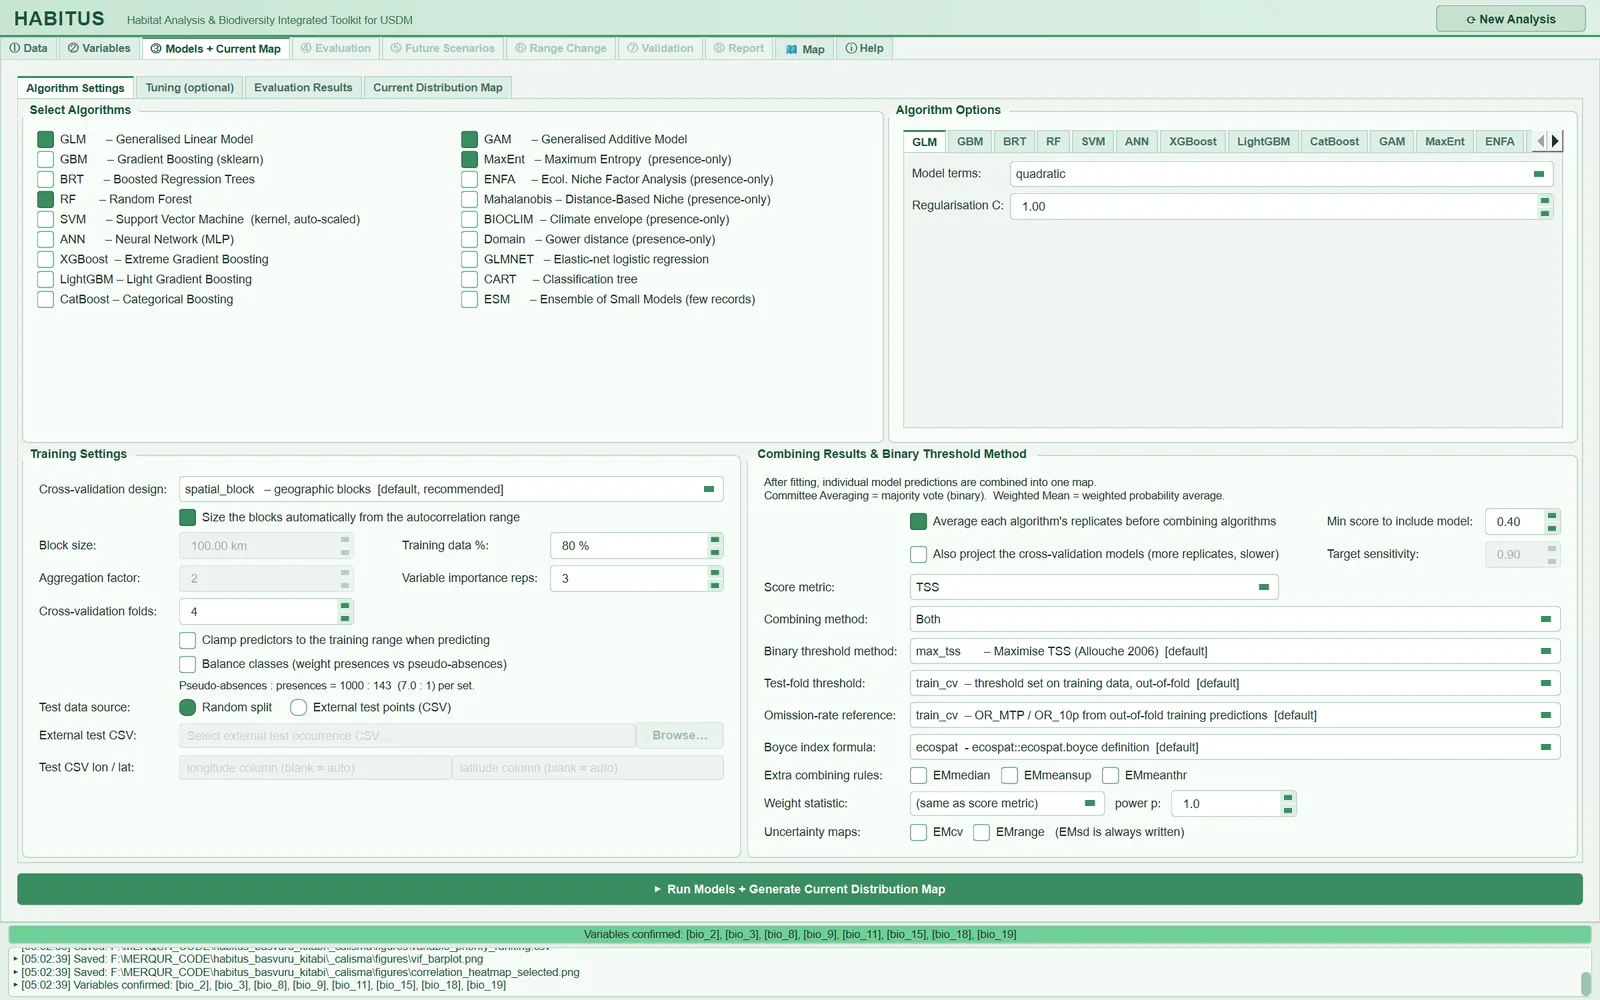
Sayfa dört bölgeden oluşur:
Select Algorithms(algoritma seçimi; sol üst): 18 onay kutusu, iki sütunda dokuzar tane (tabs/tab_models.py:125-150). Bkz. §5.3.Algorithm Options(algoritma seçenekleri; sağ üst): her algoritma için bir sekme. Sekme çubuğu 18 sekmeyi sığdıramadığı için sağdaki ok düğmeleriyle kaydırılır (tabs/tab_models.py:173-194). Altı ve daha fazla satırı olan sayfalar (BRT, XGBoost, LightGBM, CatBoost, MaxEnt, ESM) iki sütuna dizilir (tabs/tab_models.py:197-201). Her sekme §5.6–§5.23'te kendi alt bölümünde anlatılır.Training SettingsveCombining Results & Binary Threshold Method(alt yarı): Bölüm 6.- Çalıştırma düğmesi:
▶ Run Models + Generate Current Distribution Map.
Örnek koşunun verisi Abies nordmanniana'dır (626 kayıt; inceltme sonrasında 143 varlık; WorldClim 2.1 biyoiklim, 2,5′; ② Variables'ta seçilen 8 değişken: bio_2, bio_3, bio_8, bio_9, bio_11, bio_15, bio_18, bio_19; 2 sözde yokluk kümesi × 1000 nokta; MaxEnt arka planı 10 000 nokta; tohum 42). Bölümdeki sayılar bu koşunun habitus_run_config.json, evaluation_scores.csv ve oturum günlüğünden alınmıştır.
5.3 Algoritma seçimi (Select Algorithms)
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
GLM – Generalised Linear Model |
Lojistik regresyon | açık | açık / kapalı | tabs/tab_models.py:129 |
RF – Random Forest |
Rastgele orman | açık | açık / kapalı | tabs/tab_models.py:132 |
Öteki 16 kutu (GBM, BRT, SVM, ANN, XGBoost, LightGBM, CatBoost, GAM, MaxEnt, ENFA, Mahalanobis, BIOCLIM, Domain, GLMNET, CART, ESM) |
İlgili algoritmayı çalıştırır | kapalı | açık / kapalı | tabs/tab_models.py:130-146 |
Programın açılışında yalnız GLM ve RF işaretlidir. Gereken paketi kurulu olmayan algoritmanın kutusu kapatılır, devre dışı bırakılır, adının sonuna [not installed] eklenir ve ipucunda kurulum komutu gösterilir (ör. "Not installed — pip install pygam"; tabs/tab_models.py:152-168). Paket gerektirenler: XGBoost (xgboost), LightGBM (lightgbm), CatBoost (catboost), GAM (pygam), MaxEnt (elapid); öteki 13 algoritma scikit-learn ya da numpy ile çalışır (sdm_core.py:127-146). Hiçbir kutu işaretli değilse çalıştırma "Select at least one algorithm." iletisiyle durur (tabs/tab_models.py:1397-1400).
Not: Algoritmaların hangi sırayla işaretlendiği ya da öngörücülerin hangi sırayla eklendiği sonucu değiştirmez. Sütunlar her koşuda önce sürekli, sonra kategorik ve her grup kendi içinde doğal ad sırasıyla dizilir (
sdm_core.py:3892-3899).
5.4 Bütün algoritmalar için ortak kurallar
5.4.1 Hangi satırlarla eğitilir: varlık-yokluk ve yalnız-varlık
HABITUS'ta algoritmalar eğitimde kullandıkları satırlara göre üç gruba ayrılır:
- Varlık–sözde yokluk (sınıflandırıcı) modeller: GLM, GLMNET, GAM, GBM, BRT, RF, CART, SVM, ANN, XGBoost, LightGBM, CatBoost ve GLM/RF tabanlı ESM. Sözde yokluk kümesinin bütün satırlarını (varlık = 1, sözde yokluk = 0) kullanır (
sdm_core.py:4480-4498). - Varlık + arka plan: MaxEnt. Eğitim katındaki varlıkları ve ① Data'da ayrıca örneklenen MaxEnt arka planını kullanır; sözde yokluklar MaxEnt'in eğitimine girmez (
sdm_core.py:4595-4603,tabs/tab_models.py:1580). ENFA da küresel ortam dağılımını kestirmek için, varsa yalnız-varlık arka planını kullanır (sdm_core.py:4079-4092). - Yalnız varlık: Mahalanobis, BIOCLIM ve Domain yalnız varlık satırlarından uydurulur (
sdm_core.py:4227-4228,4281-4282).
Değerlendirme ise grup ne olursa olsun aynıdır: test katındaki varlıklar ve sözde yokluklar üzerinden AUC, TSS, Boyce ve ötekiler hesaplanır. Yalnız-varlık yöntemlerinde test katında hiç varlık kalmazsa eğitim katındaki varlıkların yaklaşık beşte biri teste taşınır (sdm_core.py:5455-5468; tam model için 5686-5696).
5.4.2 Girdinin ölçeklenmesi
Ölçek duyarlı yöntemlerde standartlaştırma (ortalama 0, standart sapma 1) programın içinde, yalnız eğitim satırlarıyla öğrenilerek yapılır; kullanıcının önceden ölçeklemesi gerekmez:
- GLM ve GLMNET: önce terimler (doğrusal, kare, etkileşim) üretilir, sonra bu terimler standartlaştırılır (
sdm_core.py:3488-3505). - SVM ve ANN: öngörücüler standartlaştırılır (
sdm_core.py:3562-3581). - Ağaç yöntemleri (GBM, BRT, RF, CART, XGBoost, LightGBM, CatBoost) ölçekten etkilenmez; ölçekleme yapılmaz.
- MaxEnt özellikleri elapid'in dönüştürücüsüyle üretilir. GAM, ENFA, Mahalanobis, BIOCLIM ve Domain ham değerlerle çalışır; ENFA ve Mahalanobis kovaryans matrisiyle, BIOCLIM yüzdeliklerle, Domain varlık aralığına bölünmüş farklarla ölçeği kendisi giderir.
5.4.3 Kategorik değişkenler
Kategorik rasterlar (arazi örtüsü, bakı sınıfı gibi) modele tamsayı sınıf kodu olarak gelir; her algoritma onları şöyle kullanır:
| Algoritma | Kategorik değişkenin işlenmesi | Kod |
|---|---|---|
| GLM, GLMNET, SVM, ANN | Eğitimde görülen her sınıf için bir 0/1 sütunu (one-hot); kodlar karesi alınmaz, ölçeklenmez, çarpılmaz. Eğitimde görülmemiş sınıf o değişken için bütün sütunlarda 0 alır | sdm_core.py:3364-3443 |
| GAM | Faktör terimi f(), sınıf başına bir katsayı; tek sınıflı değişken atlanır; görülmemiş sınıfın etkisi 0 sayılır |
sdm_core.py:3320-3361, 4525-4549 |
| MaxEnt | elapid'in kategorik özellik sınıfı (one-hot, beta_categorical ile cezalı); görülmemiş sınıf 0 |
sdm_core.py:4606-4612, 4712-4718, 4760-4770 |
| GBM, BRT, RF, CART, XGBoost, LightGBM, CatBoost | Tamsayı kodu sayısal bir sütun gibi bölünür | sdm_core.py:3476-3479 |
| ENFA, Mahalanobis, BIOCLIM, Domain | Kategorik değişkenler dışarıda bırakılır; günlüğe "… is an envelope/distance model for continuous predictors: the categorical variable(s) … are excluded from it." yazılır | sdm_core.py:4010-4036 |
| ESM | Kategorik değişkenler çiftlere girmez | sdm_core.py:4389-4393 |
Dikkat: Ağaç yöntemlerinde sınıf kodu sıralı bir sayı gibi bölünür: kod 3 ile 4 "yakın", 3 ile 12 "uzak" sayılır. Kodların sırası ekolojik bir anlam taşımıyorsa ağaç, sınıfları ancak birkaç bölünmeyle ayırabilir. CatBoost'un kendi kategorik işleme yeteneği HABITUS'ta kullanılmaz.
5.4.4 Tekrarlanabilirlik ve rastgele tohum
Rastgelelik içeren her öğrenici (RF, GBM, BRT, CART, SVM, ANN, GLMNET, XGBoost, LightGBM, CatBoost, MaxEnt, ESM katları) ① Data'daki Random seed (varsayılan 42) ile tohumlanır (sdm_core.py:115-124, 3474-3475, 4643). Aynı veri, aynı ayarlar ve aynı tohumla iki koşu aynı modelleri üretir. Permütasyon önemi de (PA kümesi, kat, algoritma) üçlüsüne özgü ama tohumdan türetilen bir üreteçle hesaplanır (sdm_core.py:4847-4853). Kullanılan tohum habitus_run_config.json içinde random_seed alanındadır.
5.4.5 Sınıf dengesi ve kırpma (Training Settings'ten gelen iki ayar)
Balance classes (weight presences vs pseudo-absences) (sınıfları dengele) ve Clamp predictors to the training range when predicting (tahminde öngörücüleri eğitim aralığına kırp) Training Settings grubundadır ve Bölüm 6'da anlatılır; ama algoritmaya göre farklı davrandıkları için burada özetlenir. Denge açıkken (varsayılan kapalı) her algoritma sınıf ağırlığını şöyle alır (sdm_core.py:3670-3716):
| Algoritma | Dengeleme biçimi |
|---|---|
| GLM, RF, SVM, GLMNET, CART, LightGBM | class_weight='balanced' |
| CatBoost | auto_class_weights='Balanced' |
| GBM, BRT | dengeli örnek ağırlıkları (sample_weight) |
| XGBoost | scale_pos_weight = sözde yokluk sayısı / varlık sayısı |
| ANN | dengeli örnek ağırlıkları (kurulu scikit-learn bunu destekliyorsa) |
| ESM | yalnız GLM ya da RF tabanlı küçük modellerde |
| GAM, MaxEnt, ENFA, Mahalanobis, BIOCLIM, Domain | desteklenmez; ayar bu algoritmalarda etkisizdir |
Kırpma açıkken her tahminden önce öngörücüler bütün sözde yokluk kümelerinin min–maks aralığına kırpılır; MaxEnt'e ayrıca elapid'in clamp=True ayarı açıkça verilir (sdm_core.py:4650-4655, 4929-4962).
5.4.6 Ayar (tuning) alt sekmesiyle ilişki
Tuning (optional) alt sekmesi bazı algoritmaların parametrelerini çapraz doğrulamalı ızgara aramasıyla dener ve seçilen değeri Apply selected setting ile bu sayfaya yazar. Bu sayfaya yazılabilen parametreler (tabs/tab_models.py:1212-1229, 1231-1259) ve ayar sekmesinin varsayılan ızgaraları (sdm_tuning.py) şunlardır:
| Algoritma | Bu sayfaya yazılan parametreler | Varsayılan ızgara (kaynak) |
|---|---|---|
| MaxEnt | Feature types, Regularisation multiplier (β / RM) |
rm 0,5–4,0 adım 0,5; fc L, LQ, H, LQH, LQHP (sdm_tuning.py:502-552) |
| GBM | n_estimators, learning_rate, subsample, min_samples_leaf, max_depth |
flexsdm tune_gbm: ağaç 20–500, öğrenme hızı 0,01/0,1/0,3, yaprak 1–10, 20, 30 (sdm_tuning.py:626-630) |
| RF | n_estimators, min_samples_leaf, max_features |
flexsdm tune_raf: mtry 2…öngörücü sayısı, ntree 200–1200 (sdm_tuning.py:633-634, 787-793) |
| SVM | C, gamma |
flexsdm tune_svm: C 1–16, sigma 0,001–0,2 → gamma aynı değer (sdm_tuning.py:636-637, 654-675) |
| ANN | alpha (L2), Hidden layers |
flexsdm tune_net: tek katman 2–8 nöron, decay 0,01–10 → alpha = 2 × decay (sdm_tuning.py:639-640, 678-689) |
| XGBoost | n_estimators, max_depth, learning_rate |
HABITUS'un ızgarası: 100/300/500; 3/6/9; 0,01/0,05/0,1 (sdm_tuning.py:779-781) |
| LightGBM | n_estimators, num_leaves, learning_rate |
HABITUS'un ızgarası: 100/300/500; 15/31/63; 0,01/0,05/0,1 (sdm_tuning.py:782-784) |
| GLMNET | C (inverse penalty), l1_ratio (alpha) |
C 0,01/0,1/1/10; l1_ratio 0–1 adım 0,25 (sdm_tuning.py:837-838) |
| CART | max_depth, min_samples_leaf, ccp_alpha |
2/3/5/8; 1/5/10/20; 0/0,002/0,01 (sdm_tuning.py:839-841) |
| GAM | n_splines, lam (smoothing) |
5/10/15/20; 0,1/0,6/2/10 (sdm_tuning.py:842-843) |
GLM, BRT, CatBoost, ENFA, Mahalanobis, BIOCLIM, Domain ve ESM ayar sekmesinde yoktur; onların değerleri yalnız bu sayfadan girilir. Ayar aramasının kendisi Bölüm 6'da anlatılır.
5.5 Algoritma seçme rehberi
Aşağıdaki tablo, kodda görülen yapıdan ve örnek koşudan çıkarılmış bir başlangıç rehberidir; bir yöntemin her veri kümesinde ötekinden iyi olacağını söylemez. "Hız" sütunundaki sayılar örnek koşuda bir sözde yokluk kümesinin 4 çapraz doğrulama katının süresidir (iç katlarla birlikte; günlükten).
| Algoritma | Veri türü | Hız | Yorumlanabilirlik | Aşırı uyum eğilimi (varsayılanla) | Ne zaman |
|---|---|---|---|---|---|
| GLM | varlık–sözde yokluk | çok hızlı (0,7 s) | yüksek (katsayılar) | düşük–orta (L2 cezalı, karesel) | her çalışmada temel model |
| GLMNET | varlık–sözde yokluk | hızlı | yüksek | düşük (elastik ağ) | çok öngörücü, az kayıt |
| GAM | varlık–sözde yokluk | orta (10 s) | yüksek (tepki eğrileri) | orta | doğrusal olmayan, düzgün tepkiler |
| MaxEnt | varlık + arka plan | yavaş (165 s) | orta–yüksek | β ve özellik sınıflarına bağlı | yalnız-varlık verisi, karşılaştırılabilirlik |
| RF | varlık–sözde yokluk | orta (21 s) | düşük | yüksek eğitim uyumu (eğitim AUC 1,000) | çok kayıt, karmaşık etkileşimler |
| GBM | varlık–sözde yokluk | orta | düşük–orta | düşük (kütük ağaçlar) | toplamsal esnek model |
| BRT | varlık–sözde yokluk | orta–yavaş | düşük–orta | orta | Elith ve ark. (2008) çizgisinde boosting |
| XGBoost, LightGBM, CatBoost | varlık–sözde yokluk | hızlı–orta | düşük | yüksek (derin ağaçlar) | çok kayıt (yüzlerce), karşılaştırma |
| CART | varlık–sözde yokluk | çok hızlı | çok yüksek (tek ağaç) | kararsız, basamaklı yüzey | açıklama amaçlı |
| SVM | varlık–sözde yokluk | n büyüdükçe yavaşlar | düşük | C ve gamma'ya bağlı | karşılaştırma |
| ANN | varlık–sözde yokluk | orta | çok düşük | yüksek (100+50 nöron) | çok kayıt |
| ENFA | varlık + arka plan | çok hızlı | orta (eksenler) | düşük | yalnız-varlık, kaba niş |
| Mahalanobis | yalnız varlık | çok hızlı | orta | düşük | eliptik niş varsayımı |
| BIOCLIM | yalnız varlık | çok hızlı | çok yüksek | düşük; uç kayda duyarlı | iklim zarfı, karşılaştırma |
| Domain | yalnız varlık | hızlı (varlık sayısıyla artar) | yüksek | düşük; tek kayda duyarlı | benzerlik tabanlı karşılaştırma |
| ESM | varlık–sözde yokluk (çiftler) | çift sayısıyla artar | orta | düşük (iki değişkenli modeller) | çok az kayıt (yaklaşık < 30) |
Örnek koşuda (143 varlık, 8 değişken) dört algoritmanın çapraz doğrulama ortalamaları: GLM AUC 0,889, TSS 0,687, Boyce 0,607; MaxEnt 0,895, 0,672, 0,605; RF 0,892, 0,566, 0,677; GAM 0,872, 0,611, 0,653. Eğitim ile test AUC'si arasındaki fark (dAUC) GLM'de 0,031, MaxEnt'te 0,055, GAM'de 0,087, RF'de 0,108'dir; eğitim verisine en sıkı uyan RF'dir.
İpucu: Tek bir "en iyi" algoritma aramak yerine farklı ailelerden (bir regresyon, bir ağaç topluluğu, MaxEnt) birkaç algoritma çalıştırıp topluluk haritasıyla birleştirmek yaygın uygulamadır; birleştirme Bölüm 6'dadır.
5.6 GLM: genelleştirilmiş doğrusal model
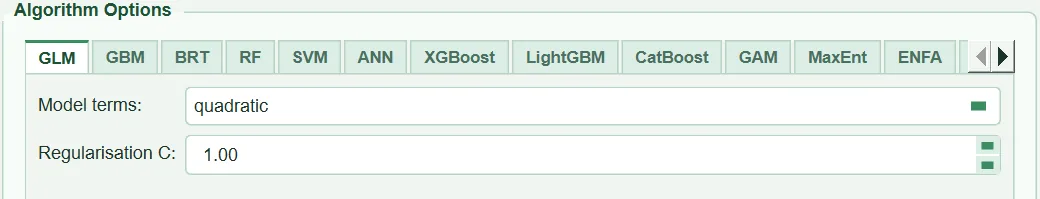
Aile ve uygulama. İkili (lojistik) regresyon: varlık olasılığının logiti öngörücülerin doğrusal bir birleşimidir. scikit-learn LogisticRegression (çözücü lbfgs, en çok 2000 yineleme) ile, önce terim üretimi sonra standartlaştırma yapan bir boru hattı içinde uydurulur (sdm_core.py:3481-3492). Veri türü varlık–sözde yokluk. Ceza, standartlaştırılmış terimlerin katsayılarına uygulanan L2 (ridge) cezasıdır.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Model terms: |
Hangi terimlerin modele gireceği | quadratic |
linear, quadratic, interactions |
tabs/tab_models.py:721-735; sdm_core.py:3300-3317 |
Regularisation C: |
Ters ceza gücü (L2) | 1.00 | 0.001 – 1 000 000 | tabs/tab_models.py:736-745; sdm_core.py:3482 |
5.6.1 Model terms (model terimleri)
- Ne işe yarar.
linearher öngörücü için yalnız x terimini,quadraticx ve x^2 terimlerini,interactionsbunlara ek olarak bütün ikili çarpımları (x_i x_j) üretir (sdm_core.py:3300-3317). MaxEnt özellik sınıflarıyla karşılaştırılırsa sırasıyla L, LQ ve LQP'dir. Terim sayısı p öngörücüde p, 2p ve p + p(p+1)/2'dir; 8 öngörücüde 8, 16 ve 44. - Ne zaman, nasıl ayarlanır.
quadraticbir değişken boyunca tek tepeli (optimumlu) tepkiye izin verir; ekolojik nişin klasik varsayımıdır ve çoğu çalışma için uygundur.linearyalnız tekdüze artan ya da azalan tepki verir; çok az kayıtta ya da yorumu basit tutmak için seçilir.interactionsen az birkaç yüz varlık kaydı gerektirir; ipucundaki on-olay-bir-değişken kuralına göre 8 öngörücüde yaklaşık 440 kayıt. - Sonuca etkisi. Terim arttıkça eğitim uyumu artar, tepki eğrileri bükülür ve projeksiyonlarda kalibrasyon aralığı dışına taşma (ekstrapolasyon) riski büyür; kare terim aralık dışında hızla düşen ya da yükselen eğri verir.
- Dikkat. Kategorik değişkenlerin kodlarına terim uygulanmaz; yalnız sürekli değişkenlere uygulanır (
sdm_core.py:3364-3378).
5.6.2 Regularisation C (düzenleme C'si)
- Ne işe yarar. scikit-learn'ün amaç işlevi C\sum_i \ell_i + \tfrac{1}{2}\lVert\beta\rVert^2'dir: C küçüldükçe ceza büyür ve katsayılar sıfıra doğru çekilir. Ceza standartlaştırılmış terimlere uygulandığından bütün terimlere eşit ölçüde etki eder.
- Ne zaman, nasıl ayarlanır. Terim sayısı kayıt sayısına göre büyükse (
interactions, çok öngörücü) C küçültülür (0,1 ya da 0,01). R'dekiglm()cezasızdır (biomod2, sdm ve flexsdm GLM'leri de); onların sonucunu yeniden üretmek için C = 1e6 girilir (ipucu,tabs/tab_models.py:741-743). - Sonuca etkisi. Ceza bir kayıp toplamına göre tanımlandığından satır sayısı arttıkça göreli etkisi azalır: örnek koşuda bir eğitim katı yaklaşık 860 satırdır (1143 satırın dörtte üçü) ve C = 1 hafif bir cezadır. İpucu, Pinus brutia örneğinde varsayılan cezanın çapraz doğrulama AUC'sini 0,804'ten (cezasız) 0,824'e çıkardığını bildirir.
- Dikkat. GLM ayar sekmesinde yoktur; C için arama yapılacaksa aynı ceza ailesini taşıyan GLMNET (l1_ratio = 0) kullanılabilir.
R ile eşdeğerlik. Model terms = linear ve C = 1e6 ile model R'de glm(y ~ x1 + x2 + …, family = binomial) ile aynı amaç işlevini çözer; quadratic için y ~ x + I(x^2) biçimi karşılıktır. biomod2'nin GLM'i terimleri AIC'ye dayalı adımsal seçimle eler; HABITUS'ta adımsal seçim yoktur, onun yerine ceza vardır.
5.7 GBM: gradyan artırma (scikit-learn)
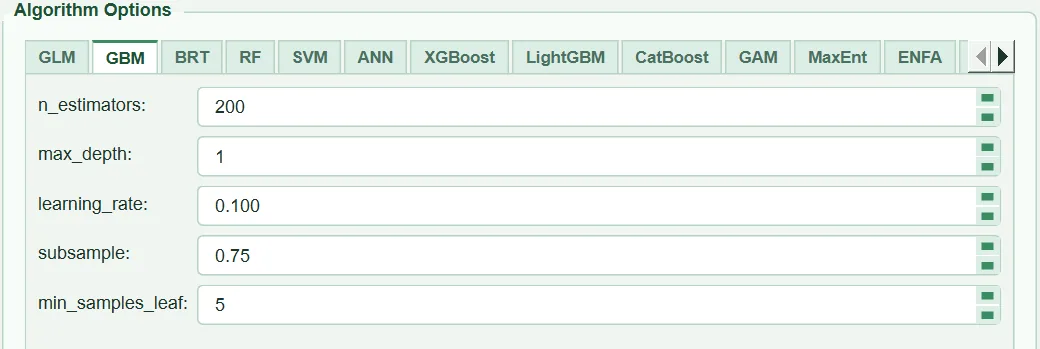
Aile ve uygulama. Gradyan artırmalı karar ağaçları (boosting): her yeni ağaç, önceki ağaçların toplamının hatasını (log-kaybın gradyanını) düzeltir. scikit-learn GradientBoostingClassifier (sdm_core.py:3516-3529). Varlık–sözde yokluk. Ölçekleme gerekmez. GBM ile BRT aynı uygulamayı kullanır; yalnız varsayılanları ve aralıkları farklıdır.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
n_estimators: |
Ağaç sayısı | 200 | 10 – 5000 (adım 100) | tabs/tab_models.py:750; sdm_core.py:3524 |
max_depth: |
Ağaç derinliği (gbm: interaction.depth) |
1 | 1 – 10 | tabs/tab_models.py:751-752; sdm_core.py:3525 |
learning_rate: |
Her ağacın katkısını küçülten katsayı (gbm: shrinkage) |
0.100 | 0.001 – 1.0 | tabs/tab_models.py:753; sdm_core.py:3526 |
subsample: |
Her ağaç için çekilen satır oranı (gbm: bag.fraction) |
0.75 | 0.1 – 1.0 (adım 0.05) | tabs/tab_models.py:756-758; sdm_core.py:3527 |
min_samples_leaf: |
Yapraktaki en az satır (gbm: n.minobsinnode) |
5 | 1 – 200 | tabs/tab_models.py:754-755; sdm_core.py:3528 |
5.7.1 n_estimators ve learning_rate
- Ne işe yarar. Model F = \sum_{m=1}^{M} \nu\, h_m(x) biçimindedir; M ağaç sayısı, \nu öğrenme hızıdır. İkisi birlikte modelin toplam "öğrenme miktarını" belirler.
- Ne zaman, nasıl ayarlanır. Öğrenme hızı küçültülürse aynı uyum için ağaç sayısı orantılı artırılmalıdır (0,1 → 0,01 ise yaklaşık 10 kat ağaç). Elith ve ark. (2008) en az 1000 ağaca ulaşacak bir öğrenme hızı önerir. En iyi çift
Tuning (optional)sekmesinde flexsdm ızgarasıyla aranabilir. - Sonuca etkisi. Çok ağaç + yüksek hız aşırı uyuma, az ağaç + düşük hız eksik uyuma götürür. Süre ağaç sayısıyla doğrusal artar.
- Dikkat. Ağaç sayısı çapraz doğrulamayla otomatik seçilmez (dismo
gbm.step'teki gibi bir erken durdurma yoktur); girilen sayı aynen kullanılır.
5.7.2 max_depth
- Ne işe yarar. Her ağacın derinliği. 1, tek bölünmeli ağaç (kütük, "stump") demektir ve model öngörücülerin toplamsal bir işlevi olur, etkileşim içermez. 2 ve üstü değişken etkileşimlerine izin verir.
- Ne zaman, nasıl ayarlanır. Varsayılan 1, flexsdm
fit_gbm'ininteraction.depth= 1 varsayılanına yakındır (sdm_core.py:3517-3522). Etkileşimlerin önemli olduğu düşünülüyorsa ve kayıt sayısı yüksekse 2–3 denenir. - Sonuca etkisi. İpucuna göre kütük ağaçlar yüzeyin hücrelerin çoğunda sıfıra çökmesini engeller ve aynı AUC'de daha yüksek Boyce verir (
tabs/tab_models.py:752). - Dikkat. gbm'in
interaction.depth'i ile scikit-learn'ünmax_depth'i 1'de aynı ağacı tanımlar; daha büyük değerlerde iki paketin ağaç büyütme biçimi farklı olduğundan sayılar birebir eşlenmez.
5.7.3 subsample
- Ne işe yarar. Her ağaç, eğitim satırlarının bu oranda rastgele bir alt kümesiyle kurulur (stokastik gradyan artırma).
- Ne zaman, nasıl ayarlanır. 0,5–0,75 aralığı yaygındır; 1,0 bütün satırları kullanır ve rastgeleliği kaldırır.
- Sonuca etkisi. 1'in altındaki değerler varyansı ve aşırı uyumu azaltır; sonuç tohuma bağlı hâle gelir (tohum sabit olduğu için tekrarlanabilir kalır).
- Dikkat. Çok küçük değerler az varlıklı veride bazı ağaçları neredeyse varlıksız bırakabilir.
5.7.4 min_samples_leaf
- Ne işe yarar. Bir yaprakta bulunabilecek en az satır sayısı; daha küçük yapraklar oluşturan bölünmeler yapılmaz.
- Ne zaman, nasıl ayarlanır. Varsayılan 5, gbm'in
n.minobsinnodevarsayılanına karşılık gelir. Gürültülü ya da az kayıtlı veride 10–20'ye çıkarılabilir. - Sonuca etkisi. Büyüdükçe ağaçlar kabalaşır, yüzey düzgünleşir, aşırı uyum azalır.
- Dikkat.
max_depth= 1'de her ağacın yalnız bir bölünmesi olduğundan etkisi sınırlıdır.
5.8 BRT: artırılmış regresyon ağaçları
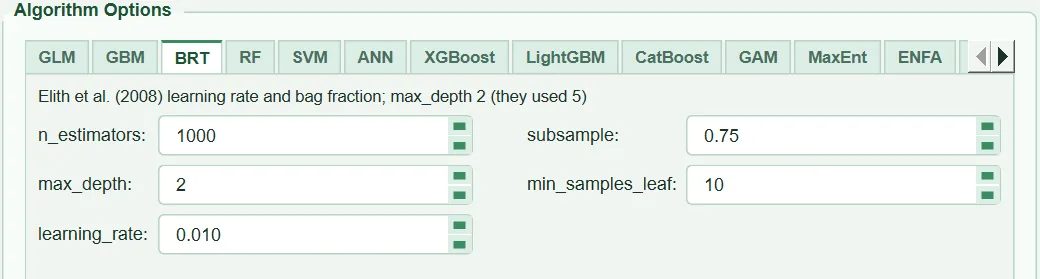
Aile ve uygulama. GBM ile aynı yöntem ve aynı scikit-learn sınıfı (GradientBoostingClassifier), ama Elith ve ark. (2008) rehberine göre seçilmiş varsayılanlarla: düşük öğrenme hızı, çok ağaç, %75 torbalama (sdm_core.py:3530-3548). Varlık–sözde yokluk.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
n_estimators: |
Ağaç sayısı | 1000 | 100 – 10 000 (adım 100) | tabs/tab_models.py:765; sdm_core.py:3543 |
max_depth: |
Ağaç derinliği (Elith ve ark.: tree.complexity) |
2 | 1 – 10 | tabs/tab_models.py:766-767; sdm_core.py:3544 |
learning_rate: |
Öğrenme hızı | 0.010 | 0.001 – 0.5 | tabs/tab_models.py:768; sdm_core.py:3545 |
subsample: |
Torbalama oranı (bag.fraction) |
0.75 | 0.1 – 1.0 | tabs/tab_models.py:769; sdm_core.py:3546 |
min_samples_leaf: |
Yapraktaki en az satır | 10 | 1 – 100 | tabs/tab_models.py:770; sdm_core.py:3547 |
5.8.1 max_depth
- Ne işe yarar. Ağaç karmaşıklığı; etkileşim düzeyini belirler.
- Ne zaman, nasıl ayarlanır. Elith ve ark. (2008) örneklerinde
tree.complexity= 5 kullanmıştır. HABITUS 2'yi varsayılan alır; kod açıklamasına göre varlık–sözde yokluk verisinde derin ağaçlar hücrelerin çoğunun uygunluğunu sıfıra iter ve Boyce indeksini yarıya düşürür (sdm_core.py:3532-3537). Özgün ayar için 5 girilir. - Sonuca etkisi. Derinlik arttıkça etkileşim ve eğitim uyumu artar, uygunluk yüzeyi keskinleşir.
- Dikkat. Derinlik artınca aynı uyum için daha az ağaç gerekir;
n_estimatorsile birlikte düşünülmelidir.
5.8.2 n_estimators, learning_rate, subsample, min_samples_leaf
- Ne işe yarar. GBM'dekiyle aynıdır (§5.7).
- Ne zaman, nasıl ayarlanır. Elith ve ark. (2008) öğrenme hızını en az 1000 ağaç oluşacak biçimde seçmeyi önerir; varsayılan 0,01 ve 1000 ağaç bu kuralı izler.
subsample0,75 yazarların önerdiği torbalama oranıdır. - Sonuca etkisi. Öğrenme hızı 0,01'den 0,005'e indirilip ağaç sayısı 2000'e çıkarılırsa model genellikle benzer ama daha düzgün olur; süre iki katına çıkar.
- Dikkat. dismo
gbm.stepağaç sayısını 10 katlı çapraz doğrulamayla kendisi seçer; HABITUS'ta ağaç sayısı sabittir ve BRT ayar sekmesinde yoktur. Ağaç sayısını veriye göre seçmek isteyen kullanıcı GBM'i ayar sekmesinde arayıp aynı değerleri burada kullanabilir.
5.9 RF: rastgele orman
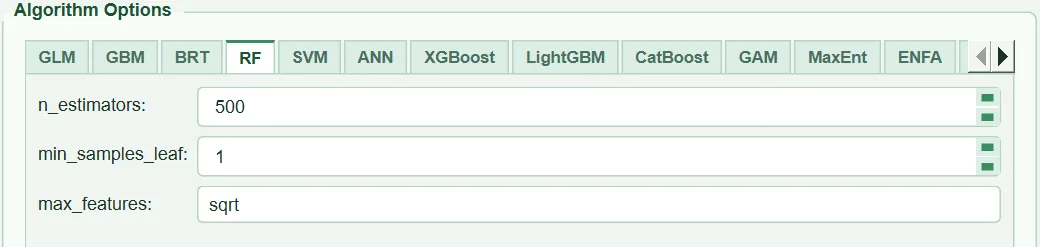
Aile ve uygulama. Torbalanmış (bootstrap) sınıflandırma ağaçlarının topluluğu; her bölünmede öngörücülerin rastgele bir alt kümesi denenir (Breiman 2001). scikit-learn RandomForestClassifier; ağaç derinliği sınırsız, bütün işlemci çekirdekleri kullanılır (sdm_core.py:3549-3561). Uygunluk, ağaçların yaprak oranlarının ortalamasıdır. Varlık–sözde yokluk.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
n_estimators: |
Ağaç sayısı (randomForest: ntree) |
500 | 50 – 2000 (adım 100) | tabs/tab_models.py:778; sdm_core.py:3555 |
min_samples_leaf: |
Yapraktaki en az satır (randomForest: nodesize) |
1 | 1 – 50 | tabs/tab_models.py:779; sdm_core.py:3557 |
max_features: |
Her bölünmede denenen öngörücü sayısı (randomForest: mtry) |
sqrt |
sqrt, log2, tamsayı, 0–1 arası oran |
tabs/tab_models.py:780-783, 1160-1172; sdm_core.py:3558 |
5.9.1 n_estimators
- Ne işe yarar. Ormandaki ağaç sayısı.
- Ne zaman, nasıl ayarlanır. Kod açıklaması Oshiro ve ark.'nın (2012) en az 128 ağaç önerisini ve 500'ün çoğu SDM verisinde kararlı olduğunu belirtir (
sdm_core.py:3550-3553). 500 çoğu durumda yeterlidir; harita gürültülü görünüyorsa 1000'e çıkarılır. - Sonuca etkisi. Ağaç sayısı aşırı uyum yaratmaz; yalnız tahminin rastgele dalgalanmasını azaltır. Süre ve bellek doğrusal artar (örnek koşuda 4 kat 21 s).
- Dikkat. Ağaç sayısını artırmak, RF'nin eğitim verisine sıkı uymasını (örnek koşuda eğitim AUC 1,000) değiştirmez; bunun için yaprak boyu kullanılır.
5.9.2 min_samples_leaf
- Ne işe yarar. Yapraktaki en az satır; 1, ağaçların tam büyütülmesi demektir (randomForest sınıflandırma varsayılanı
nodesize= 1). - Ne zaman, nasıl ayarlanır. Eğitim–test AUC farkı büyükse ya da harita lekeli görünüyorsa 5–10'a çıkarılır.
- Sonuca etkisi. Büyüdükçe olasılık yüzeyi düzgünleşir, eğitim AUC'si düşer, aşırı uyum azalır.
- Dikkat. Çok büyük değer, az varlıklı veride varlıkları sözde yokluklarla aynı yaprağa zorlar ve ayırma gücünü düşürür.
5.9.3 max_features
- Ne işe yarar. Her bölünmede rastgele seçilen aday öngörücü sayısı.
sqrt= \lfloor\sqrt{p}\rfloor (8 öngörücüde 2),log2= \lfloor\log_2 p\rfloor, tamsayı = o kadar öngörücü, 0–1 arası sayı = öngörücülerin o oranı. - Ne zaman, nasıl ayarlanır.
sqrt, Breiman'ın sınıflandırma için önerdiği ve R randomForest'in varsayılanmtrydeğeridir. Ayar sekmesi flexsdm gibi 2'den öngörücü sayısına kadar dener. - Sonuca etkisi. Küçük değer ağaçları birbirinden farklılaştırır (korelasyonu azaltır); büyük değer güçlü öngörücülerin her ağaçta öne çıkmasına yol açar.
- Dikkat. Okunamayan bir giriş çalıştırmayı "RF max_features: '…' is not sqrt, log2, a whole number of variables or a fraction between 0 and 1." iletisiyle durdurur; sıfır ya da negatif değer de reddedilir (
tabs/tab_models.py:1160-1172). 1 girilirse bu "1 öngörücü" demektir, "%100" değil.
R ile eşdeğerlik. Varsayılanlar R randomForest(…, ntree = 500, mtry = floor(sqrt(p)), nodesize = 1) sınıflandırmasıyla aynıdır. Fark: randomForest olasılığı ağaç oylarının oranından, scikit-learn yaprak oranlarının ortalamasından hesaplar; yaprak boyu 1'de ikisi çok yakındır. Valavi ve ark.'nın (2021) önerdiği aşağı örnekli (down-sampled) RF HABITUS'ta yoktur; Balance classes ağırlıklandırma yapar, aşağı örnekleme yapmaz.
5.10 SVM: destek vektör makinesi
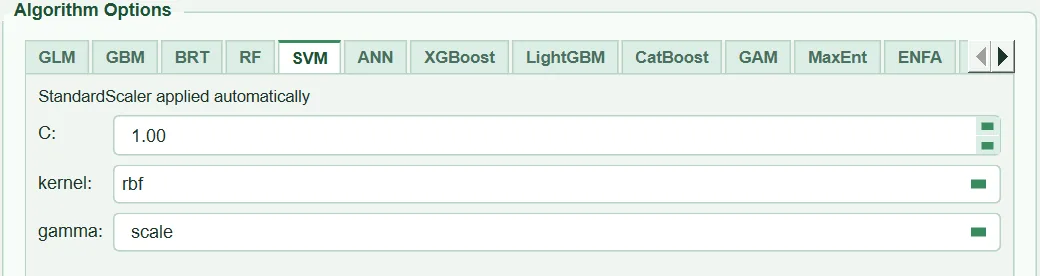
Aile ve uygulama. Çekirdek (kernel) tabanlı sınır sınıflandırıcısı. scikit-learn SVC, probability=True ile: olasılıklar Platt ölçeklemesiyle, scikit-learn'ün kendi iç çapraz doğrulamasında elde edilir (sdm_core.py:3562-3568). Öngörücüler standartlaştırılır, kategorikler one-hot kodlanır. Varlık–sözde yokluk.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
C: |
Hata cezası; küçüldükçe daha düzgün sınır | 1.00 | 0.001 – 1000 | tabs/tab_models.py:789; sdm_core.py:3565 |
kernel: |
Çekirdek işlevi | rbf |
rbf, linear, poly, sigmoid |
tabs/tab_models.py:790 |
gamma: |
Çekirdek genişliği (RBF, poly, sigmoid) | scale |
scale, auto ya da sayı |
tabs/tab_models.py:791-793, 1156-1159 |
5.10.1 C
- Ne işe yarar. Yanlış sınıflanan eğitim noktalarının cezası. Büyük C eğitim verisine sıkı uyan karmaşık bir sınır, küçük C daha düzgün bir sınır verir.
- Ne zaman, nasıl ayarlanır. flexsdm
tune_svm1–16 aralığını dener; ayar sekmesi aynı ızgarayı kullanır. - Sonuca etkisi. C büyüdükçe eğitim AUC'si yükselir, aşırı uyum artar.
- Dikkat. SVM'nin süresi satır sayısıyla kabaca kare-küp ölçeğinde artar; on binlerce sözde yoklukta yavaştır.
5.10.2 kernel ve gamma
- Ne işe yarar. RBF çekirdeği k(x,x') = \exp(-\gamma\lVert x-x'\rVert^2)'dir; \gamma bir eğitim noktasının etki yarıçapını belirler.
scale= 1/(p\cdot \mathrm{Var}(X)),auto= 1/p. Öngörücüler standartlaştırıldığı için sürekli değişkenlerle ikisi aynı değeri verir; one-hot sütunlar varsa farklılaşır. - Ne zaman, nasıl ayarlanır. RBF çoğu SDM için yeterlidir. Kutuya sayı da yazılabilir; ayar sekmesi buraya sayı yazar. flexsdm'in kernlab
sigma'sı scikit-learngamma'sıyla aynı tanımdır, dönüştürme gerekmez (sdm_tuning.py:654-675). - Sonuca etkisi. Büyük \gamma dar etki alanı, lekeli ve aşırı uyumlu yüzey; küçük \gamma düzgün, doğrusala yakın yüzey verir.
linearçekirdektegammaetkisizdir. - Dikkat. Platt ölçeklemesi kendi iç çapraz doğrulamasını kullandığından olasılık sıralaması
decision_functionsıralamasıyla birebir aynı olmayabilir; bu scikit-learn'ün belgelenmiş davranışıdır.
5.11 ANN: yapay sinir ağı (çok katmanlı algılayıcı)
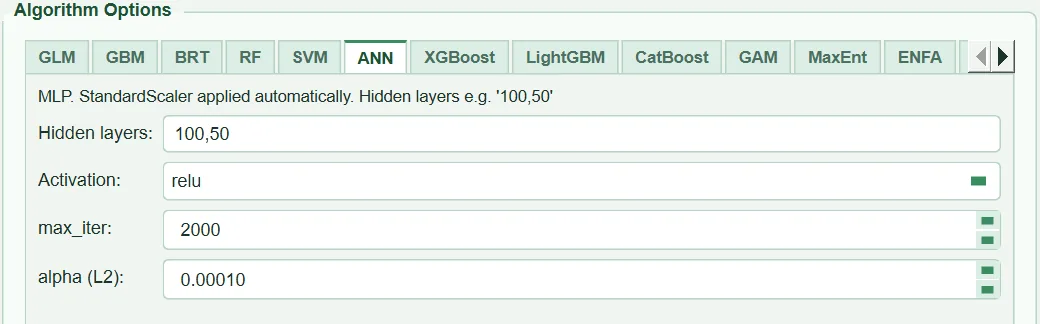
Aile ve uygulama. İleri beslemeli sinir ağı. scikit-learn MLPClassifier (Adam eniyileyicisi, scikit-learn varsayılanı), öngörücüler standartlaştırılır, kategorikler one-hot kodlanır (sdm_core.py:3569-3581). Varlık–sözde yokluk.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Hidden layers: |
Gizli katmanlardaki nöron sayıları, virgülle | 100,50 |
pozitif tamsayılar listesi | tabs/tab_models.py:799, 1144-1154 |
Activation: |
Etkinleştirme işlevi | relu |
relu, tanh, logistic |
tabs/tab_models.py:800 |
max_iter: |
En çok eğitim yinelemesi (dönem) | 2000 | 100 – 5000 | tabs/tab_models.py:801 |
alpha (L2): |
Ağırlıklara L2 cezası | 0.00010 | 0.0 – 100.0 | tabs/tab_models.py:802-804; sdm_core.py:3579 |
5.11.1 Hidden layers
- Ne işe yarar.
100,50iki gizli katman (100 ve 50 nöron) demektir;5tek katmanda 5 nöron. - Ne zaman, nasıl ayarlanır. Varsayılan ağ binlerce ağırlık taşır; yüz–iki yüz varlıklı tipik SDM verisi için büyüktür. R nnet (biomod2, flexsdm) tek gizli katman ve birkaç nöron kullanır; flexsdm
tune_net2–8 nöron dener. Az kayıtta tek katman ve 4–8 nöron önerilir. - Sonuca etkisi. Nöron arttıkça esneklik ve aşırı uyum artar, süre uzar.
- Dikkat. Okunamayan giriş "ANN hidden layers: '…' is not a list of positive whole numbers separated by commas (e.g. 100, 50)." iletisiyle çalıştırmayı durdurur (
tabs/tab_models.py:1144-1154).
5.11.2 alpha (L2)
- Ne işe yarar. Ağırlıkların karelerine ceza (ağırlık sönümü).
- Ne zaman, nasıl ayarlanır. nnet'in
decayparametresi \alpha = 2\timesdecayile karşılanır (ipucu vesdm_tuning.py:678-689; bu bağıntı iki amaç işlevinden türetilmiştir, R nnet ile sayısal olarak sınanmamıştır). flexsdm ızgarasının decay 0,01–10 aralığı alpha 0,02–20'ye karşılık gelir; varsayılan 0,0001 bunlardan çok küçüktür. - Sonuca etkisi. Büyüdükçe yüzey düzgünleşir, aşırı uyum azalır.
- Dikkat. Büyük ağ + küçük alpha birleşimi en kolay aşırı uyan ayardır.
5.11.3 Activation ve max_iter
- Ne işe yarar.
reluparçalı doğrusal,tanhvelogisticdüzgün S biçimli tepki üretir.max_itereniyileyicinin en çok dönem sayısıdır. - Ne zaman, nasıl ayarlanır. nnet
logisticetkinleştirme kullanır; R ile karşılaştırmadalogisticseçilebilir. Yakınsama uyarısı görülürsemax_iterartırılır. - Sonuca etkisi.
relutepki eğrilerinde köşeli geçişler,logistic/tanhdaha düzgün eğriler verir. - Dikkat. Erken durdurma kullanılmaz; ağ
max_iter'e ya da scikit-learn'ün yakınsama ölçütüne kadar eğitilir.
5.12 XGBoost: aşırı gradyan artırma
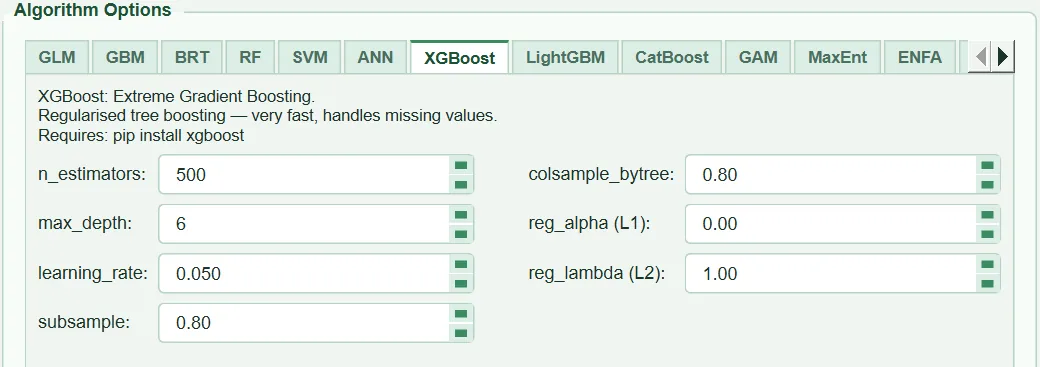
Aile ve uygulama. Düzenlemeli gradyan artırmalı ağaçlar (Chen ve Guestrin 2016), xgboost.XGBClassifier, kayıp işlevi log-kayıp (sdm_core.py:3582-3608). Varlık–sözde yokluk. Arayüzde olmayan iki ayar sabittir: min_child_weight = 1, gamma = 0.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
n_estimators: |
Artırma turu (ağaç) sayısı | 500 | 50 – 5000 | tabs/tab_models.py:815 |
max_depth: |
Ağaç derinliği | 6 | 1 – 12 | tabs/tab_models.py:816 |
learning_rate: |
Öğrenme hızı (eta) | 0.050 | 0.001 – 0.5 | tabs/tab_models.py:817 |
subsample: |
Ağaç başına satır oranı | 0.80 | 0.1 – 1.0 | tabs/tab_models.py:818 |
colsample_bytree: |
Ağaç başına öngörücü oranı | 0.80 | 0.1 – 1.0 | tabs/tab_models.py:819 |
reg_alpha (L1): |
Yaprak ağırlıklarına L1 cezası | 0.00 | 0 – 10 | tabs/tab_models.py:820 |
reg_lambda (L2): |
Yaprak ağırlıklarına L2 cezası | 1.00 | 0 – 10 | tabs/tab_models.py:821 |
5.12.1 n_estimators, learning_rate, max_depth
- Ne işe yarar. GBM'deki gibi ağaç sayısı, öğrenme hızı ve derinlik.
- Ne zaman, nasıl ayarlanır. Varsayılan derinlik 6, GBM (1) ve BRT'ye (2) göre çok derindir ve yüksek etkileşim düzeyine izin verir; birkaç yüz varlıkta 2–3 daha güvenlidir. Ayar sekmesinin ızgarası derinlik 3/6/9, hız 0,01/0,05/0,1, tur 100/300/500'dür.
- Sonuca etkisi. Derinlik ve tur arttıkça eğitim uyumu ve aşırı uyum artar.
- Dikkat. Erken durdurma yoktur; tur sayısı sabittir.
5.12.2 subsample ve colsample_bytree
- Ne işe yarar. Her ağaç satırların ve öngörücülerin bu oranlardaki rastgele alt kümesiyle kurulur.
- Ne zaman, nasıl ayarlanır. 0,5–0,9 aralığı yaygındır; az öngörücüde (ör. 4)
colsample_bytreeküçültülürse bazı ağaçlar önemli değişkeni hiç görmez. - Sonuca etkisi. Küçük oranlar varyansı ve aşırı uyumu azaltır.
- Dikkat. Sonuç tohuma bağlıdır; tohum sabit olduğundan tekrarlanabilir.
5.12.3 reg_alpha ve reg_lambda
- Ne işe yarar. Yaprak değerlerine L1 ve L2 cezaları; yaprak tahminlerini küçültür.
- Ne zaman, nasıl ayarlanır. Varsayılanlar XGBoost'un kendi varsayılanlarıdır (0 ve 1). Aşırı uyum görülürse
reg_lambda5–10'a çıkarılabilir. - Sonuca etkisi. Ceza arttıkça olasılık yüzeyi 0,5'e doğru sıkışır ve düzgünleşir.
- Dikkat. Arayüz notu XGBoost'un eksik değerleri işleyebildiğini söyler; HABITUS'ta eksik değerli satırlar veri hazırlığında zaten çıkarıldığından bu özellik kullanılmaz.
5.13 LightGBM: hafif gradyan artırma
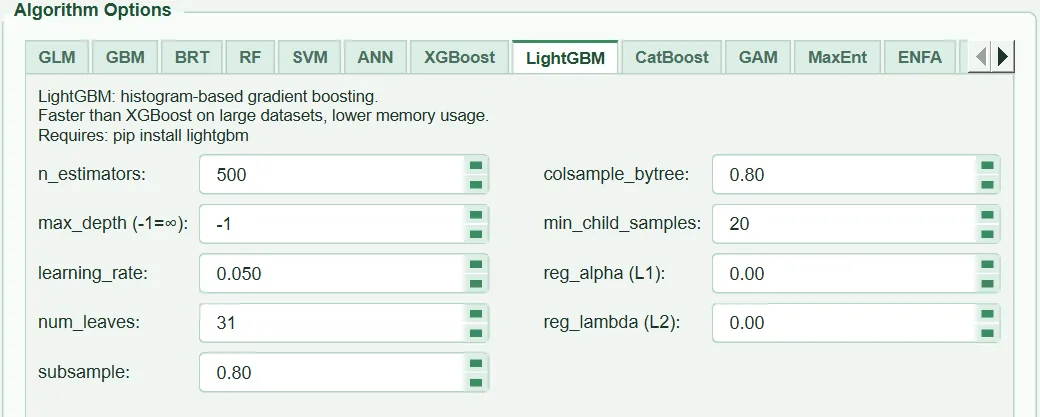
Aile ve uygulama. Histogram tabanlı, yaprak öncelikli (leaf-wise) büyüyen gradyan artırma; lightgbm.LGBMClassifier (sdm_core.py:3610-3628). Ağaç büyüklüğü derinlikle değil yaprak sayısıyla denetlenir. Varlık–sözde yokluk.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
n_estimators: |
Tur sayısı | 500 | 50 – 5000 | tabs/tab_models.py:837 |
max_depth (-1=∞): |
Derinlik sınırı | -1 (sınırsız) | -1 – 100 | tabs/tab_models.py:838 |
learning_rate: |
Öğrenme hızı | 0.050 | 0.001 – 0.5 | tabs/tab_models.py:839 |
num_leaves: |
Ağaç başına en çok yaprak | 31 | 2 – 255 | tabs/tab_models.py:840 |
subsample: |
Satır alt örnekleme oranı | 0.80 | 0.1 – 1.0 | tabs/tab_models.py:841 |
colsample_bytree: |
Ağaç başına öngörücü oranı | 0.80 | 0.1 – 1.0 | tabs/tab_models.py:842 |
min_child_samples: |
Yapraktaki en az satır | 20 | 1 – 200 | tabs/tab_models.py:843 |
reg_alpha (L1): |
L1 cezası | 0.00 | 0 – 10 | tabs/tab_models.py:844 |
reg_lambda (L2): |
L2 cezası | 0.00 | 0 – 10 | tabs/tab_models.py:845 |
5.13.1 num_leaves ve max_depth
- Ne işe yarar.
num_leavesağacın karmaşıklığını doğrudan sınırlar;max_depth= -1 derinliği sınırsız bırakır. - Ne zaman, nasıl ayarlanır. 31 yaprak, derinliği 5 olan dengeli bir ağaçtan daha karmaşıktır; az kayıtta 7–15 yaprak ve
max_depth3–4 daha uygundur. Ayar sekmesi 15/31/63 dener. - Sonuca etkisi. Yaprak arttıkça etkileşim ve aşırı uyum artar.
- Dikkat. Yaprak öncelikli büyüme az veride çok derin, dar dallar üretebilir;
max_depthile sınırlamak bunu önler.
5.13.2 min_child_samples
- Ne işe yarar. Bir yaprakta bulunması gereken en az satır.
- Ne zaman, nasıl ayarlanır. Varsayılan 20; 50'den az varlıkta varlıkları içeren yaprakların oluşmasını zorlaştırabilir, 5–10'a indirilebilir.
- Sonuca etkisi. Büyüdükçe model kabalaşır.
- Dikkat. Çok az varlıkta modelin hiç bölünme bulamaması ve neredeyse sabit tahmin vermesi mümkündür.
5.13.3 subsample ve colsample_bytree
- Ne işe yarar. Satır ve öngörücü alt örnekleme oranları.
- Ne zaman, nasıl ayarlanır.
colsample_bytreeher ağaçta uygulanır. - Sonuca etkisi.
colsample_bytreeküçüldükçe ağaçlar çeşitlenir. - Dikkat. LightGBM'de satır alt örneklemesi (
subsample) yalnızsubsample_freqsıfırdan büyükken etkindir; HABITUS bu ayarı vermediğinden (sdm_core.py:3613-3628)subsampledeğeri sonuca yansımaz.
5.13.4 n_estimators, learning_rate, reg_alpha, reg_lambda
- Ne işe yarar. XGBoost'taki anlamlarıyla aynıdır (§5.12).
- Ne zaman, nasıl ayarlanır. LightGBM'in kendi varsayılan cezaları sıfırdır; aşırı uyumda
reg_lambdaartırılır. - Sonuca etkisi. Bkz. §5.12.
- Dikkat. Erken durdurma yoktur.
5.14 CatBoost: kategorik artırma
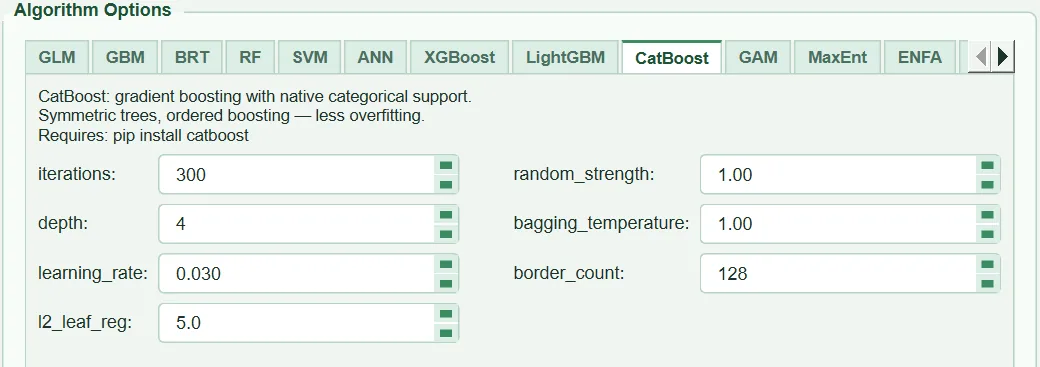
Aile ve uygulama. Simetrik (her düzeyde aynı bölünmeyi kullanan) ağaçlarla sıralı artırma; catboost.CatBoostClassifier (sdm_core.py:3630-3647). Varlık–sözde yokluk.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
iterations: |
Tur sayısı | 300 | 50 – 5000 | tabs/tab_models.py:863 |
depth: |
Simetrik ağaç derinliği | 4 | 1 – 16 | tabs/tab_models.py:864 |
learning_rate: |
Öğrenme hızı | 0.030 | 0.001 – 0.5 | tabs/tab_models.py:865 |
l2_leaf_reg: |
Yaprak değerlerine L2 cezası | 5.0 | 0 – 20 | tabs/tab_models.py:866 |
random_strength: |
Bölünme skorlarına eklenen gürültü | 1.00 | 0.01 – 10 | tabs/tab_models.py:867 |
bagging_temperature: |
Bayesçi bootstrap ağırlıklarının gücü | 1.00 | 0 – 10 | tabs/tab_models.py:868 |
border_count: |
Sürekli öngörücülerin bölünme sınırı sayısı | 128 | 1 – 255 | tabs/tab_models.py:869 |
5.14.1 iterations, learning_rate, depth
- Ne işe yarar. Tur sayısı, öğrenme hızı ve ağaç derinliği. Simetrik ağaçta derinlik d, tam olarak 2^d yaprak demektir (4 → 16 yaprak).
- Ne zaman, nasıl ayarlanır. Varsayılanlar (300 tur, 0,03, derinlik 4) CatBoost'un kütüphane varsayılanlarından (1000 tur, derinlik 6) daha küçük bir modeldir. CatBoost ayar sekmesinde yoktur; değerler elle denenir.
- Sonuca etkisi. Derinlik ve tur arttıkça eğitim uyumu artar.
- Dikkat. Hız ile tur sayısı birlikte düşünülmelidir (§5.7.1).
5.14.2 l2_leaf_reg, random_strength, bagging_temperature
- Ne işe yarar.
l2_leaf_regyaprak değerlerini küçültür;random_strengthbölünme seçimine rastgelelik katar;bagging_temperaturesatır ağırlıklarının rastgeleliğini belirler (0 = bütün satırlar eşit ağırlıkta). - Ne zaman, nasıl ayarlanır. Aşırı uyumda
l2_leaf_regartırılır (CatBoost'un kendi varsayılanı 3, HABITUS 5 kullanır). - Sonuca etkisi. Üçü de büyüdükçe model düzgünleşir ve tohuma duyarlılığı artar.
- Dikkat.
bagging_temperature= 0 rastgeleliği kaldırmaz;random_strengthyine etkilidir.
5.14.3 border_count
- Ne işe yarar. Her sürekli öngörücünün kaç olası bölünme noktasına (kantil sınırına) ayrılacağı.
- Ne zaman, nasıl ayarlanır. 128 çoğu biyoiklim değişkeni için yeterli çözünürlüktür.
- Sonuca etkisi. Küçük değer tepki eğrilerini basamaklı yapar; büyük değer süreyi uzatır.
- Dikkat. Kategorik değişkenler HABITUS'ta CatBoost'a kategorik olarak bildirilmez; tamsayı kodu sürekli bir sütun gibi bu sınırlarla bölünür (§5.4.3). Arayüz notundaki "native categorical support" bu nedenle HABITUS'ta kullanılmaz.
5.15 GAM: genelleştirilmiş toplamsal model
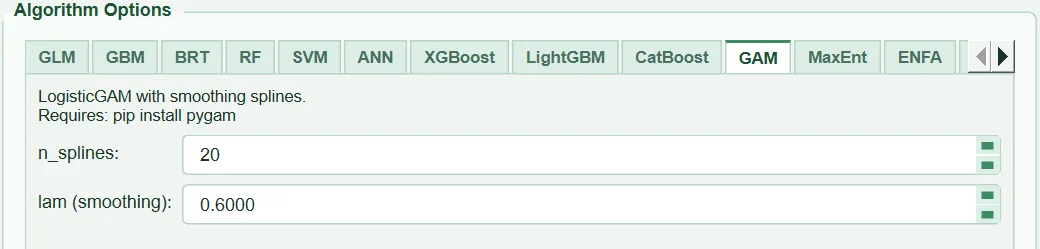
Aile ve uygulama. Lojistik toplamsal model: logit, her öngörücünün düzgün (spline) bir işlevinin toplamıdır (Hastie ve Tibshirani 1986). pygam LogisticGAM; her sürekli öngörücüye cezalı bir B-spline terimi s(), her kategorik öngörücüye faktör terimi f() verilir; etkileşim terimi yoktur (sdm_core.py:4500-4549). Varlık–sözde yokluk. Ham değerlerle çalışır.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
n_splines: |
Öngörücü başına spline taban işlevi sayısı | 20 | 4 – 100 | tabs/tab_models.py:881-886; sdm_core.py:4508-4512 |
lam (smoothing): |
Düzgünleştirme cezası | 0.6000 | 0.0001 – 1000 | tabs/tab_models.py:887-892; sdm_core.py:4513-4514 |
5.15.1 n_splines
- Ne işe yarar. Her tepki eğrisinin kurulduğu taban işlevi sayısı; eğrinin en yüksek esnekliğini belirler. Spline derecesi 3 olduğundan 3'ten büyük olmalıdır; aksi hâlde "GAM n_splines must exceed the spline order (3)." iletisi verilir.
- Ne zaman, nasıl ayarlanır. 20 pygam'ın varsayılanıdır. Az kayıtta 5–10 yeterlidir ve daha az parametre demektir; ayar sekmesi 5/10/15/20 dener.
- Sonuca etkisi. Arttıkça eğriler daha kıvrımlı olabilir (ceza izin verdiği ölçüde); süre artar.
- Dikkat. Bütün öngörücülere aynı değer uygulanır.
5.15.2 lam (düzgünleştirme cezası)
- Ne işe yarar. Eğrinin ikinci türevine (kıvrımına) uygulanan ceza katsayısı. Büyük
lameğriyi doğruya yaklaştırır. - Ne zaman, nasıl ayarlanır. 0,6 pygam'ın varsayılanıdır. Tepki eğrileri dalgalı ve ekolojik olarak inandırıcı değilse 2–10'a çıkarılır; ayar sekmesi 0,1/0,6/2/10 dener.
- Sonuca etkisi. Örnek koşuda (varsayılanlarla) GAM'ın eğitim–test AUC farkı 0,087'dir; GLM'in (0,031) neredeyse üç katı. Bu, düzgünleştirmenin bu veride hafif kaldığına işaret eder.
- Dikkat. Ceza veriden otomatik seçilmez; girilen
lamsabit kullanılır.
R ile eşdeğerlik. biomod2 ve flexsdm GAM'ları mgcv kullanır; mgcv düzgünleştirme katsayısını veriden (GCV/REML) kestirir ve varsayılan taban ince plaka regresyon spline'ıdır. HABITUS'taki pygam modeli sabit lam ile çalışır; bu nedenle iki programın tepki eğrileri aynı veride farklı düzgünlükte olabilir.
Dikkat: GAM sınıf dengesini desteklemez;
Balance classesGAM'ı etkilemez (sdm_core.py:3681).
5.16 MaxEnt: en yüksek entropi
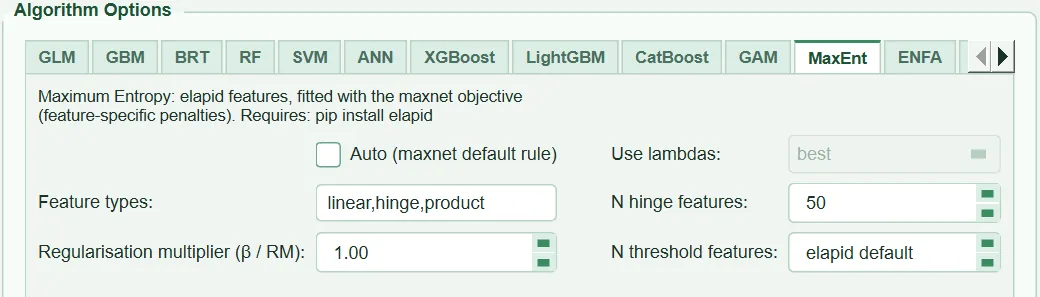
Aile ve uygulama. Varlık + arka plan yöntemi (Phillips ve ark. 2006, 2017). Öngörücülerden "özellikler" (doğrusal, kare, çarpım, menteşe, eşik) türetilir ve L1 cezalı bir modelle hangi özelliklerin kalacağı belirlenir. HABITUS özellikleri elapid kütüphanesiyle üretir (Anderson 2023), katsayıları ise R maxnet'in amaç işlevini çözerek kestirir (sdm_core.py:3776-3836, 4551-4757). Çıktı elapid'in cloglog dönüşümüdür ve sonradan yeniden ölçeklenmez (sdm_core.py:4772-4845).
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Auto (maxnet default rule) |
Özellik sınıflarını varlık sayısından seçer | kapalı | açık / kapalı | tabs/tab_models.py:1056-1063; sdm_core.py:3758-3773 |
Feature types: |
Özellik sınıfları, virgülle | linear,hinge,product |
linear, quadratic, hinge, product, threshold |
tabs/tab_models.py:1048-1055; sdm_core.py:4616-4624 |
Regularisation multiplier (β / RM): |
Düzenleme çarpanı | 1.00 | 0.1 – 20.0 (adım 0.5) | tabs/tab_models.py:1064-1077; sdm_core.py:4625 |
Use lambdas: |
Kullanılmaz (devre dışı) | best |
best, last |
tabs/tab_models.py:1078-1085 |
N hinge features: |
Öngörücü başına menteşe düğümü sayısı | 50 | 10 – 200 | tabs/tab_models.py:1086; sdm_core.py:4626 |
N threshold features: |
Öngörücü başına eşik özelliği sayısı | elapid default (0 = elapid'in 10'u) |
0 – 200 | tabs/tab_models.py:1087-1091; sdm_core.py:4645-4649 |
5.16.1 maxnet amaç işlevi birebir uygulanır
HABITUS derlemelerinde R glmnet'in Python karşılığı bulunmadığından elapid kendi başına tek bir ceza katsayılı scikit-learn lojistik regresyonuna düşer. Bu yolda özelliğe özgü cezalar yoktur ve düzenleme çarpanı modeli neredeyse değiştirmez (sdm_core.py:3780-3787). HABITUS bu nedenle elapid'in kurduğu özellik dönüştürücüsünü kullanır, katsayıları ise maxnet_refit işleviyle yeniden kestirir (sdm_core.py:4719-4746). maxnet, glmnet'i standardize = FALSE, özellik başına ceza çarpanları ve w_i = p_i + 100(1-p_i) ağırlıklarıyla (varlık 1, arka plan 100) bir λ yolu boyunca çözer ve son λ'yı tutar. Bu son λ'da çözülen problem, sabit bir çarpan dışında şudur (sdm_core.py:3789-3797):
Burada \ell_i lojistik kayıp, r_j özellik j'nin düzenleme değeridir. r_j elapid'in compute_regularization işleviyle özellik sınıfına, varlık sayısına, özelliğin varlıklardaki dağılımına ve β çarpanına göre hesaplanır (sdm_core.py:3810-3816). Kesişim cezasızdır. Problem liblinear ile, özellikler n_{\text{varlık}}\cdot r_j'ye bölünerek çözülür; ardından MaxEnt normalleştirme sabitleri (alpha, entropi) arka plan satırlarından yeniden hesaplanır (sdm_core.py:3817-3835). Koşunun kaydında bu çözücü "maxnet objective (feature-specific L1 penalties, last lambda)" olarak yazılır (sdm_core.py:4743-4744).
Varlıklar arka plana eklenir. maxnet'in addsamplestobackground = TRUE ve Maxent'in varsayılan davranışı gibi, öngörücü değerleri arka plan satırlarında bulunmayan her varlık arka plana da eklenir (sdm_core.py:4698-4707). Eklenen sayı habitus_run_config.json içinde maxent_settings_used.presences_added_to_background alanına yazılır; örnek koşunun tam modelinde 91'dir.
R maxnet ile otomatik test. tests/test_maxent_maxnet.py, Rutrough ve ark.'nın (2019) verisinin bir alt kümesinde (302 varlık, 2000 arka plan satırı; ppt, silt, slope) HABITUS'un cloglog tahminini R maxnet 0.1.4 çıktısıyla karşılaştırır. Üç ayar sınanır (LQH β=3, LQH β=1, LQPH β=3); her birinde Pearson ve Spearman korelasyonunun 0,995'ten, ortalama mutlak farkın 0,02'den küçük olması beklenir (tests/test_maxent_maxnet.py:39-50). İki ek test, β büyüdükçe sıfırdan farklı katsayı sayısının azaldığını (53-59) ve varlıkların arka plana eklendiğini (62-64) denetler. R çıktısı testle birlikte saklanan bir dosyadır; testin kendisi R çalıştırmaz. Kod açıklaması aynı veride R maxnet ile Schoener D = 0,998 uyum bildirir (sdm_core.py:3799-3800).
5.16.2 Feature types ve Auto (maxnet default rule)
- Ne işe yarar. Hangi özellik sınıflarının üretileceğini belirler:
linear(doğrusal),quadratic(kare),product(ikili çarpım),hinge(menteşe; bir düğümden sonra doğrusal artan ya da azalan parçalı işlev),threshold(eşik; basamak).Autoişaretliyse sınıflar her uyumun eğitim varlık sayısından maxnet kuralıyla seçilir: 10'dan az varlık L; 10–14 LQ; 15–79 LQH; 80 ve üstü LQHP. Eşik sınıfı otomatik kuralda hiç kullanılmaz; kutu işaretliyken metin kutusu yok sayılır ve devre dışı kalır. - Ne zaman, nasıl ayarlanır. Az kayıtta
linearya dalinear,quadraticsavunulabilir seçimdir (ipucu). Merow ve ark. (2013) karmaşıklığın soruya ve veriye göre seçilmesini önerir. ENMeval/Wallace'taki gibi bir arama için ayar sekmesi L, LQ, H, LQH, LQHP setlerini dener. - Sonuca etkisi. Az sınıf düzgün ve aktarılabilir tepki, çok sınıf (özellikle menteşe ve eşik) kalibrasyon verisine sıkı uyan, basamaklı tepki verir.
Autoaçıkken çapraz doğrulama katları ve tam model, varlık sayılarına göre farklı sınıf setleri kullanabilir (sdm_core.py:4619-4622); kullanılan kural kayda yazılır. - Dikkat. Varsayılan
linear,hinge,product, maxnet'in kuralıyla aynı değildir (kare sınıfı yoktur). maxnet ile karşılaştırma yapılacaksaAutoişaretlenmelidir.
5.16.3 Regularisation multiplier (β / RM)
- Ne işe yarar. Bütün r_j değerlerini çarpan katsayı. Büyüdükçe L1 cezası artar, daha az özellik sıfırdan farklı kalır.
- Ne zaman, nasıl ayarlanır. maxnet ve Maxent varsayılanı 1'dir. Tek doğru değer yoktur; ENMeval (Muscarella ve ark. 2014) ve kuenm bu nedenle çarpanı arar. Ayar sekmesi rm 0,5–4,0'ı (adım 0,5) özellik setleriyle çapraz dener ve seçileni buraya yazar. En iyi değer kalibrasyon alanına bağlıdır; alan değişirse yeniden aranmalıdır (ipucu).
- Sonuca etkisi. β = 1'den 6'ya çıkarıldığında sıfırdan farklı katsayı sayısının azaldığı testle sınanır (
tests/test_maxent_maxnet.py:53-59). Haritada büyük β daha geniş ve yumuşak, küçük β daha dar ve lekeli uygunluk verir. - Dikkat. Değerin etkisi ancak maxnet amaç işleviyle anlamlıdır; HABITUS her uyumda bu yolu kullanır ve kullanıldığını kayda yazar.
5.16.4 N hinge features ve N threshold features
- Ne işe yarar. Öngörücü başına üretilecek menteşe düğümü ve eşik özelliği sayısı.
- Ne zaman, nasıl ayarlanır. 50 menteşe maxnet'in varsayılanıdır. Eşik sayısı yalnız
thresholdsınıfı seçiliyse kullanılır; 0 elapid'in kendi değerini (10) bırakır. - Sonuca etkisi. Düğüm sayısı arttıkça tepki eğrisi daha ince ayrıntı yakalayabilir; ceza bunu sınırlar.
- Dikkat. Ayar sekmesinde bu iki değer bütün ızgara noktaları için sabit tutulur (
sdm_tuning.py:550-551).
5.16.5 Use lambdas
Kutu devre dışıdır ve sonucu etkilemez: model maxnet gibi λ yolunun son değerinde uydurulur (tabs/tab_models.py:1079-1085). Değer yine de kayda (use_lambdas) yazılır.
Not: MaxEnt çapraz doğrulamasında arka plan katlara bölünmez; her kat aynı arka planla eğitilir. Test skorları test katındaki varlık ve sözde yokluklarla hesaplanır. Arka planın büyüklüğü ve örnekleme biçimi ① Data'da ayarlanır (Bölüm 3). Kurulu elapid bir ayarı tanımıyorsa ayar sessizce atılmaz; "MaxEnt: the installed elapid (…) has no setting for …" uyarısı verilir (
sdm_core.py:4684-4691).
5.17 ENFA: ekolojik niş faktör analizi
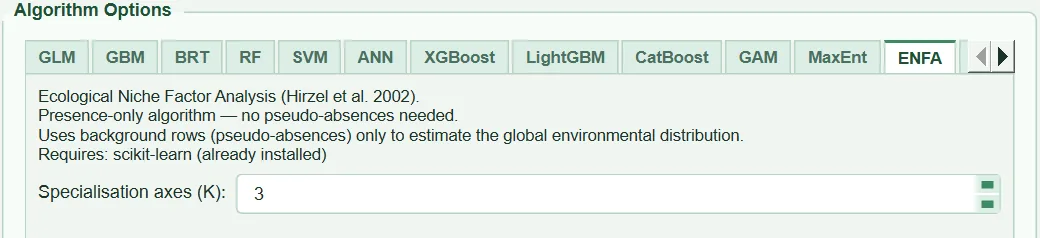
Aile ve uygulama. Türün kullandığı ortamı genel (küresel) ortamla karşılaştıran çok değişkenli niş yöntemi (Hirzel ve ark. 2002). HABITUS'ta numpy ile yazılmıştır (sdm_core.py:4046-4204):
- Küresel ortalama ve kovaryans, varsa ① Data'daki yalnız-varlık arka planından, yoksa eğitim katının bütün satırlarından (varlık + sözde yokluk) kestirilir; kovaryans Ledoit–Wolf büzülmesiyle hesaplanır ve köşegenine 1e-6 eklenir.
- Veri küresel kovaryansla beyazlatılır; marjinallik ekseni, tür ortalamasının küresel ortalamadan farkının yönüdür.
- Marjinalliğe dik alt uzayda varlıkların kovaryansının özdeğer ayrışımı yapılır ve en büyük özdeğerli K eksen tutulur.
- Ham puan \exp\{-\tfrac12[d_m^2 + \sum_k (z_k-\mu_k)^2/\lambda_k]\}'dir; d_m marjinallik ekseni boyunca tür ortalamasına uzaklıktır.
- Puan, uydurma sırasında eğitim satırlarının puan aralığıyla 0–1'e ölçeklenir; bu aralık modelle saklanır, böylece aynı hücre her tahminde aynı değeri alır (
sdm_core.py:3719-3743,4158-4162).
Kategorik değişkenler dışarıda bırakılır. En az 2 varlık gerekir.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Specialisation axes (K): |
Tutulacak özelleşme ekseni sayısı | 3 | 1 – 10 | tabs/tab_models.py:1102-1104; sdm_core.py:4074, 4133 |
5.17.1 Specialisation axes (K)
- Ne işe yarar. Puana marjinallik ekseninin yanında kaç ek eksenin gireceğini belirler. Öngörücü sayısının bir eksiğiyle sınırlanır (
sdm_core.py:4133). - Ne zaman, nasıl ayarlanır. 2–4 eksen çoğu durumda varyansın büyük kısmını taşır; az öngörücüde (ör. 4) K en çok 3 olabilir.
- Sonuca etkisi. K arttıkça puan daha çok boyutta uzaklık ölçer, uygun alan daralır.
- Dikkat. ENFA sınıf ağırlığı ve kırpma dışında başka ayar almaz; ölçek ve düzenleme sabitleri kodda sabittir.
R ile karşılaştırma. adehabitatHS enfa marjinallik ve özelleşme eksenlerini hesaplar; uygunluk haritası için Hirzel ve ark.'nın özgün çalışması ayrı bir hesap kullanır. HABITUS'un ENFA puanı yukarıdaki Gauss biçimli uzaklıktır; R uygulamalarıyla sayısal karşılaştırma testi yoktur.
5.18 Mahalanobis uzaklığı
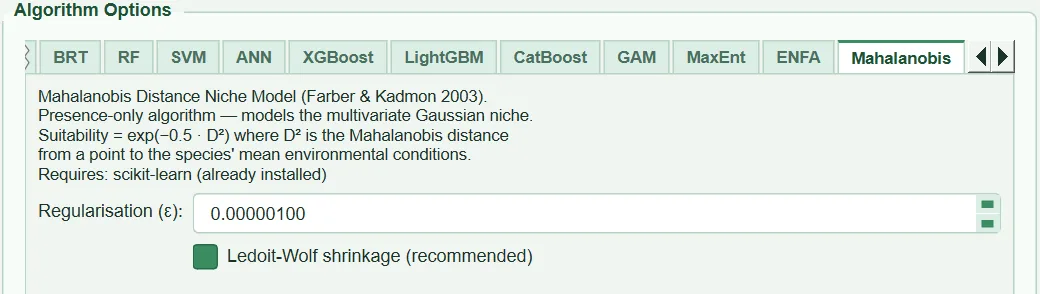
Aile ve uygulama. Yalnız-varlık uzaklık yöntemi: varlıkların ortalama ortamına Mahalanobis uzaklığı D^2(x) = (x-\mu)^\top \Sigma^{-1}(x-\mu) hesaplanır ve ham puan \exp(-D^2/2) olur (Farber ve Kadmon 2003). Kovaryans yalnız varlıklardan kestirilir (sdm_core.py:4207-4273). Puan, ENFA'daki gibi eğitim satırlarının (varlık + sözde yokluk) puan aralığıyla 0–1'e ölçeklenir ve bu aralık saklanır. Kategorik değişkenler dışarıda kalır; en az 2 varlık gerekir.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Regularisation (ε): |
Kovaryans köşegenine eklenen sabit | 0.00000100 | 0.0 – 1.0 | tabs/tab_models.py:1116-1124; sdm_core.py:4237, 4245 |
Ledoit-Wolf shrinkage (recommended) |
Kovaryansı Ledoit–Wolf büzülmesiyle kestirir | açık | açık / kapalı | tabs/tab_models.py:1125-1129; sdm_core.py:4238-4244 |
5.18.1 Ledoit-Wolf shrinkage
- Ne işe yarar. Örnek kovaryansını köşegen bir hedefe doğru en uygun miktarda büzer (Ledoit ve Wolf 2004); kapalıysa olağan örnek kovaryansı kullanılır.
- Ne zaman, nasıl ayarlanır. Varlık sayısı öngörücü sayısının birkaç katından azsa mutlaka açık tutulur.
- Sonuca etkisi. Büzülme uzaklıkları kararlı kılar; ilişkili öngörücülerde elips daha yuvarlak olur, uygun alan bir miktar genişler.
- Dikkat. Kapatılırsa ve öngörücüler güçlü ilişkiliyse matris neredeyse tekil olur; ters alma kararsızlaşır.
5.18.2 Regularisation (ε)
- Ne işe yarar. \Sigma + \varepsilon I kullanılarak matrisin tersi alınabilir tutulur.
- Ne zaman, nasıl ayarlanır.
LinAlgErroralınırsa artırılır (ipucu); 1e-4–1e-2 aralığı denenebilir. - Sonuca etkisi. Büyük ε, küçük varyanslı yönlerdeki uzaklıkları küçültür ve uygun alanı genişletir.
- Dikkat. Kutu 8 ondalık basamak gösterir; daha küçük değerler sıfıra yuvarlanır.
R ile karşılaştırma. dismo mahal ham uzaklığı farklı bir dönüşümle verir; HABITUS'un \exp(-D^2/2) dönüşümü ve eğitim aralığıyla ölçeklemesi ondan farklıdır. Aynı ortalama ve kovaryans kullanıldığında sıralama (dolayısıyla AUC) büyük ölçüde aynıdır; yalnız HABITUS'un eğitim aralığına kırpması aralık dışındaki hücrelerde eşit değerler yaratabilir.
5.19 BIOCLIM: iklim zarfı
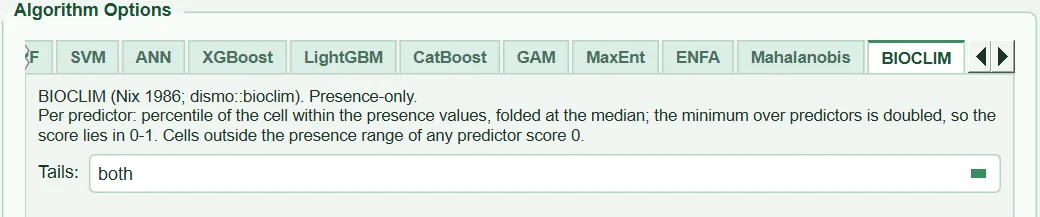
Aile ve uygulama. Yalnız-varlık zarf (envelope) yöntemi (Nix 1986). numpy ile yazılmıştır (sdm_niche.py:44-90). Her öngörücü için hücre değerinin varlık değerleri içindeki yüzdeliği p orta-sıra kuralıyla hesaplanır; p > 0{,}5 ise 1-p alınır (medyanda katlanır), öngörücüler üzerinden en küçük değer alınıp ikiyle çarpılır. Sonuç 0–1 arasındadır: 1 bütün öngörücülerin medyanında, 0 en az bir öngörücünün varlık aralığı dışında demektir. Puan yeniden ölçeklenmez. Kategorik değişkenler dışarıda kalır; en az 2 varlık gerekir.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Tails: |
Hangi kuyruğun puanı düşüreceği | both |
both, low, high |
tabs/tab_models.py:900-907; sdm_niche.py:79-88 |
5.19.1 Tails
- Ne işe yarar.
bothklasik BIOCLIM'dir: iki kuyruk da puanı düşürür.lowyalnız alt kuyruğu sayar (medyanın üstü 1, varlık aralığının üstü de 1);highyalnız üst kuyruğu sayar. dismopredict(…, tails=)ile aynı anlamdadır. - Ne zaman, nasıl ayarlanır. Değişkenlerin hepsinin yalnız bir yönde sınırlayıcı olduğu düşünülüyorsa (ör. yalnız minimum sıcaklıklar)
lowya dahighseçilir. Seçim bütün öngörücülere uygulanır. - Sonuca etkisi.
lowya dahigh,both'a göre daha geniş bir uygun alan verir. - Dikkat. Arayüzde öngörücü başına ayrı kuyruk seçimi yoktur.
R ile karşılaştırma. dismo bioclim ile aynı tanımdır. Yüzdelik orta sıra (mid-rank) ile hesaplanır; dismo'nun eşit değerleri işleme biçimi doğrulanamadığından değerler 1/n düzeyinde farklı olabilir (sdm_niche.py:16-18).
5.20 Domain: Gower uzaklığı
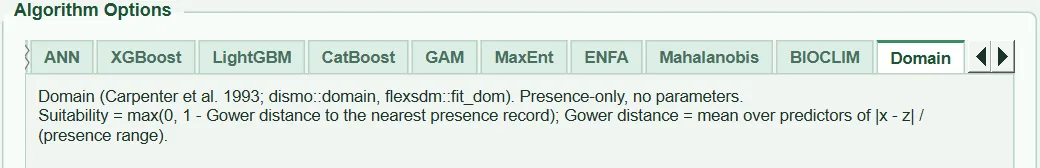
Aile ve uygulama. Yalnız-varlık benzerlik yöntemi (Carpenter ve ark. 1993). Bir hücre ile her varlık arasındaki Gower uzaklığı, öngörücüler üzerinden \lvert x_j-z_j\rvert/\text{aralık}_j ortalamasıdır; aralık varlık değerlerinin aralığıdır. Uygunluk \max(0,\,1-\min_z G)'dir (sdm_niche.py:95-127). Aralığı sıfır olan öngörücü eşitse 0, değilse 1 katkı verir. Kategorik değişkenler dışarıda kalır; en az 2 varlık gerekir; yinelenen varlık satırları bir kez sayılır.
Ayarı yoktur; sayfada yalnız açıklama notu bulunur (tabs/tab_models.py:917-925).
Dikkat: Domain, en yakın tek varlığa bakar. Tek bir hatalı ya da uç kayıt, çevresinde yüksek uygunluk yaratır; kayıt temizliği (Bölüm 2) bu yöntem için özellikle önemlidir. Hesap süresi varlık sayısıyla doğrusal artar; bellek, hücre bloklarıyla sınırlandırılır.
R ile karşılaştırma. dismo domain ve flexsdm fit_dom ile aynı tanımdır; HABITUS'ta karşılaştırmalı test yoktur.
5.21 GLMNET: elastik ağ lojistik regresyon
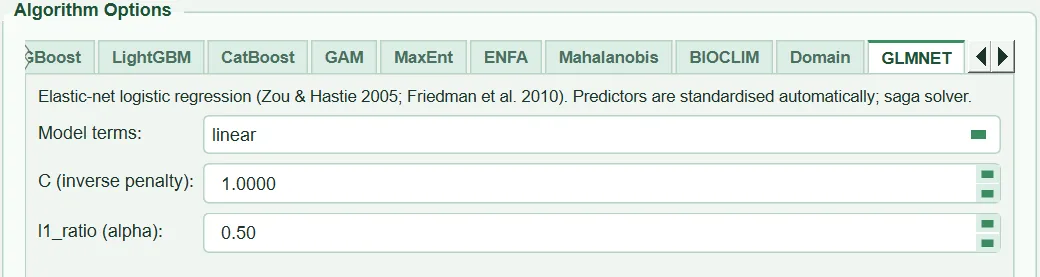
Aile ve uygulama. L1 ve L2 cezalarını birleştiren elastik ağ lojistik regresyon (Zou ve Hastie 2005; Friedman ve ark. 2010). scikit-learn LogisticRegression, saga çözücü, en çok 5000 yineleme; terimler GLM'deki gibi üretilip standartlaştırılır (sdm_core.py:3446-3461, 3493-3505). Varlık–sözde yokluk.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Model terms: |
Terim yapısı | linear |
linear, quadratic, interactions |
tabs/tab_models.py:929-934 |
C (inverse penalty): |
Ters ceza gücü | 1.0000 | 0.0001 – 10 000 | tabs/tab_models.py:935-939 |
l1_ratio (alpha): |
L1 / L2 karışımı | 0.50 | 0.0 – 1.0 (adım 0.1) | tabs/tab_models.py:940-945 |
5.21.1 C (inverse penalty)
- Ne işe yarar. scikit-learn amaç işlevini n ile bölerek glmnet biçimine getirirsek \lambda \approx 1/(C\,n) olur; n eğitim satırı sayısıdır.
- Ne zaman, nasıl ayarlanır. Örnek koşuda bir eğitim katında yaklaşık 860 satır vardır; C = 1, \lambda \approx 0{,}0012 demektir ve hafif bir cezadır. Gerçek bir seçim için ayar sekmesi C = 0,01/0,1/1/10 dener.
- Sonuca etkisi. C küçüldükçe katsayılar küçülür; l1_ratio > 0 ise bazı öngörücüler tamamen düşer.
- Dikkat. R glmnet λ'yı genellikle
cv.glmnetile seçer; HABITUS'ta tek bir sabit C kullanılır.
5.21.2 l1_ratio (alpha)
- Ne işe yarar. glmnet'in
alpha'sıdır: 0 ridge (yalnız L2), 1 lasso (yalnız L1; değişken düşürür), arası elastik ağ. - Ne zaman, nasıl ayarlanır. Güçlü ilişkili öngörücüler varsa 0,5 civarı, lasso'nun ilişkili değişkenlerden rastgele birini seçme eğilimini yumuşatır.
- Sonuca etkisi. 1'e yaklaştıkça model seyrekleşir ve yorumlanması kolaylaşır.
- Dikkat.
sagayavaş yakınsayabilir; çok küçük C ve çok terimde yakınsama uyarısı görülebilir.
5.21.3 Model terms
- Ne işe yarar. GLM ile aynı (§5.6.1); varsayılan burada
linear'dır (sdm paketinin glmnet'i gibi). - Ne zaman, nasıl ayarlanır. Ceza aşırı uyumu yavaşlattığı için
quadraticya dainteractionsGLM'e göre daha güvenle denenebilir (ipucu). - Sonuca etkisi. Terim arttıkça esneklik artar; ceza fazla terimleri sıfırlayabilir.
- Dikkat. Ayar sekmesi terim yapısını değiştirmez; buradaki değer sabit kalır.
5.22 CART: sınıflandırma ağacı
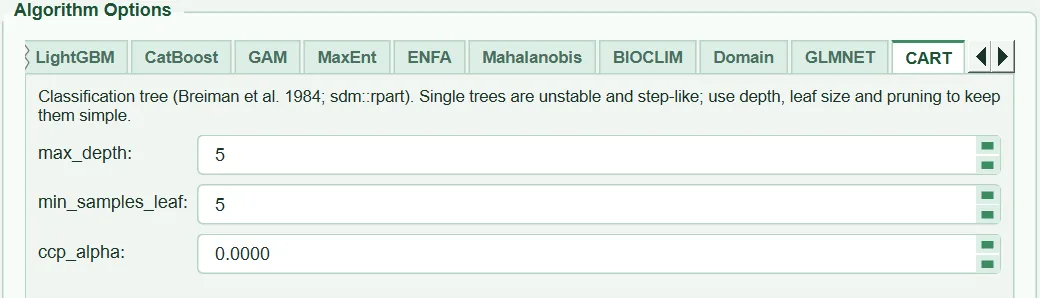
Aile ve uygulama. Tek bir sınıflandırma ağacı (Breiman ve ark. 1984). scikit-learn DecisionTreeClassifier; uygunluk, hücrenin düştüğü yapraktaki varlık oranıdır (sdm_core.py:3506-3515). Varlık–sözde yokluk.
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
max_depth: |
En çok derinlik | 5 | 0 (no limit) – 30 |
tabs/tab_models.py:957-960; sdm_core.py:3509-3511 |
min_samples_leaf: |
Yapraktaki en az satır | 5 | 1 – 500 | tabs/tab_models.py:961-963 |
ccp_alpha: |
Maliyet-karmaşıklık budaması | 0.0000 | 0.0 – 0.5 | tabs/tab_models.py:964-967 |
5.22.1 max_depth ve min_samples_leaf
- Ne işe yarar. Ağacın en çok derinliği (0 = sınırsız) ve yaprak büyüklüğü.
- Ne zaman, nasıl ayarlanır. Açıklama amaçlı kullanımda 3–5 derinlik okunabilir bir ağaç verir. Yaprak oranları olasılık olduğundan çok küçük yapraklar 0/1 yüzey üretir (ipucu).
- Sonuca etkisi. Derinlik arttıkça harita daha çok basamaklı bölgeye ayrılır ve eğitim uyumu artar.
- Dikkat. Tek ağaç kararsızdır: veri biraz değişince ağacın yapısı büyük ölçüde değişebilir.
5.22.2 ccp_alpha
- Ne işe yarar. Ağacı, eklenen her yaprağın karmaşıklık bedeline göre budar; rpart'ın
cpparametresinin karşılığıdır, ama ölçeği aynı değildir. - Ne zaman, nasıl ayarlanır. Ayar sekmesi 0/0,002/0,01 dener.
- Sonuca etkisi. Büyüdükçe ağaç küçülür.
- Dikkat. rpart varsayılan olarak
cp= 0,01 ile budar; HABITUS'un varsayılanı 0'dır (budama yok), sınırlamayı derinlik ve yaprak boyu yapar.
5.23 ESM: küçük modeller topluluğu
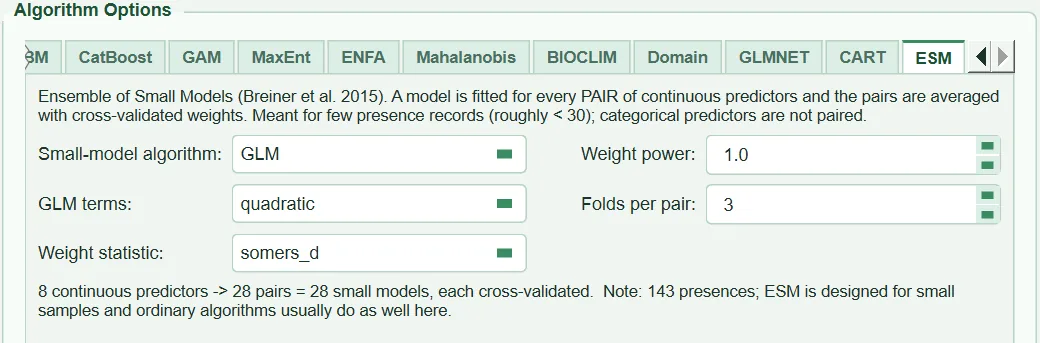
Aile ve uygulama. Çok az kayıtlı türler için önerilen yöntem (Lomba ve ark. 2010; Breiner ve ark. 2015). Her sürekli öngörücü çifti için iki değişkenli küçük bir model uydurulur; çiftler, kendi çapraz doğrulama başarılarıyla ağırlıklandırılıp ortalanır (sdm_core.py:4370-4455, sdm_niche.py:130-265). p öngörücüde p(p-1)/2 çift vardır; 8 öngörücüde 28. Kategorik değişkenler çiftlere girmez. 100'den fazla çift olursa uyarı verilir (sdm_niche.py:39).
| Arayüzdeki ad | Ne yapar | Varsayılan | Aralık / seçenekler | Kod |
|---|---|---|---|---|
Small-model algorithm: |
Küçük modellerin algoritması | GLM |
GLM, RF, MAXENT |
tabs/tab_models.py:979-983; sdm_core.py:4380-4385, 4407-4414 |
GLM terms: |
GLM küçük modellerinin terimleri | quadratic |
quadratic, linear |
tabs/tab_models.py:1004-1005; sdm_core.py:4409 |
Weight statistic: |
Çift ağırlığının ölçütü | somers_d |
somers_d, auc, boyce |
tabs/tab_models.py:984-991; sdm_niche.py:142-157 |
Weight power: |
Ağırlığın üssü | 1.0 | 0.0 – 10.0 | tabs/tab_models.py:992-996 |
Folds per pair: |
Her çifti puanlayan kat sayısı | 3 | 2 – 10 | tabs/tab_models.py:997-1003; sdm_core.py:4296-4368 |
Sayfanın altındaki bilgi satırı seçilen öngörücülerden çift sayısını hesaplar; 50 ve daha çok varlıkta ESM'nin küçük örneklemler için tasarlandığını hatırlatır (tabs/tab_models.py:1022-1044).
5.23.1 Small-model algorithm ve GLM terms
- Ne işe yarar. Her çiftin modeli. GLM, ana GLM ile aynı ayarlarla (C = 1) ve burada seçilen terimlerle; RF 200 ağaç ve yaprak boyu 2 ile (arayüzde değiştirilemez); MaxEnt ise MaxEnt sekmesindeki ayarlarla ve MaxEnt arka planının ilgili iki sütunuyla uydurulur (
sdm_core.py:4407-4445). - Ne zaman, nasıl ayarlanır. Doğrusal + karesel GLM olağan seçimdir (Breiner ve ark. 2015). RF daha yavaş, MaxEnt çok daha yavaştır. flexsdm'in
esm_glmvarsayılanı yalnız doğrusal terimdir; onunla karşılaştırma içinlinearseçilir. - Sonuca etkisi. Karesel terimler her çiftte optimumlu tepkiye izin verir.
- Dikkat.
Balance classesyalnız GLM ve RF tabanında küçük modellere uygulanır; MaxEnt tabanında yok sayılır ve kayda "not supported (ignored)" yazılır (sdm_core.py:4402-4406).
5.23.2 Weight statistic ve Weight power
- Ne işe yarar. Her çiftin ağırlığı, çiftin kat dışı (out-of-fold) tahminlerinden hesaplanan ölçütün
powerüssüdür.somers_d= \max(2(\text{AUC}-0{,}5),\,0);auc= ham AUC;boyce= \max(\text{Boyce},\,0). Şanstan iyi olmayan çiftsomers_dveboyceile 0 ağırlık alır. - Ne zaman, nasıl ayarlanır. Breiner ve ark. (2015) Somers' D kullanır.
aucağırlıkları neredeyse eşittir; ayırt edici olması için üs 1'den büyük seçilmelidir. Üs 0 eşit ağırlık demektir. - Sonuca etkisi. Üs büyüdükçe topluluk en iyi birkaç çifte yoğunlaşır.
- Dikkat. Hiçbir çift şanstan iyi değilse eşit ağırlık kullanılır ve "No small model beat chance in cross-validation; the ensemble uses equal weights." uyarısı verilir (
sdm_niche.py:260-263).
5.23.3 Folds per pair
- Ne işe yarar. Çiftlerin puanlandığı iç kat sayısı. Katlar ana çapraz doğrulama tasarımını (mekânsal blok, çevresel, bant, dama tahtası) ESM'in eğitildiği satırlara uygular; tasarım uygulanamazsa ya da tasarım
random/jackknifeise rastgele tabakalı katlar kullanılır (sdm_core.py:4296-4368). Kat sayısı varlık sayısından büyük olamaz. - Ne zaman, nasıl ayarlanır. Çok az varlıkta (10–20) 2–3 kat; daha çok varlıkta 4–5.
- Sonuca etkisi. Kat arttıkça ağırlıklar daha kararlı, süre daha uzun olur.
- Dikkat. Tasarım uygulanamadığında bir kez "ESM: the … design could not be applied to the folds that weight the small models (…); random stratified folds were used for them." uyarısı verilir.
R ile karşılaştırma. ecospat ecospat.ESM.Modeling aynı fikri biomod2 modelleriyle uygular. HABITUS'un uygulaması kendine özgüdür; ecospat ile sayısal karşılaştırma testi yoktur.
5.24 Çıktılar ve sonraki adıma geçenler
- Kaydedilen ayarlar: bu sayfadaki bütün değerler (işaretli olmayan algoritmalarınki de)
habitus_run_config.json→settings.models.algorithm_optionsalanına; MaxEnt'e gerçekte verilen ayarlar (maxent_settings_used: elapid argümanları, tohum, arka plana eklenen varlık sayısı, çözücü) ayrıca yazılır. ESM çalıştırılmışsa çift sayısı, ağırlıklar ve en iyi on çiftesmalanına yazılır (sdm_core.py:4457-4478). Sınıf dengesinin her algoritmaya nasıl uygulandığıclass_weight_appliedalanındadır. - Modeller: her algoritma × PA kümesi × kat ve tam model; ③'ün
Evaluation Resultsalt sekmesinde skorlar, ④ Evaluation'da tepki eğrileri, önem grafikleri ve ROC eğrileri. - Haritalar: algoritma başına güncel uygunluk ve topluluk haritası (
Current Distribution Map), ⑤ Future Scenarios'ta aynı modellerle projeksiyon.
5.25 Uzman soruları
S1. On sekiz algoritmadan hangilerini seçmeliyim; varsayılan neden yalnız GLM ve RF?
Cevap: Program açılışta yalnız GLM ve RF'yi işaretler (tabs/tab_models.py:129-132): biri yorumlanabilir parametrik regresyon, öteki esnek bir ağaç topluluğu; ikisi de ek paket gerektirmez ve hızlıdır. Seçim için kesin bir kural kodda yoktur. Tipik bir çalışma farklı ailelerden birkaç yöntemi (GLM ya da GAM, RF ya da BRT, MaxEnt) çalıştırıp topluluk haritasıyla birleştirir. Çok az kayıtta (yaklaşık 30'un altı) ESM, GLMNET ya da doğrusal/karesel özellikli MaxEnt; yalnız varlık kaydı olan ve sözde yoklukla çalışmak istenmeyen durumlarda MaxEnt, ENFA, Mahalanobis, BIOCLIM ve Domain düşünülür. Valavi ve ark. (2022), yalnız-varlık verisinde karşılaştırmalı başarımını çok sayıda tür üzerinde inceler; sonuçları HABITUS'un uygulamalarıyla doğrudan aktarılamaz, yine de yöntem ailelerinin genel davranışı için başvurulabilir.
S2. Varsayılan değerler nereden geliyor?
Cevap: Üç kaynaktan. (1) Kütüphane varsayılanları: RF (500 ağaç, sqrt, yaprak 1; randomForest ile aynı), SVM, ANN'in alpha'sı, GAM (20 spline, lam 0,6; pygam), XGBoost'un cezaları. (2) Yayın: BRT öğrenme hızı ve torbalama oranı Elith ve ark. (2008) (sdm_core.py:3530-3548), MaxEnt menteşe sayısı ve β = 1 maxnet, ESM Breiner ve ark. (2015). (3) HABITUS'un kendi eşli çapraz doğrulama karşılaştırmaları: GBM'in kütük ağaçları ve BRT'nin derinliği 2 (kod açıklamaları sdm_core.py:3517-3522, 3532-3537), GLM'in C = 1 cezası (ipucu, tabs/tab_models.py:741-745). Bu karşılaştırmaların ayrıntısı kod açıklamalarında belirtilen iç notlardadır; kitabın konusu değildir. Bir yayında ayarlar "HABITUS varsayılanları" diye değil, habitus_run_config.json'daki sayılarla raporlanmalıdır.
S3. HABITUS'un MaxEnt'i R maxnet ile aynı sonucu verir mi?
Cevap: Amaç işlevi aynıdır: özellik başına L1 cezası, varlık 1 / arka plan 100 ağırlığı, son λ, varlıkların arka plana eklenmesi (sdm_core.py:3776-3836, 4698-4707). tests/test_maxent_maxnet.py, Rutrough ve ark. (2019) verisinde üç ayarda R maxnet 0.1.4 tahminleriyle korelasyonun 0,995'i aşmasını ve ortalama mutlak farkın 0,02'nin altında kalmasını sınar. Kalan farkların kaynağı çözücüdür (glmnet'in koordinat inişi yerine liblinear) ve kesişimin çok küçük ama sıfır olmayan cezası. Özellik üretimi elapid'e aittir; elapid ile maxnet'in menteşe düğümlerinin yerleştirilmesi bu test verisinde uyumludur, her veri için ayrıca sınanmamıştır. maxnet ile birebir karşılaştırma için Auto (maxnet default rule) işaretlenmelidir; HABITUS'un varsayılan linear,hinge,product seti maxnet'in kuralıyla aynı değildir.
S4. MaxEnt'te varlıkların arka plana eklenmesi neden önemli?
Cevap: Maxent ve maxnet'in varsayılan davranışı budur; varlığın bulunduğu ortam, kullanılabilir ortamın da bir parçasıdır. Eklenmezse varlık hücrelerinin ortamı arka plan dağılımında eksik temsil edilir ve modelin ham çıktısı ile normalleştirme sabiti maxnet'ten farklılaşır. HABITUS yalnız öngörücü değerleri arka planda zaten bulunmayan varlıkları ekler (sdm_core.py:4702-4706); örnek koşunun tam modelinde 143 varlıktan 91'i eklenmiştir.
S5. Yalnız-varlık yöntemleri (MaxEnt, ENFA, Mahalanobis, BIOCLIM, Domain) neden sözde yokluklarla değerlendiriliyor?
Cevap: HABITUS bütün algoritmaları aynı test katında, aynı varlık ve sözde yokluk satırlarıyla puanlar (sdm_core.py:5530-5540); böylece skorlar algoritmalar arasında karşılaştırılabilir ve topluluk ağırlıkları tutarlı olur. Bu durumda AUC "varlığı sözde yokluktan ayırma" gücüdür, gerçek yokluğa karşı başarı değildir; Boyce indeksi ise yalnız varlıklara dayandığından yalnız-varlık verisi için daha uygun bir ölçüttür. Test katında varlık kalmazsa eğitim varlıklarının beşte biri teste taşınır (sdm_core.py:5455-5468); bu durumda kat başka algoritmaların katından farklılaşır. Kullanıcı yalnız-varlık modellerini ayrıca değerlendirmek isterse Boyce ve OR_10p sütunlarına odaklanmalıdır.
S6. Sınıf dengesi (Balance classes) açılmalı mı; prevalans neyi değiştirir?
Cevap: Varsayılan kapalıdır. Örnek koşuda sözde yokluk : varlık oranı 7,0 : 1'dir (pa_to_presence_ratio = 6,993). Denge açıldığında desteklenen algoritmalarda iki sınıfın toplam ağırlığı eşitlenir (§5.4.5). Bu, tahmin edilen değerin anlamını değiştirir: çıktı artık sözde yokluk oranını yansıtmaz, eşikler yeniden türetilir; sıralama ölçütleri (AUC) çoğunlukla az etkilenir (ipucu, tabs/tab_models.py:346-348). Sözde yokluk sayısı zaten keyfî olduğundan mutlak "olasılık" yorumlanmıyorsa denge şart değildir. Önemli olan, dengenin GAM, MaxEnt ve yalnız-varlık yöntemlerinde hiç uygulanmadığıdır; bir toplulukta dengeli ve dengesiz modeller karışabilir. Uygulamanın dökümü class_weight_applied alanındadır.
S7. Sonuçlar tekrarlanabilir mi; hangi kaynaklar rastgelelik katar?
Cevap: Evet; tek tohumla. Bütün rastgele öğrenicilere ① Data'daki tohum verilir (sdm_core.py:3474-3475); MaxEnt'e de random_state geçer (sdm_core.py:4643), permütasyon önemi tohumdan türetilen üreteçle hesaplanır (sdm_core.py:4847-4853). Rastgelelik katan ayarlar RF'nin bootstrap'ı, GBM/BRT/XGBoost/LightGBM'in alt örneklemesi, CatBoost'un random_strength'i ve bagging_temperature'ı, ANN'in başlangıç ağırlıkları, SVM'nin Platt katları ve ESM'nin iç katlarıdır. Çok iş parçacıklı kütüphaneler (RF, XGBoost, LightGBM n_jobs = -1) farklı işlemci sayısında kayan nokta toplama sırası yüzünden son basamaklarda fark verebilir; bu kodda sınanmamıştır. Kütüphane sürümleri habitus_run_config.json → environment alanında kaydedilir; aynı sonuç için aynı sürümler gerekir.
S8. GLM neden cezalı; R'deki glm ile sonucumu nasıl karşılaştırırım?
Cevap: Karesel ve etkileşim terimleri az kayıtta katsayıları şişirir; HABITUS standartlaştırılmış terimlere hafif bir L2 cezası uygular (sdm_core.py:3481-3492). R glm() cezasızdır. Karşılaştırma için Regularisation C = 1e6 girilir; terim yapısı R'de y ~ x + I(x^2) (quadratic) ya da y ~ poly(x1, x2, degree = 2, raw = TRUE) (interactions) ile kurulur. biomod2'nin GLM'i ayrıca AIC'ye göre adımsal seçim yapar; HABITUS'ta adımsal seçim yoktur, bu nedenle biomod2 ile katsayılar birebir aynı olmaz.
S9. GAM'ın sonuçları mgcv ile neden farklı olabilir?
Cevap: HABITUS pygam LogisticGAM'ı sabit bir düzgünleştirme cezasıyla (lam, varsayılan 0,6) ve öngörücü başına 20 B-spline tabanıyla uydurur (sdm_core.py:4500-4523). mgcv ise cezayı veriden (GCV/REML) seçer ve farklı bir taban kullanır. Aynı veride mgcv daha düzgün ya da daha kıvrımlı eğri seçebilir. Yakınlaştırmak için ayar sekmesinde lam aranabilir; ama iki model yine özdeş olmaz. GAM'da etkileşim terimi ve sınıf dengesi yoktur.
S10. BRT ağaç sayısını dismo gbm.step gibi kendisi seçiyor mu?
Cevap: Hayır. n_estimators sabittir (BRT 1000, GBM 200) ve erken durdurma kullanılmaz (sdm_core.py:3523-3548). dismo gbm.step ağaç sayısını 10 katlı çapraz doğrulama sapmasının en küçük olduğu yerde durdurur. HABITUS'ta yakın bir sonuç için GBM ayar sekmesinde n_estimators × learning_rate ızgarası aranır ve seçilen değer BRT'ye elle yazılır. Ayrıca Elith ve ark. tree.complexity = 5 kullanmışken HABITUS BRT'nin derinliği 2'dir.
S11. XGBoost, LightGBM ve CatBoost'un varsayılanları SDM için uygun mu?
Cevap: Bu üçünün varsayılanları (XGBoost derinlik 6 ve 500 tur; LightGBM 31 yaprak, sınırsız derinlik ve 500 tur; CatBoost derinlik 4 ve 300 tur) GBM ve BRT'ye göre çok daha karmaşık modellerdir (sdm_core.py:3586-3647). Yardım sekmesindeki karşılaştırma tablosu bunlar için en az 100 kayıt ve aşırı uyum eğilimi not eder. Birkaç yüz varlıktan az veride derinliği 2–3'e, yaprak sayısını 7–15'e indirmek ve sonucu eğitim–test AUC farkıyla (dAUC) denetlemek önerilir. LightGBM'de subsample ayarının etkisi olmadığına dikkat edilmelidir (§5.13.3).
S12. Kategorik bir öngörücü (ör. arazi örtüsü) eklediğimde her algoritma onu aynı biçimde mi kullanıyor?
Cevap: Hayır (§5.4.3). Regresyon ve çekirdek yöntemleri sınıf başına 0/1 sütun, GAM faktör terimi, MaxEnt kategorik özellik kullanır; ağaç yöntemleri tamsayı kodunu sayısal bölünmeyle işler; zarf ve uzaklık yöntemleri değişkeni dışarıda bırakır ve günlüğe not düşer (sdm_core.py:4010-4036). Bu yüzden bir topluluktaki modellerin bir kısmı kategorik değişkeni hiç görmeyebilir. Eğitimde görülmemiş bir sınıf (yalnız projeksiyon alanında bulunan) regresyon yöntemlerinde, GAM'da ve MaxEnt'te "sınıf etkisi yok" olarak, ağaçlarda ise sayısal kodunun düştüğü dalda değerlendirilir.
S13. ENFA ve Mahalanobis puanları neden 0–1 aralığına yeniden ölçekleniyor; harita karşılaştırılabilir mi?
Cevap: Ham puan \exp(-D^2/2) çok öngörücüde hızla sıfıra yaklaşır. HABITUS, uydurma sırasında eğitim satırlarının puan aralığını saklar ve her tahminde aynı aralığı kullanır (sdm_core.py:3719-3743). Bu nedenle bir hücre, test katında da projeksiyonda da aynı değeri alır ve eşik iki ortamda aynı anlamdadır. Yine de puanın ölçeği algoritmaya özgüdür; ENFA'nın 0,6'sı ile GLM'in 0,6'sı aynı olasılık değildir. Topluluk ağırlıkları ve ikili eşikler bu yüzden algoritma başına ayrı belirlenir (Bölüm 6).
S14. Ayarlanan parametreleri bir yayında nasıl raporlamalıyım?
Cevap: habitus_run_config.json içindeki algorithm_options (girilen değerler), maxent_settings_used (MaxEnt'e gerçekten verilenler ve çözücü), class_weight, clamp, random_seed ve environment (kütüphane sürümleri) birlikte raporlanmalıdır. Ayar sekmesi kullanıldıysa ızgara, seçim kuralı ve seçilen nokta da yazılmalıdır; ayar ile değerlendirme aynı katlarda yapıldığında skorun iyimser olabileceği Bölüm 6'da tartışılır. ODMAP raporu (Bölüm 11) bu bilgilerin çoğunu otomatik taşır.
5.26 Sık hatalar ve tuzaklar
- Paket kurulu değil: kutu gri ve
[not installed]ekli. Örnek ipucu: "Not installed — pip install elapid". Kurulumdan sonra program yeniden başlatılmalıdır. - Hiç algoritma seçilmeden çalıştırma: "Select at least one algorithm."
- ANN katmanlarını yanlış yazmak (ör.
100;50,100 50,0): "ANN hidden layers: … is not a list of positive whole numbers separated by commas (e.g. 100, 50)." - RF
max_features'aautoya da%50yazmak: "RF max_features: … is not sqrt, log2, a whole number of variables or a fraction between 0 and 1." Oran 0,5 olarak yazılmalıdır. - GAM
n_splines≤ 3: arayüz alt sınırı 4'tür; betikle verilirse "GAM n_splines must exceed the spline order (3)." - MaxEnt özellik adını yanlış yazmak (ör.
hinges,quad): elapid ayarı reddeder ve MaxEnt "MaxEnt could not be fitted…" ya da "MaxEnt could not be configured with the settings you chose…" iletisiyle başarısız olur. Geçerli adlar:linear,quadratic,hinge,product,threshold. - MaxEnt'te
Autoişaretliyken metin kutusunu değiştirmek: kutu devre dışıdır ve yok sayılır. N threshold features'ı değiştiripthresholdsınıfını seçmemek: değer kullanılmaz.- Yalnız-varlık yöntemlerine kategorik değişken vermek: değişken sessizce değil, günlükte "NOTE: … is an envelope/distance model for continuous predictors…" iletisiyle dışarıda bırakılır; yalnız kategorik değişken varsa "… needs at least one continuous predictor (only categorical ones were given)." hatası verilir.
- ESM'i çok öngörücüyle çalıştırmak: 15 öngörücü 105 çift ve 105 ayrı çapraz doğrulanmış model demektir; bilgi satırı "WARNING: more than 100 pairs…" der.
- ESM'i çok kayıtlı türde kullanmak: 50 ve üstü varlıkta bilgi satırı ESM'nin küçük örneklemler için tasarlandığını hatırlatır; olağan algoritmalar genellikle o kadar iyidir.
- Mahalanobis'te
LinAlgError: ε artırılır ya da Ledoit–Wolf açık tutulur; güçlü ilişkili öngörücüler ② Variables'ta elenir. Balance classes'ın her algoritmayı etkilediğini sanmak: GAM, MaxEnt, ENFA, Mahalanobis, BIOCLIM ve Domain'de etkisizdir.- LightGBM
subsample'ı ayarlamak: satır alt örneklemesi HABITUS'ta etkin olmadığından değer sonucu değiştirmez. - Varsayılan derin boosting modellerini az kayıtla kullanmak: XGBoost/LightGBM'de eğitim AUC'si 1'e yaklaşırken test AUC'si düşer; dAUC sütunu izlenmelidir.
5.27 Kaynaklar
Anderson, C.B., 2023. elapid: Species distribution modeling tools for Python. Journal of Open Source Software 8, 4930. https://doi.org/10.21105/joss.04930
Breiman, L., 2001. Random forests. Machine Learning 45, 5–32. https://doi.org/10.1023/A:1010933404324
Breiman, L., Friedman, J.H., Olshen, R.A., Stone, C.J., 1984. Classification and Regression Trees. Wadsworth, Belmont (yeni baskı: Routledge, 2017). https://doi.org/10.1201/9781315139470
Breiner, F.T., Guisan, A., Bergamini, A., Nobis, M.P., 2015. Overcoming limitations of modelling rare species by using ensembles of small models. Methods in Ecology and Evolution 6, 1210–1218. https://doi.org/10.1111/2041-210X.12403
Carpenter, G., Gillison, A.N., Winter, J., 1993. DOMAIN: a flexible modelling procedure for mapping potential distributions of plants and animals. Biodiversity and Conservation 2, 667–680. https://doi.org/10.1007/BF00051966
Chen, T., Guestrin, C., 2016. XGBoost: A scalable tree boosting system. Proceedings of the 22nd ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 785–794. https://doi.org/10.1145/2939672.2939785
Elith, J., Leathwick, J.R., Hastie, T., 2008. A working guide to boosted regression trees. Journal of Animal Ecology 77, 802–813. https://doi.org/10.1111/j.1365-2656.2008.01390.x
Farber, O., Kadmon, R., 2003. Assessment of alternative approaches for bioclimatic modeling with special emphasis on the Mahalanobis distance. Ecological Modelling 160, 115–130. https://doi.org/10.1016/S0304-3800(02)00327-7
Friedman, J., Hastie, T., Tibshirani, R., 2010. Regularization paths for generalized linear models via coordinate descent. Journal of Statistical Software 33(1), 1–22. https://doi.org/10.18637/jss.v033.i01
Hastie, T., Tibshirani, R., 1986. Generalized additive models. Statistical Science 1, 297–310. https://doi.org/10.1214/ss/1177013604
Hirzel, A.H., Hausser, J., Chessel, D., Perrin, N., 2002. Ecological-niche factor analysis: how to compute habitat-suitability maps without absence data? Ecology 83, 2027–2036. https://doi.org/10.1890/0012-9658(2002)083[2027:ENFAHT]2.0.CO;2
Ledoit, O., Wolf, M., 2004. A well-conditioned estimator for large-dimensional covariance matrices. Journal of Multivariate Analysis 88, 365–411. https://doi.org/10.1016/S0047-259X(03)00096-4
Lomba, A., Pellissier, L., Randin, C., Vicente, J., Moreira, F., Honrado, J., Guisan, A., 2010. Overcoming the rare species modelling paradox: a novel hierarchical framework applied to an Iberian endemic plant. Biological Conservation 143, 2647–2657. https://doi.org/10.1016/j.biocon.2010.07.007
Merow, C., Smith, M.J., Silander, J.A., 2013. A practical guide to MaxEnt for modeling species' distributions: what it does, and why inputs and settings matter. Ecography 36, 1058–1069. https://doi.org/10.1111/j.1600-0587.2013.07872.x
Muscarella, R., Galante, P.J., Soley-Guardia, M., Boria, R.A., Kass, J.M., Uriarte, M., Anderson, R.P., 2014. ENMeval: An R package for conducting spatially independent evaluations and estimating optimal model complexity for Maxent ecological niche models. Methods in Ecology and Evolution 5, 1198–1205. https://doi.org/10.1111/2041-210X.12261
Nix, H.A., 1986. A biogeographic analysis of Australian elapid snakes. In: Longmore, R. (Ed.), Atlas of Elapid Snakes of Australia. Australian Flora and Fauna Series 7. Australian Government Publishing Service, Canberra, 4–15.
Oshiro, T.M., Perez, P.S., Baranauskas, J.A., 2012. How many trees in a random forest? In: Perner, P. (Ed.), Machine Learning and Data Mining in Pattern Recognition. Lecture Notes in Computer Science 7376. Springer, Berlin, 154–168. https://doi.org/10.1007/978-3-642-31537-4_13
Phillips, S.J., Anderson, R.P., Schapire, R.E., 2006. Maximum entropy modeling of species geographic distributions. Ecological Modelling 190, 231–259. https://doi.org/10.1016/j.ecolmodel.2005.03.026
Phillips, S.J., Anderson, R.P., Dudík, M., Schapire, R.E., Blair, M.E., 2017. Opening the black box: an open-source release of Maxent. Ecography 40, 887–893. https://doi.org/10.1111/ecog.03049
Rutrough, A., Widick, I.V., Bean, W.T., 2019. Reconstruction of the historical range alters niche estimates in an endangered rodent. Ecography 42, 1742–1751. https://doi.org/10.1111/ecog.04238
Valavi, R., Elith, J., Lahoz-Monfort, J.J., Guillera-Arroita, G., 2021. Modelling species presence-only data with random forests. Ecography 44, 1731–1742. https://doi.org/10.1111/ecog.05615
Valavi, R., Guillera-Arroita, G., Lahoz-Monfort, J.J., Elith, J., 2022. Predictive performance of presence-only species distribution models: a benchmark study with reproducible code. Ecological Monographs 92, e01486. https://doi.org/10.1002/ecm.1486
Velazco, S.J.E., Rose, M.B., de Andrade, A.F.A., Minoli, I., Franklin, J., 2022. flexsdm: An R package for supporting a comprehensive and flexible species distribution modelling workflow. Methods in Ecology and Evolution 13, 1661–1669. https://doi.org/10.1111/2041-210X.13874
Zou, H., Hastie, T., 2005. Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society Series B 67, 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x